💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
目录
- 基于大数据的广西医疗机构及药店清单可视化分析介绍
- 基于大数据的广西医疗机构及药店清单可视化分析演示视频
- 基于大数据的广西医疗机构及药店清单可视化分析演示图片
- 基于大数据的广西医疗机构及药店清单可视化分析代码展示
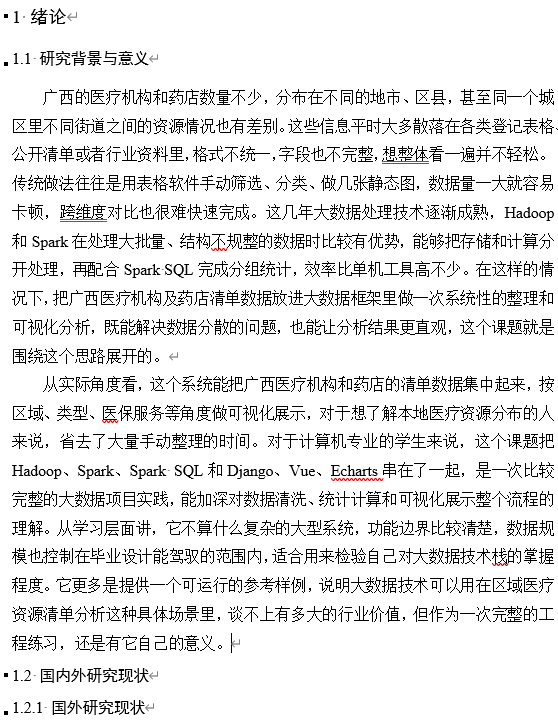
- 基于大数据的广西医疗机构及药店清单可视化分析文档展示
基于大数据的广西医疗机构及药店清单可视化分析介绍
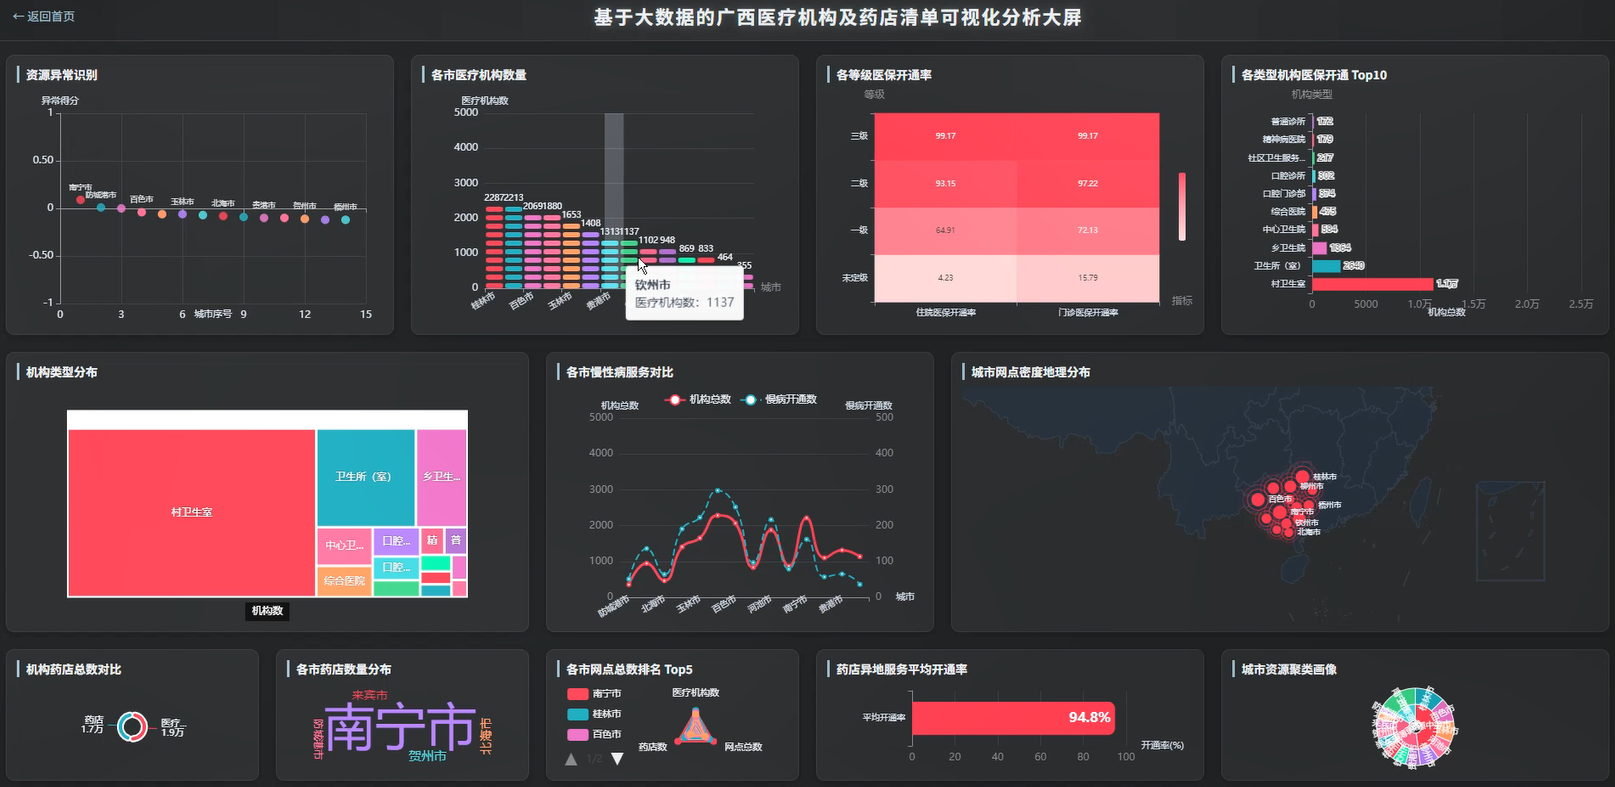
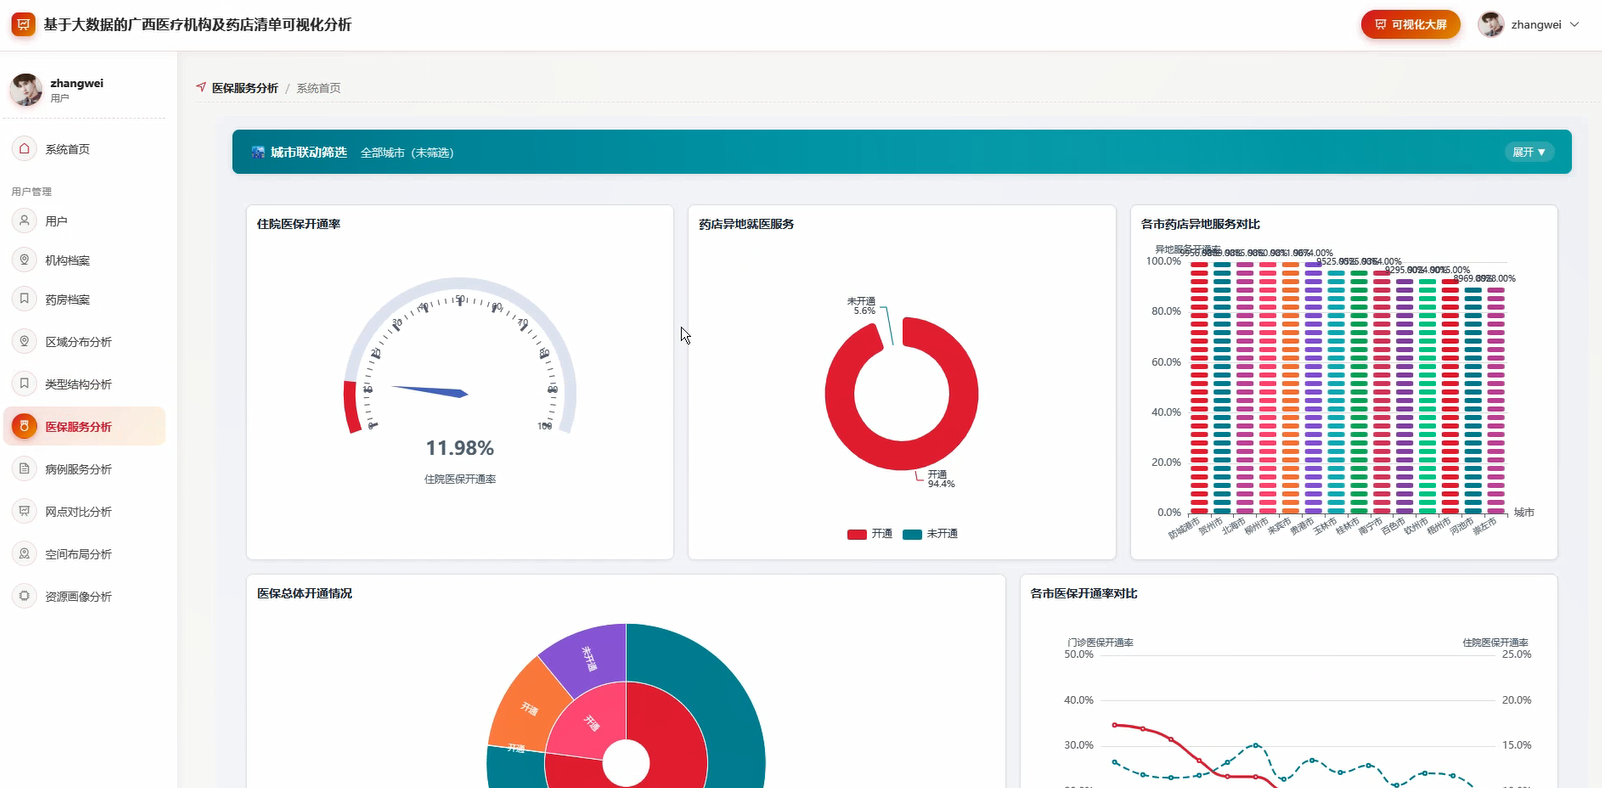
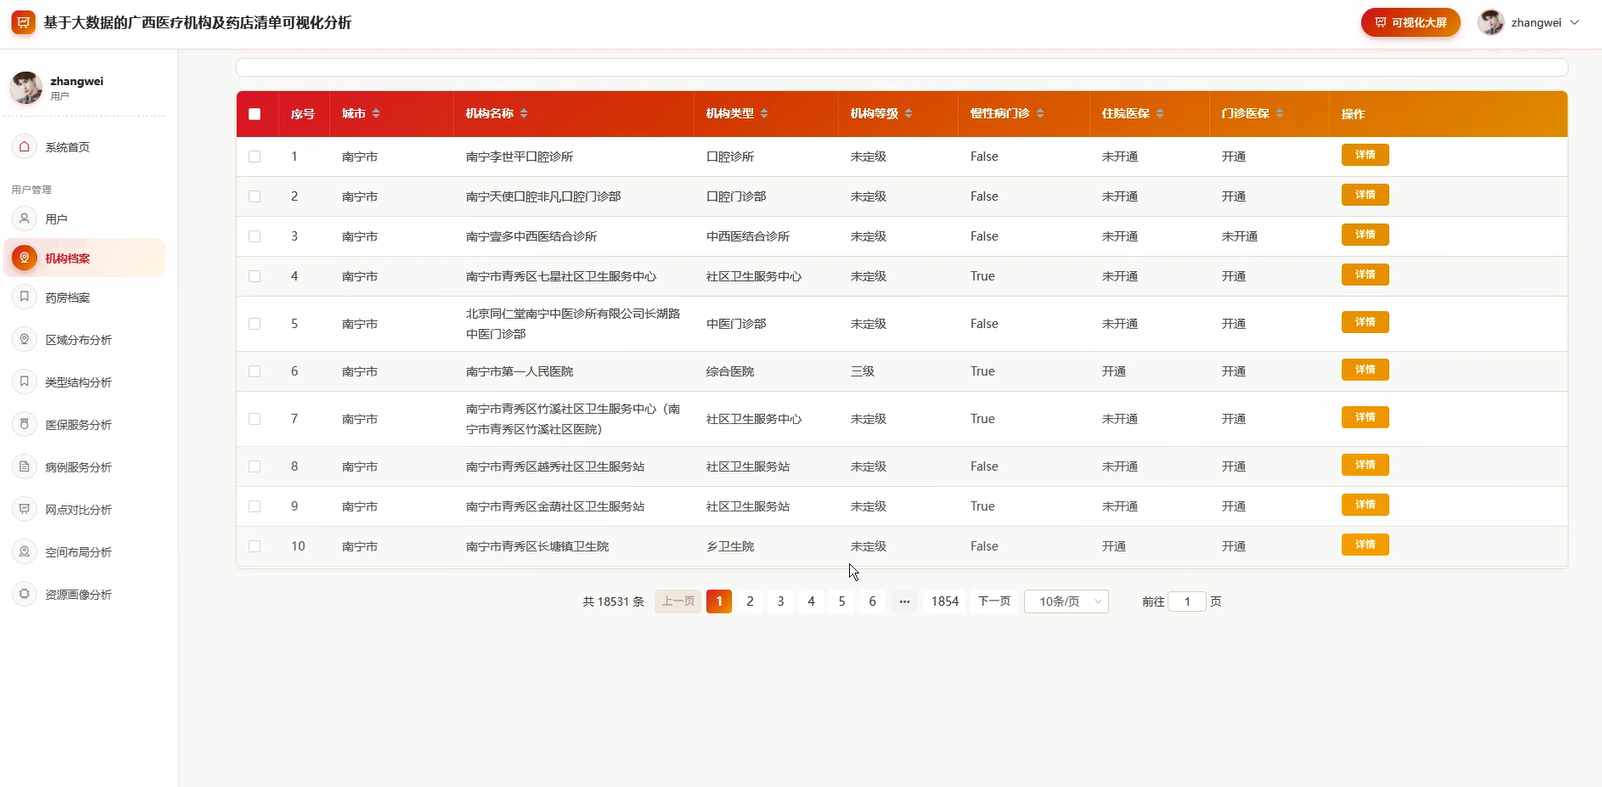
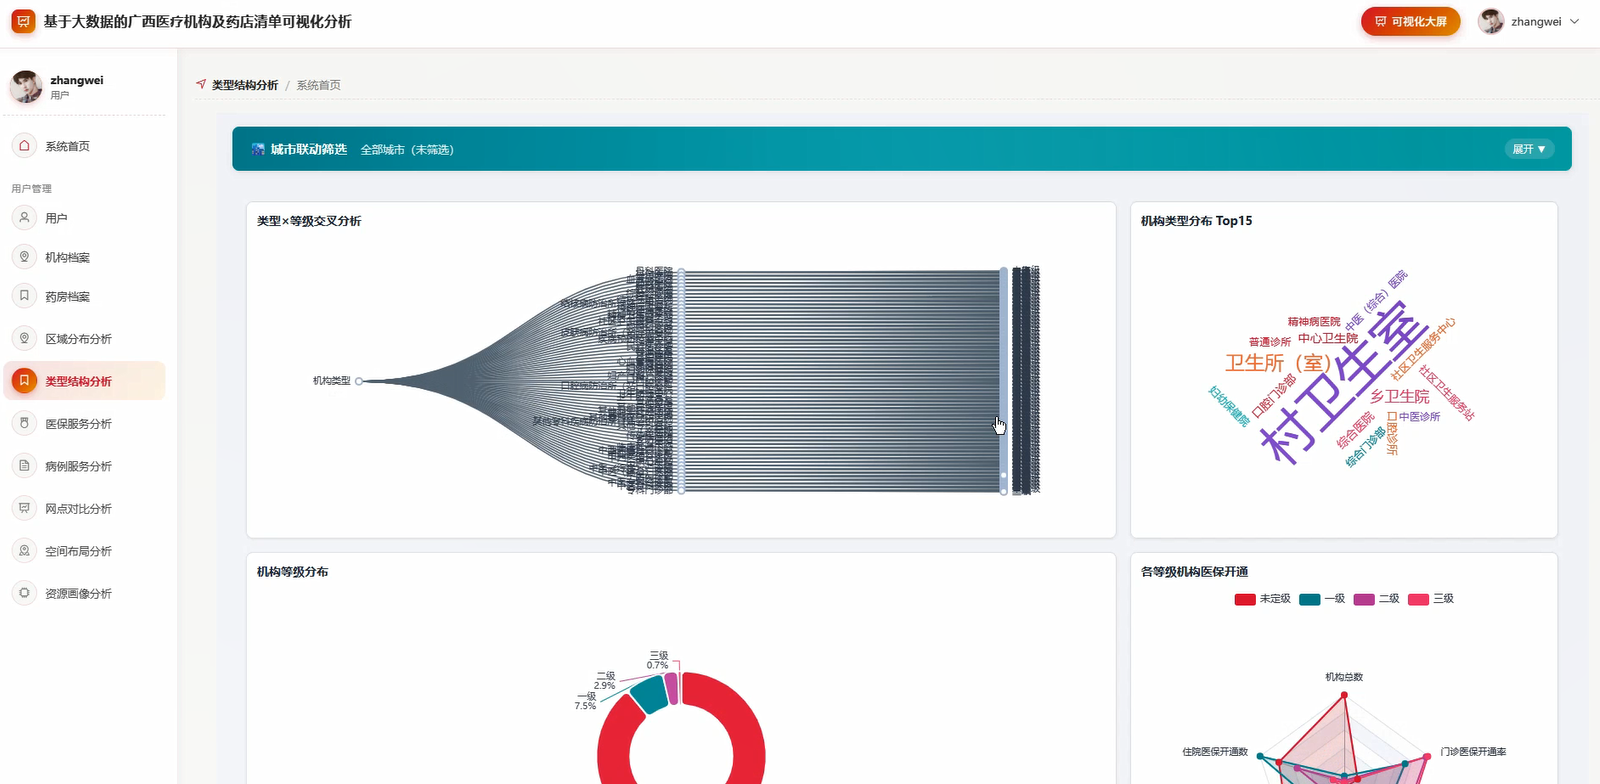
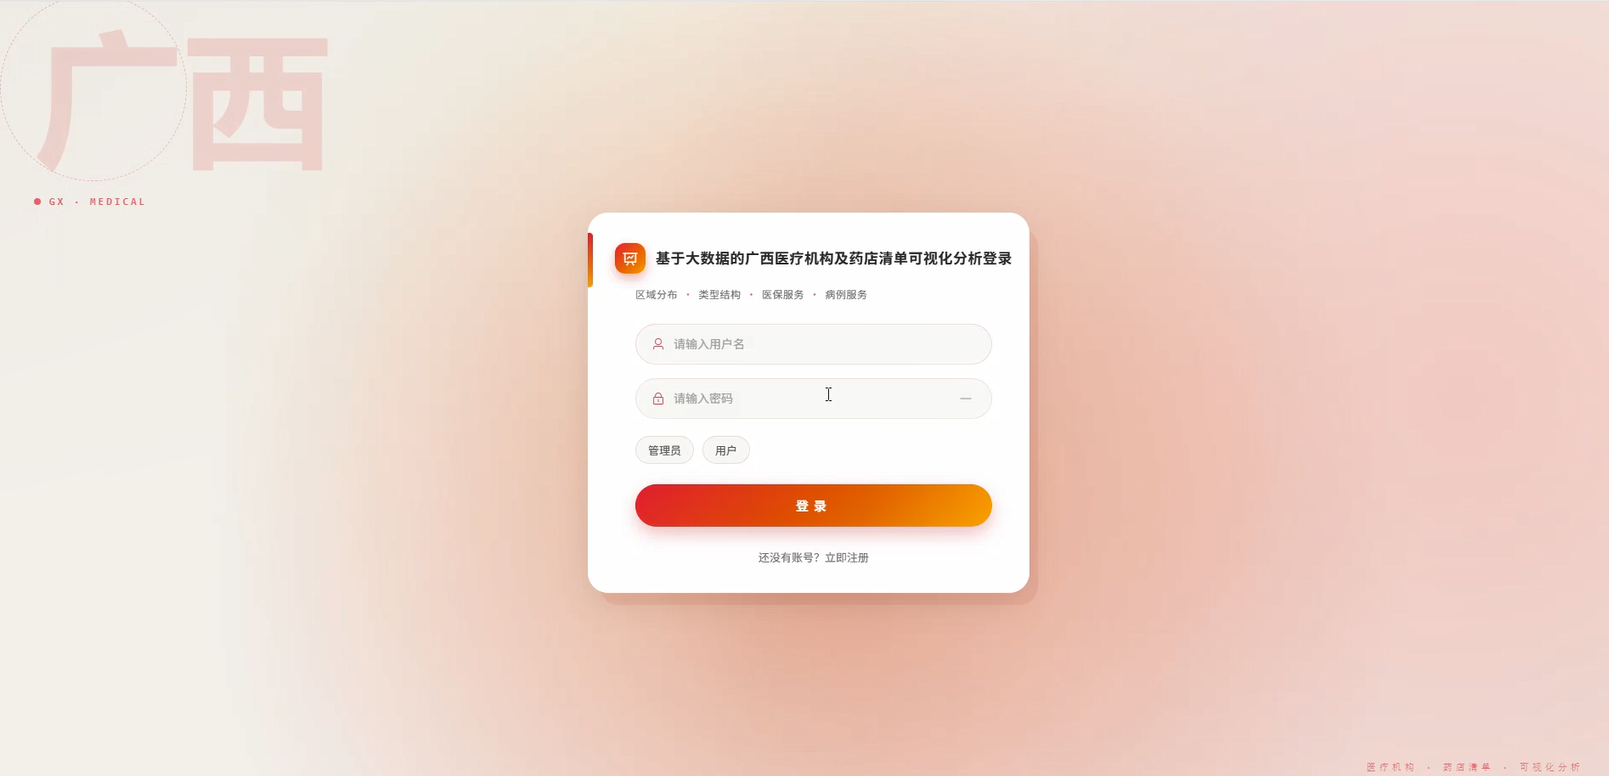
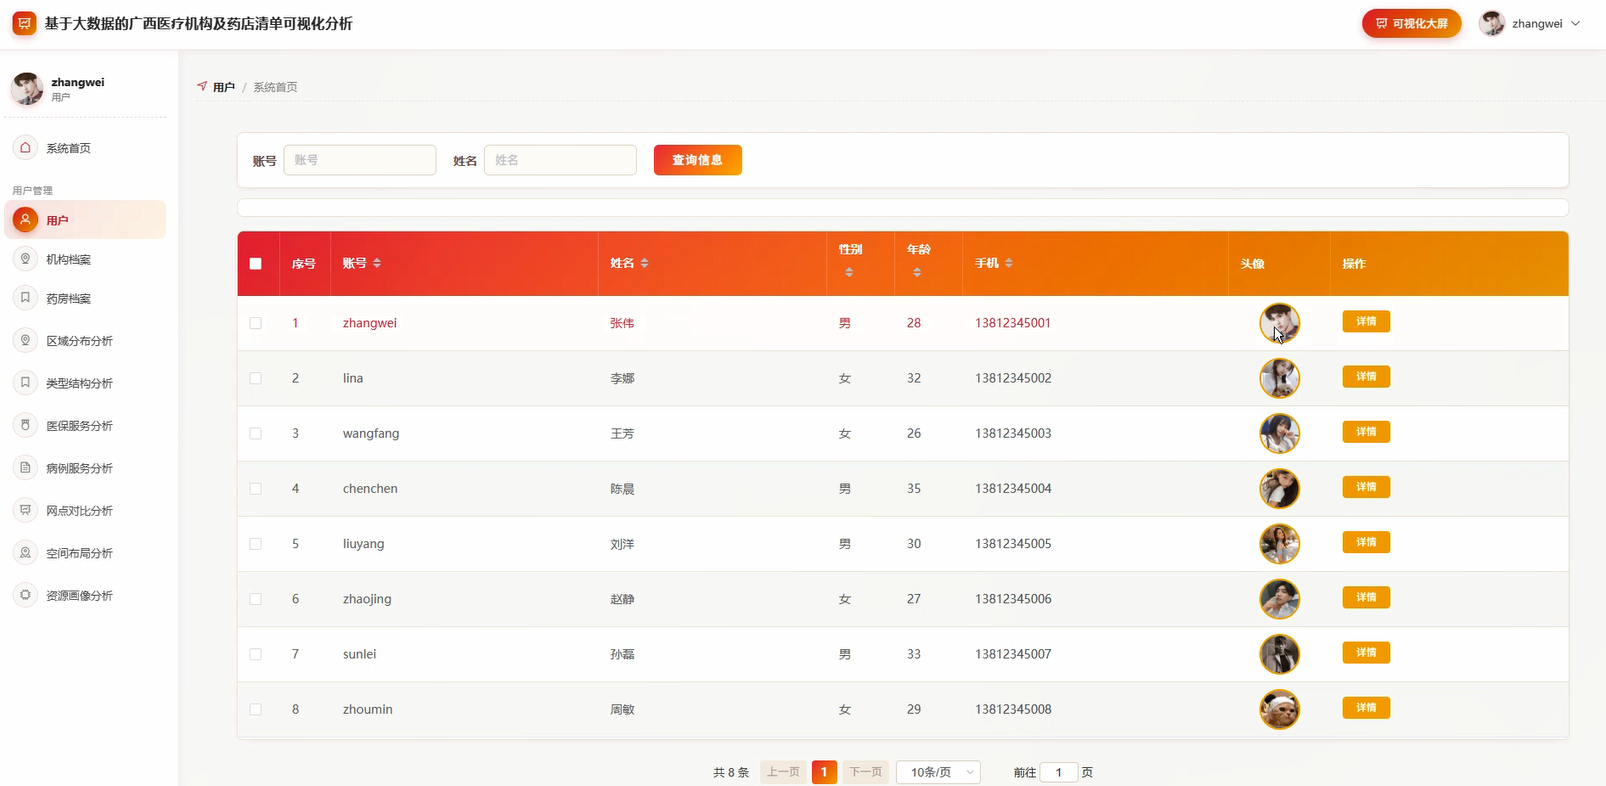
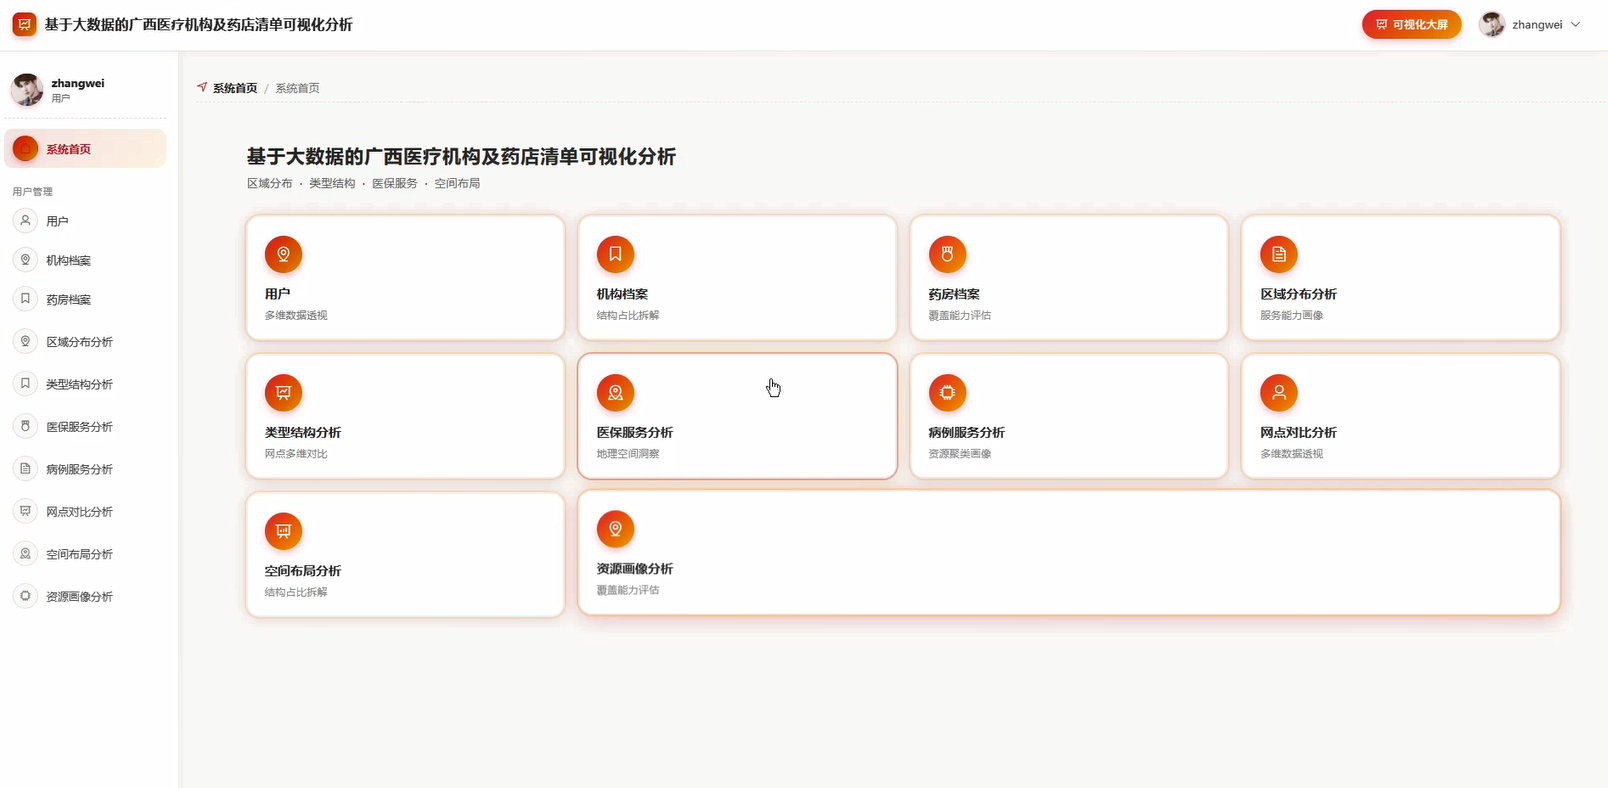
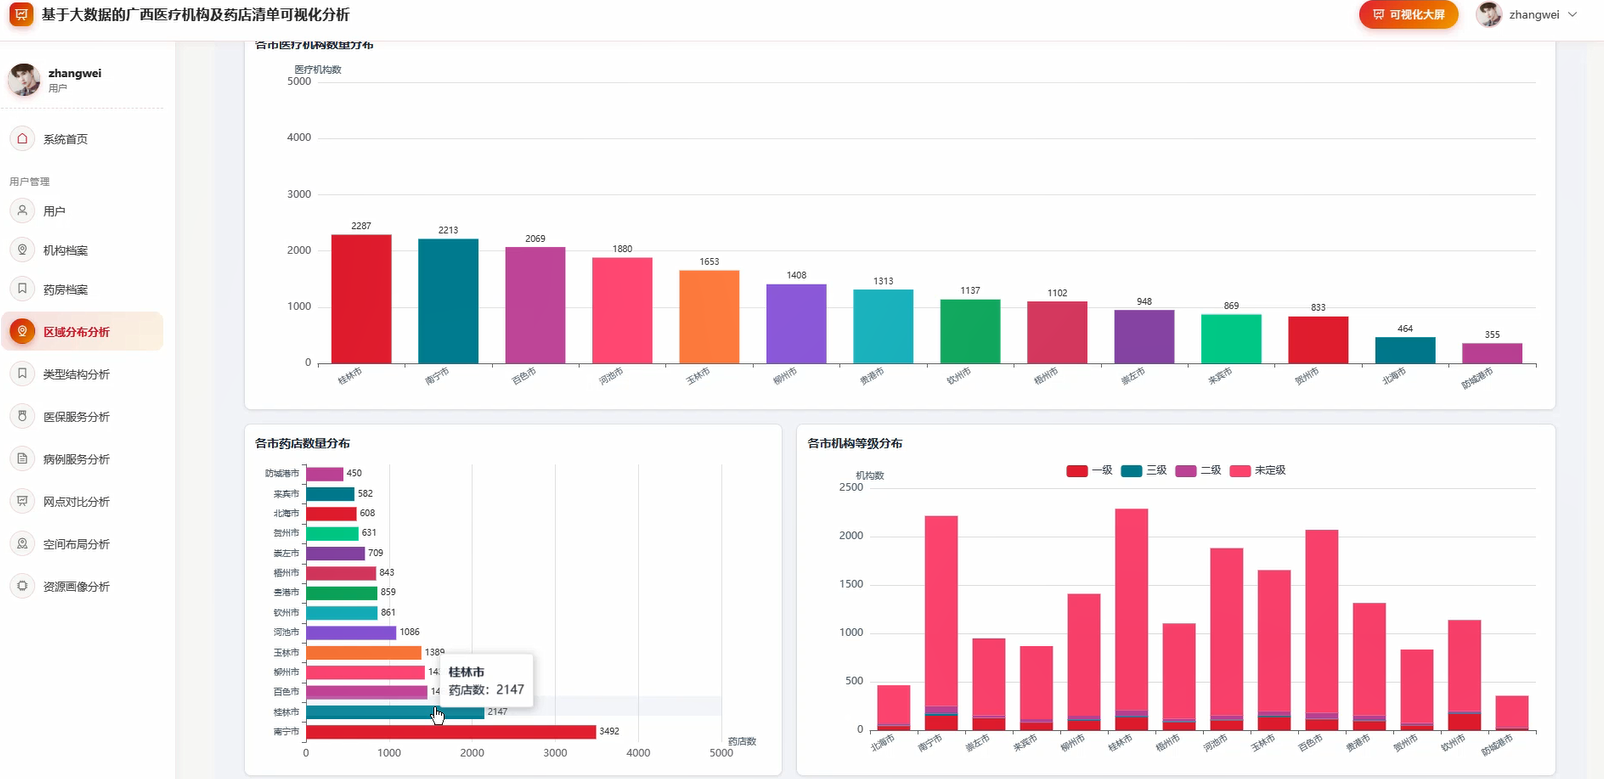
基于大数据的广西医疗机构及药店清单可视化分析系统,是一个面向广西区域医疗资源数据整理与分析的可视化平台。系统以Hadoop+Spark作为大数据处理的核心框架,采用HDFS完成原始数据的分布式存储,借助Spark SQL与Pandas、NumPy对广西医疗机构和药店的清单数据进行清洗、聚合与统计计算。后端基于Django构建数据服务接口,前端通过Vue结合ElementUI、Echarts实现图表渲染与交互展示。系统功能覆盖用户管理、机构档案、药房档案、区域分布分析、类型结构分析、医保服务分析、病例服务分析、网点对比分析、空间布局分析以及资源画像分析等模块,能够把原本零散、格式不一的机构与药店清单,转化为可按区域、类型、医保服务能力等维度查看的可视化结果,帮助使用者直观了解广西医疗机构和药店的整体分布与结构特征。
基于大数据的广西医疗机构及药店清单可视化分析演示视频
基于大数据的广西医疗机构及药店清单可视化分析演示图片
基于大数据的广西医疗机构及药店清单可视化分析代码展示
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, desc, when
from django.http import JsonResponse
from django.views.decorators.http import require_GET
from .models import MedicalInstitution, Pharmacy, Region
spark = SparkSession.builder.appName("GuangxiMedicalAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
@require_GET
def region_distribution_analysis(request):
    institution_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/medical_db").option("dbtable", "medical_institution").option("user", "root").option("password", "123456").load()
    pharmacy_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/medical_db").option("dbtable", "pharmacy").option("user", "root").option("password", "123456").load()
    institution_df.createOrReplaceTempView("institution_table")
    pharmacy_df.createOrReplaceTempView("pharmacy_table")
    region_sql = """
        SELECT region_name, COUNT(*) AS institution_count
        FROM institution_table
        GROUP BY region_name
        ORDER BY institution_count DESC
    """
    region_result = spark.sql(region_sql)
    pharmacy_sql = """
        SELECT region_name, COUNT(*) AS pharmacy_count
        FROM pharmacy_table
        GROUP BY region_name
        ORDER BY pharmacy_count DESC
    """
    pharmacy_result = spark.sql(pharmacy_sql)
    merged_df = region_result.join(pharmacy_result, on="region_name", how="outer").fillna(0)
    merged_df = merged_df.withColumn("total_count", col("institution_count") + col("pharmacy_count"))
    merged_df = merged_df.orderBy(desc("total_count"))
    result_list = merged_df.collect()
    data = []
    for row in result_list:
        data.append({"region_name": row["region_name"], "institution_count": row["institution_count"], "pharmacy_count": row["pharmacy_count"], "total_count": row["total_count"]})
    return JsonResponse({"code": 200, "msg": "区域分布分析完成", "data": data})
@require_GET
def type_structure_analysis(request):
    institution_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/medical_db").option("dbtable", "medical_institution").option("user", "root").option("password", "123456").load()
    institution_df.createOrReplaceTempView("type_table")
    type_sql = """
        SELECT institution_type, COUNT(*) AS type_count
        FROM type_table
        GROUP BY institution_type
        ORDER BY type_count DESC
    """
    type_result = spark.sql(type_sql)
    total_count = type_result.agg({"type_count": "sum"}).collect()[0][0]
    type_result = type_result.withColumn("ratio", when(col("type_count") > 0, col("type_count") / total_count * 100).otherwise(0))
    type_result = type_result.orderBy(desc("type_count"))
    result_list = type_result.collect()
    data = []
    for row in result_list:
        data.append({"institution_type": row["institution_type"], "type_count": row["type_count"], "ratio": round(row["ratio"], 2)})
    return JsonResponse({"code": 200, "msg": "类型结构分析完成", "data": data})
@require_GET
def insurance_service_analysis(request):
    institution_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/medical_db").option("dbtable", "medical_institution").option("user", "root").option("password", "123456").load()
    institution_df.createOrReplaceTempView("insurance_table")
    insurance_sql = """
        SELECT region_name, insurance_type, COUNT(*) AS service_count
        FROM insurance_table
        WHERE insurance_type IS NOT NULL
        GROUP BY region_name, insurance_type
        ORDER BY region_name, service_count DESC
    """
    insurance_result = spark.sql(insurance_sql)
    pivot_df = insurance_result.groupBy("region_name").pivot("insurance_type").sum("service_count").fillna(0)
    pivot_df = pivot_df.withColumn("total_insurance_service", sum([col(c) for c in pivot_df.columns if c != "region_name"]))
    pivot_df = pivot_df.orderBy(desc("total_insurance_service"))
    result_list = pivot_df.collect()
    data = []
    for row in result_list:
        row_dict = row.asDict()
        data.append(row_dict)
    return JsonResponse({"code": 200, "msg": "医保服务分析完成", "data": data})
基于大数据的广西医疗机构及药店清单可视化分析文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜