✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡有什么问题可以在主页上或文末下联系咨询博客~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
LLM多维度性能评估分析系统-简介
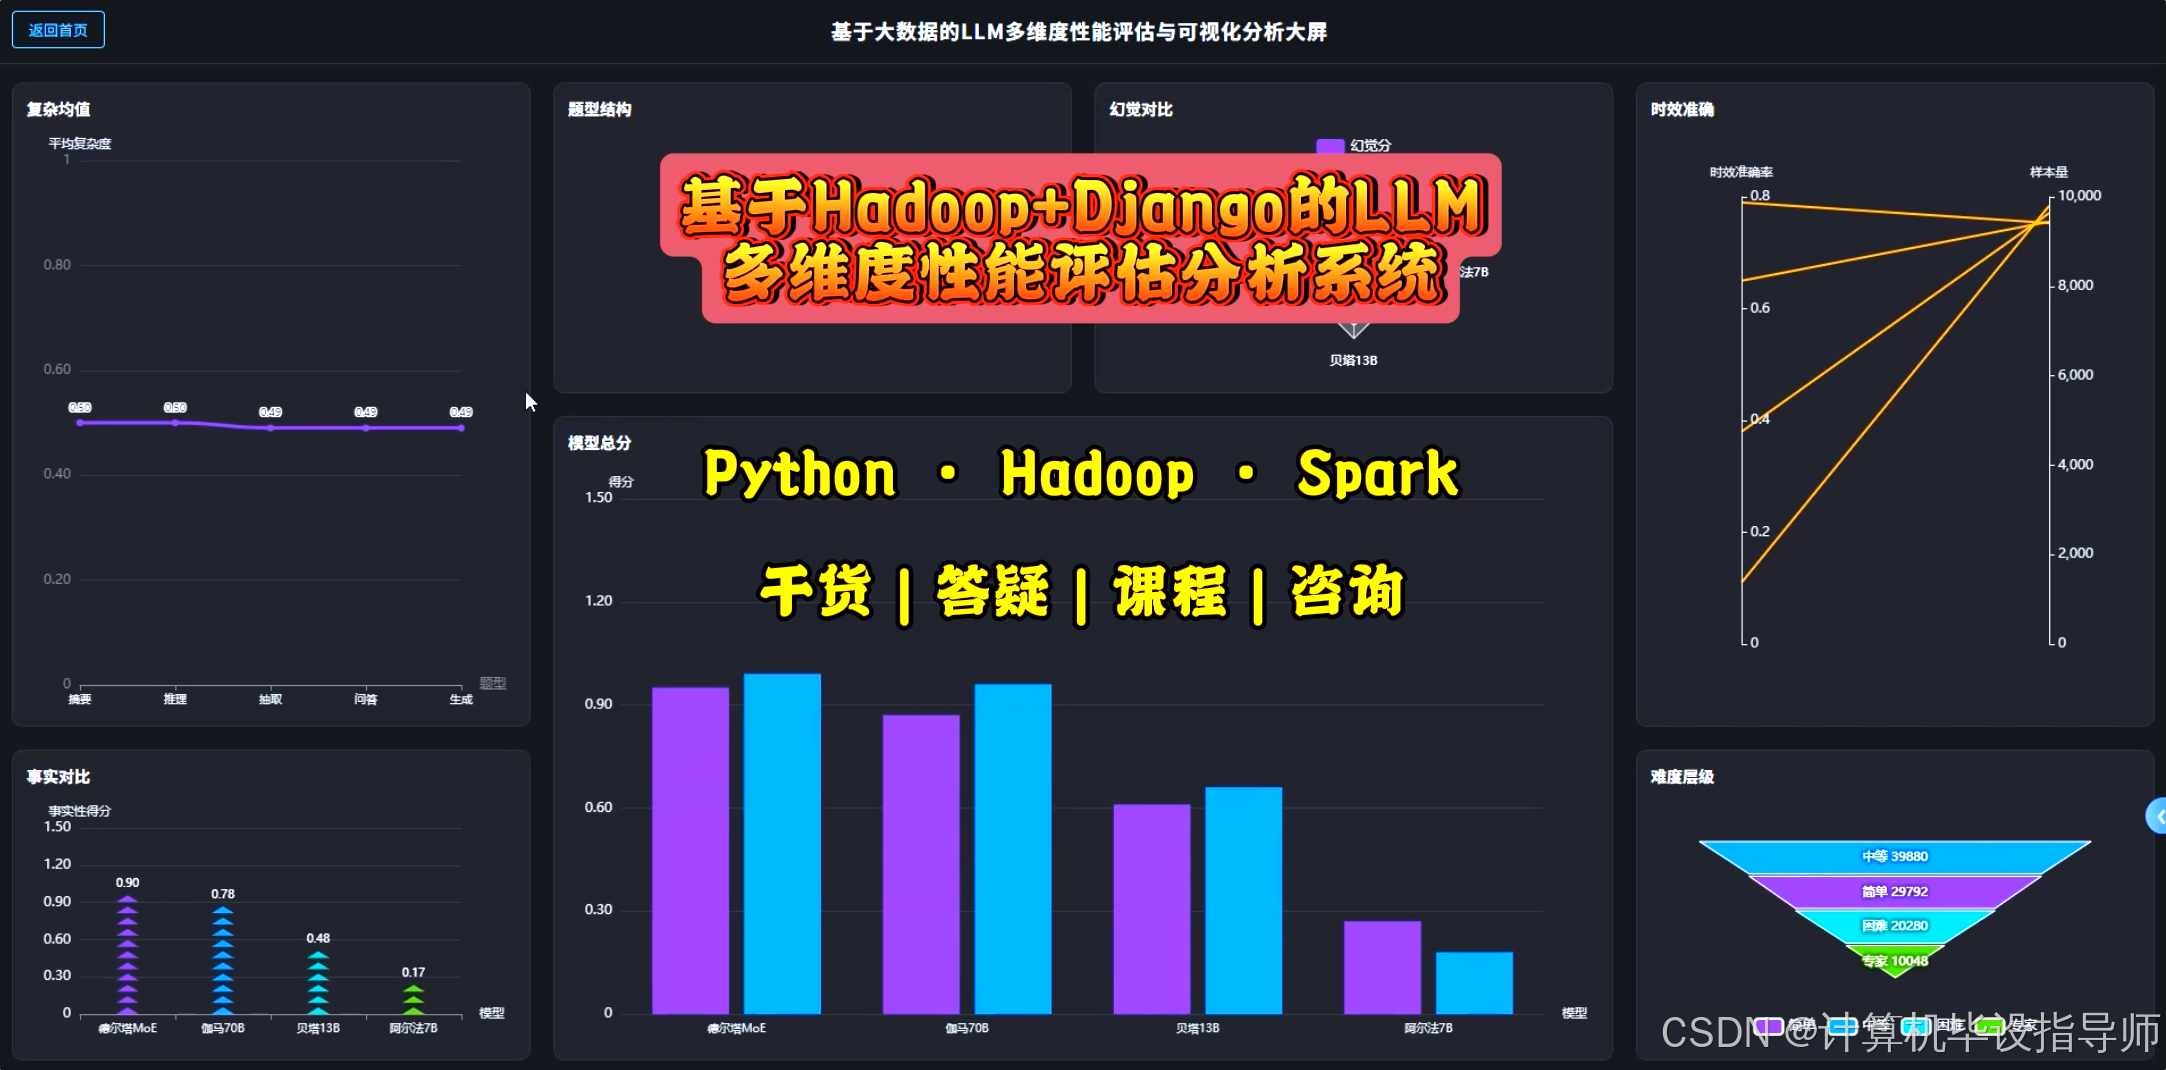
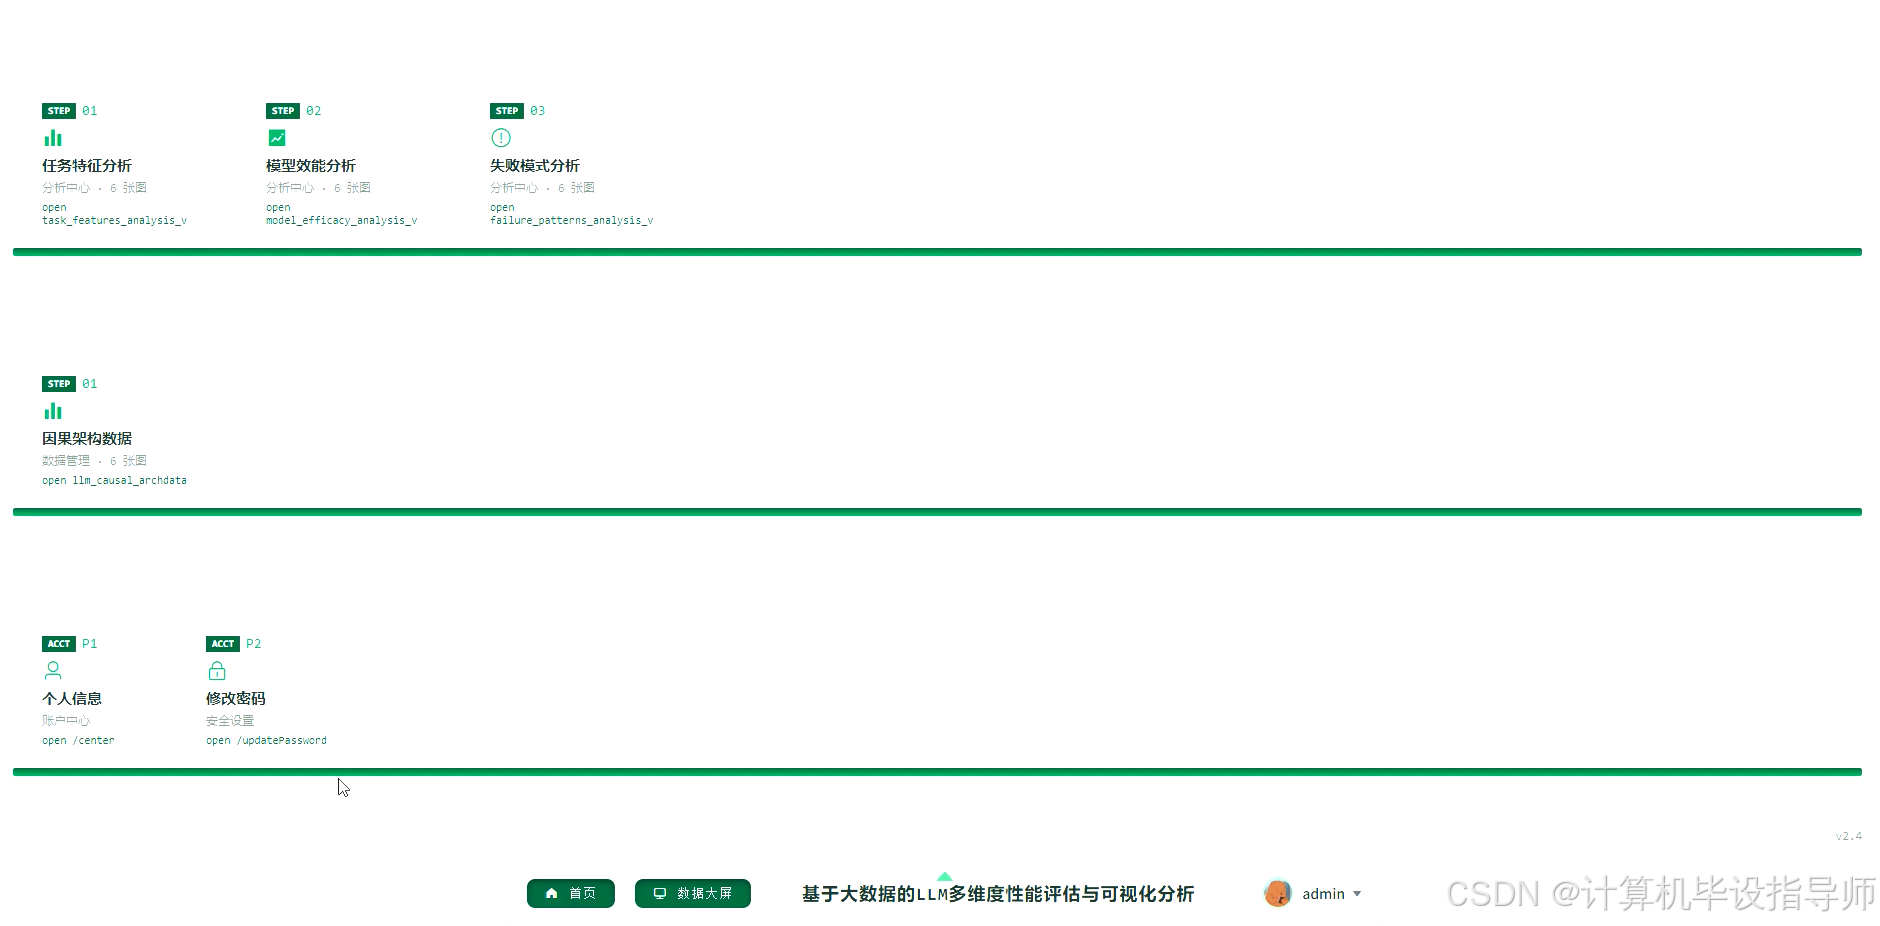
基于Hadoop+Django的LLM多维度性能评估分析系统采用Python语言开发,结合Hadoop与Spark大数据框架处理海量评估数据,后端依托Django框架提供稳定接口服务,前端运用Vue与Echarts实现数据可视化展示。系统核心功能围绕任务特征分析、模型效能评估和失败模式分析三大维度展开。在任务特征分析方面,系统对不同领域的题量分布、题型结构及难度层级进行统计,并计算措辞清晰度与复杂度均值,判断数据覆盖是否存在偏斜。模型效能分析模块对比多款大语言模型的总分、幻觉率、事实性及有用性等关键指标,生成领域与模型的交叉效能热力矩阵。失败模式分析则聚焦各类失败类型的占比与模型间的失败交叉对比,针对计算准确率与时效准确率进行专项过滤统计,同时引入K-Means算法对性能指标进行无监督分群,发现性能画像簇,并利用FP-Growth算法挖掘领域、题型、难度与失败类型的频繁项集,定位高风险任务组合。整套系统通过大数据技术栈实现对LLM多维度表现的科学量化,为大模型优化提供直观的数据支撑。
LLM多维度性能评估分析系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
LLM多维度性能评估分析系统-背景
这两年大语言模型发展挺快的,各种AI工具层出不穷。大家平时用这些大模型的时候,经常会发现有的模型写代码厉害,有的模型算数学题容易翻车,还有的模型动不动就胡说八道产生幻觉。对于搞科研或者开发的人来说,光靠主观感觉去判断哪个模型好用肯定不行,还是得有一套量化的评估标准。哪怕只是做一个小范围的测试,积累下来的评估数据量也不小,靠普通的单机脚本去跑分析肯定会卡顿。这就需要一个能处理较大数据量的大数据平台来帮忙算这些指标。本课题就是想搭一个基于Hadoop+Spark的评估分析平台,把这些大模型的测试数据收集起来,从多个维度去算算它们的表现到底怎么样,也算是顺应现在AI技术发展做的一点点尝试。
做这个课题的实际意义其实就是给大模型的评估提供一个能落地的工具。平时咱们想对比几个模型的好坏,多是看看网上的跑分榜单,但那些榜单不一定符合自己的实际业务需求。通过这个系统,我们可以自己导入特定领域的测试题和模型回答,算出幻觉分数、事实性得分这些具体的指标,然后直接在网页上看到柱状图或者热力图。用Hadoop和Spark来跑数据,主要是能保证以后数据量变大了系统也不会崩。另外,系统里用K-Means把模型表现分个群,再用FP-Growth找找哪些类型的题目最容易让模型出错,这些分析结果能帮我们避开大模型的一些短板,选对应用场景。整体来说,这个毕设系统没有解决什么世界难题,但作为一个本地的辅助分析工具,实用性还是过得去的,能给后面研究大模型的同学留点参考。
LLM多维度性能评估分析系统-视频展示
基于Hadoop+Django的LLM多维度性能评估分析系统
LLM多维度性能评估分析系统-图片展示
LLM多维度性能评估分析系统-代码展示
python
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("LlmPerfEvalSystemAnalysis").config("spark.sql.shuffle.partitions", "4").enableHiveSupport().getOrCreate()
def analyze_model_overall_score(spark_df):
    from pyspark.sql.functions import col, avg, count, expr
    import pandas as pd
    filtered_df = spark_df.filter(col("model_type").isNotNull() & col("overall_score").isNotNull())
    grouped_df = filtered_df.groupBy("model_type")
    model_score_stats = grouped_df.agg(avg("overall_score").alias("avg_score"), expr("percentile_approx(overall_score, 0.5)").alias("median_score"), count("*").alias("sample_count"))
    sorted_stats = model_score_stats.orderBy(col("avg_score").desc())
    collected_data = sorted_stats.collect()
    result_list = []
    for row in collected_data:
        result_dict = {"model_type": row["model_type"], "avg_score": round(row["avg_score"], 2), "median_score": round(row["median_score"], 2), "sample_count": row["sample_count"]}
        result_list.append(result_dict)
    pandas_df = pd.DataFrame(result_list)
    pandas_df.to_csv("output/LlmPerfEvalSystem_analysis/model_overall_score.csv", index=False)
    return result_list
def analyze_performance_kmeans_clustering(spark_df):
    from pyspark.sql.functions import col, avg, count, row_number
    from pyspark.sql.window import Window
    from pyspark.ml.feature import VectorAssembler, StandardScaler
    from pyspark.ml.clustering import KMeans
    import pandas as pd
    feature_cols = ["hallucination_score", "factuality_score", "helpfulness_score", "safety_score", "overall_score"]
    assembler = VectorAssembler(inputCols=feature_cols, outputCol="features_raw")
    assembled_df = assembler.transform(spark_df).na.fill(0.0, subset=feature_cols)
    scaler = StandardScaler(inputCol="features_raw", outputCol="features", withMean=True, withStd=True)
    scaler_model = scaler.fit(assembled_df)
    scaled_df = scaler_model.transform(assembled_df)
    kmeans = KMeans(k=4, seed=42, featuresCol="features", predictionCol="cluster_id")
    kmeans_model = kmeans.fit(scaled_df)
    clustered_df = kmeans_model.transform(scaled_df)
    cluster_summary = clustered_df.groupBy("cluster_id", "model_type").agg(count("*").alias("model_count"))
    window = Window.partitionBy("cluster_id").orderBy(col("model_count").desc())
    ranked_summary = cluster_summary.withColumn("rank", row_number().over(window)).filter(col("rank") == 1)
    cluster_agg = clustered_df.groupBy("cluster_id").agg(avg("hallucination_score").alias("avg_hallucination"), avg("overall_score").alias("avg_overall"), count("*").alias("cluster_size"))
    final_df = cluster_agg.join(ranked_summary.select("cluster_id", "model_type"), "cluster_id")
    pandas_cluster = final_df.toPandas()
    pandas_cluster.to_csv("output/LlmPerfEvalSystem_analysis/perf_kmeans_clusters.csv", index=False)
    return pandas_cluster.to_dict(orient='records')
def analyze_failure_fpgrowth(spark_df):
    from pyspark.sql.functions import col
    from pyspark.ml.fpm import FPGrowth
    import pandas as pd
    valid_df = spark_df.filter(col("failure_type").isNotNull() & (col("failure_type") != "") & col("domain").isNotNull() & col("prompt_type").isNotNull() & col("difficulty").isNotNull())
    transactions_rdd = valid_df.rdd.map(lambda row: [str(row.domain), str(row.prompt_type), str(row.difficulty), str(row.failure_type)])
    transactions_df = spark.createDataFrame(transactions_rdd, ["items"])
    fpgrowth = FPGrowth(itemsCol="items", minSupport=0.02, minConfidence=0.3)
    fpgrowth_model = fpgrowth.fit(transactions_df)
    freq_itemsets = fpgrowth_model.freqItemsets
    freq_itemsets_pd = freq_itemsets.toPandas()
    freq_itemsets_pd['items'] = freq_itemsets_pd['items'].apply(lambda x: ','.join(map(str, x)))
    total_count = transactions_df.count()
    freq_itemsets_pd['support'] = freq_itemsets_pd['freq'] / total_count if total_count > 0 else 0
    sorted_itemsets = freq_itemsets_pd.sort_values(by='freq', ascending=False)
    sorted_itemsets.to_csv("output/LlmPerfEvalSystem_analysis/failure_fpgrowth.csv", index=False)
    return sorted_itemsets.to_dict(orient='records')
LLM多维度性能评估分析系统-结语
如果你觉得内容不错,欢迎一键三连(点赞、收藏、关注)支持一下!也欢迎在评论区或在博客主页上私信联系留下你的想法或提出宝贵意见,期待与大家交流探讨!谢谢!
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得一键三连,再点个关注,学习不迷路!~~