💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
目录
- 基于大数据的无人机自主导航数据分析与可视化介绍
- 基于大数据的无人机自主导航数据分析与可视化演示视频
- 基于大数据的无人机自主导航数据分析与可视化演示图片
- 基于大数据的无人机自主导航数据分析与可视化代码展示
- 基于大数据的无人机自主导航数据分析与可视化文档展示
基于大数据的无人机自主导航数据分析与可视化介绍
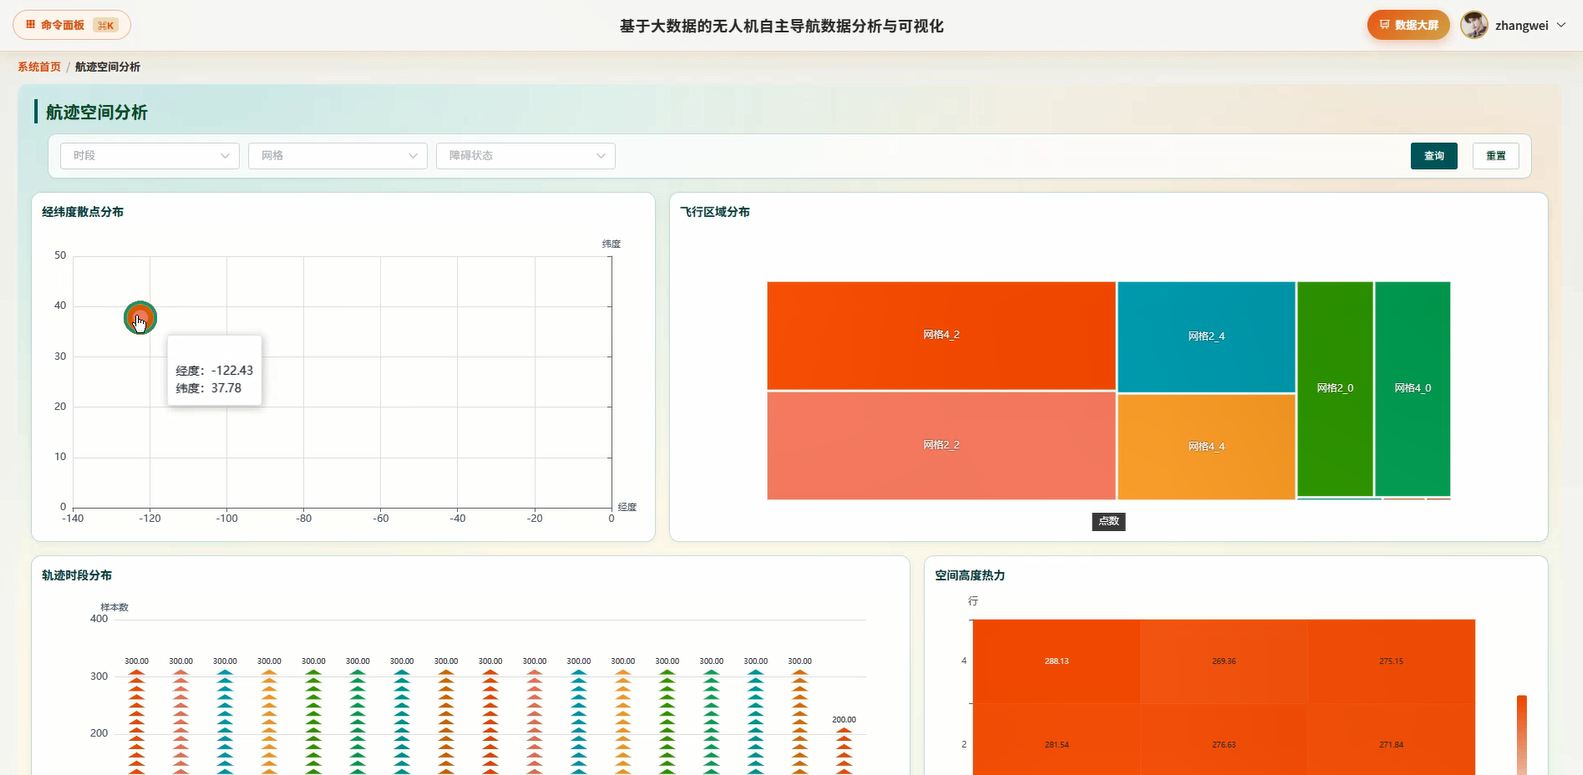
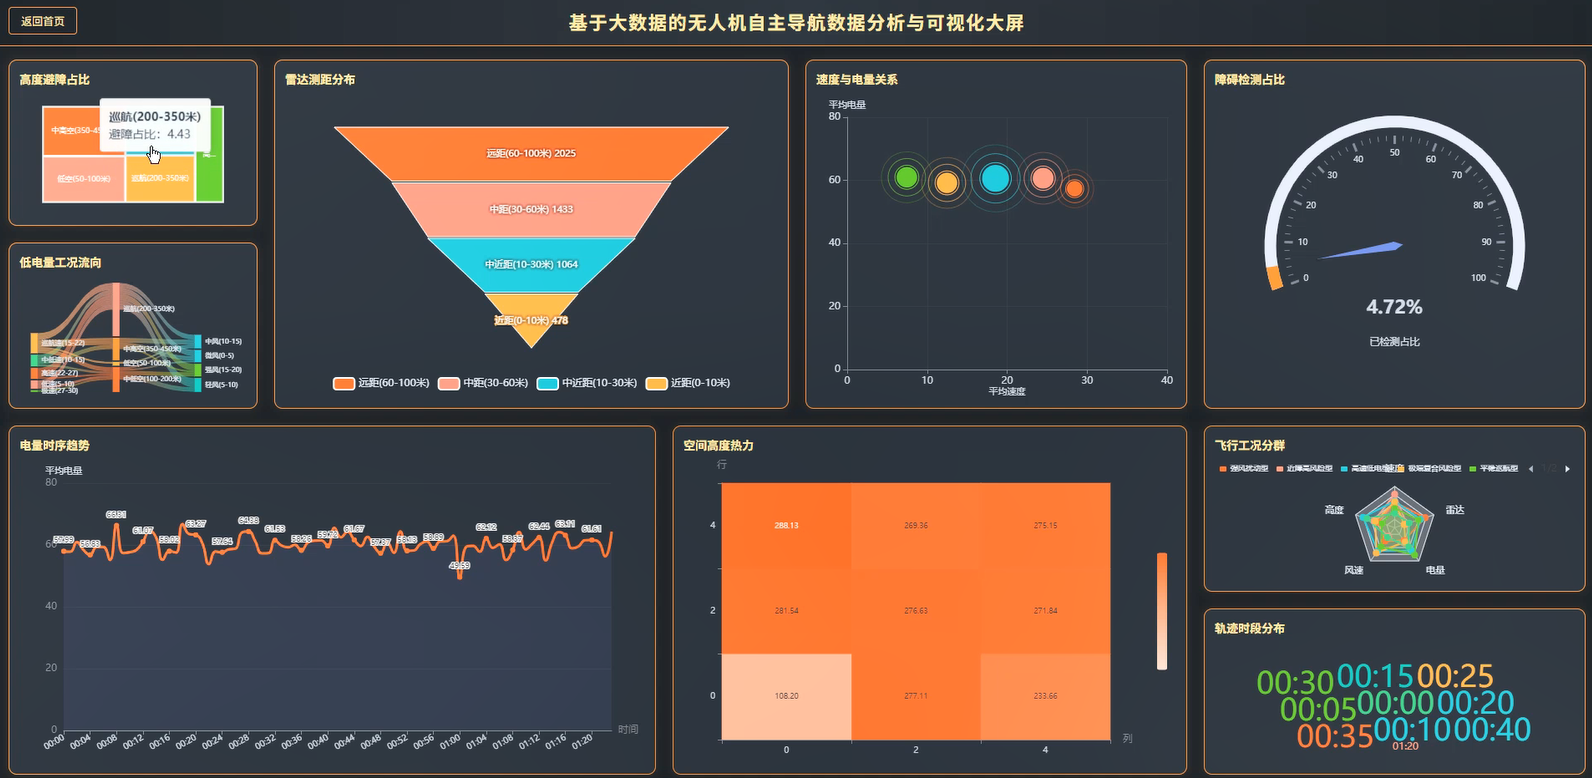
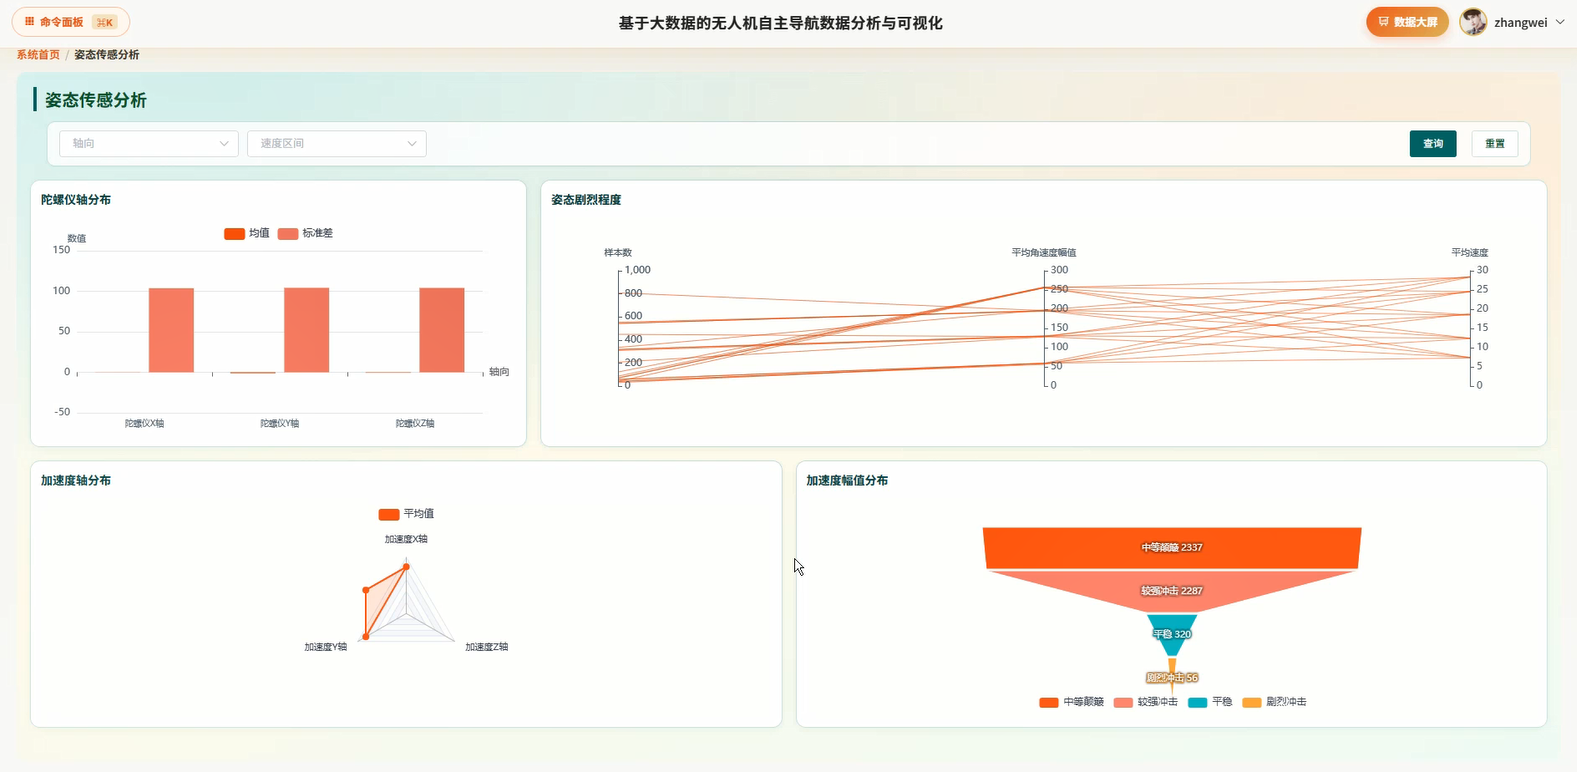
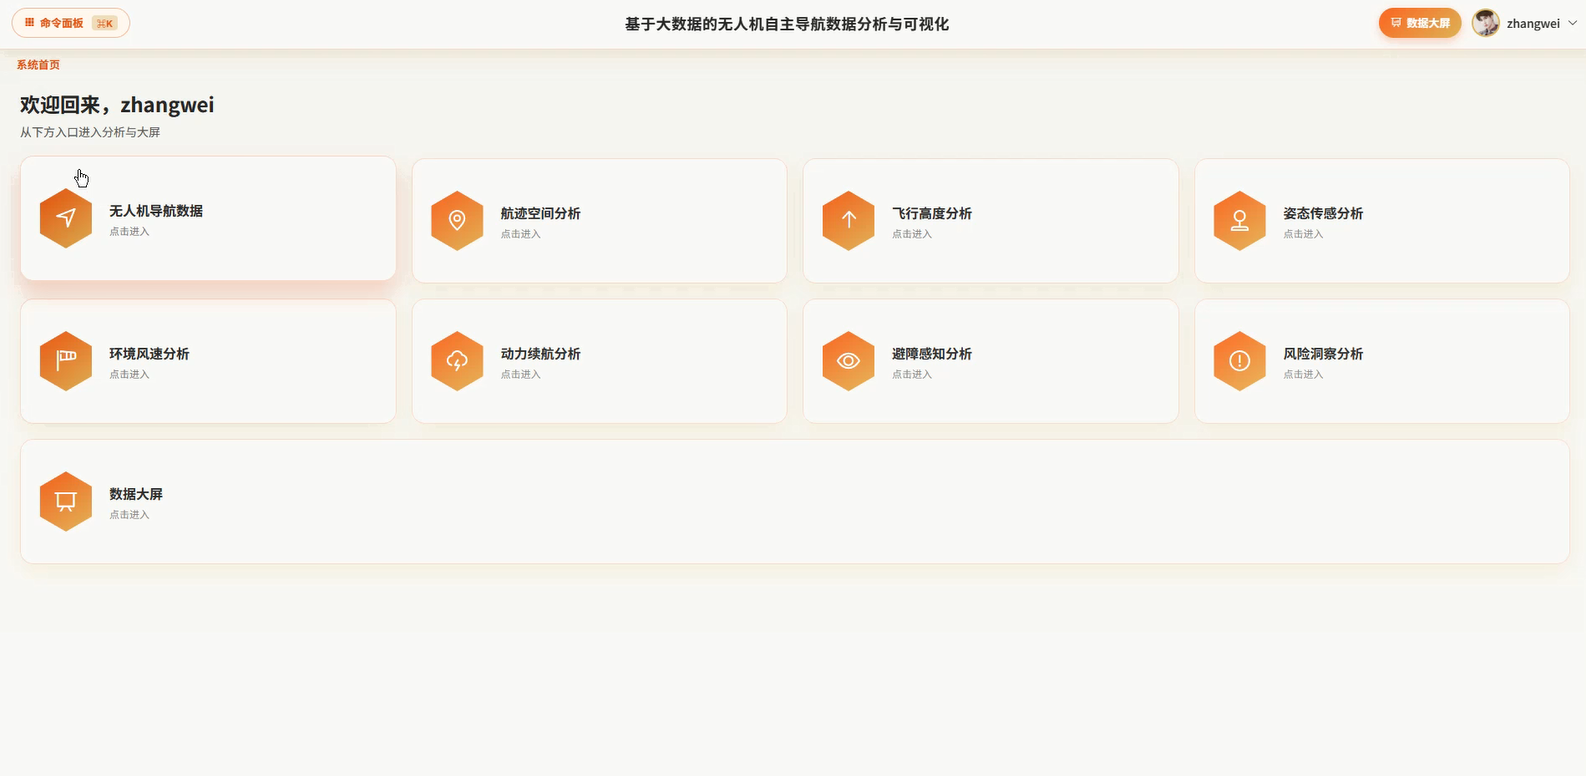
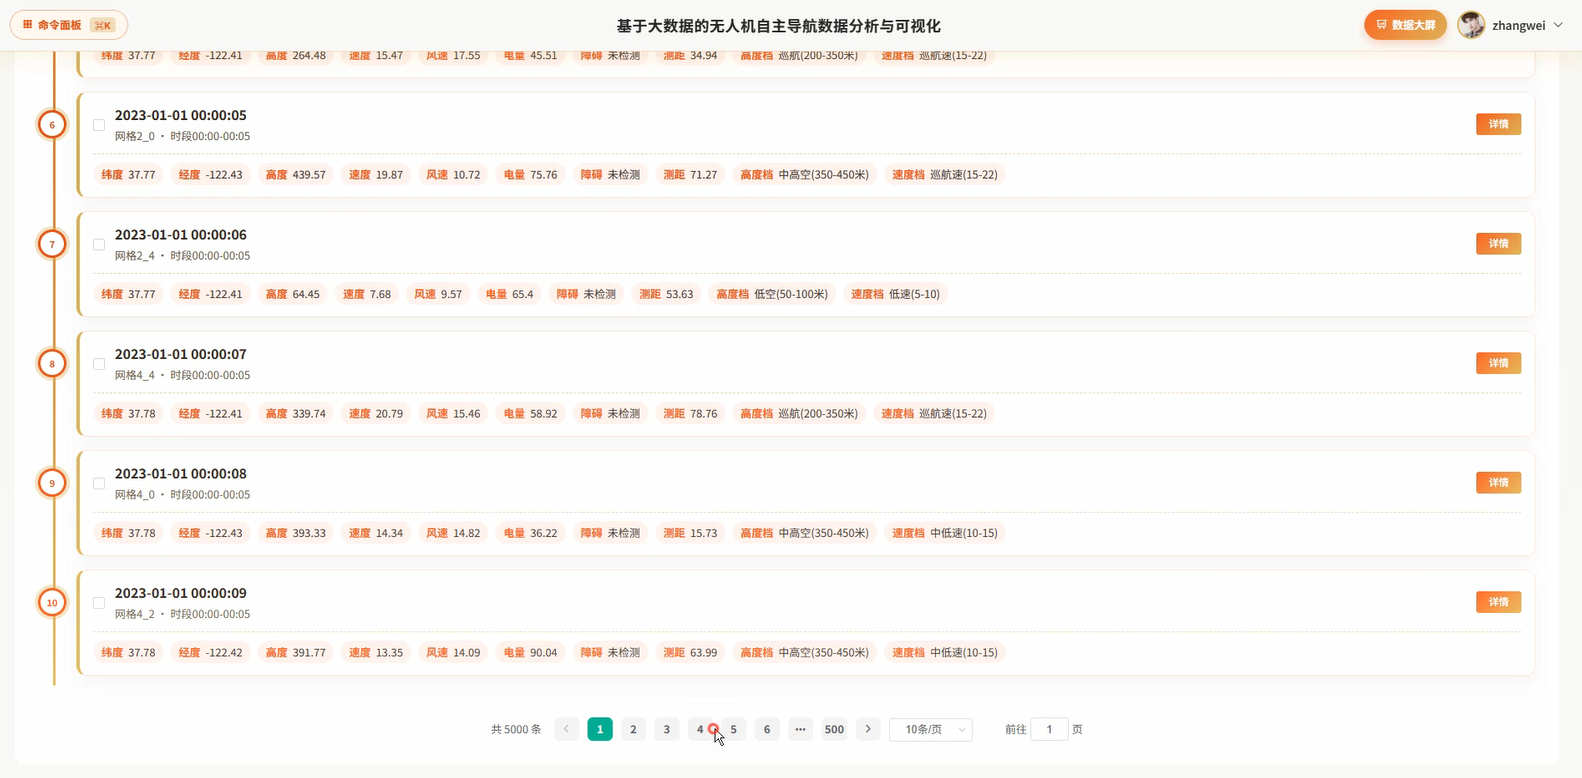
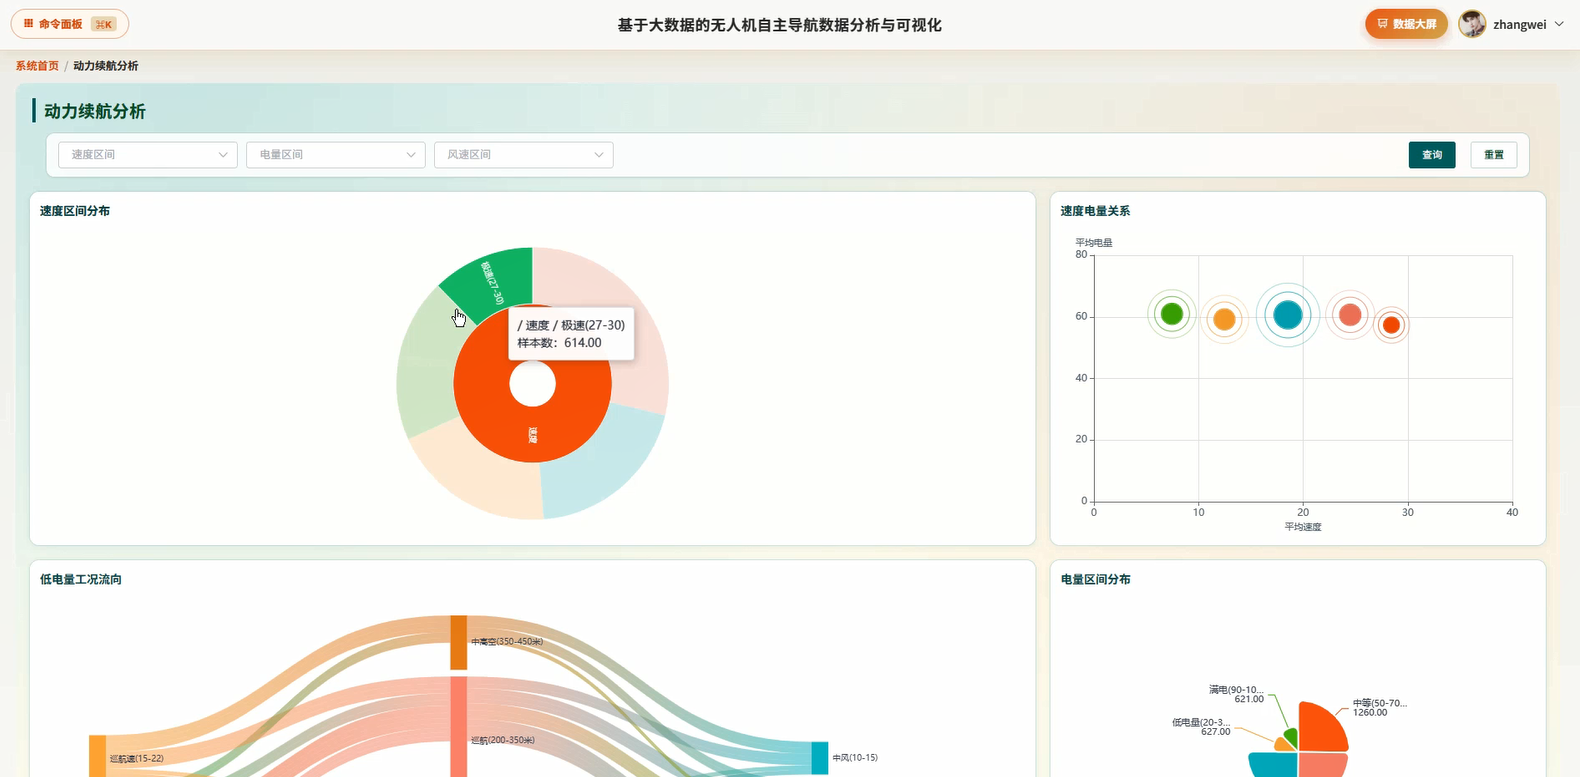
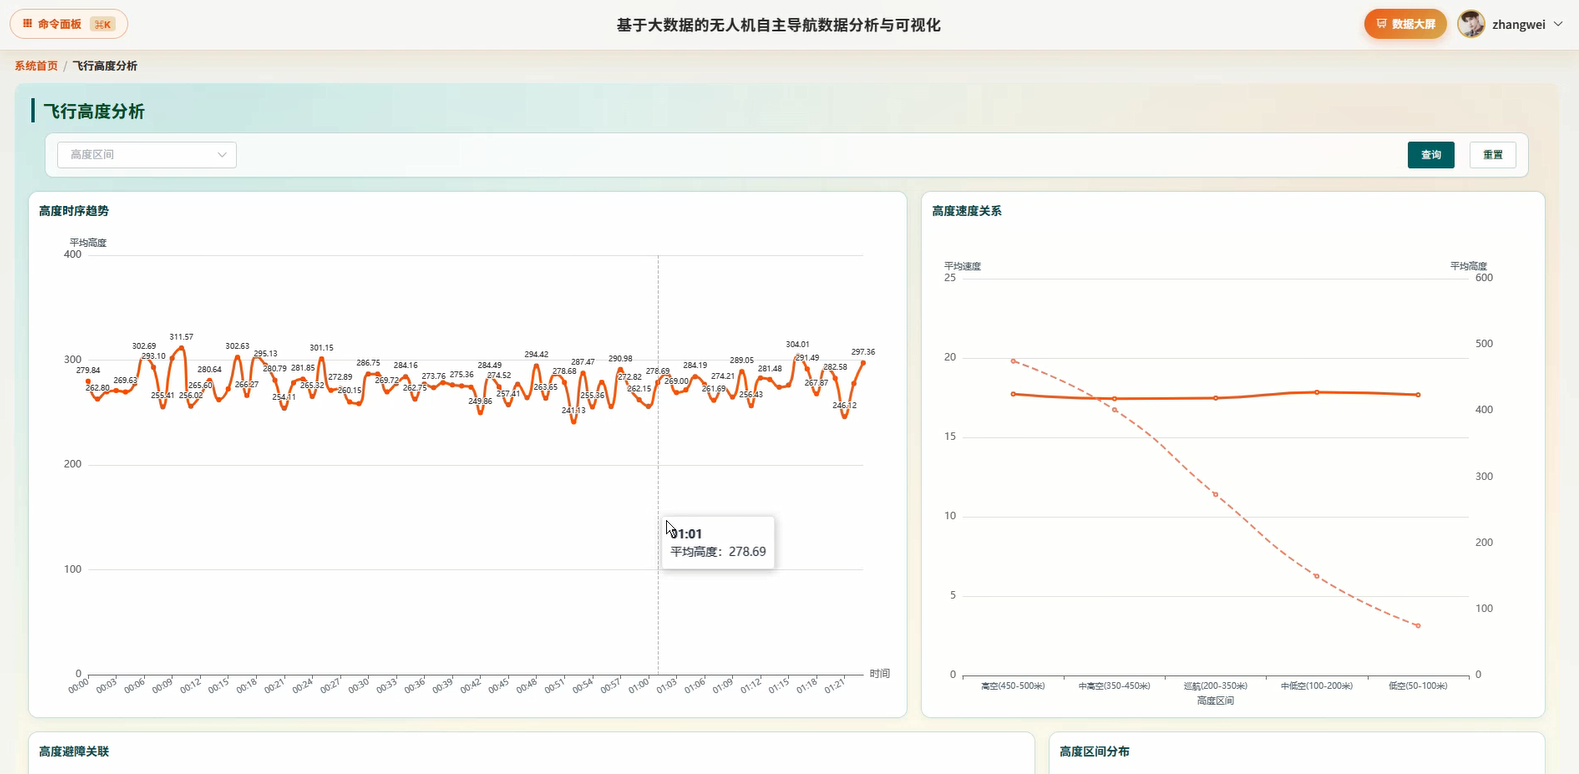
本系统名为《基于大数据的无人机自主导航数据分析与可视化》,是一套面向无人机飞行过程中产生的多源导航数据进行统一采集、清洗、存储、分析与展示的大数据应用系统。系统以Hadoop作为底层分布式存储与计算基础,通过HDFS完成无人机导航原始数据的可靠存放,借助Spark与Spark SQL对风速、航迹、动力续航、飞行高度、避障感知、姿态传感以及风险洞察等多个维度的数据进行批量处理与指标计算,并利用Pandas与NumPy完成数据预处理与数值运算,最终将分析结果写入MySQL供后端调用。后端提供Python与Java两个版本,分别采用Django与Spring Boot框架实现业务接口,前端基于Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery构建交互页面与可视化图表,并通过数据大屏对无人机自主导航的整体运行态势进行集中呈现,帮助使用者从环境风速、航迹空间、动力续航、飞行高度、避障感知、姿态传感和风险洞察等方面直观了解无人机导航状态,为后续研究与应用提供数据支撑。
基于大数据的无人机自主导航数据分析与可视化演示视频
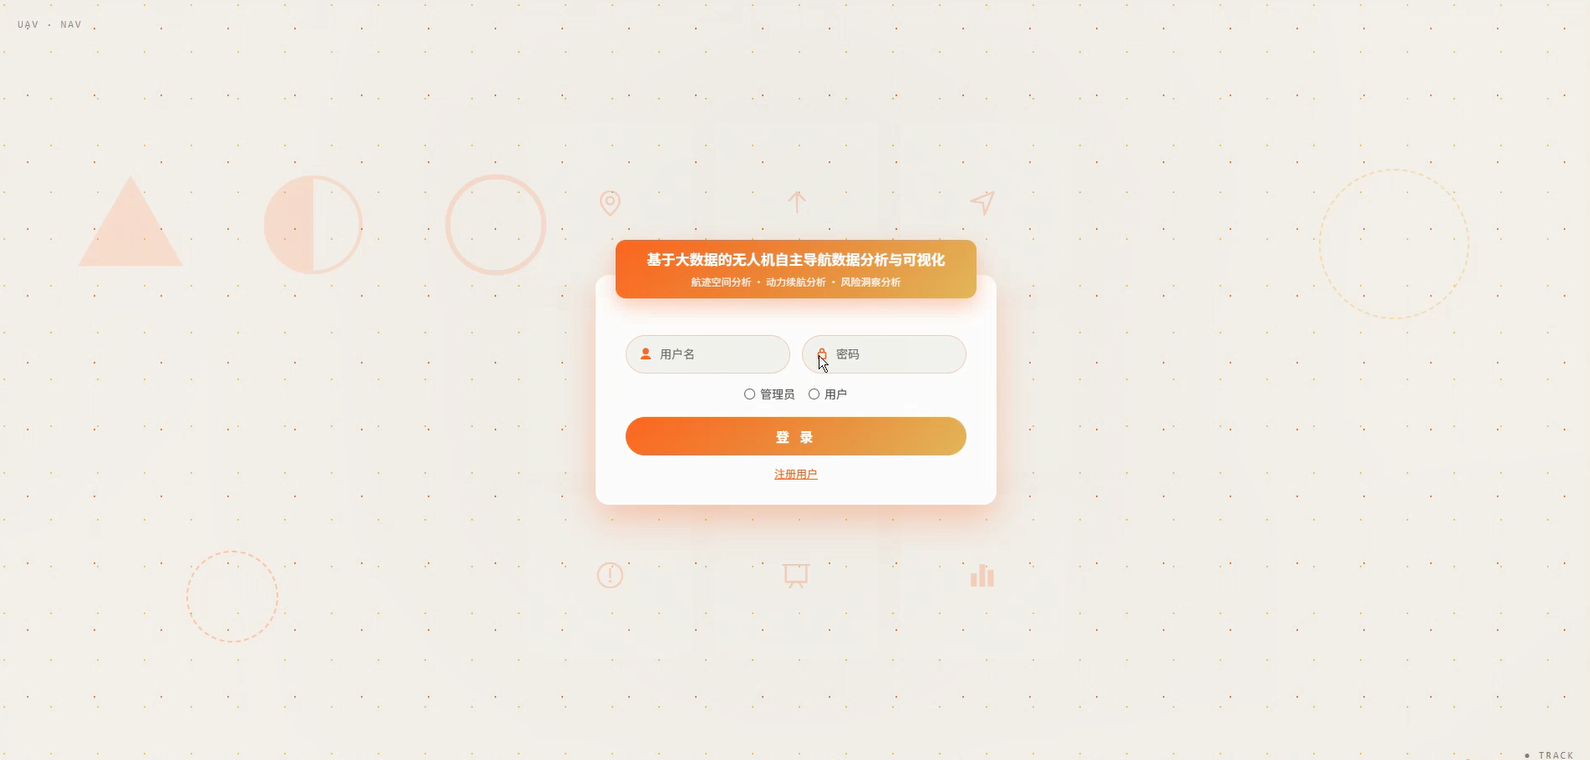
基于大数据的无人机自主导航数据分析与可视化演示图片
基于大数据的无人机自主导航数据分析与可视化代码展示
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, avg, max, min, count, when, round as spark_round
import pandas as pd
import numpy as np
spark = SparkSession.builder.appName("UAVNavigationAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").enableHiveSupport().getOrCreate()
def analyze_flight_height(spark, hdfs_path):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df_clean = df.filter(col("height").isNotNull()).filter(col("height") >= 0).filter(col("height") <= 5000)
    df_height = df_clean.groupBy("flight_id").agg(avg("height").alias("avg_height"), max("height").alias("max_height"), min("height").alias("min_height"), count("height").alias("height_points"))
    df_height = df_height.withColumn("height_range", col("max_height") - col("min_height"))
    df_height = df_height.withColumn("height_level", when(col("avg_height") < 100, "低空").when(col("avg_height") < 500, "中空").otherwise("高空"))
    df_height = df_height.withColumn("avg_height", spark_round(col("avg_height"), 2))
    df_height = df_height.withColumn("height_range", spark_round(col("height_range"), 2))
    df_height.createOrReplaceTempView("height_analysis")
    result = spark.sql("SELECT flight_id, avg_height, max_height, min_height, height_range, height_level, height_points FROM height_analysis ORDER BY avg_height DESC")
    result.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/uav_nav").option("dbtable", "flight_height_analysis").option("user", "root").option("password", "123456").save()
    pdf = result.toPandas()
    pdf["height_std"] = pdf["avg_height"].apply(lambda x: np.std([x, x * 1.05, x * 0.95]))
    pdf["height_score"] = pdf["height_std"].apply(lambda x: round(100 - x, 2))
    return pdf
def analyze_obstacle_avoidance(spark, hdfs_path):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df_clean = df.filter(col("obstacle_distance").isNotNull()).filter(col("obstacle_distance") >= 0)
    df_obs = df_clean.groupBy("flight_id").agg(avg("obstacle_distance").alias("avg_distance"), min("obstacle_distance").alias("min_distance"), count(when(col("obstacle_distance") < 10, True)).alias("near_miss_count"), count("obstacle_distance").alias("total_points"))
    df_obs = df_obs.withColumn("risk_ratio", spark_round(col("near_miss_count") / col("total_points"), 4))
    df_obs = df_obs.withColumn("avoid_level", when(col("risk_ratio") > 0.3, "高风险").when(col("risk_ratio") > 0.1, "中风险").otherwise("低风险"))
    df_obs = df_obs.withColumn("avg_distance", spark_round(col("avg_distance"), 2))
    df_obs.createOrReplaceTempView("obstacle_analysis")
    result = spark.sql("SELECT flight_id, avg_distance, min_distance, near_miss_count, total_points, risk_ratio, avoid_level FROM obstacle_analysis ORDER BY risk_ratio DESC")
    result.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/uav_nav").option("dbtable", "obstacle_avoidance_analysis").option("user", "root").option("password", "123456").save()
    pdf = result.toPandas()
    pdf["avoid_score"] = pdf.apply(lambda row: round((1 - row["risk_ratio"]) * 100, 2), axis=1)
    return pdf
def analyze_power_endurance(spark, hdfs_path):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df_clean = df.filter(col("battery_level").isNotNull()).filter(col("power_consumption").isNotNull())
    df_power = df_clean.groupBy("flight_id").agg(avg("battery_level").alias("avg_battery"), max("power_consumption").alias("max_power"), avg("power_consumption").alias("avg_power"), count("battery_level").alias("power_points"))
    df_power = df_power.withColumn("battery_drop", col("avg_battery") - col("max_power"))
    df_power = df_power.withColumn("endurance_level", when(col("battery_drop") > 50, "续航紧张").when(col("battery_drop") > 20, "续航正常").otherwise("续航充足"))
    df_power = df_power.withColumn("avg_battery", spark_round(col("avg_battery"), 2))
    df_power = df_power.withColumn("avg_power", spark_round(col("avg_power"), 2))
    df_power.createOrReplaceTempView("power_analysis")
    result = spark.sql("SELECT flight_id, avg_battery, max_power, avg_power, battery_drop, endurance_level, power_points FROM power_analysis ORDER BY battery_drop DESC")
    result.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/uav_nav").option("dbtable", "power_endurance_analysis").option("user", "root").option("password", "123456").save()
    pdf = result.toPandas()
    pdf["endurance_score"] = pdf["battery_drop"].apply(lambda x: round(max(0, 100 - x), 2))
    return pdf
基于大数据的无人机自主导航数据分析与可视化文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜