💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
目录
- 基于大数据的全球太空探索数据分析与可视化介绍
- 基于大数据的全球太空探索数据分析与可视化演示视频
- 基于大数据的全球太空探索数据分析与可视化演示图片
- 基于大数据的全球太空探索数据分析与可视化代码展示
- 基于大数据的全球太空探索数据分析与可视化文档展示
基于大数据的全球太空探索数据分析与可视化介绍
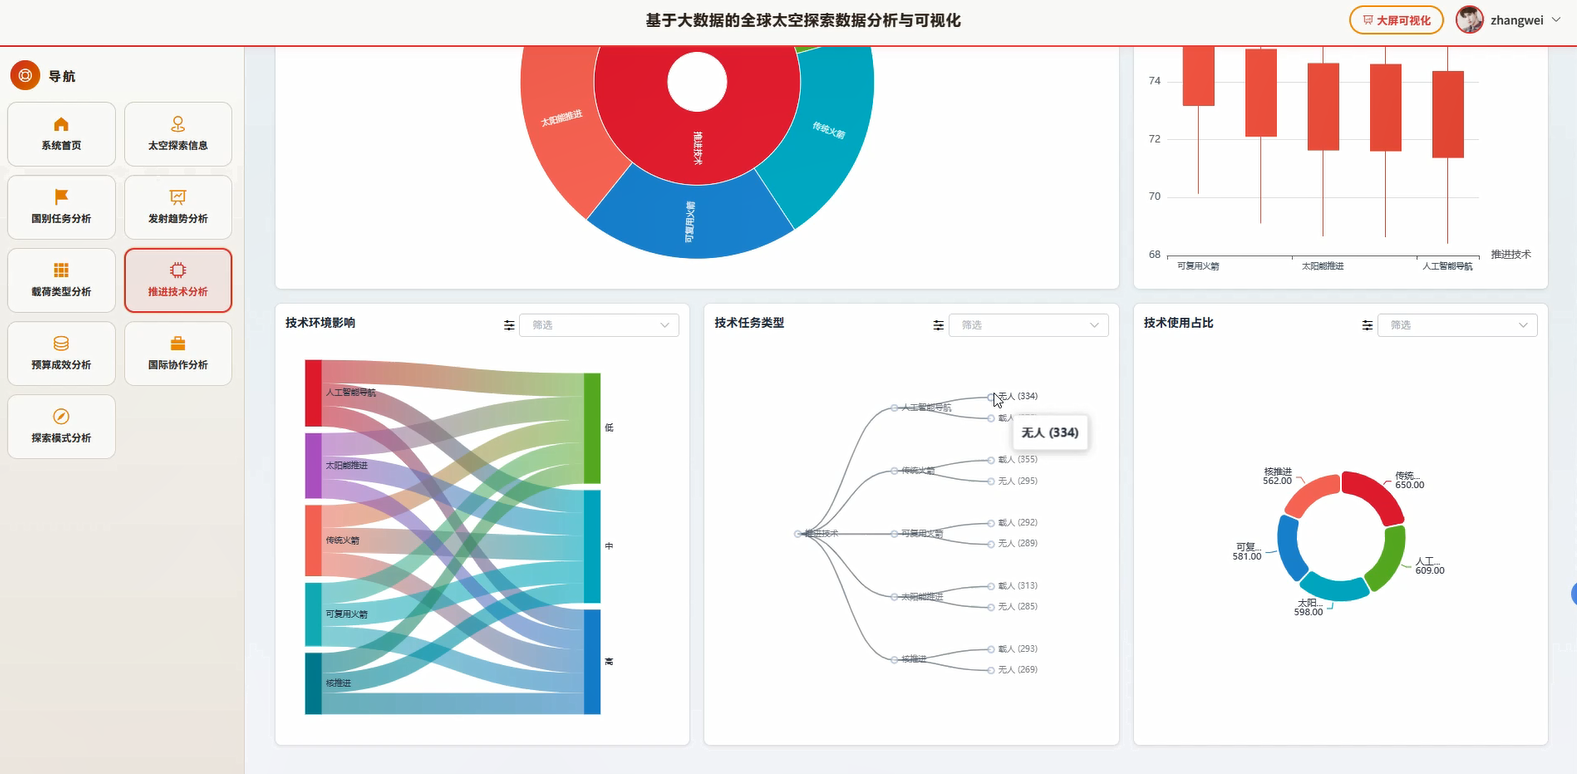
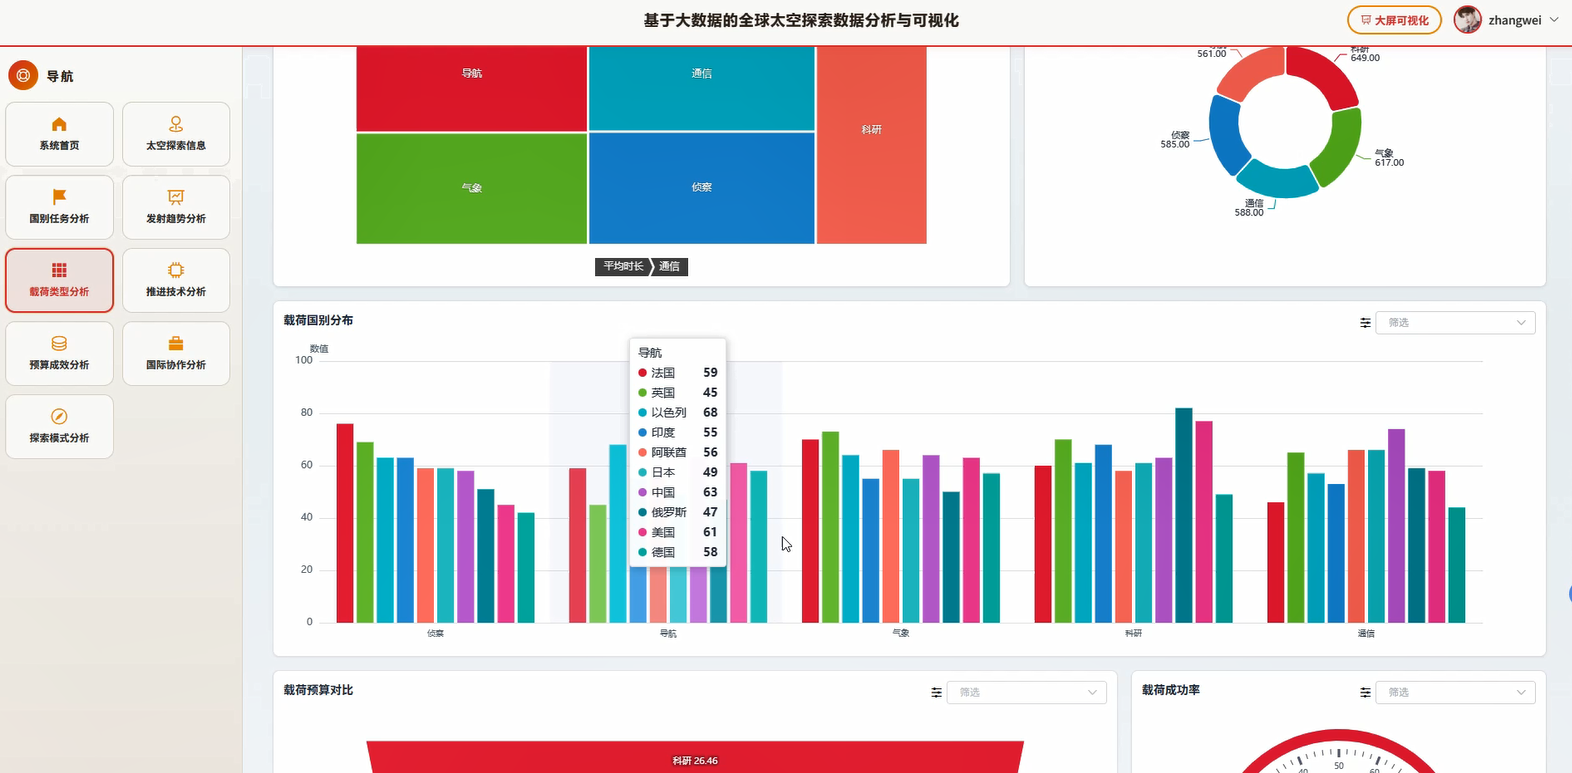
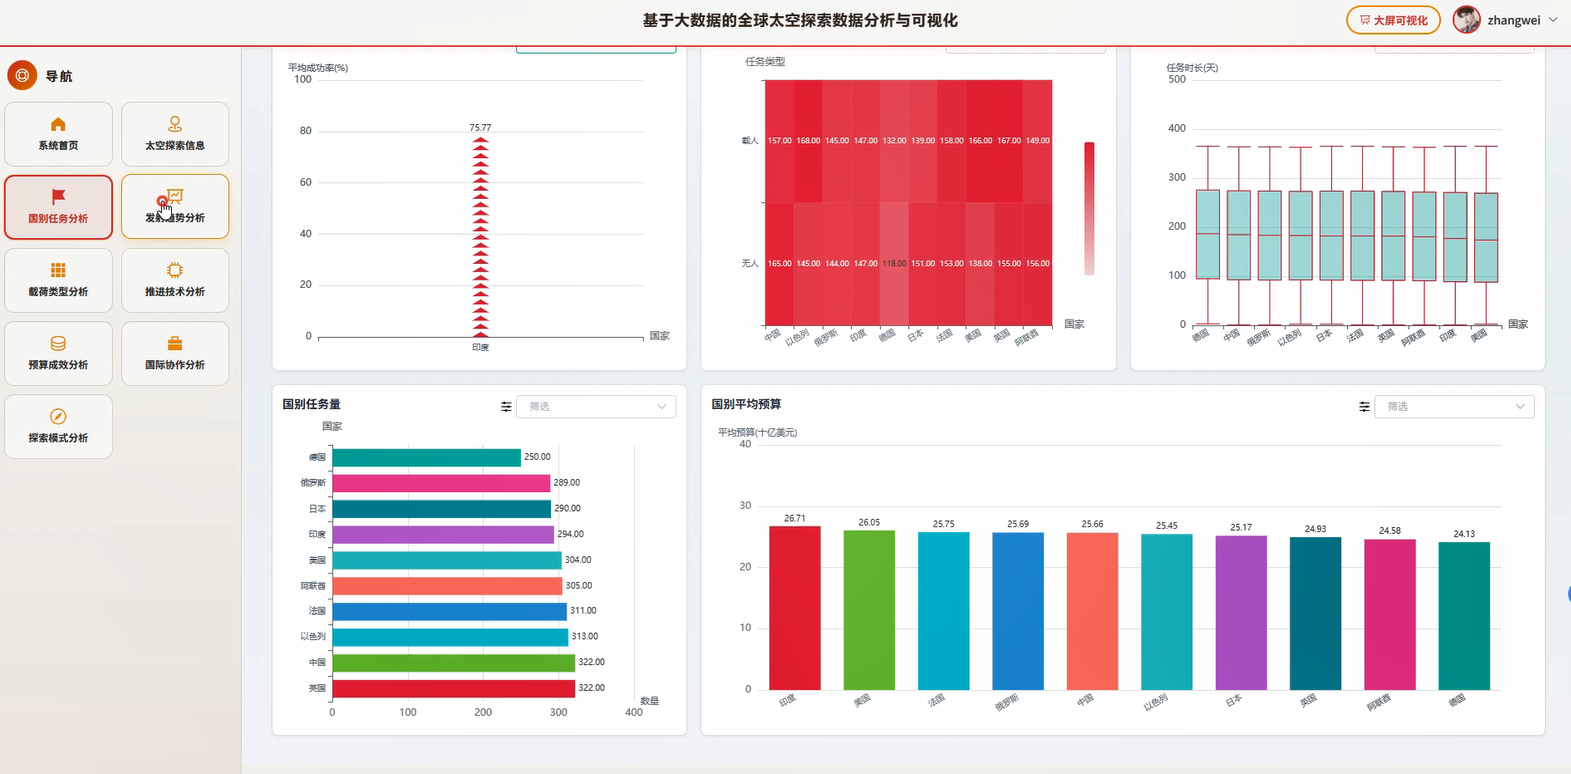
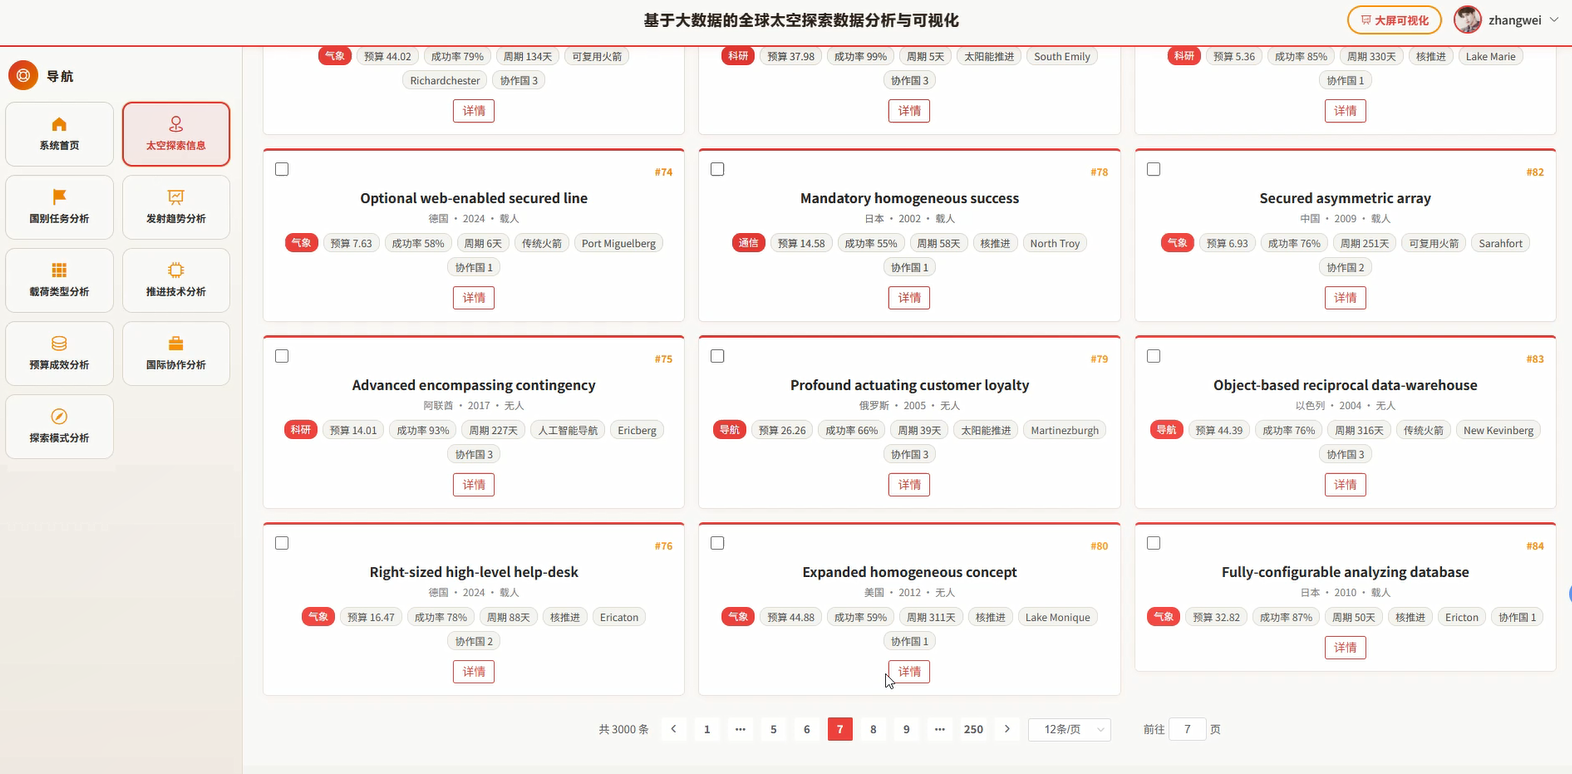
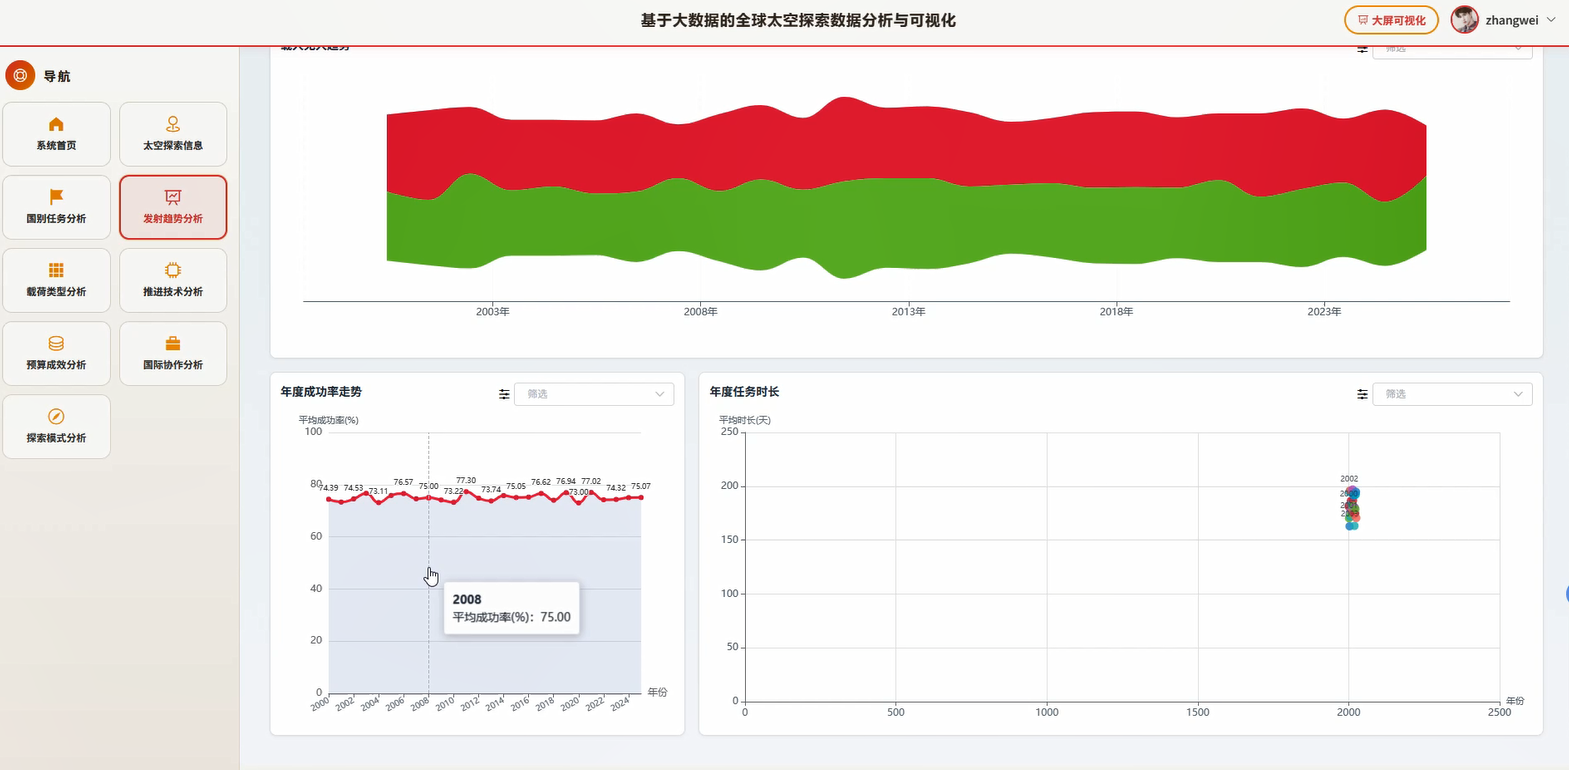
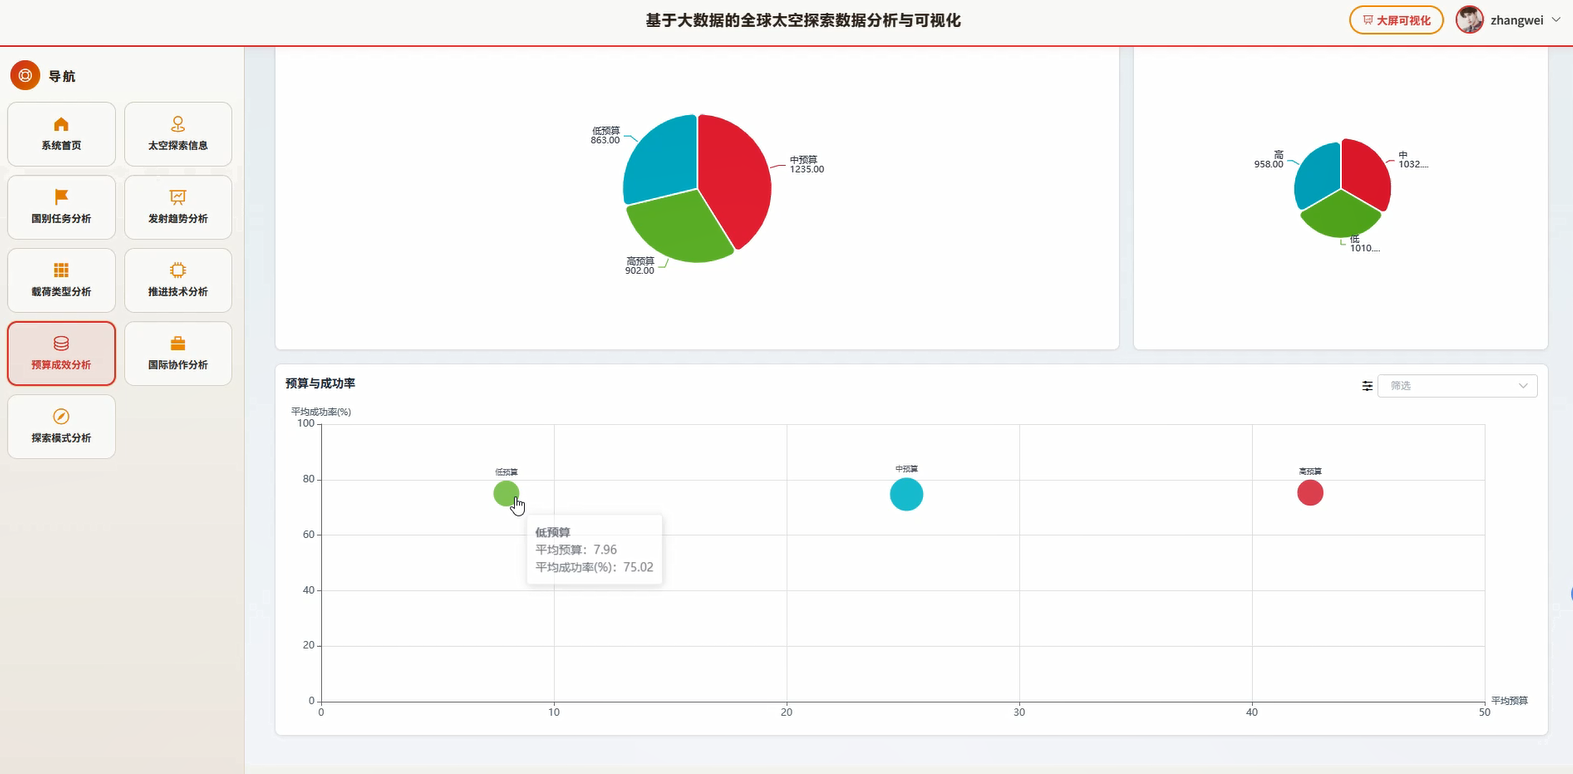
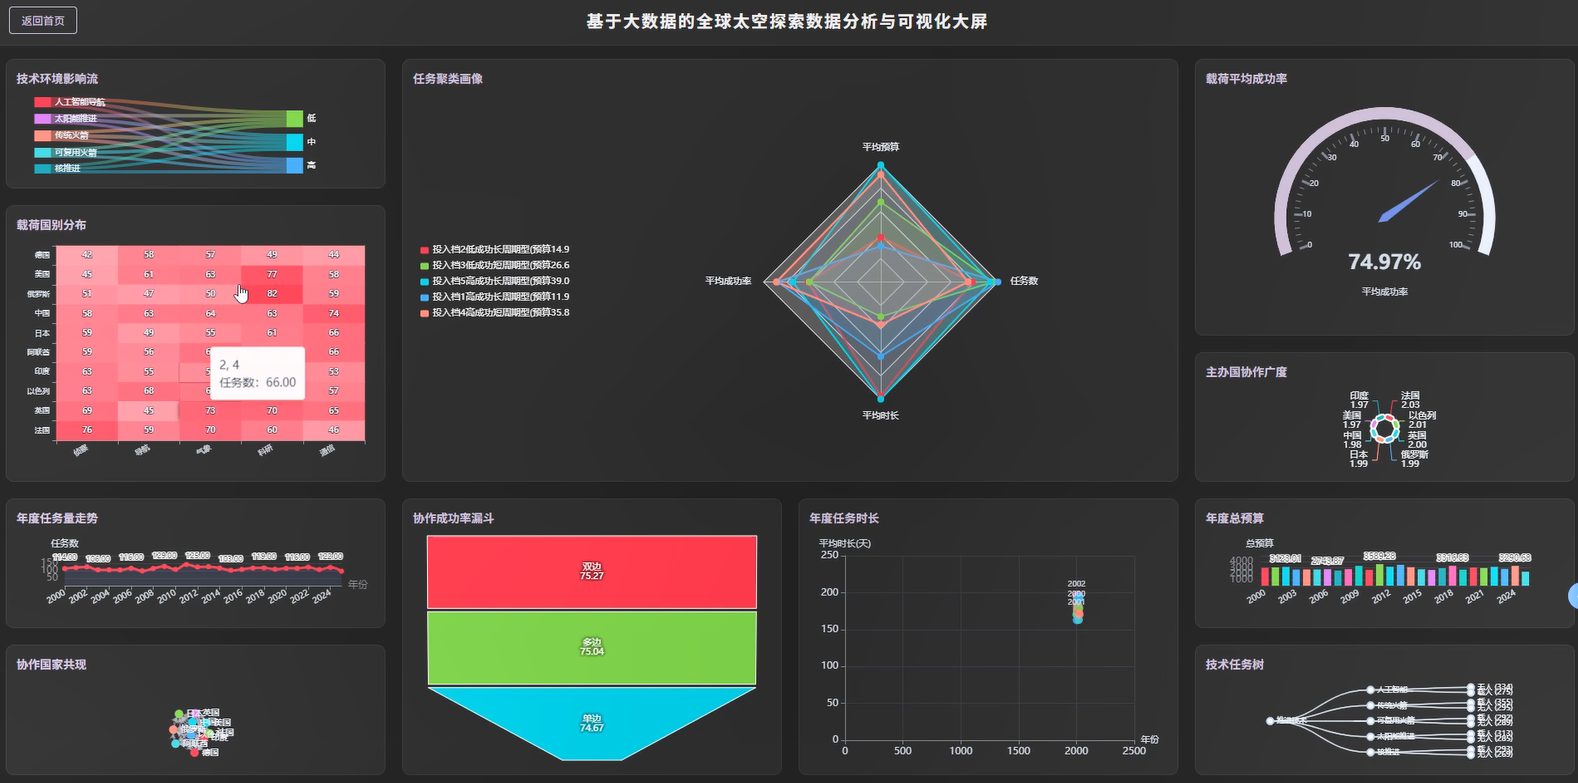
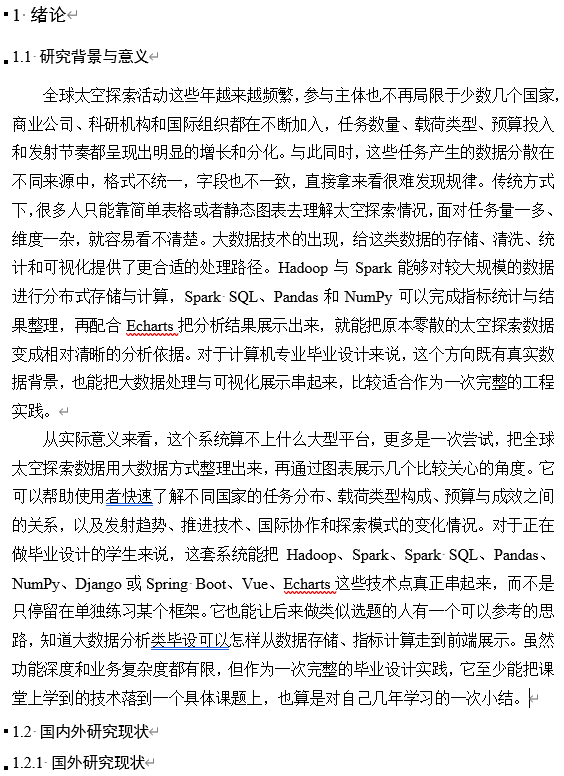
本系统名为《基于大数据的全球太空探索数据分析与可视化》,是一套面向全球太空探索领域数据整理、分析与展示的毕业设计系统。系统以Hadoop与Spark作为大数据处理核心,使用HDFS完成原始数据存储,通过Spark SQL与Pandas、NumPy完成数据清洗、统计与指标计算,开发语言支持Python与Java两个版本,后端框架对应Django与Spring Boot,前端采用Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery,数据库使用MySQL。功能上涵盖系统首页、国别任务分析、载荷类型分析、预算成效分析、太空探索信息、发射趋势分析、推进技术分析、国际协作分析与探索模式分析八个模块,能够围绕全球太空探索任务中的国家分布、载荷类别、预算投入、发射节奏、推进技术路线、国际合作情况和探索模式等维度进行多角度分析,并以图表形式直观呈现分析结果,帮助使用者更清晰地理解全球太空探索活动的发展脉络与结构特征。
基于大数据的全球太空探索数据分析与可视化演示视频
基于大数据的全球太空探索数据分析与可视化演示图片
基于大数据的全球太空探索数据分析与可视化代码展示
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, sum, avg, desc, year, when
import pandas as pd
import numpy as np

spark = SparkSession.builder.appName("GlobalSpaceExplorationAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

def country_mission_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/space/mission.csv")
    df_clean = df.dropna(subset=["country", "mission_name", "launch_date", "budget"])
    df_clean = df_clean.withColumn("launch_year", year(col("launch_date")))
    country_stats = df_clean.groupBy("country").agg(count("mission_name").alias("mission_count"), sum("budget").alias("total_budget"), avg("budget").alias("avg_budget")).orderBy(desc("mission_count"))
    country_stats = country_stats.withColumn("budget_level", when(col("total_budget") > 1000000, "高投入").when(col("total_budget") > 500000, "中投入").otherwise("低投入"))
    result_pd = country_stats.toPandas()
    result_pd["mission_rank"] = result_pd["mission_count"].rank(ascending=False, method="min")
    result_pd["budget_per_mission"] = result_pd["total_budget"] / result_pd["mission_count"]
    result_pd = result_pd.sort_values(by="mission_rank")
    chart_data = result_pd[["country", "mission_count", "total_budget", "budget_level"]].to_dict(orient="records")
    return chart_data

def payload_type_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/space/payload.csv")
    df_clean = df.dropna(subset=["payload_type", "mission_name", "country", "launch_date"])
    df_clean = df_clean.withColumn("launch_year", year(col("launch_date")))
    payload_stats = df_clean.groupBy("payload_type", "launch_year").agg(count("mission_name").alias("payload_count")).orderBy("launch_year", desc("payload_count"))
    payload_pivot = payload_stats.groupBy("payload_type").pivot("launch_year").sum("payload_count").fillna(0)
    payload_pd = payload_pivot.toPandas()
    payload_pd["total_count"] = payload_pd.iloc[:, 1:].sum(axis=1)
    payload_pd["growth_rate"] = payload_pd.iloc[:, 1:].pct_change(axis=1).iloc[:, -1].fillna(0)
    payload_pd = payload_pd.sort_values(by="total_count", ascending=False)
    payload_pd["type_ratio"] = payload_pd["total_count"] / payload_pd["total_count"].sum()
    chart_data = payload_pd[["payload_type", "total_count", "type_ratio"]].to_dict(orient="records")
    return chart_data

def launch_trend_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/space/launch.csv")
    df_clean = df.dropna(subset=["launch_date", "mission_name", "country", "rocket_type"])
    df_clean = df_clean.withColumn("launch_year", year(col("launch_date")))
    df_clean = df_clean.withColumn("launch_month", col("launch_date").substr(1, 7))
    trend_stats = df_clean.groupBy("launch_year", "launch_month").agg(count("mission_name").alias("launch_count"), count(distinct("country")).alias("country_count")).orderBy("launch_year", "launch_month")
    trend_pd = trend_stats.toPandas()
    trend_pd["cumulative_count"] = trend_pd["launch_count"].cumsum()
    trend_pd["moving_avg"] = trend_pd["launch_count"].rolling(window=3, min_periods=1).mean()
    trend_pd["year_growth"] = trend_pd.groupby("launch_year")["launch_count"].transform("sum").pct_change().fillna(0)
    trend_pd["trend_flag"] = np.where(trend_pd["moving_avg"] > trend_pd["moving_avg"].shift(1), "上升", "下降")
    chart_data = trend_pd[["launch_year", "launch_month", "launch_count", "cumulative_count", "moving_avg", "trend_flag"]].to_dict(orient="records")
    return chart_data
基于大数据的全球太空探索数据分析与可视化文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜