📖标题:Pistis Technical Report
🌐来源:arXiv, 2609.28554v1
🛎️文章简介
🔸研究问题:如何克服现有后训练中监督微调、知识蒸馏和强化学习各自为政的局限,解决长程任务中奖励稀疏、策略熵崩溃及信用分配不准的问题,从而提升多模态大模型的推理与代理能力?
🔸主要贡献:论文提出了Pistis模型家族及IDRL训练框架,通过交替进行在线蒸馏和强化学习,并引入系统级的自动Harness优化方法,显著提升了模型在复杂推理和多模态搜索任务上的表现。
📝重点思路
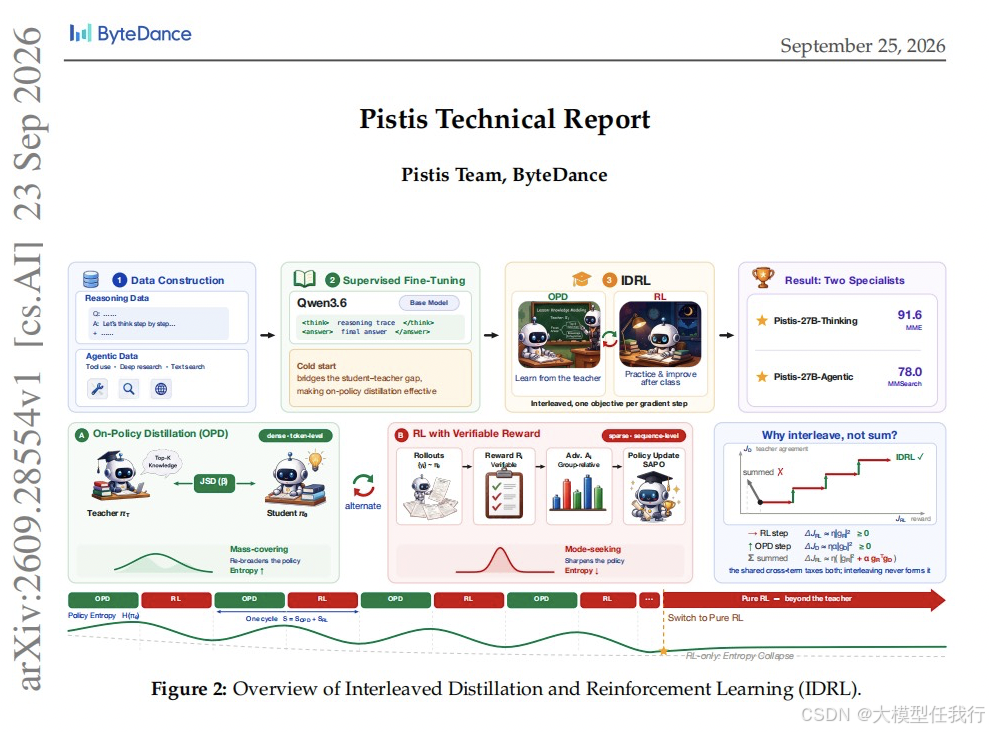
🔸构建通用后训练框架:首先基于Qwen3.5/3.6基座,利用大规模多模态结构化推理数据进行监督微调(SFT),为模型打下坚实的推理基础;针对代理变体,额外加入包含长程规划、迭代推理和工具使用的代理轨迹数据。
🔸提出IDRL训练范式:创新性地将在线策略蒸馏(OPD)与强化学习(RL)整合在一个训练循环中交替进行,而非分阶段或静态加权合并。OPD利用教师模型的分布保持学生模型的策略熵和探索能力,RL则优化任务奖励以 sharpen 策略,两者交替更新避免了梯度冲突,实现了更稳定的优化和更高效的知识迁移。
🔸引入步级正优势抑制机制:针对长程代理任务,在RL阶段识别并抑制那些虽最终成功但中间无效或被拒绝的动作获得的正奖励,从而实现对中间步骤更精准的信用分配,防止模型学习到错误的中间行为。
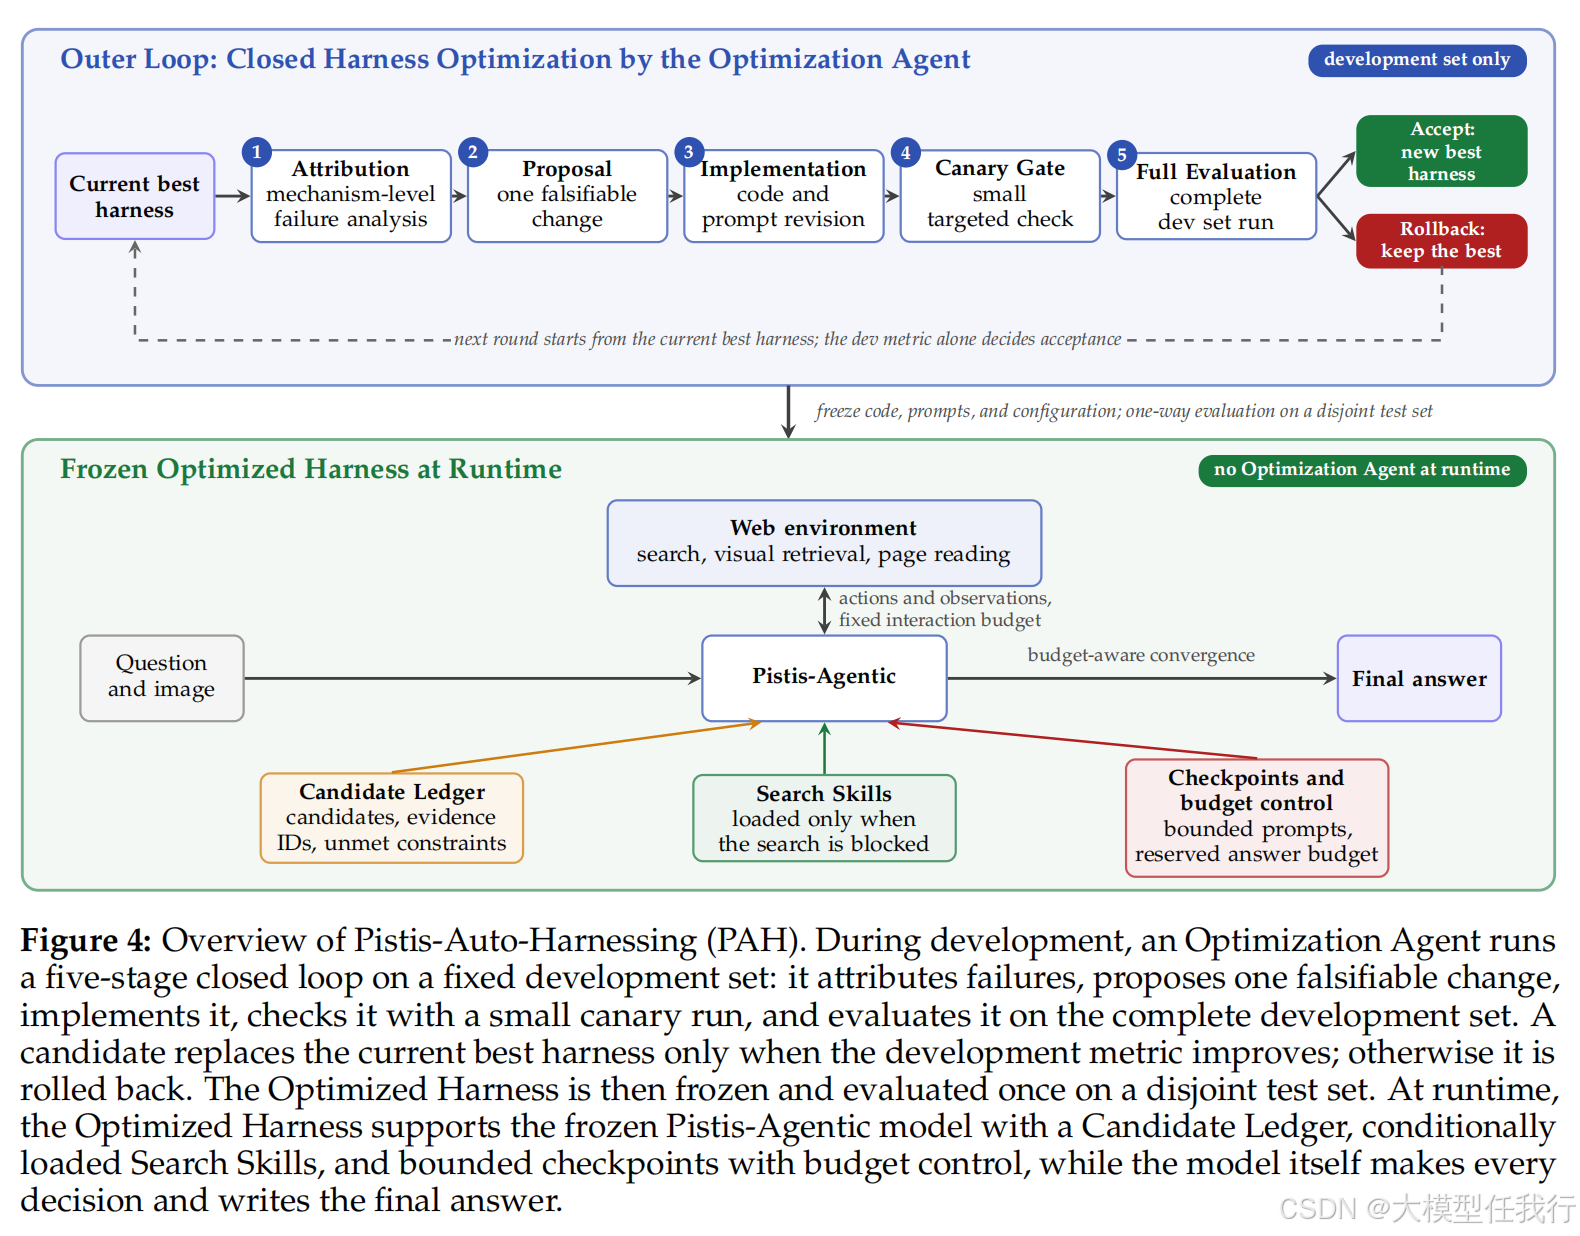
🔸开发Pistis-Auto-Harnessing系统:在不更新模型参数的前提下,通过一个优化代理自动迭代改进推理时的系统编排(如提示词、工作流、证据表示等)。该过程在开发集上闭环运行,仅当新配置提升指标时才保留,从而在固定交互预算下提升代理性能。
🔎分析总结
🔸IDRL优于单一或联合优化:实验表明,相比纯RL、纯蒸馏或两者静态相加,IDRL能更好地维持策略熵,避免早期熵崩溃,梯度范数更稳定,且在多个基准测试中取得最高平均分,证明了交替更新能有效结合两者的互补优势。
🔸Pistis模型性能全面超越基座:Pistis-27B和9B在视觉理解、推理及 grounding 任务上均优于对应的Qwen基座模型,尤其在空间和时间定位任务上优势明显;代理变体在多模态搜索和长程交互任务上提升显著。
🔸系统级优化带来额外增益:PAH方法在不增加模型参数量和交互预算的情况下,通过优化候选记录簿和搜索技能等系统组件,使多模态搜索准确率进一步提升,且该优化后的系统配置可迁移至其他模型并产生正向效果。
🔸步级抑制提升长程任务表现:消融实验显示,移除步级正优势抑制会导致搜索和推理类任务性能下降,证实了该机制对于纠正长轨迹中无效中间动作的重要性。
💡个人观点
论文打破了传统后训练中各阶段孤立的局面,利用"交替"策略,让蒸馏负责"拓宽视野"(保持多样性),强化学习负责"精准打击"(优化目标),既解决了强化学习容易陷入局部最优的问题,又避免了蒸馏无法超越教师上限的缺陷。