NLP基础知识(1.1 自注意力)
-
- [1.1.1 self-attention原理](#1.1.1 self-attention原理)
- [1.1.2 self-attention改进](#1.1.2 self-attention改进)
- [1.1.3 self-attention代码](#1.1.3 self-attention代码)
- 参考资料
1.1.1 self-attention原理
self-attention是一种将单个序列的不同位置关联起来以计算同一序列的表示的注意机制。可以把self-attention理解为感受野可以自学习的CNN,CNN是self-attention的特例。self-attention在数据量大时表现优于CNN。
全局建模能力对比
- 自注意力: 在全局建模能力上,自注意力机制具有明显的优势,因为它可以显式地捕捉序列中任意两个元素之间的关系,无论它们之间的距离。这使得自注意力机制在处理长距离依赖和全局信息方面非常强大。
- CNN: CNN在局部特征提取方面非常有效,但在全局建模能力上可能不如自注意力机制。然而,通过设计特定的网络结构(如使用全局池化层或多尺度卷积),CNN也可以在一定程度上捕捉全局信息
self attention会考虑一整个sequence的上下文,输入几个vector(向量)就输出几个vector。self-attention可以与FC(全连接层)叠加使用,self-attention处理整个sequence的上下文,FC处理某个vector。
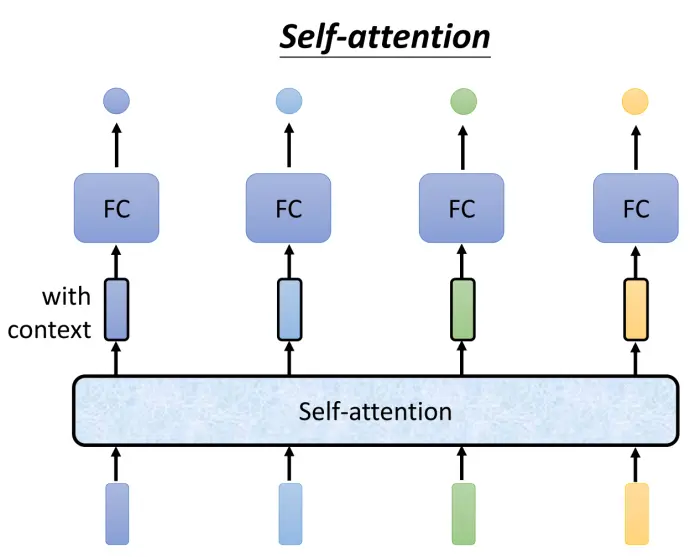
原理 :输入是一个sequence,可能是网络输入或者隐藏层的输出,输出的b是考虑了整个sequence的结果。
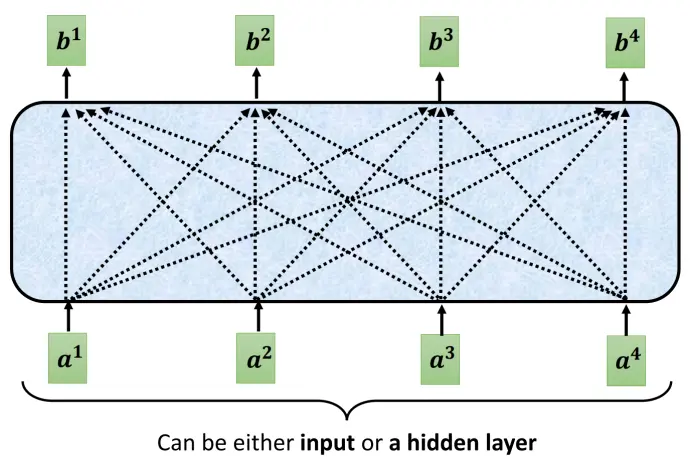
怎么产生b1向量?
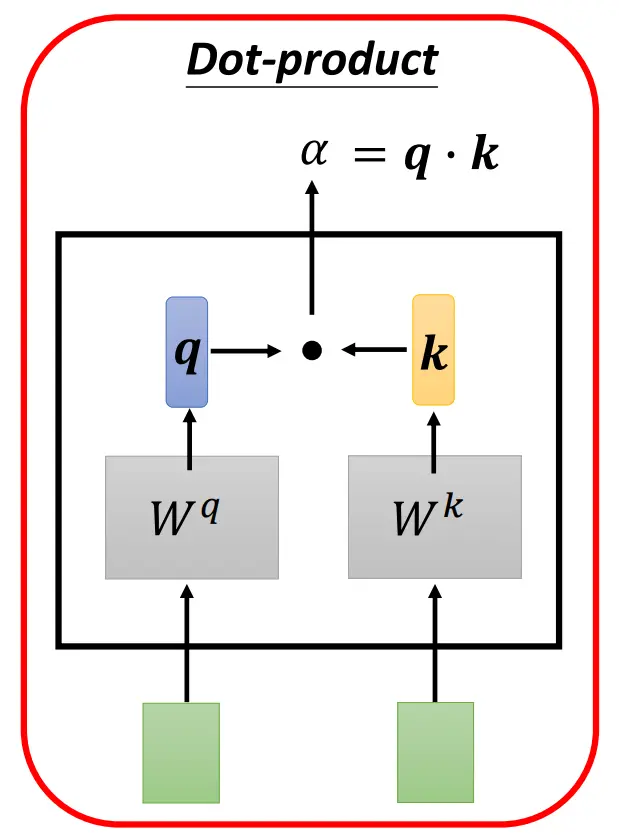
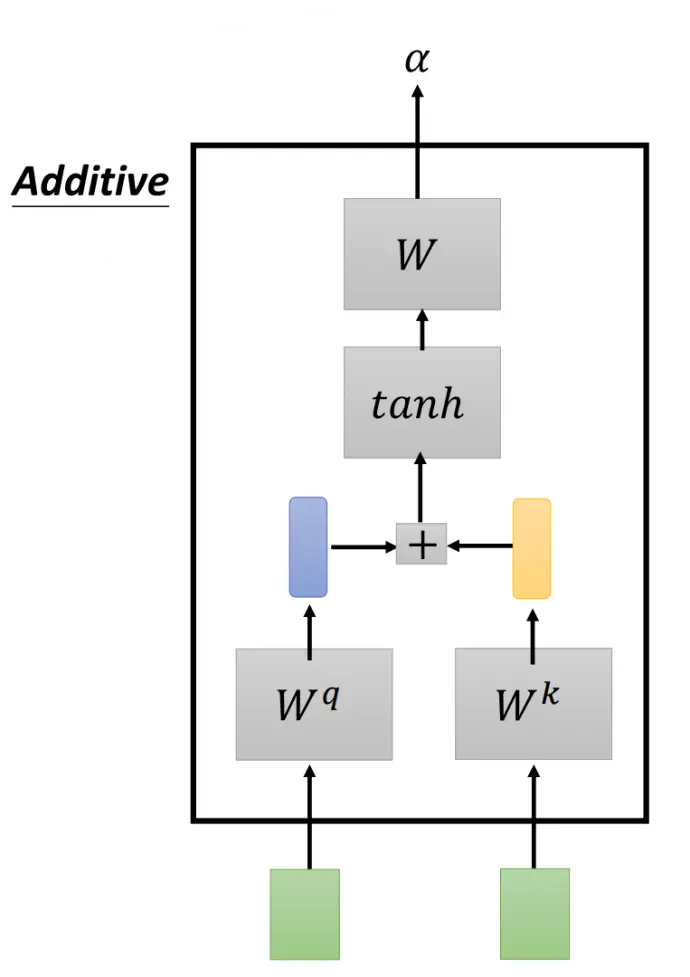
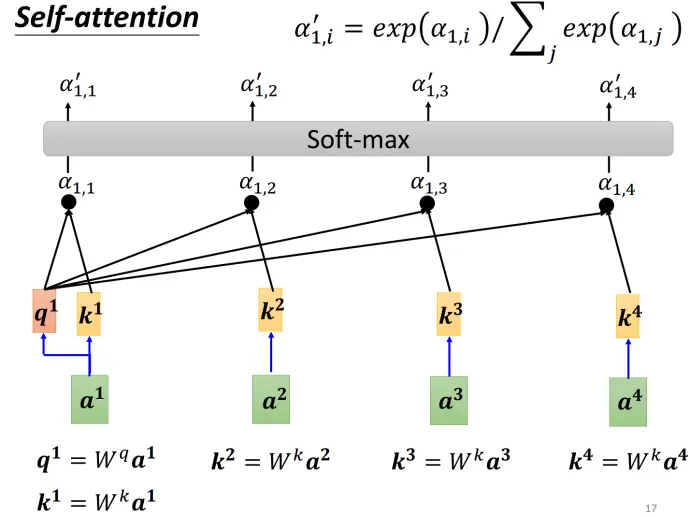
1️⃣ 找出这个sequence里面a1相关的其他向量。关联程度用 α \alpha α 表示,将两个向量作为输入,常见计算方式有:
-
点积(transformer使用):a1和a2乘两个矩阵 W q W^q Wq 和 W k W^k Wk ,得到q和k,再作点积
-
-
Additive:将q和k串起来放入激活函数
-
2️⃣ 怎么把上面生成的 α \alpha α 套用在self attention里面?
α 1 , 1 = q 1 k ˙ 1 \alpha_{1,1}=q^1 \dot k^1 α1,1=q1k˙1,经过softmax进行normalize,(q k对应query和key, q 1 k 2 q^1 k^2 q1k2 表示第二个向量对第一个向量的影响)
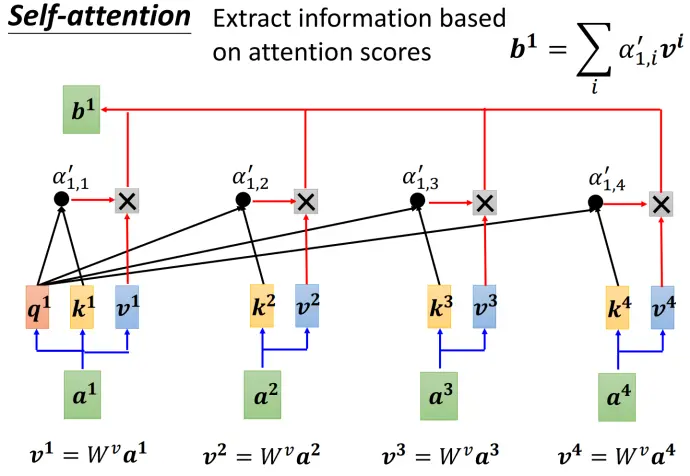
转化成矩阵格式,带学习的参数 W q W k W v W^q W^k W^v WqWkWv,注意A'就是注意力矩阵,乘以V得到self-attention的输出O。
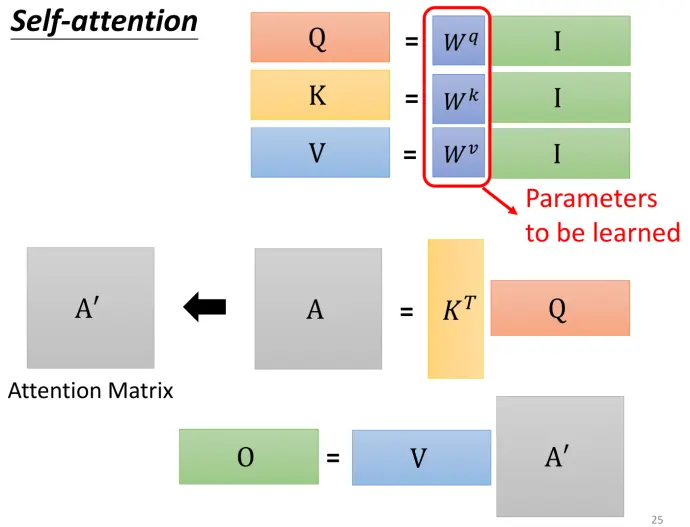
公式( d k d_k dk 是Q,K矩阵的列数,即向量维度):
A t t e n t i o n ( Q , K , V ) = s o f t m a x ( Q K T d k ) V Attention(Q,K,V) = softmax(\frac{QK^T}{\sqrt{d_k}})V Attention(Q,K,V)=softmax(dk QKT)V
除以 d k \sqrt{d_k} dk 是为了平滑softmax的结果,防止进入了softmax的饱和区,导致梯度值太小而难以训练。
self-attention 与 RNN/LSTM 对比:
- 引入Self Attention后会更容易捕获句子中长距离的相互依赖的特征。RNN或者LSTM虽然也能捕获长距离的特征,但是对于远距离的相互依赖的特征,要经过若干时间步步骤的信息累积才能将两者联系起来,而距离越远,有效捕获的可能性越小。
- self-attention和RNN都能处理时序数据,每个向量都考虑了整个sequence,但RNN需要按顺序计算,无法并行;self-attention可以并行计算。
1.1.2 self-attention改进
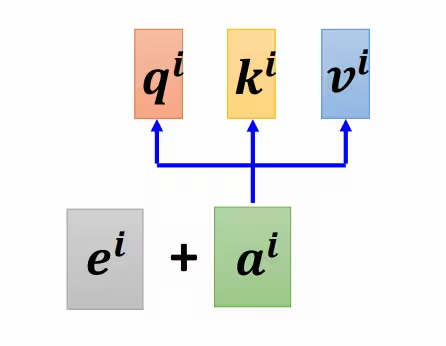
位置编码 :Self-Attention虽然考虑了所有的输入向量,但没有考虑到向量的位置信息。可以通过位置编码(Positional Encoding)来解决这个问题,就是把位置信息添加到输入序列中,让输入数据本身就带有位置信息。
上面的a是无序的,需要对a加上位置向量e,e可以通过多种方法产生(sinusodial、position embedding、floater、rnn等)。
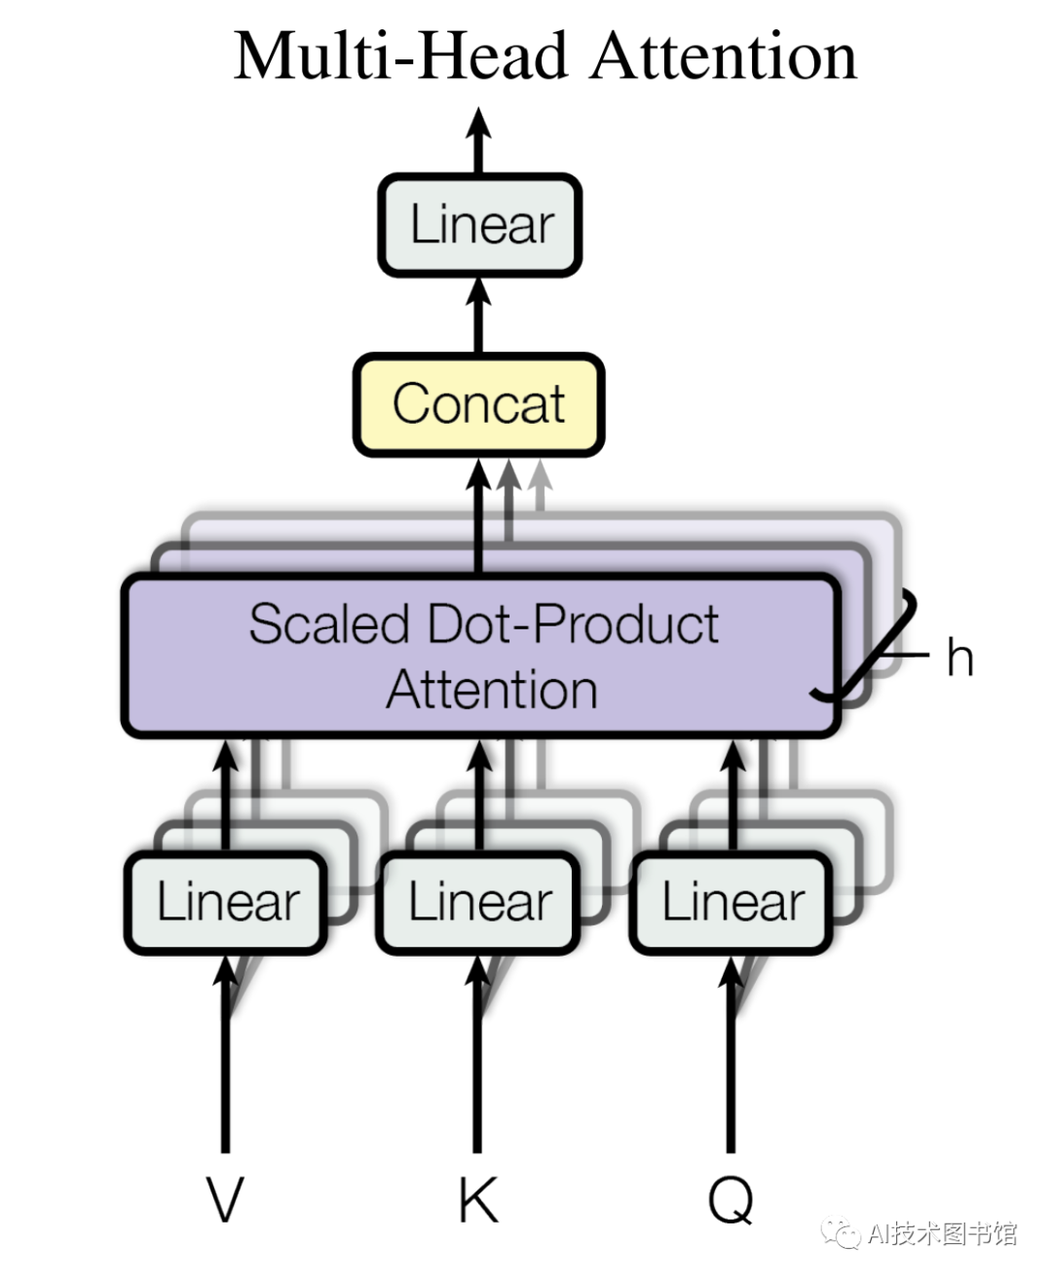
多头注意力:把输入序列投影为多组不同的Query,Key,Value,并行分别计算后,再把各组计算的结果合并作为最终的结果。类似CNN中的多个channel,生成多个W\^q W\^k W\^v $。(V,K,Q)三个矩阵通过h个线性变换,分别得到h组(V,K,Q)矩阵,每一组(V,K,Q)经过Attention计算,得到h个Attention output并进行拼接(Concat),最后通过一个线性变换得到输出,其维度与输入词向量的维度一致,其中h就是多头注意力机制的"头数"。
1.1.3 self-attention代码
python
import torch.nn as nn
import numpy as np
import torch
import math
# 多头注意力
class MHA(nn.Module):
    def __init__(self, num_head, dimension_k, dimension_v, d_k, d_v, d_o):
        # d_k表示head dimension,d_k * num_head 就是embedding的长度
        super().__init__()
        self.num_head = num_head
        self.d_k = d_k
        self.d_v = d_v
        self.d_o = d_o
        self.fc_q = nn.Linear(dimension_k, num_head * d_k)
        self.fc_k = nn.Linear(dimension_k, num_head * d_k)
        self.fc_v = nn.Linear(dimension_v, num_head * d_v)
        self.fc_o = nn.Linear(num_head * d_v, d_o)
        self.softmax = nn.Softmax(dim=2)


    def forward(self, q, k, v, mask):

        batch, n_q, dimension_q = q.size()
        batch, n_k, dimension_k = k.size()
        batch, n_v, dimension_v = v.size()

        q = self.fc_q(q)
        k = self.fc_k(k)
        v = self.fc_v(v)
        q = q.view(batch, n_q, self.num_head, self.d_k).permute(2, 0, 1, 3).contiguous().view(-1, n_q, self.d_k)
        k = k.view(batch, n_k, self.num_head, self.d_k).permute(2, 0, 1, 3).contiguous().view(-1, n_k, self.d_k)
        v = v.view(batch, n_v, self.num_head, self.d_v).permute(2, 0, 1, 3).contiguous().view(-1, n_v, self.d_v)

        attention = torch.matmul(q, k.transpose(-1, -2)) / math.sqrt(self.d_k)
        mask = mask.repeat(self.num_head, 1, 1)
        attention = attention + mask
        attention = self.softmax(attention)

        output = torch.matmul(attention, v)
        output = output.view(self.num_head, batch, n_q, self.d_v).permute(1, 2, 0, 3).contiguous().view(batch, n_q, -1)
        output = self.fc_o(output)
        return attention, output
# Multi query attention
class MQA(nn.Module):
    def __init__(self, num_head, dimension_k, dimension_v, d_k, d_v, d_o):
        super().__init__()
        self.num_head = num_head
        self.d_k = d_k
        self.d_v = d_v
        self.d_o = d_o
        self.fc_q = nn.Linear(dimension_k, num_head * d_k)
        self.fc_k = nn.Linear(dimension_k, d_k)
        self.fc_v = nn.Linear(dimension_v, d_v)
        self.fc_o = nn.Linear(num_head * d_v, d_o)
        self.softmax = nn.Softmax(dim=2)


    def forward(self, q, k, v, mask):

        batch, n_q, dimension_q = q.size()
        batch, n_k, dimension_k = k.size()
        batch, n_v, dimension_v = v.size()

        q = self.fc_q(q)
        k = self.fc_k(k)
        v = self.fc_v(v)
        q = q.view(batch, n_q, self.num_head, self.d_k).permute(2, 0, 1, 3).contiguous().view(-1, n_q, self.d_k)
        k = k.repeat(self.num_head, 1, 1)
        v = v.repeat(self.num_head, 1, 1)

        attention = torch.matmul(q, k.transpose(-1, -2)) / math.sqrt(self.d_k)
        mask = mask.repeat(self.num_head, 1, 1)
        attention = attention + mask
        attention = self.softmax(attention)

        output = torch.matmul(attention, v)
        output = output.view(self.num_head, batch, n_q, self.d_v).permute(1, 2, 0, 3).contiguous().view(batch, n_q, -1)
        output = self.fc_o(output)
        return attention, output

batch = 10
num_head = 8
n_q, n_k, n_v = 2, 4, 4 # sequence 长度
dimension_q, dimension_k, dimension_v = 128, 128, 64 # embedding的长度
d_k, d_v, d_o = 16, 16, 8
q = torch.randn(batch, n_q, dimension_q)
k = torch.randn(batch, n_k, dimension_k)
v = torch.randn(batch, n_v, dimension_v)
mask  = torch.full((batch, n_q, n_k), -np.inf)
mask = torch.triu(mask,diagonal=1)
mha = MHA(num_head, dimension_k, dimension_v, d_k, d_v, d_o)
attention, output = mha(q, k, v, mask)
print(attention.size(), output.size())

mqa = MQA(num_head, dimension_k, dimension_v, d_k, d_v, d_o)
attention, output = mqa(q, k, v, mask)
print(attention.size(), output.size())
参考资料
- 局丽叶的大模型学习路线:https://my.feishu.cn/docx/AN61dRfiWoRUiRxhc6ucbmJwnGr
- 小白入门必看:https://www.bilibili.com/video/BV1TZ421j7Ke/?vd_source=ddf75e41eaddecb4f06db9ceab0dec40
- 动图轻松理解Self-Attention:《https://zhuanlan.zhihu.com/p/619154409》
- Attention经典论文 Attention Is All You Need:《https://arxiv.org/pdf/1706.03762》,视频讲解:https://www.bilibili.com/video/BV1xoJwzDESD/?vd_source=ddf75e41eaddecb4f06db9ceab0dec40
- 李宏毅老师讲解自注意力:《https://www.bilibili.com/video/BV1L142187HH?buvid=YC4C58CDA79A1D374FA79E89DDC8B065E776&is_story_h5=false&mid=962SUbSmP6fcXi0fKJNqyg%3D%3D&plat_id=114&share_from=ugc&share_medium=iphone&share_plat=ios&share_source=WEIXIN&share_tag=s_i×tamp=1740108714&unique_k=yVdqiVv&up_id=3493116176763506&vd_source=4804e44ea59abe1f4c2b7dde30651898&spm_id_from=333.788.videopod.episodes&p=2》
- 手绘图解transformer代码:《https://zhuanlan.zhihu.com/p/366592542》