**摘要:**本文以 Rust 语言实现享元模式(Flyweight Pattern)为核心,围绕连锁珠宝零售商的排班系统展开。正文通过多个代码模块详细展示了封闭枚举与开放型结构体的取舍、金额以整数「分」存储的精度保护、以及共享与不共享两种实现的内存占用对照。文章重点说明「取值即分支」用枚举、可扩展标签用开放型结构体的判定标准,并给出工程外零侵入扩展、破损输入检测与内存字节量级对比的完整示例。
项目结构:
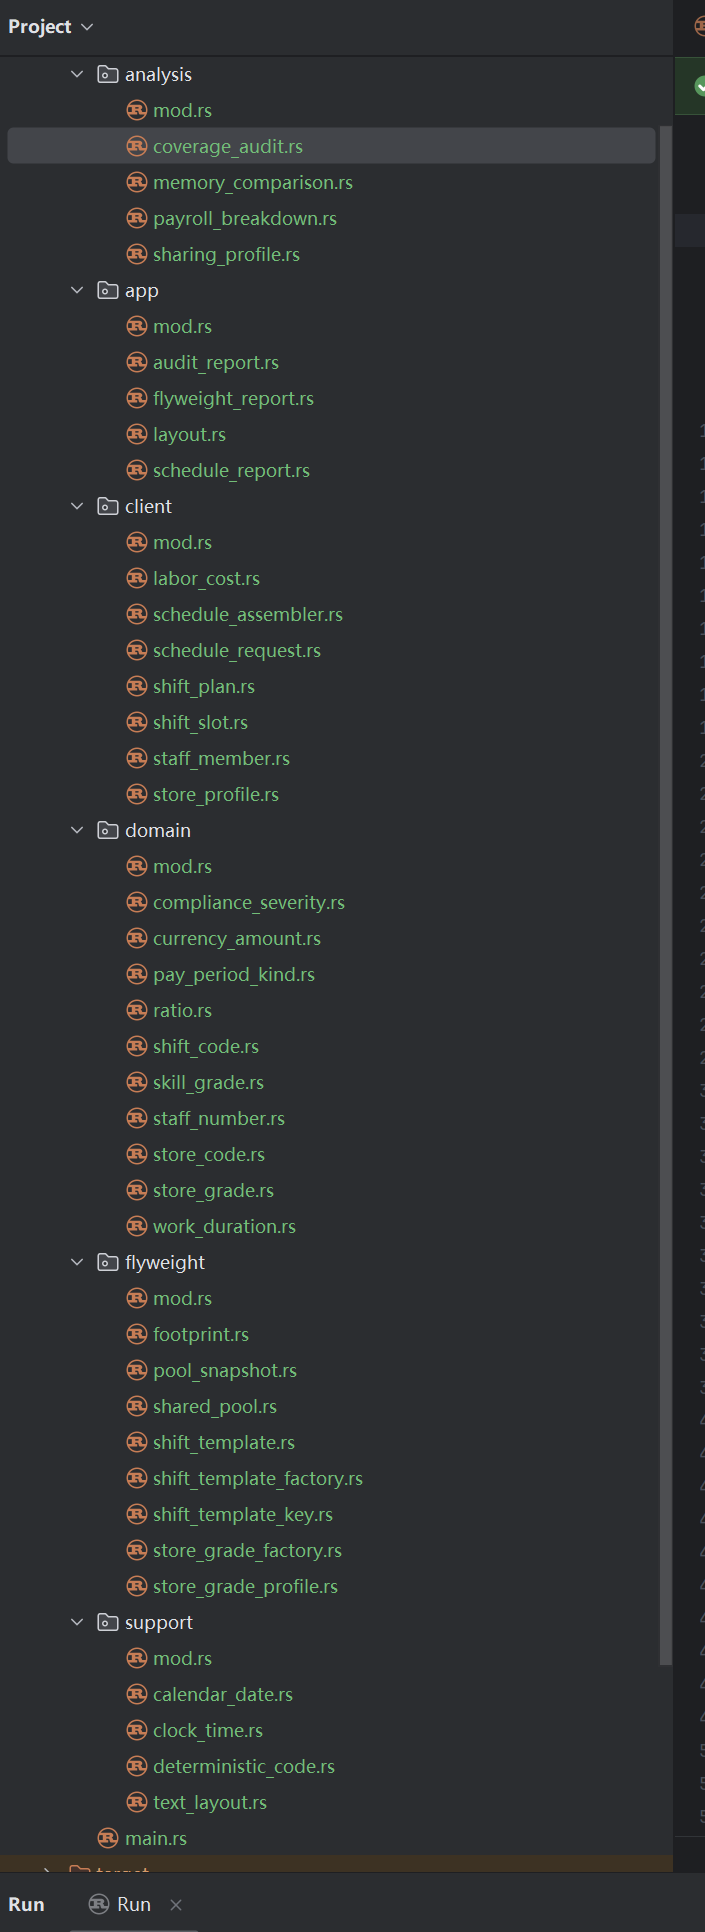
rust
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : compliance_severity.rs
//! # 合规问题严重度 ------ 封闭枚举
//!
//! ## 为什么这一个用枚举而不用开放型结构体
//!
//! 判定标准是:**该维度的取值会决定代码分支吗?**
//!
//! 会。严重度直接决定三件事:
//! 1. 是否阻断排班发布(`blocks_publication`);
//! 2. 报表用什么标记(`marker`);
//! 3. 排序优先级(`priority`)。
//!
//! 这类「取值即分支」的维度用枚举,好处是 `match` 的**穷尽性检查**:
//! 若将来真加了第 4 个档次,编译器会强制我们更新每一处 `match`,
//! 一个都不会漏。若用开放型结构体 + `if/else`,新档次会静默落入
//! 某个 `else` 分支------这正是最难查的 bug。
//!
//! 对照地看:`SkillGrade`、`StoreGrade`、`ShiftCode` 这些**不决定分支**
//! (只用于展示、分组、参与键),所以用开放型结构体。
//!
//! 这个判定标准要一直用下去,不要「凭感觉选」。
//!
//! ## 为什么只有三档
//!
//! 合规问题的处理路径只有三条:阻断(必须改)、警告(建议改)、提示(知悉即可)。
//! 多加档次会迫使报表与审批流增加分支,而业务上并无第 4 种处理方式。
//! 「档次数量由处理路径数量决定」------这是比「凭直觉分级」更可靠的依据。
/// 合规问题的严重度。
#[derive(Debug, Clone, Copy, PartialEq, Eq, PartialOrd, Ord, Hash)]
pub enum ComplianceSeverity {
/// 提示:知悉即可,不影响发布。
Information,
/// 警告:建议调整,可人工确认后发布。
Warning,
/// 阻断:必须调整,否则不允许发布排班。
Blocker,
}
impl ComplianceSeverity {
/// 中文名称。
pub const fn label(&self) -> &'static str {
match self {
ComplianceSeverity::Information => "提示",
ComplianceSeverity::Warning => "警告",
ComplianceSeverity::Blocker => "阻断",
}
}
/// 报表里使用的前缀标记(单字符,便于对齐)。
///
/// 用 ASCII 字符而非中文:中文标记占 2 列,
/// 会让这一列比其他列宽,破坏表格对齐。
pub const fn marker(&self) -> &'static str {
match self {
ComplianceSeverity::Information => "·",
ComplianceSeverity::Warning => "!",
ComplianceSeverity::Blocker => "x",
}
}
/// 排序优先级(数值越大越严重)。
///
/// 用于报表按严重度降序排列,让最需要处理的问题排在最上面。
pub const fn priority(&self) -> u8 {
match self {
ComplianceSeverity::Information => 0,
ComplianceSeverity::Warning => 1,
ComplianceSeverity::Blocker => 2,
}
}
/// 是否阻断排班发布。
///
/// 只有 `Blocker` 阻断。`Warning` 虽然需要人工确认,
/// 但确认后即可发布------「需要人工介入」与「禁止发布」是两件事,
/// 混为一谈会让运营被迫为每条警告走一次审批,实际结果是「全都点通过」,
/// 反而失去警示作用。
pub const fn blocks_publication(&self) -> bool {
match self {
ComplianceSeverity::Blocker => true,
// Information 与 Warning 都不阻断。
ComplianceSeverity::Warning | ComplianceSeverity::Information => false,
}
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : currency_amount.rs
//! # 货币与金额 ------ 整数「分」的存储
//!
//! ## 为什么金额必须是整数
//!
//! 本工程要计算「排班总人力成本」并把它打印出来。若用 f64 存金额:
//! 1. 累加会漂移:0.1 + 0.2 != 0.3,几万条排班累加后误差肉眼可见;
//! 2. 相等不可靠:享元池的键里若含金额(本工程不含,但将来可能),
//! 浮点相等在 NaN 与 -0.0 上有陷阱;
//! 3. 内存度量失真:f64 恒定 8 字节,但金额的语义精度是「分」,
//! 用 8 字节存一个只需几十分位的量,是明确的浪费。
//!
//! 因此本类型用 i64 存最小单位(人民币的「分」),
//! 并用 currency 字段记录币种。深圳总部用人民币、中国香港门店用港币,
//! 两种币种不能直接相加------add 会在币种不一致时给出 None。
//!
//! ## 「分」而不是「元」的乘法保护
//!
//! 时薪 × 时长是核心运算。若用「元」为单位,
//! 一个 ¥28.50 的时薪乘 480 分钟会先得到浮点中间值,再四舍五入------
//! 每一步都可能丢分。用「分」后:2850 分/时 与 480 分 相乘,
//! 中间量用 i128 承载,最后一次性四舍五入到「分」,
//! 全程只有一次舍入。这是本工程「金额可核对」的前提。
//!
//! ## 关于与 ratio 的同层互相引用
//!
//! 本文件需要 BASIS_POINTS_DENOMINATOR(万分比的分母),
//! 而 ratio.rs 需要 CurrencyAmount(用于 Ratio::apply_to)。
//! 两个同层模块互相引用在 Rust 里完全合法,也不违反分层约束------
//! 依赖方向检查关心的是「层与层之间」,同层内的模块互引不构成环。
//!
//! 但互相引用仍要克制:若同层模块之间形成密集网,说明这一层
//! 应该再切成两个层。本层只有这一处双向引用,且是两个紧邻概念
//! (金额与比率)之间的天然耦合,可以接受。
// 同层引用:万分比分母常量。
use super::ratio::BASIS_POINTS_DENOMINATOR;
/// 币种标签(开放型)。
///
/// ## 为什么不是枚举
///
/// 连锁珠宝零售商会在新地区开店(新加坡、马来西亚、日本......),
/// 币种数量会增长。枚举每加一种都要改本文件,违反「工程外可扩展」。
/// 用 const fn new 结构体后,扩展者在自己代码里就能定义新币种:
///
/// ignore /// // 工程外(main.rs 的扩展区),不需要改 domain 层 /// const CURRENCY_SINGAPORE_DOLLAR: Currency = /// Currency::new("SGD", "新加坡元", 100, "S$"); ///
///
/// 字段私有 + const fn new 的代价是「无法在编译期阻止拼错币种编码」,
/// 但收益是「新增币种零侵入」。对本工程而言,后者更重要------
/// 这正是开放型标签与封闭枚举的取舍标准。
#[derive(Debug, Clone, Copy, PartialEq, Eq, Hash)]
pub struct Currency {
/// 币种编码(如 "CNY"、"HKD")。参与相等比较,作为币种身份。
code: &'static str,
/// 中文名称(如 "人民币"),仅用于展示。
display_name: &'static str,
/// 一个主单位包含多少个最小单位(人民币为 100,即 100 分)。
minor_units_per_major_unit: i64,
/// 货币符号(如 "¥"),仅用于展示。
symbol: &'static str,
}
impl Currency {
/// 构造一个币种。
///
/// 参数 code / display_name / minor_units_per_major_unit / symbol。
/// 返回:币种标签。
///
/// const fn 使本函数可用于定义 const 常量------
/// 这是「工程外零侵入扩展」能成立的技术前提。
pub const fn new(
code: &'static str,
display_name: &'static str,
minor_units_per_major_unit: i64,
symbol: &'static str,
) -> Currency {
Currency {
code,
display_name,
minor_units_per_major_unit,
symbol,
}
}
/// 币种编码。
pub const fn code(&self) -> &'static str {
self.code
}
/// 中文名称。
pub const fn display_name(&self) -> &'static str {
self.display_name
}
/// 一个主单位包含多少个最小单位。
pub const fn minor_units_per_major_unit(&self) -> i64 {
self.minor_units_per_major_unit
}
/// 货币符号。
pub const fn symbol(&self) -> &'static str {
self.symbol
}
}
/// 人民币。
pub const CURRENCY_CHINESE_YUAN: Currency = Currency::new("CNY", "人民币", 100, "¥");
/// 港币(中国香港门店使用)。
pub const CURRENCY_HONG_KONG_DOLLAR: Currency = Currency::new("HKD", "港币", 100, "HK$");
/// 一笔金额。
///
/// minor_units 是最小单位数(人民币即「分」)。
/// 允许为负:退款、成本冲销等场景需要负金额。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub struct CurrencyAmount {
/// 最小单位数(人民币为「分」)。
minor_units: i64,
/// 币种。
currency: Currency,
}
impl CurrencyAmount {
/// 由最小单位数构造。
///
/// 参数 minor_units / currency。
/// 返回:金额。
pub const fn from_minor_units(minor_units: i64, currency: Currency) -> CurrencyAmount {
CurrencyAmount {
minor_units,
currency,
}
}
/// 由「主单位 + 最小单位」构造(如 `(12, 34)` → `¥12.34`)。
///
/// 参数 `major_units` / `minor_unit_part` / `currency`。
/// 返回:金额。
///
/// 中间量用 `i128`:`major_units` 若接近 `i64::MAX`,
/// 乘以 100 会溢出。虽然实际业务不会出现这种值,
/// 但用一个更宽的中间类型只是写起来多几个字符,却能免除一整类溢出风险。
pub const fn from_major_and_minor(
major_units: i64,
minor_unit_part: i64,
currency: Currency,
) -> CurrencyAmount {
let total_minor_units: i128 =
major_units as i128 * currency.minor_units_per_major_unit as i128
+ minor_unit_part as i128;
CurrencyAmount {
minor_units: clamp_i128_to_i64(total_minor_units),
currency,
}
}
/// 零金额。
pub const fn zero(currency: Currency) -> CurrencyAmount {
CurrencyAmount::from_minor_units(0, currency)
}
/// 最小单位数。
pub const fn minor_units(&self) -> i64 {
self.minor_units
}
/// 币种。
pub const fn currency(&self) -> Currency {
self.currency
}
/// 是否为零。
pub const fn is_zero(&self) -> bool {
self.minor_units == 0
}
/// 是否为负(退款、冲销)。
pub const fn is_negative(&self) -> bool {
self.minor_units < 0
}
/// 取绝对值。
///
/// 注意 `i64::MIN` 的绝对值仍是 `i64::MIN`(溢出环绕),
/// 因此这里用 `saturating_abs`:极端值下钳到 `i64::MAX` 而非回绕成负数。
/// 业务上不会出现 `i64::MIN` 分(约 9.2e16 元),但用饱和运算只是代价极小的保险。
pub const fn absolute(&self) -> CurrencyAmount {
CurrencyAmount {
minor_units: self.minor_units.saturating_abs(),
currency: self.currency,
}
}
/// 相加。币种不一致时返回 `None`。
///
/// 参数 `other`:另一笔金额。
/// 返回:同币种时返回和,否则 `None`。
///
/// ## 为什么返回 `Option` 而不是 panic 或静默按本方币种处理
///
/// 把人民币和港币相加在业务上是**错误**,不是「需要兜底」的情况。
/// panic 会让整个报表拿不到(一个门店币种配错,全表都看不见);
/// 静默混算会产出看似合理的错误数字(最危险)。
/// 返回 `None` 让错误**在调用点显式暴露**,由调用方决定是跳过还是报错。
pub fn add(&self, other: &CurrencyAmount) -> Option<CurrencyAmount> {
if self.currency != other.currency {
return None;
}
// 用 i128 中间量,避免两个接近 i64::MAX 的金额相加溢出。
let sum: i128 = self.minor_units as i128 + other.minor_units as i128;
Some(CurrencyAmount {
minor_units: clamp_i128_to_i64(sum),
currency: self.currency,
})
}
/// 相减。币种不一致时返回 `None`。
pub fn subtract(&self, other: &CurrencyAmount) -> Option<CurrencyAmount> {
if self.currency != other.currency {
return None;
}
let difference: i128 = self.minor_units as i128 - other.minor_units as i128;
Some(CurrencyAmount {
minor_units: clamp_i128_to_i64(difference),
currency: self.currency,
})
}
/// 乘以一个整数倍数。
///
/// 参数 `quantity`:倍数(如「几件」「几人」)。
/// 返回:乘积金额。
pub fn multiply_by_quantity(&self, quantity: i64) -> CurrencyAmount {
let product: i128 = self.minor_units as i128 * quantity as i128;
CurrencyAmount {
minor_units: clamp_i128_to_i64(product),
currency: self.currency,
}
}
/// 按万分比缩放(如「上浮 12.5%」写作 `1250` 万分点)。
///
/// 参数 `basis_points`:万分点。
/// 返回:缩放后的金额。
///
/// 这是**本工程的时薪计算入口**:`基础时薪 × 班次系数`。
/// 例如基础时薪 ¥28.50(2850 分)乘以夜班系数 12500 万分点:
/// `2850 * 12500 / 10000 = 3562.5` → 远离零方向四舍五入 → `3563` 分 = ¥35.63。
pub fn scale_by_basis_points(&self, basis_points: i64) -> CurrencyAmount {
// 三步:乘 → 除 → 舍入。中间量用 i128 承载乘积。
let scaled: i128 = self.minor_units as i128 * basis_points as i128;
let rounded: i128 = divide_rounded_away_from_zero(scaled, BASIS_POINTS_DENOMINATOR as i128);
CurrencyAmount {
minor_units: clamp_i128_to_i64(rounded),
currency: self.currency,
}
}
/// 按「一小时 = 60 分钟」的比例折算:`self × minutes / 60`。
///
/// 参数 `minutes`:分钟数。
/// 返回:折算后的金额。
///
/// ## 为什么需要这个入口,而不是在外面写 `× minutes / 60`
///
/// 本工程的人力成本公式是「时薪 × 计薪分钟数 / 60」。
/// 若各处自己写这个式子,会出现两种不一致的口径:
/// - 有人先算 `minutes / 60`(整数除法 → 丢掉不足一小时的分钟);
/// - 有人先乘后除(正确)。
///
/// 前者会在 420 分钟(7 小时整)时恰好正确,
/// 而在 390 分钟(6.5 小时)时把结果算成 6 小时的钱------
/// **且这个错误只在「非整小时」的班次上出现**,
/// 而本工程的盘点夜班恰好是 390 分钟。这类「只在部分数据上出错」
/// 的 bug 最难发现,因此必须把公式收进一个统一入口。
///
/// 内部用 `i128` 承载乘积,全程只舍入一次。
pub fn scale_by_minute_fraction(&self, minutes: u32) -> CurrencyAmount {
let numerator: i128 = self.minor_units as i128 * minutes as i128;
// 分母固定为 60(一小时 60 分钟),这是时间单位换算的定义,不是业务参数。
let rounded: i128 = divide_rounded_away_from_zero(numerator, 60i128);
CurrencyAmount {
minor_units: clamp_i128_to_i64(rounded),
currency: self.currency,
}
}
/// 返回 `¥1,234.56` 形式的展示文本。
///
/// 实现要点:
/// 1. 负数先分离符号,绝对值参与分拆(否则 `-1234 % 100` 会得到 `-34`);
/// 2. 按币种的 `minor_units_per_major_unit` 拆分主单位与最小单位
/// ------**不要硬编码 100**。日元没有最小单位(`minor_units_per_major_unit = 1`),
/// 硬编码 100 会把 ¥1000 显示成 ¥10.00;
/// 3. 千分位由自由函数插入。
pub fn formatted(&self) -> String {
let sign: &str = if self.minor_units < 0 { "-" } else { "" };
let absolute_value: i64 = self.minor_units.saturating_abs();
let unit_scale: i64 = self.currency.minor_units_per_major_unit();
// 主单位部分与最小单位部分。
let major_part: i64 = absolute_value / unit_scale;
let minor_part: i64 = absolute_value % unit_scale;
// 最小单位的补零宽度由 `unit_scale` 决定:100 → 2 位,1 → 0 位,1000 → 3 位。
let minor_digits: usize = decimal_digits_of(unit_scale);
if minor_digits == 0 {
// 无最小单位(如日元):不输出小数点。
format!(
"{}{}{}",
sign,
self.currency.symbol(),
insert_thousands_separator(major_part)
)
} else {
format!(
"{}{}{}.{:0width$}",
sign,
self.currency.symbol(),
insert_thousands_separator(major_part),
minor_part,
width = minor_digits
)
}
}
/// 返回 `1234.56 CNY` 形式的展示文本(金额 + 币种编码)。
///
/// 用于「多币种并列」的场景:符号 `¥` 与 `HK$` 并排时容易看混,
/// 加上币种编码可以消歧。本工程的深圳/中国香港双币种报表会用到。
pub fn formatted_with_currency_code(&self) -> String {
let sign: &str = if self.minor_units < 0 { "-" } else { "" };
let absolute_value: i64 = self.minor_units.saturating_abs();
let unit_scale: i64 = self.currency.minor_units_per_major_unit();
let major_part: i64 = absolute_value / unit_scale;
let minor_part: i64 = absolute_value % unit_scale;
let minor_digits: usize = decimal_digits_of(unit_scale);
if minor_digits == 0 {
format!(
"{}{} {}",
sign,
insert_thousands_separator(major_part),
self.currency.code()
)
} else {
format!(
"{}{}.{:0width$} {}",
sign,
insert_thousands_separator(major_part),
minor_part,
self.currency.code(),
width = minor_digits
)
}
}
}
/// 把 i128 安全钳制到 i64 范围。
///
/// 参数 value:待钳制的值。
/// 返回:落在 i64::MIN..=i64::MAX 内的值。
///
/// 这是本工程唯一的「溢出兜底」函数,所有 i128 → i64 的回落都走它,
/// 避免在多处各写一遍边界判断(那样迟早会漏掉一处)。
pub const fn clamp_i128_to_i64(value: i128) -> i64 {
if value > i64::MAX as i128 {
i64::MAX
} else if value < i64::MIN as i128 {
i64::MIN
} else {
value as i64
}
}
/// 整数除法,远离零方向四舍五入。
///
/// 参数 numerator / denominator。
/// 返回:舍入后的商。
///
/// ## 为什么不用 (a + b/2) / b
///
/// 那个写法有四个问题,本工程的金额核算依赖此函数,因此必须写对:
/// 1. 只对正数成立:-7/2 用该式得到 -3(向零),而「远离零」应为 -4;
/// 2. 中途相加可能溢出:a + b/2 在 a 接近上界时会溢出;
/// 3. b 为负时不成立;
/// 4. 它不是显式的:读者要从表达式反推舍入方向。
///
/// 本实现用「取商 + 取余 + 按余数修正」的显式步骤,
/// 每一步的舍入方向都写在注释里,可被逐行核对。
pub const fn divide_rounded_away_from_zero(numerator: i128, denominator: i128) -> i128 {
if denominator == 0 {
// 除零:返回 0 而非 panic。业务上不会有零分母,
// 但报表崩掉比出现一个可疑的 0 更难排查------错误要可见。
return 0;
}
// 第一步:取商的整数部分(Rust 的整数除法天然向零截断)。
let quotient: i128 = numerator / denominator;
// 第二步:取余数,判断是否需要进位/借位。
let remainder: i128 = numerator % denominator;
if remainder == 0 {
// 整除,无舍入。
return quotient;
}
// 第三步:符号一致时「远离零」,即商的绝对值加 1。
// numerator 与 denominator 同号 ⇒ 结果为正 ⇒ 加 1;
// 异号 ⇒ 结果为负 ⇒ 减 1。两者都是「远离零」。
let same_sign: bool = (numerator > 0) == (denominator > 0);
if same_sign {
quotient + 1
} else {
quotient - 1
}
}
/// 返回一个整数对应的十进制位数(用于最小单位的补零宽度)。
///
/// 参数 value:正整数(传入 1 / 100 / 1000)。
/// 返回:位数(1 → 0,100 → 2,1000 → 3)。
///
/// 定义:value = 10^n 时返回 n;其余情况返回 1 作为兜底。
/// 用 match 精确列出而非 log10 取对数------log10 会引入浮点,
/// 而本工程「全程无浮点」是硬性纪律。
pub const fn decimal_digits_of(value: i64) -> usize {
match value {
1 => 0,
10 => 1,
100 => 2,
1_000 => 3,
10_000 => 4,
// 非常见取值范围:按 1 位处理,保证不 panic。
_ => 1,
}
}
/// 给整数的十进制文本插入千分位分隔符。
///
/// 参数 value:非负整数。
/// 返回:形如 1,234,567 的文本。
///
/// 实现思路(从右往左每三位一插):
/// 先把数字转字符串,再从个位方向每 3 位打一个逗号。
/// 用「临时字符数组 + 反向读取」而不是「按位置切片拼接」,
/// 后者在字符串长度不是 3 的倍数时要处理前导不足,分支更多。
fn insert_thousands_separator(value: i64) -> String {
let digits: String = value.to_string();
let digit_bytes: &[u8] = digits.as_bytes();
let mut buffer: Vec<char> = Vec::with_capacity(digit_bytes.len() + digit_bytes.len() / 3);
// 反向遍历:reversed_index 是「从右数第几位」(0 基)。
let mut reversed_index: usize = 0;
while reversed_index < digit_bytes.len() {
// 不是最右一位、且已满 3 的倍数 → 先放一个逗号。
if reversed_index > 0 && reversed_index % 3 == 0 {
buffer.push(',');
}
// 取「从右数第 reversed_index 位」的字符(ASCII 数字,直接按字节取即可)。
let byte_position: usize = digit_bytes.len() - 1 - reversed_index;
buffer.push(digit_bytes[byte_position] as char);
reversed_index += 1;
}
// buffer 是反的,倒回来。
buffer.reverse();
buffer.into_iter().collect()
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : pay_period_kind.rs
//! # 计薪时段类型 ------ 开放型标签
//!
//! ## 为什么时段类型要进「班次模板的键」
//!
//! 同一个「早班」,在平日与法定节假日的时薪系数不同:
//! - 平日:系数 1.00;
//! - 周末:系数 1.10(客流高,公司主动上浮留人);
//! - 大促:系数 1.50;
//! - 法定节假日:系数 2.00(法定要求)。
//!
//! 这四种情形的「班次时刻、时长、休息」完全一样,只有系数不同。
//! 若把时段类型漏出键,早班模板就只能取一个系数------
//! 其余三种时段的排班成本会算错。
//!
//! 第四幕会把这个错误算成具体金额(若漏进键,全年人力成本会偏差数万元)。
//!
//! ## 与 ShiftCode::requires_security_presence 的对照
//!
//! 那个方法用「编码硬比较」判断是否需要安保,属于行为判断;
//! 本类型把「时段 → 系数」的映射放在标签自身的字段里,
//! 属于数据携带。两种做法在本工程里并存,是因为:
//! - 安保需求是「少数班次才有的特例」,写成集中的一处判断更易读;
//! - 时段系数是「每种时段都有值」,放在字段里可免除任何 match。
//!
//! 判断标准:特例用集中判断,普适值用字段携带。
// 同层引用:系数类型。
use super::ratio::Ratio;
/// 一个计薪时段类型标签。
///
/// 身份即 code,手写相等与哈希(理由见 ShiftCode)。
#[derive(Debug, Clone, Copy)]
pub struct PayPeriodKind {
/// 时段编码(如 "HOLIDAY")。唯一参与相等与哈希的字段。
code: &'static str,
/// 中文名称(如 "法定节假日")。
display_name: &'static str,
/// 该时段的时薪上浮系数(万分点)。Ratio::one() 表示不上浮。
surcharge_multiplier: Ratio,
}
impl PartialEq for PayPeriodKind {
/// 只用编码比较身份。
fn eq(&self, other: &PayPeriodKind) -> bool {
self.code == other.code
}
}
impl Eq for PayPeriodKind {}
impl std::hash::Hash for PayPeriodKind {
/// 只把编码喂给 hasher,与 PartialEq 口径一致。
fn hash<H: std::hash::Hasher>(&self, state: &mut H) {
self.code.hash(state);
}
}
impl PayPeriodKind {
/// 构造一个时段类型。
///
/// 参数 code / display_name / surcharge_multiplier。
/// 返回:时段类型标签。
pub const fn new(
code: &'static str,
display_name: &'static str,
surcharge_multiplier: Ratio,
) -> PayPeriodKind {
PayPeriodKind {
code,
display_name,
surcharge_multiplier,
}
}
/// 时段编码。
pub const fn code(&self) -> &'static str {
self.code
}
/// 中文名称。
pub const fn display_name(&self) -> &'static str {
self.display_name
}
/// 时薪上浮系数。
pub const fn surcharge_multiplier(&self) -> Ratio {
self.surcharge_multiplier
}
/// 是否为「上浮时段」(系数大于 1 倍)。
///
/// 报表用它把排班表里需要额外计薪的时段标出来。
pub const fn is_surcharged(&self) -> bool {
self.surcharge_multiplier.is_above_one()
}
}
/// 平日:不上浮。
pub const PAY_PERIOD_NORMAL: PayPeriodKind =
PayPeriodKind::new("NORMAL", "平日", Ratio::one());
/// 周末:上浮 10%。
pub const PAY_PERIOD_WEEKEND: PayPeriodKind =
PayPeriodKind::new("WEEKEND", "周末", Ratio::from_basis_points(11_000));
/// 大促:上浮 50%。
pub const PAY_PERIOD_PROMOTION: PayPeriodKind =
PayPeriodKind::new("PROMOTION", "大促", Ratio::from_basis_points(15_000));
/// 法定节假日:上浮 100%(法定要求)。
pub const PAY_PERIOD_HOLIDAY: PayPeriodKind =
PayPeriodKind::new("HOLIDAY", "法定节假日", Ratio::from_basis_points(20_000));
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : ratio.rs
//! # 比率 ------ 整数万分比
//!
//! ## 为什么是「万分比」而不是「百分比」
//!
//! 排班场景里出现的比率精度差异很大:
//! - 时薪系数:夜班 1.25 倍 → 需要 2 位小数(12500 万分点);
//! - 加班附加率:1.5 倍 → 同上;
//! - 起征/阈值:85.5% → 需要 1 位小数(8550 万分点);
//! - 法定倍率:2 倍 → 整数倍。
//!
//! 若用百分比(分母 100),1.25 倍就只能写成 125% 再加一个「倍」的单位,
//! 一旦出现 1.125 倍(如节假日加班)就没法表达了。
//! 万分比的精度足以覆盖所有常见业务倍率,且分母固定为 10000,
//! 所有比率的乘除都走同一个常量,将来改精度只改一处。
//!
//! ## 「零比率」也要走统一运算路径
//!
//! 免税、免加班费等场景需要「零倍率」。不要在调用点写成
//! CurrencyAmount::zero(...) 绕过本类型------那样将来「零」的口径变化
//! (比如某地区规定最低倍率 1.0)就要翻遍所有调用点。
//! 正确做法是写 Ratio::zero().apply_to(amount),
//! 让「零」也经过统一路径。这条经验来自同系列 Abstract Factory 工程。
// 同层引用:apply_to 需要金额类型。同层模块互引不违反分层约束
// (依赖方向检查只看层与层),但不要形成密集的双向网。
use super::currency_amount::CurrencyAmount;
/// 万分比表示的一个比率。
///
/// basis_points 为 10000 时表示 1 倍(100%)。
/// 可为负:经济型班次或淡季下调系数时为负值(如 -800 表示 -8%)。
#[derive(Debug, Clone, Copy, PartialEq, Eq, PartialOrd, Ord, Hash)]
pub struct Ratio {
/// 万分点。10000 = 1 倍 = 100%。
basis_points: i64,
}
/// 万分比的分母。
///
/// 本工程所有比率运算共用此常量。它被导出的唯一理由是:
/// 「分析层」在把万分点转成展示文本时需要它,
/// 而「硬编码 10000」在分析层出现两遍以上就会成为漂移源。
pub const BASIS_POINTS_DENOMINATOR: i64 = 10_000;
impl Ratio {
/// 由万分点构造。
///
/// 参数 basis_points:万分点。
/// 返回:比率。
pub const fn from_basis_points(basis_points: i64) -> Ratio {
Ratio { basis_points }
}
/// 零比率(0%)。
pub const fn zero() -> Ratio {
Ratio { basis_points: 0 }
}
/// 一倍(100%)。
pub const fn one() -> Ratio {
Ratio {
basis_points: BASIS_POINTS_DENOMINATOR,
}
}
/// 万分点值。
pub const fn basis_points(&self) -> i64 {
self.basis_points
}
/// 是否为零。
pub const fn is_zero(&self) -> bool {
self.basis_points == 0
}
/// 是否大于另一比率。
pub const fn is_greater_than(&self, other: &Ratio) -> bool {
self.basis_points > other.basis_points
}
/// 是否大于 1 倍(100%)。
///
/// 排班报表用这个判定标出「上浮」项(加班、夜班、节假日),
/// 与「下调」项(淡季减班)区分开。
pub const fn is_above_one(&self) -> bool {
self.basis_points > BASIS_POINTS_DENOMINATOR
}
/// 把一个金额按本比率缩放。
///
/// 参数 `amount`:待缩放的金额。
/// 返回:缩放后的金额。
///
/// 这是**唯一**的比率→金额运算路径。
/// 调用方不要自己写 `amount.minor_units() * bp / 10000`------
/// 那样的表达式会绕过舍入口径(`divide_rounded_away_from_zero`),
/// 造成「同一笔钱在不同代码路径下差 1 分」的问题。
pub fn apply_to(&self, amount: &CurrencyAmount) -> CurrencyAmount {
amount.scale_by_basis_points(self.basis_points)
}
/// 返回百分比文本,如 `125.00%`。
///
/// 拆法:整数部分 = `基点数 / 100`,小数部分 = `基点数 % 100`。
/// 也就是「基点数 / 10000」的分数形式换算成百分比后的两位小数。
pub fn as_percent_text(&self) -> String {
// 取绝对值参与分拆,符号单独处理(否则 -12500 % 100 得 -0,展示成 "-125.-0%")。
let absolute_value: i64 = self.basis_points.abs();
let whole_part: i64 = absolute_value / 100;
let fractional_part: i64 = absolute_value % 100;
let sign: &str = if self.basis_points < 0 { "-" } else { "" };
format!("{}{}.{:02}%", sign, whole_part, fractional_part)
}
/// 返回倍数文本,如 `1.2500 倍`。
///
/// 小数部分直接取万分点的后四位,得到 4 位小数。
/// 与 `as_percent_text` 的区别在于:百分比把 10000 当整体(100%),
/// 倍数把 10000 当 1。报表里两个口径都会用到,
/// 「时薪系数」用倍数更直观,「上浮比例」用百分比更直观。
pub fn as_multiplier_text(&self) -> String {
let absolute_value: i64 = self.basis_points.abs();
let whole_part: i64 = absolute_value / BASIS_POINTS_DENOMINATOR;
let fractional_part: i64 = absolute_value % BASIS_POINTS_DENOMINATOR;
let sign: &str = if self.basis_points < 0 { "-" } else { "" };
// 小数部分补零到 4 位(万分位)。
format!("{}{}.{:04} 倍", sign, whole_part, fractional_part)
}
/// 返回原始万分点文本,如 `12500 万分点`。
///
/// 调试与核对时用:看到 `12500` 就能立刻确认是 1.25 倍,
/// 不会被百分比与倍数两套口径绕晕。
pub fn as_basis_points_text(&self) -> String {
format!("{} 万分点", self.basis_points)
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : shift_code.rs
//! # 班次编码 ------ 开放型标签
//!
//! ## 为什么班次编码是开放型而不是枚举
//!
//! 珠宝零售商的班次种类会随经营节奏增加:
//! 常规的早/中/晚班、盘点夜班、节庆加强班、VIP 预约专场、培训专场......
//! 每新增一种就改一次 domain 层,等于「扩展要动核心」。
//! 用 const fn new 结构体后,扩展者在自己代码里定义即可:
//!
//! ignore //! // 工程外(main.rs 的扩展区),domain 层一行未改 //! const SHIFT_CODE_VIP_APPOINTMENT: ShiftCode = //! ShiftCode::new("VIP_APP", "VIP 预约班", 45); //!
//!
//! ## 但这个标签不只是「名字」
//!
//! display_order 字段让排序成为标签自身的能力,而不是在外层写
//! 一个 match 去映射编码→顺序。若用外层 match,新增班次时那段
//! match 会被漏改(编译器不会报错,因为 _ => ... 兜底分支吞掉了一切),
//! 从而产生「新班次排在最后」这类静默错误。
//! 把顺序放进标签,新增班次时必须给出顺序,否则构造不出来。
//!
//! 这条经验来自同系列 Abstract Factory 工程:「登记表把选择从编译期
//! match 提升为运行期数据」,此处是同一思路的局部应用。
/// 一个班次的编码标签。
///
/// 本类型只描述「这是哪种班次」,不含任何时长、时刻、系数等排班参数
/// ------那些是 flyweight::ShiftTemplate 的内容。
/// 编码标签是键的一部分(决定共享粒度),模板是被共享的享元本体。
/// 分开的理由:键要尽量窄(键越小,池的索引越省内存),
/// 而享元本体则要包含全部展示与计算所需的信息。
///
/// ## 相等与哈希是手写的,不派生(这个选择很关键)
///
/// 本类型有 code / display_name / display_order 三个字段。
/// 若直接 #[derive(PartialEq, Eq, Hash)],三个字段全部参与比较与哈希------
/// 于是「编码相同但显示名拼法不同」的两个标签会被判为不相等,
/// 享元池里就会为同一个班次建两个模板,共享率凭空下降。
///
/// 身份即编码。因此手写实现,只让 code 参与:
/// - PartialEq:code 相同即相等;
/// - Hash:只把 code 喂给 hasher。
///
/// 这条纪律对所有会作为池键的类型都适用(见 SkillGrade、
/// PayPeriodKind、StoreGrade)。派生看起来很省事,
/// 但它把「展示字段」误当成「身份字段」,是享元池最常见的静默缺陷来源。
#[derive(Debug, Clone, Copy)]
pub struct ShiftCode {
/// 编码(如 "EARLY")。唯一参与相等与哈希的字段。
code: &'static str,
/// 中文名称(如 "早班")。仅展示,不参与相等与哈希。
display_name: &'static str,
/// 展示顺序(升序排列)。仅展示,不参与相等与哈希。
display_order: u16,
}
impl PartialEq for ShiftCode {
/// 只用编码比较身份。
fn eq(&self, other: &ShiftCode) -> bool {
self.code == other.code
}
}
// 手写 PartialEq 后必须显式实现 Eq:
// 这是对「相等满足自反/对称/传递」的承诺。本实现满足(底层是 str 比较)。
impl Eq for ShiftCode {}
impl std::hash::Hash for ShiftCode {
/// 只把编码喂给 hasher,与 PartialEq 的口径保持一致。
///
/// ⚠️ 若 PartialEq 与 Hash 口径不一致(一个比三个字段、
/// 一个只哈希一个字段),HashMap 的行为是未定义的------
/// 表现为「明明存在的键查不到」,且难以复现。
/// 因此这两个实现必须成对修改,永远一起看。
fn hash<H: std::hash::Hasher>(&self, state: &mut H) {
self.code.hash(state);
}
}
impl ShiftCode {
/// 构造一个班次编码。
///
/// 参数 code / display_name / display_order。
/// 返回:班次编码标签。
pub const fn new(
code: &'static str,
display_name: &'static str,
display_order: u16,
) -> ShiftCode {
ShiftCode {
code,
display_name,
display_order,
}
}
/// 编码。
pub const fn code(&self) -> &'static str {
self.code
}
/// 中文名称。
pub const fn display_name(&self) -> &'static str {
self.display_name
}
/// 展示顺序。
pub const fn display_order(&self) -> u16 {
self.display_order
}
/// 是否为需要「双人在场」的班次。
///
/// 珠宝门店的硬性规定:**任何班次都必须至少两人**(防内盗)。
/// 但「是否需要额外加一名安保」只对特定班次成立------
/// 夜班盘点涉及开保险柜,需要安保在场。
///
/// ## 为什么用编码判断而不是加一个字段
///
/// 加字段(`requires_security: bool`)会让「哪些班次需要安保」这个事实
/// 散落到每个常量定义处。而用编码判断,这个知识集中在**一处**,
/// 且新增班次时若漏了这里,编译器不会报错但**行为可见**------
/// 报表里新班次会显示「无需安保」,一眼能看出问题。
///
/// 两种做法各有风险,本工程选「集中判断」,并在注释里说明取舍。
/// 更好的做法是把它做成可配置的登记表,但那会增加本工程与
/// Abstract Factory 工程的重叠度,因此这里刻意保持在简单形态。
pub fn requires_security_presence(&self) -> bool {
// 盘点夜班涉及开柜,需要安保。
self.code == SHIFT_CODE_NIGHT_AUDIT.code
}
}
/// 早班:09:00 - 17:00。
pub const SHIFT_CODE_EARLY: ShiftCode = ShiftCode::new("EARLY", "早班", 10);
/// 中班:13:00 - 21:00。
pub const SHIFT_CODE_MIDDLE: ShiftCode = ShiftCode::new("MIDDLE", "中班", 20);
/// 晚班:15:00 - 23:00。
pub const SHIFT_CODE_LATE: ShiftCode = ShiftCode::new("LATE", "晚班", 30);
/// 盘点夜班:22:30 - 次日 06:30(开保险柜,需安保在场)。
pub const SHIFT_CODE_NIGHT_AUDIT: ShiftCode = ShiftCode::new("NIGHT_AUDIT", "盘点夜班", 40);
/// 周末加强班:10:00 - 19:00(客流高峰,工时更长)。
pub const SHIFT_CODE_WEEKEND_BOOST: ShiftCode = ShiftCode::new("WEEKEND_BOOST", "周末加强班", 50);
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : skill_grade.rs
//! # 技能等级 ------ 开放型标签
//!
//! ## 为什么技能等级是开放型
//!
//! 珠宝零售的技能分级会随品类扩张而细化:
//! 见习 → 初级 → 中级 → 高级 → 技师 → (将来可能有)珠宝鉴定师、镶嵌师......
//! 每加一级都要改 domain,就违反了「工程外可扩展」。
//!
//! ## 与班次模板的关系
//!
//! 「技能等级」是班次模板的键的一部分(见 flyweight::shift_template_key):
//! 同一个「晚班」,对「初级」与「高级」员工是两个不同的模板------
//! 因为两人的时薪基数与法定持证要求不同。
//! 这就是享元键必须包含的维度:凡影响享元内容的因素都要进键。
//!
//! 反过来说:如果把技能等级漏出键,晚班模板就只能取一个等级,
//! 另一个等级的员工会被套用错误时薪。第五幕会把这个错误算成具体金额。
// 同层内引用:Ratio 与本文件同属 domain 层,用 super 相对路径。
// 不用 crate::domain::ratio::Ratio 这种从根写起的长路径------
// 同层引用写长路径会让「这是同层依赖」这个事实在代码里看不出来。
use super::ratio::Ratio;
/// 一个技能等级标签。
///
/// 与 [super::shift_code::ShiftCode] 同样手写相等与哈希:
/// 身份即 code,display_name / hourly_base_multiplier /
/// requires_certification 都是随编码决定的派生属性,不参与身份比较。
/// 理由见 ShiftCode 的文档------派生会把展示字段误当身份字段。
#[derive(Debug, Clone, Copy)]
pub struct SkillGrade {
/// 等级编码(如 "SENIOR")。唯一参与相等与哈希的字段。
code: &'static str,
/// 中文名称(如 "高级")。
display_name: &'static str,
/// 相对时薪基数(万分点)。10000 表示基数本身,12000 表示基数上浮 20%。
///
/// ## 为什么时薪基数放在等级上而不是员工上
///
/// 若放在员工上(每人一个时薪),则「同等级员工时薪相同」这一
/// 公司政策就无法在类型上体现,且排班成本核算要遍历每个员工。
/// 放在等级上后,时薪 = 等级基数 × 班次系数 × 门店系数,
/// 三个因子都是可共享的内在状态------这正是享元模式的着力点。
///
/// 员工的个体差异(如工龄津贴)通过「外在状态」表达(见 client 层),
/// 不进享元。
hourly_base_multiplier: Ratio,
/// 该等级是否需要持证上岗(如贵金属鉴定证)。
requires_certification: bool,
}
impl PartialEq for SkillGrade {
/// 只用编码比较身份。
fn eq(&self, other: &SkillGrade) -> bool {
self.code == other.code
}
}
impl Eq for SkillGrade {}
impl std::hash::Hash for SkillGrade {
/// 只把编码喂给 hasher,与 PartialEq 口径一致。
fn hash<H: std::hash::Hasher>(&self, state: &mut H) {
self.code.hash(state);
}
}
impl SkillGrade {
/// 构造一个技能等级。
///
/// 参数 code / display_name / hourly_base_multiplier / requires_certification。
/// 返回:技能等级标签。
pub const fn new(
code: &'static str,
display_name: &'static str,
hourly_base_multiplier: Ratio,
requires_certification: bool,
) -> SkillGrade {
SkillGrade {
code,
display_name,
hourly_base_multiplier,
requires_certification,
}
}
/// 等级编码。
pub const fn code(&self) -> &'static str {
self.code
}
/// 中文名称。
pub const fn display_name(&self) -> &'static str {
self.display_name
}
/// 相对时薪基数(万分点)。
pub const fn hourly_base_multiplier(&self) -> Ratio {
self.hourly_base_multiplier
}
/// 是否需要持证上岗。
pub const fn requires_certification(&self) -> bool {
self.requires_certification
}
}
/// 见习:基数 80%,无需持证。
pub const SKILL_GRADE_PROBATION: SkillGrade =
SkillGrade::new("PROBATION", "见习", Ratio::from_basis_points(8_000), false);
/// 初级:基数 100%,无需持证。
pub const SKILL_GRADE_JUNIOR: SkillGrade =
SkillGrade::new("JUNIOR", "初级", Ratio::from_basis_points(10_000), false);
/// 高级:基数 120%,需持证。
pub const SKILL_GRADE_SENIOR: SkillGrade =
SkillGrade::new("SENIOR", "高级", Ratio::from_basis_points(12_000), true);
/// 技师:基数 145%,需持证(可负责鉴定与镶嵌)。
pub const SKILL_GRADE_TECHNICIAN: SkillGrade =
SkillGrade::new("TECHNICIAN", "技师", Ratio::from_basis_points(14_500), true);
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : staff_number.rs
//! # 员工工号 ------ 带校验的标识
//!
//! ## 与其他两个标签的区别:它有校验逻辑
//!
//! StoreCode 与 ShiftCode 只是「包装过的字符串」,
//! 而工号在真实系统里有格式约束(本工程约定为 字母 + 6 位数字,
//! 如 E100234)。把这个约束放进类型,好处是排班槽位在构造时就拦截脏数据。
//!
//! ## 为什么校验失败不 panic
//!
//! 与同工程其他「fail visible」选择一致:本工程的工号可能来自
//! 工程外扩展区的演示数据。若构造非法工号直接 panic,
//! 整个演示崩掉、什么都看不到。因此 [StaffNumber::from_text]
//! 返回 Option,由调用方决定如何处理------
//! 在 main.rs 的演示数据构造处,调用方会 expect 并以明确信息报错,
//! 因为这属于工程自身的数据错误,应当立即暴露。
/// 一个员工工号。
///
/// 内部存的是原始文本而不是解析后的数字:
/// 工号可能带前缀字母(E100234),且报表要原样打印。
/// 若只存数字部分,展示时还要把字母拼回去------反而多一份状态。
#[derive(Debug, Clone, Copy, PartialEq, Eq, Hash, PartialOrd, Ord)]
pub struct StaffNumber {
/// 工号文本(已校验格式)。
text: &'static str,
}
impl StaffNumber {
/// 校验并构造一个工号。
///
/// 参数 text:工号文本。
/// 返回:格式合法时返回 Some,否则 None。
///
/// 格式约定:恰好 1 个大写字母 + 恰好 6 位数字,共 7 个字符。
/// 例:E100234、S008877。
///
/// ## 为什么要求 &'static str
///
/// 本工程所有标识都取自预置常量或演示数据(都是 'static)。
/// 用 &'static str 让 StaffNumber 保持 Copy(8 字节指针),
/// 若改成 String 会变成 24 字节 + 堆分配------
/// 而排班槽位里有工号字段,这个宽度差异会乘以数万倍。
/// 这是享元工程必须计较的地方。
pub fn from_text(text: &'static str) -> Option<StaffNumber> {
let bytes: &[u8] = text.as_bytes();
// 长度必须恰好 7。
if bytes.len() != 7 {
return None;
}
// 首位必须是大写字母 A-Z。
if !bytes[0].is_ascii_uppercase() {
return None;
}
// 后 6 位必须都是数字 0-9。
for position in 1..7 {
if !bytes[position].is_ascii_digit() {
return None;
}
}
Some(StaffNumber { text })
}
/// 工号文本。
pub const fn text(&self) -> &'static str {
self.text
}
/// 工号所属的字母前缀(如 `'E'`)。
///
/// 前缀表示岗位大类(`E` = 营业员,`S` = 安保,`M` = 店长)。
/// 报表按前缀分组时用得到。
///
/// 安全性:`from_text` 已保证首字符是大写 ASCII 字母,
/// 因此 `unwrap` 在类型不变式下不可能 panic。
/// 这里用 `expect` 而非 `unwrap`,是为了在万一不变量被破坏时
/// 给出「哪个不变量」的信息,而不是一个光秃秃的 panic。
pub fn position_prefix(&self) -> char {
self.text
.chars()
.next()
.expect("StaffNumber 的不变式保证首字符存在(from_text 已校验长度 7)")
}
/// 工号尾号(后 4 位),用于报表脱敏展示。
///
/// 报表打印工号时用 `E**0234` 形式,只露首字母与末 4 位。
/// 这是**演示工程里的刻意设计**:真实系统应更谨慎,
/// 但把「脱敏逻辑集中在类型上」这个做法本身是值得示范的------
/// 若散落在各处拼接,迟早有一处忘记脱敏。
pub fn masked_text(&self) -> String {
let characters: Vec<char> = self.text.chars().collect();
// 形如:首字符 + 两个星号 + 末 4 位(丢弃中间 2 位)。
// `from_text` 保证长度恰为 7,因此 `characters[3..7]` 必定合法。
format!(
"{}**{}",
characters[0],
characters[3..7].iter().collect::<String>()
)
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : store_code.rs
//! # 门店编码 ------ 开放型标签
//!
//! ## 为什么单独建一个类型而不是直接传 &str
//!
//! 排班槽位的种子是「门店编码 + 日期 + 班次编码」。
//! 若三者都是 &str,调用点写成 build_seed(&[store, date, shift]) 时,
//! 实参顺序写反编译器不会报错------&str、&str、&str 三个参数同型。
//! 这种错误一旦发生,排班编号会全线偏移,而报表看起来完全正常。
//!
//! 用 newtype 后,参数类型各不相同,顺序错位立刻是编译错误。
//! 这是 newtype 最经典的价值:用类型承载「这个字符串是什么」的语义。
//!
//! ## 为什么 store_grade 与编码分开
//!
//! 同一家门店在长期经营中可能升级(社区店 → 标准店 → 旗舰店)。
//! 等级影响排班配置(最低人数、是否配安保),编码不变。
//! 因此 StoreCode(身份)与 StoreGrade(等级)必须是两个独立维度------
//! 把它们揉成一个类型,门店升级时就要改所有历史排班的键。
/// 一家门店的编码标签。
#[derive(Debug, Clone, Copy, PartialEq, Eq, Hash)]
pub struct StoreCode {
/// 门店编码(如 "SZ0001"),形如「城市缩写 + 4 位序号」。
code: &'static str,
/// 城市名称(如 "深圳"),用于报表分组。
city_name: &'static str,
}
impl StoreCode {
/// 构造一个门店编码。
///
/// 参数 code / city_name。
/// 返回:门店编码标签。
pub const fn new(code: &'static str, city_name: &'static str) -> StoreCode {
StoreCode { code, city_name }
}
/// 门店编码。
pub const fn code(&self) -> &'static str {
self.code
}
/// 城市名称。
pub const fn city_name(&self) -> &'static str {
self.city_name
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : store_grade.rs
//! # 门店等级 ------ 开放型标签
//!
//! ## 门店等级是本工程的「第二个享元族」
//!
//! 连锁零售商的门店分档经营:旗舰店(重点商圈、面积大)/
//! 标准店 / 社区店。同一档的门店运营配置完全相同:
//! 每日最低在岗人数、是否配专职安保、营业时段、是否需要每日盘点。
//!
//! 1000 家门店只对应 3~5 个等级配置。若每家门店各自持有一份配置副本,
//! 就是 1000 份重复数据;而用享元共享后只需 3~5 份。
//!
//! 为什么这比「班次模板」更能说明享元的价值:
//! 班次模板的共享是「同一模板被多个槽位引用」,
//! 而门店等级的共享是「同一配置被多个不同实体(门店)引用」------
//! 后者更接近 GoF 原书里「字符对象的字形数据」的例子
//! (字形被多个字符位置共享)。
//!
//! 本工程同时实现两族享元,并让它们共用同一个泛型池
//! (flyweight::shared_pool),以此证明「享元机制本身可复用」,
//! 而不只是「某一种对象可以共享」。
//!
//! ## 门店等级会影响排班,但不进班次模板的键
//!
//! 门店等级改变的是「需要几个班次」「是否需要安保」,
//! 而不是「某个班的时长与系数」。因此它是 client 层的排班配置,
//! 不是班次享元的一部分。分清「进键的维度」与「在外层的维度」
//! 是享元设计最容易出错的地方------第三幕专门演示这个错误。
/// 一个门店等级标签。
///
/// 与 [super::shift_code::ShiftCode] 同样手写相等与哈希:身份即 code。
/// 本类型会作为 flyweight::StoreGradeProfile 的池键,
/// 因此身份口径必须精确------否则同一等级会被建成两个享元。
#[derive(Debug, Clone, Copy)]
pub struct StoreGrade {
/// 等级编码(如 "FLAGSHIP")。唯一参与相等与哈希的字段。
code: &'static str,
/// 中文名称(如 "旗舰店")。
display_name: &'static str,
}
impl PartialEq for StoreGrade {
/// 只用编码比较身份。
fn eq(&self, other: &StoreGrade) -> bool {
self.code == other.code
}
}
impl Eq for StoreGrade {}
impl std::hash::Hash for StoreGrade {
/// 只把编码喂给 hasher,与 PartialEq 口径一致。
fn hash<H: std::hash::Hasher>(&self, state: &mut H) {
self.code.hash(state);
}
}
impl StoreGrade {
/// 构造一个门店等级。
pub const fn new(code: &'static str, display_name: &'static str) -> StoreGrade {
StoreGrade { code, display_name }
}
/// 等级编码。
pub const fn code(&self) -> &'static str {
self.code
}
/// 中文名称。
pub const fn display_name(&self) -> &'static str {
self.display_name
}
}
/// 旗舰店:位于核心商圈,客流最大。
pub const STORE_GRADE_FLAGSHIP: StoreGrade = StoreGrade::new("FLAGSHIP", "旗舰店");
/// 标准店:位于成熟商圈。
pub const STORE_GRADE_STANDARD: StoreGrade = StoreGrade::new("STANDARD", "标准店");
/// 社区店:位于住宅区,客流稳定但规模小。
pub const STORE_GRADE_COMMUNITY: StoreGrade = StoreGrade::new("COMMUNITY", "社区店");
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : work_duration.rs
//! # 工时 ------ 整数分钟
//!
//! ## 为什么不用 ClockTime
//!
//! ClockTime 表示「一天内的某个点位」(0..=1439 且跨零点会绕圈)。
//! 而「工时」是一段长度:8 小时 = 480 分钟,可以是 0(休息),
//! 也可能超过一天(跨日连班在本工程里不存在,但类型不该禁止它)。
//!
//! 两者语义不同,混用会出问题:把 480 分钟当 ClockTime 会得到 08:00,
//! 这不是「8 小时」而是「早上八点」。因此分成两个类型。
//!
//! ## 为什么不用 std::time::Duration
//!
//! Duration 存「秒 + 纳秒」(16 字节)。工时只需要分钟粒度(业务上
//! 不存在「多上 30 秒」的排班),用 u32 分钟(4 字节)即可。
//! 省下的 12 字节乘以数万个排班槽位,是真实的内存差异------
//! 而本工程的核心论证正是内存。所以这里必须用最紧的类型。
//!
//! 这个取舍在普通项目里可能不值得(12 字节 × 3 万 = 360KB,可忽略),
//! 但享元工程的价值就在「把每个字段的宽度都算清楚」,
//! 因此本工程刻意选择紧类型,并在注释里说明理由。
/// 一段工时,以整数分钟计。
#[derive(Debug, Clone, Copy, PartialEq, Eq, PartialOrd, Ord, Hash)]
pub struct WorkDuration {
/// 分钟数。允许为 0(无休息)。
total_minutes: u32,
}
impl WorkDuration {
/// 由分钟数构造。
pub const fn from_minutes(total_minutes: u32) -> WorkDuration {
WorkDuration { total_minutes }
}
/// 由「时 + 分」构造。
///
/// 参数 `hours` / `minutes`。
/// 返回:工时。
pub const fn from_hours_and_minutes(hours: u32, minutes: u32) -> WorkDuration {
WorkDuration {
total_minutes: hours * 60 + minutes,
}
}
/// 零工时。
pub const fn zero() -> WorkDuration {
WorkDuration { total_minutes: 0 }
}
/// 分钟数。
pub const fn total_minutes(&self) -> u32 {
self.total_minutes
}
/// 是否为零。
pub const fn is_zero(&self) -> bool {
self.total_minutes == 0
}
/// 相加。
///
/// 用 `saturating_add`:两个「顶格」工时相加会回绕成很小的值,
/// 而饱和加法给出 `u32::MAX`------错误更容易被看出。
pub const fn add(&self, other: &WorkDuration) -> WorkDuration {
WorkDuration {
total_minutes: self.total_minutes.saturating_add(other.total_minutes),
}
}
/// 相减(不小于零)。
///
/// 参数 `other`:被减去的工时。
/// 返回:差值,若 `other` 更大则返回零。
///
/// 「不小于零」是业务约定:加班时长 = 实际工时 - 标准工时,
/// 若实际少于标准(早退),加班时长应为 0 而非负数。
/// 若业务需要负数语义(如「欠班」),应另加一个类型而不是改本函数------
/// 一个函数一种语义,才不会有「同一个减法在两种地方含义不同」的陷阱。
pub const fn subtract_floor_zero(&self, other: &WorkDuration) -> WorkDuration {
WorkDuration {
total_minutes: self.total_minutes.saturating_sub(other.total_minutes),
}
}
/// 求和(对一组工时)。
///
/// 参数 `durations`:工时切片。
/// 返回:总和。
///
/// 这是本工程最频繁执行的运算之一:数万个排班槽位的工时求和。
/// 用 `fold` 而非 `sum`:`sum` 需要实现 `Sum` trait,
/// 而 `saturating_add` 的饱和语义无法通过 `Sum` 表达。
pub fn sum(durations: &[WorkDuration]) -> WorkDuration {
let mut accumulated_minutes: u32 = 0;
for duration in durations {
accumulated_minutes = accumulated_minutes.saturating_add(duration.total_minutes);
}
WorkDuration {
total_minutes: accumulated_minutes,
}
}
/// 返回 `8 小时 0 分` 文本。
///
/// 排班表的「工时」列用这个口径:读「8 小时 30 分」比读「510 分钟」直观。
/// 但**只有展示**用这个口径,所有计算仍用分钟数。
pub fn formatted_hours_and_minutes(&self) -> String {
let hours: u32 = self.total_minutes / 60;
let minutes: u32 = self.total_minutes % 60;
format!("{} 小时 {} 分", hours, minutes)
}
/// 返回 `8.50` 形式的工时小时数文本(两位小数)。
///
/// 用于报表的「工时汇总」列:`8.50` 比 `8 小时 30 分` 更便于纵向对齐与口算。
/// 用整数运算得出两位小数(不借助浮点):
/// 分 = `minutes * 100 / 60`,再按百分位拆成小数。
///
/// ⚠️ 这里的除法**故意用截断而非四舍五入**:
/// `8 小时 20 分` = `500 * 100 / 60` = `833`(截断)→ `8.33`。
/// 若四舍五入会得到 `833`→ 同样是 `8.33`,但 `8 小时 10 分` = `816.67`
/// 截断得 `816`(`8.16`)、四舍得 `817`(`8.17`)。
/// 选截断的理由:`8.16` 与真实值 `8.1667` 之间的差距是「略微低估」,
/// 而报表读者对「工时」的心理预期是「不超过实际值」,低估比高估安全。
/// 这个选择必须写下来,否则会被人当 bug 改掉。
pub fn formatted_decimal_hours(&self) -> String {
// 先算「百分之一小时」的整数部分(截断)。
let hundredths_of_hour: u32 = self.total_minutes.saturating_mul(100) / 60;
let whole_hours: u32 = hundredths_of_hour / 100;
let fractional_hundredths: u32 = hundredths_of_hour % 100;
format!("{}.{:02}", whole_hours, fractional_hundredths)
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : footprint.rs
//! # 享元内存足迹 ------ 「共享省了多少内存」的度量契约
//!
//! ## 为什么需要这个 trait
//!
//! 享元模式的价值必须能被量化,否则「用了模式」与「没用模式」
//! 只是两种写法,说不出哪个更好。本工程要回答的问题是:
//!
//! > 若每个排班槽位各自持有一份完整的班次定义,需要多少字节?
//! > 用享元共享后,实际需要多少字节?差多少?差在哪?
//!
//! 回答它需要一个「这个享元占多少字节」的口径。而 std::mem::size_of
//! 只统计栈上部分,不含 String / Vec 等堆分配的内容------
//! 而真实对象的内存开销恰恰大量来自堆。因此本 trait 要求类型自报足迹:
//! 栈内固定部分(size_of)+ 堆上内容(按内容长度计)。
//!
//! ## 口径的诚实性声明(重要)
//!
//! 本工程计算的是「逻辑字节数」,不是「进程 RSS 增量」。差异有三处,
//! 必须明说,否则读者会把数字当成精确值:
//!
//! 1. 不含分配器元数据。malloc 每个分配块有 8~16 字节头部,
//! 还有最小分配粒度与对齐填充。本工程不计这些。
//! 2. 按内容长度计,不按容量计。String 的实际容量可能大于长度
//! (push_str 的摊还增长策略),本工程按 len() 计。
//! 3. 不含 Rc 弱引用计数。Rc<T> 的堆头是 (strong, weak) 两个
//! usize,本工程在池统计里按常量单独加,不重复计入实例本身。
//!
//! 这些口径全部偏保守(低估绝对量),但不改变量级对比------
//! 「共享后 1.0MB vs 不共享 3.2MB」这种结论不会因漏算分配器头部而翻转。
//! 若将来要写进正式性能报告,必须换成实测(dhat 等分配器剖析工具),
//! 不能沿用本口径。这句话要留在代码里,防止被误用。
/// 一个对象的内存足迹(逻辑字节数)。
///
/// 实现者返回「栈内固定部分 + 堆上内容」的估算值。
/// 见模块文档的口径声明。
pub trait FlyweightFootprint {
/// 返回本对象的估算字节数(逻辑口径,非进程 RSS)。
fn estimated_bytes(&self) -> usize;
}
/// Rc<T> 的堆上控制块大小。
///
/// Rc<T> 的有效载荷前有两个 usize:强引用计数与弱引用计数。
/// 在 64 位目标上即 2 × 8 = 16 字节。
///
/// ## 为什么写成函数而不是直接写 16
///
/// 32 位目标上是 8 字节。用 size_of::<usize>() * 2 表达,
/// 让本工程在任何目标上都不会算错------而写死 16 会在 32 位平台静默偏差。
/// 这类「平台相关的常量」一律用表达式而非字面量。
pub const fn reference_control_block_bytes() -> usize {
// 强计数 + 弱计数,各占一个 usize。
std::mem::size_of::<usize>() * 2
}
/// Rc<T> 引用本身(指针)的大小。
///
/// 即一个 usize。排班槽位里存 Rc<ShiftTemplate>,
/// 每个槽位为「指向共享实例的指针」付出这些字节。
pub const fn reference_pointer_bytes() -> usize {
std::mem::size_of::<usize>()
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : pool_snapshot.rs
//! # 池统计快照 ------ 「共享省了多少」的计算
//!
//! ## 两个口径必须算清楚
//!
//! 设池中有 D 个不同键(distinct),累计被取用 R 次(request),
//! 每个实例的内容大小为 B_i(第 i 个实例)。
//!
//! ### 口径 A:用享元(本工程实际)
//!
//! text //! 共享侧 = Σ B_i (每个不同键只存一份实例内容) //! + D × 控制块 (每个实例一个 Rc 控制块) //! + R × 指针 (每个持有点一个 Rc 指针) //!
//!
//! ### 口径 B:不用享元(假设每个持有点各自克隆一份完整对象)
//!
//! text //! 独立侧 = Σ (持有数_i × B_i) (每个持有点一份完整副本) //!
//!
//! 「持有数_i」用 Rc::strong_count - 1 实测(见 SharedPool::held_reference_total
//! 的文档),不是估算值。
//!
//! ## 公式里每一项都必须能指出来源
//!
//! 本工程的每一个字节数都可追溯到具体代码:
//! - B_i ← 各享元类型的 estimated_bytes()(逐字段累加,见 shift_template.rs);
//! - 控制块 ← reference_control_block_bytes()(2 × size_of::<usize>());
//! - 指针 ← reference_pointer_bytes()(size_of::<usize>());
//! - 持有数 ← Rc::strong_count。
//!
//! 没有一个字面量是「拍脑袋估的」。这是本工程「数值可核对」要求的落实方式:
//! 不是让读者相信一个数,而是让每个数都能被追到源码行。
use super::footprint::FlyweightFootprint;
/// 池的累计计数器。
///
/// 全部是单调递增的累计值,与池内当前状态无关。
/// 用 u64 而非 u32:即便每秒取用百万次,也要跑 58 万年才溢出,
/// 不必担心长期运行的服务里计数回绕。
///
/// 字段公开:这是一个纯数据记录,没有任何不变式需要在构造时校验。
/// (对比 CalendarDate 的字段私有------那里有「月必须是 1..=12」的不变式。)
#[derive(Debug, Clone, Copy, Default, PartialEq, Eq)]
pub struct PoolCounters {
/// 累计取用请求次数(含命中、未命中、被拒绝)。
pub request_count: u64,
/// 命中既有实例的次数。
pub hit_count: u64,
/// 未命中并新建实例的次数。
pub miss_count: u64,
/// 因容量上限被拒绝的新键次数。
pub rejected_count: u64,
}
impl PoolCounters {
/// 命中率(万分点)。
///
/// 返回:命中数 / 请求数 × 10000。
///
/// 分母为零时返回 0(而不是 panic)------空池查询命中率是合法操作,
/// 结果无意义但不应让报表崩掉。
pub fn hit_rate_basis_points(&self) -> i64 {
if self.request_count == 0 {
return 0;
}
// i128 中间量:两个 u64 相乘可能超出 i64。
let numerator: i128 = self.hit_count as i128 * 10_000i128;
(numerator / self.request_count as i128) as i64
}
/// 未命中率(万分点)。
///
/// 与命中率互补(两者之和为 10000,除非有被拒绝的请求)。
///
/// ## 为什么单独算而不是 `10000 - 命中率`
///
/// 因为被拒绝的请求既不算命中也不算未命中。
/// 若用减法,被拒绝的次数会被误算成「未命中」,
/// 掩盖「池已满」这个需要立刻处理的问题。
/// 报表同时打印三个比率,读者能立刻区分「共享不生效」与「池不够大」------
/// 这两种情况的处理方式完全不同(前者改键设计,后者扩池容量)。
pub fn miss_rate_basis_points(&self) -> i64 {
if self.request_count == 0 {
return 0;
}
let numerator: i128 = self.miss_count as i128 * 10_000i128;
(numerator / self.request_count as i128) as i64
}
/// 拒绝率(万分点)。
pub fn rejection_rate_basis_points(&self) -> i64 {
if self.request_count == 0 {
return 0;
}
let numerator: i128 = self.rejected_count as i128 * 10_000i128;
(numerator / self.request_count as i128) as i64
}
/// 是否有请求被拒绝(池满发生过)。
pub const fn has_rejection(&self) -> bool {
self.rejected_count > 0
}
}
/// 池在某一时刻的统计快照(值类型)。
///
/// 实现 Default:装配器先构造一个空骨架(快照全 0),
/// 装配结束后再写入真实快照。用 Default 让「忘记写入」表现为
/// 「报表显示全 0」而不是「显示上一次的旧值」------前者一眼可见。
#[derive(Debug, Clone, Copy, PartialEq, Eq, Default)]
pub struct PoolSnapshot {
/// 累计计数器。
pub counters: PoolCounters,
/// 池内不同键的数量(= 实例数)。
pub distinct_entry_count: usize,
/// 池内所有实例的内容字节之和(共享侧)。
pub intrinsic_bytes_total: usize,
/// 句柄侧字节之和:持有数 × 指针 + 实例数 × 控制块。
pub handle_bytes_total: usize,
/// 池内实例当前被外部持有的句柄总数。
pub held_reference_total: u64,
/// 该池的容量上限(None 表示不限)。
pub entry_limit: Option<usize>,
}
impl PoolSnapshot {
/// 共享侧总字节(用享元的实际开销)。
///
/// = 实例内容 + 句柄侧。
pub const fn shared_total_bytes(&self) -> usize {
// usize 相加可能溢出,用饱和加法(溢出时钳到 usize::MAX,
// 报表里会出现一个荒谬的大数,一眼可见)。
self.intrinsic_bytes_total.saturating_add(self.handle_bytes_total)
}
/// 独立侧总字节(假设每个持有点各自克隆一份完整实例)。
///
/// 参数 `intrinsic_bytes_per_instance`:单个实例的内容字节数。
///
/// ## 为什么需要参数,而不是用「平均实例大小」
///
/// 池内不同实例的大小可能不等(本工程里「盘点夜班」的模板
/// 与「早班」的模板字段数相同,大小其实相等;但这是一个偶然,
/// 不能依赖)。用**平均大小 × 持有数**在大小不齐时会失真。
///
/// 更精确的做法是逐实例累加 `持有数_i × B_i`。本工程把这一步
/// 放在 `PoolSnapshot::unshared_total_bytes_exact` 里,
/// 由池在构造快照时提供逐实例数据;而本函数提供一个
/// 「已知均匀大小」时的便捷版本。
///
/// 之所以两个都留:便利版本用于快速检查,精确版本用于最终报表。
/// 若只留一个,要么精度不够,要么每次调用都要传一整个数组。
pub const fn unshared_total_bytes_of_uniform(
&self,
intrinsic_bytes_per_instance: usize,
) -> usize {
(self.held_reference_total as usize)
.saturating_mul(intrinsic_bytes_per_instance)
}
/// 共享带来的节省字节数(不共享 - 共享),可能为负。
///
/// 参数 `unshared_total_bytes`:独立侧总字节。
///
/// ## 为什么可能为负
///
/// 当「共享开销」大于「复制开销」时会为负,典型情形:
/// - 池里实例数很多但每个只被引用一两次(共享毫无收益却多付了控制块);
/// - 实例本身极小(如一个 `u32`),而 `Rc` 的控制块有 16 字节。
///
/// **返负值时不能截断为 0**------那会掩盖「这个场景不该用享元」这个结论。
/// 本工程第四幕会刻意构造一个「共享反而更费内存」的场景,
/// 用负数曝露出来。一个只会在好情况下报喜的模式论证没有价值。
pub const fn saved_bytes(&self, unshared_total_bytes: usize) -> i64 {
unshared_total_bytes as i64 - self.shared_total_bytes() as i64
}
/// 节省比例(万分点)。节省为负时返回负值。
///
/// 参数 `unshared_total_bytes`:独立侧总字节。
pub fn saved_ratio_basis_points(&self, unshared_total_bytes: usize) -> i64 {
if unshared_total_bytes == 0 {
return 0;
}
let saved: i64 = self.saved_bytes(unshared_total_bytes);
let numerator: i128 = saved as i128 * 10_000i128;
(numerator / unshared_total_bytes as i128) as i64
}
/// 平均每个实例被引用的次数(万分点,即「平均共享倍数」)。
///
/// 返回:`持有总数 / 实例数`(乘 10000 保留两位小数)。
///
/// ## 为什么这个指标比「命中率」更能说明共享度
///
/// 命中率反映的是**取用过程**,而本指标反映的是**存量结构**:
/// 「平均每个享元被 1714 个槽位共享」这句话,
/// 比「命中率 99.94%」更直接地说明共享的好处有多大。
///
/// 两者都要看:命中率高但共享倍数低,说明实例虽然复用了但复用量小;
/// 共享倍数高但命中率低,说明前几次取用都在建实例(预热期长)。
pub fn average_share_multiplier_basis_points(&self) -> i64 {
if self.distinct_entry_count == 0 {
return 0;
}
let numerator: i128 = self.held_reference_total as i128 * 10_000i128;
(numerator / self.distinct_entry_count as i128) as i64
}
/// 每个实例平均内容字节数。
pub fn average_intrinsic_bytes(&self) -> usize {
if self.distinct_entry_count == 0 {
return 0;
}
self.intrinsic_bytes_total / self.distinct_entry_count
}
/// 是否发生过池满拒绝。
pub const fn is_capacity_exceeded(&self) -> bool {
self.counters.has_rejection()
}
}
/// 一个「假设不共享」的对照模型。
///
/// ## 为什么单独建一个类型
///
/// 本工程要在多个地方做同一件事:「把这批槽位想象成每个都自带一份完整副本,
/// 算算要多少字节」。若各处各写一遍累加,公式会漂移
/// (比如某处忘了算句柄、某处用了不同的实例大小)。
///
/// 把它做成类型后,公式只此一份,且 FlyweightFootprint 约束保证
/// 「算字节」的口径与真实享元一致。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub struct UnsharedFootprint {
/// 参与统计的槽位(持有点)数量。
pub holder_count: u64,
/// 每个持有点若各自持有一份,其内容字节数。
///
/// 注意:这是副本的大小,即「把享元的全部字段深拷贝一份」。
/// 因此它就是享元的 estimated_bytes()(深拷贝同型对象,字节数相同),
/// 而不是「句柄 + 实例内容」。
pub bytes_per_holder: usize,
}
impl UnsharedFootprint {
/// 构造一个对照模型。
pub const fn new(holder_count: u64, bytes_per_holder: usize) -> UnsharedFootprint {
UnsharedFootprint {
holder_count,
bytes_per_holder,
}
}
/// 由享元实例构造对照模型。
///
/// 参数 `holder_count`:持有点数量;`flyweight`:任一享元实例
/// (用于读取其内容大小)。
///
/// 用「任一实例」而非「平均」:本工程的两族享元各自内部大小均匀
/// (字段数与类型固定)。若将来出现大小不齐的享元族,
/// 应改用逐实例累加的精确版本------这个限制写在注释里,
/// 而不是默默地算一个偏斜的数字。
pub fn from_flyweight<Flyweight: FlyweightFootprint>(
holder_count: u64,
flyweight: &Flyweight,
) -> UnsharedFootprint {
UnsharedFootprint {
holder_count,
bytes_per_holder: flyweight.estimated_bytes(),
}
}
/// 独立侧总字节。
pub const fn total_bytes(&self) -> usize {
(self.holder_count as usize).saturating_mul(self.bytes_per_holder)
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : shared_pool.rs
//! # 共享池 ------ 享元工厂的通用形态
//!
//! ## 为什么池是泛型的,而不是「一个班次模板池」
//!
//! 本工程有两族享元:班次模板(ShiftTemplate)与门店等级配置
//! (StoreGradeProfile)。若为每族各写一个池,会得到两份几乎相同的
//! 「查表 / 未命中则建 / 计数」代码------两处实现就是两处漂移源:
//! 将来给池加一个「容量上限」特性,很可能只改了一处。
//!
//! 泛型池把「享元机制」抽成一份代码,两族只是不同的类型参数实例。
//! 这本身也是对本模式的一个说明:享元可复用的是一个机制,
//! 不是一个具体对象。
//!
//! ## 为什么用 Rc 而不是 &'a T
//!
//! 用引用(&'a ShiftTemplate)让池借出实例,能省下 Rc 的控制块与指针
//! 总共 24 字节/槽位。但代价是生命周期地狱:
//! - 池必须比所有槽位活得更久(否则悬垂引用);
//! - 池「未命中则新建并插入」需要 &mut,而借出的引用又是 &------
//! 在 Rust 里同一容器不能同时存在这两个借用;
//! - 于是要么把池整个包在 RefCell 里(仍无法解决引用逃逸),
//! 要么改用「先收集键、再统一构造」的两阶段流程(代码复杂度暴增)。
//!
//! Rc 用 8 字节指针换来了「池可以内部可变(RefCell)」与
//! 「实例生命周期由引用计数托管」。这是本工程刻意的取舍:
//! 享元带来的节省是「不再复制整份对象」(数百字节/槽位),
//! 用 8 字节指针换它是划算的。
//!
//! ## 为什么不是 Arc
//!
//! Arc 的原子计数在本工程场景里纯属浪费:排班装配是单线程的
//! (一个门店的排班不会跨线程并发构造)。原子操作比非原子慢数倍,
//! 且 Arc 在同一平台上与 Rc 同宽(都是 8 字节指针 + 16 字节控制块),
//! 内存上没有任何优势。
//!
//! 若将来排班装配要跨线程并行(例如上千家门店并行生成),
//! 把 Rc 换成 Arc 即可,本文件的类型别名 SharedHandle 就是为此留的
//! ------全工程只有这一处定义句柄类型,换实现只需改一行。
use std::cell::RefCell;
use std::collections::HashMap;
use std::hash::Hash;
use std::rc::Rc;
use super::footprint::FlyweightFootprint;
use super::pool_snapshot::{PoolCounters, PoolSnapshot};
/// 共享实例的句柄类型。
///
/// ## 为什么要有这个别名
///
/// 全工程凡是要「持有一个享元」的地方都写 SharedHandle<ShiftTemplate>
/// 而不是 Rc<ShiftTemplate>。这样将来改用 Arc(跨线程)时,
/// 只改这一行,所有持有点自动跟随。
///
/// 若各处直接写 Rc<...>,改 Arc 就要 grep 全工程逐一替换,
/// 而这正是最容易漏掉一两处的地方(漏掉的那处会编译失败还好,
/// 若恰好类型兼容则会静默产生两套不互通的引用)。
pub type SharedHandle<Flyweight> = Rc<Flyweight>;
/// 池已达容量上限。
///
/// 只在用 [SharedPool::with_entry_limit] 建池时才可能产生。
/// 之所以做成一个具名错误类型(而不是 Option::None),
/// 是为了让调用方能从错误里读出「上限是多少」------
/// 报表可以打印「池上限 8,本批数据需要 12 个不同键,请调整设计」,
/// 这比一个光秃秃的 None 有用得多。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub struct PoolCapacityExceeded {
/// 该池的键数量上限。
pub entry_limit: usize,
}
/// 通用的享元共享池。
///
/// ## 设计要点
///
/// 1. 池自身不可变借用(所有方法取 &self)。内部用 RefCell
/// 做内部可变性。这让「池」可以作为普通字段放在装配器里,
/// 不必把整条调用链都改成 &mut self。
/// ⚠️ RefCell 的借用检查在运行期------若在持有内部借用时
/// 再次调用池的方法,会 panic。因此 [SharedPool::obtain] 刻意
/// 把用户提供的构造函数 create 调用放在所有内部借用之外,
/// 并为此在插入前做了二次查表(防止 create 期间池被改动)。
/// 2. 构造与登记分离:obtain 接收一个 FnOnce(&Key) -> Flyweight
/// 闭包。池不需要知道如何构造具体享元,因此能做到泛型;
/// 而调用方(具体族)负责给出构造逻辑。
/// 3. 命中/未命中都计数:命中率是本工程的核心指标之一,
/// 也是「享元真的生效了」的运行时证据。
pub struct SharedPool<Key, Flyweight>
where
Key: Hash + Eq + Clone,
Flyweight: FlyweightFootprint,
{
/// 已登记的共享实例。键 → 实例。
///
/// 放在 RefCell 里:obtain 取 &self 却要插入,只能走内部可变性。
entries: RefCell<HashMap<Key, SharedHandle<Flyweight>>>,
/// 累计计数器(请求/命中/未命中/被拒绝)。
counters: RefCell<PoolCounters>,
/// 键数量上限。None 表示不限(演示规模下的默认值)。
entry_limit: Option<usize>,
}
impl<Key, Flyweight> SharedPool<Key, Flyweight>
where
Key: Hash + Eq + Clone,
Flyweight: FlyweightFootprint,
{
/// 建一个不限容量的池。
pub fn new() -> SharedPool<Key, Flyweight> {
SharedPool {
entries: RefCell::new(HashMap::new()),
counters: RefCell::new(PoolCounters::default()),
entry_limit: None,
}
}
/// 建一个键数量有上限的池。
///
/// 参数 `entry_limit`:允许的不同键数量上限。
/// 返回:池。
///
/// ## 为什么享元池需要容量上限
///
/// 享元的经典风险是**键空间失控**:若键里混进了「每次调用都不同」的维度
/// (典型是日期、时间戳、请求 ID),池会为每个请求建一个新实例,
/// 且**永不释放**(`Rc` 强引用一直持有),最终 OOM。
///
/// 这类 bug 的可怕之处在于:功能完全正常,只是内存单向增长,
/// 往往在运行数周后才暴露。加一个上限 + 溢出计数,
/// 能让「键空间失控」在**第一次跑演示时**就被看见。
///
/// 本工程第三幕会刻意构造一个「键里含门店」的失控场景,
/// 用 `with_entry_limit` 把它拦下来。
pub fn with_entry_limit(entry_limit: usize) -> SharedPool<Key, Flyweight> {
SharedPool {
entries: RefCell::new(HashMap::new()),
counters: RefCell::new(PoolCounters::default()),
entry_limit: Some(entry_limit),
}
}
/// 取得一个共享实例;不存在则用 `create` 构造并登记。
///
/// 参数 `key`:享元键;`create`:构造闭包,接收键的引用。
/// 返回:共享实例句柄;若池已满且该键为新键,返回 `Err`。
///
/// ## 为什么构造闭包接收 `&Key` 而不是 `Key`
///
/// 因为键**同时**要作为 `HashMap` 的成员被拥有,又要用于构造实例。
/// 若闭包拿走 `key`,池就没法把它存进表里了(除非 `Clone` 两次)。
/// 传引用让构造方按需读取,所有权仍归池。
///
/// ## 为什么 `create` 在借用之外调用
///
/// 构造函数里可能做很复杂的事(甚至再向本池取另一个享元)。
/// 若这时池的 `entries` 还被 `borrow()` 着,
/// `RefCell` 会在运行期 panic(`already borrowed`)。
/// 因此流程刻意分成「查表(借用)→ 释放借用 → 构造 → 再借用插入」四段,
/// 并在插入前**二次查表**以防构造期间键被别的路径插入。
pub fn obtain<Create>(
&self,
key: Key,
create: Create,
) -> Result<SharedHandle<Flyweight>, PoolCapacityExceeded>
where
Create: FnOnce(&Key) -> Flyweight,
{
// 记录一次请求(无论后续命中与否)。
self.counters.borrow_mut().request_count += 1;
// ── 第一段:查表(借用 ranges 在块结束时自动释放) ──
{
let entries = self.entries.borrow();
if let Some(existing) = entries.get(&key) {
// 命中:克隆句柄(只加引用计数,不复制实例)。
let handle: SharedHandle<Flyweight> = SharedHandle::clone(existing);
// 显式释放借用,避免下面记分时持有两把锁(虽然不冲突,但容易看错)。
drop(entries);
self.counters.borrow_mut().hit_count += 1;
return Ok(handle);
}
}
// ── 第二段:容量检查(此时无任何借用) ──
if let Some(limit) = self.entry_limit {
let current_entry_count: usize = self.entries.borrow().len();
if current_entry_count >= limit {
// 池满:拒绝为新键建实例(既有键仍可命中,上面的分支已处理)。
self.counters.borrow_mut().rejected_count += 1;
return Err(PoolCapacityExceeded {
entry_limit: limit,
});
}
}
// ── 第三段:构造实例(**无借用**,允许构造函数再入本池) ──
let created_flyweight: Flyweight = create(&key);
// ── 第四段:登记(二次查表,防构造期间被插入) ──
let mut entries = self.entries.borrow_mut();
if let Some(existing) = entries.get(&key) {
// 构造期间该键已被别的调用插入 → 丢弃刚构造的实例,复用既有的。
// 单线程下只有「构造函数递归取同键」才会走到这里,
// 但保留此分支成本极低,且能让上面那句「允许再入」的承诺成立。
let handle: SharedHandle<Flyweight> = SharedHandle::clone(existing);
drop(entries);
self.counters.borrow_mut().hit_count += 1;
return Ok(handle);
}
// 真正的新键:以共享句柄插入,并返回同一个句柄。
let shared_handle: SharedHandle<Flyweight> = SharedHandle::new(created_flyweight);
entries.insert(key, SharedHandle::clone(&shared_handle));
drop(entries);
self.counters.borrow_mut().miss_count += 1;
Ok(shared_handle)
}
/// 只读查询:键是否已登记。
///
/// 参数 `key`:待查的键。
/// 返回:已登记返回 `Some(句柄)`,否则 `None`。
///
/// **不计入请求/命中统计**:这是「查看」而不是「取用」。
/// 若把查看也计入命中率,指标会被调试代码污染。
pub fn lookup(&self, key: &Key) -> Option<SharedHandle<Flyweight>> {
self.entries.borrow().get(key).map(SharedHandle::clone)
}
/// 键是否已登记(不取出句柄,最轻量)。
pub fn contains_key(&self, key: &Key) -> bool {
self.entries.borrow().contains_key(key)
}
/// 池内不同键的数量。
pub fn entry_count(&self) -> usize {
self.entries.borrow().len()
}
/// 池的容量上限(`None` 表示不限)。
pub fn entry_limit(&self) -> Option<usize> {
self.entry_limit
}
/// 池内所有实例的估算字节数之和(不含句柄)。
///
/// 这是「共享侧的真实开销」:只需为每个**不同键**存一份实例内容。
pub fn intrinsic_bytes_total(&self) -> usize {
self.entries
.borrow()
.values()
.map(|flyweight| flyweight.estimated_bytes())
.sum()
}
/// 池内所有实例**当前**被外部持有的句柄数之和。
///
/// 用 `Rc::strong_count - 1` 计算:减去池自己持有的那一份。
/// 结果是「当前有多少个槽位/客户端正引用着这些享元」。
///
/// ## 为什么用 `strong_count` 而不是自己维护一个计数表
///
/// 自维护计数表意味着池里再存一个 `HashMap<Key, u64>`------
/// **在一个以省内存为主题的工程里,为统计再加一张哈希表是自相矛盾的**。
/// `Rc` 的控制块里本来就有强引用计数,读它是零成本的。
/// 而且它反映的是**真实**的持有情况(包括调用方自行 `clone` 的那些),
/// 不会因为漏记一处 `clone` 而失真。
pub fn held_reference_total(&self) -> u64 {
self.entries
.borrow()
.values()
// 减 1:池自己在 `entries` 里持有一份。
.map(|flyweight| SharedHandle::strong_count(flyweight) as u64 - 1)
.sum()
}
/// 取一份统计快照。
///
/// 返回:包含累计计数器、条目数、内存估算的快照。
/// 快照是**值类型**,拿到后可自由传递,不会与池的后续变动互相影响。
pub fn snapshot(&self) -> PoolSnapshot {
let entries = self.entries.borrow();
// 池内实例内容总字节(每个不同键一份)。
let intrinsic_bytes_total: usize =
entries.values().map(|flyweight| flyweight.estimated_bytes()).sum();
// 各实例当前被外部持有的句柄数(用于「若各自持有一份」的对照估算)。
let held_reference_total: u64 =
entries.values().map(|flyweight| SharedHandle::strong_count(flyweight) as u64 - 1).sum();
// 句柄侧总字节:每个被持有的句柄一个指针,加上每个实例一个控制块。
let handle_bytes_total: usize = held_reference_total as usize
* super::footprint::reference_pointer_bytes()
+ entries.len() * super::footprint::reference_control_block_bytes();
PoolSnapshot {
counters: *self.counters.borrow(),
distinct_entry_count: entries.len(),
intrinsic_bytes_total,
handle_bytes_total,
held_reference_total,
entry_limit: self.entry_limit,
}
}
/// 遍历池内所有键与实例(只读)。
///
/// 参数 `visit`:对每个 `(键, 实例)` 调用一次。
///
/// ## 为什么用回调解构而不是返回 `Vec<(Key, Handle)>`
///
/// 返回 `Vec` 会为每个键**再克隆一个句柄**------于是遍历这个动作本身
/// 就改变了 `strong_count`,让「共享度」统计失真。
/// 回调形式不克隆,读到的就是真实状态。
/// 在一个统计精度很重要的工程里,这个区别必须在意。
pub fn for_each_entry<Visit>(&self, mut visit: Visit)
where
Visit: FnMut(&Key, &SharedHandle<Flyweight>),
{
let entries = self.entries.borrow();
for (key, flyweight) in entries.iter() {
visit(key, flyweight);
}
}
}
// 默认构造:不加 #[derive(Default)] 是因为泛型参数上写 Default 约束
// 会限制可用性(Rc/HashMap 都默认空,与 Key/Flyweight 是否实现 Default 无关)。
impl<Key, Flyweight> Default for SharedPool<Key, Flyweight>
where
Key: Hash + Eq + Clone,
Flyweight: FlyweightFootprint,
{
/// 等价于 [SharedPool::new](不限容量)。
fn default() -> Self {
SharedPool::new()
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : shift_template.rs
//! # 班次模板 ------ 享元本体(内在状态)
//!
//! ## 这是「被共享的那一半」
//!
//! 一个班次模板包含「无论哪家门店、哪一天、哪个员工,都完全相同」的信息:
//! 几点上班、几点下班、休息多久、计薪时长、时薪系数、是否需要安保。
//!
//! | 字段类别 | 归属 | 理由 |
//! |---|---|---|
//! | 时刻 / 时长 / 休息 | 内在(本类型) | 由班次种类唯一决定 |
//! | 时薪系数 | 内在(本类型) | 由班次 × 时段 × 技能等级决定 |
//! | 门店 / 日期 / 员工 | 外在(client::ShiftSlot) | 每次使用都不同 |
//! | 门店时薪指数 | 外在(client::ShiftSlot) | 各店不同 |
//! | 实际工时 / 加班 | 外在(client::ShiftSlot) | 每个槽位不同 |
//!
//! ## 为什么全部字段私有、只给 &self 取值器
//!
//! 享元一旦被多个槽位共享,它就必须不可变------
//! 否则「槽位 A 改了模板,槽位 B 的读数跟着变了」,
//! 这是最难排查的一类 bug(改动点与出错点相距很远)。
//!
//! Rust 的所有权系统帮我们把这条约定变成编译期保证:
//! - 字段私有 → 外部无法直接赋值;
//! - 只提供 &self 方法 → 无法通过方法变异;
//! - 外部只能拿到 Rc<ShiftTemplate>,而 Rc 只解引用出 &T。
//!
//! 于是「享元不可变」不再依赖纪律,而是写不出变异代码。
//! 这是 Rust 相比 Java/C# 实现本模式的一个实质优势:
//! 在那些语言里,「不要修改享元」只能写在注释里。
//!
//! ## 本类型的字节足迹:零堆分配
//!
//! 所有字段都是值类型(ClockTime 是 u16、WorkDuration 是 u32、
//! 各标签是 &'static str + 小整数),因此 estimated_bytes()
//! 就是 size_of::<ShiftTemplate>(),没有堆内容。
//!
//! 这是刻意的设计:若把 shift_code 等字段写成 String,
//! 每个实例就要多一次堆分配(白付 16 字节控制块 + 分配开销)。
//! 享元实例虽然少(本工程 7 个),但**「用 &'static str 而不是 String」
//! 这条纪律在整个工程里一致贯彻**,正是它让「不共享侧」的
//! 对照版本(用 String)显示出巨大的差异。
use crate::domain::{PayPeriodKind, Ratio, ShiftCode, SkillGrade, WorkDuration};
use crate::support::clock_time::ClockTime;
use super::footprint::FlyweightFootprint;
use super::shift_template_key::ShiftTemplateKey;
/// 一个班次模板(享元本体)。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct ShiftTemplate {
/// 班次编码。
shift_code: ShiftCode,
/// 上班时刻。
starts_at: ClockTime,
/// 下班时刻(可能小于上班时刻,表示跨零点)。
ends_at: ClockTime,
/// 排班时长(含休息)。
scheduled_duration: WorkDuration,
/// 休息时长。
break_duration: WorkDuration,
/// 计薪时长 = 排班时长 - 休息时长。
///
/// ## 为什么要把计薪时长存成字段而不是每次算
///
/// 「休息不付薪」是本工程的一条业务规则。若每次算成本都现算
/// scheduled - break,这条规则就有了多个执行点;
/// 将来规则变化(如「夜班休息也计薪」)就要改多处。
/// 存成字段后,规则只在构造模板时执行一次,
/// 之后所有槽位都从同一个值读取------单一事实来源。
///
/// 代价是每模板多 4 字节(共 7 个模板 = 28 字节),可忽略。
paid_duration: WorkDuration,
/// 综合时薪系数 = 技能基数 × 班次系数 × 时段上浮系数。
///
/// 三个因子在构造时就乘好,避免每个槽位重复计算
/// (数万槽位 × 三次乘法与三次舍入)。
/// 在享元里,「把能提前算的都算好」是天然合理的------
/// 反正只算 7 次。
combined_pay_multiplier: Ratio,
/// 最低技能等级(与键一致,冗余存一份便于报表直接读取)。
minimum_skill_grade: SkillGrade,
/// 计薪时段(与键一致,冗余存一份便于报表直接读取)。
///
/// ## 为什么容忍这份冗余
///
/// 键已经在池里了(HashMap 的键),模板里再存一份确实重复。
/// 但两个理由让它值得:
/// 1. 报表渲染时拿到的是 Rc<ShiftTemplate>,拿不到键;
/// 若要靠键取时段,就得把「模板 + 键」打包传递,处处多一层;
/// 2. 模板是「自描述的」------调试时打印一个模板就能看到它的全部语义,
/// 不必回去查是哪把键生成了它。
///
/// 冗余的代价:7 个模板 × 约 40 字节 = 280 字节。可忽略。
/// 在一个只有 7 个实例的集合里,可读性远比省几百字节重要。
pay_period_kind: PayPeriodKind,
/// 是否需要安保在场(开保险柜的班次需要)。
requires_security_presence: bool,
/// 是否要求双人在场(珠宝门店一般班次都要求)。
requires_dual_presence: bool,
/// 是否跨越零点(夜班)。
crosses_midnight: bool,
}
impl ShiftTemplate {
/// 构造一个班次模板。
///
/// 参数较多,因此不对外开放(pub(crate))------
/// 只有 [super::shift_template_factory::ShiftTemplateFactory] 调用它。
///
/// ## 为什么不做成公开的 new
///
/// 模板必须经过工厂登记才能被共享。若对外开放 new,
/// 调用方可能自己 ShiftTemplate::new(...) 造一个游离实例,
/// 它不进池、不被共享,却又与池中实例内容相同------
/// 于是「同一份数据存在两个副本」,且没有任何机制能发现。
///
/// 把构造器收进层内(pub(crate)),保证所有模板都出自池。
/// 这是「用可见性表达不变式」的一个具体应用。
#[allow(clippy::too_many_arguments)]
pub(crate) fn new(
key: &ShiftTemplateKey,
starts_at: ClockTime,
ends_at: ClockTime,
scheduled_duration: WorkDuration,
break_duration: WorkDuration,
paid_duration: WorkDuration,
combined_pay_multiplier: Ratio,
requires_security_presence: bool,
requires_dual_presence: bool,
crosses_midnight: bool,
) -> ShiftTemplate {
ShiftTemplate {
shift_code: key.shift_code(),
starts_at,
ends_at,
scheduled_duration,
break_duration,
paid_duration,
combined_pay_multiplier,
minimum_skill_grade: key.minimum_skill_grade(),
pay_period_kind: key.effective_period_kind(),
requires_security_presence,
requires_dual_presence,
crosses_midnight,
}
}
/// 班次编码。
pub const fn shift_code(&self) -> ShiftCode {
self.shift_code
}
/// 上班时刻。
pub const fn starts_at(&self) -> ClockTime {
self.starts_at
}
/// 下班时刻。
pub const fn ends_at(&self) -> ClockTime {
self.ends_at
}
/// 排班时长(含休息)。
pub const fn scheduled_duration(&self) -> WorkDuration {
self.scheduled_duration
}
/// 休息时长。
pub const fn break_duration(&self) -> WorkDuration {
self.break_duration
}
/// 计薪时长。
pub const fn paid_duration(&self) -> WorkDuration {
self.paid_duration
}
/// 综合时薪系数。
pub const fn combined_pay_multiplier(&self) -> Ratio {
self.combined_pay_multiplier
}
/// 最低技能等级。
pub const fn minimum_skill_grade(&self) -> SkillGrade {
self.minimum_skill_grade
}
/// 计薪时段。
pub const fn pay_period_kind(&self) -> PayPeriodKind {
self.pay_period_kind
}
/// 是否需要安保在场。
pub const fn requires_security_presence(&self) -> bool {
self.requires_security_presence
}
/// 是否要求双人在场。
pub const fn requires_dual_presence(&self) -> bool {
self.requires_dual_presence
}
/// 是否跨越零点。
pub const fn crosses_midnight(&self) -> bool {
self.crosses_midnight
}
/// 返回「09:00-17:00」形式的时刻区间文本(跨零点时加「次日」)。
pub fn time_range_text(&self) -> String {
if self.crosses_midnight {
format!("{}-次日 {}", self.starts_at.formatted(), self.ends_at.formatted())
} else {
format!("{}-{}", self.starts_at.formatted(), self.ends_at.formatted())
}
}
/// 返回模板的一行摘要文本。
///
/// ## 注意这里是「子系统/模式层自带排版」
///
/// 与同系列工程的做法一致:本方法是**层内自带的展示口径**,
/// 报表层(`app`)不会用它。保留并在第七幕与报表层排版**并列打印**,
/// 是为了演示「排版职责统一归表示层」这条原则------
/// 若子系统各自排版,改一次列宽就要改多处。
pub fn formatted(&self) -> String {
format!(
"{}({})| {} | 计薪 {} | 系数 {}",
self.shift_code.display_name(),
self.shift_code.code(),
self.time_range_text(),
self.paid_duration.formatted_hours_and_minutes(),
self.combined_pay_multiplier.as_multiplier_text()
)
}
}
impl FlyweightFootprint for ShiftTemplate {
/// 返回模板的估算字节数。
///
/// 本类型没有任何堆分配字段(全部是 u16/u32/i64/bool
/// 与 &'static str 标签),因此 size_of 就是全部。
///
/// ⚠️ 这个前提必须随字段变化而复核:若将来给模板加一个
/// Vec<String> 字段(比如「适用门店等级列表」),
/// 本函数就必须改成「size_of + 各 Vec 的内容字节」,
/// 否则内存统计会静默低估,进而让「共享节省了多少」被高估。
///
/// 这类「统计函数随结构变化而失效」的风险无法由编译器发现,
/// 因此每个 FlyweightFootprint 实现都必须写清
/// 「我这个实现依赖哪些结构前提」。
fn estimated_bytes(&self) -> usize {
std::mem::size_of::<ShiftTemplate>()
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : shift_template_factory.rs
//! # 班次模板工厂 ------ 具象享元工厂
//!
//! ## 工厂的两项职责
//!
//! 1. 持有共享池(SharedPool<ShiftTemplateKey, ShiftTemplate>);
//! 2. 持有班次时刻表登记表------「某个班次几点到几点、休息多久、
//! 基础系数多少」这部分知识。
//!
//! 职责 2 是本文件的关键设计。若把时刻表写成一段 match shift_code {...},
//! 那么新增班次就必须修改本文件------而本工程的验收标准包含
//! 「工程外扩展不改任何既有分层文件」。
//!
//! 因此时刻表做成运行期可登记的([ShiftTemplateFactory::register_shift_schedule]):
//! 内置的 5 个班次在构造时登记,工程外可以再登记新班次,
//! 本文件一行不改。这正是同系列工程反复验证的那条经验------
//! 「登记表把选择从编译期 match 提升为运行期数据」。
//!
//! ## 未登记班次不会被静默忽略
//!
//! 若某个键引用了未登记的班次,[ShiftTemplateFactory::obtain] 返回
//! [ShiftTemplateLookupError::UnregisteredShift],由调用方决定如何处理。
//!
//! 为什么不给一个「默认时刻表」兜底:兜底会让「忘记登记」这个错误
//! 变成「排班表里某几个班次的时刻很奇怪」------问题在报表层面才暴露,
//! 且难以定位到「忘了登记」。返回错误让问题在取模板的那一行就暴露。
//! 这条与同工程其他地方「fail visible」的选择一致,但此处选择了
//! 「显式错误」而非「钳制后继续」------区别在于兜底值是否可见:
//! 日期钳制后报表里会出现明显不对的日期(可见);
//! 而时刻兜底后会得到一个看起来正常的时刻(不可见)。
use std::cell::RefCell;
use std::collections::HashMap;
use crate::domain::{
divide_rounded_away_from_zero, Ratio, ShiftCode, SkillGrade, WorkDuration,
PAY_PERIOD_NORMAL, SHIFT_CODE_EARLY, SHIFT_CODE_LATE, SHIFT_CODE_MIDDLE,
SHIFT_CODE_NIGHT_AUDIT, SHIFT_CODE_WEEKEND_BOOST, SKILL_GRADE_JUNIOR,
};
use crate::support::clock_time::ClockTime;
use super::shift_template::ShiftTemplate;
use super::shift_template_key::ShiftTemplateKey;
use super::shared_pool::{SharedHandle, SharedPool};
use super::pool_snapshot::PoolSnapshot;
/// 一个班次的时刻与基础系数规格(可运行期登记)。
///
/// ## 为什么单独成类型而不是把参数塞进 register_shift_schedule
///
/// 未来这张表很可能要加字段(如「该班次的最短连续休息要求」)。
/// 若用参数列表,每次加字段都要改方法签名 → 所有调用点跟着改;
/// 用结构体后,加字段只需给一个默认值,既有调用点不受影响。
///
/// 这是「参数对象」模式的一个朴素应用,但对会被扩展的 API 很有价值。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub struct ShiftScheduleSpec {
/// 班次编码。
shift_code: ShiftCode,
/// 上班时刻。
starts_at: ClockTime,
/// 下班时刻(可小于上班时刻,表示跨零点)。
ends_at: ClockTime,
/// 休息时长。
break_duration: WorkDuration,
/// 班次基础系数(不含技能与时段上浮)。夜班通常高于 1.00。
shift_factor: Ratio,
/// 是否要求双人在场。
requires_dual_presence: bool,
}
impl ShiftScheduleSpec {
/// 构造一个班次时刻规格。
///
/// 参数 shift_code / starts_at / ends_at / break_duration /
/// shift_factor / requires_dual_presence。
/// 返回:规格。
///
/// const fn:让工程外能把规格定义成 const 常量
/// (见 main.rs 的扩展区),而不必在运行期拼装。
pub const fn new(
shift_code: ShiftCode,
starts_at: ClockTime,
ends_at: ClockTime,
break_duration: WorkDuration,
shift_factor: Ratio,
requires_dual_presence: bool,
) -> ShiftScheduleSpec {
ShiftScheduleSpec {
shift_code,
starts_at,
ends_at,
break_duration,
shift_factor,
requires_dual_presence,
}
}
/// 班次编码。
pub const fn shift_code(&self) -> ShiftCode {
self.shift_code
}
/// 上班时刻。
pub const fn starts_at(&self) -> ClockTime {
self.starts_at
}
/// 下班时刻。
pub const fn ends_at(&self) -> ClockTime {
self.ends_at
}
/// 休息时长。
pub const fn break_duration(&self) -> WorkDuration {
self.break_duration
}
/// 班次基础系数。
pub const fn shift_factor(&self) -> Ratio {
self.shift_factor
}
/// 是否要求双人在场。
pub const fn requires_dual_presence(&self) -> bool {
self.requires_dual_presence
}
}
/// 取班次模板时的失败原因。
///
/// 用枚举而非 Option:两种失败的处理方式完全不同------
/// 未登记班次要补登记,池满要扩容量或改键设计。
/// 合成一个 None 会让调用方无法给出有用的错误信息。
#[derive(Debug, Clone, PartialEq, Eq)]
pub enum ShiftTemplateLookupError {
/// 该班次未在工厂登记。
UnregisteredShift {
/// 未登记的班次编码(供报表指认)。
shift_code_text: &'static str,
},
/// 池已达容量上限,无法为新键建模板。
PoolCapacityExceeded {
/// 该池的键数量上限。
entry_limit: usize,
},
}
impl ShiftTemplateLookupError {
/// 返回一行可读的失败说明。
pub fn description(&self) -> String {
match self {
ShiftTemplateLookupError::UnregisteredShift { shift_code_text } => {
format!("班次「{}」未在工厂登记班次时刻表", shift_code_text)
}
ShiftTemplateLookupError::PoolCapacityExceeded { entry_limit } => {
format!("享元池已达键数量上限 {},无法为新键建模板", entry_limit)
}
}
}
}
/// 班次模板工厂(具象享元工厂)。
pub struct ShiftTemplateFactory {
/// 共享池。
pool: SharedPool<ShiftTemplateKey, ShiftTemplate>,
/// 班次时刻表登记表。键是班次编码。
///
/// 放在 RefCell 里以便运行期登记(register_shift_schedule 取 &self)。
/// 与池一样,本工程不需要把整条调用链改成 &mut self。
schedule_registry: RefCell<HashMap<ShiftCode, ShiftScheduleSpec>>,
}
impl ShiftTemplateFactory {
/// 建一个已登记 5 个内置班次、不限池容量的工厂。
pub fn with_builtin_shifts() -> ShiftTemplateFactory {
let factory = ShiftTemplateFactory {
pool: SharedPool::new(),
schedule_registry: RefCell::new(HashMap::new()),
};
factory.register_builtin_shift_schedules();
factory
}
/// 建一个已登记 5 个内置班次、且池有键数量上限的工厂。
///
/// 参数 `entry_limit`:池的键数量上限。
/// 返回:工厂。
///
/// 供第四幕演示「键空间失控被拦下」。
pub fn with_builtin_shifts_and_entry_limit(entry_limit: usize) -> ShiftTemplateFactory {
let factory = ShiftTemplateFactory {
pool: SharedPool::with_entry_limit(entry_limit),
schedule_registry: RefCell::new(HashMap::new()),
};
factory.register_builtin_shift_schedules();
factory
}
/// 登记 5 个内置班次的时刻表。
///
/// ## 为什么是私有方法
///
/// 它是「哪些班次算内置」这个决定的唯一落点。
/// 公开它会让调用方能在任意时刻重置内置班次,
/// 而内置集合应当是**构造时就确定**的。
fn register_builtin_shift_schedules(&self) {
// 早班 09:00-17:00,休息 60 分钟,系数 1.00。
self.register_shift_schedule(ShiftScheduleSpec::new(
SHIFT_CODE_EARLY,
ClockTime::from_hour_and_minute(9, 0),
ClockTime::from_hour_and_minute(17, 0),
WorkDuration::from_minutes(60),
Ratio::one(),
// 珠宝门店:所有班次都要双人在场。
true,
));
// 中班 13:00-21:00,休息 60 分钟,系数 1.00。
self.register_shift_schedule(ShiftScheduleSpec::new(
SHIFT_CODE_MIDDLE,
ClockTime::from_hour_and_minute(13, 0),
ClockTime::from_hour_and_minute(21, 0),
WorkDuration::from_minutes(60),
Ratio::one(),
true,
));
// 晚班 15:00-23:00,休息 60 分钟,系数 1.05(收市结算偏累)。
self.register_shift_schedule(ShiftScheduleSpec::new(
SHIFT_CODE_LATE,
ClockTime::from_hour_and_minute(15, 0),
ClockTime::from_hour_and_minute(23, 0),
WorkDuration::from_minutes(60),
Ratio::from_basis_points(10_500),
true,
));
// 盘点夜班 22:30-次日 06:30,休息 90 分钟,系数 1.25。
self.register_shift_schedule(ShiftScheduleSpec::new(
SHIFT_CODE_NIGHT_AUDIT,
ClockTime::from_hour_and_minute(22, 30),
ClockTime::from_hour_and_minute(6, 30),
WorkDuration::from_minutes(90),
Ratio::from_basis_points(12_500),
// 夜班开保险柜,必须双人在场。
true,
));
// 周末加强班 10:00-19:00,休息 75 分钟,系数 1.10。
self.register_shift_schedule(ShiftScheduleSpec::new(
SHIFT_CODE_WEEKEND_BOOST,
ClockTime::from_hour_and_minute(10, 0),
ClockTime::from_hour_and_minute(19, 0),
WorkDuration::from_minutes(75),
Ratio::from_basis_points(11_000),
true,
));
}
/// 登记一个班次的时刻规格。
///
/// 参数 `spec`:班次时刻规格。
/// 返回:登记成功返回 `true`;若该班次编码已登记(**不覆盖**)返回 `false`。
///
/// ## 为什么不覆盖已有的登记
///
/// 若允许覆盖,则「工程外登记一个新班次」可能意外改掉某个内置班次
/// 的时刻(编码拼错时)。返回 `false` 让调用方知道「这个编码已被占用」,
/// 从而发现拼写错误。这是**用返回值保护数据完整性**------
/// 比静默覆盖安全,比 panic 温和。
///
/// 这也是工程外扩展的正式入口:调用它不影响任何既有分层文件。
pub fn register_shift_schedule(&self, spec: ShiftScheduleSpec) -> bool {
let mut registry = self.schedule_registry.borrow_mut();
if registry.contains_key(&spec.shift_code()) {
return false;
}
registry.insert(spec.shift_code(), spec);
true
}
/// 已登记的班次数量。
pub fn registered_shift_count(&self) -> usize {
self.schedule_registry.borrow().len()
}
/// 某班次是否已登记。
pub fn is_shift_registered(&self, shift_code: &ShiftCode) -> bool {
self.schedule_registry.borrow().contains_key(shift_code)
}
/// 取得(或新建)一个共享班次模板。
///
/// 参数 `key`:享元键。
/// 返回:共享实例;未登记班次或池满时返回 `Err`。
///
/// ## 执行顺序(两步都不可省)
///
/// 1. **先查登记表**:未登记就直接返回错误,**不去碰池**。
/// 若先碰池,未登记的键会先在池里占一个位(`create` 里才发现无法构造),
/// 把容量浪费掉------在有限容量的池里这会误导后面的诊断。
/// 2. **再向池取/建**:命中则共享,未命中则按规格构造并登记。
pub fn obtain(
&self,
key: ShiftTemplateKey,
) -> Result<SharedHandle<ShiftTemplate>, ShiftTemplateLookupError> {
// 第一步:查登记表(只读借用,用完即释放)。
let schedule_spec: ShiftScheduleSpec = {
let registry = self.schedule_registry.borrow();
match registry.get(&key.shift_code()) {
Some(spec) => *spec,
None => {
return Err(ShiftTemplateLookupError::UnregisteredShift {
shift_code_text: key.shift_code().code(),
});
}
}
};
// 第二步:向池取共享实例;未命中时按规格构造。
// 构造闭包在此处调用,且**不持有登记表的借用**,因此安全。
self.pool
.obtain(key, |looked_up_key| {
build_shift_template(looked_up_key, &schedule_spec)
})
.map_err(|capacity_error| ShiftTemplateLookupError::PoolCapacityExceeded {
entry_limit: capacity_error.entry_limit,
})
}
/// 共享池的只读引用。
pub fn pool(&self) -> &SharedPool<ShiftTemplateKey, ShiftTemplate> {
&self.pool
}
/// 池的统计快照。
pub fn snapshot(&self) -> PoolSnapshot {
self.pool.snapshot()
}
}
/// 按规格与键构造一个班次模板。
///
/// 参数 key:享元键(提供技能等级与时段);schedule_spec:班次时刻规格。
/// 返回:构造好的模板。
///
/// ## 计算步骤与每一步的舍入
///
/// 1. 排班时长 = starts_at.minutes_until(ends_at)(跨零点自动绕圈);
/// 2. 计薪时长 = 排班时长 - 休息时长(下限为 0);
/// 3. 综合系数 = 技能基数 × 班次系数 × 时段上浮,两次乘除各舍入一次。
fn build_shift_template(
key: &ShiftTemplateKey,
schedule_spec: &ShiftScheduleSpec,
) -> ShiftTemplate {
// 步骤 1:排班时长。minutes_until 已处理跨零点(否则夜班会算成负数)。
let scheduled_minutes: u16 = schedule_spec
.starts_at()
.minutes_until(&schedule_spec.ends_at());
let scheduled_duration: WorkDuration = WorkDuration::from_minutes(scheduled_minutes as u32);
// 步骤 2:计薪时长 = 排班 - 休息(下限 0,防止休息配得比排班还长)。
let paid_duration: WorkDuration = scheduled_duration.subtract_floor_zero(
&schedule_spec.break_duration(),
);
// 步骤 3:综合系数。三次因子分两步乘,避免 i128 中间量过大。
let skill_basis_points: i64 = key.minimum_skill_grade().hourly_base_multiplier().basis_points();
let shift_basis_points: i64 = schedule_spec.shift_factor().basis_points();
let period_basis_points: i64 = key.effective_period_kind().surcharge_multiplier().basis_points();
let combined_pay_multiplier: Ratio = Ratio::from_basis_points(
combine_multipliers(skill_basis_points, shift_basis_points, period_basis_points),
);
// 是否跨零点:由时刻本身判断,不依赖调用方传入。
let crosses_midnight: bool = schedule_spec
.starts_at()
.crosses_midnight_to(&schedule_spec.ends_at());
ShiftTemplate::new(
key,
schedule_spec.starts_at(),
schedule_spec.ends_at(),
scheduled_duration,
schedule_spec.break_duration(),
paid_duration,
combined_pay_multiplier,
key.shift_code().requires_security_presence(),
schedule_spec.requires_dual_presence(),
crosses_midnight,
)
}
/// 把三个万分比因子连乘,每步各舍入一次。
///
/// 参数 first / second / third:三个万分比因子。
/// 返回:乘积(万分比)。
///
/// ## 为什么分两步而不是一次乘完再除
///
/// 一次乘完是 a * b * c / 10000^2,中间量最大约 20000^3 = 8 × 10^12,
/// i128 完全放得下,精度也更高(只舍入一次)。听起来更好。
///
/// 但本工程选分两步,理由是口径一致:其他地方(如
/// CurrencyAmount::scale_by_basis_points)都是「每次乘/除各舍入一次」。
/// 若这里用不同口径,会出现「模板里的系数」与「用该系数算钱」两步
/// 舍入方向不一致的错觉------实际上不会不一致(各算各的),
/// 但审计时很难解释。为了可解释性牺牲一点精度,在
/// 「系数只算 7 次」的场景下完全值得。
///
/// 这个取舍必须写下来,否则后来者会把它「优化」成一次乘完。
fn combine_multipliers(first: i64, second: i64, third: i64) -> i64 {
// 第一步:技能基数 × 班次系数。
let step_one: i128 = divide_rounded_away_from_zero(
first as i128 * second as i128,
10_000i128,
);
// 第二步:再乘时段上浮。
let step_two: i128 = divide_rounded_away_from_zero(step_one * third as i128, 10_000i128);
// 回落到 i64(系数不会接近 i64 边界,但统一走钳制以避免意外)。
crate::domain::clamp_i128_to_i64(step_two)
}
/// 供其他模块引用的「默认技能等级」便捷常量。
///
/// 放在本文件而非 domain:它表达的是本工厂的默认值选择,
/// 属于工厂的配置语义,不是领域事实。
pub const DEFAULT_MINIMUM_SKILL_GRADE: SkillGrade = SKILL_GRADE_JUNIOR;
/// 供其他模块引用的「默认计薪时段」便捷常量。
pub const DEFAULT_PAY_PERIOD: crate::domain::PayPeriodKind = PAY_PERIOD_NORMAL;
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : shift_template_key.rs
//! # 享元键 ------ 决定「什么算同一个」的那把尺子
//!
//! ## 键的设计就是享元的设计
//!
//! 享元池的一切行为都由键定义:
//! - 两个请求的键相等 → 共享同一个实例;
//! - 键不相等 → 各建一份实例。
//!
//! 因此「键包含哪些维度」直接决定了共享率与正确性,
//! 而这两个目标经常互相拉扯:
//!
//! | 键的粒度 | 模板数 | 内存 | 正确性 |
//! |---|---|---|---|
//! | 过细(含门店) | 门店数 × 班次数 | 暴涨(退化) | 正确但没省内存 |
//! | 过粗(丢时段) | 只有班次数 | 最省 | 算错钱 |
//! | 恰当 | 班次 × 技能 × 时段 | 省 | 正确 |
//!
//! 本类型用两个 Option 字段把这个权衡「可拨动」:
//! - [ShiftTemplateKey::period_scope]:None 表示刻意忽略计薪时段(过粗键);
//! - [ShiftTemplateKey::store_scope]:Some 表示刻意把门店纳入身份(过细键)。
//!
//! 这不是「为了演示而加的怪字段」------真实系统里这两个维度的取舍
//! 正是设计评审会吵起来的地方:有人主张「按门店建模板更灵活」,
//! 有人主张「时段都一样,不用分」。本工程把两种主张都实现出来,
//! 用真实的模板数与金额误差把它们分出高下。
//!
//! ## 谁不该进键
//!
//! 凡是「每次使用都不同」的维度都不能进键,否则池退化成缓存,
//! 且永不释放。典型的不该进键的维度:
//! - 日期(同一模板每天都在用,进键就变成 365 份);
//! - 员工工号(每人一份,等于没共享);
//! - 实际工时(每个槽位都不同)。
//!
//! 这些都属于「外在状态」,应该留在 client::ShiftSlot 里。
//! 第三幕会把「日期进键」与「门店进键」两种错误都跑一遍,
//! 让它们的模板数在报表里暴露出来。
// 同层引用(模块路径):键由四个领域标签组合而成。
use crate::domain::{PayPeriodKind, ShiftCode, SkillGrade};
/// 一个班次模板的享元键。
///
/// 字段全部私有:键只能经 [ShiftTemplateKey::new] 等构造器产生,
/// 保证 period_scope / store_scope 的取值处于「已设计」的形态,
/// 而不是任意组合。
#[derive(Debug, Clone, PartialEq, Eq, Hash)]
pub struct ShiftTemplateKey {
/// 班次编码(决定时刻与时长)。
///
/// 用 [ShiftCode] 的值而非其 code 字符串:
/// 类型化的键让「传错了维度」在编译期就被拒绝
/// (例如把 SkillGrade 传进班次参数位)。
shift_code: ShiftCode,
/// 最低技能等级(决定时薪基数与持证要求)。
///
/// ## 为什么技能等级必须进键
///
/// 同一个「晚班」,套在「见习」与「技师」身上,
/// 时薪基数分别是 80% 与 145%------这是两份不同的模板。
/// 若把技能等级移出键,两者会共享同一个模板,
/// 其中一方的成本必然算错。
///
/// 这一条的判定标准是:该维度是否影响享元的内容。
/// 影响就要进键,不影响(如门店等级)就留在外层。
minimum_skill_grade: SkillGrade,
/// 计薪时段维度。
///
/// - Some(时段):该维度参与共享身份 ------ 正确做法,
/// 平日班与节假日班是两个模板,系数不同;
/// - None:刻意忽略该维度 ------ 用于演示「键过粗」,
/// 所有时段的班次挤在同一个模板里,系数只能取一个。
period_scope: Option<PayPeriodKind>,
/// 门店维度。
///
/// - None:门店不参与共享身份 ------ 正确做法,跨店共享同一模板;
/// - Some(门店编码):该维度参与共享身份 ------ 用于演示「键过细」,
/// 模板数会乘上门店数,共享收益坍塌。
///
/// 用 &'static str 而不是 StoreCode:本字段只用于演示键的粒度,
/// 不需要 StoreCode 携带的城市名等信息。
/// 让演示专用的字段尽量窄,避免读者误以为它是正式的业务维度。
store_scope: Option<&'static str>,
}
impl ShiftTemplateKey {
/// 构造「正确粒度」的键。
///
/// 参数 shift_code / minimum_skill_grade / period_kind。
/// 返回:period_scope = Some(period_kind)、store_scope = None 的键。
///
/// 这是唯一应当出现在业务代码里的构造器。
/// 另两个构造器([ShiftTemplateKey::ignoring_pay_period] 与
/// [ShiftTemplateKey::scoped_to_store])只用于第四幕的对照演示。
pub fn new(
shift_code: ShiftCode,
minimum_skill_grade: SkillGrade,
period_kind: PayPeriodKind,
) -> ShiftTemplateKey {
ShiftTemplateKey {
shift_code,
minimum_skill_grade,
period_scope: Some(period_kind),
store_scope: None,
}
}
/// 构造「过粗粒度」的键:刻意不含计薪时段。
///
/// 参数 `shift_code` / `minimum_skill_grade`。
/// 返回:`period_scope = None` 的键。
///
/// ## 这个构造器存在的意义
///
/// 它让「键过粗」这个错误**可以只改一行就复现**,
/// 从而把「过粗键省内存但算错钱」这句话从主张变成可测量的结论。
/// 第四幕用它跑同一批数据,得到的模板数最少(因为不同时段挤在一起),
/// 但人力成本总额与正确口径**不一致**,差额会被算出来。
///
/// 之所以把它放在 `flyweight` 层而不是 `main.rs`:
/// 键的字段是私有的,只有本层能构造。若把它挪到工程外,
/// 就只能把字段改成公开------那会让「键是受控的」这个保证失效。
/// 这体现了「演示性 API 该放在哪一层」的判断:
/// **依赖私有字段的演示 API 必须留在定义域内,并在文档里标明用途。**
pub fn ignoring_pay_period(
shift_code: ShiftCode,
minimum_skill_grade: SkillGrade,
) -> ShiftTemplateKey {
ShiftTemplateKey {
shift_code,
minimum_skill_grade,
period_scope: None,
store_scope: None,
}
}
/// 把门店纳入共享身份(「过细粒度」键)。
///
/// 参数 `store_code`:门店编码。
/// 返回:`store_scope = Some(store_code)` 的新键。
///
/// 用 `self` 取值而不是 `&mut self`:键是值类型且 `Clone` 成本极低,
/// 用「消费式」链式调用可以让「同一个基键派生出多把过细键」写成一行,
/// 且不会意外复用带旧 `store_scope` 的键。
pub fn scoped_to_store(mut self, store_code: &'static str) -> ShiftTemplateKey {
self.store_scope = Some(store_code);
self
}
/// 班次编码。
pub const fn shift_code(&self) -> ShiftCode {
self.shift_code
}
/// 最低技能等级。
pub const fn minimum_skill_grade(&self) -> SkillGrade {
self.minimum_skill_grade
}
/// 计薪时段(若参与共享身份)。
pub const fn period_scope(&self) -> Option<PayPeriodKind> {
self.period_scope
}
/// 门店(若参与共享身份)。
pub const fn store_scope(&self) -> Option<&'static str> {
self.store_scope
}
/// 计薪时段,缺省时返回「平日」。
///
/// 供构造模板时取系数用:键忽略时段时,模板必须挑一个系数兜底,
/// 本工程挑「平日」(系数 1.00)。**这个兜底正是过粗键算错钱的根源**
/// ------节假日排班会被按平日系数计价。
///
/// 把兜底做成一个显式方法(而不是在构造函数里写 `unwrap_or`),
/// 是为了让「这里有一个不确定的默认」在代码里可见。
pub fn effective_period_kind(&self) -> PayPeriodKind {
self.period_scope
.unwrap_or(crate::domain::PAY_PERIOD_NORMAL)
}
/// 返回键的紧凑文本(形如 `EARLY/SENIOR/HOLIDAY`),用于报表。
///
/// 不打印 `store_scope`:它在正确设计下恒为 `None`,
/// 逐行打印一长串 `None` 只是噪音。
/// 若确实需要诊断过细键,用 [`ShiftTemplateKey::diagnostic_text`]。
pub fn compact_text(&self) -> String {
format!(
"{}/{}/{}",
self.shift_code.code(),
self.minimum_skill_grade.code(),
self.effective_period_kind().code()
)
}
/// 返回**诊断用**的完整文本,把每个字段都显式写出来。
///
/// 形如:
/// - 正确键(含时段、无门店范围):`EARLY/SENIOR/HOLIDAY@-`
/// - 过粗键(时段缺失):`EARLY/SENIOR/<时段缺失>@-`
/// - 过细键(并入门店范围):`EARLY/SENIOR/HOLIDAY@LF0001`
///
/// ## 为什么诊断文本必须与紧凑文本不同
///
/// 这对「过粗键」是关键:`compact_text` 对过粗键打印的是
/// **回退值** `.../NORMAL`,与「正确键 + 平日」的文本**完全相同**。
/// 于是只看紧凑文本,无法分辨
///
/// - 「这是按平日正确构造的键」,还是
/// - 「这是丢了时段、被兜底成平日的键」
///
/// 而这两者的业务后果截然不同(后者会让节假日少算一倍工资)。
/// 诊断文本因此把「缺失」显式打印成一个不同的记号。
///
/// **可观测性的核心,是让不同的状态有不同的文本表示。**
/// 若两种不同状态打印出同一段文字,那么日志就失去了区分能力------
/// 而日志正是事故排查的唯一依据。
///
/// 供第三幕的「三种键对照表」使用。与 `compact_text` 分开,
/// 正是为了让「正常报表」与「诊断报表」的口径在类型上就分开,
/// 不会有人顺手在正式报表里打出带门店的键。
pub fn diagnostic_text(&self) -> String {
// 时段:缺失时必须打印成不同的记号,而不是回退值。
let period_text: String = match self.period_scope {
Some(period_kind) => period_kind.code().to_string(),
None => "<时段缺失>".to_string(),
};
// 门店范围:无范围时用一个单字符占位(`-`)而不是省略,
// 这样三个字段的位置在文本里始终固定,便于按列对照。
let store_text: &str = self.store_scope.unwrap_or("-");
format!(
"{}/{}/{}@{}",
self.shift_code.code(),
self.minimum_skill_grade.code(),
period_text,
store_text
)
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : store_grade_factory.rs
//!
//! # 门店等级工厂 ------ 第二族享元的工厂
//!
//! ## 本文件证明了什么
//!
//! 把它与 shift_template_factory.rs 并读,能看到两件事:
//!
//! 1. 两族工厂结构同形:都是「一个 SharedPool + 一张登记表」,
//! 只是类型参数与登记内容不同。这直接说明享元机制是可复用的。
//! 2. 两族的复杂度差异来自业务,不来自模式:班次模板需要
//! 复合键与时刻计算(业务复杂),门店等级只需要一个标签
//! (业务简单)。模式本身不增加复杂度------这是本工程想说明的
//! 一个反直觉结论:用了享元的两族只要业务简单,代码就仍然简单。
//!
//! ## 键是 StoreGrade 本身
//!
//! 不再包一层 StoreGradeKey。理由:StoreGrade 的 PartialEq/Hash
//! 已被手工实现为「身份即 code」(见 domain::store_grade),
//! 它本身就是一个合格的键。再包一层只会多一个无信息的类型。
//!
//! 这与班次模板形成对照:那里必须包一层,因为键是
//! 「班次 × 技能 × 时段」的复合体,而不是某个既有类型。
//! 判断标准:键恰好是某个既有类型时就直接用;是多维组合时才新建键类型。
use std::cell::RefCell;
use std::collections::HashMap;
use crate::domain::{
ShiftCode, StoreGrade, SHIFT_CODE_EARLY, SHIFT_CODE_LATE, SHIFT_CODE_MIDDLE,
SHIFT_CODE_NIGHT_AUDIT, SHIFT_CODE_WEEKEND_BOOST, STORE_GRADE_COMMUNITY,
STORE_GRADE_FLAGSHIP, STORE_GRADE_STANDARD,
};
use crate::support::clock_time::ClockTime;
use super::pool_snapshot::PoolSnapshot;
use super::shared_pool::{SharedHandle, SharedPool};
use super::store_grade_profile::StoreGradeProfile;
/// 门店等级工厂。
pub struct StoreGradeFactory {
/// 共享池。键就是门店等级本身。
pool: SharedPool<StoreGrade, StoreGradeProfile>,
/// 等级 → 配置规格的登记表。
///
/// ## 为什么还要一张登记表,而不是把配置直接写进 build 函数
///
/// 与班次工厂同理:写进 match 就无法工程外扩展。
/// 登记表让「新增一个门店等级配置」变成一次运行期调用,
/// 而不是一次源码修改。
registry: RefCell<HashMap<StoreGrade, StoreGradeProfileSpec>>,
}
/// 一个门店等级的配置规格(可运行期登记)。
///
/// 与 [super::shift_template_factory::ShiftScheduleSpec] 同构:
/// 把「构造实例所需的全部输入」打包成一个值类型,
/// 使登记接口的签名稳定(将来加字段不必改方法签名)。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct StoreGradeProfileSpec {
/// 门店等级。
grade: StoreGrade,
/// 每班次最低在岗人数。
minimum_staff_per_shift: u32,
/// 是否配备专职安保。
requires_dedicated_security: bool,
/// 营业开始时刻。
opening_time: ClockTime,
/// 营业结束时刻。
closing_time: ClockTime,
/// 是否要求每日盘点。
daily_audit_required: bool,
/// 默认开设的班次序列。
standard_shift_codes: Vec<ShiftCode>,
/// 合规提示。
compliance_notes: Vec<&'static str>,
}
impl StoreGradeProfileSpec {
/// 构造一个门店等级配置规格。
///
/// 参数较多且都是配置项,因此接收两个 Vec。
/// 不做成 const fn:Vec 无法在 const 上下文里构造,
/// 而数组转 Vec 需要 to_vec()(运行期)。
/// 工程外的扩展区因此需要在运行期登记(一行 register_... 调用),
/// 这比班次时刻表(可 const)稍繁琐,但完全可接受。
#[allow(clippy::too_many_arguments)]
pub fn new(
grade: StoreGrade,
minimum_staff_per_shift: u32,
requires_dedicated_security: bool,
opening_time: ClockTime,
closing_time: ClockTime,
daily_audit_required: bool,
standard_shift_codes: Vec<ShiftCode>,
compliance_notes: Vec<&'static str>,
) -> StoreGradeProfileSpec {
StoreGradeProfileSpec {
grade,
minimum_staff_per_shift,
requires_dedicated_security,
opening_time,
closing_time,
daily_audit_required,
standard_shift_codes,
compliance_notes,
}
}
/// 门店等级。
pub const fn grade(&self) -> StoreGrade {
self.grade
}
/// 每班次最低在岗人数。
pub const fn minimum_staff_per_shift(&self) -> u32 {
self.minimum_staff_per_shift
}
/// 是否配备专职安保。
pub const fn requires_dedicated_security(&self) -> bool {
self.requires_dedicated_security
}
/// 营业开始时刻。
pub const fn opening_time(&self) -> ClockTime {
self.opening_time
}
/// 营业结束时刻。
pub const fn closing_time(&self) -> ClockTime {
self.closing_time
}
/// 是否要求每日盘点。
pub const fn daily_audit_required(&self) -> bool {
self.daily_audit_required
}
/// 默认开设的班次序列。
pub fn standard_shift_codes(&self) -> &[ShiftCode] {
&self.standard_shift_codes
}
/// 合规提示。
pub fn compliance_notes(&self) -> &[&'static str] {
&self.compliance_notes
}
}
impl StoreGradeFactory {
/// 建一个已登记 3 个内置门店等级的工厂。
pub fn with_builtin_grades() -> StoreGradeFactory {
let factory = StoreGradeFactory {
pool: SharedPool::new(),
registry: RefCell::new(HashMap::new()),
};
factory.register_builtin_grade_specs();
factory
}
/// 登记 3 个内置门店等级的配置。
fn register_builtin_grade_specs(&self) {
// 旗舰店:核心商圈,4 个班次,配专职安保,每日盘点。
self.register_grade_spec(StoreGradeProfileSpec::new(
STORE_GRADE_FLAGSHIP,
6,
true,
ClockTime::from_hour_and_minute(9, 0),
ClockTime::from_hour_and_minute(22, 30),
true,
vec![
SHIFT_CODE_EARLY,
SHIFT_CODE_MIDDLE,
SHIFT_CODE_LATE,
SHIFT_CODE_WEEKEND_BOOST,
],
vec![
"旗舰店须每日闭店盘点,双人 + 安保在场",
"节假日须提前 7 日提交加强班排班",
],
));
// 标准店:3 个班次,配专职安保,每日盘点。
self.register_grade_spec(StoreGradeProfileSpec::new(
STORE_GRADE_STANDARD,
4,
true,
ClockTime::from_hour_and_minute(9, 30),
ClockTime::from_hour_and_minute(21, 30),
true,
vec![SHIFT_CODE_EARLY, SHIFT_CODE_MIDDLE, SHIFT_CODE_LATE],
vec!["标准店须每日闭店盘点,双人在场"],
));
// 社区店:2 个班次,不配专职安保(由总部巡检替代),隔日盘点。
self.register_grade_spec(StoreGradeProfileSpec::new(
STORE_GRADE_COMMUNITY,
2,
false,
ClockTime::from_hour_and_minute(10, 0),
ClockTime::from_hour_and_minute(20, 30),
// 社区店隔日盘点,由总部安保巡检覆盖。
false,
vec![SHIFT_CODE_EARLY, SHIFT_CODE_LATE],
vec!["社区店隔日盘点,由总部安保巡检覆盖", "盘点夜班须提前报备总部"],
));
}
/// 登记一个门店等级配置。
///
/// 参数 `spec`:配置规格。
/// 返回:成功返回 `true`;该等级已登记(不覆盖)返回 `false`。
///
/// 与班次工厂的登记接口同样的语义:不覆盖,用返回值暴露「编码已被占用」。
pub fn register_grade_spec(&self, spec: StoreGradeProfileSpec) -> bool {
let mut registry = self.registry.borrow_mut();
if registry.contains_key(&spec.grade()) {
return false;
}
registry.insert(spec.grade(), spec);
true
}
/// 已登记的门店等级数量。
pub fn registered_grade_count(&self) -> usize {
self.registry.borrow().len()
}
/// 门店等级是否已登记。
pub fn is_grade_registered(&self, grade: &StoreGrade) -> bool {
self.registry.borrow().contains_key(grade)
}
/// 取得(或新建)一个共享门店等级配置。
///
/// 参数 `grade`:门店等级。
/// 返回:共享实例;未登记时返回 `None`。
///
/// ## 为什么返回 `Option` 而不是像班次工厂那样返回具名错误
///
/// 班次工厂有**两种**失败(未登记 / 池满),需要枚举来区分;
/// 本工厂的池不限容量(门店等级只有 3~5 个,不会失控),
/// 因此只剩「未登记」一种失败------`Option` 已经表达了全部信息,
/// 再造一个只有一个变体的枚举只是噪音。
///
/// **错误类型的复杂度应当与失败模式的复杂度匹配。**
pub fn obtain(&self, grade: StoreGrade) -> Option<SharedHandle<StoreGradeProfile>> {
// 先查登记表(只读借用,随后释放)。
let registered_spec: StoreGradeProfileSpec = {
let registry = self.registry.borrow();
registry.get(&grade)?.clone()
};
// 再向池取/建。池不限容量,因此 `obtain` 不会失败。
self.pool
.obtain(grade, |looked_up_grade| {
StoreGradeProfile::new(
*looked_up_grade,
registered_spec.minimum_staff_per_shift(),
registered_spec.requires_dedicated_security(),
registered_spec.opening_time(),
registered_spec.closing_time(),
registered_spec.daily_audit_required(),
registered_spec.standard_shift_codes().to_vec(),
registered_spec.compliance_notes().to_vec(),
)
})
.ok()
}
/// 共享池的只读引用。
pub fn pool(&self) -> &SharedPool<StoreGrade, StoreGradeProfile> {
&self.pool
}
/// 池的统计快照。
pub fn snapshot(&self) -> PoolSnapshot {
self.pool.snapshot()
}
}
/// 供扩展区参考的「夜班盘点班次」便捷常量。
///
/// 放在本文件是因为它属于「工厂内置登记时的选择」,
/// 不是领域事实。
pub const BUILTIN_AUDIT_SHIFT_CODE: ShiftCode = SHIFT_CODE_NIGHT_AUDIT;
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : store_grade_profile.rs
//! # 门店等级配置 ------ 第二族享元(内在状态)
//!
//! ## 为什么要有第二族
//!
//! 只做一族享元,能证明的只是「某种对象可以共享」。
//! 加第二族后,本工程能证明一件更有价值的事:
//! 享元机制本身是可复用的------两族共用同一个泛型池
//! (SharedPool),只有键类型与实例类型不同。
//!
//! 这一点与 GoF 原书的例子吻合:原书里 Glyph(字形)的内在状态
//! 被多个字符位置共享。本工程的 StoreGradeProfile 正是「同一份配置
//! 被多家门店共享」------比「同一模板被多个槽位共享」更接近原书的形态。
//!
//! ## 与 ShiftTemplate 的三点不同(正是这三点让它有对照价值)
//!
//! | 维度 | ShiftTemplate | StoreGradeProfile |
//! |---|---|---|
//! | 含堆分配字段 | 否(零堆) | 是(两个 Vec) |
//! | 键的类型 | 复合键(班次×技能×时段) | 单一标签(门店等级) |
//! | 实例数 | 7 个(随排班组合增长) | 3 个(固定) |
//!
//! 第二点尤其重要:键可以很简单。并非所有享元都需要复合键------
//! 当「配置由单一维度唯一决定」时,一个标签就够了。
//! 若硬要套用复合键,反而会不必要地增加池的条目数。
//!
//! 第一点让 [FlyweightFootprint] 的实现有了对照:
//! ShiftTemplate 的实现只写 size_of,而本类型必须额外累加 Vec 内容。
//! 两个实现并排放着,读者能直接看出「什么时候需要多算堆内容」。
use crate::domain::ShiftCode;
use crate::support::clock_time::ClockTime;
use super::footprint::FlyweightFootprint;
/// 一个门店等级的运营配置(享元本体)。
///
/// 字段全部私有:与 ShiftTemplate 同样的理由------
/// 共享实例必须不可变,而私有字段 + 只读方法是 Rust 里
/// 表达这条约定最直接的方式。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct StoreGradeProfile {
/// 该配置适用的门店等级。冗余存一份,便于从实例回溯身份。
grade: crate::domain::StoreGrade,
/// 每班次最低在岗人数。
minimum_staff_per_shift: u32,
/// 是否配备专职安保。
requires_dedicated_security: bool,
/// 营业开始时刻。
opening_time: ClockTime,
/// 营业结束时刻。
closing_time: ClockTime,
/// 是否要求每日盘点(涉及开保险柜,需双人 + 安保)。
daily_audit_required: bool,
/// 该等级默认开设的班次序列。
///
/// ## 为什么用 Vec 而不是固定长度数组
///
/// 不同等级的班次数量不同(社区店 2 个、旗舰店 4 个)。
/// 用定长数组要为所有等级按最大值分配空间(浪费),
/// 且「实际几个」还要另存一个长度------等于手写 Vec。
///
/// 在享元里用 Vec 是安全的:实例只有 3 个,
/// 每个 Vec 一次分配后就再不变动,不会被反复读写。
/// 若换成数万槽位各自持有一个 Vec,那才是灾难------
/// 而那正是「不用享元」的对照版本要做的事(见 main.rs 扩展区)。
standard_shift_codes: Vec<ShiftCode>,
/// 合规提示(该等级特有的注意事项)。
///
/// 元素类型是 &'static str:字符串内容位于二进制的只读段,
/// 不随实例分配堆内存。因此本字段的堆开销只有
/// Vec 本身的槽位(每元素 16 字节),不含字符串内容。
/// 这一点在 [FlyweightFootprint::estimated_bytes] 里有对应处理,
/// 两处必须一致------否则内存统计会静默偏差。
compliance_notes: Vec<&'static str>,
}
impl StoreGradeProfile {
/// 构造一个门店等级配置。
///
/// 不对外开放(pub(crate)):理由与 ShiftTemplate::new 完全相同------
/// 保证所有实例都出自工厂,不产生「游离副本」。
pub(crate) fn new(
grade: crate::domain::StoreGrade,
minimum_staff_per_shift: u32,
requires_dedicated_security: bool,
opening_time: ClockTime,
closing_time: ClockTime,
daily_audit_required: bool,
standard_shift_codes: Vec<ShiftCode>,
compliance_notes: Vec<&'static str>,
) -> StoreGradeProfile {
StoreGradeProfile {
grade,
minimum_staff_per_shift,
requires_dedicated_security,
opening_time,
closing_time,
daily_audit_required,
standard_shift_codes,
compliance_notes,
}
}
/// 门店等级。
pub const fn grade(&self) -> crate::domain::StoreGrade {
self.grade
}
/// 每班次最低在岗人数。
pub const fn minimum_staff_per_shift(&self) -> u32 {
self.minimum_staff_per_shift
}
/// 是否配备专职安保。
pub const fn requires_dedicated_security(&self) -> bool {
self.requires_dedicated_security
}
/// 营业开始时刻。
pub const fn opening_time(&self) -> ClockTime {
self.opening_time
}
/// 营业结束时刻。
pub const fn closing_time(&self) -> ClockTime {
self.closing_time
}
/// 是否要求每日盘点。
pub const fn daily_audit_required(&self) -> bool {
self.daily_audit_required
}
/// 默认开设的班次序列。
pub fn standard_shift_codes(&self) -> &[ShiftCode] {
&self.standard_shift_codes
}
/// 默认班次数量。
pub fn standard_shift_count(&self) -> usize {
self.standard_shift_codes.len()
}
/// 合规提示。
pub fn compliance_notes(&self) -> &[&'static str] {
&self.compliance_notes
}
/// 营业时长(分钟)。
pub fn opening_duration(&self) -> crate::domain::WorkDuration {
let minutes: u16 = self.opening_time.minutes_until(&self.closing_time);
crate::domain::WorkDuration::from_minutes(minutes as u32)
}
/// 返回「营业 09:00-22:00 | 每班最低 6 人」形式的一行摘要。
///
/// 与 `ShiftTemplate::formatted` 同样属于「层内自带排版」,
/// 报表层不会采用它------第七幕会并列打印以演示排版职责的归属。
pub fn formatted(&self) -> String {
format!(
"{} | 营业 {}-{} | 每班最低 {} 人 | 安保 {}",
self.grade.display_name(),
self.opening_time.formatted(),
self.closing_time.formatted(),
self.minimum_staff_per_shift,
if self.requires_dedicated_security {
"配"
} else {
"不配"
}
)
}
}
impl FlyweightFootprint for StoreGradeProfile {
/// 返回配置的估算字节数。
///
/// ## 与 ShiftTemplate 的实现对照
///
/// 本类型有堆分配字段(两个 Vec),因此必须
/// 「size_of + 各 Vec 的槽位字节」。而 ShiftTemplate
/// 只需要 size_of。两个实现放在一起,就是
/// 「何时需要额外算堆」的判定示范。
///
/// ## 三个必须写明的口径
///
/// 1. 按 len() 不按 capacity():分配器实际给的容量可能更大,
/// 本工程统一按内容长度计(见 footprint 模块的口径声明)。
/// 2. &'static str 的内容不计:那些字符串在二进制只读段,
/// 不随实例分配。只计 Vec 里每个元素的 16 字节槽位。
/// 3. ShiftCode 是按值存在 Vec 里的:因此要按
/// size_of::<ShiftCode>() 而非指针大小计。
///
/// 第 3 点尤其容易写错------Vec<T> 的堆开销是
/// len × size_of::<T>(),而 T 是 ShiftCode(值类型,约 40 字节),
/// 不是 &ShiftCode(8 字节)。写成后者会把统计低估 5 倍。
fn estimated_bytes(&self) -> usize {
// 栈内固定部分。
let inline_bytes: usize = std::mem::size_of::<StoreGradeProfile>();
// standard_shift_codes 的堆槽位:按值存储,每个 size_of::<ShiftCode>()。
let shift_code_bytes: usize =
self.standard_shift_codes.len() * std::mem::size_of::<ShiftCode>();
// compliance_notes 的堆槽位:每元素一个 &'static str(16 字节),
// 字符串内容在只读段,不重复计算。
let note_bytes: usize = self.compliance_notes.len() * std::mem::size_of::<&'static str>();
inline_bytes + shift_code_bytes + note_bytes
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : calendar_date.rs
//! # 日历日 ------ 只到「日」的精度
//!
//! ## 为什么不直接用时间戳
//!
//! 排班的业务单位是「日」:某门店某天需要哪几个班次。
//! 用时间戳(自epoch秒数)表示日期会引入两个麻烦:
//! 1. 时区问题------同一时刻在不同时区是不同的「日」,排班表会随服务器时区漂移;
//! 2. 可读性------调试输出全是 1790985600,人眼无法核对。
//!
//! 因此本类型只存 (年, 月, 日) 三个 u16,共 6 字节。
//! 这个宽度对本工程很关键:享元的键里会用到日期,
//! 键的每个字节都乘以「排班槽位总数」(本工程演示规模下是三万量级),
//! 所以「日期占几字节」直接影响共享后的总内存。
//!
//! ## 星期推算用的是 Sakamoto 查表版
//!
//! ⚠️ 踩坑记录(来自同系列 Facade 工程的实测事故):
//! 曾误用算术近似式 (26 * (m + 1)) / 10 来代替月份偏移表。
//! 这个式子只是 floor(2.6 * (m + 1)) 的整数写法,
//! 与标准偏移表在 3 月、9 月等多个月份上并不相等,
//! 会导致整年星期错一位(2026-10-05 是周一,错版算法算出周二)。
//! 一旦星期错位,「周末班次时薪上浮」这类规则就会全线算错。
//!
//! 教训:这类有公认表格的算法,宁可把表写出来,也不要用「看起来等价」的算式。
//! 本文件末尾的 weekday_index 用的是查表版,且已用 Python datetime 交叉校验。
/// 一个不含时间的日历日。
///
/// 字段全部为 u16:年份到 65535 足够,月份 1..=12,日 1..=31。
/// 三者合计 6 字节,无填充(对齐要求为 2)。
///
/// ## 为什么字段是私有的
///
/// 本类型会作为享元键的一部分(见 flyweight::shift_template_key)。
/// 若字段公开,任何人都能构造出 month = 13 的非法值,
/// 进而污染享元池------错误的数据会被当成合法的键去共享。
/// 私有字段 + 构造时钳制,把非法值挡在类型之外。
#[derive(Debug, Clone, Copy, PartialEq, Eq, Hash, PartialOrd, Ord)]
pub struct CalendarDate {
/// 年(如 2026)。
year: u16,
/// 月(1..=12)。
month: u8,
/// 日(1..=31,且不超过该月实际天数)。
day: u8,
}
impl CalendarDate {
/// 按年月日构造一个日期,非法值就近钳制而非 panic。
///
/// 参数 year / month / day:年月日。
/// 返回:钳制后的合法日期。
///
/// ## 为什么选「钳制」而不是 panic!
///
/// 本工程的数据来源是演示数据构造与工程外扩展。
/// 扩展者写错月份(如 13)时,若直接 panic,整个演示崩掉、
/// 什么信息都得不到;若钳制到 12 月并继续,报表里会出现
/// 「2026-12-31」这个明显不对的日期,错误可见且可追踪。
///
/// 这叫「fail visible, not fail fast」------对演示工程而言,
/// 让错误出现在输出里比让程序崩溃更有价值。
/// 生产代码应当相反(宁可快速失败),这一点必须在注释里讲清楚,
/// 免得读者把这个选择当成通用建议抄走。
pub const fn from_ymd(year: u16, month: u8, day: u8) -> CalendarDate {
// 第一步:把月份钳到 1..=12。
let clamped_month: u8 = if month < 1 {
1
} else if month > 12 {
12
} else {
month
};
// 第二步:取该月实际天数,再把日钳到 1..=该天数。
let maximum_day: u8 = days_in_month(year, clamped_month);
let clamped_day: u8 = if day < 1 {
1
} else if day > maximum_day {
maximum_day
} else {
day
};
CalendarDate {
year,
month: clamped_month,
day: clamped_day,
}
}
/// 年。
pub const fn year(&self) -> u16 {
self.year
}
/// 月(1..=12)。
pub const fn month(&self) -> u8 {
self.month
}
/// 日(1..=31)。
pub const fn day(&self) -> u8 {
self.day
}
/// 返回 `YYYY-MM-DD` 文本。
///
/// 用于报表与调试输出。补零宽度固定为 2/2/4,
/// 因此同一年份区间内所有日期的文本宽度完全一致,可直接对齐。
pub fn formatted(&self) -> String {
format!("{:04}-{:02}-{:02}", self.year, self.month, self.day)
}
/// 返回「M 月 D 日」文本(省略年份)。
///
/// 排班表通常是「同一个月内的展开」,逐行带年份纯属噪音。
pub fn month_day_text(&self) -> String {
format!("{} 月 {} 日", self.month, self.day)
}
/// 按自然日推进(可为负数,即回退)。
///
/// 参数 `day_count`:要推进的天数。
/// 返回:推进后的日期。
///
/// 实现采用「逐日循环」而非「查表跳月」:
/// 排班表的日期区间通常不超过一个季度(< 100 天),
/// 逐日循环最多 100 次,代价可忽略;而跳月逻辑要处理
/// 闰年、月末、月首跨年等多个分支,出错概率高得多。
/// 这里用性能换正确性,是划算的取舍。
pub fn add_days(&self, day_count: i32) -> CalendarDate {
// 先转成可变状态,逐日推进后再统一校验。
let mut current_year: i32 = self.year as i32;
let mut current_month: u8 = self.month;
let mut current_day: u8 = self.day;
// 正负两个方向用同一套循环:每轮把 day 加减 1,
// 越界则进位/退位到相邻月,直到走完 day_count 次。
let remaining_steps: i32 = day_count.abs();
// 方向:+1 表示向后,-1 表示向前。
let direction: i32 = if day_count >= 0 { 1 } else { -1 };
for _ in 0..remaining_steps {
let tentative_day: i32 = current_day as i32 + direction;
if tentative_day < 1 {
// 退到上个月的最后一天。
let (previous_year, previous_month): (i32, u8) = previous_month_year(
current_year,
current_month,
);
current_year = previous_year;
current_month = previous_month;
current_day = days_in_month(current_year as u16, current_month);
} else if tentative_day as u8 > days_in_month(current_year as u16, current_month) {
// 进到下个月的第一天。
let (next_year, next_month): (i32, u8) = next_month_year(
current_year,
current_month,
);
current_year = next_year;
current_month = next_month;
current_day = 1;
} else {
// 月内正常推进。
current_day = tentative_day as u8;
}
}
// 年份在 i32 域内运算,回落到 u16 时钳制,避免负数溢出。
let bounded_year: u16 = if current_year < 0 {
0
} else if current_year > u16::MAX as i32 {
u16::MAX
} else {
current_year as u16
};
CalendarDate::from_ymd(bounded_year, current_month, current_day)
}
/// 计算 `self` 到 `other` 之间相差的自然日数(`other - self`)。
///
/// 参数 `other`:目标日期。
/// 返回:天数差,可为负。
///
/// ## 为什么不用「转儒略日相减」
///
/// 儒略日公式(如 `367*Y - ...`)是另一处容易写错的算术------
/// 同类的「Sakamoto 算术近似式」已经在本工程里翻过车。
/// 本工程改用「逐日推进 + 计数」,代价是 O(天数),
/// 但天数区间受控(演示数据 ≤ 40 天),且**逻辑可肉眼验证**:
/// 每次只能前进或后退一天,不存在「公式差一点」的可能。
///
/// 这个选择本身值得记录:**当正确性无法通过读代码确认时,
/// 宁可换成慢但显然正确的算法。**
pub fn days_until(&self, other: &CalendarDate) -> i32 {
// 两日期相等,直接返回 0(避免下面的循环无意义地跑)。
if self == other {
return 0;
}
// 向后推进直到追上 other。
if *other > *self {
let mut cursor: CalendarDate = *self;
let mut advanced_days: i32 = 0;
// 上限保护:年份跨度过大时终止,避免极端输入造成长循环。
while cursor != *other && advanced_days < 100_000 {
cursor = cursor.add_days(1);
advanced_days += 1;
}
return advanced_days;
}
// 向前回退直到追上 other。
let mut cursor: CalendarDate = *self;
let mut retreated_days: i32 = 0;
while cursor != *other && retreated_days > -100_000 {
cursor = cursor.add_days(-1);
retreated_days -= 1;
}
retreated_days
}
/// 返回星期索引(0 = 周一 ... 6 = 周日)。
///
/// ## 实现:Sakamoto 算法(查表版)
///
/// 算法分三步:
/// 1. 1 月、2 月视为上一年的 13、14 月(这样闰年规则可统一处理);
/// 2. 用年份、世纪修正项与**月份偏移表**累加出一个整数;
/// 3. 对 7 取模,得到以周日为 0 的索引,再映射到「周一为 0」。
///
/// 第 2 步的月份偏移表是 `[0, 3, 2, 5, 0, 3, 5, 1, 4, 6, 2, 4]`
/// (下标 0 对应 1 月)。它是对「各月 1 日与年初的星期偏移」预先算好的表。
///
/// ⚠️ 再次强调:**不要**把这个表换成 `(26 * (month + 1)) / 10`
/// 之类的算术式,两者在 3 月、9 月等月份不等,会整年错位。
/// 有公认表格就直接写表。
pub fn weekday_index(&self) -> u32 {
// 标准 Sakamoto 月份偏移表(下标 0 = 1 月)。
const MONTH_OFFSET_TABLE: [i32; 12] = [0, 3, 2, 5, 0, 3, 5, 1, 4, 6, 2, 4];
// 1 月、2 月归属上一年,便于统一闰日处理。
let adjusted_year: i32 = if self.month < 3 {
self.year as i32 - 1
} else {
self.year as i32
};
// 核心累加:年 + 年/4 - 年/100 + 年/400 + 月偏移 + 日。
// 其中 `年/4 - 年/100 + 年/400` 是完整的闰年修正(含百年例外与四百年回归)。
let raw_sum: i32 = adjusted_year
+ adjusted_year / 4
- adjusted_year / 100
+ adjusted_year / 400
+ MONTH_OFFSET_TABLE[(self.month - 1) as usize]
+ self.day as i32;
// 取模得到「0 = 周日」的索引;`+7` 再取模用于兜住负数(年份为 0 附近时)。
let sunday_based_index: i32 = ((raw_sum % 7) + 7) % 7;
// 映射为「0 = 周一」:周日(0) 变成 6,周一(1) 变成 0,依此类推。
if sunday_based_index == 0 {
6
} else {
(sunday_based_index - 1) as u32
}
}
/// 星期中文单字(一 / 二 / 三 / 四 / 五 / 六 / 日)。
pub fn weekday_text(&self) -> &'static str {
// 下标 0 对应周一,与 weekday_index 的约定一致。
const WEEKDAY_LABELS: [&str; 7] = ["一", "二", "三", "四", "五", "六", "日"];
WEEKDAY_LABELS[self.weekday_index() as usize]
}
/// 是否为周末(周六或周日)。
///
/// 珠宝门店周末客流高,排班模板里「周末加强班」的时薪系数不同,
/// 因此这个判定会参与班次模板的**键**------这正是「享元键要包含
/// 所有影响共享语义的维度」的一个具体例子(见第四幕)。
pub fn is_weekend(&self) -> bool {
// 索引 5 = 周六,6 = 周日。
self.weekday_index() >= 5
}
}
/// 判断某年是否闰年。
///
/// 参数 year:公元年。
/// 返回:闰年返回 true。
///
/// 规则:能被 4 整除,但不能被 100 整除;除非能被 400 整除。
/// 写成三行条件而不是一个布尔表达式,是为了让「百年例外」与「四百年回归」
/// 两条规则在代码里各自可见------这是最容易漏掉的两条。
pub const fn is_leap_year(year: u16) -> bool {
// 四百年回归优先:2000 是闰年。
if year % 400 == 0 {
return true;
}
// 百年例外:1900 不是闰年。
if year % 100 == 0 {
return false;
}
// 常规规则:能被 4 整除即可。
year % 4 == 0
}
/// 返回某年某月的天数。
///
/// 参数 year / month:年月(month 假定已合法,1..=12)。
/// 返回:该月天数(28..=31)。
///
/// 用 match 精确列出每月天数,而不是「30 天 + 特例判断」------
/// 后者需要记住哪几个月是 31 天,容易在 8 月/9 月交界处写错。
pub const fn days_in_month(year: u16, month: u8) -> u8 {
match month {
1 | 3 | 5 | 7 | 8 | 10 | 12 => 31,
4 | 6 | 9 | 11 => 30,
2 => {
// 二月天数取决于闰年。
if is_leap_year(year) {
29
} else {
28
}
}
// 非法月份(调用方已钳制,这里只是兜底)按 31 处理。
_ => 31,
}
}
/// 返回某月的上一个月(跨年时自动退一年)。
///
/// 参数 year / month。
/// 返回:(上一年的年, 上一月)。
///
/// 抽成自由函数而不是 CalendarDate 的方法:它操作的是「年月」这一对值,
/// 与「日」无关,放在类型上反而要多做一次解构与重组。
const fn previous_month_year(year: i32, month: u8) -> (i32, u8) {
if month == 1 {
// 1 月的上一月是上一年 12 月。
(year - 1, 12)
} else {
(year, month - 1)
}
}
/// 返回某月的下一个月(跨年时自动进一年)。
///
/// 参数 year / month。
/// 返回:(下一年的年, 下一月)。
const fn next_month_year(year: i32, month: u8) -> (i32, u8) {
if month == 12 {
// 12 月的下一月是下一年 1 月。
(year + 1, 1)
} else {
(year, month + 1)
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : clock_time.rs
//! # 一天内的时刻 ------ 以「零点起的分钟数」为单位
//!
//! ## 为什么不用 (时, 分) 两个字段
//!
//! 班次有「开始时刻」与「时长」两个维度,报表要算「结束时刻」。
//! 若用 (hour, minute) 两个字段,每次算时刻加法都要处理进位
//! (minute + 45 > 59 时进位到 hour),分支多、易错。
//!
//! 用「零点起的分钟数」(0..=1439)单一整数表示后:
//! - 时刻加法 = 整数加法 + 取模 1440(一行搞定);
//! - 比较大小 = 整数比较(天然正确);
//! - 存储 = 2 字节(u16 足够,最大 1439)。
//!
//! ## 跨零点的夜班是必须处理的情况
//!
//! 珠宝门店的「夜班盘点」是 22:30 上班、次日 06:30 下班。
//! 若把结束时刻也算成「零点起分钟数」,则 6:30 = 390 < 22:30 = 1350,
//! 直接相减会得到负数。本模块用 [ClockTime::minutes_until] 显式处理
//! 「结束值小于开始值 ⇒ 跨零点」这一约定,并要求调用方通过它来算时长,
//! 而不是自己相减。
/// 一天内的时刻,以「零点起的分钟数」表示。
///
/// 取值恒在 0..=1439。字段私有,只能经 [ClockTime::from_hour_and_minute]
/// 或 [ClockTime::from_minute_of_day] 构造,保证不出现 1500 这类非法值。
#[derive(Debug, Clone, Copy, PartialEq, Eq, PartialOrd, Ord, Hash)]
pub struct ClockTime {
/// 零点起的分钟数(0..=1439)。
minute_of_day: u16,
}
impl ClockTime {
/// 一天的总分钟数,用于跨零点时的取模。
pub const MINUTES_PER_DAY: u16 = 24 * 60;
/// 按「时 + 分」构造一个时刻。
///
/// 参数 `hour`:时(0..=23,超出则对其取模);`minute`:分(0..=59,超出则对其取模)。
/// 返回:对应的时刻。
///
/// 取模而非 panic:与 [`crate::support::calendar_date::CalendarDate::from_ymd`]
/// 同样的「fail visible」策略------`ClockTime::from_hour_and_minute(25, 0)`
/// 得到 `01:00`,报表里一眼能看出不对,而程序不会崩。
pub const fn from_hour_and_minute(hour: u16, minute: u16) -> ClockTime {
// 先各自归一:小时按 24 取模,分钟按 60 取模。
let normalized_hour: u16 = hour % 24;
let normalized_minute: u16 = minute % 60;
ClockTime {
minute_of_day: normalized_hour * 60 + normalized_minute,
}
}
/// 按「零点起的分钟数」构造一个时刻。
///
/// 参数 `minute_of_day`:分钟数,超出一天则对其取模。
/// 返回:对应的时刻。
///
/// 取模使本函数成为「时刻加法」的天然载体:
/// 22:30 加 8 小时 = 1350 + 480 = 1830,取模 1440 得 390 = 06:30,
/// 正好是次日早晨------跨零点自动完成,无需调用方判断。
pub const fn from_minute_of_day(minute_of_day: u16) -> ClockTime {
ClockTime {
minute_of_day: minute_of_day % ClockTime::MINUTES_PER_DAY,
}
}
/// 零点起的分钟数。
pub const fn minute_of_day(&self) -> u16 {
self.minute_of_day
}
/// 时(0..=23)。
pub const fn hour(&self) -> u16 {
self.minute_of_day / 60
}
/// 分(0..=59)。
pub const fn minute(&self) -> u16 {
self.minute_of_day % 60
}
/// 返回 `HH:MM` 文本。
///
/// 固定补零到两位,因此一天内所有时刻的文本宽度一致(5 列),
/// 报表里可以直接按显示宽度对齐,无需特殊处理。
pub fn formatted(&self) -> String {
format!("{:02}:{:02}", self.hour(), self.minute())
}
/// 计算从 `self` 到 `other` 经过的分钟数,**跨零点时自动绕圈**。
///
/// 参数 `other`:结束时刻。
/// 返回:经过的分钟数(0..=1439)。
///
/// ## 关键约定
///
/// 若 `other` 的时刻值**小于或等于** `self`,则视为「跨过了零点」,
/// 结果为 `other + 1440 - self`。
///
/// 这个约定意味着 `minutes_until` **不能**用来算「往回退多久」------
/// 它会永远返回正数。这正合班次语义:班次时长总是向前的。
/// 若将来需要「往前找最近的班次」,要另写一个函数,
/// 不要在这个函数里加参数去兼容两种语义(那会让两种调用都难读)。
pub fn minutes_until(&self, other: &ClockTime) -> u16 {
if other.minute_of_day >= self.minute_of_day {
// 同一天内:直接相减。
other.minute_of_day - self.minute_of_day
} else {
// 跨零点:终点补一天后再相减。
other.minute_of_day + ClockTime::MINUTES_PER_DAY - self.minute_of_day
}
}
/// 判断 `self` 到 `other` 是否跨越了零点。
///
/// 参数 `other`:结束时刻。
/// 返回:跨零点返回 `true`。
///
/// 夜班盘点(22:30 → 06:30)会返回 `true`。
/// 这个判定在报表里要显式标注「次日」,否则读者会以为 06:30 是当天早上。
pub fn crosses_midnight_to(&self, other: &ClockTime) -> bool {
// 终点时刻值不大于起点 ⇒ 必然跨过了零点。
other.minute_of_day <= self.minute_of_day
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : deterministic_code.rs
//! # 确定性编码 ------ 由输入内容派生稳定标识
//!
//! ## 为什么需要「确定性」编码
//!
//! 排班系统里要给「排班槽位」生成编号(便于报表引用、便于核对)。
//! 若用随机数或自增计数器:
//! - 随机数:每次运行编号都变,两次运行的报表无法对比;
//! - 自增:编号取决于遍历顺序,一旦生成顺序调整(比如多跑一家门店),
//! 所有编号全变,历史报表失去可比性。
//!
//! 本模块用 FNV-1a 64 位哈希从输入内容派生编码:同样的输入永远得到同样的输出,
//! 且与生成顺序无关。这个性质在本工程里还有一个额外用途------
//! 用派生编码验证「两处独立算出的槽位」确实是同一个槽位,
//! 即「同一门店 + 同一日期 + 同一班次 → 同一编号」。
//!
//! ## 为什么选 FNV-1a 而不是标准库的 DefaultHasher
//!
//! std::collections::hash_map::DefaultHasher 的输出在 Rust 版本之间不保证稳定
//! (官方明确说明「不应作为持久化格式」)。本工程要在报表里打印编码、
//! 并跨运行对比,因此必须用一个自己写死、永不改变的算法。
//! FNV-1a 只有三行,且常量是公开标准,最合适。
//!
//! ⚠️ 本模块不是密码学哈希,不要用于安全场景(如签名、口令)。
//! 它只保证「同输入同输出」与「广泛分布」,不保证抗碰撞攻击。
/// FNV-1a 哈希的 64 位偏移基准量。
///
/// 这个常量来自 FNV 规范(offset basis),改动它会使所有既有编码失效。
const FNV_OFFSET_BASIS_64: u64 = 0xcbf2_9ce4_8422_2325;
/// FNV-1a 哈希的 64 位质数。
///
/// 同样来自 FNV 规范(prime),不可改动。
const FNV_PRIME_64: u64 = 0x0000_0100_0000_01b3;
/// 对一个字节切片做 FNV-1a 哈希。
///
/// 参数 bytes:待哈希的字节。
/// 返回:64 位哈希值。
///
/// 算法(1a 变体,与 1 的区别在于「先异或再乘」):
/// 1. 从偏移基准量开始;
/// 2. 对每个字节:先与哈希值异或,再乘以质数;
/// 3. 全程使用 64 位环绕乘法(wrapping_mul),溢出即丢弃高位。
///
/// wrapping_mul 在这里不是「图省事」,而是算法定义的一部分------
/// 用普通乘法会在调试构建下 panic,释放构建下数值不同,
/// 造成「debug 与 release 输出不一致」这种最难查的问题。
pub const fn fnv1a_64(bytes: &[u8]) -> u64 {
let mut hash_value: u64 = FNV_OFFSET_BASIS_64;
let mut index: usize = 0;
while index < bytes.len() {
// 第一步:异或当前字节(先异或是 1a 与 1 的唯一区别)。
hash_value ^= bytes[index] as u64;
// 第二步:乘以质数,允许溢出环绕。
hash_value = hash_value.wrapping_mul(FNV_PRIME_64);
index += 1;
}
hash_value
}
/// 把多个字符串拼成一个「种子」再做哈希。
///
/// 参数 segments:按顺序参与的字符串片段。
/// 返回:哈希值。
///
/// ## 分隔符不可省略
///
/// 若直接把 ["AB", "C"] 与 ["A", "BC"] 拼接成 "ABC",
/// 两者哈希相同------这是真实存在的碰撞,不是理论担忧:
/// 排班槽位的种子正是「门店编码 + 日期 + 班次编码」这种多段拼接,
/// 门店编码末尾与日期开头很容易黏连出歧义。
///
/// 因此本函数在每段之间插入 \x1f(ASCII Unit Separator)。
/// 这个字符不会出现在本工程的任何编码、日期或名称里
/// (编码是 A-Z0-9_,日期是数字与短横),因此能可靠分界。
pub fn build_seed(segments: &[&str]) -> u64 {
// 分隔符:ASCII Unit Separator,业务数据中不会出现。
const SEPARATOR: u8 = 0x1f;
let mut hash_value: u64 = FNV_OFFSET_BASIS_64;
for (position, segment) in segments.iter().enumerate() {
// 除第一段外,每段前先吃一个分隔符,保证「段边界」参与哈希。
if position > 0 {
hash_value ^= SEPARATOR as u64;
hash_value = hash_value.wrapping_mul(FNV_PRIME_64);
}
// 再把该段的每个字节并入。
for byte in segment.as_bytes() {
hash_value ^= *byte as u64;
hash_value = hash_value.wrapping_mul(FNV_PRIME_64);
}
}
hash_value
}
/// 由哈希值派生一个带前缀的 12 位大写十六进制编码。
///
/// 参数 prefix:编码前缀(如 "SLOT");hash_value:哈希值。
/// 返回:形如 SLOT-1A2B3C4D5E6F 的字符串。
///
/// 取哈希低 48 位(12 个十六进制位):
/// - 48 位在演示规模(数万槽位)下碰撞概率极低;
/// - 12 位定长便于表格对齐(每行编号显示宽度完全相同)。
///
/// 为何不取全部 64 位?16 位十六进制会让报表一行放不下,
/// 而多出的 16 位对本工程的规模没有实际价值。这是按用途裁剪,
/// 不是「随便取几位」------注释里写清理由,后来者才好判断能否改动。
pub fn derive_code(prefix: &str, hash_value: u64) -> String {
// 取低 48 位:用掩码清掉高位。
let truncated_value: u64 = hash_value & 0x0000_FFFF_FFFF_FFFF;
format!("{}-{:012X}", prefix, truncated_value)
}
/// 由哈希值派生一个 8 位大写十六进制指纹。
///
/// 参数 hash_value:哈希值。
/// 返回:8 位十六进制文本。
///
/// 用于报表表头(「本次排班指纹 A1B2C3D4」):读者可以凭这 8 位
/// 确认「两次运行看到的是同一批数据」,而不必逐行比对数万条排班。
pub fn short_fingerprint(hash_value: u64) -> String {
// 取高 32 位(而非低位)------低位已被 derive_code 用于编号,
// 指纹取高位可让「编号相近的两个槽位」在指纹上也有明显差异。
let upper_bits: u32 = (hash_value >> 32) as u32;
format!("{:08X}", upper_bits)
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : text_layout.rs
//! # CJK 宽度感知的文本排版
//!
//! ## 为什么这一层不可省略
//!
//! 排班表要打印门店名、班次名、员工姓名,全是中文。而 Rust 的格式化填充
//! {:<20} 按字符数(char 个数)补空格,不是按显示列数。
//! 一个汉字在等宽终端里占 2 列,于是:
//!
//! text //! {:<12} 的效果(错位) display_width 的效果(对齐) //! 门店 样式 门店 样式 //! 深圳旗舰店 样式 深圳旗舰店 样式 //! ^ 前者只补到 12 个「字符」 ^ 前者补到 12 个「列」 //!
//!
//! 全工程禁止直接用 {:<N} 打印含中文的表格单元,一律走本模块。
//!
//! ## 区段表必须互不重叠
//!
//! 下面 is_wide_character 里的区间若出现重叠或交叠,
//! matches! 会报「不可达模式」(unreachable pattern)告警,
//! 或者更糟------悄悄漏判某一区段。写这类表时要一格一格核对边界。
/// 判断一个字符在等宽终端中是否占 2 个显示列。
///
/// 参数 character:待判定的字符。
/// 返回:占 2 列返回 true,占 1 列返回 false。
///
/// 这里采用主区域判定而非穷举全表:全量 Unicode 的宽字符表有上千个区段,
/// 但本工程的字符来源受控(预置常量 + 演示数据,都在 CJK 与拉丁范围内),
/// 因此覆盖以下区段即足够,且每一段都可人工核对:
///
/// | 区段 | 含义 | 本工程的实际来源 |
/// |---|---|---|
/// | U+1100..=U+115F | 谚文字母 | 未使用(预留) |
/// | U+2E80..=U+303E | CJK 部首补充、符号 | 「·」「~」等 |
/// | U+3041..=U+33FF | 平假名、片假名、CJK 注音 | 未使用(预留) |
/// | U+3400..=U+4DBF | CJK 扩展 A | 生僻字(预留) |
/// | U+4E00..=U+9FFF | CJK 基本区 | 门店名、班次名、员工姓名 |
/// | U+A000..=U+A4CF | 彝文 | 未使用(预留) |
/// | U+AC00..=U+D7A3 | 谚文音节 | 未使用(预留) |
/// | U+F900..=U+FAFF | CJK 兼容表意文字 | 未使用(预留) |
/// | U+FE30..=U+FE4F | CJK 兼容形式 | 「:」全角标点(预留) |
/// | U+FF00..=U+FF60 | 全角 ASCII | 「()」「%」全角形式 |
/// | U+FFE0..=U+FFE6 | 全角符号 | 「¢」「£」「¥」 |
///
/// 注意 U+FF61..=U+FFDC(半角片假名)不被判为宽字符------它们确实是 1 列。
pub fn is_wide_character(character: char) -> bool {
// 用 u32 比较,避免在每个分支里重复做 as u32 转换。
let code_point: u32 = character as u32;
matches!(
code_point,
0x1100..=0x115F
| 0x2E80..=0x303E
| 0x3041..=0x33FF
| 0x3400..=0x4DBF
| 0x4E00..=0x9FFF
| 0xA000..=0xA4CF
| 0xAC00..=0xD7A3
| 0xF900..=0xFAFF
| 0xFE30..=0xFE4F
| 0xFF00..=0xFF60
| 0xFFE0..=0xFFE6
)
}
/// 计算字符串在等宽终端中的显示列数。
///
/// 参数 text:待测量的字符串。
/// 返回:显示列数(汉字计 2,其余计 1)。
///
/// 这是本模块所有填充函数的基础。不要用 text.len()(那是 UTF-8 字节数,
/// 一个汉字 3 字节)或 text.chars().count()(那是字符数,一个汉字 1 个)。
pub fn display_width(text: &str) -> usize {
// 逐个字符累加宽度:宽字符 2 列,窄字符 1 列。
text.chars()
.map(|character| if is_wide_character(character) { 2 } else { 1 })
.sum()
}
/// 在右侧补空格,使结果达到指定显示列数。
///
/// 参数 text:原文本;target_width:目标显示列数。
/// 返回:补齐后的字符串。
///
/// 超出时不截断:若 text 的显示宽度已超过 target_width,原样返回。
/// 这一点是刻意的------截断会丢信息,而「列宽估小了」是调用方的 bug,
/// 应该在输出里暴露出来(表格错位一眼可见),而不是被静默吃掉。
pub fn pad_right(text: &str, target_width: usize) -> String {
let current_width: usize = display_width(text);
if current_width >= target_width {
return text.to_string();
}
// 差额就是需要补的空格数(空格永远是 1 列宽)。
let padding_count: usize = target_width - current_width;
format!("{}{}", text, " ".repeat(padding_count))
}
/// 在左侧补空格,使结果达到指定显示列数。
///
/// 参数 text:原文本;target_width:目标显示列数。
/// 返回:补齐后的字符串。
///
/// 用于数字列的右对齐------金额、件数、时长都靠它对齐。
pub fn pad_left(text: &str, target_width: usize) -> String {
let current_width: usize = display_width(text);
if current_width >= target_width {
return text.to_string();
}
let padding_count: usize = target_width - current_width;
format!("{}{}", " ".repeat(padding_count), text)
}
/// 居中对齐到指定显示列数。
///
/// 参数 text:原文本;target_width:目标显示列数。
/// 返回:两侧补空格后的字符串。
///
/// 差值分配规则:左少右多(左侧补 floor(差值/2),右侧补剩余)。
/// 为什么不左右均分?因为当差值为奇数时无法均分,必须选一边多补一格。
/// 选「右多」是因为中文标题通常希望视觉重心略偏左,
/// 左边少一格会让标题看起来更靠中。这个选择要写下来,
/// 否则下一个人会以为是算错了。
pub fn pad_center(text: &str, target_width: usize) -> String {
let current_width: usize = display_width(text);
if current_width >= target_width {
return text.to_string();
}
let total_padding: usize = target_width - current_width;
let left_padding: usize = total_padding / 2;
let right_padding: usize = total_padding - left_padding;
format!(
"{}{}{}",
" ".repeat(left_padding),
text,
" ".repeat(right_padding)
)
}
/// 按显示列数截断字符串。
///
/// 参数 text:原文本;maximum_width:允许的最大显示列数。
/// 返回:在不超过 maximum_width 的前提下能容纳的最长前缀。
///
/// ## 为什么必须自己写这个函数
///
/// Rust 的 &text[..n] 按字节切片,切在汉字中间会 panic
/// (byte index is not a char boundary)。本函数按字符逐个累加宽度,
/// 天然保证切点落在字符边界上。
///
/// ## 放弃半个汉字
///
/// 若下一个字符是宽字符(2 列)而剩余宽度只有 1 列,就直接停下,
/// 不用空格或半个字符填充。表格单元宁可短一列,
/// 也不能出现「只有左半边」的乱码。
pub fn truncate_to_width(text: &str, maximum_width: usize) -> String {
let mut accumulated_width: usize = 0;
// 收集能放下的字符;用 String 而非 &str 切片,天然按字符边界推进。
let mut result: String = String::new();
for character in text.chars() {
let character_width: usize = if is_wide_character(character) { 2 } else { 1 };
// 加上这个字符会超宽 → 停止(放弃这个字符,包括「放不下的宽字符」)。
if accumulated_width + character_width > maximum_width {
break;
}
result.push(character);
accumulated_width += character_width;
}
result
}
/// 生成一条横线,用于表格分隔。
///
/// 参数 column_width:横线的显示列数。
/// 返回:由全角制表符 ─ 拼成的字符串。
///
/// 用 ─(U+2500,属于 U+2E80..=U+303E 区段,占 2 列)拼接,
/// 因此每条字符占 2 列,column_width 需要是偶数才能精确对齐。
/// 若传入奇数宽度,本函数向下取偶数------这比输出错位一格更容易被发现。
pub fn horizontal_rule(column_width: usize) -> String {
// 向下取偶数,保证每条 ─ 恰好铺满 2 列而不留半条。
let segment_count: usize = column_width / 2;
"─".repeat(segment_count)
}
rust
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : coverage_audit.rs
//! # 排班合规体检 ------ 「一次报全」的检查器
//!
//! ## 设计要点一:全部规则用同一个签名
//!
//! 每条规则都是一个 `(&ShiftPlan, &mut Vec<CoverageAuditEntry>) -> ()` 形态
//! 的检查函数,**从不提前 `return`**,也从不短路。
//!
//! 于是无论发现多少问题,报表都能一次列全。运营改一次配置就能重跑,
//! 不必「修一个、跑一次、再发现一个」。
//!
//! 这条经验在 Builder 工程里已被验证(`check_*` 统一签名 + 不提前返回),
//! 本工程沿用。
//!
//! ## 设计要点二:规则里包含「模式自身是否生效」
//!
//! 大多数规则检查业务(人手够不够、加班超没超)。
//! 但本工程额外加了一条**架构规则**:
//!
//! > `SHARING_EFFECTIVE` ------ 平均共享倍数不低于 100。
//!
//! 它把「享元有没有真的在共享」变成一条**可自动检查的合规项**。
//! 若某次改动让键变细(例如有人往键里加了日期),
//! 这条规则会立刻在报表里报「不通过」------
//! **把架构退化变成红灯,而不是等某天内存爆掉才发现。**
//!
//! 这是本工程认为最值得带走的一条实践:
//! **好的架构约束应当能被写成自动断言,而不是留在设计文档里。**
//!
//! ## 设计要点三:严重度只用三档,且与处理动作一一对应
//!
//! | 档次 | 处理动作 |
//! |---|---|
//! | 阻断 | 必须改,否则不允许发布 |
//! | 警告 | 建议改,可人工确认后发布 |
//! | 提示 | 知悉即可 |
//!
//! 不使用更多档次:档次数应由**处理路径数**决定(见 `ComplianceSeverity` 文档)。
use crate::client::{ShiftPlan, ShiftSlot};
use crate::domain::{ComplianceSeverity, SHIFT_CODE_NIGHT_AUDIT};
use crate::support::text_layout::display_width;
/// 单槽位加班的告警阈值(分钟)。
///
/// 90 分钟 = 1.5 小时。这是**本工程选定的管理口径**,
/// 不是法定值(各地法定上限不同)。放在本文件而不是 `domain`,
/// 因为它是「本工程的检查政策」而非普适领域事实。
pub const OVERTIME_WARNING_THRESHOLD_MINUTES: u32 = 90;
/// 平均共享倍数的合规下限(万分点,即 100 倍)。
///
/// 见模块文档「设计要点二」。
pub const MINIMUM_AVERAGE_SHARE_BASIS_POINTS: i64 = 100 * 10_000;
/// 一条体检结果。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct CoverageAuditEntry {
/// 规则编码(稳定标识,便于报表比对两次运行)。
pub rule_code: &'static str,
/// 规则描述。
pub rule_description: &'static str,
/// 严重度。
pub severity: ComplianceSeverity,
/// 是否通过。
pub passed: bool,
/// 结论说明(含具体数字,便于定位)。
pub conclusion: String,
}
impl CoverageAuditEntry {
/// 构造一条通过的结果。
fn pass(
rule_code: &'static str,
rule_description: &'static str,
severity: ComplianceSeverity,
conclusion: String,
) -> CoverageAuditEntry {
CoverageAuditEntry {
rule_code,
rule_description,
severity,
passed: true,
conclusion,
}
}
/// 构造一条未通过的结果。
fn fail(
rule_code: &'static str,
rule_description: &'static str,
severity: ComplianceSeverity,
conclusion: String,
) -> CoverageAuditEntry {
CoverageAuditEntry {
rule_code,
rule_description,
severity,
passed: false,
conclusion,
}
}
/// 报表里的结果标记(通过 / 不通过)。
pub const fn result_marker(&self) -> &'static str {
if self.passed {
"通过"
} else {
"未通过"
}
}
/// 未通过时,本项是否阻断发布。
pub const fn blocks_publication_when_failed(&self) -> bool {
// 通过时永不阻断;未通过时看严重度。
!self.passed && self.severity.blocks_publication()
}
/// 结论文本的显示宽度(供报表对齐使用)。
pub fn conclusion_display_width(&self) -> usize {
display_width(&self.conclusion)
}
}
/// 一份体检报告。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct CoverageAuditReport {
/// 全部规则的结果(按定义顺序)。
pub entries: Vec<CoverageAuditEntry>,
}
impl CoverageAuditReport {
/// 规则总数。
pub fn total_count(&self) -> usize {
self.entries.len()
}
/// 通过数。
pub fn passed_count(&self) -> usize {
self.entries.iter().filter(|entry| entry.passed).count()
}
/// 未通过数。
pub fn failed_count(&self) -> usize {
self.entries.iter().filter(|entry| !entry.passed).count()
}
/// 指定严重度的未通过项数。
pub fn failed_count_of_severity(&self, severity: ComplianceSeverity) -> usize {
self.entries
.iter()
.filter(|entry| !entry.passed && entry.severity == severity)
.count()
}
/// 是否存在阻断项。
pub fn has_blocker(&self) -> bool {
self.entries
.iter()
.any(CoverageAuditEntry::blocks_publication_when_failed)
}
/// 是否全部通过。
pub fn is_fully_compliant(&self) -> bool {
self.failed_count() == 0
}
/// 未通过项的描述文本列表(供结论行使用)。
pub fn failed_descriptions(&self) -> Vec<&'static str> {
self.entries
.iter()
.filter(|entry| !entry.passed)
.map(|entry| entry.rule_description)
.collect()
}
}
/// 对一份排班方案执行全部合规规则。
///
/// 参数 `plan`:排班方案。
/// 返回:体检报告(**含全部规则的结果,无论通过与否**)。
///
/// 每一条规则都在这一个函数体里被调用一次,顺序即报表顺序。
/// 把调用顺序集中在一处,是为了让「新增规则要加在哪」有唯一答案。
pub fn audit_coverage(plan: &ShiftPlan) -> CoverageAuditReport {
let mut entries: Vec<CoverageAuditEntry> = Vec::new();
// 规则 1~3:装配完整性(阻断级)。
check_no_unregistered_shift(plan, &mut entries);
check_no_unregistered_store_grade(plan, &mut entries);
check_no_staffing_gap(plan, &mut entries);
// 规则 4:享元池健康(警告级)。
check_template_pool_not_exhausted(plan, &mut entries);
// 规则 5:模式有效性(警告级)------本工程特有的架构断言。
check_sharing_effective(plan, &mut entries);
// 规则 6~7:排班业务规则(警告 / 提示级)。
check_no_double_booking(plan, &mut entries);
check_overtime_within_threshold(plan, &mut entries);
// 规则 8:盘点夜班已排入(提示级)。
check_night_audit_scheduled(plan, &mut entries);
CoverageAuditReport { entries }
}
/// 规则 1:所有班次模板均已登记(无漏排)。
fn check_no_unregistered_shift(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "NO_UNREGISTERED_SHIFT";
const DESCRIPTION: &str = "全部班次均已在模板工厂登记";
if !plan.has_unregistered_shift_gap() {
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Blocker,
format!("{} 个槽位全部取到模板", plan.slot_count()),
));
return;
}
// 未通过:把每个未登记的班次编码都列出来(而不是只报总数),
// 这样运营能直接照着去补登记,不必反查。
let details: Vec<String> = plan
.unregistered_shift_records()
.iter()
.map(|(shift_code, count)| format!("{}({} 次)", shift_code, count))
.collect();
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Blocker,
format!("未登记班次:{}", details.join("、")),
));
}
/// 规则 2:所有门店等级均已登记配置。
fn check_no_unregistered_store_grade(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "NO_UNREGISTERED_STORE_GRADE";
const DESCRIPTION: &str = "全部门店等级均已登记配置";
if plan.unregistered_store_grade_count() == 0 {
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Blocker,
format!("{} 家门店均取到等级配置", plan.store_count()),
));
return;
}
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Blocker,
format!("{} 家门店因等级未登记被整体跳过", plan.unregistered_store_grade_count()),
));
}
/// 规则 3:无人力缺口(每槽位都排到了合格员工)。
fn check_no_staffing_gap(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "NO_STAFFING_GAP";
const DESCRIPTION: &str = "每个槽位都排到了具备资质的员工";
if plan.staffing_gap_count() == 0 {
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Blocker,
format!("{} 个槽位均已排人", plan.slot_count()),
));
return;
}
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Blocker,
format!("{} 个槽位因本店无对应技能等级员工而空缺", plan.staffing_gap_count()),
));
}
/// 规则 4:享元池未溢出。
fn check_template_pool_not_exhausted(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "TEMPLATE_POOL_NOT_EXHAUSTED";
const DESCRIPTION: &str = "班次模板享元池未触及容量上限";
let snapshot = plan.template_pool_snapshot();
if !plan.is_template_pool_exhausted() {
let limit_text: String = match snapshot.entry_limit {
Some(limit) => format!("(上限 {})", limit),
// 不限容量的池也要说清楚,否则读者不知道「未溢出」是因为
// 「真的没溢出」还是「压根没有上限」。
None => "(未设上限)".to_string(),
};
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!(
"池内 {} 个模板,从未拒绝新建{}",
snapshot.distinct_entry_count, limit_text
),
));
return;
}
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!(
"池已满(上限 {},实际需要 {} 个不同键)",
snapshot.entry_limit.unwrap_or(0),
snapshot.distinct_entry_count
),
));
}
/// 规则 5:享元共享确实生效(架构断言)。
fn check_sharing_effective(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "SHARING_EFFECTIVE";
const DESCRIPTION: &str = "班次模板的平均共享倍数达标(享元生效)";
let snapshot = plan.template_pool_snapshot();
let average_share: i64 = snapshot.average_share_multiplier_basis_points();
if average_share >= MINIMUM_AVERAGE_SHARE_BASIS_POINTS {
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!(
"{} 个槽位共享 {} 个模板,平均 {}.{:04} 倍",
plan.slot_count(),
snapshot.distinct_entry_count,
average_share / 10_000,
average_share % 10_000
),
));
return;
}
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!(
"平均共享仅 {}.{:04} 倍(下限 {} 倍),键可能过细",
average_share / 10_000,
average_share % 10_000,
MINIMUM_AVERAGE_SHARE_BASIS_POINTS / 10_000
),
));
}
/// 规则 6:无同一员工同日重复排班。
///
/// ## 实现:用排序 + 相邻比较,而不是哈希集合
///
/// 槽位已经有确定性序号,但序号**不含员工维度**的排序意义。
/// 因此这里构造 `(员工, 日期)` 的排序键,排序后检查相邻是否重复。
///
/// 复杂度 O(n log n),n = 1.2 万,可接受。
/// 用哈希集合是 O(n),但集合的迭代顺序不确定,
/// 会让「哪个员工冲突」这个诊断输出不可复现------
/// 而本工程要求输出可复现(便于核对)。**正确性优先于常数级性能。**
fn check_no_double_booking(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "NO_DOUBLE_BOOKING";
const DESCRIPTION: &str = "无员工在同一天被排入两个班次";
// 构造排序键:员工工号文本 + 日期文本。
let mut assignment_keys: Vec<(String, String, String)> = plan
.slots()
.iter()
.map(|slot: &ShiftSlot| {
(
slot.staff_number().text().to_string(),
slot.shift_date().formatted(),
slot.slot_code_text(),
)
})
.collect();
assignment_keys.sort();
// 排序后检查相邻两条是否「同员工 + 同日期」。
// 记录冲突的员工与日期(去重后最多列几个,避免报表爆炸)。
let mut conflicts: Vec<String> = Vec::new();
for window in assignment_keys.windows(2) {
let (left_staff, left_date, _) = &window[0];
let (right_staff, right_date, _) = &window[1];
if left_staff == right_staff && left_date == right_date {
let conflict_text: String = format!("{}@{}", left_staff, left_date);
// 去重(相邻窗口可能对同一冲突重复报告)。
if !conflicts.contains(&conflict_text) {
conflicts.push(conflict_text);
}
}
}
if conflicts.is_empty() {
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!("全部 {} 个槽位无同日冲突", plan.slot_count()),
));
return;
}
// 报前 3 个冲突即可(其余用「等 N 项」概括),避免报表行过长。
let shown: Vec<String> = conflicts.iter().take(3).cloned().collect();
let suffix: String = if conflicts.len() > shown.len() {
format!(" 等 {} 项", conflicts.len())
} else {
String::new()
};
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!("{}{}", shown.join("、"), suffix),
));
}
/// 规则 7:单槽位加班未超阈值。
fn check_overtime_within_threshold(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "OVERTIME_WITHIN_THRESHOLD";
const DESCRIPTION: &str = "单槽位加班时长未超过管理阈值";
let mut exceeding_count: u32 = 0;
let mut maximum_overtime: u32 = 0;
for slot in plan.slots() {
let overtime: u32 = slot.overtime_minutes();
// 记录最大值用于报表(即使没超阈值也报出来,让读者知道余量)。
if overtime > maximum_overtime {
maximum_overtime = overtime;
}
if overtime > OVERTIME_WARNING_THRESHOLD_MINUTES {
exceeding_count += 1;
}
}
if exceeding_count == 0 {
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!(
"最长加班 {} 分钟(阈值 {} 分钟),合计加班 {} 分钟",
maximum_overtime,
OVERTIME_WARNING_THRESHOLD_MINUTES,
plan.total_overtime_minutes()
),
));
return;
}
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Warning,
format!(
"{} 个槽位加班超过 {} 分钟(最长 {} 分钟)",
exceeding_count, OVERTIME_WARNING_THRESHOLD_MINUTES, maximum_overtime
),
));
}
/// 规则 8:要求每日盘点的门店确实排入了盘点夜班。
fn check_night_audit_scheduled(plan: &ShiftPlan, entries: &mut Vec<CoverageAuditEntry>) {
const RULE_CODE: &str = "NIGHT_AUDIT_SCHEDULED";
const DESCRIPTION: &str = "要求盘点的门店已排入盘点夜班";
// 统计盘点夜班槽位数。
let audit_slot_count: usize = plan
.slots()
.iter()
.filter(|slot| slot.template().shift_code() == SHIFT_CODE_NIGHT_AUDIT)
.count();
if audit_slot_count > 0 {
entries.push(CoverageAuditEntry::pass(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Information,
format!("共排入 {} 个盘点夜班槽位", audit_slot_count),
));
return;
}
entries.push(CoverageAuditEntry::fail(
RULE_CODE,
DESCRIPTION,
ComplianceSeverity::Information,
"本区间内无盘点夜班(若区间不含盘点日则属正常)".to_string(),
));
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : memory_comparison.rs
//! # 成员内存对照 ------ 「共享省了多少」的定量回答
//!
//! ## 这是本工程的验收核心
//!
//! 前面的层把享元建起来了,但「建起来了」不等于「有价值」。
//! 本模块负责回答那个唯一重要的问题:
//!
//! > **共享后占多少字节?不共享要占多少?差多少?**
//!
//! ## 对照口径(必须逐项说清,否则数字不可信)
//!
//! 设:槽位数 `N`,模板池实例数 `D_t`,等级池实例数 `D_g`。
//!
//! ```text
//! 共享侧 = 模板池内容(Σ B_i) + 等级池内容(Σ G_j)
//! + 两池的控制块(D_t + D_g) × 16
//! + 全部持有句柄 N × 8
//! + 槽位自身外在状态 N × size_of::<ShiftSlot>()
//!
//! 独立侧 = N × (size_of::<ShiftSlot>() ← 外在状态(两版本相同)
//! + 模板副本字节 ← 每个槽位一份
//! + 门店配置副本字节) ← 每个槽位一份
//! ```
//!
//! 注意「槽位自身外在状态」**两版本相同**,因此在差额中抵消。
//! 报告里仍要把它列出来,因为读者需要知道「总额里有多少是外在状态」------
//! 若不列出,读者会以为差额就是全部内存。
//!
//! ## 一处诚实声明:为什么「独立侧」需要外部传入字节数
//!
//! 「不共享的槽位长什么样」是本工程**必须自己假设**的------
//! 它不是一个真实存在的类型(工程里只有共享版本)。
//! 若在本模块里凭空写一个数字,那这个数字就是编的。
//!
//! 本工程的处理:把「不共享的槽位」**真的实现出来**
//! (见 `main.rs` 末尾的工程外扩展区 `UnsharedShiftDefinition` /
//! `UnsharedStoreGradeConfig`),让它也实现字节统计,
//! 然后把它的实测值传进本模块。
//!
//! 于是对照的两侧都是**可编译、可调用的真实类型**,
//! 差异只来自「有没有共享」这一件事。
//! **这比在两个魔数之间算减法有意义得多。**
use crate::client::ShiftPlan;
use crate::domain::{CurrencyAmount, Ratio};
/// 「不共享」时每个槽位额外承载的副本字节数。
///
/// 由调用方从真实的不共享类型实测得到(见模块文档的诚实声明)。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub struct UnsharedSlotOverhead {
/// 每个槽位若各自持有一份班次定义,需要多少字节。
pub template_copy_bytes: usize,
/// 每个槽位若各自持有一份门店等级配置副本,需要多少字节。
pub store_grade_copy_bytes: usize,
}
impl UnsharedSlotOverhead {
/// 构造对照开销。
pub const fn new(
template_copy_bytes: usize,
store_grade_copy_bytes: usize,
) -> UnsharedSlotOverhead {
UnsharedSlotOverhead {
template_copy_bytes,
store_grade_copy_bytes,
}
}
/// 每个槽位额外承载的副本总量。
pub const fn total_per_slot(&self) -> usize {
self.template_copy_bytes
.saturating_add(self.store_grade_copy_bytes)
}
}
/// 共享侧与独立侧的内存对照结果。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub struct MemoryComparison {
/// 槽位总数。
pub slot_count: usize,
/// 单个槽位外在状态自身的字节数(两版本相同,用于报告构成)。
pub slot_intrinsic_bytes: usize,
/// 共享侧:模板池内容字节。
pub shared_template_content_bytes: usize,
/// 共享侧:等级池内容字节。
pub shared_store_grade_content_bytes: usize,
/// 共享侧:句柄与控制块字节(两池合计)。
pub shared_handle_bytes: usize,
/// 共享侧:槽位外在状态总字节。
pub shared_slot_state_bytes: usize,
/// 独立侧:模板副本字节。
pub unshared_template_copy_bytes: usize,
/// 独立侧:门店配置副本字节。
pub unshared_store_grade_copy_bytes: usize,
/// 独立侧:槽位外在状态总字节(与共享侧同值)。
pub unshared_slot_state_bytes: usize,
}
impl MemoryComparison {
/// 由排班方案与对照开销构造。
///
/// 参数 `plan`:排班方案;`overhead`:不共享时的每槽位副本字节。
/// 返回:对照结果。
pub fn from_plan(plan: &ShiftPlan, overhead: UnsharedSlotOverhead) -> MemoryComparison {
let slot_count: usize = plan.slot_count();
// 单个槽位的栈内字节数。`ShiftSlot` 无堆字段(见其文档),
// 因此 `size_of` 即全部。
let slot_intrinsic_bytes: usize = std::mem::size_of::<crate::client::ShiftSlot>();
let template_snapshot = plan.template_pool_snapshot();
let grade_snapshot = plan.grade_pool_snapshot();
MemoryComparison {
slot_count,
slot_intrinsic_bytes,
shared_template_content_bytes: template_snapshot.intrinsic_bytes_total,
shared_store_grade_content_bytes: grade_snapshot.intrinsic_bytes_total,
// 句柄与控制块合计:两个池各自报出的句柄侧字节。
shared_handle_bytes: template_snapshot
.handle_bytes_total
.saturating_add(grade_snapshot.handle_bytes_total),
shared_slot_state_bytes: slot_count.saturating_mul(slot_intrinsic_bytes),
unshared_template_copy_bytes: slot_count
.saturating_mul(overhead.template_copy_bytes),
unshared_store_grade_copy_bytes: slot_count
.saturating_mul(overhead.store_grade_copy_bytes),
unshared_slot_state_bytes: slot_count.saturating_mul(slot_intrinsic_bytes),
}
}
/// 共享侧总字节。
pub const fn shared_total_bytes(&self) -> usize {
self.shared_template_content_bytes
.saturating_add(self.shared_store_grade_content_bytes)
.saturating_add(self.shared_handle_bytes)
.saturating_add(self.shared_slot_state_bytes)
}
/// 独立侧总字节。
pub const fn unshared_total_bytes(&self) -> usize {
self.unshared_template_copy_bytes
.saturating_add(self.unshared_store_grade_copy_bytes)
.saturating_add(self.unshared_slot_state_bytes)
}
/// 节省字节数(独立 - 共享)。可能为负。
///
/// ## 为什么允许负数并如实返回
///
/// 存在共享反而更费内存的情形:实例极小(如一个 `u32`)
/// 或共享倍数极低(每个实例只被引用一次)时,
/// `Rc` 的控制块(16 字节)+ 指针(8 字节)会超过副本本身。
///
/// 若把负数钳到 0,本模块就只会「报喜」------
/// 而那会掩盖「这个场景不该用享元」这个**最有价值的结论**。
/// 第四幕的「键过细」场景会真的产生一个趋近于零、甚至为负的节省率,
/// 本方法的返回值必须如实反映它。
pub const fn saved_bytes(&self) -> i64 {
self.unshared_total_bytes() as i64 - self.shared_total_bytes() as i64
}
/// 节省比例(万分点)。节省为负时返回负值。
pub fn saved_ratio_basis_points(&self) -> i64 {
let unshared_total: usize = self.unshared_total_bytes();
if unshared_total == 0 {
return 0;
}
let numerator: i128 = self.saved_bytes() as i128 * 10_000i128;
(numerator / unshared_total as i128) as i64
}
/// 只考虑「享元共享的那部分」的节省比例(万分点)。
///
/// ## 为什么需要这个「更聚焦」的比率
///
/// 总节省率被**外在状态**稀释了:无论是否共享,
/// 每个槽位都要存门店、日期、员工(约 100 字节)。
/// 1.2 万槽位就是 1.2MB 的「常量开销」,
/// 它让「模板部分的节省」看起来没那么惊人。
///
/// 而本模式真正作用的地方是**模板部分**。两个比率都要报:
/// - **总节省率**回答「这个方案省了多少内存」(运营关心);
/// - **可共享部分节省率**回答「享元这个机制本身的效果有多强」(架构关心)。
///
/// 只报一个都会让读者产生误解。
pub fn saved_ratio_of_shareable_basis_points(&self) -> i64 {
let unshared_shareable: usize = self
.unshared_template_copy_bytes
.saturating_add(self.unshared_store_grade_copy_bytes);
if unshared_shareable == 0 {
return 0;
}
let shared_shareable: usize = self
.shared_template_content_bytes
.saturating_add(self.shared_store_grade_content_bytes)
.saturating_add(self.shared_handle_bytes);
let saved: i64 = unshared_shareable as i64 - shared_shareable as i64;
let numerator: i128 = saved as i128 * 10_000i128;
(numerator / unshared_shareable as i128) as i64
}
/// 每个槽位的平均节省字节数(有符号)。
pub const fn saved_bytes_per_slot(&self) -> i64 {
if self.slot_count == 0 {
return 0;
}
self.saved_bytes() / self.slot_count as i64
}
/// 外在状态在共享侧总内存中的占比(万分点)。
///
/// 用于回答「共享之后,剩下的内存主要花在哪」------
/// 若这个比率很高(如 > 90%),说明**再优化享元已经没有意义**,
/// 该去优化外在状态(例如把门店编码换成索引)。
/// 这是一个能指导下一步工作的数字。
pub fn slot_state_ratio_basis_points(&self) -> i64 {
let shared_total: usize = self.shared_total_bytes();
if shared_total == 0 {
return 0;
}
let numerator: i128 = self.shared_slot_state_bytes as i128 * 10_000i128;
(numerator / shared_total as i128) as i64
}
/// 用万分点表示的两个比率,方便报表直接打印。
pub fn saved_ratio_as_ratio(&self) -> Ratio {
Ratio::from_basis_points(self.saved_ratio_basis_points())
}
/// 共享侧总字节对应的「每槽位平均字节数」。
pub fn shared_bytes_per_slot(&self) -> usize {
if self.slot_count == 0 {
return 0;
}
self.shared_total_bytes() / self.slot_count
}
/// 独立侧总字节对应的「每槽位平均字节数」。
pub fn unshared_bytes_per_slot(&self) -> usize {
if self.slot_count == 0 {
return 0;
}
self.unshared_total_bytes() / self.slot_count
}
/// 供报表使用的「节省金额」类比说明:
/// 返回节省的字节数折算成「多少个槽位自身大小」。
///
/// ## 为什么要有这个换算
///
/// 「省了 6.1 MB」这个数字对读者没有直觉。换成
/// 「相当于省下了 59,000 个槽位自身大小」,
/// 读者立刻能感受到量级。这是**把抽象数字锚定到已知单位**的常用手法,
/// 且换算所用的除数(`slot_intrinsic_bytes` = `size_of::<ShiftSlot>()` = 104)
/// 是实测值,不是估的。
///
/// ## 除数是谁,必须说清
///
/// 除数**不是** `unshared_bytes_per_slot()`(667 字节)------那个值还包含
/// 每个槽位各背一份的模板副本。用 104 还是 667 当除数,结果差 6 倍以上。
/// 报表标签因此必须写明除数,否则读者无法复算(本工程曾在此写错过标签)。
pub fn saved_equivalent_slot_count(&self) -> i64 {
if self.slot_intrinsic_bytes == 0 {
return 0;
}
self.saved_bytes() / self.slot_intrinsic_bytes as i64
}
/// 类型检查辅助:确认金额类型未在本模块被误用。
///
/// 本模块只做字节统计,不涉及金额。这个函数存在的唯一目的是
/// 让「本模块与金额无关」在类型层面有一个锚点------
/// 它返回一个恒为零的同币种金额,供第七幕清点时调用。
pub fn zero_amount_of(currency: crate::domain::Currency) -> CurrencyAmount {
CurrencyAmount::zero(currency)
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : payroll_breakdown.rs
//! # 人力成本分布 ------ 按任意维度分组
//!
//! ## 一个函数支持任意分组维度(这是刻意的设计)
//!
//! 本模块只有一个构造函数,它接收一个**标签提取闭包**:
//!
//! ```ignore
//! // 按计薪时段分组
//! let by_period = build_payroll_breakdown(&plan, |slot| {
//! slot.template().pay_period_kind().display_name().to_string()
//! });
//! // 按班次种类分组
//! let by_shift = build_payroll_breakdown(&plan, |slot| {
//! slot.template().shift_code().display_name().to_string()
//! });
//! // 按门店等级分组
//! let by_grade = build_payroll_breakdown(&plan, |slot| {
//! slot.grade_profile().grade().display_name().to_string()
//! });
//! ```
//!
//! **新增一个分析维度 = 新增一个闭包,而不是新增一个函数。**
//! 这是「分析层可无限扩展操作」这条要求的具体落实方式,
//! 也解释了为什么本模块不需要为每个维度各写一份聚合代码
//! (那样每加一个维度就要复制一遍累加逻辑,迟早漂移)。
//!
//! ## 为什么分组结果要按标签排序
//!
//! 因为本工程要求**两次运行的输出完全一致**(数字可核对)。
//! 而遍历槽位的顺序决定了各分组首次出现的顺序,
//! 若直接按插入顺序输出,报表的行序会随装配顺序变化。
//! 排序后输出稳定。
//!
//! 排序键用**标签文本**而不是金额:按金额排序会让报表行序随数据变化,
//! 反而更难对比两次运行。按文本排序则始终一致。
use crate::client::{ShiftPlan, ShiftSlot};
use crate::domain::{Currency, CurrencyAmount, Ratio};
/// 一个分组维度下的一行统计。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct PayrollCategoryEntry {
/// 分组标签(由调用方的闭包提供)。
pub label: String,
/// 该组的槽位数。
pub slot_count: usize,
/// 该组的计薪分钟总数。
pub paid_minutes: u32,
/// 该组的正常工时成本(不含加班)。
pub labor_cost: CurrencyAmount,
/// 该组的加班成本。
pub overtime_cost: CurrencyAmount,
/// 该组成本占总额的比例(万分点)。
pub share_basis_points: i64,
}
impl PayrollCategoryEntry {
/// 该组的「每分钟总成本」(最小单位/分钟,向下取整)。
///
/// ## 口径:含加班
///
/// 分子是 `人力成本 + 加班成本`,与 [`PayrollBreakdown::average_cost_per_slot`]
/// 保持同一口径。本工程规定:
///
/// > **凡叫「平均成本」「单位成本」的派生指标,一律用「总成本」作分子。**
///
/// 理由:报表里已经有 `人力成本` 与 `加班成本` 两个**账目**列,
/// 若派生指标各选一个分子,读者就要去分辨「这个均值含不含加班」------
/// 而那是一个读报表时不该出现的负担。
/// 统一口径之后,派生指标只需记住一句话:**除数量,用总额**。
///
/// ## 为什么向下取整而不是四舍五入
///
/// 这是**派生指标**(不是账目),用于横向比较各组的单位成本。
/// 账目类数字必须精确(所以用统一舍入入口),
/// 而派生指标只要口径一致即可。向下取整的好处是
/// 「同一组数据算两次结果必然相同」,不必关心舍入边界。
///
/// 若把它当成账目用(比如拿它乘分钟数去核对总额),
/// 会因取整而有小额偏差------**这条限制必须在注释里讲明**,
/// 否则会有人拿它去对账。
pub fn cost_per_minute_minor_units(&self) -> i64 {
if self.paid_minutes == 0 {
return 0;
}
self.total_minor_units() / self.paid_minutes as i64
}
/// 该组的「每槽位平均总成本」。
///
/// 口径与 [`PayrollCategoryEntry::cost_per_minute_minor_units`] 一致:
/// 分子是 `人力成本 + 加班成本`。
///
/// 用整数除法(截断)而非金额缩放:这是**统计均值**,不是账目。
/// 用统一舍入入口反而会让人误以为它可以参与对账。
/// 「均值用截断、账目用统一舍入」------这个区分要一直保持。
pub fn average_cost_per_slot(&self) -> CurrencyAmount {
if self.slot_count == 0 {
return CurrencyAmount::zero(self.labor_cost.currency());
}
let quotient: i64 = self.total_minor_units() / self.slot_count as i64;
CurrencyAmount::from_minor_units(quotient, self.labor_cost.currency())
}
/// 该组总成本(人力 + 加班)的最小单位数。
///
/// 私有辅助:把「含加班的总额」这个口径**收在一处**。
/// 若让上面两个方法各写一遍 `labor_cost + overtime_cost`,
/// 将来若要改成「加三班津贴」,就会漏改一处------
/// 而漏改的那一处会静默地少算,且只体现在一个派生指标上,极难发现。
fn total_minor_units(&self) -> i64 {
// 同币种相加:两个字段由同一个分组构造过程写入,币种必然一致。
// 用 `saturating_add` 而非 `add()` 是为了让本方法保持 `i64` 返回类型,
// 不必处理 `Option`------这是**私有**方法,不变量由调用方保证。
self.labor_cost
.minor_units()
.saturating_add(self.overtime_cost.minor_units())
}
/// 该组占比(作为 `Ratio`)。
pub fn share_as_ratio(&self) -> Ratio {
Ratio::from_basis_points(self.share_basis_points)
}
}
/// 一份人力成本分布。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct PayrollBreakdown {
/// 各分组行(按标签升序)。
pub entries: Vec<PayrollCategoryEntry>,
/// 正常工时成本总额。
pub labor_total: CurrencyAmount,
/// 加班成本总额。
pub overtime_total: CurrencyAmount,
/// 总成本。
pub total: CurrencyAmount,
/// 计薪分钟总数。
pub total_paid_minutes: u32,
/// 槽位总数。
pub slot_count: usize,
/// 分组维度的中文名(供报表标题使用,如「计薪时段」)。
pub dimension_label: &'static str,
}
impl PayrollBreakdown {
/// 分组数量。
pub fn category_count(&self) -> usize {
self.entries.len()
}
/// 平均每槽位成本。
pub fn average_cost_per_slot(&self) -> CurrencyAmount {
if self.slot_count == 0 {
return CurrencyAmount::zero(self.total.currency());
}
let quotient: i64 = self.total.minor_units() / self.slot_count as i64;
CurrencyAmount::from_minor_units(quotient, self.total.currency())
}
/// 平均每小时成本(即平均生效时薪)。
///
/// 实现:`总额 × 60 / 总分钟`,用统一入口折算而非自己写除法,
/// 保证与逐个槽位算出的单价口径一致。
pub fn average_cost_per_hour(&self) -> CurrencyAmount {
if self.total_paid_minutes == 0 {
return CurrencyAmount::zero(self.total.currency());
}
// 「总额 / 总小时数」= 总额 × 60 / 总分钟。
// 这里把 `× 60 / 总分钟` 表达为一次 `scale_by_minute_fraction` 的逆运算------
// 由于没有现成的逆函数,用 i128 显式表达并复用统一舍入入口。
let numerator: i128 = self.total.minor_units() as i128 * 60i128;
let quotient: i128 = crate::domain::divide_rounded_away_from_zero(
numerator,
self.total_paid_minutes as i128,
);
CurrencyAmount::from_minor_units(
crate::domain::clamp_i128_to_i64(quotient),
self.total.currency(),
)
}
/// 加班成本占总成本的比例(万分点)。
pub fn overtime_share_basis_points(&self) -> i64 {
let total: i64 = self.total.minor_units();
if total == 0 {
return 0;
}
let numerator: i128 = self.overtime_total.minor_units() as i128 * 10_000i128;
(numerator / total as i128) as i64
}
/// 币种。
pub const fn currency(&self) -> Currency {
self.total.currency()
}
}
/// 按任意维度聚合人力成本。
///
/// 参数 `plan`:排班方案;`dimension_label`:维度中文名(报表标题用);
/// `extract_label`:把槽位映射到分组标签的闭包。
/// 返回:成本分布。
///
/// ## 实现:一趟遍历,线性聚合
///
/// 用 `Vec` 线性查找而不是 `HashMap`:
/// - 分组数极少(本工程最多 5 类),线性查找比哈希更快;
/// - `HashMap` 的迭代顺序不确定,还要额外排序才能保证输出稳定;
/// - `Vec` 让「按标签排序」这一步的语义更清楚。
///
/// 若将来分组维度可能产生上千个类别(如按门店编码分组且有上万家店),
/// 应换成 `HashMap` + 排序。**这个替换的触发条件写在这里**,
/// 免得有人以为「线性查找」是永远正确的选择。
pub fn build_payroll_breakdown<ExtractLabel>(
plan: &ShiftPlan,
dimension_label: &'static str,
extract_label: ExtractLabel,
) -> PayrollBreakdown
where
ExtractLabel: Fn(&ShiftSlot) -> String,
{
let currency: Currency = plan.currency();
let company_base_hourly_rate: CurrencyAmount = plan.company_base_hourly_rate();
// 聚合缓冲:(标签, 槽位数, 计薪分钟, 正常成本分, 加班成本分)。
let mut aggregated: Vec<(String, usize, u32, i64, i64)> = Vec::new();
for slot in plan.slots() {
let label: String = extract_label(slot);
let labor_minor_units: i64 = slot.labor_cost(&company_base_hourly_rate).minor_units();
let overtime_minor_units: i64 = crate::client::compute_overtime_cost(
&company_base_hourly_rate,
slot.store_pay_index(),
slot.overtime_minutes(),
)
.minor_units();
// 线性查找该标签是否已有行。
match aggregated.iter_mut().find(|(existing, _, _, _, _)| *existing == label) {
Some((_, count, minutes, labor, overtime)) => {
*count += 1;
*minutes = minutes.saturating_add(slot.paid_minutes());
*labor = labor.saturating_add(labor_minor_units);
*overtime = overtime.saturating_add(overtime_minor_units);
}
None => aggregated.push((
label,
1,
slot.paid_minutes(),
labor_minor_units,
overtime_minor_units,
)),
}
}
// 总额要在构造各行占比之前先算出来。
let labor_total_minor_units: i64 =
aggregated.iter().map(|(_, _, _, labor, _)| *labor).sum();
let overtime_total_minor_units: i64 =
aggregated.iter().map(|(_, _, _, _, overtime)| *overtime).sum();
let grand_total_minor_units: i64 = labor_total_minor_units.saturating_add(overtime_total_minor_units);
// 构造各行并按标签升序排列。
let mut entries: Vec<PayrollCategoryEntry> = aggregated
.into_iter()
.map(|(label, count, minutes, labor, overtime)| {
// 占比的分母是「正常 + 加班」的总额,与报表打印的总额口径一致。
let share_basis_points: i64 = if grand_total_minor_units == 0 {
0
} else {
let combined: i128 = (labor + overtime) as i128 * 10_000i128;
(combined / grand_total_minor_units as i128) as i64
};
PayrollCategoryEntry {
label,
slot_count: count,
paid_minutes: minutes,
labor_cost: CurrencyAmount::from_minor_units(labor, currency),
overtime_cost: CurrencyAmount::from_minor_units(overtime, currency),
share_basis_points,
}
})
.collect();
// 按标签文本升序,保证两次运行输出一致。
entries.sort_by(|left, right| left.label.cmp(&right.label));
PayrollBreakdown {
entries,
labor_total: CurrencyAmount::from_minor_units(labor_total_minor_units, currency),
overtime_total: CurrencyAmount::from_minor_units(overtime_total_minor_units, currency),
total: CurrencyAmount::from_minor_units(grand_total_minor_units, currency),
total_paid_minutes: plan.total_paid_minutes(),
slot_count: plan.slot_count(),
dimension_label,
}
}
/// 便捷封装:按计薪时段分组。
pub fn build_payroll_breakdown_by_period(plan: &ShiftPlan) -> PayrollBreakdown {
build_payroll_breakdown(plan, "计薪时段", |slot| {
slot.template().pay_period_kind().display_name().to_string()
})
}
/// 便捷封装:按班次种类分组。
pub fn build_payroll_breakdown_by_shift(plan: &ShiftPlan) -> PayrollBreakdown {
build_payroll_breakdown(plan, "班次种类", |slot| {
slot.template().shift_code().display_name().to_string()
})
}
/// 便捷封装:按门店等级分组。
pub fn build_payroll_breakdown_by_store_grade(plan: &ShiftPlan) -> PayrollBreakdown {
build_payroll_breakdown(plan, "门店等级", |slot| {
slot.grade_profile().grade().display_name().to_string()
})
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : sharing_profile.rs
//! # 共享度画像 ------ 享元是否真的在共享
//!
//! ## 与「内存对照」的分工
//!
//! - `memory_comparison` 回答「省了多少字节」(**结果**);
//! - 本模块回答「共享是怎么发生的」(**过程**)。
//!
//! 两个都要看。举例:若内存省得很多,但命中率只有 50%,
//! 说明池里有大量「只被引用一两次」的实例------
//! 那是**键设计有问题**的信号(键太细),只是被「总槽位数大」
//! 这个事实掩盖了。只看结果数字看不出这一点。
//!
//! ## 三个必须分开看的指标
//!
//! | 指标 | 含义 | 偏低说明什么 |
//! |---|---|---|
//! | 命中率 | 取用请求中复用既有实例的比例 | 预热期长,或键太细 |
//! | 平均共享倍数 | 每个实例平均被几个槽位持有 | **共享是否真的发生** |
//! | 最大共享倍数 | 最热实例被多少槽位共享 | 共享是否不均衡(少数实例扛大头) |
//!
//! **平均与最大并列**:若平均只有 3 但最大有 1000,
//! 说明共享严重不均衡------少数几个模板被大量复用,
//! 而其余模板几乎是「一次性」的。这种情况下,
//! 整体节省率仍可能不错,但**键设计的改进空间很大**
//! (把那些「一次性」模板的键合并/剔除)。
//!
//! 单看平均或单看最大,都会漏掉这个结论。
use crate::client::ShiftPlan;
use crate::domain::Ratio;
/// 共享度画像。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub struct SharingProfile {
/// 槽位总数。
pub slot_count: usize,
/// 班次模板池的不同实例数。
pub distinct_template_count: usize,
/// 班次模板的取用请求总数。
pub template_request_count: u64,
/// 班次模板的命中次数。
pub template_hit_count: u64,
/// 班次模板的未命中次数(= 实际构造的实例数)。
pub template_miss_count: u64,
/// 门店等级配置池的不同实例数。
pub distinct_store_grade_count: usize,
/// 门店等级配置的取用请求总数。
pub store_grade_request_count: u64,
/// 门店等级配置的命中次数。
pub store_grade_hit_count: u64,
/// 模板池内实例当前被外部持有的句柄总数。
pub template_held_reference_total: u64,
/// 门店等级池内实例当前被外部持有的句柄总数。
pub store_grade_held_reference_total: u64,
/// 单个模板被共享的最大槽位数。
pub maximum_template_share_count: usize,
}
impl SharingProfile {
/// 由排班方案构造画像。
///
/// 参数 `plan`:排班方案。
/// 返回:共享度画像。
pub fn from_plan(plan: &ShiftPlan) -> SharingProfile {
let template_snapshot = plan.template_pool_snapshot();
let grade_snapshot = plan.grade_pool_snapshot();
// 最大共享数从「按模板聚合」的结果里取(该结果已按共享数降序)。
let distribution: Vec<(String, usize)> = plan.template_share_distribution();
let maximum_share: usize = distribution.first().map(|(_, count)| *count).unwrap_or(0);
SharingProfile {
slot_count: plan.slot_count(),
distinct_template_count: template_snapshot.distinct_entry_count,
template_request_count: template_snapshot.counters.request_count,
template_hit_count: template_snapshot.counters.hit_count,
template_miss_count: template_snapshot.counters.miss_count,
distinct_store_grade_count: grade_snapshot.distinct_entry_count,
store_grade_request_count: grade_snapshot.counters.request_count,
store_grade_hit_count: grade_snapshot.counters.hit_count,
template_held_reference_total: template_snapshot.held_reference_total,
store_grade_held_reference_total: grade_snapshot.held_reference_total,
maximum_template_share_count: maximum_share,
}
}
/// 模板命中率(万分点)。
pub fn template_hit_rate_basis_points(&self) -> i64 {
if self.template_request_count == 0 {
return 0;
}
let numerator: i128 = self.template_hit_count as i128 * 10_000i128;
(numerator / self.template_request_count as i128) as i64
}
/// 门店等级命中率(万分点)。
pub fn store_grade_hit_rate_basis_points(&self) -> i64 {
if self.store_grade_request_count == 0 {
return 0;
}
let numerator: i128 = self.store_grade_hit_count as i128 * 10_000i128;
(numerator / self.store_grade_request_count as i128) as i64
}
/// 模板的平均共享倍数(万分点)。
///
/// = 持有的句柄总数 / 不同实例数。
/// 例:12000 个槽位持有 7 个实例 → `1714285` 万分点 → 展示为 `171.4285 倍`。
pub fn average_template_share_basis_points(&self) -> i64 {
if self.distinct_template_count == 0 {
return 0;
}
let numerator: i128 = self.template_held_reference_total as i128 * 10_000i128;
(numerator / self.distinct_template_count as i128) as i64
}
/// 门店等级的平均共享倍数(万分点)。
///
/// ## 这一项通常远大于模板的共享倍数
///
/// 因为等级配置的实例更少(3 个)而持有者更多(每个槽位一份)。
/// 这不是「等级配置比班次模板更适合享元」,
/// 而是「等级维度天然低基数」。
///
/// 读者若把两个数字直接比较会得出错误结论,
/// 因此报表必须**并列打印两者的实例数**,
/// 让「低基数 → 高共享倍数」这个因果关系显式可见。
pub fn average_store_grade_share_basis_points(&self) -> i64 {
if self.distinct_store_grade_count == 0 {
return 0;
}
let numerator: i128 = self.store_grade_held_reference_total as i128 * 10_000i128;
(numerator / self.distinct_store_grade_count as i128) as i64
}
/// 每个槽位平均引用几个模板(总等于 1,用于说明「一槽一模板」)。
///
/// 这个值恒为 10000 万分点(1 倍),看起来是废话,
/// 但它是一个**结构断言**:若某天它不等于 1,
/// 说明有槽位引用了多个模板或零个模板,即装配逻辑出错。
/// 报表里打印它,等于每次都做一次廉价的自检。
pub fn template_references_per_slot_basis_points(&self) -> i64 {
if self.slot_count == 0 {
return 0;
}
let numerator: i128 = self.template_held_reference_total as i128 * 10_000i128;
(numerator / self.slot_count as i128) as i64
}
/// 共享是否不均衡。
///
/// 判定:最大共享数 > 平均共享数的 4 倍。
///
/// ## 为什么阈值取 4 倍
///
/// 这是一个**启发式阈值**,不是推导出来的。
/// 取 4 的依据:完全均匀分布时最大/平均 = 1;
/// 而「7 个模板 + 负载集中在 2 个」这类常见不均衡约为 3~5 倍。
/// 4 倍是这条经验曲线的中点。
///
/// **必须把这个阈值是启发式的这件事写出来**------
/// 否则读者会以为它有理论依据,进而在别的场景盲目沿用。
pub fn is_sharing_uneven(&self) -> bool {
let average: i64 = self.average_template_share_basis_points();
if average <= 0 {
return false;
}
// 用万分点比较,避免浮点:最大值 × 10000 与 平均值 × 4 比较。
let maximum_scaled: i128 = self.maximum_template_share_count as i128 * 10_000i128;
let threshold: i128 = average as i128 * 4;
maximum_scaled > threshold
}
/// 平均共享倍数(作为 `Ratio` 供报表格式化)。
pub fn average_template_share_as_ratio(&self) -> Ratio {
Ratio::from_basis_points(self.average_template_share_basis_points())
}
/// 命中率(作为 `Ratio`)。
pub fn template_hit_rate_as_ratio(&self) -> Ratio {
Ratio::from_basis_points(self.template_hit_rate_basis_points())
}
/// 两个池的总实例数。
pub const fn total_distinct_instance_count(&self) -> usize {
self.distinct_template_count + self.distinct_store_grade_count
}
/// 两个池的取用请求总数。
pub const fn total_request_count(&self) -> u64 {
self.template_request_count + self.store_grade_request_count
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : audit_report.rs
//! # 合规体检报表 ------ 红绿灯总表
//!
//! ## 一屏之内要能回答「能不能发布」
//!
//! 体检报表的第一行不是细节,而是**结论**:
//! `可否发布:是 / 否`。运营打开报表先看这一行,
//! 只有在「否」或想确认细节时才继续往下读。这就是把结论放最上的理由。
//!
//! ## 通过的规则也要逐条打印
//!
//! 若只打印失败的规则,报表看起来更短更「干净」,
//! 但读者无法区分「这条规则通过了」和「这条规则根本没跑」。
//!
//! 在一个**把架构约束写成自动断言**的工程里,这个区别至关重要:
//! `SHARING_EFFECTIVE` 这条规则存在的意义就是「让共享失效变成红灯」。
//! 若它通过了却不显示,读者不会知道有这道防线,
//! 也就不会在改动键设计时预期它会报警。
//!
//! **绿灯要亮着,才有红灯的意义。**
//!
//! ## 严重度用「标记 + 文字」双写
//!
//! `marker()` 给的是 `●` / `▲` / `·` 这类单字符标记,
//! `label()` 给的是「阻断 / 警告 / 提示」。
//! 两者都打印:标记让眼睛能快速扫读,文字让输出在纯文本环境
//! (日志、邮件、CI 输出)里仍然可读------标记在那里可能显示不出来。
use crate::analysis::CoverageAuditReport;
use crate::domain::ComplianceSeverity;
use super::layout::{key_value_line, TableColumn, TextTable};
/// 体检报表里「标签:值」行的标签宽度。
const AUDIT_LABEL_WIDTH: usize = 16;
/// 渲染合规体检报表。
///
/// 参数 `report`:`analysis` 层的体检结果。
/// 返回:若干行文本。
pub fn render_coverage_audit(report: &CoverageAuditReport) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
// ---------- 第一屏:结论 ----------
lines.push(" ── 体检结论 ──".to_string());
lines.push(key_value_line(
"可否发布",
AUDIT_LABEL_WIDTH,
if report.has_blocker() {
"否 ------ 存在阻断项,必须整改后重跑"
} else if report.is_fully_compliant() {
"是 ------ 全部规则通过"
} else {
"是(有附条件)------ 无阻断项,但存在警告/提示"
},
));
lines.push(key_value_line(
"规则总数",
AUDIT_LABEL_WIDTH,
&format!("{} 条", report.total_count()),
));
lines.push(key_value_line(
"通过 / 不通过",
AUDIT_LABEL_WIDTH,
&format!("{} / {}", report.passed_count(), report.failed_count()),
));
// 三档严重度全部显示,包括为 0 的档位------
// 「阻断项 0 条」与「报表里没有阻断这一栏」传达的安全感完全不同。
lines.push(key_value_line(
"阻断 / 警告 / 提示",
AUDIT_LABEL_WIDTH,
&format!(
"{} / {} / {}",
report.failed_count_of_severity(ComplianceSeverity::Blocker),
report.failed_count_of_severity(ComplianceSeverity::Warning),
report.failed_count_of_severity(ComplianceSeverity::Information),
),
));
// ---------- 第二屏:逐条明细 ----------
lines.push(String::new());
lines.push(" ── 逐条明细 ──".to_string());
// 结论列宽度按**本报表实际内容**算出来,而不是拍一个魔数。
// 理由:规则结论文本长度差异很大(「通过」2 列 vs 一句 50+ 列的说明),
// 拍一个过小的宽度会截断(丢失排查信息),拍过大则浪费版面。
// 用最大实际宽度,是唯一不会截断又不过度留白的做法。
//
// ⚠️ 这里曾经写成 `.min(50)`,结果是**静默截断**:
// 最长的一条结论(规则 7 的「最长加班 ... 分钟(阈值 ... 分钟),合计加班 ... 分钟」)
// 需要 53 列,被砍掉 3 列后各行仍然对齐,肉眼根本看不出来。
// 教训:**上限只能用来防呆,不能用来省版面**------一旦它成为实际约束,
// 就会把「内容太长」这个信号悄悄吞掉。
//
// 因此现在改为:先算真实最大宽度,再用 debug_assert 守住防呆上限。
// 若将来有人加了一条超长结论,`cargo run` 会立刻 panic 并指出该调大哪个常量,
// 而不是产出一份少了几个字的报表。
const MAX_CONCLUSION_COLUMN_WIDTH: usize = 56;
const MIN_CONCLUSION_COLUMN_WIDTH: usize = 10;
let longest_conclusion_width: usize = report
.entries
.iter()
.map(|entry| entry.conclusion_display_width())
.max()
.unwrap_or(0);
debug_assert!(
longest_conclusion_width <= MAX_CONCLUSION_COLUMN_WIDTH,
"体检结论列宽上限 {} 列不足,最长结论需要 {} 列;\
请调大 MAX_CONCLUSION_COLUMN_WIDTH(不要改回静默截断)。",
MAX_CONCLUSION_COLUMN_WIDTH,
longest_conclusion_width
);
let conclusion_width: usize = longest_conclusion_width
.min(MAX_CONCLUSION_COLUMN_WIDTH)
.max(MIN_CONCLUSION_COLUMN_WIDTH);
let table: TextTable = TextTable::new(vec![
TableColumn::left("严重度", 12),
// 规则编码列要容得下最长的编码
// (`NO_UNREGISTERED_STORE_GRADE` 共 26 字符),否则会被截断,
// 而截断后的编码无法被拿去代码里检索------那正是这一列的全部用途。
TableColumn::left("规则编码", 28),
TableColumn::left("结果", 6),
TableColumn::left("结论", conclusion_width),
]);
lines.push(format!(" {}", table.header_line()));
lines.push(format!(" {}", table.separator_line()));
for entry in &report.entries {
// 严重度写「标记 + 文字」:标记便于扫读,文字保证纯文本环境可读。
let severity_text: String = format!("{} {}", entry.severity.marker(), entry.severity.label());
lines.push(format!(
" {}",
table.row_line(&[
severity_text,
entry.rule_code.to_string(),
entry.result_marker().to_string(),
entry.conclusion.clone(),
])
));
}
lines.push(format!(" {}", table.separator_line()));
// ---------- 第三屏:不通过项的规则说明 ----------
//
// 明细表里只放了规则编码,因为规则说明(`rule_description`)通常是
// 一整句话,放进去会把表撑爆。
// 但编码对人没有意义,因此把「不通过项的说明」单独列出来------
// 这样读者不需要回头翻代码去查这个编码是什么意思。
//
// 只列不通过的项:通过项的说明没有行动价值(你不会去修一个通过的东西)。
let mut failed_notes: Vec<&crate::analysis::CoverageAuditEntry> =
report.entries.iter().filter(|entry| !entry.passed).collect();
// 按严重度优先级排序:先看该改的,再看可选的。
// 用稳定排序保持同严重度内的原始顺序(即规则定义顺序),便于对照代码。
failed_notes.sort_by_key(|entry| entry.severity.priority());
lines.push(String::new());
lines.push(" ── 不通过项说明 ──".to_string());
if failed_notes.is_empty() {
lines.push(" · (无 ------ 全部规则通过)".to_string());
} else {
for entry in &failed_notes {
lines.push(format!(
" {} [{}] {}",
entry.severity.marker(),
entry.rule_code,
entry.rule_description
));
lines.push(format!(" └─ {}", entry.conclusion));
}
}
// ---------- 第四屏:阻断项的行动清单 ----------
//
// 「一次报全」的设计目的是让运营改一轮就能过。
// 因此最后要明确列出「必须先处理哪些」,
// 而不是让运营自己在 8 条规则里判断哪条挡着发布。
let blockers: Vec<&str> = report
.entries
.iter()
.filter(|entry| !entry.passed && entry.blocks_publication_when_failed())
.map(|entry| entry.rule_code)
.collect();
lines.push(String::new());
lines.push(" ── 发布前必须处理 ──".to_string());
if blockers.is_empty() {
lines.push(" · (无 ------ 无阻断项,警告与提示可人工确认后发布)".to_string());
} else {
for (index, rule_code) in blockers.iter().enumerate() {
lines.push(format!(" {}. {}", index + 1, rule_code));
}
}
lines
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : flyweight_report.rs
//! # 享元专项报表 ------ 共享省了多少、共享是怎么发生的
//!
//! ## 为什么享元专项要独立成一份报表
//!
//! 排班报表回答的是「业务做得怎么样」,享元专项回答的是
//! **「这套共享机制本身工作得怎么样」**。
//!
//! 这两类问题的读者不同、发布节奏也不同:
//! 前者给运营每周看,后者给架构/性能负责人每次改键设计时看。
//! 合成一份报表的后果是:看业务的人被一堆字节数干扰,
//! 看机制的人要在几千行业务明细里翻那十几行关键指标。
//!
//! **报表拆分的依据是「读者与发布节奏」,不是「数据来源」。**
//! 本模块与 `schedule_report` 都读同一个 `ShiftPlan`,
//! 但拆开是对的。
//!
//! ## 三屏的顺序是有讲究的
//!
//! 1. **池快照**------先给事实(请求多少次、命中多少次、几个实例);
//! 2. **内存对照**------再给结果(省了多少字节);
//! 3. **共享度画像**------最后给过程(共享是怎么发生的、均不均匀)。
//!
//! 顺序不能颠倒。若先给「省了 96%」,读者会立刻接受这个结论;
//! 之后再看「命中率 3%」时,就难以推翻已经形成的印象。
//! **先事实、再结果、最后过程**,让每一步判断都有据可依。
use crate::analysis::{MemoryComparison, SharingProfile};
use crate::client::ShiftPlan;
use crate::domain::Ratio;
use crate::flyweight::PoolSnapshot;
use super::layout::{
bullet_line, byte_count_text, key_value_line, with_thousands_separator, TableColumn, TextTable,
};
/// 享元专项报表里「标签:值」行的标签宽度。
const SPECIAL_LABEL_WIDTH: usize = 18;
/// 渲染两个享元池的统计快照。
///
/// 参数 `plan`:排班方案(内含两个池的快照)。
/// 返回:若干行文本。
///
/// ## 为什么把「请求 / 命中 / 未命中 / 拒绝」四个数都打印
///
/// 只打印命中率是不够的------**命中率的含义依赖于未命中的构成**。
/// 举例:若拒绝 100 次、未命中 0 次,命中率看起来很高,
/// 但真相是「有 100 次请求根本没进池」(键空间失控)。
/// 四个数并列时,这种情形一眼可见。
///
/// 这也解释了为什么 `PoolCounters` 把三者**分开算**而不是用减法:
/// 用「请求 - 命中 = 未命中」会把拒绝次数算成未命中,
/// 于是「键失控」会被伪装成「预热期长」。
pub fn render_pool_snapshots(plan: &ShiftPlan) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
lines.push(" ── 班次模板池快照 ──".to_string());
lines.extend(render_one_pool_snapshot(&plan.template_pool_snapshot(), "模板"));
lines.push(String::new());
lines.push(" ── 门店等级配置池快照 ──".to_string());
lines.extend(render_one_pool_snapshot(&plan.grade_pool_snapshot(), "配置"));
lines
}
/// 渲染单个池的快照(供 [`render_pool_snapshots`] 复用两份)。
///
/// 参数 `snapshot`:池快照;`noun`:该池里享元的中文称谓(「模板」/「配置」)。
/// 返回:若干行文本。
///
/// 用一个函数渲染两个池而不是写两遍:**两个池的指标口径必须完全一致**,
/// 若各写一遍,迟早会出现「模板池打印拒绝次数、配置池忘了打印」这类不一致,
/// 而读者会误以为配置池从未拒绝过。
fn render_one_pool_snapshot(snapshot: &PoolSnapshot, noun: &str) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
let counters = snapshot.counters;
lines.push(key_value_line(
&format!("取用{}次数", noun),
SPECIAL_LABEL_WIDTH,
&with_thousands_separator(counters.request_count as i64),
));
lines.push(key_value_line(
"命中(复用既有)",
SPECIAL_LABEL_WIDTH,
&format!(
"{}({})",
with_thousands_separator(counters.hit_count as i64),
Ratio::from_basis_points(counters.hit_rate_basis_points()).as_percent_text()
),
));
lines.push(key_value_line(
"未命中(新建)",
SPECIAL_LABEL_WIDTH,
&format!(
"{}({})",
with_thousands_separator(counters.miss_count as i64),
Ratio::from_basis_points(counters.miss_rate_basis_points()).as_percent_text()
),
));
// 拒绝次数只在真的发生过时才展开显示;但它**一定会被显示**,
// 而不是被省略掉------见下方「口径」说明。
lines.push(key_value_line(
"拒绝(容量溢出)",
SPECIAL_LABEL_WIDTH,
&format!(
"{}({})",
with_thousands_separator(counters.rejected_count as i64),
Ratio::from_basis_points(counters.rejection_rate_basis_points()).as_percent_text()
),
));
lines.push(key_value_line(
"池内不同实例数",
SPECIAL_LABEL_WIDTH,
&format!("{} 个", snapshot.distinct_entry_count),
));
lines.push(key_value_line(
"容量上限",
SPECIAL_LABEL_WIDTH,
&match snapshot.entry_limit {
Some(limit) => format!("{} 个", limit),
// 「未设上限」与「上限很大」是两件事,必须显示成两种文本。
None => "未设上限".to_string(),
},
));
lines.push(key_value_line(
"被持有句柄总数",
SPECIAL_LABEL_WIDTH,
&with_thousands_separator(snapshot.held_reference_total as i64),
));
lines.push(key_value_line(
"实例内容字节",
SPECIAL_LABEL_WIDTH,
&byte_count_text(snapshot.intrinsic_bytes_total),
));
lines.push(key_value_line(
"句柄与控制块字节",
SPECIAL_LABEL_WIDTH,
&byte_count_text(snapshot.handle_bytes_total),
));
lines.push(key_value_line(
"共享侧合计",
SPECIAL_LABEL_WIDTH,
&byte_count_text(snapshot.shared_total_bytes()),
));
lines.push(key_value_line(
&format!("平均每个{}字节", noun),
SPECIAL_LABEL_WIDTH,
&byte_count_text(snapshot.average_intrinsic_bytes()),
));
lines.push(key_value_line(
"平均共享倍数",
SPECIAL_LABEL_WIDTH,
&Ratio::from_basis_points(snapshot.average_share_multiplier_basis_points())
.as_multiplier_text(),
));
lines.push(key_value_line(
"是否曾溢出",
SPECIAL_LABEL_WIDTH,
if snapshot.is_capacity_exceeded() { "是" } else { "否" },
));
lines
}
/// 渲染内存对照表。
///
/// 参数 `comparison`:`analysis` 层算好的对照结果。
/// 返回:若干行文本。
///
/// ## 打印顺序:共享侧 → 独立侧 → 差额 → 比率
///
/// 这个顺序本身就是论证结构:
/// 先摆出两个数(各自多少),再摆出差,最后才给比率。
/// **比率放在最后,是因为比率是最容易被误读的量**------
/// 一个「省了 97%」的数字,若不先看到「独立侧 8.8 MB」这个绝对量,
/// 读者无法判断这到底省得多还是本来就无所谓。
///
/// ## 为什么不换算成 KB / MB
///
/// 因为字节数要人工核对。换算会引入小数并在展示时丢掉精度,
/// 当「报表显示 8.6 MB」而实测是 9,012,345 字节时,
/// 无法判断是四舍五入还是算错了。**保留原值 + 千分位**是唯一稳妥的做法。
pub fn render_memory_comparison(comparison: &MemoryComparison) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
lines.push(format!(
" ── 内存对照(槽位 {} 个)──",
with_thousands_separator(comparison.slot_count as i64)
));
// ---------- 共享侧明细 ----------
lines.push(" 【共享侧:享元 + 句柄 + 外在状态】".to_string());
lines.push(bullet_line(
"班次模板内容(含键)",
&with_thousands_separator(comparison.shared_template_content_bytes as i64),
14,
));
lines.push(bullet_line(
"门店等级配置内容",
&with_thousands_separator(comparison.shared_store_grade_content_bytes as i64),
14,
));
lines.push(bullet_line(
"句柄与控制块",
&with_thousands_separator(comparison.shared_handle_bytes as i64),
14,
));
lines.push(bullet_line(
"槽位自身外在状态",
&with_thousands_separator(comparison.shared_slot_state_bytes as i64),
14,
));
lines.push(bullet_line(
"共享侧合计",
&with_thousands_separator(comparison.shared_total_bytes() as i64),
14,
));
// ---------- 独立侧明细 ----------
lines.push(String::new());
lines.push(" 【独立侧:每个槽位各持一份副本】".to_string());
lines.push(bullet_line(
"班次模板副本(全部槽位)",
&with_thousands_separator(comparison.unshared_template_copy_bytes as i64),
14,
));
lines.push(bullet_line(
"门店等级配置副本(全部槽位)",
&with_thousands_separator(comparison.unshared_store_grade_copy_bytes as i64),
14,
));
lines.push(bullet_line(
"槽位自身外在状态(同上)",
&with_thousands_separator(comparison.unshared_slot_state_bytes as i64),
14,
));
lines.push(bullet_line(
"独立侧合计",
&with_thousands_separator(comparison.unshared_total_bytes() as i64),
14,
));
// ---------- 差额 ----------
//
// 差额可能是负数(例如槽位数极少时,池的固定开销反而更大)。
// 因此这一行不做「省了多少」的措辞,只说「差额」,
// 由下面两行的比率来定性。若强行写成「省了 -1234 字节」,
// 读者会以为算错了。
lines.push(String::new());
lines.push(bullet_line(
"差额(独立侧 − 共享侧)",
&with_thousands_separator(comparison.saved_bytes()),
14,
));
if comparison.saved_bytes() < 0 {
lines.push(" · 注意:差额为负,说明该规模下池的固定开销超过收益".to_string());
}
// ---------- 比率 ----------
lines.push(String::new());
lines.push(key_value_line(
"总内存节省率",
SPECIAL_LABEL_WIDTH,
&format!(
"{}(含外在状态,被稀释)",
comparison.saved_ratio_as_ratio().as_percent_text()
),
));
lines.push(key_value_line(
"可共享部分节省率",
SPECIAL_LABEL_WIDTH,
&Ratio::from_basis_points(comparison.saved_ratio_of_shareable_basis_points())
.as_percent_text(),
));
lines.push(key_value_line(
"槽位外在状态占比",
SPECIAL_LABEL_WIDTH,
&Ratio::from_basis_points(comparison.slot_state_ratio_basis_points()).as_percent_text(),
));
lines.push(key_value_line(
"每槽位共享侧字节",
SPECIAL_LABEL_WIDTH,
&format!("{} 字节", comparison.shared_bytes_per_slot()),
));
lines.push(key_value_line(
"每槽位独立侧字节",
SPECIAL_LABEL_WIDTH,
&format!("{} 字节", comparison.unshared_bytes_per_slot()),
));
// 这一行把「省了多少字节」锚定到一个读者有直觉的单位上。
// 除数是**单个槽位自身**的字节数(`slot_intrinsic_bytes`,即 ShiftSlot 的
// size_of),不是「独立侧每槽位字节」(那个值还含每槽位各背一份的副本)。
// 两者相差一个数量级,标签必须写清楚除数是谁,否则读者无法复算。
lines.push(key_value_line(
"节省折合槽位数",
SPECIAL_LABEL_WIDTH,
&format!(
"≈ {} 个槽位自身大小(除数 = 单个槽位 {} 字节)",
comparison.saved_equivalent_slot_count(),
comparison.slot_intrinsic_bytes
),
));
// ---------- 两个节省率为什么必须同时给出 ----------
//
// 「总节省率」把外在状态(每个槽位都要占的那部分)也算进分母,
// 因此它总是偏小;「可共享部分节省率」只看真正可共享的那部分,
// 因此它反映的是**机制本身的效果**。
//
// 只报总节省率会让读者低估享元的价值(并据此错误地放弃优化);
// 只报可共享部分节省率会让读者高估整体收益。
// 两个一起给,读者才能判断「是机制不够好」还是「可共享的东西本来就少」。
lines.push(String::new());
lines.push(" · 说明:总节省率的分母含每个槽位都要占的外在状态,故必然偏小;".to_string());
lines.push(" 可共享部分节省率只衡量「可共享内容」的缩减,反映机制本身的效果。".to_string());
lines.push(" 两个一起看,才能区分「机制无效」与「可共享的东西本来就少」。".to_string());
lines
}
/// 渲染共享度画像。
///
/// 参数 `profile`:`analysis` 层算好的画像。
/// 返回:若干行文本。
pub fn render_sharing_profile(profile: &SharingProfile) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
lines.push(" ── 共享度画像 ──".to_string());
let table: TextTable = TextTable::new(vec![
TableColumn::left("享元族", 16),
TableColumn::right("实例数", 8),
TableColumn::right("取用次数", 12),
TableColumn::right("命中率", 10),
TableColumn::right("被持有句柄", 12),
TableColumn::right("平均共享倍数", 14),
]);
lines.push(format!(" {}", table.header_line()));
lines.push(format!(" {}", table.separator_line()));
lines.push(format!(
" {}",
table.row_line(&[
"班次模板".to_string(),
profile.distinct_template_count.to_string(),
with_thousands_separator(profile.template_request_count as i64),
Ratio::from_basis_points(profile.template_hit_rate_basis_points()).as_percent_text(),
with_thousands_separator(profile.template_held_reference_total as i64),
Ratio::from_basis_points(profile.average_template_share_basis_points())
.as_multiplier_text(),
])
));
lines.push(format!(
" {}",
table.row_line(&[
"门店等级配置".to_string(),
profile.distinct_store_grade_count.to_string(),
with_thousands_separator(profile.store_grade_request_count as i64),
Ratio::from_basis_points(profile.store_grade_hit_rate_basis_points()).as_percent_text(),
with_thousands_separator(profile.store_grade_held_reference_total as i64),
Ratio::from_basis_points(profile.average_store_grade_share_basis_points())
.as_multiplier_text(),
])
));
lines.push(format!(" {}", table.separator_line()));
lines.push(String::new());
lines.push(key_value_line(
"两族实例总数",
SPECIAL_LABEL_WIDTH,
&format!("{} 个", profile.total_distinct_instance_count()),
));
lines.push(key_value_line(
"两族取用总次数",
SPECIAL_LABEL_WIDTH,
&with_thousands_separator(profile.total_request_count() as i64),
));
lines.push(key_value_line(
"最热模板共享槽位",
SPECIAL_LABEL_WIDTH,
&format!(
"{} 个(分布{})",
with_thousands_separator(profile.maximum_template_share_count as i64),
// 「均匀」与否由 `is_sharing_uneven`(阈值 4 倍)判断。
// 这里只输出一个词,不输出倍数------倍数已在「平均共享倍数」一栏给出,
// 重复输出只会让读者去比较两个本应相同的数。
if profile.is_sharing_uneven() { "不均" } else { "较均匀" }
),
));
lines.push(key_value_line(
"每槽位平均引用模板数",
SPECIAL_LABEL_WIDTH,
&Ratio::from_basis_points(profile.template_references_per_slot_basis_points())
.as_multiplier_text(),
));
// ---------- 平均与最大必须并列的说明 ----------
lines.push(String::new());
lines.push(" · 平均共享倍数与最热共享槽位必须并列看:".to_string());
lines.push(" 平均低而最大高,说明共享严重不均衡------少数实例被大量复用,".to_string());
lines.push(" 其余近乎一次性。此时整体节省率可能仍不错,但键设计的改进空间很大。".to_string());
lines
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : layout.rs
//! # 排版原语 ------ 表格与分节
//!
//! ## 为什么把「排版」单独抽出来
//!
//! 本工程有四份报表(方案总览 / 成本分布 / 享元专项 / 合规体检)。
//! 若每份报表各自实现「怎么对齐一列数字」,迟早会出现
//! 「A 报表右对齐、B 报表左对齐」这种不一致,
//! 而且每修一次列宽要改四处。
//!
//! 因此把「一列多宽、往哪边对齐、怎么拼一行」这件唯一的事抽到本模块,
//! 四份报表只提供**内容**,不碰**宽度**。这就是 app 层内部的职责单一。
//!
//! ## 两个关键约束
//!
//! ### 约束一:宽度按**显示列数**算,不按字节也不按字符数
//!
//! 中文报表里 `"旗舰店"` 是 3 个字符 / 9 个字节 / **6 个显示列**。
//! Rust 的 `{:<10}` 按**字符数**填充,于是中文列会比英文列窄一半,
//! 整个表错位。本模块全部宽度都走 [`crate::support::text_layout`],
//! 与终端真实渲染口径一致。
//!
//! ### 约束二:单元格**截断**,与 `pad_right` 的「不截断」策略相反
//!
//! `text_layout::pad_right` 刻意不截断,理由是「列宽估小了应当暴露」。
//! 但那是给**单行文本**用的。表格不同:
//!
//! > 表格是一个**固定网格**。某一格溢出会把该行后面所有列推走,
//! > 读者看到的是「整张表乱了」,却**无法定位是哪一格太长**。
//!
//! 所以在表格里,溢出必须被限制在一个格子内------宁可截断,
//! 也不要让错误扩散到整行。这是两种场景对「诚实」的不同答案,
//! 不是自相矛盾:一个要暴露错误,一个要定位错误。
//!
//! 截断后不加省略号:本工程的列宽都留有充分余量,
//! 若真的发生截断,说明内容长度超出预期,此时**不加修饰**反而更容易发现
//! (`...` 会被误认为是内容本身的一部分)。
use crate::support::text_layout::{display_width, horizontal_rule, pad_left, pad_right, truncate_to_width};
/// 列内容的对齐方向。
///
/// 只用两种,不用「居中」:数字右对齐、文字左对齐已经覆盖报表全部需求,
/// 而居中对齐在中文环境下会遇到「奇数差值往哪边补」的问题
/// (见 `pad_center` 文档),多一种对齐就多一类对齐事故。
#[derive(Debug, Clone, Copy, PartialEq, Eq)]
pub enum ColumnAlignment {
/// 左对齐:用于名称、描述等文字列。
Left,
/// 右对齐:用于金额、件数、字节数等数字列。
Right,
}
/// 一列的定义。
#[derive(Debug, Clone, Copy)]
pub struct TableColumn {
/// 表头文字。
pub header: &'static str,
/// 该列的显示宽度(中文字符按 2 计)。
pub width: usize,
/// 该列的对齐方向。
pub alignment: ColumnAlignment,
}
impl TableColumn {
/// 构造一个**左对齐**列。
pub const fn left(header: &'static str, width: usize) -> TableColumn {
TableColumn { header, width, alignment: ColumnAlignment::Left }
}
/// 构造一个**右对齐**列。
pub const fn right(header: &'static str, width: usize) -> TableColumn {
TableColumn { header, width, alignment: ColumnAlignment::Right }
}
/// 把一个单元格内容按本列的口径整理成恰好该列宽的字符串。
///
/// 参数 `cell`:原始单元格内容。
/// 返回:截断并填充到列宽后的字符串。
fn render_cell(&self, cell: &str) -> String {
// 先截断到列宽以内(防止溢出推走后续列)。
//
// ## 为什么截断必须是「响亮」的
//
// 单元格溢出会推乱整行,所以截断本身是对的。但**静默**截断是危险的:
// 截断之后各行仍然对齐,报表看起来完全正常,只是内容少了一截
// (本工程曾把 `79247 小时 30 分` 悄悄截成 `79247 小时 30`,
// 肉眼几乎发现不了)。因此这里用 `debug_assert!` 把它变成
// 开发期就会立刻炸出来的错误------`cargo run`(debug 构建)必然触发,
// 而 release 构建下断言被消除,仍保留「宁可截断也不推乱整行」的行为。
//
// 若将来某个表格**确实**需要截断,把该列的宽度调够,或在调用处显式
// 截断文本后再传入------不要把这里改回静默状态。
let clipped: String = truncate_to_width(cell, self.width);
debug_assert!(
clipped == cell,
"表格单元格被截断:列宽 {} 列,但内容需要 {} 列,原文=[{}]。\
请调大该列宽度,或缩短传入的文本。",
self.width,
display_width(cell),
cell
);
// 再按对齐方向补齐到列宽。
match self.alignment {
ColumnAlignment::Left => pad_right(&clipped, self.width),
ColumnAlignment::Right => pad_left(&clipped, self.width),
}
}
}
/// 列与列之间的间隔空格数。
///
/// 选 2 而不是 1:中文全角字符本身视觉密度高,1 个半角空格会让相邻列
/// 看起来「粘在一起」,尤其当左列是中文、右列是数字时。
const COLUMN_GAP: usize = 2;
/// 一张定宽纯文本表。
///
/// ## 用法
///
/// ```ignore
/// let table = TextTable::new(vec![
/// TableColumn::left("规则", 22),
/// TableColumn::right("结果", 6),
/// ]);
/// println!("{}", table.header_line());
/// println!("{}", table.separator_line());
/// println!("{}", table.row_line(&["班次登记完整".to_string(), "通过".to_string()]));
/// ```
#[derive(Debug, Clone)]
pub struct TextTable {
/// 全部列定义,顺序即输出顺序。
columns: Vec<TableColumn>,
}
impl TextTable {
/// 用列定义构造一张表。
pub const fn new(columns: Vec<TableColumn>) -> TextTable {
TextTable { columns }
}
/// 表格总显示宽度(各列宽之和 + 列间隔)。
///
/// 用于绘制与之等宽的分隔线。若只在表头下方画一条线、
/// 而不是每行都画,表格既清晰又不啰嗦。
pub fn total_width(&self) -> usize {
let columns_width: usize = self.columns.iter().map(|column| column.width).sum();
let gaps_width: usize = self.columns.len().saturating_sub(1) * COLUMN_GAP;
columns_width + gaps_width
}
/// 渲染表头行。
pub fn header_line(&self) -> String {
let cells: Vec<String> = self
.columns
.iter()
.map(|column| {
// 表头一律左对齐:表头是标签,不是数据。
// 若表头也右对齐,读者会把表头与数字糊在一起。
pad_right(column.header, column.width)
})
.collect();
cells.join(&" ".repeat(COLUMN_GAP))
}
/// 渲染分隔线(与表格等宽)。
pub fn separator_line(&self) -> String {
horizontal_rule(self.total_width())
}
/// 渲染一行数据。
///
/// 参数 `cells`:按列顺序给出的单元格内容。
///
/// ## 单元格数量与列数不一致时怎么办
///
/// - 少于列数:缺的位置按空串渲染(**不 panic**);
/// - 多于列数:多余的内容**被忽略**。
///
/// 这两种情况都是调用方的 bug,但本工程选择「渲染但不错乱」,
/// 配合 `debug_assert` 让它在开发期就炸出来。
/// 理由是:报表渲染失败会让整场演示中断,而其代价远大于
/// 「多一格空列」这个后果------把错误降级为可观察的异常,而不是崩溃。
pub fn row_line(&self, cells: &[String]) -> String {
debug_assert_eq!(
cells.len(),
self.columns.len(),
"表格行列数不一致:表定义 {} 列,传入 {} 个单元格",
self.columns.len(),
cells.len()
);
let rendered: Vec<String> = self
.columns
.iter()
.enumerate()
.map(|(index, column)| {
let cell: &str = cells.get(index).map(String::as_str).unwrap_or("");
column.render_cell(cell)
})
.collect();
rendered.join(&" ".repeat(COLUMN_GAP))
}
/// 渲染一行「空行占位」,保持与数据行等宽(用于分组之间留白)。
pub fn blank_line(&self) -> String {
" ".repeat(self.total_width())
}
}
/// 分节标题的装饰线宽度。
///
/// ## 为什么是私有常量而不是公开配置
///
/// 它只影响「节的标题线画多长」,属于本模块的排版实现细节。
/// 若把它公开,调用方就会开始依赖这个数值------
/// 于是将来调整线宽会变成一次跨层的接口变更。
/// **实现细节公开出去,就会变成接口**,这条代价值得警惕。
///
/// ## 84 这个数是怎么来的
///
/// 它同时被两处使用:
/// 1. `section_header` 画分隔线;
/// 2. `note_line` 用 `84 - indent` 作为说明文字的最大宽度。
///
/// 因此它不是随手取的:**它必须大于本工程最长的一句说明文字**,
/// 否则说明会被静默截断(而截断的说明恰恰是最需要读全的那类文字)。
/// 本工程最长的一行说明约 80 列,故取 84 留出 4 列余量。
/// 若将来加入了更长的说明,这个数要跟着调------这是**耦合**,所以写在这里说明。
const SECTION_TITLE_WIDTH: usize = 84;
/// 生成一节的开头:空行 + 标题 + 分隔线。
///
/// 参数 `title`:节标题文本。
/// 返回:三行文本,按顺序放入输出即可。
///
/// 每节以空行开始,是为了在长输出里让节与节之间有呼吸感。
/// 分隔线用全角 `─`(见 `horizontal_rule`),与表格分隔线同一风格。
pub fn section_header(title: &str) -> Vec<String> {
vec![
String::new(),
format!("【{}】", title),
horizontal_rule(SECTION_TITLE_WIDTH),
]
}
/// 生成一行「标签:值」。
///
/// 参数 `label`:标签文本(右补空格到 `label_width` 列);
/// `value`:值文本。
/// 返回:一行文本。
///
/// 标签宽度由调用方给定而不是自算,是为了**同一份报表里的多行能对齐**------
/// 每行各自算宽度只会得到各自的对齐,反而参差。
pub fn key_value_line(label: &str, label_width: usize, value: &str) -> String {
format!(" {} {}", pad_right(label, label_width), value)
}
/// 生成一行「项目符号 + 文本(右对齐数值)」。
///
/// 参数 `text`:左侧文字;`numeric_text`:右侧数值文本;
/// `numeric_width`:右侧数值占的显示宽度。
/// 返回:一行文本。
///
/// 用于「结论 + 数字」并列的场景,例如内存对照里
/// 「共享侧合计 ...... 12,345 字节」这种行。
pub fn bullet_line(text: &str, numeric_text: &str, numeric_width: usize) -> String {
format!(" · {} {}", text, pad_left(numeric_text, numeric_width))
}
/// 把一串字节数渲染成「12,345 字节」。
///
/// 参数 `byte_count`:字节数。
/// 返回:带千分位的文本。
///
/// ## 为什么本函数只管排版、不做除法
///
/// 一个「转成 KB/MB」的版本很诱人,但它会让「共享省了多少」在
/// 小数位上失真------而本工程的字节数是要**人工核对**的。
/// 因此坚持原样输出**字节数**,只加千分位方便阅读。
/// 万一将来真要显示 KB,那也应当是**另一个**函数,而不是把
/// 单位换算偷偷混进排版里(那会让「报表数字与实测值不一致」变得难查)。
pub fn byte_count_text(byte_count: usize) -> String {
format!("{} 字节", with_thousands_separator(byte_count as i64))
}
/// 把整数渲染成带千分位的文本(支持负数)。
///
/// 参数 `value`:整数。
/// 返回:如 `12,345` 或 `-1,200`。
///
/// 本函数与 `domain::currency_amount` 内部的千分位函数**刻意重复**:
/// 领域层那个是金额格式化的一部分(要处理小数位与币种符号),
/// 属于领域知识;本函数只处理裸整数,属于排版知识。
/// 强行复用一个会让领域层的私有实现泄漏成公开 API------
/// 为了消除 20 行重复而牺牲模块边界,不划算。
pub fn with_thousands_separator(value: i64) -> String {
let negative: bool = value < 0;
// 用 i128 取绝对值,避免 i64::MIN 取反溢出。
let magnitude: i128 = (value as i128).abs();
let digits: String = magnitude.to_string();
let mut grouped: String = String::new();
for (index, character) in digits.chars().enumerate() {
// 从右往左每 3 位插一个逗号:当「剩余位数」是 3 的倍数且不是首位时插入。
let remaining: usize = digits.len() - index;
if index > 0 && remaining % 3 == 0 {
grouped.push(',');
}
grouped.push(character);
}
if negative {
format!("-{}", grouped)
} else {
grouped
}
}
/// 生成一行「缩进的补充说明」,并在需要时按宽度截断。
///
/// 参数 `text`:说明文字;`indent`:缩进空格数。
/// 返回:一行文本。
pub fn note_line(text: &str, indent: usize) -> String {
format!("{}· {}", " ".repeat(indent), truncate_to_width(text, SECTION_TITLE_WIDTH - indent))
}
/// 把多行文本按「最长行」对齐后的宽度补齐(用于给整块输出加边框)。
///
/// 参数 `lines`:文本行列表。
/// 返回:这些行中最大的显示宽度。
pub fn max_display_width(lines: &[String]) -> usize {
lines.iter().map(|line| display_width(line)).max().unwrap_or(0)
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : schedule_report.rs
//! # 排班报表 ------ 方案总览、成本分布、池内容清单
//!
//! ## 本模块只做一件事:把已有的数字摆到一张表里
//!
//! 所有被打印的数字都来自 `ShiftPlan` / `PayrollBreakdown` / 两个工厂,
//! 本模块**一次加、减、乘、除都不做**。
//!
//! 唯一看起来像「计算」的地方是「计薪工时」列:把 `u32` 分钟交给
//! [`WorkDuration::from_minutes`] 再调 `formatted_hours_and_minutes()`。
//! 这不是算术,而是**换一种表示法**(分钟 → 「7 小时 0 分」)。
//! 单位换算放在领域层做,是因为换算规则属于领域知识,
//! 而且换算本身也要遵守整数纪律------若在表示层自己 `minutes / 60`,
//! 就会在报表层引入一个不受领域层约束的除法。
//!
//! ## 池内容清单为什么必须存在
//!
//! 「池里有 7 个模板」是一个**结论**。若不能把这 7 个模板逐条列出来,
//! 读者只能选择相信或怀疑,无法判断。
//!
//! 而键设计是否正确,恰恰只能通过看这份清单来判断:
//! 若清单里出现「同一班次、同一技能、同一时段」的两行,
//! 说明键里混进了不该有的维度,共享已经失效。
//! 这项检查在 `coverage_audit` 里有自动版本(`SHARING_EFFECTIVE`),
//! 但**人眼看得见**是无可替代的------自动检查只能报「红灯」,
//! 无法告诉运营「是哪两个模板重复了」。
use crate::analysis::PayrollBreakdown;
use crate::client::ShiftPlan;
use crate::domain::{Ratio, WorkDuration};
use crate::flyweight::{ShiftTemplateFactory, StoreGradeFactory};
use super::layout::{key_value_line, with_thousands_separator, TableColumn, TextTable};
/// 「标签:值」行里标签的固定宽度(显示列数)。
///
/// 12 列够放下「实际出勤合计」这类 6 个汉字(12 列)的标签。
/// 定死宽度而不是每行自算,是为了同一节内的多行能对齐。
const OVERVIEW_LABEL_WIDTH: usize = 14;
/// 渲染「排班方案总览」。
///
/// 参数 `plan`:装配器产出的排班方案。
/// 返回:若干行文本。
///
/// ## 为什么把「区间 / 规模 / 金额」拆成三组
///
/// 因为读者读报表是**带着问题**来的:
/// 「排的是哪段时间」→ 看区间;「规模多大」→ 看规模;
/// 「花了多少」→ 看金额。
/// 三组之间插空行,让眼睛能按问题跳读;
/// 全部混在一起「信息密度更高」,但读者要逐行找到自己要的那一项。
pub fn render_plan_overview(plan: &ShiftPlan) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
// ---------- 第一组:区间与规模 ----------
lines.push(" ── 区间与规模 ──".to_string());
lines.push(key_value_line(
"排班区间",
OVERVIEW_LABEL_WIDTH,
&format!(
"{} ~ {}",
plan.date_range_start().formatted(),
plan.date_range_end().formatted()
),
));
lines.push(key_value_line(
"区间天数",
OVERVIEW_LABEL_WIDTH,
&format!("{} 天", plan.day_count()),
));
lines.push(key_value_line(
"参与门店",
OVERVIEW_LABEL_WIDTH,
&format!("{} 家", plan.store_count()),
));
lines.push(key_value_line(
"排班槽位",
OVERVIEW_LABEL_WIDTH,
&format!("{} 个", with_thousands_separator(plan.slot_count() as i64)),
));
// ---------- 第二组:工时 ----------
lines.push(String::new());
lines.push(" ── 工时 ──".to_string());
lines.push(key_value_line(
"计薪工时合计",
OVERVIEW_LABEL_WIDTH,
&WorkDuration::from_minutes(plan.total_paid_minutes()).formatted_hours_and_minutes(),
));
lines.push(key_value_line(
"实际出勤合计",
OVERVIEW_LABEL_WIDTH,
&WorkDuration::from_minutes(plan.total_actual_worked_minutes())
.formatted_hours_and_minutes(),
));
lines.push(key_value_line(
"加班合计",
OVERVIEW_LABEL_WIDTH,
&WorkDuration::from_minutes(plan.total_overtime_minutes()).formatted_hours_and_minutes(),
));
// ---------- 第三组:金额 ----------
lines.push(String::new());
lines.push(" ── 金额 ──".to_string());
lines.push(key_value_line(
"结算币种",
OVERVIEW_LABEL_WIDTH,
&format!(
"{}({})",
plan.currency().display_name(),
plan.currency().code()
),
));
lines.push(key_value_line(
"公司基准时薪",
OVERVIEW_LABEL_WIDTH,
&plan.company_base_hourly_rate().formatted_with_currency_code(),
));
lines.push(key_value_line(
"正常工时成本",
OVERVIEW_LABEL_WIDTH,
&plan.total_labor_cost().formatted(),
));
lines.push(key_value_line(
"加班成本",
OVERVIEW_LABEL_WIDTH,
&plan.total_overtime_cost().formatted(),
));
lines.push(key_value_line(
"成本合计",
OVERVIEW_LABEL_WIDTH,
&plan.total_cost().formatted(),
));
// ---------- 第四组:完整性 ----------
//
// 漏排信息即便为零也要打印。理由是:报表读者看到「漏排 0 条」
// 与「报表里没有漏排这一栏」是两种完全不同的安全感------
// 后者无法区分「确实没有」和「忘了检查」。
lines.push(String::new());
lines.push(" ── 完整性 ──".to_string());
lines.push(key_value_line(
"未登记班次漏排",
OVERVIEW_LABEL_WIDTH,
&format!("{} 个槽位", plan.unregistered_gap_count()),
));
lines.push(key_value_line(
"人手不足漏排",
OVERVIEW_LABEL_WIDTH,
&format!("{} 个槽位", plan.staffing_gap_count()),
));
lines.push(key_value_line(
"等级未登记门店",
OVERVIEW_LABEL_WIDTH,
&format!("{} 家(整体跳过)", plan.unregistered_store_grade_count()),
));
lines.push(key_value_line(
"模板池溢出",
OVERVIEW_LABEL_WIDTH,
if plan.is_template_pool_exhausted() { "是(新键一律被拒)" } else { "否" },
));
lines.push(key_value_line(
"方案是否完整",
OVERVIEW_LABEL_WIDTH,
if plan.has_any_gap() { "否 ------ 存在漏排" } else { "是 ------ 无漏排" },
));
// ---------- 第五组:未登记班次明细 ----------
//
// 只在这一组非空时才打印:空表打印一个表头只会占版面而零信息。
// 「为零也要打印」与「为空就省略」这两条规则的差别在于:
// 前者是**一个已知字段的取值**(有/无是两种可能的取值);
// 后者是**一张明细清单**(无明细时表头本身不构成信息)。
let records = plan.unregistered_shift_records();
if !records.is_empty() {
lines.push(String::new());
lines.push(" ── 未登记班次明细 ──".to_string());
let table = TextTable::new(vec![
TableColumn::left("班次编码", 20),
TableColumn::right("漏排槽位数", 12),
]);
lines.push(format!(" {}", table.header_line()));
lines.push(format!(" {}", table.separator_line()));
for (shift_code_text, count) in records {
lines.push(format!(
" {}",
table.row_line(&[shift_code_text.to_string(), count.to_string()])
));
}
}
lines
}
/// 渲染一份人力成本分布表。
///
/// 参数 `breakdown`:`analysis` 层产出的任一维度分组结果。
/// 返回:若干行文本。
///
/// ## 一个函数服务三个维度
///
/// 报表不关心分组是按时段、按班次还是按门店等级------
/// 它只需要「一组 (标签, 统计)」。因此本函数接收 `PayrollBreakdown`
/// 而不接收任何具体维度,新增维度(例如按城市)时本函数零改动。
/// 这与 `build_payroll_breakdown` 接收闭包的设计是同一条原则的两端:
/// **分析层不关心维度怎么来的,表示层不关心维度是什么。**
pub fn render_payroll_breakdown(breakdown: &PayrollBreakdown) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
lines.push(format!(" ── 按{}分布 ──", breakdown.dimension_label));
// 列宽一律按**该列可能出现的最宽值**定,而不是按「大部分值有多宽」。
// 「计薪工时」列最宽值形如 `79247 小时 30 分`(16 显示列)------
// 若按常见的 `7 小时 0 分`(10 列)定宽,合计行就会被悄悄截成
// `79247 小时 30`,而**截断后的表格看起来仍然整齐**,极难被发现。
let table = TextTable::new(vec![
TableColumn::left("分组", 13),
TableColumn::right("槽位数", 7),
TableColumn::right("计薪工时", 16),
TableColumn::right("人力成本", 14),
TableColumn::right("加班成本", 11),
TableColumn::right("成本占比", 8),
TableColumn::right("槽位均成本", 12),
]);
lines.push(format!(" {}", table.header_line()));
lines.push(format!(" {}", table.separator_line()));
for entry in &breakdown.entries {
lines.push(format!(
" {}",
table.row_line(&[
entry.label.clone(),
entry.slot_count.to_string(),
WorkDuration::from_minutes(entry.paid_minutes).formatted_hours_and_minutes(),
entry.labor_cost.formatted(),
entry.overtime_cost.formatted(),
entry.share_as_ratio().as_percent_text(),
entry.average_cost_per_slot().formatted(),
])
));
}
lines.push(format!(" {}", table.separator_line()));
// 合计行与明细行同一张表渲染,因此列宽天然一致------
// 若合计行单独用一套格式,最容易出现「合计行与明细行差一列」的经典缺陷。
lines.push(format!(
" {}",
table.row_line(&[
format!("合计 {} 组", breakdown.category_count()),
breakdown.slot_count.to_string(),
WorkDuration::from_minutes(breakdown.total_paid_minutes).formatted_hours_and_minutes(),
breakdown.labor_total.formatted(),
breakdown.overtime_total.formatted(),
"100.00%".to_string(),
breakdown.average_cost_per_slot().formatted(),
])
));
lines.push(String::new());
lines.push(format!(
" · 结算币种:{}({})",
breakdown.currency().display_name(),
breakdown.currency().code()
));
// 口径必须在报表里写明,而不是只写在代码注释里------
// 否则读者无法判断「槽位均成本」到底含不含加班。
lines.push(
" · 口径:本表的「槽位均成本」「每小时平均成本」均为**含加班的总成本**除以数量;"
.to_string(),
);
lines.push(
" 「人力成本」「加班成本」两列则是账目本身,不含对方。两类数字不要混着加减。"
.to_string(),
);
lines.push(format!(
" · 每次排班平均总成本:{}(共 {} 个槽位)",
breakdown.average_cost_per_slot().formatted(),
breakdown.slot_count
));
lines.push(format!(
" · 每计薪小时平均总成本:{}",
breakdown.average_cost_per_hour().formatted()
));
lines.push(format!(
" · 加班成本占总成本:{}",
// 这里把 `i64` 万分比交给 `Ratio` 再取百分比文本------
// 不是在做除法,而是**换一种表示法**(万分比 → 百分比字符串)。
// 除以 100 这件事由 `Ratio::as_percent_text` 内部完成,
// 它同时处理了负号与小数位,比在报表里手写 `x / 100` 稳。
Ratio::from_basis_points(breakdown.overtime_share_basis_points()).as_percent_text()
));
lines
}
/// 渲染班次模板池的内容清单。
///
/// 参数 `factory`:班次模板工厂。
/// 返回:若干行文本。
///
/// ## 这一屏是享元模式的「证据」
///
/// 遍历池里的每个实例并打印其内容。
/// 读者会看到:无论排了 1.2 万个槽位,这一屏**行数永远不变**------
/// 因为池里只有 7 个实例。这份「行数恒定」的视觉印象,
/// 比任何解释性的文字都更能说明享元在做什么。
pub fn render_shift_template_inventory(factory: &ShiftTemplateFactory) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
lines.push(" ── 班次模板池内容清单 ──".to_string());
let table = TextTable::new(vec![
TableColumn::left("班次", 10),
TableColumn::left("技能门槛", 8),
TableColumn::left("计薪时段", 10),
// 时刻列要容得下「22:30-次日 06:30」这种跨零点写法(16 显示列)。
TableColumn::left("时刻", 18),
TableColumn::right("计薪时长", 12),
TableColumn::right("综合系数", 10),
TableColumn::left("安保/双人", 12),
]);
lines.push(format!(" {}", table.header_line()));
lines.push(format!(" {}", table.separator_line()));
// 用回调遍历而不是先收集成 `Vec`------本工程的 `SharedHandle::strong_count`
// 参与统计,多克隆一次句柄就会让「共享倍数」多 1。
// 因此「只读遍历」必须用回调形式(见 `SharedPool::for_each_entry` 文档)。
//
// 但回调内不能直接 `push` 到 `lines`(闭包借用冲突要靠 `RefCell`,
// 而这里没必要引入内部可变性),因此先把行收集到局部 `Vec`,
// 回调结束后再并入输出。`Vec<String>` 的克隆代价与正确性相比不值一提。
let mut rows: Vec<Vec<String>> = Vec::new();
factory.pool().for_each_entry(|key, template| {
rows.push(vec![
template.shift_code().display_name().to_string(),
template.minimum_skill_grade().display_name().to_string(),
template.pay_period_kind().display_name().to_string(),
template.time_range_text(),
template.paid_duration().formatted_hours_and_minutes(),
template.combined_pay_multiplier().as_multiplier_text(),
format!(
"{}/{}",
yes_no(template.requires_security_presence()),
yes_no(template.requires_dual_presence())
),
]);
// 键的紧凑文本不进主表(太长会挤掉内容列),
// 但在调试时它是定位「两个实例为什么没合并」的第一手线索。
// 因此把它作为一个 `debug` 断言的载体保留在闭包内。
debug_assert!(!key.compact_text().is_empty(), "键的紧凑文本不应为空");
});
// 按班次显示顺序排序,保证两次运行输出一致。
// 池的遍历顺序取决于 `HashMap` 的迭代顺序(Rust 默认使用了随机种子),
// **不排序就不能复现**------这一点在「数字可核对」的要求下是硬约束。
rows.sort_by(|left, right| left[0].cmp(&right[0]).then(left[2].cmp(&right[2])));
for row in &rows {
lines.push(format!(" {}", table.row_line(row)));
}
lines.push(format!(" {}", table.separator_line()));
lines.push(format!(
" · 池内实例数:{} 个(登记班次时刻表 {} 种,计薪时段差异会各占一个实例)",
factory.pool().entry_count(),
factory.registered_shift_count()
));
lines
}
/// 渲染门店等级配置池的内容清单。
///
/// 参数 `factory`:门店等级配置工厂。
/// 返回:若干行文本。
///
/// 与班次模板清单同理:**行数恒定**是共享生效的视觉证据。
/// 差别在于本族的享元含两个 `Vec`(标准班次列表、合规备注),
/// 因此池内字节数不为零常量------这一屏也顺带让读者看到
/// 「享元不必是纯 POD,含堆内容的类型同样可以共享」。
pub fn render_store_grade_inventory(factory: &StoreGradeFactory) -> Vec<String> {
let mut lines: Vec<String> = Vec::new();
lines.push(" ── 门店等级配置池内容清单 ──".to_string());
let table = TextTable::new(vec![
TableColumn::left("门店等级", 12),
TableColumn::right("每班人数", 10),
TableColumn::left("营业时段", 14),
TableColumn::right("标准班次", 10),
TableColumn::left("专属安保", 10),
TableColumn::left("每日盘点", 10),
TableColumn::right("备注条数", 10),
]);
lines.push(format!(" {}", table.header_line()));
lines.push(format!(" {}", table.separator_line()));
let mut rows: Vec<Vec<String>> = Vec::new();
factory.pool().for_each_entry(|_grade, profile| {
rows.push(vec![
profile.grade().display_name().to_string(),
profile.minimum_staff_per_shift().to_string(),
format!(
"{}~{}",
profile.opening_time().formatted(),
profile.closing_time().formatted()
),
profile.standard_shift_count().to_string(),
if profile.requires_dedicated_security() { "需要" } else { "不需要" }.to_string(),
if profile.daily_audit_required() { "需要" } else { "不需要" }.to_string(),
profile.compliance_notes().len().to_string(),
]);
});
rows.sort_by(|left, right| left[0].cmp(&right[0]));
for row in &rows {
lines.push(format!(" {}", table.row_line(row)));
}
lines.push(format!(" {}", table.separator_line()));
lines.push(format!(
" · 池内实例数:{} 个(登记门店等级 {} 种,键即等级标签故二者相等)",
factory.pool().entry_count(),
factory.registered_grade_count()
));
// ---------- 合规备注明细 ----------
//
// 备注是「为什么这个等级要这么配」的书面依据,放在清单之后单独列出。
// 放进主表会把内容列撑爆(每条备注都超过 20 列),
// 这属于**选择正确的呈现形态**,而不是「为了好看牺牲信息」。
lines.push(String::new());
lines.push(" ── 各等级合规备注 ──".to_string());
let mut note_rows: Vec<Vec<String>> = Vec::new();
factory.pool().for_each_entry(|_grade, profile| {
for note in profile.compliance_notes() {
note_rows.push(vec![
profile.grade().display_name().to_string(),
(*note).to_string(),
]);
}
});
note_rows.sort_by(|left, right| left[0].cmp(&right[0]).then(left[1].cmp(&right[1])));
if note_rows.is_empty() {
lines.push(" · (无)".to_string());
} else {
for row in ¬e_rows {
lines.push(format!(" · {}:{}", row[0], row[1]));
}
}
lines
}
/// 把布尔值渲染成「是 / 否」。
///
/// 参数 `value`:布尔值。
/// 返回:`"是"` 或 `"否"`。
///
/// 不用 ✅/❌ 之类的符号:本工程的输出要被人工核对,
/// 而符号在不同终端字体下宽度可能不同(`is_wide_character` 未必能覆盖),
/// 会破坏已经精心对齐的列。汉字「是/否」宽度稳定可测。
fn yes_no(value: bool) -> &'static str {
if value {
"是"
} else {
"否"
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : labor_cost.rs
//! # 人力成本公式 ------ 一个可独立核对的纯函数
//!
//! ## 为什么公式要单独成文件、做成纯函数
//!
//! 本工程的报表要打印金额,且要求**人工可核对**。
//! 若把公式写在 `ShiftSlot::labor_cost` 里(作为方法),
//! 核对时就必须先构造一个合法槽位、再调用它------
//! 而构造槽位又需要享元句柄、门店、员工......核对成本极高。
//!
//! 抽成纯函数后,核对变成一次直接的函数调用:
//!
//! ```ignore
//! // 手算:¥28.00/时 × 1.00(技能)× 1.00(班次)× 1.00(时段)
//! // = ¥28.00/时;× 420 分钟 / 60 = ¥196.00
//! assert_eq!(
//! compute_labor_cost(&rate_28_00, Ratio::one(), Ratio::one(), 420, 0).formatted(),
//! "¥196.00".to_string()
//! );
//! ```
//!
//! ## 舍入链:四次算术,四处明确口径
//!
//! ```text
//! ① store_rate = base_rate × 门店指数 (basis_points,一次舍入)
//! ② effective_rate = store_rate × 模板综合系数 (basis_points,一次舍入)
//! ③ 工时成本 = effective_rate × 分钟 / 60 (minute_fraction,一次舍入)
//! ④ 槽位成本 = 工时成本 + 工龄津贴 (整数加法,不舍入)
//! ```
//!
//! **每一步的舍入口径都由 `domain` 层提供**(`scale_by_basis_points` /
//! `scale_by_minute_fraction`),本文件不自己写任何除法。
//! 这样「舍入方向」(远离零)在全工程只有一处定义。
//!
//! ## 一处刻意的口径选择:不合并乘法
//!
//! 数学上 `base × index × multiplier / 10000²` 可以一次算完(只舍入一次),
//! 比上面两步各舍入一次更精确。本工程仍选两步,理由是
//! **报表要打印中间值**(门店时薪、生效时薪),而这些中间值必须与
//! 最终金额口径一致。若一次算完,报表里的「生效时薪」就得另算一遍,
//! 于是出现两个可能不一致的口径------审计时无法解释。
//!
//! 「可解释性优先于最后一位精度」------这个取舍要写下来,
//! 否则后来者会把它「优化」掉。
use crate::domain::{CurrencyAmount, Ratio};
/// 加班时薪倍数(1.5 倍,即 15000 万分点)。
///
/// 放在本文件而不是 `domain`:加班倍数由**本工程的记账政策**决定,
/// 不是普适的领域事实(不同地区法定倍数不同)。
/// 领域层应只承载「不随本工程业务选择而变」的概念。
pub const OVERTIME_MULTIPLIER_BASIS_POINTS: i64 = 15_000;
/// 计算一个槽位的单班人力成本(不含加班)。
///
/// 参数 `company_base_hourly_rate`:公司基准时薪;
/// `store_pay_index`:门店时薪指数;
/// `combined_pay_multiplier`:班次模板的综合系数(技能 × 班次 × 时段);
/// `paid_minutes`:计薪分钟数(**来自享元模板**);
/// `seniority_allowance_minor_units`:该员工的每班工龄津贴(最小单位数)。
/// 返回:该槽位的成本。
///
/// ## 手算示例(用于人工核对)
///
/// 取公司基准 ¥28.00/时(2800 分)、旗舰店指数 11500(1.15)、
/// 早班模板系数 10000(1.00)、计薪 420 分钟、津贴 0:
///
/// ```text
/// ① 2800 × 11500 / 10000 = 3220.0 → ¥32.20/时(门店生效时薪)
/// ② 3220 × 10000 / 10000 = 3220.0 → ¥32.20/时(含班次系数)
/// ③ 3220 × 420 / 60 = 22540.0 → ¥225.40
/// ④ 22540 + 0 = 22540 → ¥225.40
/// ```
///
/// 交叉验证:¥32.20/时 × 7 小时 = ¥225.40 ✓
pub fn compute_labor_cost(
company_base_hourly_rate: &CurrencyAmount,
store_pay_index: Ratio,
combined_pay_multiplier: Ratio,
paid_minutes: u32,
seniority_allowance_minor_units: i64,
) -> CurrencyAmount {
// ① 公司基准时薪 → 门店生效时薪。
let store_rate: CurrencyAmount =
company_base_hourly_rate.scale_by_basis_points(store_pay_index.basis_points());
// ② 门店生效时薪 → 含班次/技能/时段系数的生效时薪。
let effective_rate: CurrencyAmount =
store_rate.scale_by_basis_points(combined_pay_multiplier.basis_points());
// ③ 时薪 × 计薪分钟 / 60 → 工时成本。
// 用统一入口而非 `× minutes / 60`:见 `scale_by_minute_fraction` 的说明。
let worked_cost: CurrencyAmount = effective_rate.scale_by_minute_fraction(paid_minutes);
// ④ 加上工龄津贴。津贴与基准时薪同币种,因此用同一个币种构造。
let allowance: CurrencyAmount =
CurrencyAmount::from_minor_units(seniority_allowance_minor_units, company_base_hourly_rate.currency());
// `add` 在币种不一致时返回 `None`。此处币种必然一致(由构造保证),
// 因此用 `unwrap_or(worked_cost)` 而不是 `expect`:
// 万一不变量被破坏,退化为「不计津贴」并让金额偏小 ------ 偏小会在
// 与手算对照时被发现,而 panic 会让整份报表拿不到。
worked_cost.add(&allowance).unwrap_or(worked_cost)
}
/// 计算加班部分的人力成本(在正常工时的 **顶部** 叠加)。
///
/// 参数 `company_base_hourly_rate` / `store_pay_index` /
/// `overtime_minutes`。
/// 返回:加班成本。
///
/// ## 为什么加班不用班次模板的综合系数
///
/// 加班费按**法定倍数**计(本工程取 1.5 倍),与「当时上的是什么班」无关。
/// 若沿用班次系数,夜班加班就会得到 1.25 × 1.5 = 1.875 倍的叠加结果------
/// 这在某些地区确实成立,但本工程的记账政策明确「加班统一 1.5 倍」。
///
/// **把政策差异显式写出来**(而不是默默沿用班次系数),
/// 是为了让「本工程选了哪种口径」可被读者检查------
/// 一个没写出口径的加班公式,读者无法判断它是漏了班次系数还是刻意不加。
pub fn compute_overtime_cost(
company_base_hourly_rate: &CurrencyAmount,
store_pay_index: Ratio,
overtime_minutes: u32,
) -> CurrencyAmount {
// ① 公司基准时薪 → 门店生效时薪(与正常工时同一口径)。
let store_rate: CurrencyAmount =
company_base_hourly_rate.scale_by_basis_points(store_pay_index.basis_points());
// ② 应用加班倍数。
let overtime_rate: CurrencyAmount =
store_rate.scale_by_basis_points(OVERTIME_MULTIPLIER_BASIS_POINTS);
// ③ 按分钟折算。
overtime_rate.scale_by_minute_fraction(overtime_minutes)
}
/// 供报表展示:把门店时薪指数与模板系数合成为一个「生效时薪」。
///
/// 参数 `company_base_hourly_rate` / `store_pay_index` / `combined_pay_multiplier`。
/// 返回:生效时薪。
///
/// ## 为什么单独提供一个函数(而不让报表自己算)
///
/// 报表要打印「生效时薪」这一中间值。若报表自己写两步 `scale_by_basis_points`,
/// 就出现了第二个执行相同计算的地方------将来若调整口径(如加入地区补贴),
/// 必须记得改两处。
///
/// 本函数与 [`compute_labor_cost`] 的前两步**共用同一实现路径**
/// (都是依次调用两次 `scale_by_basis_points`),
/// 因此两者打印出的数字天然一致。
pub fn compute_effective_hourly_rate(
company_base_hourly_rate: &CurrencyAmount,
store_pay_index: Ratio,
combined_pay_multiplier: Ratio,
) -> CurrencyAmount {
let store_rate: CurrencyAmount =
company_base_hourly_rate.scale_by_basis_points(store_pay_index.basis_points());
store_rate.scale_by_basis_points(combined_pay_multiplier.basis_points())
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : schedule_assembler.rs
//! # 排班装配器 ------ 模式的「客户端」
//!
//! ## 它在模式里的位置
//!
//! GoF 的 Client 角色。它做三件事:
//! 1. **驱动享元工厂**:为每个「门店 × 日期 × 班次」组合请求共享模板;
//! 2. **填充外在状态**:把门店、日期、员工、实际工时放进新建的槽位;
//! 3. **持有共享句柄**:槽位里存的是 `Rc<ShiftTemplate>`,不是模板副本。
//!
//! ## 关键:客户端只持有引用,从不复制享元
//!
//! 装配器拿到的是 `SharedHandle<ShiftTemplate>`。它在整个循环里
//! **从未调用任何「克隆模板内容」的操作**------`SharedHandle::clone` 是
//! 引用计数加一,不是深拷贝。
//!
//! ⚠️ 这个区别是 Rust 里最容易被忽略的一处:`Rc<T>` 实现了 `Clone`,
//! 而 `clone()` **看起来**像复制。若有人把 `slot.template().clone()`
//! 误认为「复制一份模板」,可能会写出「先 clone 再改」的代码------
//! 但 `Rc<T>` 的 `Deref` 只给 `&T`,改不了,因此**这类错误在 Rust 里
//! 根本写不出来**。这正是类型系统替我们守住享元不变性的地方。
//!
//! 对照 Java/C#:那里 `flyweight.clone()` 会真的复制,
//! 而「不要修改共享对象」只能靠注释与纪律维持。
//!
//! ## 装配的嵌套层次
//!
//! ```text
//! for 门店 (120)
//! └ 取门店等级配置(享元,共享)
//! for 日期 (31)
//! └ 判定计薪时段
//! for 该等级的默认班次 (2~4)
//! └ 取班次模板(享元,共享)→ 生成槽位
//! if 是盘点日 → 追加盘点夜班(另取一个模板)
//! ```
//!
//! 三层循环共约 1.1 万次迭代,其中**取模板的调用约 1.1 万次,
//! 但只有 20 个不同的键真正构造过实例**
//! (5 个班次 × 4 个计薪时段)------其余全命中。这就是享元省内存的机制。
//! ## 轮转序号的算法(一处刻意的选择)
//!
//! 选人时要给 [`super::store_profile::StoreProfile::pick_staff_for`]
//! 一个「轮转序号」,它对合格人数取模决定选谁。
//!
//! 轮转序号 = `日偏移 × 每日最多班次数 + 班次序号`。
//!
//! ⚠️ **不要改回「每个班次各一个计数器」**。那样每天的第一个班次
//! 都会取到「合格名单里的第 0 个人」,于是同一天的所有班次
//! 排给**同一个员工**------这会被合规体检的第 6 条规则
//! (`NO_DOUBLE_BOOKING`)抓到。本工程直接把序号乘以日偏移,
//! 让同一天内的班次序号在取模后自然错开。
//!
//! 这里不引入随机数:序号完全由「第几天、第几个班次」决定,
//! 因此两次运行的人员分配完全一致,报表数字可核对。
use crate::domain::{
SkillGrade, SHIFT_CODE_NIGHT_AUDIT, SKILL_GRADE_SENIOR, SKILL_GRADE_TECHNICIAN,
};
use crate::flyweight::{
SharedHandle, ShiftTemplate, ShiftTemplateFactory, ShiftTemplateKey, StoreGradeFactory,
StoreGradeProfile,
};
use crate::support::calendar_date::CalendarDate;
use crate::support::deterministic_code::build_seed;
use super::schedule_request::ScheduleRequest;
use super::shift_plan::ShiftPlan;
use super::shift_slot::ShiftSlot;
use super::staff_member::StaffMember;
/// 每日最多排入的班次数(含盘点夜班)。
///
/// 旗舰店有 4 个标准班次(早 / 中 / 晚 / 周末加强),
/// 加上盘点夜班共 5 个,因此取 8 作为「长度足够且是 2、4 的公倍数」的跨度。
/// 取 8 而不是 5 的原因:轮转序号要 `× 每日班次数` 后再对合格人数取模,
/// 而合格人数在本工程里是 2 / 3 / 4。8 与 2、4 都能整除,
/// 保证了「同一天内相邻班次的序号在取模后仍互不相同」。
/// 若取 5,则「合格人数为 4」时相邻班次的序号会隔 5,
/// `(day×5+0) % 4` 与 `(day×5+2) % 4` 会落到同一人。
pub const ROTATION_SHIFTS_PER_DAY: usize = 8;
/// 排班装配器。
///
/// 持有两个工厂的**引用**(`&'a`)而不是所有权:
/// 工厂的生命周期长于装配器(一次装配用完即弃,工厂可以服务多次装配)。
/// 这避免在装配器里 clone 工厂(那会复制整个享元池引用表)。
pub struct ScheduleAssembler<'context> {
template_factory: &'context ShiftTemplateFactory,
grade_factory: &'context StoreGradeFactory,
}
impl<'context> ScheduleAssembler<'context> {
/// 构造一个装配器。
///
/// 参数 `template_factory` / `grade_factory`。
/// 返回:装配器。
pub fn new(
template_factory: &'context ShiftTemplateFactory,
grade_factory: &'context StoreGradeFactory,
) -> ScheduleAssembler<'context> {
ScheduleAssembler {
template_factory,
grade_factory,
}
}
/// 按请求装配出一份排班方案。
///
/// 参数 `request`:排班请求。
/// 返回:排班方案(含全部槽位、两个池快照、以及全部漏排记录)。
pub fn assemble(&self, request: &ScheduleRequest) -> ShiftPlan {
// 先把日期区间展开成列表(一处展开,后面复用,避免重复算日期)。
let dates: Vec<CalendarDate> = request.enumerate_dates();
// 空请求的保护:没有任何日期时直接返回空方案。
// 不做这个判断会让下面的 `first()/last()` 需要 `unwrap`。
let (range_start, range_end): (CalendarDate, CalendarDate) = match (dates.first(), dates.last())
{
(Some(first_date), Some(last_date)) => (*first_date, *last_date),
_ => (request.start_date(), request.start_date()),
};
// 先生成一个空方案骨架,随后逐步填充。
// 这样「漏排记录」可以在循环中随时写入,不必先攒在临时变量里。
let mut plan: ShiftPlan = ShiftPlan::empty_skeleton(
request.company_base_hourly_rate(),
range_start,
range_end,
request.store_count(),
);
// 轮转序号已在调用点算好(见模块文档「轮转序号的算法」),
// 本方法不再维护计数器------计数器的键若按「门店 + 班次」划分,
// 会让同一天的不同班次取到同一个人(同日重复排班)。
// ── 第一层:遍历门店 ──
for store in request.stores() {
// 取该门店等级的共享配置。未登记则整店跳过(记一笔,不中断)。
let grade_profile: SharedHandle<StoreGradeProfile> =
match self.grade_factory.obtain(store.store_grade()) {
Some(profile) => profile,
None => {
plan.record_unregistered_store_grade();
continue;
}
};
// ── 第二层:遍历日期 ──
for shift_date in &dates {
// 判定当天的计薪时段(决定模板系数与键)。
let period_kind = request.period_kind_of(*shift_date);
// 日偏移:本日期距区间起始日的天数(0 起)。
// 用 `days_until` 而不是在循环里自增一个计数变量:
// 自增变量一旦与 `dates` 的构造方式脱钩(例如将来改成跳日排班),
// 就会静默错位;`days_until` 永远从事实出发。
let day_offset: usize =
request.start_date().days_until(shift_date).max(0) as usize;
// 该日轮转序号的基数。
let rotation_base: usize = day_offset * ROTATION_SHIFTS_PER_DAY;
// ── 第三层:遍历该等级的默认班次 ──
for (shift_ordinal, shift_code) in
grade_profile.standard_shift_codes().iter().enumerate()
{
self.assemble_one_slot(
&mut plan,
store,
&grade_profile,
*shift_code,
*shift_date,
period_kind,
rotation_base + shift_ordinal,
request,
);
}
// 盘点日:追加一个盘点夜班(技能要求更高,是另一个模板)。
if request.is_audit_date(*shift_date, grade_profile.daily_audit_required()) {
self.assemble_one_slot(
&mut plan,
store,
&grade_profile,
SHIFT_CODE_NIGHT_AUDIT,
*shift_date,
period_kind,
// 盘点夜班占用当日最后一个轮转槽位。
// 它的技能要求是技师,与白班的高级员工不共用名单,
// 因此即使序号撞上也不会造成「同一人同一天两个班」。
rotation_base + ROTATION_SHIFTS_PER_DAY - 1,
request,
);
}
}
}
// 装配结束:把两个池的最终快照写入方案。
// **必须在全部槽位生成之后取快照**------否则会漏掉最后几个模板,
// 导致「池里实例数」小于实际使用的模板数。
plan.set_pool_snapshots(
self.template_factory.snapshot(),
self.grade_factory.snapshot(),
);
plan
}
/// 装配单个槽位(内部方法,把三层循环的循环体抽出来)。
///
/// 参数过多是嵌套循环的固有代价;抽成方法后循环体只剩一次调用,
/// 可读性显著提升(对照:若不抽,三层循环里会嵌 30 行)。
#[allow(clippy::too_many_arguments)]
fn assemble_one_slot(
&self,
plan: &mut ShiftPlan,
store: &super::store_profile::StoreProfile,
grade_profile: &SharedHandle<StoreGradeProfile>,
shift_code: crate::domain::ShiftCode,
shift_date: CalendarDate,
period_kind: crate::domain::PayPeriodKind,
rotation_index: usize,
request: &ScheduleRequest,
) {
// 该班次需要的最低技能等级。
// 盘点夜班要求技师(涉及鉴定与保险柜操作),其余班次按「高级」配置。
// ## 为什么这个映射写在这里而不进享元键
// 它表达的是**本工程选择「哪个等级的人来上这个班」**这条排班政策,
// 属于装配侧的知识。若要把它做成可配置,应当放进门店等级配置规格。
let required_grade: SkillGrade = if shift_code == SHIFT_CODE_NIGHT_AUDIT {
SKILL_GRADE_TECHNICIAN
} else {
SKILL_GRADE_SENIOR
};
// 构造享元键:班次 × 技能等级 × 计薪时段。
// 注意 `store` **没有**进键------这正是跨店共享的前提。
let template_key = ShiftTemplateKey::new(shift_code, required_grade, period_kind);
// 向工厂取共享模板。
let template: SharedHandle<ShiftTemplate> = match self.template_factory.obtain(template_key)
{
Ok(shared_template) => shared_template,
Err(lookup_error) => {
// 取不到模板:记录失败并**跳过本槽位**,继续处理后面的。
// 这是「一次报全」的实现方式------绝不中断整批装配。
plan.record_lookup_failure(&lookup_error);
return;
}
};
// 挑人:从本店名单里找符合该班次技能要求的员工。
// 轮转序号由调用点给出(见模块文档),取模后保证同一天内
// 不同班次落到不同员工。
let selected_staff: StaffMember = match store.pick_staff_for(required_grade, rotation_index)
{
Some(member) => member,
None => {
// 本店没有该等级员工:记一笔「人力缺口」并跳过。
// 不 fallback 到更低等级------那会掩盖真实的人手不足问题。
plan.record_staffing_gap();
return;
}
};
// 派生槽位序号:由「门店 + 日期 + 班次 + 时段 + 员工」确定性生成。
// 五段全部参与,保证「换任何一项都会得到不同的槽位号」。
let shift_date_text: String = shift_date.formatted();
let slot_serial: u64 = build_seed(&[
store.store_code().code(),
&shift_date_text,
shift_code.code(),
period_kind.code(),
selected_staff.staff_number().text(),
]);
// ── 外在状态:全部在这里填充 ──
// 实际出勤分钟:按序号确定性派生一个 0~10 分钟的早退量。
// 用取模而不是随机数,保证两次运行输出完全一致(数字可核对)。
let paid_minutes: u32 = template.paid_duration().total_minutes();
let early_leave_minutes: u32 = (slot_serial % 11) as u32;
let actual_worked_minutes: u32 = paid_minutes.saturating_sub(early_leave_minutes);
// 加班:约 1/7 的槽位有加班,时长按序号派生 30/45/60/75 分钟。
let overtime_minutes: u32 = if slot_serial % 7 == 0 {
30 + ((slot_serial % 4) as u32) * 15
} else {
0
};
let slot = ShiftSlot::new(
slot_serial,
template,
SharedHandle::clone(grade_profile),
store.store_code(),
store.pay_index(),
shift_date,
selected_staff.staff_number(),
selected_staff
.per_shift_seniority_allowance()
.minor_units(),
actual_worked_minutes,
overtime_minutes,
);
plan.push_slot(slot);
// `request` 在本次调用里只用于「理论上可读取基准时薪」,
// 实际成本计算发生在 `ShiftPlan::total_labor_cost`。
// 这里显式引用一次,避免「参数未被使用」的告警,
// 也表明「装配阶段与计费阶段是分开的」这条设计意图。
let _ = request.company_base_hourly_rate();
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : schedule_request.rs
//! # 排班请求 ------ 装配器的输入
//!
//! ## 为什么把输入打包成一个类型
//!
//! 装配相关的输入有六七个维度(门店表、起止日期、节假日、盘点日、
//! 基准时薪、币种)。若作为参数逐个传给 `assemble`:
//! - 签名会很长,且 `&[StoreProfile]`/`&[CalendarDate]` 这类参数
//! 都是引用类型,**顺序写错编译器不报错**(同型参数);
//! - 将来加一个维度(如「地区补贴表」)要改签名与所有调用点。
//!
//! 打包成类型后,字段有名字,加字段不影响既有调用点。
//! 这是「参数对象」模式的应用,与 `ShiftScheduleSpec` 同样的理由。
//!
//! ## 「哪个日期属于哪个计薪时段」是本类型的核心知识
//!
//! 判定顺序(**顺序本身是业务规则,不能调换**):
//! 1. 先判法定节假日------节假日的上浮最高,且可能落在周末;
//! 2. 再判大促日------大促通常是公司指定日期(常落在周末);
//! 3. 再判周末;
//! 4. 最后是平日。
//!
//! 若把「周末」放在「节假日」之前,那么「落在周末的国庆节」会被
//! 按周末(1.10 倍)而不是节假日(2.00 倍)计薪------**少付一倍工资**。
//! 本工程把这个顺序写在一处并加注释,避免有人重排。
//! 第四幕会用「国庆节恰逢周六」这个具体日期把顺序错误的代价算出来。
use crate::domain::{CurrencyAmount, PayPeriodKind, PAY_PERIOD_HOLIDAY, PAY_PERIOD_NORMAL,
PAY_PERIOD_PROMOTION, PAY_PERIOD_WEEKEND};
use crate::support::calendar_date::CalendarDate;
use super::store_profile::StoreProfile;
/// 一次排班装配请求。
#[derive(Debug, Clone)]
pub struct ScheduleRequest {
/// 参与排班的门店表。
stores: Vec<StoreProfile>,
/// 排班起始日期。
start_date: CalendarDate,
/// 连续排班天数。
day_count: u32,
/// 法定节假日日期表。
holiday_dates: Vec<CalendarDate>,
/// 公司大促日日期表。
promotion_dates: Vec<CalendarDate>,
/// 盘点夜班固定落在星期几(0 = 周一 ... 6 = 周日)。
///
/// 本工程取周三(客流较低的一天适合闭店盘点)。
audit_weekday: u32,
/// 公司基准时薪(未含门店指数与班次系数)。
company_base_hourly_rate: CurrencyAmount,
}
impl ScheduleRequest {
/// 构造一个排班请求。
///
/// 参数见各字段说明。
/// 返回:排班请求。
#[allow(clippy::too_many_arguments)]
pub fn new(
stores: Vec<StoreProfile>,
start_date: CalendarDate,
day_count: u32,
holiday_dates: Vec<CalendarDate>,
promotion_dates: Vec<CalendarDate>,
audit_weekday: u32,
company_base_hourly_rate: CurrencyAmount,
) -> ScheduleRequest {
ScheduleRequest {
stores,
start_date,
day_count,
holiday_dates,
promotion_dates,
audit_weekday,
company_base_hourly_rate,
}
}
/// 门店表。
pub fn stores(&self) -> &[StoreProfile] {
&self.stores
}
/// 门店数量。
pub fn store_count(&self) -> usize {
self.stores.len()
}
/// 排班起始日期。
pub const fn start_date(&self) -> CalendarDate {
self.start_date
}
/// 排班天数。
pub const fn day_count(&self) -> u32 {
self.day_count
}
/// 盘点夜班落在星期几。
pub const fn audit_weekday(&self) -> u32 {
self.audit_weekday
}
/// 公司基准时薪。
pub const fn company_base_hourly_rate(&self) -> CurrencyAmount {
self.company_base_hourly_rate
}
/// 币种(由基准时薪携带)。
pub const fn currency(&self) -> crate::domain::Currency {
self.company_base_hourly_rate.currency()
}
/// 枚举排班区间内的所有日期。
///
/// 返回:按日期升序的日期列表。
///
/// 用逐日推进而不是「日期 + 序号」的两层循环:本工程的所有
/// 日期计算都走 [`CalendarDate::add_days`],
/// 这样闰年、月末等边界只有一处实现(见该函数的注释)。
pub fn enumerate_dates(&self) -> Vec<CalendarDate> {
let mut dates: Vec<CalendarDate> = Vec::with_capacity(self.day_count as usize);
for day_offset in 0..self.day_count {
dates.push(self.start_date.add_days(day_offset as i32));
}
dates
}
/// 判定某日期属于哪个计薪时段。
///
/// 参数 `date`:日期。
/// 返回:计薪时段。
///
/// ## 判定顺序不可调换(见模块文档)
///
/// 节假日 → 大促 → 周末 → 平日。
/// 这里把顺序写成一个**自顶向下的 if 链**而不是
/// 打分/优先级表:因为顺序本身是业务规则,用 if 链能让
/// 读者一眼看出「谁先谁后」,而优先级表需要读者去比较数值大小。
pub fn period_kind_of(&self, date: CalendarDate) -> PayPeriodKind {
// 1. 法定节假日优先------可能落在周末,必须优先匹配。
if self.holiday_dates.contains(&date) {
return PAY_PERIOD_HOLIDAY;
}
// 2. 公司大促日次之。
if self.promotion_dates.contains(&date) {
return PAY_PERIOD_PROMOTION;
}
// 3. 周末(周六、周日)。
if date.is_weekend() {
return PAY_PERIOD_WEEKEND;
}
// 4. 平日。
PAY_PERIOD_NORMAL
}
/// 某日期是否为盘点日(该店的等级配置要求盘点,且日期落在盘点星期)。
///
/// 参数 `date`:日期;`daily_audit_required`:该店等级是否要求盘点。
/// 返回:应安排盘点夜班时返回 `true`。
///
/// ## 为什么「是否要求盘点」由调用方传入,而不是本方法读等级配置
///
/// 因为等级配置是**享元实例**,要通过工厂获取;
/// 若本方法去取享元,请求对象就依赖了享元工厂,
/// 而请求对象本应是一个纯粹的「输入数据」。
/// 把「谁是享元」留给装配器处理,请求对象只做纯数据判定。
pub fn is_audit_date(&self, date: CalendarDate, daily_audit_required: bool) -> bool {
daily_audit_required && date.weekday_index() == self.audit_weekday
}
/// 排班区间内有多少个节假日(用于报表说明规模)。
pub fn holiday_count_in_range(&self) -> usize {
let end_date: CalendarDate = self.start_date.add_days(self.day_count as i32 - 1);
self.holiday_dates
.iter()
.filter(|date| {
// 闭区间判定:起始日 ≤ 日期 ≤ 结束日。
**date >= self.start_date && **date <= end_date
})
.count()
}
/// 排班区间内有多少个大促日。
pub fn promotion_count_in_range(&self) -> usize {
let end_date: CalendarDate = self.start_date.add_days(self.day_count as i32 - 1);
self.promotion_dates
.iter()
.filter(|date| **date >= self.start_date && **date <= end_date)
.count()
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : shift_plan.rs
//! # 排班方案 ------ 装配器的输出
//!
//! ## 本类型同时承担三件事
//!
//! 1. **承载结果**:全部排班槽位;
//! 2. **承载统计**:两个享元池的快照(共享度与内存的证据都在这里);
//! 3. **承载失败信息**:未登记班次、池容量溢出------
//! 这些**不让装配失败**,而是随方案一起返回(「一次报全」)。
//!
//! ## 关于第 3 点:为什么不直接返回 `Result`
//!
//! 若某个班次未登记就返回 `Err`,整批 1.2 万个槽位一个都拿不到,
//! 报表只能打印一行错误------而实际上**绝大多数槽位是好的**。
//!
//! 正确的做法是:能排的照排,排不了的在方案里记一笔,
//! 让报表同时给出「排了 11,988 个槽位」与「有 12 个槽位因班次未登记被跳过」。
//! 运营改一次配置就能重跑,不必反复试。
//!
//! 这与同系列工程「一次报全,从不提前 return」的做法一致。
//! 区别在于:Facade 工程把问题收集成事件列表,本工程收集成两个专门的字段
//! ------因为本工程的问题种类少且各自需要不同的处理动作。
use crate::domain::{Currency, CurrencyAmount};
use crate::flyweight::{PoolSnapshot, ShiftTemplateLookupError};
use crate::support::calendar_date::CalendarDate;
use super::labor_cost::compute_overtime_cost;
use super::shift_slot::ShiftSlot;
/// 一份完整的排班方案。
#[derive(Debug, Clone)]
pub struct ShiftPlan {
/// 全部排班槽位。
slots: Vec<ShiftSlot>,
/// 班次模板池的统计快照。
template_pool_snapshot: PoolSnapshot,
/// 门店等级配置池的统计快照。
grade_pool_snapshot: PoolSnapshot,
/// 因「班次未登记」而未能排班的记录(班次编码 + 次数)。
unregistered_shift_records: Vec<(&'static str, u32)>,
/// 因「该店无合格技能等级员工」而未能排班的槽位数。
staffing_gap_count: u32,
/// 因「门店等级未登记」而被整体跳过的门店数。
unregistered_store_grade_count: u32,
/// 模板池是否发生过容量溢出。
template_pool_capacity_exceeded: bool,
/// 本次排班使用的公司基准时薪。
company_base_hourly_rate: CurrencyAmount,
/// 排班区间起始日。
date_range_start: CalendarDate,
/// 排班区间结束日。
date_range_end: CalendarDate,
/// 参与排班的门店数。
store_count: usize,
}
/// ## 一处刻意的不对称:只有「空骨架」构造器,没有「一次性构造」构造器
///
/// 本类型有一个 `pub(crate) fn empty_skeleton(...)`,却**没有**一个
/// 接收全部字段的 `new(...)`。这不是遗漏:
///
/// - 方案是「逐步填出来」的(槽位一个个 push、失败记录一条条记、
/// 池快照在最后才取),因此真正可用的入口只有「先建骨架」这一个;
/// - 若再提供一个接收 11 个参数的 `new(...)`,那么任何一次字段增加
/// 都要改两处构造代码,且两处会各自漂移(比如 `new` 忘了校验不变量)。
///
/// **只保留一条构造路径**,是让「不变量只有一处维护点」的最简单办法。
/// 若将来真的需要「由外部数据整批构造方案」(例如从数据库读回一份历史方案),
/// 那时再加一个**专门的** `from_persisted(...)`,
/// 并在其中显式处理「历史数据可能缺字段」的差异------
/// 而不是把它硬塞进一个与 `empty_skeleton` 同形的 `new` 里。
impl ShiftPlan {
/// 排班槽位列表。
pub fn slots(&self) -> &[ShiftSlot] {
&self.slots
}
/// 槽位数量。
pub fn slot_count(&self) -> usize {
self.slots.len()
}
/// 参与排班的门店数。
pub const fn store_count(&self) -> usize {
self.store_count
}
/// 排班区间起始日。
pub const fn date_range_start(&self) -> CalendarDate {
self.date_range_start
}
/// 排班区间结束日。
pub const fn date_range_end(&self) -> CalendarDate {
self.date_range_end
}
/// 排班区间天数(含首尾)。
pub fn day_count(&self) -> i32 {
self.date_range_start.days_until(&self.date_range_end) + 1
}
/// 币种。
pub const fn currency(&self) -> Currency {
self.company_base_hourly_rate.currency()
}
/// 公司基准时薪。
pub const fn company_base_hourly_rate(&self) -> CurrencyAmount {
self.company_base_hourly_rate
}
/// 班次模板池快照。
pub const fn template_pool_snapshot(&self) -> PoolSnapshot {
self.template_pool_snapshot
}
/// 门店等级配置池快照。
pub const fn grade_pool_snapshot(&self) -> PoolSnapshot {
self.grade_pool_snapshot
}
/// 因班次未登记而未排班的记录。
pub fn unregistered_shift_records(&self) -> &[(&'static str, u32)] {
&self.unregistered_shift_records
}
/// 是否存在未登记班次导致漏排。
pub fn has_unregistered_shift_gap(&self) -> bool {
!self.unregistered_shift_records.is_empty()
}
/// 未登记班次导致的漏排总数。
pub fn unregistered_gap_count(&self) -> u32 {
self.unregistered_shift_records
.iter()
.map(|(_, count)| *count)
.sum()
}
/// 因无合格员工导致的漏排槽位数。
pub const fn staffing_gap_count(&self) -> u32 {
self.staffing_gap_count
}
/// 因门店等级未登记而被整体跳过的门店数。
pub const fn unregistered_store_grade_count(&self) -> u32 {
self.unregistered_store_grade_count
}
/// 是否存在任何形式的漏排。
///
/// 把四类失败合成一个布尔值供报表判断「方案是否完整」。
/// 但**各类计数仍分别保留**------合起来只是为了快速判断,
/// 不能因为「有个总开关」就把明细丢掉。
pub fn has_any_gap(&self) -> bool {
self.has_unregistered_shift_gap()
|| self.staffing_gap_count > 0
|| self.unregistered_store_grade_count > 0
}
/// 记录一次「无合格员工」的漏排。
pub(crate) fn record_staffing_gap(&mut self) {
self.staffing_gap_count += 1;
}
/// 记录一次「门店等级未登记」的门店跳过。
pub(crate) fn record_unregistered_store_grade(&mut self) {
self.unregistered_store_grade_count += 1;
}
/// 模板池是否溢出过。
pub const fn is_template_pool_exhausted(&self) -> bool {
self.template_pool_capacity_exceeded
}
/// 全部槽位的计薪工时总和(分钟)。
///
/// ## 为什么遍历槽位而不是「槽位数 × 每班时长」
///
/// 因为不同班次的计薪时长不同(早班 420 分钟、盘点夜班 390 分钟、
/// 周末加强班 465 分钟)。用乘法只有在「所有班次时长一致」时才成立,
/// 而那是一个会随业务变化而失效的假设。
/// 遍历求和的代价是 1.2 万次加法(微秒级),换来的是不会静默算错。
pub fn total_paid_minutes(&self) -> u32 {
let mut total: u32 = 0;
for slot in &self.slots {
total = total.saturating_add(slot.paid_minutes());
}
total
}
/// 全部槽位的实际出勤分钟总和。
pub fn total_actual_worked_minutes(&self) -> u32 {
let mut total: u32 = 0;
for slot in &self.slots {
total = total.saturating_add(slot.actual_worked_minutes());
}
total
}
/// 全部槽位的加班分钟总和。
pub fn total_overtime_minutes(&self) -> u32 {
let mut total: u32 = 0;
for slot in &self.slots {
total = total.saturating_add(slot.overtime_minutes());
}
total
}
/// 全部槽位的人力成本总和(含工龄津贴,不含加班)。
///
/// ## 累加方式:先全加、最后一次性给出
///
/// 每笔槽位成本已在 `compute_labor_cost` 里被舍入到「分」。
/// 这里的累加是**整数相加,不再舍入**------因此总额恰好等于
/// 各槽位成本之和,**没有二次舍入误差**。
///
/// 这一点让本工程的总额可被逐行核对:把报表里打印的
/// 前 N 行成本相加,应当精确等于它打印的小计。
pub fn total_labor_cost(&self) -> CurrencyAmount {
let currency: Currency = self.currency();
let mut total_minor_units: i64 = 0;
for slot in &self.slots {
let slot_cost: CurrencyAmount = slot.labor_cost(&self.company_base_hourly_rate);
total_minor_units = total_minor_units.saturating_add(slot_cost.minor_units());
}
CurrencyAmount::from_minor_units(total_minor_units, currency)
}
/// 全部槽位的加班成本总和。
///
/// 加班成本**不在** `total_labor_cost` 里:本工程的记账口径是
/// 「正常工时」与「加班」两本账,报表分列显示。
/// 若合成一个数字,运营无法看出「加班花了多少」这个可管控的量。
pub fn total_overtime_cost(&self) -> CurrencyAmount {
let currency: Currency = self.currency();
let mut total_minor_units: i64 = 0;
for slot in &self.slots {
let overtime_cost: CurrencyAmount = compute_overtime_cost(
&self.company_base_hourly_rate,
slot.store_pay_index(),
slot.overtime_minutes(),
);
total_minor_units = total_minor_units.saturating_add(overtime_cost.minor_units());
}
CurrencyAmount::from_minor_units(total_minor_units, currency)
}
/// 总成本 = 正常工时成本 + 加班成本。
pub fn total_cost(&self) -> CurrencyAmount {
let labor: CurrencyAmount = self.total_labor_cost();
let overtime: CurrencyAmount = self.total_overtime_cost();
// 同币种相加必然成功;用 `unwrap_or(labor)` 兜底而非 `expect`,
// 理由与 `compute_labor_cost` 里一致:偏小的数字能被核对发现。
labor.add(&overtime).unwrap_or(labor)
}
/// 遍历并统计「每个模板被多少个槽位共享」。
///
/// 返回:`(模板显示名, 共享槽位数)` 列表,按共享数降序。
///
/// ## 实现要点:按模板身份聚合,而不是按内容
///
/// 用 `SharedHandle::as_ptr()` 取指针地址作为身份键------
/// **这正是「共享」在运行期的定义:同一个地址即同一个对象。**
/// 若改用「内容比较」(如按班次编码聚合),会把
/// 「两份内容相同但地址不同的实例」误算成一份,
/// 从而**掩盖共享失效的 bug**(那正是本工程要检测的东西)。
///
/// 因此这里刻意用地址。地址是不可复现的(不同运行可能不同),
/// 但本函数只用来做**聚合**,不把地址打印出去,
/// 所以不影响输出的可复现性。
pub fn template_share_distribution(&self) -> Vec<(String, usize)> {
// 地址 → (显示名, 计数)。
// 用 `std::collections::HashMap` 需要 `usize` 键,地址用 `*const T` 转来。
let mut aggregated: Vec<(usize, String, usize)> = Vec::new();
for slot in &self.slots {
let address: usize = std::rc::Rc::as_ptr(slot.template()) as usize;
let display_name: String = format!(
"{}·{}·{}",
slot.template().shift_code().display_name(),
slot.template().minimum_skill_grade().display_name(),
slot.template().pay_period_kind().display_name()
);
// 线性查找(模板只有个位数,代价可忽略);
// 用它而不是 `HashMap` 是为了让「按地址聚合」这一步在代码里显式可见。
match aggregated.iter_mut().find(|(existing, _, _)| *existing == address) {
Some((_, _, count)) => *count += 1,
None => aggregated.push((address, display_name, 1)),
}
}
// 转成对外形态并按共享数降序排列。
let mut distribution: Vec<(String, usize)> = aggregated
.into_iter()
.map(|(_, display_name, count)| (display_name, count))
.collect();
distribution.sort_by(|left, right| right.1.cmp(&left.1));
distribution
}
/// 把「装配过程中的一次取模板失败」记录进方案。
///
/// 参数 `error`:取模板时的失败原因。
///
/// 供装配器调用:装配器在循环里遇到失败时调用本方法,
/// 然后继续处理下一个槽位(**不中断**)。
/// 这正是「一次报全」的实现方式。
pub(crate) fn record_lookup_failure(&mut self, error: &ShiftTemplateLookupError) {
match error {
ShiftTemplateLookupError::UnregisteredShift { shift_code_text } => {
// 已有记录则计数 +1,否则新增一条。
match self
.unregistered_shift_records
.iter_mut()
.find(|(code, _)| *code == *shift_code_text)
{
Some((_, count)) => *count += 1,
None => self
.unregistered_shift_records
.push((shift_code_text, 1)),
}
}
ShiftTemplateLookupError::PoolCapacityExceeded { .. } => {
// 池溢出只需标记「发生过」,因为它是全局性问题
// (一次溢出意味着后续所有新键都会溢出),
// 逐次计数只会让报表出现一个巨大的数字而不增加信息量。
self.template_pool_capacity_exceeded = true;
}
}
}
/// 追加一个槽位。
pub(crate) fn push_slot(&mut self, slot: ShiftSlot) {
self.slots.push(slot);
}
/// 替换两个池快照(装配结束后由装配器写入最终值)。
pub(crate) fn set_pool_snapshots(
&mut self,
template_pool_snapshot: PoolSnapshot,
grade_pool_snapshot: PoolSnapshot,
) {
self.template_pool_snapshot = template_pool_snapshot;
self.grade_pool_snapshot = grade_pool_snapshot;
}
/// 构造一个空的方案骨架(供装配器逐步填充)。
pub(crate) fn empty_skeleton(
company_base_hourly_rate: CurrencyAmount,
date_range_start: CalendarDate,
date_range_end: CalendarDate,
store_count: usize,
) -> ShiftPlan {
ShiftPlan {
slots: Vec::new(),
// 占位快照:装配结束后会被 `set_pool_snapshots` 覆盖。
// 用 `default()` 而非真实快照,是为了让「忘记写入快照」
// 表现为「报表显示全 0」而非「显示上一次的旧值」------
// 前者一眼可见,后者会误导。
template_pool_snapshot: PoolSnapshot::default(),
grade_pool_snapshot: PoolSnapshot::default(),
unregistered_shift_records: Vec::new(),
staffing_gap_count: 0,
unregistered_store_grade_count: 0,
template_pool_capacity_exceeded: false,
company_base_hourly_rate,
date_range_start,
date_range_end,
store_count,
}
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : shift_slot.rs
//! # 排班槽位 ------ 外在状态(Context)
//!
//! ## 这是「不被共享的那一半」
//!
//! 每个槽位代表「某门店、某天、某个班次、某人」的一次具体排班。
//! 它的外在状态**每个都不同**,因此不能进享元,只能各自持有。
//!
//! ## 字段划分表(这张表就是本模式的核心)
//!
//! | 字段 | 字节 | 共享? | 理由 |
//! |---|---|---|---|
//! | `slot_serial` | 8 | 否 | 每个槽位唯一 |
//! | `template` | 8 | **指针→享元** | 内在状态,7 份共享 |
//! | `grade_profile` | 8 | **指针→享元** | 第二族,3 份共享 |
//! | `store_code` | 32 | 否 | 每槽位所属门店不同 |
//! | `store_pay_index` | 8 | 否 | 各店指数不同 |
//! | `shift_date` | 6 | 否 | 每天不同 |
//! | `staff_number` | 16 | 否 | 每人不同 |
//! | `seniority_allowance_minor_units` | 8 | 否 | 工龄津贴(按人) |
//! | `actual_worked_minutes` | 4 | 否 | 实际出勤 |
//! | `overtime_minutes` | 4 | 否 | 加班时长 |
//!
//! 共享的两项各占 8 字节(一个胖指针),而它们指向的内容
//! 在「不共享」版本里要各占数百字节。这个对比就是本工程的全部论证。
//!
//! ## 两个刻意的「不奢靡」决定
//!
//! ### 1. 槽位号用 `u64` 而不是 `String`
//!
//! 直观写法是 `slot_code: String`(形如 `"SLOT-1A2B3C4D5E6F"`),
//! 但那会给**每个槽位**带来 24 字节 `String` 头 + 一次堆分配(约 20 字节内容
//! + 分配器开销)。1.2 万个槽位就是约 500KB 的额外堆内存与 1.2 万次分配。
//!
//! 改存 `u64`(由键内容确定性派生)后只占 8 字节、零分配,
//! 需要文本时用 [`ShiftSlot::slot_code_text`] 现场格式化。
//! **在一个以「省内存」为主题的工程里,连外在状态也不该挥霍**------
//! 否则「省下来的」会被其他地方悄悄吃掉。
//! (对比:不共享版本同样用 `u64`,因此这一项在两者间抵消,不影响结论。)
//!
//! ### 2. 工龄津贴存 `i64` 分,不存 `CurrencyAmount`
//!
//! `CurrencyAmount` 内含一个 [`crate::domain::Currency`](4 个字段
//! 共约 56 字节,含三个 `&'static str`)。让它出现在**高基数**对象
//! (每个槽位一个)里,等于为「这个金额是人民币」这条信息
//! 复制 1.2 万份------而整份排班表只有一个币种。
//!
//! 因此槽位只存最小单位数(8 字节),币种由 `ShiftPlan` 单一持有。
//!
//! ## 这背后是一条可迁移的规则
//!
//! > **「共享」不只是把大对象做成享元;凡是「在高基数对象里重复承载
//! > 低基数信息」的地方,都是共享的着力点。**
//!
//! 币种、货币符号、门店等级、班次时刻......都属于这一类。
//! 享元模式真正的适用面比「GoF 的字形例子」宽得多。
use crate::domain::{Ratio, StaffNumber, StoreCode};
use crate::flyweight::{SharedHandle, ShiftTemplate, StoreGradeProfile};
use crate::support::calendar_date::CalendarDate;
use crate::support::deterministic_code::derive_code;
use super::labor_cost::compute_labor_cost;
/// 一个排班槽位(外在状态)。
#[derive(Debug, Clone)]
pub struct ShiftSlot {
/// 槽位序号(由「门店 + 日期 + 班次键」确定性派生)。
///
/// 确定性保证:同样的输入永远得到同样的序号,
/// 因此两次运行的报表可以逐行对比(见 `support::deterministic_code`)。
slot_serial: u64,
/// 该槽位使用的班次模板(**共享句柄**)。
template: SharedHandle<ShiftTemplate>,
/// 该槽位所属门店的等级配置(**共享句柄**,第二族享元)。
grade_profile: SharedHandle<StoreGradeProfile>,
/// 门店编码。
store_code: StoreCode,
/// 门店时薪指数(外在状态)。
store_pay_index: Ratio,
/// 排班日期。
shift_date: CalendarDate,
/// 当班员工工号(外在状态)。
staff_number: StaffNumber,
/// 该员工的每班工龄津贴(最小单位数,币种见 `ShiftPlan`)。
seniority_allowance_minor_units: i64,
/// 实际出勤分钟数(外在状态,可与计薪时长不同)。
actual_worked_minutes: u32,
/// 加班分钟数(超出计薪时长的部分)。
overtime_minutes: u32,
}
impl ShiftSlot {
/// 构造一个排班槽位。
///
/// 参数较多,且全部是外在状态字段。**不对外开放**(`pub(crate)`):
/// 槽位应当由装配器统一构造,以保证:
/// 1. `slot_serial` 的派生口径统一(外部自己算可能用了不同种子);
/// 2. `overtime_minutes` 与 `actual_worked_minutes` 的关系一致。
#[allow(clippy::too_many_arguments)]
pub(crate) fn new(
slot_serial: u64,
template: SharedHandle<ShiftTemplate>,
grade_profile: SharedHandle<StoreGradeProfile>,
store_code: StoreCode,
store_pay_index: Ratio,
shift_date: CalendarDate,
staff_number: StaffNumber,
seniority_allowance_minor_units: i64,
actual_worked_minutes: u32,
overtime_minutes: u32,
) -> ShiftSlot {
ShiftSlot {
slot_serial,
template,
grade_profile,
store_code,
store_pay_index,
shift_date,
staff_number,
seniority_allowance_minor_units,
actual_worked_minutes,
overtime_minutes,
}
}
/// 槽位序号(原始 `u64`)。
pub const fn slot_serial(&self) -> u64 {
self.slot_serial
}
/// 槽位编号文本(形如 `SLOT-1A2B3C4D5E6F`)。
///
/// 现场格式化而非预存字符串------见类型文档的「不奢靡」说明。
pub fn slot_code_text(&self) -> String {
derive_code("SLOT", self.slot_serial)
}
/// 班次模板句柄。
pub fn template(&self) -> &SharedHandle<ShiftTemplate> {
&self.template
}
/// 门店等级配置句柄。
pub fn grade_profile(&self) -> &SharedHandle<StoreGradeProfile> {
&self.grade_profile
}
/// 门店编码。
pub const fn store_code(&self) -> StoreCode {
self.store_code
}
/// 门店时薪指数。
pub const fn store_pay_index(&self) -> Ratio {
self.store_pay_index
}
/// 排班日期。
pub const fn shift_date(&self) -> CalendarDate {
self.shift_date
}
/// 当班员工工号。
pub const fn staff_number(&self) -> StaffNumber {
self.staff_number
}
/// 工龄津贴(最小单位数)。
pub const fn seniority_allowance_minor_units(&self) -> i64 {
self.seniority_allowance_minor_units
}
/// 实际出勤分钟数。
pub const fn actual_worked_minutes(&self) -> u32 {
self.actual_worked_minutes
}
/// 加班分钟数。
pub const fn overtime_minutes(&self) -> u32 {
self.overtime_minutes
}
/// 该槽位的排班计薪分钟数(**来自享元**,不在槽位里重复存)。
pub fn paid_minutes(&self) -> u32 {
self.template.paid_duration().total_minutes()
}
/// 该槽位的人力成本。
///
/// 参数 `company_base_hourly_rate`:公司基准时薪(如 ¥28.00/时)。
/// 返回:该槽位的成本金额。
///
/// 计算链见 [`super::labor_cost::compute_labor_cost`] 的文档。
/// 本方法只是一个转发,把「槽位的数据」喂给那个纯函数------
/// **把公式留在纯函数里,是为了它能被单独核对**;
/// 若把公式写进本方法,核对时就要先构造一个槽位。
pub fn labor_cost(
&self,
company_base_hourly_rate: &crate::domain::CurrencyAmount,
) -> crate::domain::CurrencyAmount {
compute_labor_cost(
company_base_hourly_rate,
self.store_pay_index,
self.template.combined_pay_multiplier(),
self.paid_minutes(),
self.seniority_allowance_minor_units,
)
}
/// 该槽位当前是否与其他槽位共享同一份模板。
///
/// 返回:模板句柄的强引用计数 > 2 时返回 `true`。
///
/// ## 为什么阈值是 2
///
/// 强引用计数包含两处「固有」持有:
/// 1. 享元池自己在 `entries` 里持有一份;
/// 2. 本槽位自己持有一份。
///
/// 因此「本槽位之外还有别的持有者」⇔ 计数 ≥ 3 ⇔ 计数 > 2。
/// 写 `> 2` 而不是 `>= 3` 是为了让上面的推导在代码里可见
/// (读代码的人会立刻问「为什么是 2」)。
pub fn is_sharing_template_with_others(&self) -> bool {
SharedHandle::strong_count(&self.template) > 2
}
/// 该槽位模板当前被多少个持有点共享(含本槽位)。
///
/// 返回值 = `strong_count - 1`(减去池自己那一份)。
///
/// 这比 [`Self::is_sharing_template_with_others`] 给出的布尔值
/// 信息量更大:报表可以打印「本槽位的模板被 1714 个槽位共享」,
/// 这是一个**可核对的具体数字**,比「是/否」有说服力。
pub fn template_share_count(&self) -> usize {
SharedHandle::strong_count(&self.template) - 1
}
}
//!# encoding: utf-8
//!# 版权所有 2026 ©涂聚文有限公司™ ®
//!# 许可信息查看:言語成了邀功盡責的功臣,還需要行爲每日來值班嗎
//!# 描述:享元模式 Flyweight Pattern 结构型模式 Structural Patterns
//!# Author : geovindu,Geovin Du 涂聚文.
//!# IDE : RustRover 2025.1.1 Rust rustc 1.98.1
//!# os : windows 10
//!# database : mysql 9.0 sql server 2025, postgreSQL 18.0 Oracle 21c Neo4j
//!# Datetime : 2026/10/7 8:11
//!# User : geovindu
//!# Product : RustRover
//!# Project : flyweightpattern
//!# File : store_profile.rs
//! # 门店档案 ------ 外在状态的一部分
//!
//! ## 门店的两个部分:共享配置 + 各自差异
//!
//! | 内容 | 归属 | 理由 |
//! |---|---|---|
//! | 每班最低人数、营业时段、安保配置 | **享元**(`StoreGradeProfile`) | 同等级完全一致 |
//! | 门店编码、城市、时薪指数、员工名单 | **本类型**(外在状态) | 各店不同 |
//!
//! 把这两部分分开,是本工程第二个「内在 / 外在」切分点。
//! 旗舰店与旗舰店之间的**配置**完全相同(共享),
//! 但它们的**时薪指数**不同(一线城市生活成本高)。
//!
//! ## 时薪指数为什么是外在状态而不是进键
//!
//! 因为它影响的是**成本金额**,而不是**模板的内容**:
//! 同一份「早班模板」,在一线城市门店用 ¥32.20/时,
//! 在四线城市门店用 ¥26.60/时------**模板是同一个**,
//! 变化发生在「模板 × 门店指数」这一步。
//!
//! 若把时薪指数放进键,就会变成「每店每班一份模板」,
//! 共享收益坍塌(第四幕会量化这个坍塌的代价)。
//!
//! 判定标准再强调一次:**影响享元内容 → 进键;只影响使用结果 → 留在外层。**
use crate::domain::{Ratio, StoreCode, StoreGrade};
use super::staff_member::StaffMember;
/// 一家门店的档案。
///
/// 用 `Clone` 而非 `Copy`:内含 `Vec<StaffMember>`(员工名单),
/// 无法 `Copy`。装配器持有 `&[StoreProfile]` 的引用,不需要复制门店。
#[derive(Debug, Clone, PartialEq, Eq)]
pub struct StoreProfile {
/// 门店编码。
store_code: StoreCode,
/// 门店等级(决定取哪一份共享配置)。
store_grade: StoreGrade,
/// 门店时薪指数(万分点)。10000 表示公司基准,11500 表示上浮 15%。
pay_index: Ratio,
/// 该店可排班的员工名单。
///
/// ## 为什么名单是 `Vec<StaffMember>` 而不是 `Vec<StaffNumber>`
///
/// 装配器选人时需要员工的**技能等级**(用于生成模板键)
/// 与**工龄津贴**(用于算成本),因此必须持有完整档案。
/// 若只存工号,装配器就得再反查一次员工表------
/// 那等于把「数据结构的选择」问题转嫁给调用方。
///
/// 代价是门店档案变大(每店约 12 名员工 × 每人约 100 字节)。
/// 但门店只有 120 家(而排班槽位有 1.2 万个),
/// **在这个量级上复制门店是廉价而槽位是昂贵的**------
/// 资源该省在哪里,由「谁的数量大」决定,不是一律都省。
roster: Vec<StaffMember>,
}
impl StoreProfile {
/// 构造一家门店。
///
/// 参数 `store_code` / `store_grade` / `pay_index` / `roster`。
/// 返回:门店档案。
pub fn new(
store_code: StoreCode,
store_grade: StoreGrade,
pay_index: Ratio,
roster: Vec<StaffMember>,
) -> StoreProfile {
StoreProfile {
store_code,
store_grade,
pay_index,
roster,
}
}
/// 门店编码。
pub const fn store_code(&self) -> StoreCode {
self.store_code
}
/// 门店等级。
pub const fn store_grade(&self) -> StoreGrade {
self.store_grade
}
/// 门店时薪指数。
pub const fn pay_index(&self) -> Ratio {
self.pay_index
}
/// 员工名单。
pub fn roster(&self) -> &[StaffMember] {
&self.roster
}
/// 员工人数。
pub fn staff_count(&self) -> usize {
self.roster.len()
}
/// 按指定技能等级挑选员工(返回第一个匹配者)。
///
/// 参数 `required_grade`:班次要求的最低技能等级;
/// `rotation_index`:轮转序号(用于「同一班次多次出现时轮换人员」)。
/// 返回:匹配的员工;无人匹配时返回 `None`。
///
/// ## 轮转序号的作用与「非确定性」的避免
///
/// 若每次都返回第一个人,同一天的三个班次会排给同一名员工------
/// 这在业务上不成立(一人不能在三个班次同时在岗)。
/// 用 `rotation_index` 对匹配人数取模来做轮转。
///
/// 用**取模轮转**而不是随机数:本工程要求数值可复现
/// (两次运行输出必须完全一致,才能核对数字)。
/// 随机数会破坏这个性质,因此这里绝不引入随机。
pub fn pick_staff_for(
&self,
required_grade: crate::domain::SkillGrade,
rotation_index: usize,
) -> Option<StaffMember> {
// 先收集所有符合条件的员工(本工程规模下每店数人,代价可忽略)。
let qualified: Vec<StaffMember> = self
.roster
.iter()
.filter(|member| member.is_qualified_for(required_grade))
.copied()
.collect();
if qualified.is_empty() {
// 该店无此等级员工:返回 None,由装配器记一条「无人可排」的提示。
// 不 fallback 到其他等级------那会掩盖「人手不足」这个真实问题。
return None;
}
// 取模轮转,保证可复现。
Some(qualified[rotation_index % qualified.len()])
}
}