栈与队列的进出顺序、存储结构选择及循环队列判满
- 栈与队列的进出顺序、存储结构选择及循环队列判满
- [1. 阅读前问题卡:栈和队列](#1. 阅读前问题卡:栈和队列)
- [1.1 阅读前先看这几个问题](#1.1 阅读前先看这几个问题)
- [1.2 读完后完成这 3 道高频问题](#1.2 读完后完成这 3 道高频问题)
- [1.3 自检清单](#1.3 自检清单)
- [2. 前言](#2. 前言)
- [2.1 进出位置与数据顺序](#2.1 进出位置与数据顺序)
- [2.2 存储结构与操作接口](#2.2 存储结构与操作接口)
- [2.3 首尾相连后的判空与判满](#2.3 首尾相连后的判空与判满)
- [3. 栈和队列](#3. 栈和队列)
- [3.1 栈](#3.1 栈)
- [3.1.1 概念与结构](#3.1.1 概念与结构)
- [3.1.2 栈的实现](#3.1.2 栈的实现)
- [3.2 队列](#3.2 队列)
- [3.2.1 概念与结构](#3.2.1 概念与结构)
- [3.2.2 队列的实现](#3.2.2 队列的实现)
- [3.3 栈和队列算法题](#3.3 栈和队列算法题)
- [3.3.1 有效的括号](#3.3.1 有效的括号)
- [3.3.2 用队列实现栈](#3.3.2 用队列实现栈)
- [3.3.3 用栈实现队列](#3.3.3 用栈实现队列)
- [3.3.4 设计循环队列](#3.3.4 设计循环队列)
1. 阅读前问题卡:栈和队列
1.1 阅读前先看这几个问题
- 栈允许在哪一端插入和删除元素?这怎样决定元素的进出顺序?
- 压栈、出栈和取栈顶分别指什么?文中的栈接口还提供哪些操作?
- 为什么原文认为数组较适合实现栈?
- 队列的入队和出队分别发生在哪一端?它与栈的顺序有何不同?
- 为什么原文更倾向于用链表实现队列?队列声明中如何记录两端和有效元素个数?
- 循环队列为什么让
Q.rear所指位置不存储数据?原文用什么关系描述队空和队满?
1.2 读完后完成这 3 道高频问题
1.2.1 高频问题 1:请比较栈与队列的插入、删除位置和元素进出顺序。
1.2.2 高频问题 2:原文为什么分别倾向于用数组实现栈、用链表实现队列?
1.2.3 高频问题 3:循环队列为什么要空出 rear 所指位置?原文如何区分队空与队满?
1.3 自检清单
- 能说清栈顶、栈底以及后进先出的关系。
- 能指出压栈、出栈和取栈顶分别对应什么操作。
- 能说清队头、队尾以及先进先出的关系。
- 能解释原文对栈和队列底层结构的不同倾向。
- 能从两个头文件中辨认结构字段和基本操作声明。
- 能说出原文给出的循环队列队空、队满判别关系。
2. 前言
2.1 进出位置与数据顺序
一摞盘子只从最上面添放、取走,最后放上去的盘子会最先被取走。排队时,新来的人站到队尾,离开队伍的人从队头走,先来的人先离开。对应到文中,盘子的顶端是栈唯一进行插入和删除的一端;队伍的尾部和头部分别对应队列的入队端和出队端。由进出位置,便能理解栈的后进先出和队列的先进先出。
2.2 存储结构与操作接口
若总在一排位置的末端放入物品,从末端取放很直接;若要从这一排位置的开头不断取走物品,维持连续排列就更费事。对应到文中的结构选择:栈在栈顶进出,原文认为数组尾部插入代价较小,因此倾向数组;队列从队头出队,原文认为数组头部出数据效率较低,因此倾向链表。两个头文件随后列出存储字段和操作接口,但没有给出函数内部实现。
2.3 首尾相连后的判空与判满
把一圈位置依次用于放物品时,两个位置标记碰到一起,单看标记重合就难分辨是已取空还是已放满。预留一个位置,可以让两种状态呈现不同的标记关系。对应到原文的循环队列,Q.rear 所指位置不存储数据;文中用 Q.rear = Q.front 讨论队空与队满的区分,并将 rear + 1 = front 所示状态视为队满。
3. 栈和队列
3.1 栈
3.1.1 概念与结构
栈是一种特殊的线性表,只允许在固定的一端插入和删除元素。进行插入和删除操作的一端称为栈顶,另一端称为栈底。栈中的数据元素遵守后进先出 LIFO(Last In First Out)的原则。
- 压栈:栈的插入操作,也叫进栈、入栈;数据从栈顶进入。
- 出栈:栈的删除操作;数据从栈顶离开。
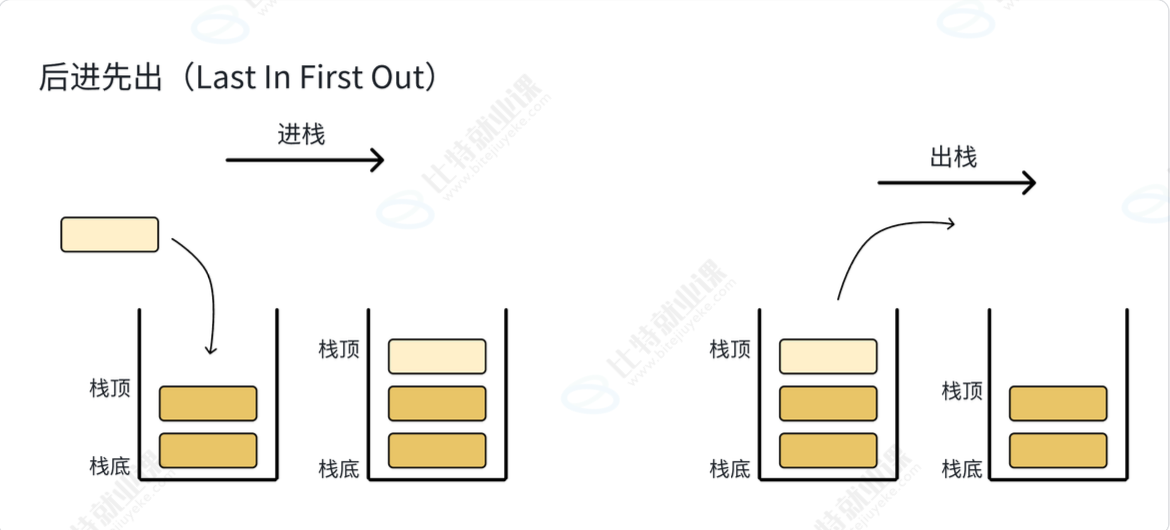
栈底层结构选型
栈一般可以使用数组或者链表实现。相对而言,数组结构更优一些,因为数组在尾部插入数据的代价比较小。
3.1.2 栈的实现
stack.h:
c
typedef int STDataType;

typedef struct Stack
{
    STDataType* a;
    int top;
    int capacity;
} ST;

// 初始化栈
void STInit(ST* ps);
// 销毁栈
void STDestroy(ST* ps);
// 入栈
void STPush(ST* ps, STDataType x);
// 出栈
void STPop(ST* ps);
// 取栈顶元素
STDataType STTop(ST* ps);
// 获取栈中有效元素个数
int STSize(ST* ps);
// 栈是否为空
bool STEmpty(ST* ps);
3.2 队列
3.2.1 概念与结构
队列是一种特殊的线性表,只允许在一端插入数据、在另一端删除数据,具有先进先出 FIFO(First In First Out)的特点。
- 入队列:进行插入操作的一端称为队尾。
- 出队列:进行删除操作的一端称为队头。
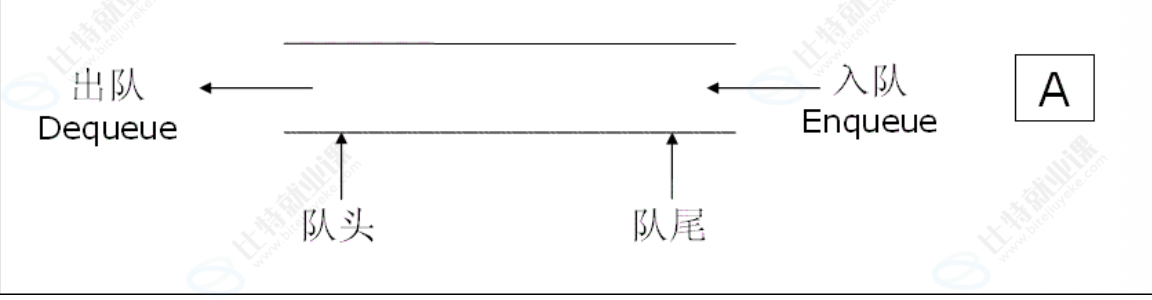
队列底层结构选型
队列也可以使用数组或链表实现。使用链表结构更优一些,因为如果使用数组结构,出队列要在数组头部取出数据,效率会比较低。
3.2.2 队列的实现
Queue.h:
c
typedef int QDataType;

// 队列结点结构
typedef struct QueueNode
{
    int val;
    struct QueueNode* next;
} QNode;

// 队列结构
typedef struct Queue
{
    QNode* phead;
    QNode* ptail;
    int size;
} Queue;

// 初始化队列
void QueueInit(Queue* pq);
// 销毁队列
void QueueDestroy(Queue* pq);
// 入队列,队尾
void QueuePush(Queue *pq, QDataType x);
// 出队列,队头
void QueuePop(Queue* pq);
// 取队头数据
QDataType QueueFront(Queue* pq);
// 取队尾数据
QDataType QueueBack(Queue* pq);
// 队列判空
bool QueueEmpty(Queue* pq);
// 队列有效元素个数
int QueueSize(Queue* pq);
3.3 栈和队列算法题
3.3.1 有效的括号
https://leetcode.cn/problems/valid-parentheses/description/
3.3.2 用队列实现栈
https://leetcode.cn/problems/implement-stack-using-queues/description/
3.3.3 用栈实现队列
https://leetcode.cn/problems/implement-queue-using-stacks/description/
3.3.4 设计循环队列
https://leetcode.cn/problems/design-circular-queue/description/
循环队列的概念与结构
循环队列是一种特殊的队列,首尾相连成环。循环队列可以使用数组实现,也可以使用循环链表实现。
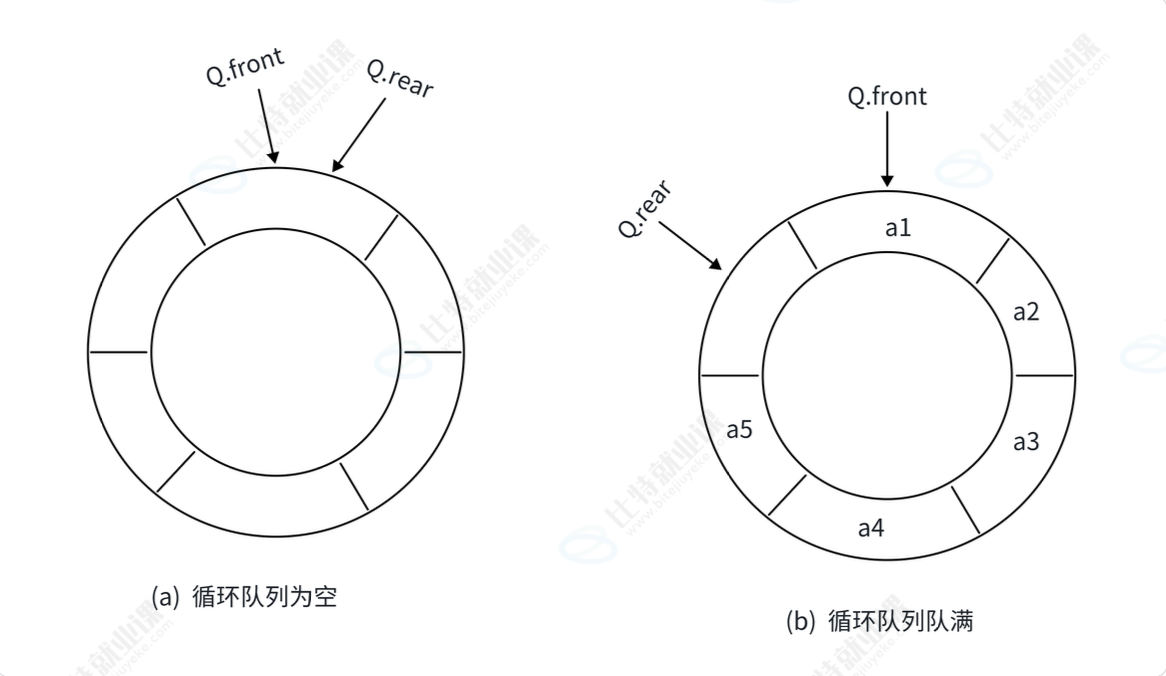
思考:队列满的情况下,为什么 Q.rear 不存储数据?
为了用 Q.rear = Q.front 区分队空与队满,文中将左图所示情况视为队满,此时 rear + 1 = front。
4.回答问题卡的问题
问题 1:栈允许在哪一端插入和删除元素?这怎样决定元素的进出顺序?
答:
栈顶,栈中的数据元素遵守后进先出 LIFO(Last In First Out)的原则。
问题 2:压栈、出栈和取栈顶分别指什么?文中的栈接口还提供哪些操作?
答:
压栈是栈的插入操作,出栈是栈的删除操作,取栈顶是读取栈顶元素
初始化栈STInit,销毁栈STDestroy,获取有效元素个数STSize和判断栈是否为空STEmpty。压栈、出栈和取栈顶分别对应 STPush、STPop、STTop。
问题 3:为什么原文认为数组较适合实现栈?
答:
因为数组在尾部插入数据的代价比较小
时间代价(常数项极低)
栈的入栈操作发生在数组尾部。如果数组容量足够,只需要执行 array[size] = value; size++;,也就是内存赋值和索引自增,对整数元素来说是 O(1)。如果触发扩容并重新分配存储空间,就可能要搬移已有元素;能否达到均摊 O(1) 要看扩容方案。std::vector 的尾部追加有这一保证,原文只给出 C 栈的接口,没有说明它采用什么扩容策略。
如果单链表没有维护尾指针,每次在尾部插入都需要从头遍历到尾节点,时间复杂度是 O(n);维护了尾指针后,连接新节点可以是 O(1)。链表栈也可以在表头插入和删除,避开尾部遍历。逐个申请节点的实现还会有内存分配开销,但是否每次重新申请、是否涉及系统调用、成本有多大,要看分配器和节点复用方式。
2. 空间代价(内存开销)
数组的内存是连续的。文中的栈结构除了存储数据,还维护数组指针 a、栈顶位置相关字段 top 和容量 capacity。
链表除了存储数据,每个节点还需要存储指针 next,这会带来额外开销。在 Windows x64 ABI 下,一个指针占 8 字节;具体大小要以目标平台为准。频繁申请和释放节点可能产生碎片,但不是必然产生大量碎片,分配器也会复用和管理空间。
3. 底层缓存(CPU Cache Locality)
数组在内存中是连续存储的,通常有利于利用相邻数据的缓存局部性。链表节点通过指针连接,不保证连续分布;如果节点分散,沿指针访问可能带来较差的局部性。实际速度仍取决于访问方式、分配布局和硬件,不能据此断言所有数组栈都比链表栈快。
问题 4:队列的入队和出队分别发生在哪一端?它与栈的顺序有何不同?
答:
队尾,队头
队列只允许在一端插入数据、在另一端删除数据,具有先进先出 FIFO(First In First Out)的特点。
队列先进入的先离开,栈最后进入的先离开。
问题 5:为什么原文更倾向于用链表实现队列?队列声明中如何记录两端和有效元素个数?
答:
因为如果使用数组结构,出队列要在数组头部取出数据,效率会比较低。
数组:
- 出队操作 :把第 0 个元素拿走后,数组会留下一个空洞。为了保持数组的连续性,后面的所有元素必须整体向前移动一位 (
array[i-1] = array[i])。 - 代价 :假设队列里有 10000 个元素,出队一次,就要搬运 9999 个元素。所以普通数组出队的时间复杂度是 O(n),极其耗费 CPU。
即使有些实现为了不移动数据,只让一个 head 指针往后移,却又不回绕或复用前面的空间,这会导致出现有空位却不能继续入队(称为"假溢出")(可以使用循环数组处理)
链表是由分散在内存中的节点通过指针连接起来的。
-
出队操作 :只需要把队头(head)指针指向下一个节点(
head = head->next),然后将原来的头节点释放掉即可。 -
代价 :全程只改变了几个指针的指向,完全不需要移动任何数据 。因此链表出队的时间复杂度是 O(1)。
-
同时,删除最后一个节点时,还要把队尾置空。链表入队(在尾部添加)只要维护好一个
tail(尾指针),也是 O(1)。文中的队列声明用
phead记录队头、ptail记录队尾、size记录有效元素个数,入队、出队时要相应更新计数
问题 6:循环队列为什么让 Q.rear 所指位置不存储数据?原文用什么关系描述队空和队满?
答:
"牺牲一个存储单元(即 Q.rear 所指位置不存数据)"是为了解决队空和队满判断条件冲突的问题
原文用 Q.rear = Q.front 表示头尾位置重合,对应队空;用 rear + 1 = front 表示队尾再往前走一格就到队头,对应队满。这里的 = 是关系表达,写成 C 的判断条件时要用 ==。
高频问题 1:请比较栈与队列的插入、删除位置和元素进出顺序。
答:
栈顶插入和删除元素,后进先出
队尾插入,队头删除,先进先出
高频问题 2:原文为什么分别倾向于用数组实现栈、用链表实现队列?
答:
原文倾向于用数组实现栈,是因为栈在栈顶进出,把栈顶安排在数组尾部时,尾部插入数据的代价比较小。
原文倾向于用链表实现队列,是因为队列从队头出队,而原文认为数组头部出数据效率较低。这是文中对结构选择的理由;原文也明确说循环队列可以使用数组实现,因此不能把这一倾向理解成队列只能使用链表。
高频问题 3:循环队列为什么要空出 rear 所指位置?原文如何区分队空与队满?
答:
空出 rear 所指位置,是为了让队空和队满对应不同的头尾关系,避免仅凭两个位置重合时无法区分状态。
按原文的关系表达,Q.rear = Q.front 对应队空,rear + 1 = front 对应队满,也就是队尾再沿环前进一格就到队头。这里的 = 表示相等关系;如果写 C 判断,要用 ==。由于首尾相连,"前进一格"也包括从末尾回到开头。
原文末句把左图称为队满,与配图标注冲突:图中左侧 (a) 标为队空,右侧 (b) 标为队满。