文章目录
- 一、强化学习基础
- 二、强化学习算法
-
- (一)免模型学习
-
- [1、策略优化方法(Policy Optimization)](#1、策略优化方法(Policy Optimization))
- 2、Q-Learning方法
- (二)有模型学习
- 三、偏好学习与DPO
-
- (一)偏好学习基础
- [(二)从偏好学习到 RLHF](#(二)从偏好学习到 RLHF)
- (三)DPO:直接偏好优化
- 四、PPO:近端策略优化
- 五、GRPO:群体相对策略优化
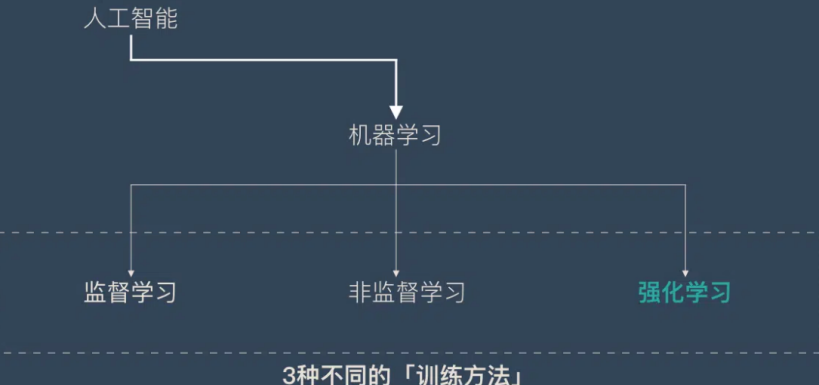
机器学习通常可以分为:监督学习、非监督学习和强化学习。
- 监督学习: 使用带标签的数据训练模型,让模型学会从输入预测输出。常见任务有分类、回归;
- 非监督学习: 使用没有标签的数据,让模型自己发现数据中的结构或模式。常见任务有聚类、降维、异常检测;
- 强化学习: 让智能体在与环境的交互中,通过奖励和惩罚来学习最优策略。常见应用有游戏AI、机器人控制、推荐系统等。
一、强化学习基础
强化学习(Reinforcement Learning, RL) 是一类机器学习方法,核心思想是通过与环境的交互、试错探索,逐步优化策略,以最大化长期累计的奖励。不同于监督学习和无监督学习,强化学习不依赖大量的标注数据,而是通过智能体(agent)与环境的互动来自行学习。
(一)强化学习的主要组成部分
- 智能体(Agent):在环境中执行动作的决策者;
- 环境(Environment):智能体交互的对象,提供反馈;
- 动作(Action):智能体可以采取的行为;
- 奖励(Reward):环境对智能体动作的反馈,帮助智能体衡量动作的好坏;
- 策略(Policy):智能体根据状态选择动作的规则,可以是显式的函数或隐式的神经网络模型。
在强化学习中,智能体在每个时间步(timestep)根据当前状态(state)采取一个动作(action),随后环境会反馈一个新的状态和相应的奖励(reward)。智能体的目标是通过优化策略,使得其在长期内获得的奖励最大化。
(二)策略函数和值函数
策略函数用于描述智能体如何选择动作,值函数用于描述这些动作的长期回报。
策略函数 π θ ( a ∣ s ) \pi_\theta(a|s) πθ(a∣s)(Policy Function):
策略函数描述了在给定状态 s s s 下,智能体选择某个动作 a a a 的概率或确定性规则。它决定了智能体的行为方式,指导智能体在不同状态下应采取的动作。
- 随机策略:如果智能体根据概率来选择动作,策略函数 π θ ( a ∣ s ) \pi_\theta(a|s) πθ(a∣s) 定义了智能体在状态 s s s下以概率 π θ ( a ∣ s ) \pi_\theta(a|s) πθ(a∣s) 选择动作 a a a 的分布;
- 确定性策略:如果智能体在每个状态下总是选择一个固定的动作,策略函数就是一个确定性的函数 a = π θ ( s ) a=\pi_\theta(s) a=πθ(s)
值函数 V π ( s ) V^\pi(s) Vπ(s)(Value Function):
值函数描述了在状态 s s s 下,按照策略 π \pi π 行动时能够获得的期望累积回报。它反映了智能体在当前状态下的"好坏",即从状态 s s s 开始,智能体期望未来能够获得的奖励总和。
V π ( s ) = E ∑ t = 0 i n f γ t R ( s t , a t ) ∣ s 0 = s , a t ∼ π V^\pi(s)=\mathbb{E}\\sum_{t=0}\^{inf} \\gamma\^t R(s_t,a_t)\|s_0=s,a_t\\sim \\pi Vπ(s)=Et=0∑infγtR(st,at)∣s0=s,at∼π
- 期望累积回报: γ \gamma γ 是折扣因子, R ( s t , a t ) R(s_t,a_t) R(st,at) 是智能体在时间步 t t t 采取动作 a t a_t at 后获得的即时奖励。值函数是这些奖励的加权和,表示从状态 s s s 开始,按照策略 π \pi π 行动后未来能够获得的总奖励的期望值。
- 状态值函数和动作值函数:
- 状态值函数 V π ( s ) V^\pi(s) Vπ(s) 描述的是在状态 s s s 下,期望未来的累积回报;
- 动作值函数 Q π ( s , a ) Q^\pi (s,a) Qπ(s,a) 描述的是状态 s s s 下,选择某个特定动作 a a a 时的期望累积回报,即:
Q π ( s , a ) = E ∑ t = 0 i n f γ t R ( s t , a t ) ∣ s 0 = s , a 0 = a , a t ∼ π Q^\pi(s,a)=\mathbb{E}\\sum_{t=0}\^{inf}\\gamma\^t R(s_t,a_t)\|s_0=s,a_0=a,a_t\\sim \\pi Qπ(s,a)=Et=0∑infγtR(st,at)∣s0=s,a0=a,at∼π
(三)奖励、价值和优势
| 概念 | 一句话 | 谁给的 |
|---|---|---|
| 奖励(Reward) | 做完一个动作,立刻拿到多少分 | 环境给 |
| 价值(Value) | 从某个状态开始,未来总共能拿多少分 | Critic 估计 |
| 优势(Advantage) | 在这个状态下,做这个动作比平均好多少 | 用价值和奖励算出来 |
- 奖励 r t r_t rt 是环境在每一步给出的即时反馈,只看眼前,不看常远。所以需要"价值"来补足长远视角;
- 价值 V ( s ) V(s) V(s) 表示从状态 s s s 开始,按照当前策略走下去,未来能拿到的总奖励的期望 。只和状态 s s s 有关,和具体动作无关;
V ( s ) = E ∑ k = 0 i n f γ k r t + k ∣ s t = s V(s)=\mathbb{E}\\sum_{k=0}\^{inf}\\gamma\^k r_{t+k}\|s_t=s V(s)=Ek=0∑infγkrt+k∣st=s - 优势 A ( s , a ) A(s,a) A(s,a) 表示在状态 s s s 下,做动作 a a a 比平均情况好多少 ,其中 Q ( s , a ) Q(s,a) Q(s,a)表示在状态 s s s 下做动作 a a a的价值, V ( s ) V(s) V(s)表示在状态 s s s 下按当前策略的平均价值。
A ( s , a ) = Q ( s , a ) − V ( s ) A(s,a)=Q(s,a)-V(s) A(s,a)=Q(s,a)−V(s)
为什么需要 Critic?
| 问题 | 说明 |
|---|---|
| 价值能由奖励算吗? | 能,但需要等回合结束,且方差极大 |
| 为什么还需要 Critic? | 因为训练时拿不到未来奖励,且蒙特卡洛方差太大 |
| Critic 做什么? | 用神经网络估计 V ( s ) V(s) V(s),提供低方差的训练信号 |
| 不用 Critic 行吗? | 行,但退化成 REINFORCE,方差大、训练慢 |
| Critic 的代价? | 显存翻倍、训练不稳定、调参麻烦 |
(四)信用分配
信用分配(Credit Assignment) 是强化学习中的一个核心难题:当智能体完成一整局游戏、拿到最终奖励时,它很难判断到底是哪一步动作真正导致了好的结果。奖励往往在回合结束时才出现,而中间可能经历了成百上千个动作,如何把这份"功劳"合理地分摊到每一个动作上,就是信用分配要解决的问题。
为什么会有信用分配问题?
- 奖励稀疏:很多任务只有到最后才给奖励,中间每一步都是 0 分,模型不知道哪一步"做对了";
- 延迟奖励:某个关键动作做完后,可能要过很久才看到回报,模型难以把"后来的好结果"和"之前的动作"联系起来;
- 因果混淆:一局游戏里动作很多,真正起作用的可能只有一两个,其余都是噪声,模型容易把功劳分给无关动作。
信用分配的粒度: 不同算法,信用分配的精细程度不同:
| 内容粒度 | 含义 | 例子 |
|---|---|---|
| 回合级别 | 整个回合共享一个信号 | REINFORCE |
| 状态-动作级别 | 每个动作有自己的信号 | Q-Learning、PPO |
| Token 级别 | 每个 token 有自己的信号 | 部分 LLM RL 方法 |
| 句子级别 | 整句话共享一个信号 | GRPO |
二、强化学习算法
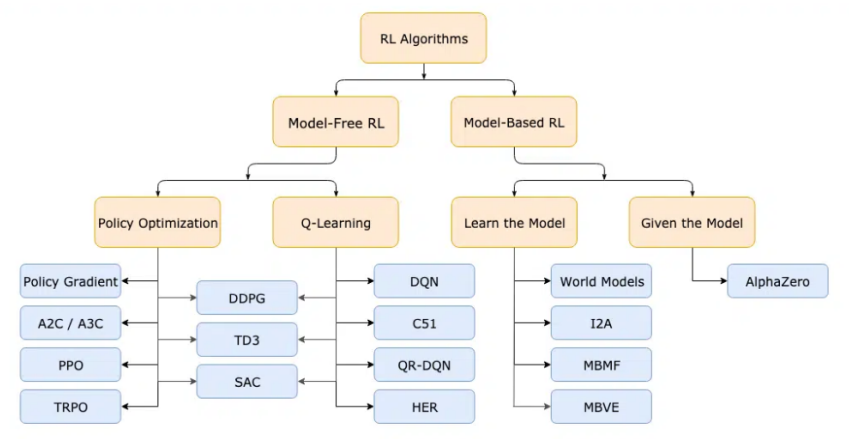
强化学习中的算法大致分为两类:
- 有模型学习(Model-Based):在交互过程中建模环境,便于规划未来的决策,但在真实环境中表现不佳时其效果也会受限。
- 免模型学习(Model-Free):不建模环境,而是通过直接优化策略或价值函数来指导决策,如常见的Q-Learning和策略梯度方法(Policy Gradient)。免模型学习实现简单且适用于实际场景,因而得到广泛应用。
(一)免模型学习
1、策略优化方法(Policy Optimization)
策略优化方法 直接优化智能体的策略 ,使其能够最大化累积回报。其核心思想是直接通过策略梯度方法更新参数,优化策略函数。
A3C(Asynchronous Advantage Actor-Critic):
A3C是一种 异步 的 Actor-Critic 算法,它将 Actor 和 Critic 结合,并使用多个异步的智能体进行并行训练来提升效率。A3C的目标是优化策略函数 π θ ( a ∣ s ) \pi_\theta(a|s) πθ(a∣s) 以及值函数 V π ( s ) V^\pi (s) Vπ(s)。
- 策略函数 π θ ( a ∣ s ) \pi_\theta(a|s) πθ(a∣s):定义了在状态 s 下选择动作 a 的概率,决定了智能体的行为;
- 值函数 V π ( s ) V^\pi (s) Vπ(s):定义了在状态 s 下,遵循策略 π \pi π 所能获得的期望累积回报,反映了状态的价值。
- 策略梯度:更新策略的梯度基于优势函数 A ( s , a ) A(s,a) A(s,a),即:
∇ θ J ( θ ) = E s ∼ d π , a ∼ π θ ∇ θ log π θ ( a ∣ s ) A ( s , a ) \nabla_\theta J(\theta)=\mathbb{E}{s \sim d^{\pi}, a \sim \pi\theta}\\nabla_\\theta \\log \\pi_\\theta(a\|s)A(s,a) ∇θJ(θ)=Es∼dπ,a∼πθ∇θlogπθ(a∣s)A(s,a)
其中 A ( s , a ) = Q ( s , a ) − V ( s ) A(s,a)=Q(s,a)-V(s) A(s,a)=Q(s,a)−V(s),用于表示当前动作相比于平均测量的好坏程度。 - 价值函数更新:值函数使用TD误差(时间差分误差)更新: δ t = R t + 1 + γ V ( s t + 1 ) − V ( s t ) \delta_t= R_{t+1}+\gamma V(s_{t+1})-V(s_t) δt=Rt+1+γV(st+1)−V(st),Actor 更新策略参数 θ \theta θ,Critic更新值函数参数 w w w 来估计 V ( s ) V(s) V(s)。
PPO(Proximal Policy Optimization): 近端策略优化
PPO 引入了一个损失函数的裁剪机制 ,限制策略更新的幅度。其关键公式:
L CLIP ( θ ) = E t min ( r t ( θ ) A t \^ , clip ( r t ( θ ) , 1 − ϵ , 1 + ϵ ) A \^ t L^{\text{CLIP}}(\theta)=\mathbb{E}_t\\min (r_t(\\theta)\\hat{A_t}, \\text{clip}(r_t(\\theta),1-\\epsilon, 1+\\epsilon)\\hat{A}_t LCLIP(θ)=Etmin(rt(θ)At\^,clip(rt(θ),1−ϵ,1+ϵ)A\^t
其中 r t ( θ ) = π θ ( a t ∣ s t ) π old ( a t ∣ s t ) r_t(\theta)=\frac{\pi_\theta(a_t|s_t)}{\pi_{\text{old}}(a_t|s_t)} rt(θ)=πold(at∣st)πθ(at∣st),是策略变化比率, A ^ t \hat{A}_t A^t 是优势函数, ϵ \epsilon ϵ 是限制变化幅度的超参数。该损失函数通过对更新幅度进行裁剪,保证了训练过程中的稳定性。
A3C 与 PPO 对比:
| 特性 | A3C | PPO |
|---|---|---|
| 核心机制 | 异步并行更新 | 同步并行 + 裁剪限制更新 |
| 更新方式 | 异步、无锁更新 | 同步、批量更新 |
| 数据利用 | 通常 on-policy,数据用后即弃 | 可对同一批数据多次更新 |
| 稳定性 | 较低(异步带来的滞后可能影响收敛) | 较高(裁剪机制保证更新稳定) |
| 训练速度 | 较快(并行效率高) | 相对较慢(同步等待) |
| 实现难度 | 中等(需处理异步通信) | 中等(逻辑清晰但超参数敏感) |
2、Q-Learning方法
Q-Learning 算法通过学习最优的动作值函数 Q ( s , a ) Q(s,a) Q(s,a) 来间接优化策略,它不直接优化策略,而是通过值函数指导动作选择 。
DQN(Deep Q-Network):
DQN 是 Q-Learning 在深度学习框架下的扩展,通过神经网络估计 Q ( s , a ) Q(s,a) Q(s,a) 函数,并引入经验回放和目标网络等技术。Q-Learning 的更新公式为:
Q ( s t , a t ) ← Q ( s t , a t ) + α ( R t + 1 + γ max a ′ Q ( s t + 1 , a ′ ) − Q ( s t , a t ) ) Q(s_t,a_t) \leftarrow Q(s_t,a_t) + \alpha(R_{t+1} + \gamma \max_{a'} Q(s_{t+1},a')-Q(s_t,a_t)) Q(st,at)←Q(st,at)+α(Rt+1+γa′maxQ(st+1,a′)−Q(st,at))
其中 α \alpha α 是学习率, γ \gamma γ 是折扣因子。DQN 用神经网络来近似 Q 值函数 Q ( s , a ; θ ) Q(s,a;\theta) Q(s,a;θ),并通过损失函数优化网络参数:
L ( θ ) = E ( s , a , r , s ′ ) ( r + γ max a ′ Q ( s ′ , a ′ ; θ − ) − Q ( s , a ; θ ) ) 2 L(\theta)=\mathbb{E}_{(s,a,r,s')}(r+\\gamma \\max_{a'} Q(s',a';\\theta\^{-})-Q(s,a;\\theta))\^2 L(θ)=E(s,a,r,s′)(r+γa′maxQ(s′,a′;θ−)−Q(s,a;θ))2
为了提升训练的稳定性,DQN 使用了目标网络 Q ( s , a ; θ − ) Q(s,a;\theta^{-}) Q(s,a;θ−)来保持Q值的平滑更新。
C51:
DQN 方法输出的是每个动作的 Q 值期望,很多时候期望值相同,风险却不相同。而 C51 将回报的分布作为学习对象,不学"Q值等于多少",而是学"Q值的分布",其核心在于 学习每个状态-动作对的回报分布,而非单一的期望值:
Z ( s , a ) = ∑ i = 1 N z i ⋅ P ( Z = z i ∣ s , a ) Z(s,a)=\sum_{i=1}^N z_i \cdot P(Z=z_i|s,a) Z(s,a)=i=1∑Nzi⋅P(Z=zi∣s,a)
其中 Z ( s , a ) Z(s,a) Z(s,a)是分布的离散化估计,C51通过改进Q-Learning来提升性能。
Rainbow:
Rainbow 则结合了多个强化学习中的增强技术,包括双 Q-Learning、优先经验回放和分布式 QLearning 等,进一步提升了 Q-Learning 的性能和稳定性。
(二)有模型学习
有模型学习通过学习环境的动态模型来进行规划,这类方法能够模拟环境的未来状态,并提前规划动作。
模型预测控制(MPC):
MPC 使用环境模型 在每一个时间步规划未来一段时间的动作序列 。核心思想是在每个时间步解决如下优化问题:
max a 0 , . . . , a H ∑ t = 0 H R ( s t , a t ) \max_{a_0,...,a_H}\sum_{t=0}^HR(s_t,a_t) a0,...,aHmaxt=0∑HR(st,at)
其中 H H H 是规划的时域长度, s t + 1 = f ( s t , a t ) s_{t+1}=f(s_t,a_t) st+1=f(st,at) 是由模型 f f f 预测的状态转移。MPC 执行优化后的第一个动作,然后重新进行规划。
MPC 不像Q-Learning 那样学一个长期策略,而是每一步都现场算一次。
Expert Iteration(专家迭代):
Expert Iteration 将规划和策略学习结合。通过如蒙特卡洛树搜索(MCTS)等规划方法生成专家动作,并使用这些动作来训练策略函数。其目标是改进当前策略:
π new ( a ∣ s ) = arg max π E s ∼ π old ∑ t = 0 inf γ t R ( s t , a t ) \pi_{\text{new}}(a|s)=\argmax_{\pi}\mathbb{E}{s\sim \pi{\text{old}}}\\sum_{t=0}\^{\\inf}\\gamma\^t R(s_t,a_t) πnew(a∣s)=πargmaxEs∼πoldt=0∑infγtR(st,at)
AlphaZero 是 Expert Iteration 的一个典型例子,它结合 MCTS 和深度强化学习,在复杂的游戏如围棋中达到了超越人类顶级玩家的水平。
三、偏好学习与DPO
(一)偏好学习基础
偏好学习的核心是:不直接告诉模型"正确答案是什么",而是告诉它"A比B好"。建模偏好的最常见方法是用 Bradley-Terry 模型:
1、偏好模型的建立
偏好学习首先需要建立一个偏好模型 P ( a ∣ s ) P(a|s) P(a∣s):
- 输入:状态 s s s 和动作 a a a
- 输出:一个偏好概率 P ( a ∣ s ) P(a|s) P(a∣s),表示在状态 s s s 下,动作 a a a 是否被用户(或专家)所偏好
偏好模型的作用类似于传统强化学习中的策略模型:
| 对比项 | 策略模型 | 偏好模型 |
|---|---|---|
| 输入 | 状态 s s s | 状态 s s s 和动作 a a a |
| 输出 | 动作概率分布 | 偏好概率 |
| 学习信号 | 奖励信号 | 用户偏好 |
偏好学习的数学形式:
P ( a ∣ s ) = softmax ( f θ ( s , a ) ) P(a|s)=\text{softmax}(f_\theta(s,a)) P(a∣s)=softmax(fθ(s,a))
- f θ ( s , a ) f_\theta(s,a) fθ(s,a)是偏好模型的打分函数,参数为 θ \theta θ
- softmax \text{softmax} softmax 确保输出为有效的概率分布
2、偏好比较
在给定一对动作 ( a i , a j ) (a_i,a_j) (ai,aj) 和状态 s s s 的情况下,模型需要判断哪个动作更被偏好。这可以通过定义一个偏好比较函数 P ( a i ≻ a j ∣ s ) P(a_i \succ a_j | s) P(ai≻aj∣s),即在状态 s s s 下,动作 a i a_i ai 相较于 a j a_j aj更被偏好的概率。该概率可以通过偏好模型计算得到:
P ( a i ≻ a j ∣ s ) = P ( a i ∣ s ) P ( a i ∣ s ) + P ( a j ∣ s ) = exp ( f θ ( s , a i ) ) exp ( f θ ( s , a i ) ) + exp ( f θ ( s , a j ) ) P(a_i \succ a_j | s) = \frac{P(a_i | s)}{P(a_i | s) + P(a_j | s)} = \frac{\exp(f_\theta(s, a_i))}{\exp(f_\theta(s, a_i)) + \exp(f_\theta(s, a_j))} P(ai≻aj∣s)=P(ai∣s)+P(aj∣s)P(ai∣s)=exp(fθ(s,ai))+exp(fθ(s,aj))exp(fθ(s,ai))
Bradley-Terry 模型:
Bradley-Terry 模型(简称 BT 模型)是用来建模"两两比较"概率的经典模型。其核心公式:
P ( A ≻ B ) = r ( A ) r ( A ) + r ( B ) P(A \succ B)=\frac{r(A)}{r(A)+r(B)} P(A≻B)=r(A)+r(B)r(A)
或者更常见的形式:
P ( A ≻ B ) = σ ( r ( A ) − r ( B ) ) P(A \succ B) = \sigma(r(A)-r(B)) P(A≻B)=σ(r(A)−r(B))
其中 r ( A ) r(A) r(A)是 A 的"实力分数", r ( B ) r(B) r(B)是 B 的"实力分数", σ \sigma σ是 sigmoid 函数。
(二)从偏好学习到 RLHF
RLHF(Reinforcement Learning from Human Feedback)分三步:
- 第一步:收集人类反馈
模型生成回答,人类标注哪个更好(属于偏好学习) - 第二步:训练奖励模型
用 Bradley-Terry 模型,让好回答得分更高(属于偏好学习) - 第三步:用强化学习微调策略
用 PPO 让策略模型生成高奖励的回答(属于强化学习)
RLHF 的问题:
| 问题 | 说明 |
|---|---|
| 流程复杂 | 要训奖励模型 + 跑 PPO |
| 不稳定 | PPO 调参难,容易崩 |
| 计算贵 | 要同时加载多个模型 |
| 奖励可能被钻空子 | 模型学会骗奖励模型,而不是真正变好 |
(三)DPO:直接偏好优化
DPO的核心思想: 利用偏好数据,通过一个数学等价变换,把原本需要"训奖励模型 + 跑强化学习"的两阶段过程,压缩成一个直接优化策略模型的监督学习损失。它不显式优化奖励函数,但隐式地实现了同样的目标。
DPO的训练过程:
- 准备偏好数据 ( x , y w , y l ) (x,y_w,y_l) (x,yw,yl):回答A(人类更喜欢,记作 y w y_w yw,winner),回答B(人类不喜欢,记作 y l y_l yl,loser)
- 加载参考模型(冻结)和策略模型(可训练):其中参考模型的作用是约束策略模型不要偏离太远,防止训练崩掉。
| 模型 | 作用 | 是否训练 |
|---|---|---|
| 策略模型 π θ \pi_\theta πθ | 正在训练的语言模型 | 是 |
| 参考模型 π r e f \pi_{ref} πref | 微调前的模型,冻结不动 | 否 |
- 对每个偏好对:
- 算策略模型对 y w y_w yw 和 y l y_l yl 的 log 概率
- 算参考模型对 y w y_w yw 和 y l y_l yl 的 log 概率
- 算 DPO 损失
- 反向传播,更新策略模型
- 重复直到收敛
DPO的偏好比较公式: DPO 判断"A 比 B 好"的概率:
P ( A ≻ B ∣ x ) = σ ( β log π θ ( y w ∣ x ) π ref ( y w ∣ x ) − log π θ ( y l ∣ x ) π ref ( y l ∣ x ) ) P(A \succ B \mid x) = \sigma \left( \beta \left \\log \\frac{\\pi_\\theta(y_w\|x)}{\\pi_{\\text{ref}}(y_w\|x)} - \\log \\frac{\\pi_\\theta(y_l\|x)}{\\pi_{\\text{ref}}(y_l\|x)} \\right \right) P(A≻B∣x)=σ(βlogπref(yw∣x)πθ(yw∣x)−logπref(yl∣x)πθ(yl∣x))
DPO的损失函数: DPO 使用基于二元交叉熵的损失函数来训练偏好模型。该损失函数旨在最小化模型预测偏好与实际用户(或专家)偏好之间的差异。
L DPO = − log σ ( β log π θ ( y w ∣ x ) π ref ( y w ∣ x ) − log π θ ( y l ∣ x ) π ref ( y l ∣ x ) ) \mathcal{L}_{\text{DPO}} = -\log \sigma \left( \beta \left \\log \\frac{\\pi_\\theta(y_w\|x)}{\\pi_{\\text{ref}}(y_w\|x)} - \\log \\frac{\\pi_\\theta(y_l\|x)}{\\pi_{\\text{ref}}(y_l\|x)} \\right \right) LDPO=−logσ(βlogπref(yw∣x)πθ(yw∣x)−logπref(yl∣x)πθ(yl∣x))
- 如果策略模型对好回答的相对概率 > 对差回答的相对概率,损失小;如果反过来,损失大
- 训练目标:让损失最小化
四、PPO:近端策略优化
PPO(Proximal Policy Optimization,近端策略优化)是一种常用的强化学习算法,属于策略优化方法。其核心思想是通过 限制策略更新的幅度 来提升训练的稳定性,避免策略在每次更新中发生较大变化,从而防止训练过程中的不稳定和策略崩溃。
(一)PPO的核心思想
传统的策略优化目标是直接优化策略 π θ ( a ∣ s ) \pi_\theta(a|s) πθ(a∣s),使得给定状态下的行为能够最大化累计奖励。PPO在此基础上,通过引入一个 重要的比例项"probability ratio" r t ( θ ) r_t(\theta) rt(θ) 来度量新旧策略之间的差异:
r t ( θ ) = π θ ( a t ∣ s t ) π θ old ( a t ∣ s t ) r_t(\theta)=\frac{\pi_\theta(a_t|s_t)}{\pi_{\theta_{\text{old}}}(a_t|s_t)} rt(θ)=πθold(at∣st)πθ(at∣st)
该比率表示在同一状态-行为对 ( s t , a t ) (s_t,a_t) (st,at)下,新旧策略选择该行为的概率之比。如果这个比率偏离1过多,说明更新后的策略与原始策略差异较大,可能会导致训练不稳定。
(二)PPO的损失函数
PPO的损失函数是基于策略比率 r t ( θ ) r_t(\theta) rt(θ) 进行定义的,它有两种主要形式:剪辑形式和KL散度形式。(实践中绝大多数 PPO 实现用的是裁剪形式,KL 形式更多是作为对比或早期方案。)
剪辑损失函数:
PPO的最经典形式是剪辑损失函数,它通过对策略更新的比率进行剪辑来避免策略大幅度更新。
L CLIP ( θ ) = E t min ( r t ( θ ) A \^ t , clip ( r t ( θ ) , 1 − ϵ , 1 + ϵ ) A \^ t ) L^{\text{CLIP}}(\theta)=\mathbb{E}_t\\min(r_t(\\theta)\\hat{A}_t,\\text{clip}(r_t(\\theta),1-\\epsilon,1+\\epsilon)\\hat{A}_t) LCLIP(θ)=Etmin(rt(θ)A\^t,clip(rt(θ),1−ϵ,1+ϵ)A\^t)
- r t ( θ ) r_t(\theta) rt(θ):新旧策略的概率比
- A ^ t \hat{A}_t A^t:优势函数,表示在时间步 t 的策略相对于基准测量的好坏,通常为优势估计 A t = Q ( s t , a t ) − V ( s t ) A_t=Q(s_t,a_t)-V(s_t) At=Q(st,at)−V(st)
- ϵ \epsilon ϵ:剪辑系数,用于限制策略更新幅度。
基于KL散度的PPO:
KL散度用于度量新旧策略分布的差异,通常定义为:
D K L π θ old ∥ π θ = E t log π θ old ( a t ∣ s t ) − log π θ ( a t ∣ s t ) D_{KL}\\pi_{\\theta_{\\text{old}}} \\\| \\pi_\\theta = \mathbb{E}_t \\log \\pi_{\\theta_{\\text{old}}}(a_t\|s_t) - \\log \\pi_\\theta(a_t\|s_t) DKLπθold∥πθ=Etlogπθold(at∣st)−logπθ(at∣st)
基于KL散度的PPO不裁剪概率比,而是在损失里加一个 KL 惩罚项:
L K L ( θ ) = E t r t ( θ ) A \^ t − β D K L \[ π θ old ∥ π θ ] L^{KL}(\theta) = \mathbb{E}_t \left r_t(\\theta) \\hat{A}_t - \\beta D_{KL} \[\\pi_{\\theta_{\\text{old}}} \\\| \\pi_\\theta \right] LKL(θ)=Etrt(θ)A\^t−βDKL\[πθold∥πθ]
如果新旧策略差太多,KL 散度大,惩罚大;如果新旧策略差不多,KL 散度小,惩罚小。通过调节 β \beta β,间接限制更新幅度。
(三)优势函数的估计
通常,优势函数被定义为当前策略相对于基准策略的相对表现:
A ( s t , a t ) = Q ( s t , a t ) − V ( s t ) A(s_t,a_t)=Q(s_t,a_t)-V(s_t) A(st,at)=Q(st,at)−V(st)
其中:
- Q ( s t , a t ) Q(s_t,a_t) Q(st,at) 是给定状态和行为下的动作值函数,表示采取动作 a t a_t at 的预期回报;
- V ( s t ) V(s_t) V(st)是状态值函数,表示在状态 s t s_t st 下的预期回报。
PPO算法中, A t A_t At通常通过广义优势估计(GAE, Generalized Advantage Estimation)方法来进行估计,GAE通过加权累积时间差分误差来平衡偏差和方差:
A ^ t = ∑ l = 0 i n f ( γ λ ) l δ t + l \hat{A}t=\sum{l=0}^{inf}(\gamma \lambda)^l \delta_{t+l} A^t=l=0∑inf(γλ)lδt+l
其中, γ \gamma γ是折扣因子, λ \lambda λ是衰减因子, δ t = r t + γ V ( s t + 1 ) − V ( s t ) \delta_t=r_t+\gamma V(s_{t+1})-V(s_t) δt=rt+γV(st+1)−V(st)是时间差分误差,衡量"实际拿到的奖励 + 下一状态的价值估计"和"当前状态的价值估计"差多少。这个 δ t \delta_t δt必须用Critic模型的输出 V ϕ ( s ) V_\phi(s) Vϕ(s)才能算出来。
五、GRPO:群体相对策略优化
GRPO(Group Relative Policy Optimization,群体相对策略优化)是 DeepSeek 团队提出的一种强化学习算法,核心思想是 去掉 PPO 中昂贵的 Critic 网络,改用"组内相对比较"来估算优势。
GRPO 对同一个问题,让模型生成一组(Group)回答,然后用组内奖励的均值和标准差来标准化每个回答的优势:
A ^ i , t = r i − mean ( r ) std ( r ) + ϵ \hat{A}_{i,t}=\frac{r_i-\text{mean}(r)}{\text{std}(r)+\epsilon} A^i,t=std(r)+ϵri−mean(r)
其中 r i r_i ri 是第 i i i 个回答的奖励, r r r是组内所有回答的奖励集合。高于组内平均的回答获得正优势,低于平均的获得负优势。
PPO 与 GRPO 对比:
| 对比维度 | PPO | GRPO |
|---|---|---|
| Critic 网络 | 需要,与策略模型同规模 | 不需要 |
| 优势估计方式 | GAE(需要 Critic 估算状态价值) | 组内相对标准化 |
| 显存占用 | 高(4 个模型:Actor+Critic+Ref+RM) | 低(减少约一半) |
| 信用分配 | Token 级别,能定位"哪一步做得好" | 句子/序列级别,整条回答共享同一个优势 |
| KL 散度处理 | 加入奖励函数中 | 直接加入损失函数 |