【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
26、【数学】【信息论】KL 弃峰怎么救:α-散度、退火、JS 与 Wasserstein
背景
上篇 blog
【数学】【信息论】反向 KL 为什么可以弃峰:zero-forcing 与 mode dropping
解释了反向 KL 为什么允许弃峰: K L ( Q ∥ P ) = ∑ x Q ( x ) log Q ( x ) P ( x ) \mathrm{KL}(Q\|P)=\sum_x Q(x)\log\frac{Q(x)}{P(x)} KL(Q∥P)=∑xQ(x)logP(x)Q(x) 的每一项按 Q Q Q 加权,被弃的峰上 Q ≈ 0 Q\approx0 Q≈0、整项 → 0 \to0 →0,于是"漏盖不罚、只有多盖才罚",这叫 zero-forcing 。放弃一个等权、充分分离的峰,代价只有 ln 2 \ln2 ln2;严格的判据是反向 KL 有限只要求 Q ≪ P Q\ll P Q≪P( Q Q Q 有质量处 P P P 必须非零),并不要求 P ≪ Q P\ll Q P≪Q。因此反向的 KL 地形天然"每峰一盆",初始化落在哪就丢哪个峰,现实里对应变分推断的 posterior collapse(后验坍缩)。
弃峰这个毛病既然难以避免,本篇来看怎么救 。总共有两条路子:改目标 (换散度、改温度)或改容量 (让 Q Q Q 更有表达力)。下面逐个说明,最后用一张表对号入座。
问题的两面:弃峰与摊平
先把病灶说全。前向与反向各有一个"盲区":
| 方 向 | 只罚什么 | 放任什么 | 典型症状 |
|---|---|---|---|
| 前向 K L ( P ∣ Q ) \mathrm{KL}(P|Q) KL(P∣Q) | 漏盖 | 多盖 | 摊平、把质量灌进低概率区 |
| 反向 K L ( Q ∣ P ) \mathrm{KL}(Q|P) KL(Q∣P) | 多盖 | 漏盖 | 弃峰、丢模式、后验坍缩 |
一个只惩罚"覆盖不足",一个只惩罚"覆盖过度"。任何单一方向都天然偏向一侧 ,所以补救的核心,要么是给缺失的那一半惩罚补上(换散度),要么是让优化目标不再在两端二选一(插值),要么是把 Q Q Q 做得足够强、不再需要二选一。
两种症状都可以具体看到:双峰 P P P 用单峰大高斯去拟合,前向解会把分布摊得又宽又平、把大量质量灌进两峰之间的谷底(over-cover);反向解则直接放弃一个峰(under-cover)。一个"和稀泥"、一个"钻牛角尖",正是下面的方法要分别对症的。
思路一:换散度------α 家族与 JS
最直接的办法是组合两个方向 。定义一个带参数 α ∈ 0 , 1 \alpha\in0,1 α∈0,1 的散度:
D α ( P ∥ Q ) = ( 1 − α ) K L ( P ∥ Q ) + α K L ( Q ∥ P ) D_\alpha(P\|Q)=(1-\alpha)\,\mathrm{KL}(P\|Q)+\alpha\,\mathrm{KL}(Q\|P) Dα(P∥Q)=(1−α)KL(P∥Q)+αKL(Q∥P)
α = 0 \alpha=0 α=0 就是前向(mass-covering)、 α = 1 \alpha=1 α=1 就是反向(mode-seeking)、 α = 0.5 \alpha=0.5 α=0.5 恰好对称。调 α \alpha α 就能在"覆盖"与"精准"之间连续滑动------这比在两端硬选要灵活得多。
更经典的参数化是 Rényi 散度:
D α ( P ∥ Q ) = 1 α − 1 log ∑ x P ( x ) α Q ( x ) 1 − α D_\alpha(P\|Q)=\frac{1}{\alpha-1}\log\sum_x P(x)^{\alpha}Q(x)^{1-\alpha} Dα(P∥Q)=α−11logx∑P(x)αQ(x)1−α
它在 α → 1 \alpha\to1 α→1 时回到前向 K L ( P ∥ Q ) \mathrm{KL}(P\|Q) KL(P∥Q),而 α = 1 2 \alpha=\frac12 α=21 是一个对称成员(与 Hellinger 距离单调对应)。连同 α-散度(Amari) ,这些" α \alpha α 族"提供的都是同一个旋钮:往哪边拧,就在覆盖与精准之间偏一点。
另一条常见路线是对称化 :JS 散度(Jensen-Shannon divergence) 。
J S ( P , Q ) = 1 2 K L ( P ∥ M ) + 1 2 K L ( Q ∥ M ) , M = 1 2 ( P + Q ) \mathrm{JS}(P,Q)=\tfrac12\,\mathrm{KL}(P\|M)+\tfrac12\,\mathrm{KL}(Q\|M),\qquad M=\tfrac12(P+Q) JS(P,Q)=21KL(P∥M)+21KL(Q∥M),M=21(P+Q)
它对称、恒非负、且有上界 ln 2 \ln2 ln2。有界这一点在支撑不重叠时特别重要:
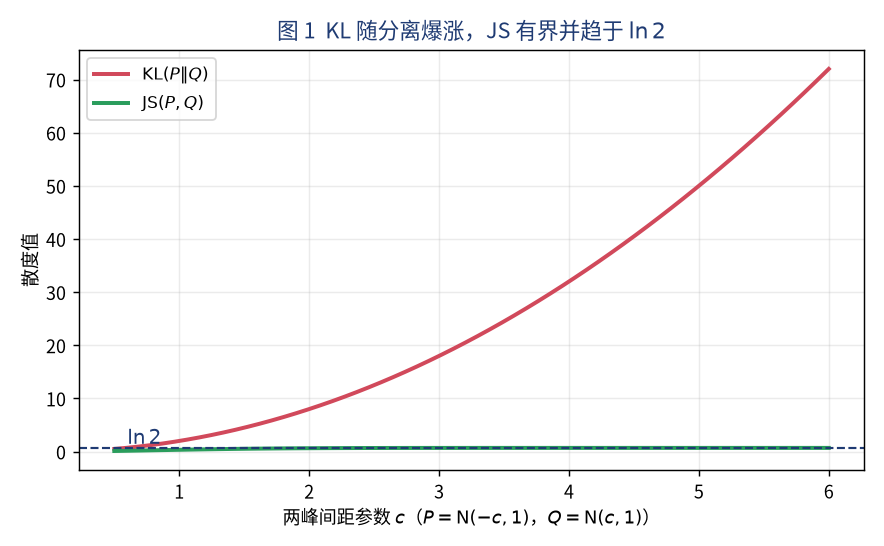
图 1 里 P = N ( − c , 1 ) P=\mathcal N(-c,1) P=N(−c,1)、 Q = N ( c , 1 ) Q=\mathcal N(c,1) Q=N(c,1),两峰随 c c c 增大越离越远: K L ( P ∥ Q ) \mathrm{KL}(P\|Q) KL(P∥Q) 像 2 c 2 2c^2 2c2 一样爆涨 ,而 J S \mathrm{JS} JS 稳稳地逼近并停在 ln 2 \ln2 ln2。所以当两个分布"完全错开"时,JS 不会像 KL 那样给出天文数字、导致优化不稳;它用一个温和的有界值表达"这两者不重叠"。
思路二:温度与退火
第二个思路不换散度,而是改目标分布 ------把 P P P 调"热"一点,减小弃峰的动机。所谓退火(tempering / annealing),就是不再直接拟合 P P P,而是拟合
P β ( x ) = P ( x ) β Z β , 0 < β ≤ 1 , Z β = ∫ P ( x ) β d x P_\beta(x)=\frac{P(x)^\beta}{Z_\beta},\qquad 0<\beta\le1,\quad Z_\beta=\int P(x)^\beta\,dx Pβ(x)=ZβP(x)β,0<β≤1,Zβ=∫P(x)βdx
β = 1 \beta=1 β=1 是原来的 P P P; β < 1 \beta<1 β<1 会把分布"摊平":
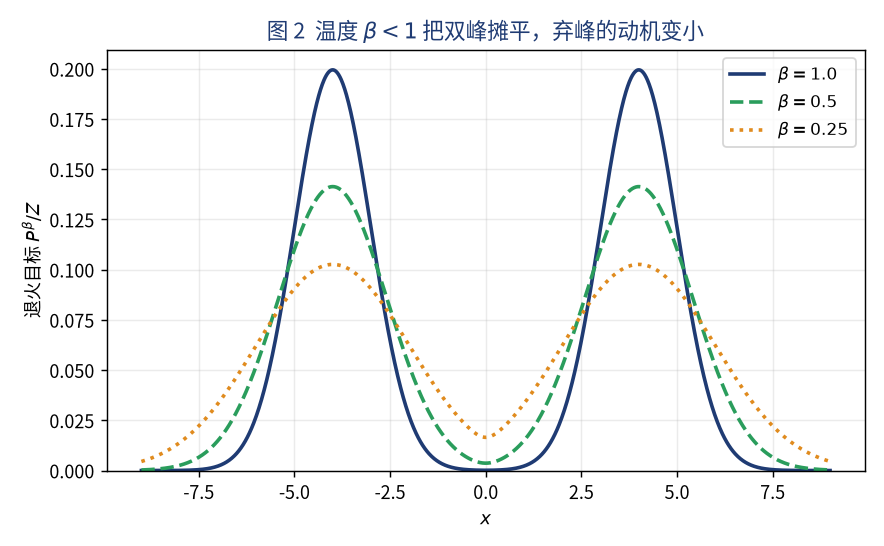
图 2 把一个双峰 P P P 分别取 β = 1 , 0.5 , 0.25 \beta=1,\ 0.5,\ 0.25 β=1, 0.5, 0.25: β \beta β 越小,两峰之间的谷底抬得越高、分布越平。谷底不再那么"空",反向 KL 摊平的代价随之下降,弃峰的动机就变小了 。实践里常配合一个"从大到小"的日程:先高温( β \beta β 小、容易覆盖全局),再逐步降温收敛到真实目标。
这套思想在工程里有几个变体:KL 退火 (训练初期把 KL 项权重调小、逐步加上去)、β-VAE (给 KL 项一个可调的系数 β \beta β)、free-bits(给每个隐变量维度的 KL 设一个下限,不许它塌到零)------目的都是防止后验坍缩,本质都是在温度/权重上做文章。
一个典型的日程是让温度参数 β \beta β 从很小的值(比如 0.1 0.1 0.1)线性升到 1 1 1:早期目标很平、 Q Q Q 容易把所有峰都纳入视野,晚期逐渐收紧到真实 P P P、把形状磨准。先求不漏、再求不糙,是这类退火策略的通用节奏。
思路三:几何感知------Wasserstein
KL 和 JS 都只看"密度值差多少",不看"两个峰隔多远"。一个把质量从 x = − 4 x=-4 x=−4 搬到 x = 4 x=4 x=4 的代价,和搬到 x = − 3.9 x=-3.9 x=−3.9 的代价,在 KL 眼里差别仅体现在密度重叠上,缺乏几何直觉。Wasserstein 距离(最优传输距离) 换了个角度:它衡量"把一堆质量搬到另一堆,最少要花多少运费"。
一维情形有个极简的闭式:设 F P , F Q F_P,F_Q FP,FQ 是两个分布的累积分布函数,则
W 1 ( P , Q ) = ∫ − ∞ ∞ ∣ F P ( x ) − F Q ( x ) ∣ d x W_1(P,Q)=\int_{-\infty}^{\infty}\big|F_P(x)-F_Q(x)\big|\,dx W1(P,Q)=∫−∞∞ FP(x)−FQ(x) dx
它有真正的几何含义,即使两个分布支撑完全不重叠也给出有限、有意义的数值,而且随"平均搬多远"平滑变化。这正是它在生成模型里受欢迎的原因------不会像 KL 那样在支撑错开时直接发散,也不会像 JS 那样饱和。
对一元高斯还有干净的闭式: W 2 2 ( N ( μ 1 , σ 1 2 ) , N ( μ 2 , σ 2 2 ) ) = ( μ 1 − μ 2 ) 2 + ( σ 1 − σ 2 ) 2 W_2^2\big(\mathcal N(\mu_1,\sigma_1^2),\mathcal N(\mu_2,\sigma_2^2)\big)=(\mu_1-\mu_2)^2+(\sigma_1-\sigma_2)^2 W22(N(μ1,σ12),N(μ2,σ22))=(μ1−μ2)2+(σ1−σ2)2。它把"均值差多少、宽度差多少"直接翻译成距离,不依赖两者是否重叠------这正是 KL 做不到的。
思路四:增强 Q 的表达力
前面三条都在改目标 。最后一条改模型 :如果 Q Q Q 有足够表达力、能同时盖住多个峰,那"弃峰还是摊平"这个两难就消失了。做法包括:
- 把单高斯换成高斯混合(Gaussian Mixture) ,每个峰交给一个分量;
- 用 Normalizing Flow(归一化流) 把简单分布逐步变换成复杂分布;
- 用混合密度网络(Mixture Density Network) 让网络直接输出多个分量。
这些办法不改变损失函数,只让 Q Q Q 有能力把每个峰都盖住、同时不在谷底乱放质量。代价是参数变多、训练更难,而且并不能消除优化本身的多解------初始化不好仍可能只激活一部分分量。
不同目标,拟合出不同的 Q
把上面几种目标放在一起,看同一个双峰 P P P 下"单峰 Q Q Q 会落在哪",差别立刻显现:
| 目 标 | 最优单峰 Q Q Q 的落点 | 性 格 |
|---|---|---|
| 前向 K L ( P ∣ Q ) \mathrm{KL}(P|Q) KL(P∣Q) | 居中,覆盖两峰(矩匹配) | 覆盖 |
| 反向 K L ( Q ∣ P ) \mathrm{KL}(Q|P) KL(Q∣P) | 锁定其中一个峰 | 弃峰 |
| JS | 居中、较宽容 | 折中 |
| Wasserstein | 居中,按几何距离权衡 | 折中 |
JS 与 Wasserstein 之所以"居中",是因为它们同时照顾了两个方向:既不放过"漏盖",也不放任"多盖"。这张表也解释了为什么换散度能治弃峰------它把反向缺的那一半惩罚补了回来。
对号入座
把散落在上面的方法整理成一张图,按"改什么"归类:
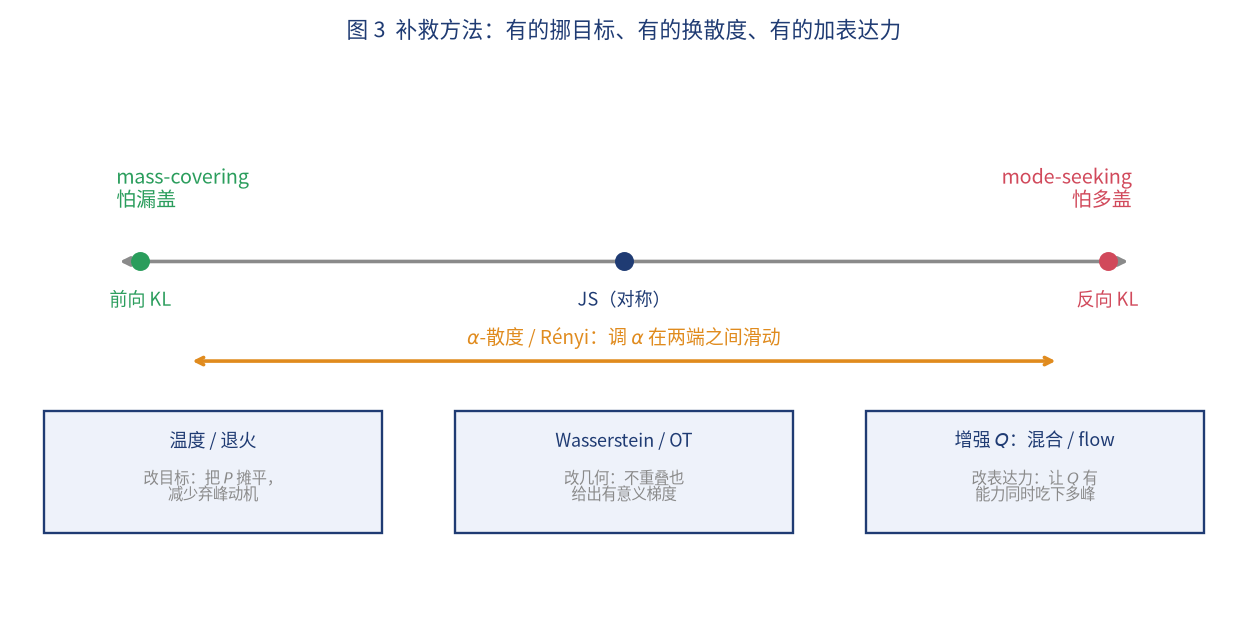
图 3 上面一条轴是"覆盖 ↔ 精准"的谱:前向 KL 在最左、反向 KL 在最右、JS 取中,α-散度是可以滑动的旋钮。下面三格是从另外角度切入的招数:温度/退火改目标 、Wasserstein/OT 改几何 、增强 Q Q Q 改容量。再配一张表:
| 方 法 | 改什么 | 对 症 | 代 价 |
|---|---|---|---|
| α-散度 / 凸组合 | 目标:混合前向反向 | 弃峰↔摊平可调 | 需选 α \alpha α |
| JS | 目标:对称有界 | 支撑不重叠 | 相距远时梯度饱和 |
| Wasserstein | 目标:几何距离 | 不重叠也有梯度 | 计算与理论更重 |
| 温度 / 退火 | 目标:摊平 P P P | 减少弃峰动机 | 需设计日程 |
| 增强 Q Q Q | 容量:多峰拟合 | 让 Q Q Q 吃下多峰 | 参数/训练成本高 |
三个常见疑问
- "JS 和 Wasserstein 是不是就没有缺点了?" :各有代价。JS 有界,所以两个分布离得极远时梯度会饱和 到接近零,生成模型里反而学不动------这正是 WGAN 后来改用 Wasserstein 的动机;而 Wasserstein 计算更贵、高维下要近似求解最优传输。没有一种散度对所有场景都占优。
- "next-token 训练为什么还用前向交叉熵?" :因为手里有真实样本、目标是让模型分布覆盖数据分布,前向 KL 对"漏盖"的重罚恰好合适;而且第 23、25 篇反复提到,one-hot 标签下反向方向会因 log 0 \log0 log0 发散。所以语言模型用前向,不是随手选的。
- "那 α \alpha α 到底取多少?" :没有普适最优。它取决于任务更怕"漏盖"还是更怕"多盖":要覆盖全部模式就往 α = 0 \alpha=0 α=0 偏,要精准干净就往 α = 1 \alpha=1 α=1 偏。实践中常以样本质量、模式覆盖率等指标经验地调。
一句话记忆
弃峰要么靠"改目标"(α-散度、JS、Wasserstein、温度退火),要么靠"加容量"(混合、flow)。散度换不来免费午餐,只换来"覆盖↔精准"这根轴的重新摆放。
小结
KL 弃峰的根源是反向 KL 的 zero-forcing------只惩罚"多盖"、放任"漏盖"。补救有两条主路:改目标 (α-散度在两端插值、JS 对称有界、Wasserstein 引入几何、温度/退火摊平 P P P),或改容量 (用高斯混合、flow 等增强 Q Q Q,让它能同时覆盖多个峰)。它们分别对症不同的失衡,也各有代价:JS 会饱和、Wasserstein 更重、退火要调日程、增强 Q Q Q 要更多参数。没有万能散度,只有在"覆盖"与"精准"之间按任务做的取舍。 至此,从信息量、熵、交叉熵到 KL 的方向与补救,整条信息论链条走完。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!