本篇是专栏首篇,先把"服务化"四个字拆成字节、账本和时延三样可测的东西。用 Python 手写 SOME/IP 编解码器 :一个真实的扭矩请求被序列化为 20 字节
12 34 01 01 00 00 00 10 A0 01 00 01 01 01 00 00 14 6E 07 5A,回环解析校验通过;再把同样 64B 应用数据 推上四条通道算总线账:CAN 500k = 8帧 / 127.65B / 2.042ms 、CAN FD 2M = 1帧 / 82.23B / 0.432ms 、SOME/IP-UDP = 142B / 0.0114ms 、SOME/IP-TCP = 162B / 0.0130ms ------出现一个反直觉结果:UDP 的字节效率只有 45.1%,低于 CAN FD 的 77.8% (以太网固定开销 78B),但传输时间低 38 倍 ,选型只看一个口径必然选错。最后对 SOME/IP-SD 做 20000 次蒙特卡洛:仅周期 Offer(5s)的服务发现均值 2.499s、p95 4.752s;重启后初始 burst 连发3次(间隔20ms)均值 30ms、p95 57ms,加速 83.4 倍 ------上电与重启恢复的时延大头不在网络,在你有没有配那 3 个报文。结论:通道选型 = 载荷 × 时延 × 可靠性 三张表,发现时延 = 周期 × 是否 burst,先算账,再写代码。
1. 首篇为什么先算账
信号时代的问题是"这个报文几毫秒到";服务时代的问题是"这个服务在哪、谁提供、挂了谁顶"。但服务化不是把 CAN 矩阵换成 ID/方法就完事------底下跑的还是字节,字节还是要占总线、还是要排队、还是要被人发现。
本专栏的路线图(每篇都带可复现实验):
| 篇 | 主题 | 核心产出 |
|---|---|---|
| 01(本篇) | 报文字节级解析 + 四通道开销账 + 发现时延 | 编解码器、开销表、SD蒙特卡洛 |
| 02 | SOME/IP-SD 状态机与事件订阅 | Offer/StopOffer、TTL、Eventgroup重传 |
| 03 | 事件通知与丢包语义 | 序列号回绕、最后值缓冲、更新速率控制 |
| 04 | SOME/IP-TP 分片与大数据传输 | >1412B 的分片账与重组超时 |
| 05 | UDP 还是 TCP:连接管理与超时体系 | 半开连接、心跳、会话恢复 |
| 06 | 服务矩阵从 Excel 到 ARXML/SD 文件 | 工具链打通与代码生成 |
| 07 | Wireshark 抓包调试实战 | 解码器配置、10类典型故障包 |
| 08 | 量产问题集:丢包/风暴/上电时延 | 真实故障复盘与门禁值 |
2. SOME/IP 报文解剖:16 字节头的字节级解析
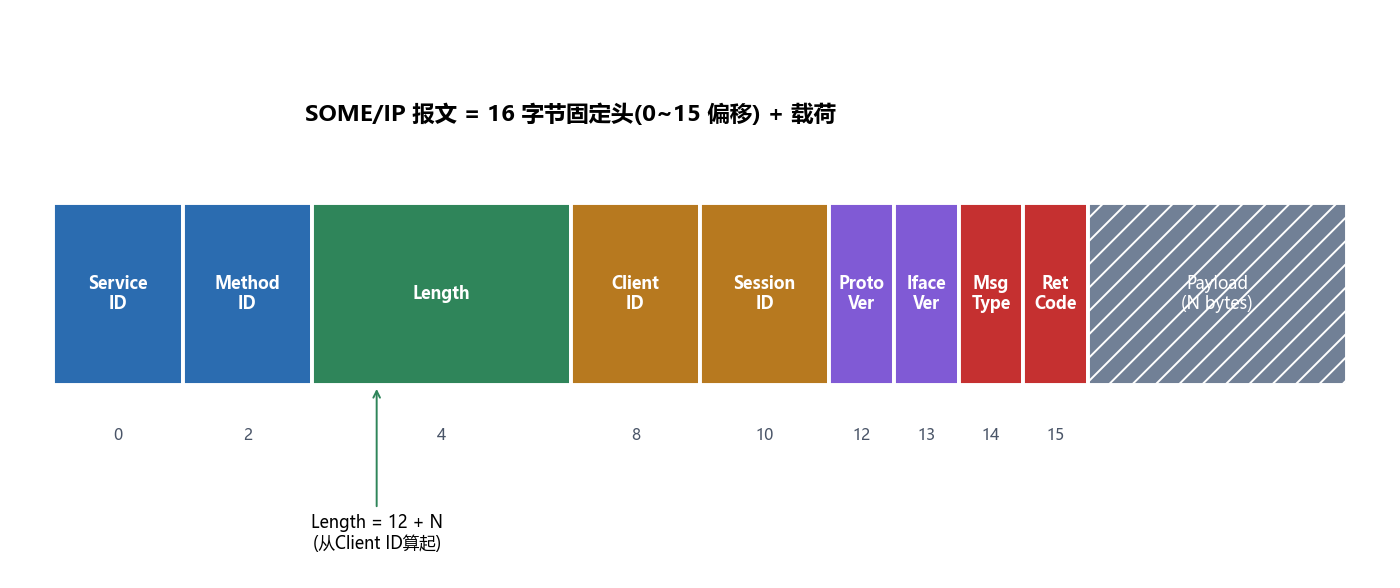
先记住一句话:SOME/IP 报文 = 16 字节固定头 + N 字节载荷,任何一篇讲 SOME/IP 的文章都该能让你对着这张图说出每个字节的含义。
表1 头字段逐字节对照(本篇实验的真实值)
| 字段 | 偏移 | 字节数 | 本篇REQUEST值 | 含义 |
|---|---|---|---|---|
| Service ID | 0 | 2 | 0x1234 |
服务标识,由服务矩阵统一分配 |
| Method ID | 2 | 2 | 0x0101 |
方法标识(最高位置1则为事件ID) |
| Length | 4 | 4 | 0x00000010 = 16 |
其后全部字节数 = 12 + 载荷长 |
| Client ID | 8 | 2 | 0xA001 |
客户端标识,响应时回填 |
| Session ID | 10 | 2 | 0x0001 |
会话号,同一次请求-响应配对 |
| Protocol Version | 12 | 1 | 0x01 |
固定 1(本版本) |
| Interface Version | 13 | 1 | 0x01 |
接口版本,版本协商依据 |
| Message Type | 14 | 1 | 0x00 = REQUEST |
报文类型,见表2 |
| Return Code | 15 | 1 | 0x00 = E_OK |
返回码,见表3 |
| Payload | 16 | N | 4B | 服务自定义序列化数据 |
最容易写错的三个字节级坑,本篇代码里全部踩过并修复:
- Length 不含自身 :它统计的是从 Client ID 开始到报文尾的字节数,即
12 + N。本篇载荷 4 字节 → Length = 16(00 00 00 10)。把它写成16 + N是集成阶段最常见的解析错位原因。 - 响应方向 Client/Server 对调 :服务端回包时 Client ID 仍是请求方的
0xA001,但会话号必须沿用请求的,否则客户端的匹配表查不到,只能靠超时兜底。 - Method ID 与 Event ID 共用一个空间:最高位是事件标志,分配表必须统一管,否则"方法"和"事件"会在同一个 ID 上撞车。
真实的字节流(实验 A 输出,hexdump 格式):
plaintext
REQUEST  (20B):
0000  12 34 01 01 00 00 00 10 A0 01 00 01 01 01 00 00
0010  14 6E 07 5A

RESPONSE (19B):
0000  12 34 01 01 00 00 00 0F 01 A0 00 01 01 01 80 00
0010  14 6E 07
载荷 14 6E = 十进制 5230,若信号 LSB 定义为 0.01%,语义值就是 52.30% 扭矩请求 ;07 是计数器,5A 是校验字节。响应的 Length = 0x0000000F = 15 = 12 + 3,Message Type 翻成 0x80(RESPONSE)。编解码器回环校验:解出的 Service/RC/扭矩值与发送端完全一致(roundtrip = True)。
3. 请求-响应与返回码:语义层的契约
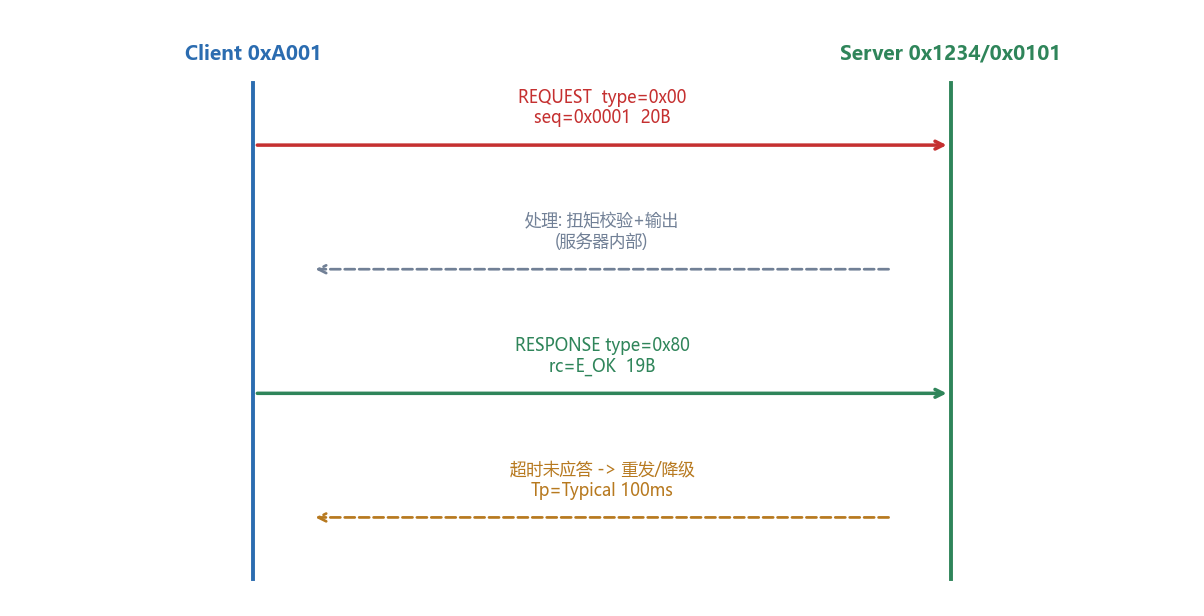
表2 Message Type 取值(工程常用子集)
| 值 | 名称 | 语义 | 典型用途 |
|---|---|---|---|
| 0x00 | REQUEST | 请求,期望响应 | RPC 调用、参数读写 |
| 0x01 | REQUEST_NO_RETURN | 请求,不期望响应 | 广播型写操作 |
| 0x02 | NOTIFICATION | 事件通知 | 信号订阅推送 |
| 0x80 | RESPONSE | 成功响应 | 与 REQUEST 配对 |
| 0x81 | ERROR | 错误响应 | 携带非零 Return Code |
| 0x20/0xA0 | TP_REQUEST/TP_RESPONSE | 分片传输 | 载荷超过 MTU 时 |
表3 Return Code 节选(故障定位的第一现场)
| 值 | 名称 | 你在排查什么 |
|---|---|---|
| 0x00 | E_OK | 正常 |
| 0x01 | E_NOT_OK | 服务内部拒绝,查业务日志 |
| 0x02/0x03 | E_UNKNOWN_SERVICE/METHOD | ID 分配表两侧不一致 |
| 0x04 | E_NOT_READY | 服务还没初始化完,查启动时序 |
| 0x05/0x06 | E_NOT_REACHABLE/TIMEOUT | 对端没起来或没订阅 |
| 0x09 | E_MALFORMED_MESSAGE | Length/序列化与矩阵不符 |
经验:量产问题里 80% 的 SOME/IP 故障会先体现在这三类返回码上------ID 不一致、启动时序、格式不符。把 Return Code 原样透传到诊断/日志,比事后抓包省一半时间。
4. 开销账:同样 64B 数据走四条通道
这是本篇的核心实验。同一份 64B 应用数据(比如一帧融合后的传感器块),分别走 CAN、CAN FD、SOME/IP-UDP、SOME/IP-TCP,算线上真实占用的字节数(含帧头、协议头、前导码、帧间隙与填充位)。
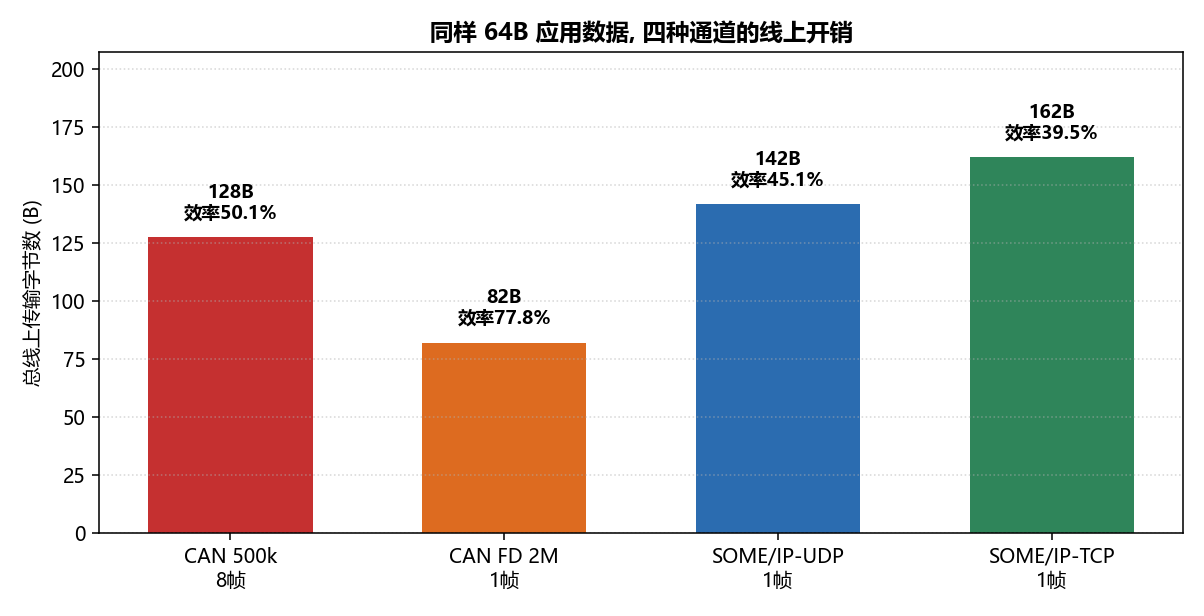
表4 64B 载荷的四通道开销(实验 B 实测)
| 通道 | 帧数 | 线上字节 | 字节效率 | 传输时间 |
|---|---|---|---|---|
| CAN 500k | 8 | 127.65 B | 50.1% | 2.042 ms |
| CAN FD 2M/500k | 1 | 82.23 B | 77.8% | 0.432 ms |
| SOME/IP-UDP | 1 | 142 B | 45.1% | 0.0114 ms |
| SOME/IP-TCP | 1 | 162 B | 39.5% | 0.0130 ms |
表5 全载荷谱系(8B~1024B,节选)
| 载荷 | CAN 线上B / 帧 / 时间ms | CAN FD 线上B / 时间ms | UDP 线上B / 效率 / 时间ms | TCP 线上B / 时间ms |
|---|---|---|---|---|
| 8B | 15.96 / 1 / 0.255 | 17.25 / 0.166 | 86 / 9.3% / 0.0069 | 106 / 0.0085 |
| 32B | 63.82 / 4 / 1.021 | 45.43 / 0.285 | 110 / 29.1% / 0.0088 | 130 / 0.0104 |
| 64B | 127.65 / 8 / 2.042 | 82.23 / 0.432 | 142 / 45.1% / 0.0114 | 162 / 0.0130 |
| 128B | 255.30 / 16 / 4.085 | 164.45(2帧) / 0.865 | 206 / 62.1% / 0.0165 | 226 / 0.0181 |
| 256B | 510.60 / 32 / 8.170 | 328.90(4帧) / 1.730 | 334 / 76.6% / 0.0267 | 354 / 0.0283 |
| 512B | 1021.20 / 64 / 16.339 | 657.80(8帧) / 3.459 | 590 / 86.8% / 0.0472 | 610 / 0.0488 |
| 1024B | 2042.40 / 128 / 32.678 | 1315.60(16帧) / 6.918 | 1102 / 92.9% / 0.0882 | 1122 / 0.0898 |
计算口径(写进可复现性附录):经典 CAN 单帧固定开销 47 位 + 8n 数据位,填充位按 1.15 系数估算;CAN FD 头 22 位 + 尾 34/38 位(CRC17/21),BRS 时头尾跑 500k、数据段跑 2M;以太网通道固定开销 = 前导 8 + IFG 12 + ETH 14 + IP 20 + UDP 8 + SOME/IP 16 = 78B(TCP 再 +20B),链路按 100BASE-T1 的 100Mbit/s。
5. 时延账:"字节效率"和"时延"是两个口径
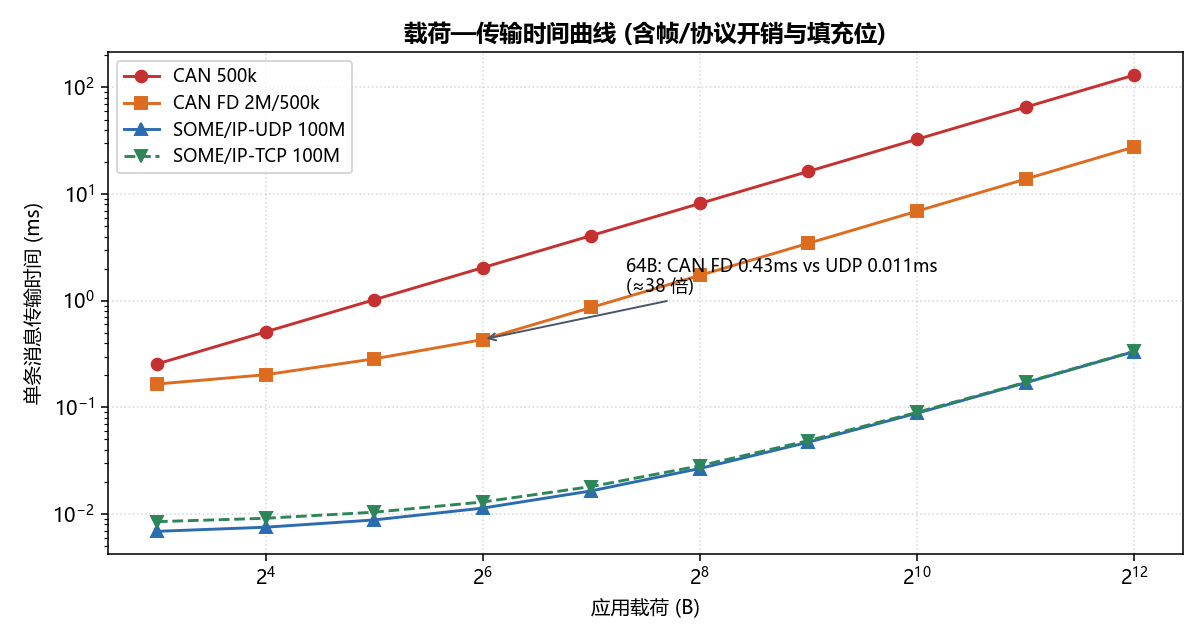
表4 里藏着一个必须讲透的反直觉:64B 时 UDP 的字节效率(45.1%)反而输给 CAN FD(77.8%)------以太网每帧要背 78B 固定开销,数据越小越"亏"。如果选型只看效率百分比,你会得出"以太网不适合传 64B"的错误结论。
但看传输时间:0.0114ms vs 0.432ms,差 38 倍。因为效率的分母是字节,时延的分母是"字节 ÷ 速率"------100Mbit/s 对 2Mbit/s 是 50 倍速率差,足以把 78B 的开销差完全吃掉。三条推论:
- 小载荷高频信号(10~64B、10ms 周期):以太网时延仍是碾压级,但要注意 CPU 侧每帧中断/协议栈开销------那是软件账,不在本表里。
- CAN 的真实约束是帧数不是效率:64B 要拆 8 帧,128B 就是 16 帧------CAN FD 的 64B 单帧能力在此处直接把时延打到 1/4.7。
- >=256B 的场景字节效率才追平:1024B 时 UDP 效率 92.9%,而 CAN 已经要 32.678ms------大数据上以太网没有悬念,这也是标定/日志/OTA 必须走以太网的算术原因。
6. 服务发现:上电时延的隐形预算
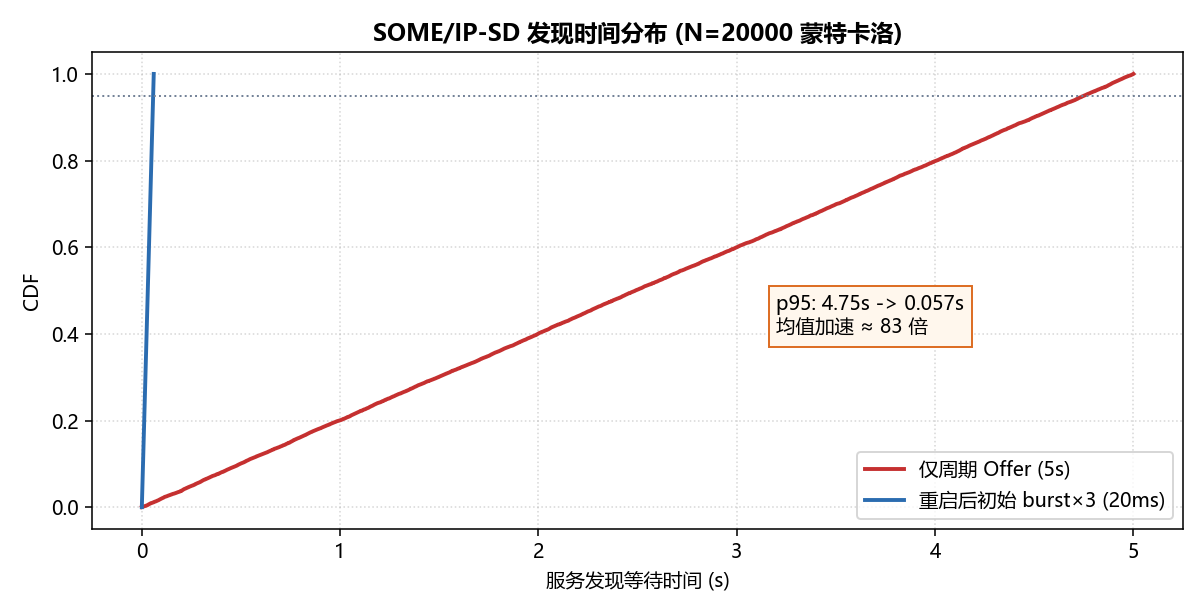
SOME/IP-SD 是服务化的"开场白":服务端周期发 OfferService,客户端才知道谁活着。发现时延直接决定上电到功能可用的时间,而它几乎完全由两个配置决定:Offer 周期、是否启用重启后的初始 burst。
实验 C:对两种配置各做 20000 次蒙特卡洛(重启时刻在周期内均匀随机,种子固定),统计客户端拿到第一个 Offer 的等待时间:
表6 服务发现等待时间(N=20000)
| 配置 | 均值 | p95 | p99 | 最大 |
|---|---|---|---|---|
| 仅周期 Offer(5s) | 2.499 s | 4.752 s | 4.948 s | 5.000 s |
| 重启后初始 burst ×3(间隔20ms) | 0.030 s | 0.057 s | 0.059 s | 0.060 s |
| 加速比 | 83.4× | 83.4× | --- | --- |
结论很硬:95 分位的重启恢复从 4.75 秒压到 57 毫秒,代价只是重启瞬间多发 2 个报文 。量产配置里这一项必须进检查单------它同时影响用户可感知的"开机多久有响应"和功能安全场景下的"降级后多久恢复"。另一个要点:Offer 周期与 TTL 必须满足 TTL ≥ 3×周期,否则丢一帧就可能被客户端判死。
7. UDP 还是 TCP:一张决策表
表7 传输协议决策表
| 场景 | 选择 | 理由(对应本篇数据) |
|---|---|---|
| 周期骨架信号(10~100ms) | UDP | 时延 0.0114ms@64B,丢一帧下一帧覆盖 |
| 事件通知(通知即新值) | UDP | 最后值缓冲天然容忍丢包,省连接维护 |
| 请求-响应 RPC(诊断/参数) | TCP | 需要可靠与顺序,连接成本一次摊销 |
| 大数据(标定/日志/OTA) | TCP 或 UDP+TP | 1024B 时 UDP 仍 0.088ms,但 >1412B 必须分片 |
| 上电风暴(全网服务涌现) | UDP + burst 启用 | 见表6,发现时延是主要矛盾 |
| 对端可能重启/网络切换 | TCP + 心跳 | 半开连接靠心跳暴露,配合 E_NOT_READY |
8. 落地检查单:上车前 10 问
表8 首篇即用的工程检查单(带本篇实测参考值)
| # | 检查项 | 通过判据 | 本篇参考值 |
|---|---|---|---|
| 1 | Service/Method ID 分配表唯一且两侧同步 | 差异=0 | 冲突会先报 E_UNKNOWN_* |
| 2 | Length 字段语义核对 | 12+N 逐报文成立 | 16 / 15 实测 |
| 3 | 典型消息四通道开销账已算 | 有表可查 | 64B: 127.65/82.23/142/162 B |
| 4 | 最坏传输时间 < 分配预算 | 余量>30% | FD 0.432ms,UDP 0.0114ms |
| 5 | SD 初始 burst 已启用 | 重启发现 p95<100ms | burst: p95=57ms ✓ |
| 6 | Offer 周期与 TTL 关系 | TTL ≥ 3×周期 | 5s 周期 → TTL ≥ 15s |
| 7 | 载荷 >1412B 的分片策略 | 走 TP 或 TCP | 1024B 内 UDP 单帧 |
| 8 | Return Code 透传到日志/DTC | 关键码全覆盖 | E_00/01/02/03/04/06/09 |
| 9 | 请求超时与重传配置 | 与会话管理一致 | Typical 100ms |
| 10 | 抓包基线已留存 | Wireshark 可解码 | 本篇 hex 即最小样例 |
9. 方法论:三条可迁移的结论
- 协议贵不贵,要拆成字节效率和时延两个口径。64B 时 UDP 效率(45.1%)低于 CAN FD(77.8%),时延却低 38 倍------单看任何一个口径都会选错通道,这张双口径表比任何"以太网 vs CAN"的定性争论都有用。
- 服务发现是上电时延的隐形预算 。周期 5s 让重启恢复 p95 = 4.752s,初始 burst 把它压到 57ms(83.4×),成本只有 3 个报文------架构里"配不配"的决定,常常比"优化不优化"更值钱。
- 字节级契约先于框架。手写一遍编解码,Length=12+N、响应会话号沿用、返回码透传这三个坑在集成前就全部暴露------先能手算一帧,再谈 SOA 框架。
10. 本篇的可复现性
- 环境:Python 3.12 + matplotlib 3.10,单文件
exp01.py,随机种子 20261008,蒙特卡洛 N=20000。 - 图表:5 张图全部由脚本直接生成(报文结构/时序/开销柱状/时延曲线/发现CDF),无手工绘制。
- 核心编解码(完整脚本含开销模型与仿真,可在本专栏读者群获取):
python
import struct
def build(service, method, client, session, iface, mtype, rc, payload):
    length = 12 + len(payload)          # Length = 其后全部字节数
    hdr = struct.pack('>HHIHHBBBB', service, method, length, client,
                      session, 0x01, iface, mtype, rc)
    return hdr + payload
def parse(msg):
    h = struct.unpack('>HHIHHBBBB', msg[:16])
    return dict(zip(('service','method','length','client','session',
                     'proto','iface','mtype','rc'), h)), msg[16:]
# 扭矩请求: 5230 * 0.01% = 52.30%
req = build(0x1234, 0x0101, 0xA001, 0x0001, 0x01, 0x00, 0x00,
            struct.pack('>hBB', 5230, 7, 0x5A))
print(req.hex(' '))   # 12 34 01 01 00 00 00 10 a0 01 00 01 01 01 00 00 14 6e 07 5a
11. 下篇预告
02. SOME/IP-SD 状态机与事件订阅:Offer/StopOffer 与 TTL 到期的完整状态迁移、Eventgroup 订阅与 SubscribeAck 的重传节奏、"订阅风暴"在上电时刻的分布实测------把本篇那个 83.4× 的发现加速,扩展成一整张上电时序预算表。