视觉SLAM第11讲|回环检测:词袋模型、字典构建与相似度计算全解析
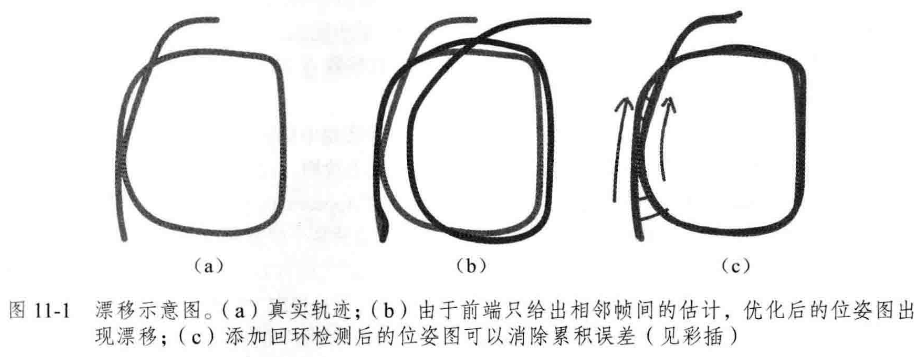
前面我们把前端视觉里程计、后端优化都讲透了,但只要是前端递推的系统,就绕不开一个宿命:累积漂移。哪怕后端有滑动窗口优化,也只能缓解,没法根治。
想要彻底把漂移拉回来,最核心的机制就是回环检测 ------发现"这个地方我之前来过",然后给后端加一条全局约束,把整条轨迹掰回正确的位置。
第11讲就把回环检测的主流方案讲透:最经典的词袋模型怎么建字典、怎么算相似度、怎么验证候选回环。
一、回环检测概述:为什么它能根治漂移
1.1 核心作用
回环检测的任务只有一个:判断机器人当前所在的位置,是不是之前已经来过的某个位置。
如果确认是,就往后端优化里加一条约束:这两个时刻的相机位姿,本质上是同一个位置。后端根据这条约束,重新分配整条轨迹的误差,就能把之前累积的漂移整体消除。
💡通俗解释:就像你逛街逛了一圈,突然看到了之前见过的便利店,立刻反应过来"我回到这了",之前走歪的路线瞬间就校正了。回环检测就是SLAM系统的"场景识别器"。
1.2 两类方案
- 环境布置式 :比如固定位置放二维码、标志物。
优点:准确稳定,实现简单;缺点:必须改造环境,未知场景无法使用。 - 视觉回环检测 :只靠图像本身的相似度判断,不依赖任何环境布置。
这是SLAM领域的主流方案,也是本讲的重点。
1.3 评价指标:准确率 vs 召回率
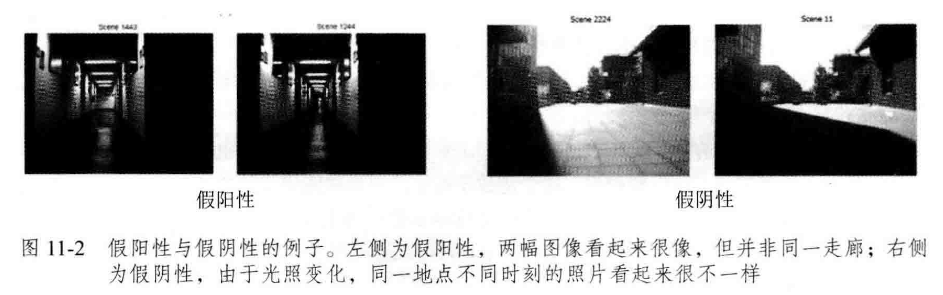
回环检测本质是个分类问题,两个核心指标此消彼长:
- 准确率(精确率):检测出来的回环里,真的是回环的比例。准确率低意味着误检多,会把后端优化带偏。
- 召回率:所有真实的回环里,被成功检测出来的比例。召回率低意味着漏检多,很多回环没发现,漂移消不掉。
💡通俗解释:准确率就是"没认错"的比例,召回率就是"没漏掉"的比例。工程上都是找一个平衡点,既不能乱报,也不能漏太多。
二、词袋模型:图像的"关键词"表示
如果逐像素比对两张图像像不像,计算量太大了,还容易受光照、角度影响。
工程上的成熟方案是词袋模型(Bag of Words, BoW):把图像转换成一组"单词"的统计,用单词的重合度来判断相似度,思路和文本检索完全一致。
2.1 核心思路
- 提取图像的ORB特征,每个特征的描述子就是一个高维特征向量;
- 把大量特征描述子聚类,每个聚类中心就是一个"视觉单词";
- 所有单词合起来就是一本视觉字典;
- 任何一张图像,都可以统计每个单词出现了多少次,形成一个词袋向量,代表这张图。
💡通俗解释:就像判断两篇文章像不像,不用逐字比对,只看关键词的重合度。"视觉单词"就是图像的关键词,词袋向量就是图像的"关键词列表"。
2.2 效率优势
原本两幅图像比相似度,要逐个特征点做匹配,复杂度很高。
现在都转成词袋向量,直接算向量相似度,计算量降了几个数量级,完全可以做到实时检测。
三、字典构建:视觉单词怎么来的
词袋模型的基础是字典。字典质量直接决定回环检测的效果。
3.1 聚类生成单词
生成单词的核心方法是K-means聚类:
- 收集大量图像的特征描述子,作为训练样本;
- 设置要生成的单词数量K;
- 运行K-means聚类,得到K个聚类中心;
- 每个中心就是一个视觉单词。
3.2 K叉树字典:加速查找
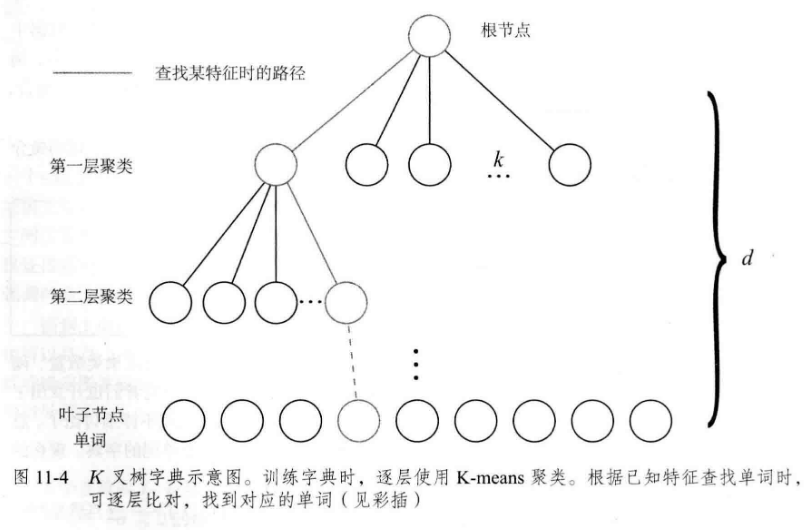
如果字典有几万个单词,每个特征逐个比对找最近的单词,还是太慢。
工程上用K叉树结构构建层级字典:
- 第一层:把所有特征聚成K类,每个类中心是第一层节点;
- 第二层:每个类内部再聚K类,形成下一层节点;
- 逐层往下,叶子节点就是最终的视觉单词。
查找的时候,从根节点开始,逐层找最近的分支,最后到叶子节点就是对应的单词。比线性查找快很多。
💡通俗解释:就像查字典,先查部首,再查偏旁,再查笔画,不用整本词典翻一遍。K叉树字典就是这个思路,把查找从线性复杂度变成了对数级。
3.3 字典规模的权衡
不是字典越大越好:
- 字典太小:单词太"粗",区分度差,不同场景也容易匹配上,准确率低;
- 字典太大:单词太"细",同一个场景稍微变点角度、光照就匹配不上,召回率低。
工程上都是根据场景调字典大小,一般几千到几万个单词。
四、相似度计算:怎么判断两张图像像不像
有了字典,就能把任何一张图像转换成词袋向量,接下来就是计算相似度。
4.1 词袋向量的生成
步骤:
- 提取当前图像的所有ORB特征;
- 每个特征在字典里查找对应的视觉单词;
- 统计每个单词出现的次数,形成向量。
4.2 加权:罕见单词权重更高
不是所有单词的权重都一样。
非常常见的单词(比如普通墙角、均匀纹理),在哪都有,匹配上了说明不了什么;
非常罕见的单词,匹配上了,说明是同一场景的概率很高。
所以通常会用类似TF-IDF的加权策略:单词的区分度越高,相似度计算时权重越大。
4.3 相似度评分与候选筛选
两个词袋向量,计算相似度,常用的有L1范数相似度、余弦相似度等。
相似度越高,是同一场景的概率越大。
设定一个阈值,相似度超过阈值,就标记为候选回环。
五、候选验证:光像还不够,还得几何对
词袋是外观相似度,只能当初步筛选。现实中很容易出现"不同地方长得很像"的情况,比如一模一样的办公室隔间、重复排列的路灯,直接用会产生大量误检。
所以候选回环之后,必须加一步几何验证:
- 用当前帧和候选回环帧的匹配特征点,求解PnP位姿;
- 把地图点按这个位姿重投影,看重投影误差是不是足够小;
- 误差在阈值内,才确认是真回环,否则丢弃。
💡通俗解释:长得像不一定是同一个地方,几何位置对得上才是。几何验证是回环检测的最后一道防线,能过滤掉绝大多数误检,工程上是标配。
六、工程优化与实践
6.1 关键帧策略
不是每一帧都去做回环检测,也不是和所有历史帧都比。
只和历史关键帧比对,计算量大幅减少。只要关键帧间隔合适,也不会漏检回环。
6.2 实践:DBoW3库
开源的DBoW3库是SLAM领域最常用的词袋工具,直接支持ORB特征,内置K叉树字典、相似度计算。
基本流程:
- 用数据集训练字典,或者加载预训练字典;
- 把图像特征转成词袋向量;
- 计算相似度,筛选候选回环;
- 几何验证确认回环。
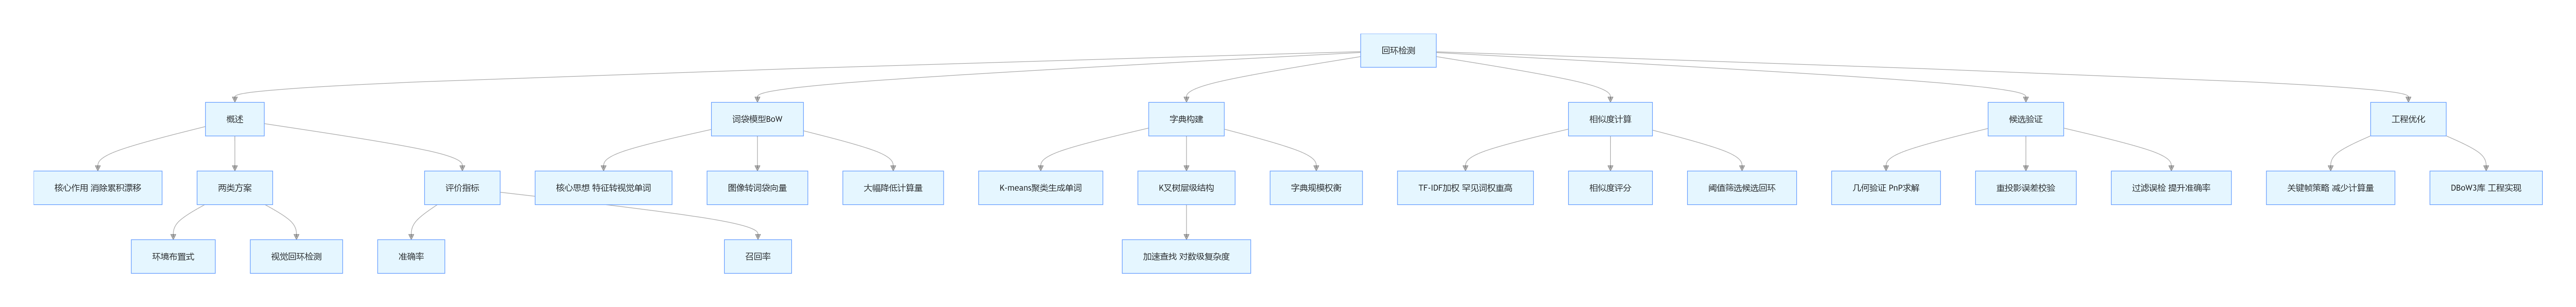
七、知识体系全景
小结
回环检测是SLAM系统里唯一能根治累积漂移的机制。词袋模型是目前最成熟、最常用的视觉回环方案,靠视觉单词把图像相似度计算降到了可实时的程度,再配合几何验证过滤误检,兼顾了速度和准确性。
当然词袋也不是完美的:极端相似的场景、光照剧烈变化还是容易出问题。现在也有越来越多的方案用深度学习特征代替手工ORB特征,进一步提升回环检测的鲁棒性,但词袋的整体框架依然通用。
到这里,前端、后端、回环检测就都齐了。下一讲我们进入建图模块,看看有了位姿和特征,怎么构建出不同类型的地图。