当大模型从"什么都会说"走向"什么场景都能用",幕后的数据标注产业正在经历一场不为人知的蜕变------从机械的"画框框打标签",升级为融合专业知识、工程体系和标准化能力的高端知识编码工作。
这场变革正在重新定义谁有资格进入这个行业,以及谁能在这个500亿赛道中真正建立起壁垒。
一、你以为的数据标注,早就不是你以为的样子了
提起"数据标注",大多数人的第一反应还是几年前那个画面:几百号人挤在电脑前,对着图片画框、给文字打分类标签。月薪三四千、重复劳动、没什么技术含量------这是外界给这个行业贴了多年的标签。
但如果你现在还这么想,那真的跟不上了。
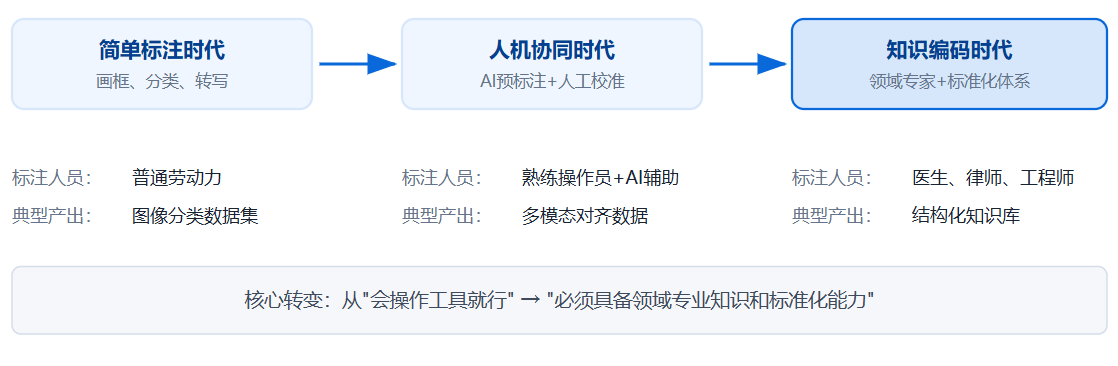
前不久《浙江日报》在一篇深度报道中一针见血地指出:随着人工智能从通用能力训练加速走向行业应用,数据标注正由过去相对简单的"打标签""画框框",向高专业性、高交互性、高复杂性的方向快速发展。1 换句话说,医生开始参与标注医学影像数据,律师需要介入法律文书的语义标注,自动驾驶工程师要指导道路场景的精细分类------行业专家正在成为数据标注的核心力量。
这个变化背后的逻辑其实很简单:大模型要落地到具体行业,光靠"开放域"的海量文本远远不够。医疗场景需要精准的病理判断,法律场景需要理解司法解释的逻辑链条,自动驾驶需要对路况做出毫秒级的反应。这些场景对训练数据的要求,已经不是"量够大就行",而是**"必须够准、够专业、够可靠"**。
二、从"标数据"到"标知识",门槛到底抬高了多少?
过去的数据标注,说到底是"把一个东西分到哪个类别"的问题。比如,这张图里有没有行人?这段语音说的是什么字?但是到了今天,大模型需要的已经远远不止这些了。
一段话里的讽刺意味,一个法律判决书中的推理逻辑,一段医患对话中的隐含症状,一个复杂的驾驶场景中不同物体之间的交互关系------这些东西没有标准答案,却又对模型的表现至关重要。正如前文报道中所说的,高端语言数据标注,本质上正在从"数据加工"走向"知识编码"。
换句话说,以前是"看到什么标什么",现在需要"理解了再标"。标注员不再是机械执行规则的工人,而是需要理解领域知识、能够处理边界情况和歧义问题的知识工作者。
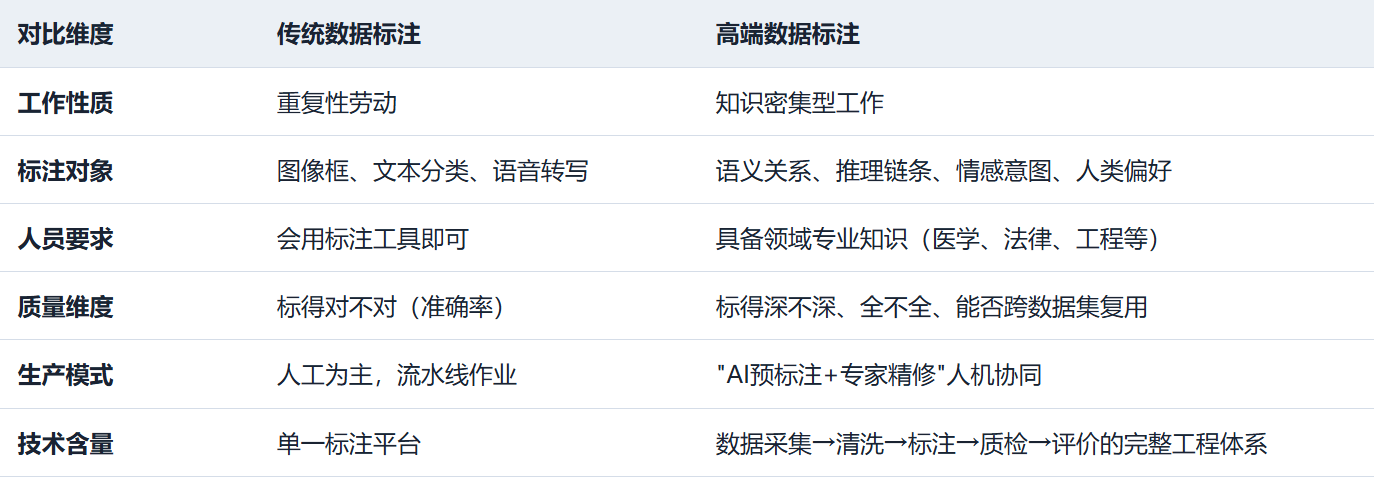
这个变化对产业的影响是结构性的。一方面,低端标注的门槛很低,导致竞争日趋激烈、利润越来越薄。另一方面,真正能做好高端标注的团队少之又少------你既要有懂领域的专家资源,又要有能支撑大规模协作的工程化平台,还得有经得起推敲的标准化流程。
三、"标准"这个东西,正在成为行业新的分水岭
在数据标注行业干了十几年的人都会告诉你一件事:把数据标出来不难,难的是让不同的人、在不同的时间、以同样的标准,把数据标出来。
同一个语言现象,如果不同项目、不同企业甚至不同标注员采用了不同的理解和处理方式,即使投入再多人力,产出的也是大量彼此不一致的数据。对于AI训练来说,这种不一致最终都会变成"数据噪声"------让模型学到的不是规律,而是混乱。
所以报道中特别强调了一个关键判断:标注标准是连接语言知识与AI数据工程的关键接口。它一头连接着语言学、行业规范和专业知识,另一头连接着数据生产、模型训练和AI应用落地。没有标准,专家的知识就进不了规模化生产的流水线,高质量就变成一句空话。
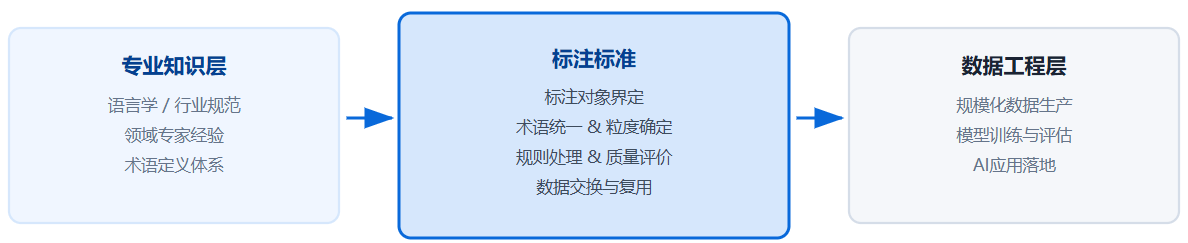
标准不是给数据标注"锦上添花"的外围工作,而是整个高质量数据建设的基础设施。没有统一术语,专家之间难以准确沟通;没有统一标注规则,大规模协作就无法保证一致性;没有统一的质量评价方法,"高质量"三个字就无从检验。
四、当一个赛道从"拼人力"变成"拼体系",核数聚在做什么?
理解了上面的产业逻辑,再来看核数聚这家公司的布局,很多动作就变得非常清晰了。
核数聚是国内领先的人工智能数据资源与服务提供商,但它的定位远不止是"帮人标注数据"。这家公司依托自主研发的数据采集、数据标注、模型服务三大核心技术平台,从产业链的上游到下游做了全链路覆盖。
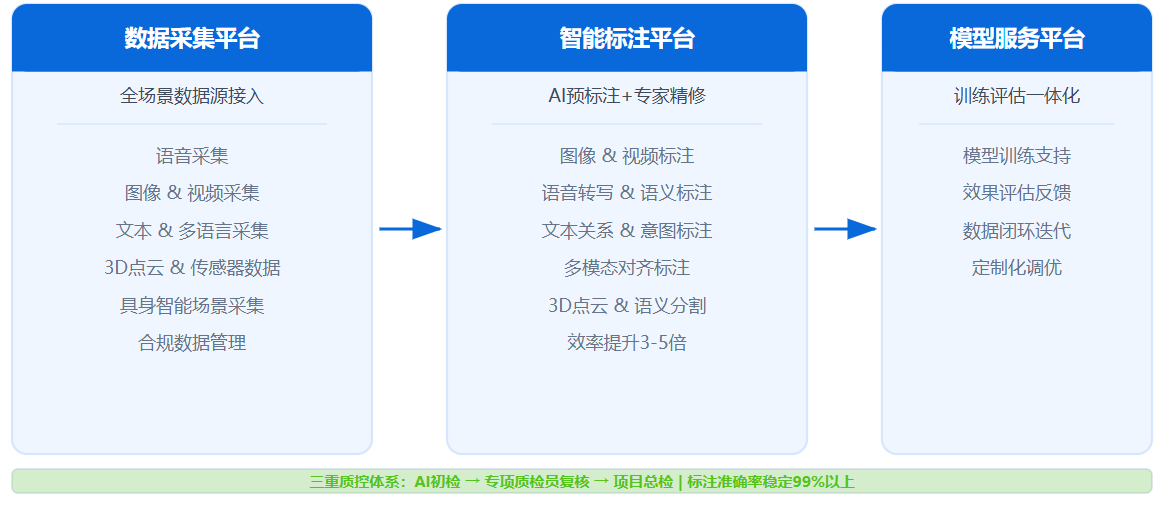
这套体系有几个值得关注的亮点。
**第一,不是单纯靠人。**核数聚的平台采用了"AI预标注+人工精修"的模式,标注效率提升了3-5倍。2 这个做法本质上就是行业趋势中提到的"人机协同"------用AI处理那些模式清晰的、重复性的工作,把有经验的标注员和领域专家的精力聚焦在真正需要判断力的环节上。
**第二,质量管控不是走过场。**三重质控体系------AI初检、专项质检员复核、项目总检------保证了标注准确率稳定在99%以上。2 在高端标注领域,99%的准确率不是锦上添花,而是入场券。
**第三,客户类型说明了能力深度。**核数聚的客户名单里包括了腾讯、阿里这样的头部互联网企业,也有乐聚、智元这样的具身智能厂商,还有Momenta、博世这样的自动驾驶企业。这些客户有一个共同特征:它们对数据质量的要求,远高于行业的平均水平。尤其是具身智能和自动驾驶场景,数据误差可能就是安全风险。
五、这场变革走到最后,拼的是什么?
回到文章开头那个判断:《浙江日报》报道中特别提到,高端数据标注已经从单一的"标注平台"竞争,走向了**"数据工程体系"竞争**。
什么叫"数据工程体系"?说白了,就是你能不能把数据的全生命周期------从采集、清洗、治理,到标注、质检、评价、编目、管理------串成一个高效、可控、可复用的闭环。这个闭环里,每一个环节都需要标准化,每一个环节都会影响最终的数据质量。
未来真正有竞争力的企业,不会只是比谁标注员多、谁单价便宜。而是比谁能把"行业专家的知识"高效率、标准化地转化为"机器可以学习的数据"。这需要三个能力:懂行业(知道标什么)、懂工程(知道怎么标)、懂标准(知道怎样才算标好了)。
核数聚深耕行业15年+,这个趋势其实是利好消息。因为"数据工程体系"的门槛比"数据标注平台"高太多了------你需要有自研的技术平台,需要有覆盖多领域的数据处理经验,需要有一整套经得起客户检验的质量管控流程。这些东西,不是融几轮钱、招一批人就能短时间搭建起来的。
用一句大白话说:**低端标注拼的是单价,高端标注拼的是能力。**而能力这个东西,需要时间沉淀。