10 月 8 号 GPT-6 全量开放那天,朋友圈被各种"AI 帮我做了个计算器""AI 给我生成了自驾游地图"刷屏了。大家都在晒界面,但作为一个写了多年前端的人,我更好奇的是另一个问题:
这些滑块、图表、表单,到底是怎么从一段模型输出,变成能实时交互、还不用再次请求模型的界面的?
带着这个问题,我翻到了 Thesys 工程团队 10 月 8 日当天发布的逆向分析(他们抓包分析了 Web 版 ChatGPT),又自己对着网络面板和编译产物啃了两天。结论让我有点恍惚:
Intelligent UI 的客户端内核,本质上就是一个跑在沙箱 Worker 里的、迷你版 React 协调器(reconciler) ------hooks、diff、操作指令(operations)一应俱全。我们熟悉的前端工程范式,被 OpenAI 拿去重新实现了一遍,只不过这次写 UI 的人从开发者变成了模型。
这篇文章把整套机制从外到内拆开讲清楚:模型写的 "DIL 方言" 长什么样、服务端怎么把半成品代码救回来、客户端为什么要套三层沙箱、UI 操作指令怎么编码传输,以及------这对我们前端到底意味着什么。
先说结论(5 个关键发现)
- 模型不直接吐 HTML,而是写一种叫 DIL 的格式:Markdown 写正文 + JSX 风格标签写组件 + JavaScript 写状态逻辑
- 服务端把 DIL 编译成 JS 程序 + JSON 常量表,自动修复未闭合标签、校验属性、隔离异常表达式
- 客户端在 CSP 为 default-src 'none' 的隐藏 iframe + Web Worker 里跑模型代码,有 lockdown 和看门狗
- 运行时是 React 风格的 reconciler:保 hook 状态 → diff 新旧树 → 输出二进制 UI 操作;交互零模型调用
- 流式靠 SSE + JSON Patch:一次 6341 字符的回复,18.7 秒内分 84 次更新推送
🏗️一、先看全貌:五个角色怎么配合
Intelligent UI 不是一个模型端到端搞定的东西,而是模型、后端服务器、客户端三方分工的流水线。理解这张图,后面所有细节都有位置放:
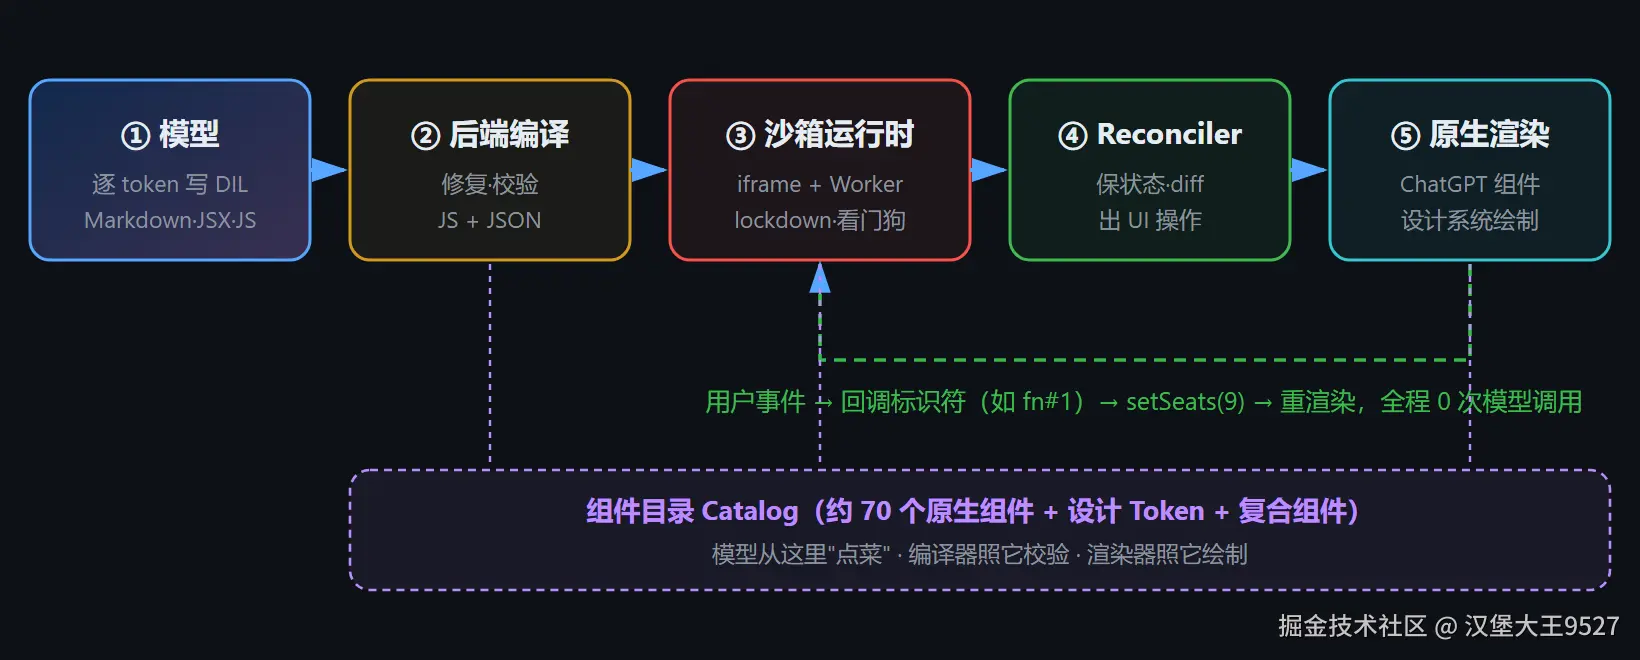
为什么要拆这么多层?核心矛盾是:模型是一个 token 一个 token 往外吐的,但界面必须在"只写了一半"的时候就能渲染、还能持续交互不丢状态。这跟我们做流式 SSR / Suspense 时遇到的问题几乎一模一样,后面你会不断看到这种"前端既视感"。
📝二、DIL:模型写的"方言",三合一
先看模型实际输出的东西。OpenAI 内部管它叫 DIL(推理格式),由三种前端工程师一看就懂的东西拼起来:
- Markdown:负责正文叙述
- JSX 风格标签 :负责组件,比如
<slider/>、<box> - JavaScript :负责状态和逻辑,用
{@body ...}声明
这是官方逆向文档里那个最小示例的完整 DIL(一个团队套餐价格计算器):
ini
## Team plan estimate

Drag the slider to see the **monthly price** for your team.

{@body const [seats,setSeats] = DIL.useState(8)}
{@body const price = seats*29}
<box border padding={3} gap={2}>
  <slider min={1} max={50} value={seats} onChange={setSeats}/>
  <title size="xl">${price}/mo</title>
</box>
看懂这几行,DIL 的核心就懂了八成:
- 标题、段落是普通 Markdown;
**monthly price**最终会被编译成text里嵌一个bold - 第一行
{@body}声明状态seats(初始值 8),这就是 React 的 useState ,只不过钩子叫DIL.useState - 第二行派生
price = seats * 29 - 滑块的
value绑定状态、onChange绑定 setter------拖动滑块价格实时变,不需要再请求模型
DIL 的完整词汇表也基本是"JSX 精简版 + Svelte 模板语法"的味道:
| 语法 | 作用 | 前端既视感 |
|---|---|---|
{@body ...} |
声明 JS 语句(状态、派生值) | 组件函数体 |
{expression} |
表达式插值 | JSX 的 {} |
{#if} / {:else} |
条件渲染 | Svelte 模板 |
{#each list as item, i} |
列表循环 | Svelte each / v-for |
| 事件处理函数 | onChange 等回调 | React 事件绑定 |
GenUI 动作 |
issueNewTurn(发起新一轮对话)、copy 等 | 跨边界命令 |
为什么非要发明一套新格式,不让模型直接吐 React?
因为输出是流式、且随时处于"写了一半"的状态 。DIL 的设计约束是:① 用模型本来就最熟的记号(Markdown/JSX/JS),保证写得对;② 每条语句独占一行、任何开着的标签都能自动闭合,让服务器可以在"最后一个完整语法结构"处切断,切完照样能编译。
⚙️三、服务端编译:模型代码绝不直接执行
客户端永远不会直接执行模型写出来的东西 。后端先把 DIL 编译成两样产物,存进消息体(字段名 model_dil_v2):一个 JavaScript 程序 + 一份 JSON 文档。
上面那段计算器,编译后大致长这样(我做了格式化):
php
function __dilSafe(evaluate, failureValue) {
  try { return evaluate(); } catch { return failureValue; }
}

DIL.render(__dil.jsx(() => {
  const __dilConstants = DIL.useConstants();
  const [seats, setSeats] = DIL.useState(8, { key: "seats" });
  const price = __dilSafe(() => seats * 29, undefined);
  return __dil.jsx(__dil.Fragment, null,
    __dil.jsx("title", { size: "lg" }, __dilConstants["0"]),
    __dil.jsx("text", null, __dilConstants["1"],
      __dil.jsx("bold", null, __dilConstants["2"]),
      __dilConstants["3"]),
    __dil.jsx("box", { border: true, padding: 3, gap: 2 },
      __dilSafe(() => __dil.jsx("slider", { min:1, max:50, value:seats, onChange:setSeats }), null),
      __dil.jsx("title", { size: "xl" }, __dilConstants["4"],
        __dilSafe(() => price, null), __dilConstants["5"])));
}, { key: "body:2" }));
配套的 JSON 常量表:
json
{
  "constants": {
    "0": "Team plan estimate",
    "1": "Drag the slider to see the ",
    "2": "monthly price",
    "3": " for your team.",
    "4": "$",
    "5": "/mo"
  }
}
这一层编译器干了五件事,每一件都值得我们做工程化的同学细品:
| 编译动作 | 解决什么问题 |
|---|---|
| 拍平成函数调用 | 标签全变成 __dil.jsx(...),客户端只需要一个 JS 运行时,不用再写 DIL 解析器 |
| 异常隔离 __dilSafe | 每个表达式包 try/catch,一个表达式抛错只干掉一个元素,不会整屏白掉 |
| 文本进常量表 | 静态文字全部抽到 JSON,流式时文字增长只改数据、不改程序结构 |
| 稳定状态键 | 每个 state 拿到 { key: "seats" },重编译后状态不丢------这就是 React 的 key |
| 修复与校验 | 未闭合标签自动关、半截语句直接丢、不符合目录 schema 的属性删除并记诊断 |
最后那个"属性校验"特别有意思。逆向团队抓到的真实案例里,编译器一次删掉了两个非法属性:给 icon 写的 fill(诊断为 unknown_prop),以及给 box 写的 gap="1"(诊断为 invalid_literal,类型不对)。
注意这个设计思想
模型生成的 UI 是"白名单制"的。 不是模型想渲染什么就渲染什么,而是只能从组件目录里"点菜",点了不存在的菜(未知属性/错误类型)编译器直接撤掉。这跟我们做低代码平台时的组件协议层是同一个思路------用 schema 把生成式输出约束在安全边界内。
🔒四、三层沙箱:为什么要把模型代码当"不可信代码"防
这一层是我看得最后背发凉的部分------结合最近 OpenAI Agent DNS 逃逸、入侵政府网站那一连串安全事故,你就明白 OpenAI 为什么对"执行模型生成的代码"这件事警惕到偏执。
模型写的程序不在 ChatGPT 页面里跑。运行环境是这样隔离的:
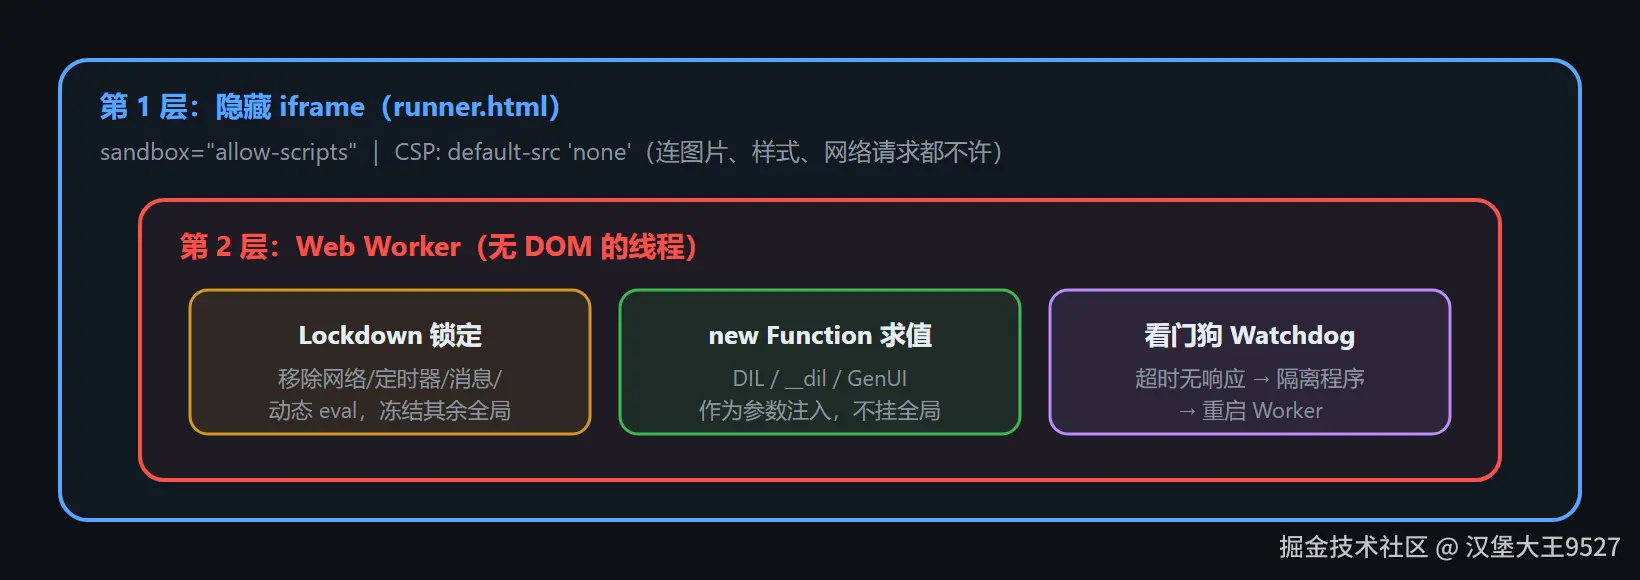
逐层拆一下这三道防线:
- 隐藏 iframe :加载
runner.html,只给allow-scripts权限,CSP 直接default-src 'none'------默认禁止一切外部资源加载,想外发数据连门都没有 - Worker 内 Lockdown :求值程序之前,先把网络访问、定时器(
setTimeout们)、消息通道、动态代码执行(eval/new Function再嵌套)全部从全局作用域抹掉,剩下的全局对象冻结。模型代码想fetch外传、想setInterval驻留,都做不到 - 看门狗:程序在超时时间内不响应,就会被隔离(quarantine),整个 Worker 重启------防死循环、防资源耗尽
运行时对象 DIL、__dil、GenUI 和目录里的复合组件,是作为参数传进函数作用域的,不挂在全局上。这意味着模型代码接触到的"世界"是一个被精心裁剪过的最小能力集。
一个隐藏线索:Hermes
逆向团队发现沙箱还兼容 Hermes (React Native 用的 JS 引擎)的全局对象。这强烈暗示 ChatGPT 移动端跑的是同一套运行时,只是用各自的原生渲染器应用操作指令------一次编译,多端运行。是不是又想到了 React Native?
🔁五、协调器:一个长在 Worker 里的"迷你 React"
沙箱里的运行时本身不画任何东西。它是一个 React 风格的小型 reconciler,工作流程和 React 做的事几乎一一对应:
- 渲染组件,把 hook 状态保存在带 key 的槽位里(
key: "seats") - 把这次生成的树和上一次的树做 diff
- 把差异编码成一串操作指令(operations) 输出给页面
首次渲染时,那个计算器输出的指令长这样(节选,一行一个节点):
shell
#1  CREATE title  SET size="lg"          PLACE under root at 0
#2  CREATE text "Team plan estimate"     PLACE under #1 at 0
#8  CREATE box   SET border,padding=3,gap=2  PLACE under root at 2
#9  CREATE slider SET min=1,max=50,value=8,onChange=fn#1 PLACE under #8 at 0
#10 CREATE title SET size="xl"          PLACE under #8 at 1
#12 CREATE text "232"                   PLACE under #10 at 1
注意两个细节,这是整套设计最精妙的地方:
第一,函数从不出 Worker。 滑块的 onChange 回调在指令里只是一个标识符 fn#1,真正的函数体永远留在 Worker 内部。线上传输时,所有指令还会被编码成二进制整数序列,字符串单独放一张表------这跟 React DevTools 协议、React Native 的视图指令序列化是一个路数。
第二,交互反向走,且零模型调用。 你把滑块从 8 拖到 9:
页面(原生渲染器)拖到 9,发 fn#1(9)沙箱 WorkersetSeats(9) → 重渲染diff → 返回更新指令页面更新$261/mo · 9 seats模型调用:0 次
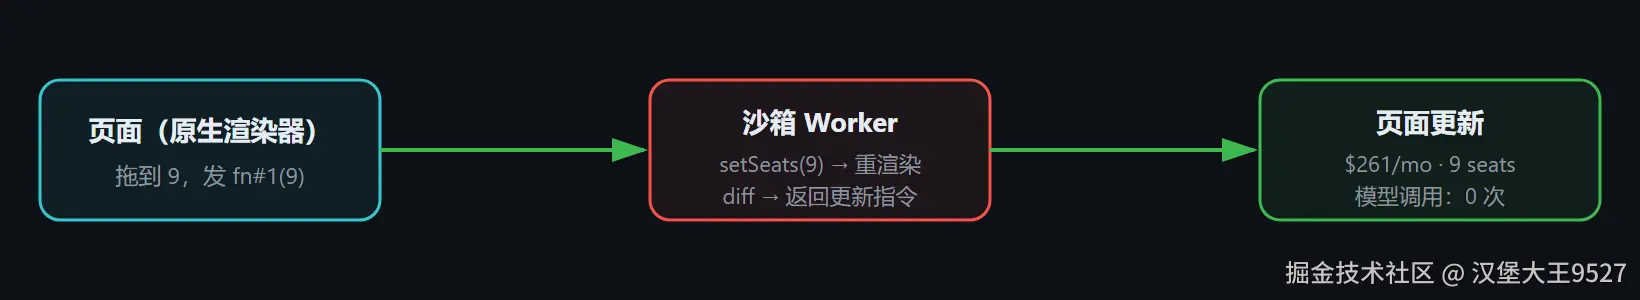
页面收到事件后,把回调标识符和参数 fn#1(9) 发给 Worker;Worker 内部执行 setSeats(9)、重渲染、diff、回传更新指令;页面把 232 改成 261。整个过程模型参与次数:0。
这就是为什么这些组件能"即时响应"------状态逻辑是真正在你本地跑的 JS,不是每次都花一次 API 调用去问模型。
🌊六、流式渲染:6341 字符,84 次补丁
流式文本很简单------新 token 往后拼就行。但流式界面有三个老大难:
- 输出大部分时间是个跑不起来的半截程序(标签还开着、表达式没写完)
- 界面必须一边"长"一边能用,用户已经摸过的组件状态不能丢
- 有些内容(如图片)不是从文本流来的,是服务器单独给的
ChatGPT 的方案是:不推 token 流,而是推对一条结构化消息的"补丁流" 。通道是 SSE(POST /backend-api/f/conversation),每个事件都是一条 JSON-Patch 风格的更新,同时改三处:原始 DIL 文本、编译后的程序、常量表。
一条真实的补丁长这样(节选):
css
{"o": "patch", "v": [
  {"p": "/message/content/parts/0", "o": "append",
   "v": " Sunday lamb roast with friends --- generous food, ..."},
  {"p": "/message/metadata/model_dil_v2/code", "o": "replace",
   "v": "DIL.render(__dil.jsx(()=>{..."},
  {"p": "/message/metadata/model_dil_v2/constants", "o": "append",
   "v": {"0": "Here's a plan for a proper Sunday lamb roast..."}}
]}服务器不做增量编译:每隔几百毫秒(基本跟着模型 chunk 走)就把"模型到目前为止写的全部内容"重新编译一遍,从第一个 token 就开始编,哪怕那时一个标签都还没出现。
"半成品"怎么编译?
编译器在最后一个完整语法结构处切断:
- 没写完的
{@body}语句、没闭合的标签 → 直接丢弃 - 已经有内容的开放元素 → 自动闭合;没内容的 → 丢弃
- 半截文本 → 原样保留
每次切断都在 recoveryDiagnostics 里记一笔(unterminated_tag、unclosed_block 等),源码补全后诊断自动消失。所以你看到的效果是:文字一个词一个词地蹦,组件则等标签完整后"啪"地一下出现。
实测数据:三种更新
逆向团队抓了一条 6341 字符的回复,18.7 秒内共 84 次更新,其中 76 次携带新文本,分成三类:
结构变化:追加文本 + 重发整个编译程序
仅文本增长:程序不变,只更常量
标签写到一半:只发文本,界面不动
其余:建消息 1 / 图片结果 5 / 完成标记 2
这其实就是"组件级流式渲染"
对比一下我们熟悉的 React 18 Suspense + streaming SSR:服务端分段吐 HTML、客户端 hydration、边界独立 resolve。Intelligent UI 做的事本质相同,只是把"React 组件"换成了"模型选择的目录组件",把 SSR 的字节流换成了 JSON Patch。流式 UI 的工程难题,十年前在 Gmail 那里、两年前在 RSC 那里,答案早就写过一遍了。
🧩七、组件目录:模型不是造物主,是"点菜的人"
最后一块拼图是 Catalog(目录),它定义了模型能要什么 。模型不能从原始布局/样式规则自由发挥,只能从 ChatGPT 已经知道怎么画的组件里选,再用设计 Token(如 padding={3})装饰。
| 目录组成 | 内容 |
|---|---|
| 原生组件 | 客户端组件注册表里约 70 个,逆向样本中实际出现了 39 个 |
| 设计 Token | 间距、圆角、颜色、字号(如 4px 间距体系:padding=3 = 12px,gap=2 = 8px) |
| 复合组件 | OpenAI 用 DIL 自己写好、预构建进沙箱的,比如图片、商品卡;模型只会用、不会自己定义 |
这种"Token 优先、裸 CSS 少量放开"的策略带来两个直接结果:
- 生成的界面在所有平台上都长得像 ChatGPT------不会出现一个 Windows 95 风格的按钮
- 编译器有 schema 可校验------不存在的属性、类型错误的字面量在编译期就被删掉
页面端也只接受已知组件类型的 CREATE 指令,模型输出无法注入任意标记或样式(少数属性接受裸 CSS 是例外,另有跑在 iframe 里的 AppBlock 作为逃生舱)。
🎯八、对前端的 5 个真实启示
扒完整套机制,我最大的感受不是"前端要完",而是 "我们这些年攒下的工程范式,正在变成生成式 UI 的底座" 。说 5 个具体的:
启示 1:React 的心智模型不仅没过时,还成了"模型的运行时"
hooks(useState)、key、reconciler、diff、视图指令序列化------OpenAI 照着 React 的核心抽象重新实现了一遍。你对 hooks 规则、key 的作用、渲染与提交阶段的理解,在理解和调试这类生成式 UI 时直接可迁移。框架 API 会变,这套范式短期内不会。
启示 2:"执行不可信代码"的沙箱能力,会成为前端新基建
iframe CSP + Worker lockdown + 看门狗 + 能力以参数注入,这一整套是把模型代码当"敌方代码"防。未来凡是要在产品里跑 AI 生成代码/插件的团队,都得交这份作业。懂安全沙箱、懂 CSP、懂 Worker 隔离的前端,会比只会写页面的值钱。
启示 3:设计系统 / 组件协议,是约束 AI 产出的缰绳
模型不能随便画,只能从带 schema 的目录里选。这意味着设计系统工程师、组件库维护者的价值不降反升------你定义的组件 API、Token 体系、属性校验,直接决定了 AI 能生成什么质量的界面。你写的不是组件,是 AI 的"表达边界"。
启示 4:UI 正在"协议化"------视图描述与渲染器分离
DIL → 编译 → 二进制操作 → 各端原生渲染,再加上 Hermes 线索,这是一套跨端视图协议。"写声明式描述、跑通用协调器、接平台渲染器"这套东西,React Native 和小程序们验证过,现在 AI 把它推到了极致。理解协议层和渲染层边界的人,卡位更好。
启示 5:流式交互的经验(Suspense/RSC/乐观更新)迎来第二春
"半成品可渲染、状态跨重编译不丢、交互不等服务端"------这些正是 streaming SSR、Suspense、乐观 UI、本地状态优先一直在解决的问题。模型让交互更复杂了,但解题的工具箱还是前端的那个工具箱。
💬写在最后:被取代的是"写标签的手",不是"懂这套系统的脑子"
看完 Intelligent UI 的实现,我反而没那么焦虑了。
表面上看,模型连界面都能自己生成了------滑块、图表、表单、计算器,一句话的事。但往下扒三层你会发现:让这件事真正可靠地跑起来,靠的全是过去十几年前端工程踩过的坑攒下的方案------组件化、hooks、reconciler、沙箱隔离、流式渲染、设计 Token、属性 schema。
AI 接管的是"写标签"这一步,而"标签怎么被安全执行、状态怎么不丢、半成品怎么渲染、组件边界怎么定义"------这些系统级的判断,一个都没被接管。
当然,这也意味着分工真的变了:以后可能不再需要那么多人写业务组件,但会更需要能设计运行时、定义组件协议、搭建安全沙箱、约束模型表达边界的人。