LinuxTCP 套接字编程:从文件描述符抽象到并发服务模型的内核视角-CSDN博客
👆上一篇文章里,一条
socket()→bind()→listen()→accept()的TCP连接全程。连接建好了,两个进程可以互相发字节了然后呢?
然后你会撞上一个尴尬的事实:你能把字节送到对面,却送不了"意思" 。你手里是一个 C++ 对象,里面有三个字段;网线上跑的是一串没有类型、没有边界、没有结构的字节。这中间隔着的东西,就是本文要讲的序列化、反序列化与自定义协议。
本文不堆知识点,而是沿着一条推理链往前走:先看全貌 → 再看内核给的到底是什么 → 字节流的边界从哪里来 → 帧里的内容怎么摆 → 用什么格式摆 → 代码怎么分层装起来 → 怎么跑起来亲眼看见它 → 最后下沉到内核,看同一套思想在那里长什么样。
卯榫结构下,知识点环环相扣,如沐春风。
目录
- 一、站到一万米高空:一次「10 20 +」的完整旅行
- 二、把镜头拉近:内核为什么只肯给你一串字节
- 三、给字节流画格子:应用层协议登场
- 四、格子里的内容怎么摆:序列化登场
- 五、挑一门"共同语言":手搓、JSON、XML 与 protobuf
- 六、把库用起来:jsoncpp 三件套
- 七、设计我们自己的报文:Request 与 Response
- 八、把零件装起来:分层、回调与两条流水线
- 九、跑起来看见它:一次发三条,复现粘包
- 十、下沉到内核:同样的四个套路
- 十一、这条路还没走完:源码里真实的坑
- 十二、速查表
一、站到一万米高空:一次「10 20 +」的完整旅行
1.1 我们要造的东西
先把目标说清楚:一个网络计算器 。客户端输入 10 20 +,服务端算出 30,把结果送回来。就这么一句话。
这一节我们先把地图摊开,看清全貌,后面再一层一层往下钻。这张图就是全文的目录,建议先花两分钟看明白它。
1.2 全景图:从键盘敲下回车,到结果打印出来
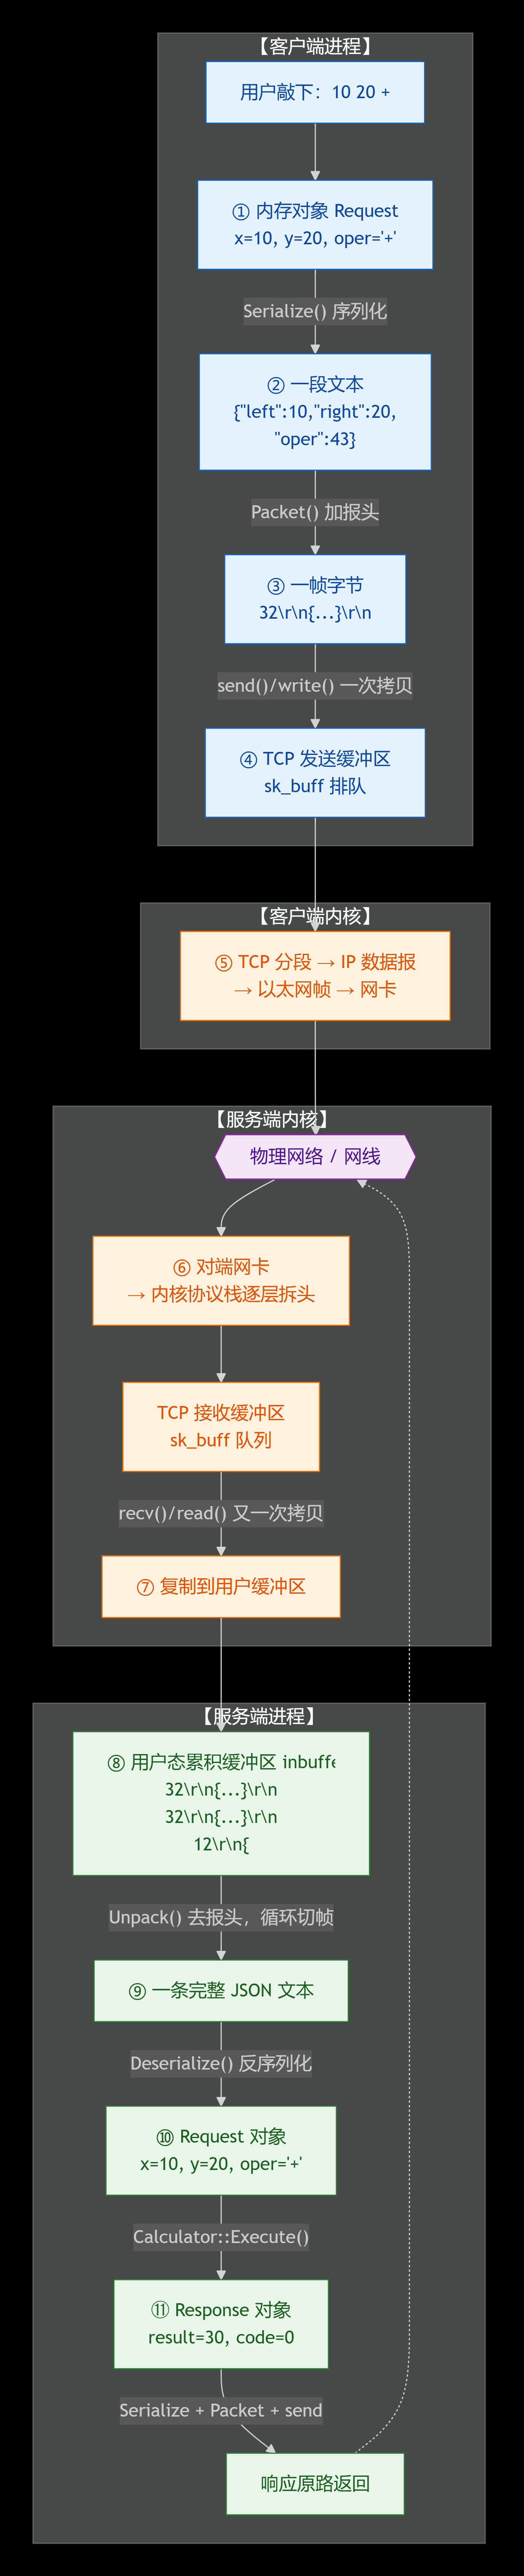
把这张图从头看到尾,你会发现一件很有意思的事:每一层都在做同样两件事------往下走的时候"加东西"(加结构、加报头),往上走的时候"减东西"(拆结构、去报头)。
这件事在网络里有正式的名字,叫封装与解封装(Encapsulation / Decapsulation) 。你其实早就见过它了:应用层加 len\r\n 报头,传输层加 TCP 报头(端口、序号、校验和),网络层加 IP 报头(源 IP、目的 IP、总长度),链路层加以太网帧头帧尾。每一层都认为自己送的是"数据",每一层都要为下一层补上自己那一段说明。
1.3 图里藏着三次"变形",也就是本文的三条主线
再仔细看这张图,真正容易出错、也最值得讲的是中间那三次"变形",它们对应三个完全不同的问题:
第一次变形(①→③):对象怎么变成字节? 内存里的 Request 有三个字段,要变成一串能上网的字节。这一步叫序列化,它解决的是"内容怎么摆"的问题。
第二次变形(③→⑧):一串字节流,怎么知道哪一段是一条消息? 对面的 TCP 给你的是一条连续不断的字节河,它不告诉你"这一条消息到这里结束了"。这一步叫定界 ,它解决的是"边界在哪里"的问题,由我们的应用层协议(Packet / Unpack)负责。
第三次变形(⑧→⑩):字节怎么变回对象? 对面收到一串字节,要还原成和自己一模一样的 Request。这一步叫反序列化 ,它比序列化多了一份麻烦------输入是不可信的。
这里必须强调一个极易被混淆的点:定界和序列化是两件互相正交的事,只是经常被一起提起。
- 定界回答的是"这一帧从哪里开始、到哪里结束"------像是"船多大";
- 序列化回答的是"这帧里面的字节怎么摆,对面才能还原出同样的对象"------像是"船上装什么"。
不信你看:Packet() 里那行 std::to_string(json_string.size()) + gsep + json_string + gsep,它对 json_string 的内容一无所知 ------里面装 JSON 也好,装图片也好,装纯文本也好,加头逻辑一个字都不用改。反过来,Serialize() 也完全不管自己产出的字符串最后会被谁加头、被切成几段发出去。两个模块各自只关心自己的那一半,这才叫"正交"。
1.4 本文的下行路线
全景看完了,接下来我们由大到小、由外到内,一层层往下钻:
内核给的到底是什么(第二章)
→ 边界怎么画出来(第三章)
→ 格子里的内容怎么摆(第四章)
→ 用什么格式摆最划算(第五、六章)
→ 我们自己的报文长什么样(第七章)
→ 代码怎么分层装起来(第八章)
→ 跑一遍看效果(第九章)
→ 同一套思想在内核里的四个实例(第十章)
→ 还没填上的坑(第十一章)
→ 速查表(第十二章)。
现在出发。第一站不是代码,而是内核------因为在动手写协议之前,我们得先搞清楚:我们的数据,在这条路上到底要经过哪些"关卡"。
二、把镜头拉近:内核为什么只肯给你一串字节
2.1 承上启下:先承认一个反直觉的事实
前面我们画了全景图,看到数据从用户程序往下走,穿过内核,穿过网线,再进到对面的内核和用户程序。
接下来我们要看的第一件事,可能会颠覆你的一个直觉:当你调用 write() 或 send() 成功返回时,你的数据根本还没有发到网络上。
write() 返回成功,只意味着"我把数据交给了操作系统",不意味着"对端收到了"。那数据去哪了?它进了内核里的一个缓冲区 。这一节我们就把这个缓冲区讲清楚------因为它是后面所有问题的源头:粘包、半包、字节流没有边界,全都从这里长出来。
2.2 传输层的两对缓冲区:write 和 read 的本质是拷贝
先记住两条关于 TCP 套接字的基本事实。
第一条:TCP 套接字是全双工的。 一个文件描述符,既能读也能写,互不干扰。原因很简单------通信的双方,各自都有一对缓冲区:
【客户端内核】                        【服务端内核】
   发送缓冲区     ──────────────→      接收缓冲区
   接收缓冲区     ←──────────────      发送缓冲区
       ↑                                   ↑
用户 write 往里放                    用户 read 从里拿
用户 read 从里拿 用户 write 往里放 第二条:write 和 read 的本质,都是"拷贝",不是"发送"和"接收"。
- 你调用
write(fd, buf, n),实际发生的是:把用户态buf里的 n 个字节,拷贝进内核的发送缓冲区。 - 你调用
read(fd, buf, n),实际发生的是:把内核接收缓冲区里的数据,拷贝到用户态buf里。
注意这个措辞的差别:真正的"发送"动作发生在内核里,由操作系统自主决定------什么时候发、一次发多少、出错了怎么办(重传、拥塞控制),这些全是内核的事,你的程序插不上手。
更准确地说:内核里管这件事的,是网络层 。所以"两个进程在通信"这个说法,从系统层面看并不准确------准确的说法是:两端的操作系统在替两个进程通信。你的进程只负责把数据交给自己的操作系统,以及从自己的操作系统那里取走数据。
2.3 换一个视角:write/read 其实是一个生产者-消费者模型
把上面的机制抽象一下,你会发现这是一个极其熟悉的模型:
- 生产者 :调用
write的用户进程。它往缓冲区里"放"数据。缓冲区满了怎么办?睡下等待 ------这就是write阻塞的原因。 - 消费者 :内核里的协议栈。它从缓冲区里"取"数据,交给网卡发出去。缓冲区空了怎么办?睡下等待。
- 数据从空变非空时,唤醒消费者;从满变不满时,唤醒生产者。
所以 write 和 read 为什么会阻塞?本质是用户进程和操作系统之间的一次同步。 你写下的每一行 send(),背后都是一次跨特权级的、带条件变量的握手。
这个模型后面还会反复出现:等一下你会看到,我们在用户态也会造一个缓冲区 (inbuffer),用完全一样的"生产者-消费者"模式来对付粘包和半包。内核在宏观上做的事,我们在微观上又做了一遍。
2.4 报文在内核里长什么样:sk_buff 与两条队列
现在往缓冲区里再看深一层。
缓冲区里躺着的是什么?是一个一个的报文 (从网卡收上来的,或者准备往网卡发出去的)。但内核不可能把"一堆字节"随便堆在那儿------它必须能管理这些报文:谁先谁后、属于哪个连接、该交给哪个协议处理、该往哪块网卡发。
于是内核设计了一个结构体来描述"一个正在内核里流动的网络包",它叫 sk_buff(socket buffer)。而所有的报文,被组织成两条队列,挂在 socket 上:
struct sk_buff_head sk_receive_queue;   // 接收队列:从网卡收上来、等着被用户 read 走的报文
struct sk_buff_head sk_write_queue;     // 发送队列:用户 write 进来、等着被协议栈发出去的报文
这里先只建立三个印象,第十节我们再把这个结构体彻底拆开:
- 内核里没有"字节流",只有"包"。 所谓字节流,是内核把一个个收到的报文按顺序拼起来、再交给你的结果;
- 每个包都是一个
sk_buff对象,它不复制数据,而是用几个指针"圈"出数据在内存里的范围; - 排队是内核管理报文的基本手段,收有收的队,发有发的队。
2.5 三条结论,以及本章真正的"问题"
把这一章的东西收束成三条结论:
结论一:TCP 支持全双工,通信双方各有一对缓冲区。
结论二:从系统级角度看,用户 write 是把数据拷进内核发送缓冲区,用户 read 是把数据从内核接收缓冲区拷出来------这本质是一个生产者-消费者模型;write/read 的阻塞,就是用户与操作系统的同步。
结论三:用户调用 write 成功返回之后,数据还没有出现在网络上。什么时候发、发多少、出错怎么办,由发送方操作系统自主决定。
现在,把结论三再往下推一步,本章真正的"问题"就浮出来了:
既然"什么时候发、发多少"完全由操作系统决定,那么应用程序写下去的"消息边界",内核是不知道、也不关心的。
你连续 send() 了三次、每次 10 字节。在内核眼里,那只是"我给缓冲区里塞了 30 个字节"。它完全可能把这 30 字节合成一个包发出去,也可能因为 MSS 限制切成 8+22 两个包,甚至可能因为你前面恰好还有别的数据,一起打包发走。
到了对面,用户进程调用 read() 拿数据时,拿到的就是内核交给它的一段字节 ------这段字节可能正好是一条消息,可能是三条消息粘在一起(粘包 ),也可能只有半条甚至半条的半条(半包)。
这就是网络编程里那个著名的"粘包问题"。
2.6 给"粘包"正个名
必须说清楚:"粘包"这个词其实并不严谨。 TCP 根本没有"包"的概念,它眼里的数据就是一条没有缝隙的字节流;既然没有"包",也就无所谓"粘不粘"。
准确的说法是:字节流不保留消息边界,而应用层需要边界。
顺带回答一个高频疑问:UDP 有粘包问题吗?没有。 因为 UDP 是面向数据报的(SOCK_DGRAM),它保留消息边界 ------你一次 sendto 发出去的是一个完整的数据报,对面一次 recvfrom 就收到一个完整的、边界清晰的报。代价是:UDP 会丢包、会乱序、超长会被截断,它只是不给你"拼不齐"的烦恼,却给了你别的烦恼。
这就是为什么"用 TCP 就必须自己写应用层协议,用 UDP 就不用"------因为边界这件事,TCP 拒绝替你管,UDP 替你管了。
2.7 承上启下
问题摆明了:TCP 只给字节流,边界必须由应用层自己定义。
那么下一个问题立刻来了:边界该怎么定义? 这是下一章的主题。
三、给字节流画格子:应用层协议登场
3.1 三种定界方案,以及为什么最终选"长度 + 内容"
要让接收方能判断"这一帧到哪里结束",工程上其实只有三条路可走。我们一条条看,顺便看看每条路的代价。
方案一:定长。 双方约定每条消息固定 100 字节,发送方不够就补空格,接收方每次都读 100 字节。这个方案简单到不需要任何解析代码,但极其浪费------发一个 1+1 也要占 100 字节;而且一旦哪天需要发的消息超过 100 字节,整个协议就得推翻重来。它只适合"消息长度天然固定"的场景。
方案二:特殊分隔符。 比如约定用 \n 结尾,接收方一直读到 \n 为止,就算一帧。很多文本协议(HTTP 的头部、SMTP)用这种思路。但它天生带着一个麻烦:万一消息内容里本身就包含这个分隔符呢? 那你必须引入"转义"机制(把内容里的 \n 写成 \\n),发送方要转、接收方要还原,转义规则一旦复杂起来协议就变得很脆;而且解析时得逐字节扫描,效率也不高。
方案三:长度 + 内容(自描述长度)。 在每条消息前面先说清楚"我这条正文有多少字节",接收方先读出长度,再按长度精确取走正文。
三个方案对比下来,只有第三种既支持任意长度、又不需要转义、还能一次算出边界在哪个位置 ------它不需要扫描内容,读一个长度就能把边界"算"出来。所以它成了工业界的绝对主流:HTTP 的 Content-Length、UDP 报头的长度字段、netlink 的 nlmsg_len,全是这个思路。
我们的项目选的就是方案三。
3.2 一帧长什么样:Packet() 加头
先看这个方案在源码里的落地。
const std::string gsep = "\r\n"; // 分隔符:回车+换行,用来隔开"长度"和"正文" 然后是加头函数。注意它的名字叫 Packet(打包),不叫 Serialize(序列化) ------这个命名很讲究,前面说过,它俩是两件不同的事:Packet 只负责"画格子",不关心格子里面装的是什么。
std::string Packet(const std::string &json_string)
{
    // 把正文的长度转成十进制字符串,前面拼上,再前后各加一个 \r\n
    // 例如正文 "{\"left\":10}" 有 10 字节,这里就产出 "10\r\n{\"left\":10}\r\n"
    return std::to_string(json_string.size()) + gsep + json_string + gsep;
}
于是一条完整的帧,由四段拼成:
 32  \r\n  {"left":10,"right":20,"oper":43}  \r\n
 ↑      ↑                 ↑                    ↑
长度串  分隔符           JSON 正文          结束分隔符
(2字节) (2字节)          (32字节)             (2字节)

整帧总长 = 2 + 2 + 32 + 2 = 38 字节
这里有三个细节值得掰开讲,每个都是真实的设计取舍。
细节一:为什么长度用十进制字符串("32"),而不是 4 字节二进制?
用二进制当然更紧凑(4 字节 vs 2~3 字节)、解析也更快(一条指令读出来)。但它有代价:必须约定字节序 (谁来 htonl?大端还是小端?),而且抓包时看到的是一串乱码,调试时很痛苦。用十进制字符串,好处是人能直接看懂 、跨平台没有字节序问题,代价只是多几个字节、解析时要 stoi。
对于一个教学项目、乃至很多真实的文本协议(HTTP 的 Content-Length 就是十进制字符串),这个取舍完全合理。记住这个对比,第十节你会看到内核在 UDP 报头里做的正好是相反的选择,而且那个选择同样合理。
细节二:为什么分隔符用 \r\n 而不是 \n?
\r\n(回车+换行)是 HTTP、SMTP 等经典文本协议的传统,好处是 telnet 上去手工调试时视觉上更清晰。但要老实说一句:在"长度前缀"方案里,分隔符不是必需的 。长度字段已经能算出一帧到哪里结束了,解析器非要去找 \r\n,只是为了给"长度"和"正文"之间留一个显眼的视觉分界罢了。
细节三:正文后面那个 \r\n 是冗余的。
同理,长度已经决定正文到哪结束,尾部再补一个 \r\n 在信息论上是多余的。保留它纯粹是为了抓包时帧的尾部肉眼可见。但这份"美观"是有代价的------解析时算总长度必须把它算进去:
int total = lenstr.size() + len + 2 * gsep.size();
//                                      ↑ 注意是 2,不是 1
// 一个 \r\n 在长度和正文之间,一个 \r\n 在正文末尾,两个都要算进整帧长度
一旦这里少算一个 \r\n,后面所有的解析都会错位------这是这类协议最典型的翻车方式。
再加一个小注:jsoncpp 的 FastWriter 生成的 JSON 文本末尾会自带一个 \n 。这个 \n 同样算在 json_string.size() 里,同样计入长度字段。所以如果你发现长度比肉眼数的多 1 字节,不用慌,那是 FastWriter 的"历史包袱"。
3.3 去头比加头难:Unpack 为什么必须返回三个状态
加头很容易,去头才是难点 ------因为接收缓冲区里的数据随时可能是不完整的。
在动手写代码之前,先想清楚一个问题:如果 Unpack 只返回 true/false,够不够用?
不够。因为接收方会遇到三种截然不同的情况:
- 缓冲区里确实有一条完整报文 → 成功取走,并且要继续看还有没有下一条;
- 缓冲区里的数据还不够拼出一条完整报文 → 什么都不能做,等下一次
recv追加数据; - 数据本身是坏的(比如长度字段是乱码)→ 这是真出错了。
如果只有 true/false,"数据还不够"和"真出错了"就分不开:
- 把"还不够"当成"出错"处理 → 收到半包时误判,可能直接关闭连接、丢弃缓冲区里已经辛苦攒好的数据;
- 把"出错"当成"还不够"处理 → 程序死死卡在那里,等一个永远不会到来的完整报文。
所以这里必须用三态返回值。 源码里的约定是这样的:
// 返回值语义(非常关键,务必记住):
//   ret > 0 :成功解出一条报文,*json_string 里是正文
//   ret == 0:数据还不够,这不是错误!什么都不做,等下次 recv
//   ret < 0 :真出错了
int Unpack(std::string &packet, std::string *json_string);
有了这个约定,我们来看完整实现,每一步都配上人话:
int Unpack(std::string &packet, std::string *json_string)
{
    // 缓冲区是空的 → 没数据可解,等同于"还不够"
    if (packet.empty())
        return 0;

    // 调用方连输出参数都没给 → 这是编程错误,不是数据问题
    if (json_string == nullptr)
        return -1;

    // 第一步:找第一个 \r\n,它的位置就是"长度串"的结尾
    auto pos = packet.find(gsep);
    if (pos == std::string::npos)
        return 0;   // 连分隔符都没找到 → 报头都没收全,等下次

    // 第二步:把分隔符前面那截取出来,就是长度串,比如 "32"
    std::string lenstr = packet.substr(0, pos);
    // ⚠️ 源码在这里留了一行 TODO:
    //    "lenstr 合法性判断,lenstr -> 123 345"
    //    也就是说,作者自己知道这里缺了校验。这个坑第十一章专门讲

    // 第三步:字符串长度 → 整数长度
    int len = std::stoi(lenstr);

    // 第四步:算出一整帧的总字节数
    //   lenstr.size()   长度串本身占的字节("32" 是 2 字节)
    // + len             正文占的字节
    // + 2*gsep.size()   两个 \r\n 各占 2 字节,共 4 字节
    int total = lenstr.size() + len + 2 * gsep.size();

    // 第五步:缓冲区里的字节够不够一整帧?
    if (packet.size() < total)
        return 0;   // 不够 → 半包,等下次 recv,一个字节都别动它

    // 第六步:从第一个 \r\n 之后开始,精确取 len 个字节,这就是正文
    *json_string = packet.substr(pos + gsep.size(), len);

    // 第七步:把这整帧从缓冲区里删掉
    //   erase(0, total) 的意思是"从下标 0 开始,删掉 total 个字节",
    //   剩下的内容(可能是下一条报文的开头)会自动顺移上来,留给下一轮
    packet.erase(0, total);

    return 1;   // 成功解出一条
}
这段代码里有两个设计精华,值得单独拎出来记住。
精华一:return 0 的时候,缓冲区一个字节都不动。
不管是"报头没收全"还是"正文没收全",函数都原样返回,packet 纹丝不动。这个"不动"是刻意的------半包数据必须原地保留,等下次 recv 追加新数据后接着拼。 如果你在这里"好心"把已读的部分删掉,半包就永远拼不起来了。
精华二:erase 只删已经消费掉的那一整帧。
处理完一帧就精确删掉一帧的长度,剩下的部分(下一个报文的开头)留在缓冲区里继续等。加上前面"不够就返回"的策略,这两条合起来,实际上构成了一个生产者-消费者模型 :Recv 往缓冲区尾部追加 字节(生产),Unpack 从缓冲区头部精确摘走完整帧(消费)。缓冲区就像一条传送带。
你看,2.3 节里内核干的事,我们在用户态又干了一遍------只是粒度从"报文"变成了"帧"。
3.4 半包的代码解法(一):Recv 里的那个 +=
现在把镜头切到网络层,看看字节是怎么进到这条"传送带"上的。
int Recv(std::string *out) override
{
    char inbuffer[1024];
    // 一次最多读 1023 字节(留一个字节给结尾的 '\0',后面要当 C 字符串用)
    ssize_t n = recv(_sockfd, inbuffer, sizeof(inbuffer) - 1, 0);
    if (n > 0)
    {
        inbuffer[n] = 0;    // 手工补字符串结束符
        *out += inbuffer;   // ★★★ 注意这里是 +=(追加),不是 =(覆盖)
    }
    return n;
}
这一个 +=,就是半包问题在代码层面的一半答案。
假如把它写成 *out = inbuffer(每次覆盖),会怎么样?上一次 recv 收到的半条报文,会被这一次的新数据直接覆盖掉,半包永远拼不起来,粘包/半包问题永久无解。
用 += 之后,缓冲区变成了一个会增长的累积体:
第 1 次 recv(18字节):拿到 "32\r\n{\"left\":10,\"ri"        ← 半包
第 2 次 recv(20字节):拿到 "ght\":20,\"oper\":43}\r\n"      ← 补全了
累积后:               "32\r\n{\"left\":10,\"right\":20,\"oper\":43}\r\n"
然后 Unpack 一算:total = 2 + 32 + 4 = 38,缓冲区正好 38 字节,够,切走。
顺带看一个容易被忽视的细节:char inbuffer[1024] 意味着单次 recv 最多只能拿回 1023 字节 。所以哪怕你不考虑任何极端情况,只要一条 JSON 报文超过 1023 字节,它就必然被切成多次 recv 才能收完。
这句话值得再说一遍:半包不是"可能发生的意外",而是"迟早会发生的事实"。
3.5 粘包的代码解法:while(true) 循环解到底
半包的问题解决了(+= 攒着 + 不够就不动),接下来是它的孪生兄弟:粘包 ------一次 recv 可能带来 N 条报文(N 可以是 0、1、3、10......)。
怎么办?循环解包,一条都不能漏。
这就是服务端 ParseRequest 里那个 while(true) 的全部意义。我们在第八章会看它的完整实现,这里先记住它的骨架:"解包 → 反序列化 → 处理 → 打包应答"这四步,要在一个死循环里反复做,直到 Unpack 明确告诉你"没有完整帧了"(返回 0)才退出。
这也顺带解释了一个设计细节:为什么 Unpack 的返回值里,"成功解出一条"必须是一个正数 而不是 true?因为调用方需要在一个循环里反复调用它,只有"成功/不够/出错"三态齐全,循环才能写出正确的退出条件。
3.6 局部小结与承上启下
到这里,第一个大问题(怎么定界)彻底解决了。我们用到的全部工具就是三样:
Packet:加头,把正文变成len\r\n正文\r\n的一帧;Unpack:去头,三态返回,"不够"时一个字节都不动;Recv的+=与while(true)循环:分别对付半包和粘包。
现在,缓冲区里已经能精确切出一条完整的文本了:
{"left":10,"right":20,"oper":43} 下一个问题顺势而来:为什么是这个样子? 为什么不是 "10 20 +" 这种更省事的写法?为什么不是干脆把内存里的 Request 结构体原封不动发过去?
这就要请出本章标题里的另一半------序列化了。
四、格子里的内容怎么摆:序列化登场
4.1 一个天真但致命的方案
前面我们辛苦地把边界画出来了,现在格子里躺着一串字节。问题是:这串字节应该长什么样?
先别急着谈 JSON。假设我们什么库都不用,最直觉的做法会是什么?
我们有一个这样的结构体(先看个大概,第七章会详细设计它):
class Request {
public:
    int  _data_x;   // 左操作数
    int  _data_y;   // 右操作数
    char _oper;     // 运算符
};那么"把请求发出去"最直觉的写法就是:把这个结构体在内存里的样子,原样倒到网线上。
// ⚠️ 危险示范,千万不要这么写
Request req(10, 20, '+');
send(sockfd, &req, sizeof(req), 0);   // 把这一块内存的字节原样倒出去
对面收到之后,同样暴力地强转回来:
// ⚠️ 同样危险
Request *req = (Request *)buffer;
int result = req->_data_x + req->_data_y; // 看起来能跑?在同一台机器、同一个编译器、同一套编译选项下,这段代码甚至真的能跑通。可一旦环境变了,它就会以各种匪夷所思的方式崩掉。为什么?下面五条理由,每一条都足以判它死刑。
4.2 不能直接发结构体的五条理由
理由一:内存对齐与填充字节,让"内存布局"变成一个不确定的东西。
不用背复杂的对齐规则,看一个例子就够了:
struct A {
    int  x;     // 4 字节
    char c;     // 1 字节
    int  y;     // 4 字节
};
std::cout << sizeof(A);   // 你猜是多少?
很多人的第一反应是 9。但实际输出通常是 12 。因为编译器为了让 y 落在 4 字节边界上(对齐后 CPU 读取更快),会在 c 后面塞进 3 个填充字节:
偏移:  0    1    2    3    4    5    6    7    8    9   10   11
内容: [x    x    x    x ][c ][pad pad pad][y    y    y    y ]
↑ 这 3 个字节是垃圾数据,内容取决于当时内存里的残留值 于是就出问题了:填充字节里的内容是不确定的 ,你把整个结构体发过去,等于把栈上的垃圾数据也一起发了过去。更糟的是,不同的编译器、不同的编译选项(比如 #pragma pack)、32 位与 64 位平台,填充规则都可能不一样------A 机器上 sizeof 是 12,B 机器上可能是 9,两端对不齐,解析必然错位。
理由二:字节序(大小端)。
int x = 10; 在内存里占 4 个字节。到底是 00 00 00 0A(大端)还是 0A 00 00 00(小端)?这取决于 CPU 架构。x86 是小端,很多 ARM 可以配置,而网络协议统一采用大端。
你直接发内存,就等于把自己机器的字节序也一并发过去了。 如果对面是另一种字节序,它读出来的 10 会变成 167772160。
理由三:指针。
这一条最要命。如果结构体里有指针:
struct BadMsg {
    char *name;   // 指针
    int   len;
};
你发过去的 8 个字节,是指针的值 ------也就是"某个地址"。但这个地址是你进程虚拟地址空间里的地址,在对方进程里毫无意义,甚至对方进程的那个地址上压根没有映射物理内存。
指针是不能被序列化的,它没有跨进程、跨主机的意义。 能被传输的只有"数据本身",不能是"数据在哪"。
理由四:类型宽度不统一。
long 在 32 位系统上是 4 字节,在 64 位 Linux 上是 8 字节,size_t 同理。直接把内存倒过去,两端对"这个字段多长"的理解就不一致。
理由五:演进与跨语言。
今天 Request 有三个字段,明天产品说"再加一个优先级字段"。你在结构体末尾加一行,所有老客户端立刻全废------它们发来的字节少 4 个,新服务端按新布局解析就会越界。
更别提跨语言:服务端是 C++,客户端是 Python 或 Java(这太常见了)。Python 根本不认识 C++ 结构体的内存布局,你怎么把 Request 的对象内存交给它?
4.3 序列化的定义:为数据造一门"共同语言"
把上面的教训总结成一句话:
序列化(Serialization):把内存中的对象,转换成一种"与平台无关、与语言无关"的字节序列。 反序列化(Deserialization):把这个字节序列,还原成内存中的对象。
关键词是**"与平台无关"**。序列化要做的,正是把 4.2 里的五个问题一个个消灭掉:
- 用明确的文本格式 (或明确的字节序约定)消灭对齐与字节序问题;
- 用不带动地址的纯数据 消灭指针问题;
- 用自描述的键值结构 (
"left": 10,键名就写在数据里)消灭"两端结构体布局必须完全一致"的问题------对面多认一个字段、少认一个字段,都不影响它读到left; - 用跨语言的通用格式 消灭语言壁垒。
所以序列化的本质,是为数据定义一门"共同语言":数据在两台机器之间传递时,不再说各自的方言(本机内存布局),而是统一说普通话(约定的序列化格式)。
4.4 反序列化:逆运算,但多了一个"信任问题"
反序列化看起来只是"反着来一遍",但它比序列化多了一层麻烦:输入是不可信的。
序列化的时候,数据是你自己的对象,你有完全的控制权,怎么写都是对的。反序列化的时候,数据是从网络上来的,它可能是:
- 残缺的 (半包)------这个我们已经在
Unpack那里拦住了; - 格式错的(对面程序有 bug,或者根本不是我们的客户端);
- 恶意的(有人手工构造了一个畸形报文)。
所以反序列化的第一件事不是"解析",而是"先判断能不能解析"。这也是为什么源码里 Deserialize 的返回值是 bool:
bool Deserialize(std::string &in); // 返回 false = 解析失败,别信这条数据 这个 bool 不只是个返回值,它是一条纪律:凡是来自网络的输入,在使用之前都必须校验。
4.5 插叙:内核其实一直在做序列化------从 sockaddr_in 说起
道理讲完了,但在挑序列化格式之前,我想先插一段题外话。因为它能给你一个最朴素的参照系:序列化不是"网络编程里的新东西",而是"数据在不同表示形式之间转换"这件事的通用名字------内核自己就一直在做。
回忆上一篇文章讲过的 bind() / connect(),它们都需要一个地址参数。而"地址"这个东西,在我们的程序里同时以三种形态存在:
- 形态一,给人看的 :字符串
"192.168.1.1"和端口号8080; - 形态二,给内核看的 :
struct sockaddr_in,一块固定布局的二进制内存; - 形态三,给网线看的:一串大端字节序的字节。
这三种形态之间的每一次转换,本质上都是一次手工的序列化或反序列化。我们一个个看。
先说 sockaddr_in 这个结构体。它为什么长这样?它要解决的是这样一个问题:
socket API 必须支持多种协议族,它们的地址格式各不相同。但
bind()、connect()这些函数的参数类型必须是统一的 ------否则每支持一种协议,就要新增一套 API。怎么办?答案是定义一个"通用地址"struct sockaddr,让每种具体协议的地址结构体都跟它一样大,用的时候强转。
这个需求直接决定了它的字段:
struct sockaddr {              // 通用地址(相当于"基类",本身几乎不用)
    sa_family_t sa_family;     // 2 字节:地址族
    char        sa_data[14];   // 14 字节:地址内容,具体含义由协议族决定
};                             // 总共 16 字节

struct sockaddr_in {           // IPv4 专用地址
    sa_family_t    sin_family; // 2 字节:地址族,填 AF_INET
    in_port_t      sin_port;   // 2 字节:端口号 ------ 必须是【网络字节序】
    struct in_addr sin_addr;   // 4 字节:IPv4 地址 ------ 必须是【网络字节序】
    char           sin_zero[8];// 8 字节:纯填充!没有任何数据含义
};                             // 2+2+4+8 = 16 字节,和 sockaddr 正好一样大
重点看最后那个 sin_zero[8]:它是纯粹为了"凑大小"而存在的。 前三个字段加起来才 8 字节,离 16 还差 8,所以补 8 个字节。补到 16 之后,sockaddr_in* 才能安全地强转成 sockaddr* 传给系统调用。
你看,这个字段的存在理由不是"存了什么数据",而是"为了让布局对齐、让类型转换安全"------设计结构体的时候,先想清楚"要解决什么问题",字段自然就长出来了。 这正是我们在 sockaddr_in 里看到的,也是后面设计 Request / Response 时要用的方法。
有了它,源码里那个宏就好理解了:
// 把具体协议地址强转成通用地址类型,喂给 socket 系统调用
#define CONV(address) ((struct sockaddr *)address)
现在再看那三次转换,你会发现它们全是"序列化"。
转换一:主机字节序 → 网络字节序。
_address.sin_port = htons(_port);   // h->n:host to network,short(16位)
// 在小端机器上,htons 实际做的事就是"把两个字节翻个面"
// 例如端口 8080 = 0x1F90,内存里小端是 [90 1F],翻成 [1F 90] 才是网络序 为什么要有这一步?因为网络协议统一规定用大端 ,而 x86 是小端。htons 做的正是"把我这台机器内部的表示,转成网络上的通用表示"------这不是序列化是什么?数据没变(还是 8080),只是表示形式变了。
转换二:字符串 IP → 4 字节二进制。
inet_pton(AF_INET, ip.c_str(), &(_address.sin_addr));
// p = presentation(表示形式,人看的字符串)
// n = numeric(数值形式,网线上跑的 4 字节)
// "192.168.1.1" → [C0 A8 01 01]
转换三:4 字节二进制 → 字符串 IP(反序列化)。
char ipstr[32];
inet_ntop(AF_INET, &(_address.sin_addr), ipstr, sizeof(ipstr));
_ip = ipstr;
_port = ntohs(_address.sin_port);   // 网络序 → 主机序,反向再翻一次面
注意源码里把 inet_ntoa 注释掉了,改用 inet_ntop。原因上一篇文章讲过:inet_ntoa 用的是静态缓冲区,多线程下会互相覆盖,是个线程安全的坑 ;inet_ntop 由调用方提供缓冲区,安全。这个改动本身,就是"反序列化要注意线程安全"的一个真实实例。
插叙小结一下:序列化不是网络编程的专利,它是"数据在不同表示形式之间转换"的通用名字。你写 htons、inet_pton 的时候,其实已经在做序列化了。区别只在于:sockaddr_in 的格式是固定的、位精确的、二进制 的,而我们接下来要选的 JSON 格式是灵活的、文本的、自描述的。
顺便留一个思考题:如果把 sockaddr_in 改用 JSON 来传,它会变成 {"family":"AF_INET","port":8080,"ip":"192.168.1.1"}------可读性暴涨,体积也暴涨,而且内核根本不可能去解析文本。这就是"位精确二进制"与"自描述文本"的分界线:越靠近硬件、越追求效率的地方,越用前者;越靠近人、越追求灵活的地方,越用后者。
4.6 承上启下
道理讲完了。现在的问题是:用什么格式来做序列化? 自己拼字符串行不行?JSON、XML、protobuf 又该怎么选?这是下一章的内容。
五、挑一门"共同语言":手搓、JSON、XML 与 protobuf
5.1 先看"自己做"为什么不可以
// 1. 自己做 - 不建议的!
// 2. 用别人的 - json protobuf xml
"自己做"长什么样?大概就是把三个字段拼成一个字符串:
// 手工拼接:用空格分隔,运算符放中间
// 10 20 '-'  →  "10 - 20"
std::string s = std::to_string(_data_x) + " " + _oper + " " + std::to_string(_data_y);
对面再用 sscanf 或者 stringstream 把它拆开。这在小项目里能跑,但它有一堆隐患:
- 分隔符冲突:万一哪个字段里出现了空格呢?我们现在三个字段分别是整数和单个字符,恰好安全;但业务一变(比如要传一个字符串参数),立刻爆炸。
- 解析歧义 :
"10 - 20"和"10 -20"是一个意思吗?负数怎么处理? - 没有字段名:位置就是含义。想加字段?只能加在末尾,中间插一个就全乱套。
- 没有类型 :
"10"到底是数字还是字符串?不知道。 - 解析代码很脆 :
sscanf的返回值、stringstream的失败状态,全都得小心处理。
更麻烦的是:每加一个协议,你就要手写一套这样的解析代码。 这是典型的"重复造轮子,并且造不好"。
5.2 我们为什么选 JSON
用 JSON 纯粹是图方便。日志里直接能读明文,不用像 protobuf 那样看着乱码还得折腾解码工具;不用维护 .proto 和代码生成,加字段直接改。体积在这场景根本没影响,一次请求就几十字节,多几个键名还没 TCP/IP 头大,完全无所谓。
选择序列化方案的判断标准,从来不是"哪个更先进",而是"我的场景最在意什么"。 这就是为什么今天 JSON 和 protobuf 都活得好好的------它们服务的是完全不同的场景。
5.3 承上启下
选定了 JSON,接下来的问题就非常具体了:在 C++ 里怎么用 JSON? 这是下一章的内容。
六、把库用起来:jsoncpp 三件套
C++ 标准库没有 JSON(这是 C++ 程序员长期的痛),我们用第三方库 jsoncpp 。Ubuntu 下 sudo apt install libjsoncpp-dev 安装,编译时加 -ljsoncpp。
#include <jsoncpp/json/json.h>
// 部分系统上路径是 <json/json.h>,取决于安装方式
这个头文件路径是"我代码明明没问题却编译不过"的头号原因。 如果报 No such file or directory,先用 find /usr/include -name "json.h" 找一下实际位置。
jsoncpp 的接口非常精简,核心就三样东西:一个容器(Json::Value)、一个读工(Json::Reader)、一个写工(Json::Writer)。
6.1 Json::Value:为什么需要一个"万能类型"
这是 jsoncpp 里最重要的类型。理解它的关键,是先理解它要解决的矛盾:
C++ 是静态类型 语言------变量声明的时候类型就定死了,
int就是int,std::string就是std::string。 但 JSON 是动态类型 的------同一个{}里面,"age"是数字,"name"是字符串,"scores"是数组,"info"又是另一个对象。类型是跟着数据走的,不是跟着声明走的。
这个矛盾怎么解?答案是:造一个"什么都能装"的容器类型,自己记录"我现在到底是什么"。 Json::Value 扮演的就是这个角色------它内部存了一个类型标记,你往里塞什么,它就变成什么类型。
用法极其直观:
Json::Value root;                 // 创建一个空的 Value
root["name"] = "zhangsan";        // 塞字符串 → 它变成 object,并多了一个键 "name"
root["age"]  = 18;                // 塞整数
root["sex"]  = "man";
// 现在它就等价于:{"name":"zhangsan","age":18,"sex":"man"}
它可以嵌套,因为 Json::Value 本身又能作为值塞进另一个 Json::Value:
Json::Value stu;                  // 学生:一个对象
stu["name"] = "zhangsan";
stu["age"]  = 18;

Json::Value score;                // 成绩:另一个对象
score["math"]    = 88;
score["chinese"] = 98;

Json::Value one;                  // 把两个对象组装成一个大对象
one["who"]   = stu;
one["score"] = score;
// 结果:{"who":{"name":"zhangsan","age":18},"score":{"math":88,"chinese":98}} 还能当数组用------append 就是往数组末尾追加元素:
Json::Value root;
for (int i = 0; i < 10; i++) {
    root.append(one);      // 追加 10 次,root 变成一个 JSON 数组
}
取值时用 asXxx() 系列方法做转换:
std::string name = root["name"].asString();   // 当字符串读
int age = root["age"].asInt(); // 当整数读 这里有一个必须知道的特性:asInt() 做的是"尽力转换",不是"严格校验"。 如果这个键根本不存在,root["missing"] 会返回一个"空 Value",asInt() 给你 0,asString() 给你 ""------不报错,也不抛异常。
这既是方便(不用写一堆空值检查),也是陷阱:字段名拼错一个字母,你不会得到任何报错,只会得到一个 0。 所以反序列化之后做一次字段存在性检查(root.isMember("left"))是个好习惯。
6.2 反序列化工具:Json::Reader
从字符串解析出 Json::Value,用 Json::Reader:
Json::Reader reader;              // 造一个解析器
Json::Value  root;                // 准备接结果
bool parseok = reader.parse(json_string, root);   // 字符串 → Value
if (!parseok) {
    // ★ 关键:一定要检查返回值!
    // 网络上传来的数据是不可信的,解析失败是完全正常的事情
    return false;
}
// 解析成功,现在可以取值了
std::string name = root["name"].asString();
reader.parse() 还有一个重载可以拿到具体的错误信息:
Json::Value root;
Json::Reader reader;
JSONCPP_STRING err;               // 老版本是 std::string
reader.parse(json_string, root, err);
// err 里会有形如 "* Line 1, Column 12 Missing ',' or '}'" 的定位信息这在调试序列化问题的时候极其有用------比"解析失败了"这四个字有用一万倍。
6.3 序列化工具:三种 Writer,以及怎么选
反方向,把 Json::Value 变成字符串,jsoncpp 提供了三种 Writer,区别只在"输出格式好不好看"。
第一种,Json::FastWriter------紧凑输出
Json::FastWriter writer;
std::string s = writer.write(root);
// 输出:{"name":"zhangsan","age":18}
// ★ 没有多余的空白和换行,一行搞定,最省流量
// ★ 注意:结尾会带一个 '\n'(历史包袱,接收方要么容忍,要么 trim 掉) 第二种,Json::StyledWriter------格式化输出(给人看的)。
Json::StyledWriter writer;
std::string s = writer.write(root);
// 输出:
// {
//    "name" : "zhangsan",
//    "age" : 18
// }
// 适合打日志,不适合发网络(多出来的空格换行全是流量) 第三种,Json::StreamWriterBuilder------新版推荐方式。
Json::StreamWriterBuilder wbuilder;
std::unique_ptr<Json::StreamWriter> swriter(wbuilder.newStreamWriter());
std::stringstream ss;
swriter->write(root, &ss);
std::cout << ss.str() << std::endl;
// 优点:可以通过 wbuilder 的 settings 精细控制缩进、精度等参数
怎么选?一句话:要发到网络上的用 FastWriter(省流量),要打日志给人看的用 StyledWriter。
这也是 testjson/test.cpp 这个文件存在的意义------它是一个专门用来试各种写法的练习场,把注释里的代码一块块放开试,比看文档快得多。
还有一个"野路子":root.toStyledString() 一行搞定。但源码注释里明确写着 "不推荐"------因为它内部实现依赖全局状态,线程安全性存疑。
6.4 承上启下
到这里,JSON 库的用法已经齐了:Value 装数据,Reader 解析,Writer 生成。
但库只是工具。真正要设计的是我们自己的报文结构体------里面放哪些字段、每个字段用什么类型、遇到错误怎么表达。这是下一章的内容。
七、设计我们自己的报文:Request 与 Response
7.1 先问需求,再定字段
设计任何结构体之前,都应该先问一句:这个东西要解决什么问题? 字段不是拍脑袋想出来的,是被需求逼出来的。
一次远程计算请求,要能被对面的服务端独立、完整地理解并执行 ,它至少需要携带三样信息:左操作数、右操作数、运算符。这三个东西合在一起,才能唯一确定一次二元运算------少一个都算不了。
而服务端的应答需要携带两样信息:计算结果 ,以及状态码。
第二样是设计的关键点,我们等一下展开。先看请求。
7.2 Request:三个字段,以及为什么要自己会序列化
class Request
{
public:
    Request() : _data_x(0), _data_y(0), _oper(0) {}   // 默认构造:全 0
    Request(int x, int y, char oper) : _data_x(x), _data_y(y), _oper(oper) {}

    bool Serialize(std::string *out);      // 对象 → JSON 字符串(把自己摊开)
    bool Deserialize(std::string &in);     // JSON 字符串 → 对象(把自己装回来)

public:
    // 10 20 '-' → 表示算 10 - 20 = ?
    // 约定:_data_x、_oper、_data_y 这个三元组唯一确定一次运算
    int  _data_x;   // 左操作数
    int  _data_y;   // 右操作数
    char _oper;     // 运算符:'+' '-' '*' '/' '%'
};
为什么把 Serialize / Deserialize 做成这个类自己的成员函数? 因为" 怎么把自己变成字节 "是这一类自己的知识。协议一旦升级(比如加个字段),只需要改这一个类,所有用到它的地方自动跟上。这就是"数据 + 行为绑定",避免了"序列化逻辑散落在各个业务文件里"的混乱。
看 Serialize 的实现:
bool Serialize(std::string *out)
{
    // 1. 造一个 JSON 对象(Json::Value 就是那个"万能容器")
    Json::Value root;
    root["left"]  = _data_x;    // 左操作数 → 键名 "left"
    root["right"] = _data_y;    // 右操作数 → 键名 "right"
    root["oper"]  = _oper;      // 运算符   → 键名 "oper"  ← 这一行有故事,见 7.3

    // 2. 用 FastWriter 序列化成紧凑的一行字符串
    Json::FastWriter writer;
    *out = writer.write(root);  // 输出用指针参数:把结果写回调用方给的字符串

    return true;                // 目前恒为 true,保留返回值是给未来留的余地
}
再看对应的 Deserialize:
bool Deserialize(std::string &in)
{
    Json::Value  root;
    Json::Reader reader;

    // 1. 解析。★ 一定要检查返回值,因为 in 来自网络,完全可能不是合法 JSON
    bool parsesuccess = reader.parse(in, root);
    if (!parsesuccess)
        return false;           // 解析失败 → 明确告诉调用方"别信这条数据"

    // 2. 从 Value 里按键名把字段取回来
    //    这里的 asInt() 是"尽力转换":键不存在会静默返回 0,不会报错
    _data_x = root["left"].asInt();
    _data_y = root["right"].asInt();
    _oper   = root["oper"].asInt();

    return true;
}
注意 Serialize 用指针 做输出参数(std::string *out),而 Deserialize 用引用 做输入参数(std::string &in)。这个风格上的不对称,第十一章会作为一个小改进点来谈。
7.3 一个真实的坑:char _oper 进了 JSON 会变成什么?
上面 Serialize 里有一行 root["oper"] = _oper;,看起来人畜无害,但它的实际行为和你的直觉不一样。
直觉上,我们希望 JSON 里是:
{"left":10, "right":20, "oper":"+"}但实际的输出是:
{"left":10, "right":20, "oper":43} 43 是哪来的? 是字符 '+' 的 ASCII 码。
原因在于 Json::Value 的重载集合。它提供了针对 int、unsigned、int64、double、bool、const char*、std::string 的赋值版本,但偏偏没有针对 char 的版本。而 C++ 的重载决议规则里,char → int 属于整型提升 (Promotion,优先级高),char → bool 属于布尔转换 (Conversion,优先级低)。规则规定提升优于转换,于是 char 被提升成 int,以整数的身份写进了 JSON。
那么问题来了:这算 bug 吗? 严格说,不算,因为它是可逆的:
- 序列化时:
'+'(值 43)→ 写成 JSON 数字43; - 反序列化时:
root["oper"].asInt()得到43→ 赋给char _oper→ 隐式转回字符'+'。
一来一回,值是对的,程序能正常跑。但它留下两个隐患:
隐患一,可读性损失。 抓包或看日志时,你看到的是 "oper":43,得在脑子里查 ASCII 表才知道是加号。JSON 作为文本协议最大的优势(人可读),在这里被丢掉了。
隐患二,契约模糊。 这个字段到底应该被理解成"数字 43"还是"字符 '+'"?将来换一门语言实现客户端(比如 Python),对面拿到 43 大概率会当成整数处理,然后 43 == '+' 在 Python 里是 False------跨语言实现时就翻车了。
正确的做法是明确转成单字符串:
root["oper"] = std::string(1, _oper);   // 用单个字符构造一个 std::string
// 输出:{"left":10,"right":20,"oper":"+"}   ← 清晰、无歧义、跨语言安全
// 对应地,反序列化时要改成:
// _oper = root["oper"].asString()[0];
这个坑的普遍意义是:序列化时,每个字段的"线上类型"应该是被明确设计过的,而不是"碰巧被编译器推导出来的"。 C++ 的隐式类型转换在这里悄悄替你做了决定,而你应该把它显式地写出来。
验证方法:把
Request req(10, 20, '+')序列化后的结果打印出来,看看oper后面是"+"还是43。凡是涉及隐式转换的地方,都值得亲自跑一遍验证。
7.4 Response 为什么要两个字段:因为不是每次计算都有结果
现在看应答。
class Response
{
public:
    Response() : _result(0), _code(0) {}
    Response(int result, int code) : _result(result), _code(code) {}

    bool Serialize(std::string *out)
    {
        Json::Value root;
        root["result"] = _result;   // 计算结果
        root["code"]   = _code;     // 状态码
        Json::FastWriter writer;
        *out = writer.write(root);
        return true;
    }

    bool Deserialize(std::string &in)
    {
        Json::Value  root;
        Json::Reader reader;
        if (!reader.parse(in, root))    // 解析失败要返回 false
            return false;
        _result = root["result"].asInt();
        _code   = root["code"].asInt();
        return true;
    }

public:
    int _result;   // 结果
    int _code;     // 状态码
};
为什么"结果"和"状态码"必须分开? 因为不是每次计算都有结果。
想想 10 / 0 这种情况:算不出来。但这又不是一个"错误"------它是完全合法的输入,服务端应该礼貌地说"你这个运算我做不了,原因是除零",而不是默默返回一个 0(0 也可能是一个合法的计算结果!),更不该干脆断开连接。
所以应答必须能表达两种状态:
- 成功 :
{"result":30, "code":0}------ 结果有效,看_result; - 失败 :
{"result":0, "code":1}------ 结果无效,看_code解释原因。
用 _code 的值来编码失败原因 ,这是分布式系统里极其常见的做法(例如:HTTP 状态码)。一个能表达失败细节的协议,才是一个能被诊断的协议。
7.5 Calculator::Execute:状态码是从业务分支里长出来的
状态码不是凭空定的,它由业务逻辑里所有可能失败的分支决定。
Response Execute(const Request &req)
{
    Response resp;              // 默认构造:_result=0, _code=0(0 表示成功)
    switch (req._oper)
    {
    case '+':
        resp._result = req._data_x + req._data_y;
        break;                  // _code 保持 0 → 成功
    case '-':
        resp._result = req._data_x - req._data_y;
        break;
    case '*':
        resp._result = req._data_x * req._data_y;
        break;
    case '/':
    {
        if (req._data_y == 0)
            resp._code = 1;     // 错误码 1:除数为 0
        else
            resp._result = req._data_x / req._data_y;
    }
    break;
    case '%':
    {
        if (req._data_y == 0)
            resp._code = 2;     // 错误码 2:取模的除数为 0
        else
            resp._result = req._data_x % req._data_y;
    }
    break;
    default:
        resp._code = 3;         // 错误码 3:不认识的运算符
        break;
    }
    return resp;
}
把状态码整理一下:
_code |
含义 | 触发条件 |
|---|---|---|
| 0 | 成功 | 默认值。所有正常计算路径都不会改它 |
| 1 | 除零错误 | '/' 且右操作数为 0 |
| 2 | 取模除零 | '%' 且右操作数为 0 |
| 3 | 非法运算符 | switch 走到了 default |
注意 '/' 和 '%' 的除零被分成了两个不同的错误码(1 和 2)。 虽然都是除零,但对定位问题的人来说,信息量不一样。这是"错误码的粒度,要按使用者的诊断需要来定"的一个小示范------太粗(全都叫"出错了")没法定位,太细(每个分支一个码)又没人记得住。
还有一点值得特别注意:Calculator 完全不知道 JSON、不知道 socket、不知道协议的存在。 它只接收一个 Request 对象,返回一个 Response 对象。这叫业务逻辑与通信细节解耦------它是下一章"分层"的基础,也是整个项目能保持清晰的原因。
7.6 承上启下
到这一步,零件都齐了:
Request/Response:会自己序列化和反序列化;Calculator:会算数,但不懂网络;Protocol:会切帧、会打包,但不懂业务;TcpSocket/TcpServer:会收发字节,但不懂"报文"。
下一章的问题就是:怎么把它们拼起来,而且不要让它们互相知道对方的细节?
八、把零件装起来:分层、回调与两条流水线
8.1 先想清楚"不能怎么做"
上一章我们把零件凑齐了:序列化的、算数的、切帧的、收发字节的。
现在到了组装环节。在动手之前,先想清楚一个"绝对不能这么做"的方案:让 TcpServer 直接去调用 Calculator。
为什么不行?因为这样一来,网络模块从此就依赖了业务模块 。将来你想用同一个 TcpServer 去写个聊天室服务、写个文件传输服务,就必须去动网络模块的代码------一个本来跟业务毫无关系的模块,被业务"污染"了。这就是耦合。
正确的思路是:每一层只干自己的事,彼此之间通过一层薄薄的"接口"说话。具体怎么做?分两步。
8.2 第一步:分层------三层各管一段
先把职责切开:
┌─────────────────────────────────────────────────────┐
│  业务层  Calculator
│  会算数;只知道 Request / Response,完全不知道网络的存在
├─────────────────────────────────────────────────────┤
│  协议层  Protocol(+ Request / Response)
│  会切帧、打包、序列化;只知道"字符串",不知道算的是加法
├─────────────────────────────────────────────────────┤
│  网络层  TcpServer / TcpSocket / InetAddr
│  会收发字节、管连接;只知道"字节流",不知道里面装的是什么
└─────────────────────────────────────────────────────┘
每一层"知道什么、不知道什么",是这张图里最重要的信息:
- 业务层 知道
Request里每个字段的含义、Response::_code该怎么定;它不知道 socket、IP、端口、JSON 这些词是什么意思。 - 协议层 知道报文格式、帧长什么样、序列化规则;它不知道业务是什么------算数也好、聊天也好、传文件也好,它一视同仁。
- 网络层 知道 fd、地址、收发循环;它不知道收到的字节是 JSON 还是别的什么东西。
一句话总结:每一层只认识自己这一层的概念,对上下层的具体实现一无所知。 这就是分层的价值。
8.3 第二步:既然下层不认识上层,那"收到数据后该干什么"由谁决定?------回调
分层之后有个显而易见的问题:网络层不许认识业务层,那"收到数据之后该干什么"这件事,谁来决定?
答案是:上层把自己的处理函数,通过构造函数塞进下层。
// 定义一个"函数类型":
//   输入一个 Request&,输出一个 Response ------ 这就是"业务处理"这个动作的抽象
using HandlerRequest_t  = std::function<Response(Request &)>;

//   输入一个 Response&,没有输出 ------ 这是"应答处理"这个动作的抽象
using HandlerResponse_t = std::function<void (Response &)>;

class Protocol
{
public:
    // 服务端的构造方式:把"怎么处理请求"注入进来
    Protocol(HandlerRequest_t handler) : _version("1.0"), _handler_request(handler) {}

    // 客户端的构造方式:把"怎么处理应答"注入进来
    Protocol(HandlerResponse_t handler_response)
        : _version("1.0"), _handler_response(handler_response) {}

private:
    std::string        _version;          // ← 预留的版本号,目前从未被使用(见 11.5)
    HandlerRequest_t   _handler_request;  // 业务处理回调(服务端用)
    HandlerResponse_t  _handler_response; // 应答处理回调(客户端用)
};
std::function 是什么? 一句话:它是一个"可以像变量一样被传递、被存储的函数"。普通函数、lambda 表达式、绑定了对象的成员函数、仿函数对象------任何能像函数一样被调用的东西,都能装进它。
有了它,Protocol 层就获得了一种能力:"我不知道这条请求该怎么处理,但我手里有个东西,调用它就能拿到答案。"
这个模式在架构上叫依赖注入(Dependency Injection) ,在系统编程里叫回调 。它的收益是复用 :换成聊天室、游戏服务器,Protocol 一行都不用改,换一个 HandlerRequest_t 传进去就完事。
注意两个构造函数被写得"很灵性"------服务端和客户端各自只需要注入自己关心的那个回调。服务端只关心"怎么处理请求",客户端只关心"应答回来后怎么处理",另一个成员就留空。这样同一个类,两端都能用。
8.4 服务端的五步流水线:ParseRequest
现在看服务端收到一段字节后,具体发生了什么。
// 如果读到半个报文,什么都不做;
// 如果读到一个或多个完整报文,循环处理,把每一条都处理掉
std::string ParseRequest(std::string &inbuffer)
{
    std::string result;              // 攒起来的所有应答(可能不止一条!)
    while (true)
    {
        std::string json_string;

        // ── 步骤 1:解包(去报头)──────────────────────
        int n = Unpack(inbuffer, &json_string);
        if (n < 0) {
            LOG(LogLevel::DEBUG) << "no way !!";    // 真出错了
            return std::string();
        }
        if (n == 0) {
            // 数据不够,缓冲区里已经没有完整报文了
            // ★ 注意:返回的是 result 而不是空串!
            //   因为前面几轮循环可能已经生成了应答,不能因为"末尾剩半个"就丢掉它们
            LOG(LogLevel::INFO) << inbuffer << " parse done";
            return result;
        }

        // ── 步骤 2:反序列化(拆内容)──────────────────
        Request req;
        if (!req.Deserialize(json_string))
            return std::string();   // ⚠️ 这里有个坑,见 11.3

        // ── 步骤 3:调业务(通过回调,Protocol 根本不知道"算数"这回事)──
        Response resp;
        if (_handler_request)
            resp = _handler_request(req);

        // ── 步骤 4:应答序列化 ─────────────────────────
        std::string resp_json_string;
        resp.Serialize(&resp_json_string);

        // ── 步骤 5:加报头,攒进结果里 ──────────────────
        result += Packet(resp_json_string);

        // 回到循环开头,看缓冲区里还有没有下一条报文
    }
}
这个 while(true) 循环是全文的技术核心之一。 它的意义在第 3.5 节已经讲过:一次 recv 可能带来 N 条请求,所以必须循环解包,一条都不能漏。
这里有一个极容易写错、后果又很严重的细节,值得单独拎出来说:n == 0 那一行,return 的必须是 result,不能是空串。 此时缓冲区里确实没有完整帧了,但循环前面几轮可能已经算出了应答 ------如果直接 return std::string(),这些已经算好的结果会被整批丢掉。这是一个"看起来没问题、跑起来偶发丢包"的典型 bug。
还有一处设计值得注意:请求和应答用的是同一套报文格式 (都走 Packet)。这叫对称协议------实现起来最省事,代价是报文自己不带"我是请求还是应答"的标识,只能靠"谁连谁"来区分方向(客户端发出去的一定是请求,服务端发出来的一定是应答)。
HTTP/1.1 就不这么做------它用请求行 GET / HTTP/1.1 和状态行 HTTP/1.1 200 OK 明确区分两者的身份,代价是解析逻辑更复杂。两种方案没有高下之分,只有"你愿不愿意为通用性付出解析复杂度"的取舍。
8.5 客户端的对称流水线:ParseResponse
客户端方向是完全对称的,只是最后一步从"业务处理 + 攒应答"变成了"调用回调 + 什么都不发"。
std::string ParseResponse(std::string &inbuffer)
{
    while (true)
    {
        std::string json_string;

        // 1. 解包
        int n = Unpack(inbuffer, &json_string);
        if (n < 0) {
            LOG(LogLevel::DEBUG) << "no way !!";
            return std::string();
        }
        if (n == 0) {
            LOG(LogLevel::INFO) << inbuffer << " parse done";
            return std::string();   // 客户端不需要返回内容,调用方也不看
        }

        // 2. 反序列化成 Response 对象
        Response resp;
        if (!resp.Deserialize(json_string))
            return std::string();

        // 3. 调回调,把结果交给上层(客户端就是打印一下)
        if (_handler_response)
            _handler_response(resp);
        // 注意:客户端收到应答后通常不再回话,所以没有第 4、5 步
    }
}对比一下两条流水线,你会发现服务端是五步 (多出"业务 + 攒应答"),客户端是三步 ;服务端的返回值是"攒好的应答字节"(要发回去),客户端的返回值则没有意义(调用方不看)。理解了这种对称性,你就理解了整个协议层的骨架。
8.6 服务端 main:四步组装
现在看整个服务端是怎么把零件装起来的。这二十来行代码是全文的"集成点"。
int main(int argc, char *argv[])
{
    if (argc != 2) { Usage(argv[0]); exit(1); }
    uint16_t port = std::stoi(argv[1]);

    // 【第 1 步】定义计算器 ------ 业务对象,不知道网络的存在
    std::unique_ptr<Calculator> cal = std::make_unique<Calculator>();

    // 【第 2 步】定义协议对象,并把"业务"通过 lambda 注入进去
    //   这个 lambda 就是 Protocol 要用的 HandlerRequest_t:
    //   你给我一个 Request,我还你一个 Response
    std::unique_ptr<Protocol> protocol = std::make_unique<Protocol>(
        [&cal](Request &req) -> Response {
            return cal->Execute(req);
        }
    );

    // 【第 3 步】定义网络对象,并把"协议"通过 lambda 注入进去
    //   这个 lambda 是 TcpServer 要用的 Handler_t:
    //   你给我一串字节,我还你一串应答字节
    std::unique_ptr<TcpServer> tsvr = std::make_unique<TcpServer>(
        [&protocol](std::string &inbuffer) -> std::string {
            return protocol->ParseRequest(inbuffer);
        }, port
    );

    // 【第 4 步】启动事件循环
    tsvr->Loop();
    return 0;
}
这个组装方式有个共同点:每一层都是"通过构造函数接收下一层的处理函数",而不是去 new 一个对象。 于是形成了一条完整的调用链:
TcpServer 收到字节
   → 调 _handler → Protocol::ParseRequest
        → 调 _handler_request → Calculator::Execute
   ← 拿到应答字节
TcpServer 发送字节 而每一层只认识一个 std::function ,完全不认识下层具体类型。这就是依赖倒置 在几十行代码里的落地:高层模块(业务)和低层模块(网络)都依赖抽象(std::function),不互相依赖。
顺带看一眼依赖方向:精简版里画过它的依赖图,关键点是------依赖箭头单向向下,没有一条箭头从网络层指回业务层。这是整个架构能成立的前提。
8.7 网络层的内部结构:模板方法模式
前面说网络层"只管收发字节"。但网络层自己内部也有设计问题要解决:它要同时支持 TCP 和 UDP(甚至将来更多协议),而这几种协议的"连接建立流程"是类似的,具体步骤却各不相同。
怎么让"流程"复用、"步骤"可替换?源码用的办法叫模板方法模式:父类把流程顺序定死,子类只实现每一步的具体动作。
class Socket                                  // 抽象基类:定义"骨架"
{
protected:
    // 三个纯虚函数 = 三个必须由子类实现的"步骤"
    virtual void CreateSocketOrDie() = 0;            // 步骤 1:创建套接字
    virtual void BindSocketOrDie(uint16_t port) = 0; // 步骤 2:绑定端口
    virtual void ListenSocketOrDie() = 0;            // 步骤 3:开始监听

public:
    virtual std::shared_ptr<Socket> Accepter(InetAddr &addr) = 0;  // 接受连接
    virtual int  Recv(std::string *out) = 0;                       // 收字节
    virtual int  Send(const std::string &in) = 0;                  // 发字节
    virtual bool Connect(InetAddr &addr) = 0;                      // 发起连接
    virtual void Close() = 0;                                      // 关闭

    // 服务端:固定的"三步走"流程 ------ 谁也不能改顺序,只能改每步怎么做
    void BuildTcpSocketMethod(uint16_t port)
    {
        CreateSocketOrDie();
        BindSocketOrDie(port);
        ListenSocketOrDie();
    }

    // 客户端:只需要创建套接字这一步
    void BuildTcpClientSockMethod()
    {
        CreateSocketOrDie();
    }
};

class TcpSocket : public Socket { /* 真正去调 socket/bind/listen/accept 的实现 */ };
// class UdpSocket : public Socket { ... };   // 留好的扩展位(源码里注释着)
设计意图一句话说清 :父类 Socket 定死"流程顺序 "(建 → 绑 → 听),子类 TcpSocket 只负责"每一步怎么做"。将来要加 UDP,只要再写一个子类实现那三个纯虚函数,流程代码一行都不用重写。
这就是模板方法模式 :"实现的方式可以不一致,但操作的接口必须一致" ------ 而强制接口一致的手段,就是纯虚函数(子类不实现就创建不出对象)。
8.8 服务端的并发模型与两个缓冲区的生命周期
最后一个关键细节,藏在服务端的收发循环里。先看并发模型:
void Loop()
{
    signal(SIGCHLD, SIG_IGN);   // 子进程退出时由内核自动回收,避免产生僵尸进程
    while (true)
    {
        InetAddr clientaddr;
        auto sockfd = _listensock->Accepter(clientaddr);   // 主线程不断 accept
        if (!sockfd)
            continue;

        if (fork() == 0)
        {
            // 子进程:专门服务这一个客户端,处理完就退出
            service(sockfd, clientaddr);
            sockfd->Close();
            exit(0);
        }
        // 父进程:什么都不做,回到循环开头继续 accept
    }
}
这是经典的"一个连接一个进程"模型:父进程只管接受连接,每来一个客户端就 fork 一个子进程专门伺候它。signal(SIGCHLD, SIG_IGN) 让内核自动回收子进程,避免僵尸进程堆积。(这个模型的扩展性问题,第十一章会作为改进点来谈。)
然后是最能体现功力的地方------子进程里的收发循环:
void service(std::shared_ptr<Socket> sockfd, InetAddr &clientaddr)
{
    // ★ 注意这两个变量的【位置】------它们定义在 while 外面!
    std::string inbuffer, outbuffer;

    while (true)
    {
        outbuffer.clear();   // 每轮开头清空【发送】缓冲区

        // 接收:inbuffer 是跨轮累积的(Recv 内部用的是 +=)
        int n = sockfd->Recv(&inbuffer);
        if (n <= 0) {
            // n == 0 表示对端正常关闭(客户端退出了)
            // n <  0 表示接收出错
            LOG(LogLevel::WARNING) << "recv: client quit, " << clientaddr.ToString();
            break;
        }

        // 处理:一次可能解出并生成多条应答,所以用 += 攒着
        if (_handler)
            outbuffer += _handler(inbuffer);

        // 一个字都没解出来(说明只收到了半包)→ 这一轮不发,直接回去继续 recv
        if (outbuffer.empty())
            continue;

        n = sockfd->Send(outbuffer);
        if (n < 0) {
            LOG(LogLevel::WARNING) << "send: client quit, " << clientaddr.ToString();
            break;
        }
    }
}
这段代码里最值得琢磨的,是两个缓冲区截然不同的生命周期。
inbuffer 和 outbuffer 都定义在 while 外面,但它们的用法完全不同:
inbuffer:跨轮累积,永远不清空。 因为里面可能存着没收全的半个请求,必须留着,等下一次recv把剩下的字节追加进来(靠的正是 3.4 节那个+=)。半包的"半"字,就藏在这个变量的生命周期里。outbuffer:每轮开头clear()。 因为应答一旦发出去就完成使命了,不需要跨轮保留。不清空的话,上一轮的应答会被重复发送。
如果把 inbuffer 也放进 while 里面(或者每轮清空),半包就永远拼不起来------这是半包问题最经典的一种翻车方式,值得你在自己的代码里反复检查。
另外,outbuffer += _handler(inbuffer) 里的这个 += 也有讲究:一次 recv 可能解出多条 请求(粘包),于是产生多条 应答。用 += 把它们拼在一起,一次 send 全部发出去 ,比循环调用 N 次 send 少 N-1 次系统调用------这是一个实打实的小优化。
8.9 承上启下
到这里,整个项目已经能从代码上"闭合"了:字节进来、被切帧、被还原成对象、被算完、被重新序列化、被发回去。
但纸面上的正确不等于真的正确。下一章,我们要把粘包现象亲手复现出来------因为只有亲眼见过它,你才会真正相信前面那些"绕来绕去"的设计不是多余的。
九、跑起来看见它:一次发三条,复现粘包
9.1 实验代码:客户端一口气发三条
理论讲完了,现在用代码把粘包现象复现出来。
while (true)
{
    // ★ 关键:这一轮要拼 3 条请求
    int cnt = 3;
    std::string outbuffer;
    while (cnt--)
    {
        // 0. 采集用户输入
        int x, y; char oper;
        std::cout << "Enter Your x: ";    std::cin >> x;
        std::cout << "Enter Your y: ";    std::cin >> y;
        std::cout << "Enter Your oper: "; std::cin >> oper;

        // 1. 构造请求对象
        Request req(x, y, oper);

        // 2. 序列化:对象 → JSON 字符串
        std::string req_json;
        req.Serialize(&req_json);

        // 3. 加报头:JSON → 一帧完整报文
        std::string send_req_string = procotol.Packet(req_json);

        // 4. ★ 攒进 outbuffer(注意是 +=),攒满 3 条一起发
        outbuffer += send_req_string;
    }

    // 5. 一次 send 把 3 条报文全发出去
    socket->Send(outbuffer);

    // 6. 接收:可能收到半条,也可能一次收到全部 3 条应答
    socket->Recv(&inbuffer);

    // 7. 解析:循环解包,把这一轮收到的所有应答都处理掉
    procotol.ParseResponse(inbuffer);
}这段代码的意图很明确:它故意制造"多条消息挤在一起"的场景,来验证我们的协议层能不能扛住。
9.2 一次 recv 收到三条的真相
跑起来会发生什么?假设你输入了 10 + 20、100 - 1、6 * 7 三组数据。客户端这一轮拼出来的 outbuffer 是这样的:
32\r\n{"left":10,"right":20,"oper":43}\r\n32\r\n{"left":100,"right":1,"oper":45}\r\n30\r\n{"left":6,"right":7,"oper":42}\r\n (每条帧的结构都是 长度\r\n正文\r\n:前两条正文 32 字节、第三条 30 字节,所以三条帧分别是 38、38、36 字节,加起来 112 字节。)
一次 send 出去之后,服务端打印出来的 inbuffer 会是什么?
大概率是完整的三条,粘在一起。
为什么?三个原因:
- 三条加起来才 112 字节,远小于 MSS(通常 1460 字节),TCP 没有理由主动拆分它;
- 服务端
recv用的是 1023 字节的缓冲区,一次装得下; - 服务端真正去读数据的时刻,这三条已经全都躺在内核接收缓冲区里了。
于是 ParseRequest 拿到这一大坨,开始它的 while(true) 循环:第一次 Unpack 切走第一条,第二次切走第二条,第三次切走第三条,第四次发现数据不够了、返回 0,循环退出。 三条请求,三次计算,result 里攒下三条应答,一次 send 全部发回。
客户端这边完全对称:一次 recv 拿到三条应答粘在一起,ParseResponse 循环三次,打印出:
result: 30[0]
result: 99[0]
result: 42[0]
粘包现象,就这么在两端同时被复现出来了。 而我们的代码处理得干干净净------因为它从一开始就没假设过"一次 recv 等于一条消息"。
9.3 反过来看:这正好证明了循环解析的必要性
现在做个思想实验:如果 ParseRequest 里没有 那个 while(true) 循环,只解一条会怎样?
你的三条请求,只有第一条会被处理,后两条会被静默丢弃------客户端会一直等下一条应答,卡死在那里。
而且这个 bug 极难复现:有时候三条恰好分三次 recv 到达,程序一切正常;有时候(网络稍有拥塞,或者你手速快一点)它们粘在一起了,程序就丢消息。那种"偶尔出错、重试一下就好"的玄学 bug,根源往往就是这里的半包/粘包处理不完整。
这就是为什么"用 TCP 就必须处理粘包"------它不是一种需要规避的意外,而是 TCP 的设计本质。
9.4 承上启下
到这里,用户态的完整故事已经讲完了:从对象到字节,从字节到帧,从帧回到对象,中间还亲手验证了一遍。
但作为一个啃 Linux 内核的学习者,我们不该停在这里。应该往下再问一句:这一整套思路,内核是怎么做的?
下一章你会看到:内核在完全相同的处境下,做出了几乎相同的选择,只是实现得更极致。
十、下沉到内核:同样的四个套路
这一章我们把前面所有设计,拿到内核里找它们的"同款"。你会看到四个熟悉的套路:长度前缀定界、加头去头不拷贝、自描述报头、公共头部 + 强转。
10.1 套路一:长度前缀定界------看 UDP 报头
我们的报文格式是 len\r\n{正文}\r\n,核心思想是"先说长度,再放内容"。现在看 Linux 的 UDP 报头长什么样:
struct udphdr {
    __be16 source;   // 源端口
    __be16 dest;     // 目的端口
    __be16 len;      // ★ 整个 UDP 报文的长度 = 8 字节报头 + 数据
    __sum16 check;   // 校验和
}; 看到第三行了么?len------内核也在用"长度前缀"来标记一条消息的边界 ,和我们 Packet() 里的 std::to_string(json_string.size()) 是同一个思想。
但内核做了两个和我们不同的选择,值得对比。
选择一:用二进制 16 位整数,而不是十进制字符串。
因为内核要的是极致的效率和固定偏移 :解析 len 就是"从第 4 个字节开始读 2 字节",一条 movzwl 指令搞定,不用扫描字符串、不用 stoi、也不可能抛异常。而我们用十进制字符串,是因为我们更在意可读性和调试便利。
这正是 3.2 节"细节一"里那个取舍的另一面------同一个问题,在不同的约束下,会有不同的最优解。
选择二:用 __be16 明确标注大端。
代码里写 __be16 而不是 uint16_t,是在用类型系统表达"这个字段是网络字节序的,取出来用之前要 ntohs" 。这是一个非常值得学习的内核编程习惯:把隐式约定变成显式类型。
回到我们 7.3 节那个 char _oper 的坑 ------如果我们也能用类型明确表达"这个字段的线上类型是字符",就不会有 43 这种意外了。内核在这件事上比我们做得严谨。
顺便回答一个前面留下的问题:为什么 UDP 报头里有 len,TCP 报头里却没有?
struct tcphdr {
    __be16 source;     // 源端口
    __be16 dest;       // 目的端口
    __be32 seq;        // 序号    ← TCP 靠序号来定位字节,而不是长度
    __be32 ack_seq;    // 确认号
    // ... 标志位、窗口、校验和、紧急指针 ...
    // ★ 注意:这里没有 total_length 这样的字段!
};
TCP 为什么不需要长度字段? 因为 TCP 的职责就是提供无边界的字节流 ------它的"边界"概念是字节序号(seq),而不是"消息"。所以 TCP 可以自由地合并、切分段,完全不需要(也不应该)记录"应用层写了几次"。这就是第二章那个"字节河"在报文格式上的体现。
那整条链路上,边界到底由谁负责? 答案是:
应用层:TCP 不给边界 → 我们自己加 len\r\n      (本文的工作)
传输层:UDP 自带 len 字段;TCP 刻意不加        (把定界责任推给应用层)
网络层:IP 报头里的 tot_len 保证"每个 IP 包"的边界清楚
链路层:以太网帧有自己的帧定界符
"谁能提供边界,谁就必须提供边界"------这是一条贯穿整个协议栈的设计原则。 你看,我们手写的那行 Packet,其实是在代替 TCP 完成它拒绝做的那件事。
10.2 套路二:加头去头不拷贝------sk_buff 的四个指针
还记得第二章提到的 sk_buff 吗?我们在那里只说了"内核用 sk_buff 描述报文,用两条队列管理收发"。现在把镜头拉近,看看这个结构体为什么长成这样。
先问需求:一个网络包在内核里从网卡走到应用层,要穿过链路层 → 网络层 → 传输层 → socket 层,每一层都要剥掉一个头;反过来发送时,每一层都要加上一个头。
如果每加一层头就重新分配一块内存、把数据整体拷贝过去------一个包就要拷贝四五次,性能无法接受。
所以内核设计的 sk_buff,核心就是用指针 而不是数据搬移来表示"头在哪里":
源码位置 :include/linux/skbuff.h(节选)
struct sk_buff {
    /* ── 四个指针,圈出缓冲区里的三块区域 ── */
    unsigned char *head;    // 缓冲区起点(刚分配出来的内存开头)
    unsigned char *data;    // 当前有效数据的起点
    unsigned char *tail;    // 当前有效数据的终点
    unsigned char *end;     // 缓冲区终点

    unsigned int len;       // 当前有效数据的长度(= tail - data)

    struct sock       *sk;    // 这个包属于哪个 socket
    struct net_device *dev;   // 从哪块网卡收的 / 要往哪块网卡发
    __u16              protocol; // 三层协议类型(ETH_P_IP / ETH_P_ARP ...)

    unsigned char cb[48] __aligned(8);  // 各层协议各用一块的"私有小黑板"
}; 先看字段设计:四个指针圈出三块区域,sk 回答"这是我的哪个连接",dev 回答"我该从哪进哪出",protocol 回答"我该交给哪个三层协议处理",cb[48] 是留给各层协议临时存状态的"小黑板"。每一个字段都在回答一个具体的管理问题------这就是"先有需求、后有字段"的典型。
关键在四个指针的排布:
      head        data              tail        end
       ↓           ↓                 ↓           ↓
       ┌───────────┬─────────────────┬───────────┐
       │ headroom  │    有效数据      │  tailroom │
       └───────────┴─────────────────┴───────────┘
        ← 预留空间 →                   ← 预留空间 →
        (给各层加头用)               (给各层加尾用)
headroom 和 tailroom 是刻意预留出来的空间,专门给各层"加头加尾"用。于是:
- 加一个头 :
skb_push(len)------ 只是把data指针往前挪len个字节,然后往那块空间里填头部。数据一个字节都没动。 - 去掉一个头 :
skb_pull(len)------ 把data指针往后挪len个字节。同样没有拷贝。 - 追加尾部数据 :
skb_put(len)------ 把tail指针往后挪。
这就是内核版的 Packet() 和 Unpack()------只不过它用"移动指针"代替了"拼接字符串"。
回头看我们的实现,差距就出来了:Packet 做的是 std::to_string(...) + gsep + json + gsep,会分配一块新内存并拷贝两次 ;Unpack 里的 packet.erase(0, total),会把后面的字节整体往前搬(一次 O(n) 的 memmove)。
在小报文、低并发下这无所谓。但在每秒几十万个包的高性能服务器上,这些拷贝就是瓶颈。这也解释了为什么几乎所有高性能 C++ 网络库都要自己实现一个 Buffer 类 ------它们都在模仿 sk_buff 的思路:用两个下标(读下标 / 写下标)代替 erase,只有下标在移动,数据不动,等空闲的时候再做一次整体压缩。
muduo 的 Buffer:  [ 已读 |   可读   |  可写  |   空闲   ]
                      ↑          ↑         ↑
                  readIndex  readIndex_  writeIndex_
"用边界指针表示数据范围,而不是用数据搬移表示"------这是我们从 sk_buff 里能学到的最有价值的一课。
10.3 套路四:公共头部 + 强转------回到 sockaddr
最后回到 4.5 节那个 sockaddr_in,把它和内核的设计思想接上。
那个 sin_zero[8] 填充字段的存在意义,现在应该很清楚了:它是在用空间换取"类型转换的安全性"。
struct sockaddr_in addr;
bind(fd, (struct sockaddr *)&addr, sizeof(addr));
//       ↑ 这个强转就是 CONV 宏做的事
强转之所以安全,是因为两者大小都是 16 字节,而且前 2 字节(地址族)的语义是相同的 。接收方拿到一个 sockaddr* 之后,先读前 2 字节的 sa_family,知道是 AF_INET,再把指针强转回 sockaddr_in*,去访问端口和 IP。
"公共头部 + 强转回具体类型"------这个模式你在内核里会反复遇到 :回想一下 IPC 那三个结构体(shmid_ds、msqid_ds、semid_ds)共享的公共首成员 kern_ipc_perm,是完全一样的手法。
为什么要有这个模式? 因为接口要统一,数据要分化 :bind() 只能有一个版本,但地址有几十种格式。解决矛盾的办法,就是"让所有格式共享一个公共头部,用类型转换在统一接口和具体数据之间来回切换"。
有意思的是,这套思路在 JSON 里也有个对应物 :Json::Value。它内部记录"我现在是 object 还是 array 还是 int",你调用 asInt() 时它会检查类型------这就是动态类型版本的"公共头部 + 强转" 。区别只是:C 语言靠手工强转(快,但转错了直接读到垃圾内存),Json::Value 靠内部类型标记(安全,但有运行时开销)。
同一个设计思想,一个用在了地址结构上,一个用在了数据容器上------这就是"套路"的力量。
10.4 本章小结
把四个套路排一下,你会发现它们其实回答的是同一批问题在四个不同层面的解法:
- "边界在哪里" → UDP 报头的
len、IP 的tot_len、netlink 的nlmsg_len,和我们Packet里的长度前缀一模一样; - "加头去头怎么不拷贝" →
sk_buff的head/data/tail/end四指针和skb_push/pull; - "统一接口怎么适配多种数据" →
sockaddr的公共头部 + 强转,以及它的动态类型版本Json::Value。
用户态和内核态,用的是同一本设计手册,只是内核写得更较真。
十一、这条路还没走完:源码里真实的坑
代码跑通了,功能也验证了。但**"能跑"和"健壮"之间还有很长的距离**。这一章把项目里真实存在的问题一个一个摆出来------因为看懂这些坑,比多写一百行代码更有价值。
11.1 std::stoi 会抛异常,而调用链上没人接
回到 Unpack 里的这一行:
std::string lenstr = packet.substr(0, pos);
// lenstr 合法性判断,lenstr -> 123 345     ← 源码里作者自己留的 TODO
int len = std::stoi(lenstr);
std::stoi 在两种情况下会抛异常:
lenstr不是合法数字(比如对面发来abc\r\n...)→ 抛std::invalid_argument;- 数字超出
int范围(比如99999999999999999999)→ 抛std::out_of_range。
而调用链上没有任何 try/catch 。异常会一路向上穿透 ParseRequest、_handler、service、Loop,最后冲出 main------进程直接终止。
这意味着什么?任何人用 nc 手工给服务器发一句 abc\r\n,就能把服务器打挂。 这是一个真实的拒绝服务(DoS)漏洞。
源码里那行注释说明作者知道这里有问题,只是没来得及补。修法有三种:
// 方案一:先校验字符,再转换
if (lenstr.empty() || lenstr.find_first_not_of("0123456789") != std::string::npos)
    return -1;   // 长度串里出现了非数字字符 → 直接判定为协议错误

// 方案二:用不抛异常的 std::from_chars(C++17)
int len = 0;
auto [ptr, ec] = std::from_chars(lenstr.data(), lenstr.data() + lenstr.size(), len);
if (ec != std::errc()) return -1;

// 方案三:包一层 try/catch
try { len = std::stoi(lenstr); }
catch (...) { return -1; }三种都能修,但思路不同:方案一是"不信任何非法输入 ",方案二是"用不抛异常的工具 ",方案三是"兜底接住"。生产代码里,通常是方案一/二做主、方案三做保险。
11.2 长度字段是个攻击面:负数长度会直接搞崩进程
即使 stoi 成功了,还有一个更阴险的输入:负数。
如果对面发来 -100\r\n,那么:
int len = std::stoi("-100");                          // len = -100(stoi 认为这是合法的!)
int total = 3 + (-100) + 4;                           // total = -93(负数!)
if (packet.size() < total) return 0;                  // size() 是无符号,和负数比较......
                                                      // 这里会发生危险的隐式类型转换
*json_string = packet.substr(pos + 2, len);            // len = -100 → 被转成巨大的 size_t
                                                      // 结果把缓冲区剩下的内容全当成"正文"
packet.erase(0, total);                               // ★ total 是负数 → 转成 size_t 变成天文数字
// → 超出字符串长度 → 抛 std::out_of_range → 崩溃 根本原因在于:packet.size() 返回的是 size_t(无符号),而 total 是 int(有符号)。两者比较时,int 会被隐式转换成 size_t,负数瞬间变成一个天文数字。
这是 C/C++ 里最经典的坑之一,编译器的 -Wsign-compare 警告就是专门抓它的。编译时请务必加上 -Wall -Wextra------它们能提前把这类问题喊出来。
正确的做法是:凡是"来自网络的长度 / 下标 / 偏移",在参与任何运算之前,都必须先做范围校验。
// 既防负数,也防"声称有 10GB 大包"的内存炸弹
if (len < 0 || len > MAX_MSG_SIZE)
    return -1;
这里的上限 MAX_MSG_SIZE 同样重要------没有上限的长度字段就是一个内存炸弹 :攻击者声称"我这条消息有 2GB",服务端就会傻傻地等着收满 2GB 才处理,或者提前分配 2GB 内存。校验范围,是协议实现的第一条纪律。
11.3 一帧解析失败,前面算好的应答全丢
再看 ParseRequest 里的这一步:
Request req;
if (!req.Deserialize(json_string))
    return std::string();   // ⚠️ 返回空串,把已经攒下的 result 一起丢了
设想一次 recv 收到了 3 条请求:第 1 条正常,第 2 条 JSON 损坏(比如被中间设备篡改,或者对面客户端有 bug),第 3 条正常。
会发生什么?第 1 条已经算完、应答已经在 result 里了;处理到第 2 条时 Deserialize 失败,函数直接 return std::string()------第 1 条的应答被一起丢掉,第 3 条也不会被处理。
正确的做法是"跳过坏的那一条,继续处理后面的",并且把已经攒好的 result 返回给调用方:
if (!req.Deserialize(json_string)) {
    LOG(LogLevel::WARNING) << "bad json, skip: " << json_string;
    continue;   // ← 跳过这一条,继续循环,而不是整体 return
}
这里的原则是:一个坏帧不应该毁掉一批好帧。 在协议实现里,这叫错误隔离(Fault Isolation)------错误应该被限制在尽可能小的范围内,而不是让一处的失败扩散成整体的失败。这个原则不只适用于网络协议,在分布式系统、微服务、批处理里,到处都能看到它的身影。
11.4 send 不保证把数据全部发出去
看这一行:
int Send(const std::string &in) override
{
    return send(_sockfd, in.c_str(), in.size(), 0);   // 返回值直接被丢掉了
}
send 返回的是实际写入内核缓冲区的字节数 ,它可能小于你要求的字节数。什么情况会发生?
- 发送缓冲区快满了(对端读得太慢);
- 被信号中断(
EINTR); - 对于非阻塞 socket,这几乎是常态。
目前的代码只检查了 n < 0(出错),默认每次 send 都能一次发完 。在小报文、本地测试的环境下这几乎总是成立,所以问题看不出来;但一旦报文变大、或者网络拥塞,就会出现"只发了一半"的情况------而对端会把半个报文当垃圾,你会看到一个极难复现的诡异 bug。
正确的写法是循环发送:
int Send(const std::string &in) override
{
    size_t total_sent = 0;
    while (total_sent < in.size()) {
        ssize_t n = send(_sockfd, in.c_str() + total_sent, in.size() - total_sent, 0);
        if (n < 0) {
            if (errno == EINTR) continue;   // 被信号打断,重试即可
            return -1;                       // 真错误
        }
        total_sent += n;                     // 累加已发送的字节数
    }
    return total_sent;
}
注意这和 recv 的对称性 :recv 可能只读到半个包,send 也可能只写出半个包。两端都要处理"部分完成",才是完整的答案------这正是第十一章开头说的"能跑和健壮之间的距离"。
11.5 其它零碎的改进点
Deserialize 的入参应该用 const 引用。 它并不修改 in,写成 const std::string & 才是正确地表达意图(而且能接受临时对象)。顺带一提,项目里 Serialize 用指针做出参、Deserialize 用引用做入参,两种风格混用------统一成"输入用 const&、输出用 *"会更清晰。
_oper 的类型契约要写进协议。 就是 7.3 节那个坑。要么明确用 std::string(1, _oper) 存成字符,要么在文档里写清楚"这里传的是 ASCII 码"------但不能像现在这样,靠"碰巧能转回来"来工作。
JSON 的体积和性能。 每条报文都要重复传输 "left"、"right"、"oper" 这些键名,在报文里占了将近一半的字节。如果 QPS 很高,换成 protobuf 能省下大量带宽------这也是为什么内核协议栈全都是二进制的 (回想 10.1 节的 __be16)。
日志里打印整个 inbuffer 有风险。 LOG(LogLevel::DEBUG) << inbuffer 会把收到的全部内容打进日志。如果客户端发来超长数据,日志会被撑爆------这本身也是一种 DoS。生产环境必须限制日志长度。
fork 模型的扩展性。 TcpServer::Loop 用的是"一个连接一个进程"。连接一多,进程数和内存开销、上下文切换开销都会上来。换成线程池(或 epoll 事件循环)会好得多------这是上一篇文章讲过的内容。
11.7 编译与依赖
最后补一句工程上的事。Makefile 里链接了 jsoncpp:
netcal_server:NetCalServer.cc
	g++ -o $@ $^ -std=c++17 -ljsoncpp
#                      ↑ 指定 C++17 标准
#                              ↑ 链接 jsoncpp 库
两个最常见的报错,正好对应编译链接的两个阶段:
fatal error: jsoncpp/json/json.h: No such file or directory→ 头文件没找到。要么是没装开发包(apt install libjsoncpp-dev),要么是路径不同(试试<json/json.h>)。undefined reference to Json::Value::...→ 头文件找到了,但没链接库 。检查-ljsoncpp有没有加上。链接错误永远发生在编译成功之后,这是编译链接两阶段的基本特征。
十二、速查表
12.1 先把主线串一遍
TCP 是字节流,不保留"消息"边界
    ↓
应用层必须自己定界 → 三种方案:定长 / 分隔符 / 长度+内容
    ↓
选"长度+内容":Packet() 加头(len\r\n + 正文 + \r\n)
               Unpack() 去头,必须三态返回(1成功 / 0不够 / -1出错)
    ↓
半包的代码解法:Recv 用 += 累积 + Unpack 精确 erase(不够就一字节不动)
粘包的代码解法:while(true) 循环解到底,一条都不能漏
    ↓
边界解决后,帧里的内容怎么摆?→ 序列化
    ↓
不能直接发结构体!对齐填充 / 字节序 / 指针 / 类型宽度 / 版本演进 / 跨语言
    ↓
选方案:手搓(脆) vs JSON(可读灵活) vs protobuf(小快但需 schema)
    ↓
jsoncpp 三件套:Json::Value(万能容器)+ Reader(解析)+ Writer(生成)
    ↓
设计报文结构体:Request(三个字段)+ Response(结果 + 状态码)
    ↓
组装:分层(网络 / 协议 / 业务)+ 回调(std::function 依赖注入)
    ↓
下沉到内核:UDP 的 len 字段、sk_buff 的 head/data/tail/end、
            nlmsghdr 的 nlmsg_len、sockaddr_in 的公共头部
    ↓
同一个思想,在用户态和内核态各实现了一遍
12.2 概念速查
| 问题 | 答案 |
|---|---|
| 什么是序列化? | 把内存中的对象,转成"与平台无关、与语言无关"的字节序列 |
| 什么是反序列化? | 把字节序列还原成内存中的对象;输入不可信,必须先校验再使用 |
| 定界和序列化是一回事吗? | 不是。定界解决"帧从哪到哪"(Packet/Unpack),序列化解决"帧里的字节怎么摆"(Serialize/Deserialize) |
为什么不能直接 send(&struct, sizeof(struct))? |
对齐填充字节不确定、字节序不同、指针无意义、类型宽度不统一、无法演进、无法跨语言 |
| TCP 为什么有粘包? | TCP 是字节流,不保留写入边界;内核按效率合并/切分段,从不记录"应用层写了几次" |
| UDP 有粘包问题吗? | 没有。UDP 保留消息边界(一次 sendto 对应一次 recvfrom),代价是丢包/乱序/截断 |
write 返回成功,数据到对面了吗? |
没有。write 只是把数据拷贝进内核发送缓冲区,什么时候发由内核决定 |
| 内核怎么管理收发缓冲区里的报文? | 用 sk_buff 描述每个报文,用 sk_receive_queue / sk_write_queue 两条队列排队 |
| 最常见的字节序坑在哪? | 多字节整数跨主机传输。网络统一用大端,x86 用小端,所以要 htons / htonl |
12.3 自定义协议速查
| 问题 | 答案 |
|---|---|
| 为什么用"长度+内容"定界? | 只有它既支持任意长度、又不需要转义、还能一次算出边界位置 |
| 报文格式是什么? | len\r\n{json正文}\r\n(长度串 + 分隔符 + 正文 + 结束分隔符) |
| 长度为什么用十进制字符串? | 人可读、抓包直观、无字节序问题;代价是解析要用 stoi 且可能失败 |
Unpack 为什么必须三态返回? |
要区分"解出一条(1)"/"数据不够(0)"/"真出错(-1)";只有 true/false 会把半包误判成错误 |
收到半包时 Unpack 做什么? |
什么都不做(return 0),缓冲区一个字节都不动 |
| 半包在代码上靠什么解决? | Recv 里用 += 累积不覆盖;Unpack 成功后 erase 只删已消费的部分 |
ParseRequest 为什么用 while(true)? |
一次 recv 可能带来 N 条报文(粘包),必须循环解完,一条都不能漏 |
n == 0 时为什么返回 result 而不是空串? |
前面几轮循环可能已经算出了应答,返回空串会把它们整批丢掉 |
inbuffer / outbuffer 的生命周期? |
inbuffer 跨轮累积不能清 (存着半个包);outbuffer 每轮 clear()(发完即完成) |
| 请求和应答的格式一样吗? | 本项目是对称协议,都用 Packet,靠"谁连谁"区分方向;HTTP 用请求行/状态行区分 |
12.4 jsoncpp 速查
| 问题 | 答案 |
|---|---|
Json::Value 是什么? |
一个"什么都能装"的动态类型容器,内部记录自己的实际类型 |
| 怎么加字段? | root["key"] = value;;嵌套对象直接赋值另一个 Value |
| 怎么当数组用? | root.append(value); |
| 怎么解析字符串? | Json::Reader reader; reader.parse(s, root); 必须检查返回值 |
| 解析失败怎么看原因? | reader.parse(s, root, err_string) 的第三个参数带着错误位置 |
| 三种 Writer 怎么选? | FastWriter 紧凑(发网络用);StyledWriter 美化(打日志用);StreamWriterBuilder 新版推荐、可精细控制 |
asInt() 键不存在会怎样? |
静默返回 0,不报错 。字段名拼错一个字母不会有任何提示(可用 isMember() 检查) |
| 头文件路径? | 一般是 <jsoncpp/json/json.h>,部分系统是 <json/json.h> |
12.5 结构体设计速查
| 问题 | 答案 |
|---|---|
Request 需要哪些字段? |
左操作数、右操作数、运算符------三元组唯一确定一次运算 |
Response 为什么要有 _code? |
不是每次计算都有结果(如除零)。0=成功,1=除零,2=取模除零,3=非法运算符 |
| 状态码粒度怎么定? | 按使用者的诊断需要定。/ 除零(1) 和 % 除零(2) 分开,因为信息量不同 |
char _oper 写进 JSON 会变成什么? |
数字 43(ASCII 码) ,不是字符串 "+"。因为重载决议把 char 整型提升成了 int |
| 这个坑怎么避免? | root["oper"] = std::string(1, _oper);,并对应改成 asString()[0] |
为什么 Serialize/Deserialize 是成员函数? |
"怎么把自己变成字节"是这类数据自己的知识,协议升级只改这一个类 |
12.6 架构速查
| 问题 | 答案 |
|---|---|
| 三层职责怎么分? | 网络层只管字节;协议层只管切帧/序列化;业务层只管算数 |
| 层与层之间怎么连接? | std::function 回调 + 构造函数注入(依赖注入) |
为什么不让 TcpServer 直接调 Calculator? |
会造成耦合,网络模块从此不能被别的业务复用 |
Protocol 怎么做到业务无关? |
它只持有 HandlerRequest_t(Request→Response 的函数),不持有具体业务对象 |
| 网络层的类结构用了什么模式? | 模板方法模式:Socket 定死流程(建→绑→听),TcpSocket 实现每一步 |
| 服务端的并发模型? | fork 一连接一进程;SIGCHLD 设为 SIG_IGN 防止僵尸进程 |
12.7 内核对照速查
| 问题 | 答案 |
|---|---|
| UDP 报头里有长度字段吗? | 有,len(含 8 字节报头)。这就是内核版的长度前缀 |
| TCP 报头里有长度字段吗? | 没有 。TCP 靠 seq 序号定位字节,把定界责任推给应用层 |
| IP 层怎么保证边界? | 报头里的 tot_len 保证每个 IP 数据报的边界清楚 |
sk_buff 的四个指针是什么? |
head / data / tail / end,圈出 headroom + 有效数据 + tailroom |
| 内核加头为什么快? | skb_push 只是移动 data 指针,不拷贝数据 (对比我们的字符串拼接和 erase) |
nlmsghdr 和我们的报头什么关系? |
同一个思想:nlmsg_len 就是我们的 len;它多了 type / seq / flags |
| 我们的协议缺了什么元信息? | 消息类型、序号(配对请求应答)、版本号(_version 成员从未被使用) |
sockaddr_in 的 sin_zero[8] 干嘛的? |
纯填充,让 sockaddr_in 和 sockaddr 都是 16 字节,强转才安全 |
htons 算序列化吗? |
算。"把机器内部表示转成网络通用表示"就是序列化,只是位精确、二进制的 |
12.8 踩坑速查
| 症状 | 原因 | 修法 |
|---|---|---|
服务器被一句 abc\r\n 打挂 |
std::stoi 抛异常且无人接(真实 DoS) |
校验字符集 / std::from_chars / try-catch |
发 -100\r\n 就崩溃 |
负数长度 + int/size_t 隐式转换 + erase 抛 out_of_range |
校验 0 <= len <= MAX_MSG_SIZE,编译加 -Wall -Wextra |
| 偶发丢消息,重试就好 | 半包没处理完整 / Unpack 循环被提前 return 打断 |
保证 while(true) 循环处理完整,错误隔离用 continue |
| 一条坏 JSON 导致整批应答丢失 | Deserialize 失败时 return std::string() 丢弃了已攒的 result |
改成 continue 跳过坏帧 |
| 大报文偶发对端解析失败 | send 没有循环,可能只发了一半 |
循环 send,处理 EINTR 和部分发送 |
日志里 oper 是数字不是字符 |
char 被整型提升成 int 写进 JSON |
std::string(1, _oper) |
编译报 No such file <jsoncpp/json/json.h> |
没装 libjsoncpp-dev 或路径不同 |
装包 / 改用 <json/json.h> |
undefined reference to Json::Value |
编译成功但没链接库 | Makefile 加 -ljsoncpp |
12.9 一句话带走
TCP 给了你一条字节河,序列化是你自己搭的船。
定界(
len\r\n)决定船有多大,序列化(JSON)决定船上装什么,反序列化决定对面能不能把货卸下来点清楚。而Unpack的三态返回值、Recv的+=、while(true)的循环,是保证这条船在半包和粘包的浪里不会翻的三块压舱石。至于内核------它早就在用同一套办法了,只是它管的是
sk_buff,我们管的是std::string。