文章目录
- [1. Vector stores 向量存储](#1. Vector stores 向量存储)
-
- [1.1 内部向量存储](#1.1 内部向量存储)
- [1.2 外部向量存储](#1.2 外部向量存储)
- [2. 检索向量构建提示词询问模型](#2. 检索向量构建提示词询问模型)
- [3. RunnablePassthrough 的使用](#3. RunnablePassthrough 的使用)
系列文章:
前置介绍:避免老年人跟不上时代,也是时候开始学习 agent 相关的知识,还是经典的黑马程序员教程开始学习。
1. Vector stores 向量存储
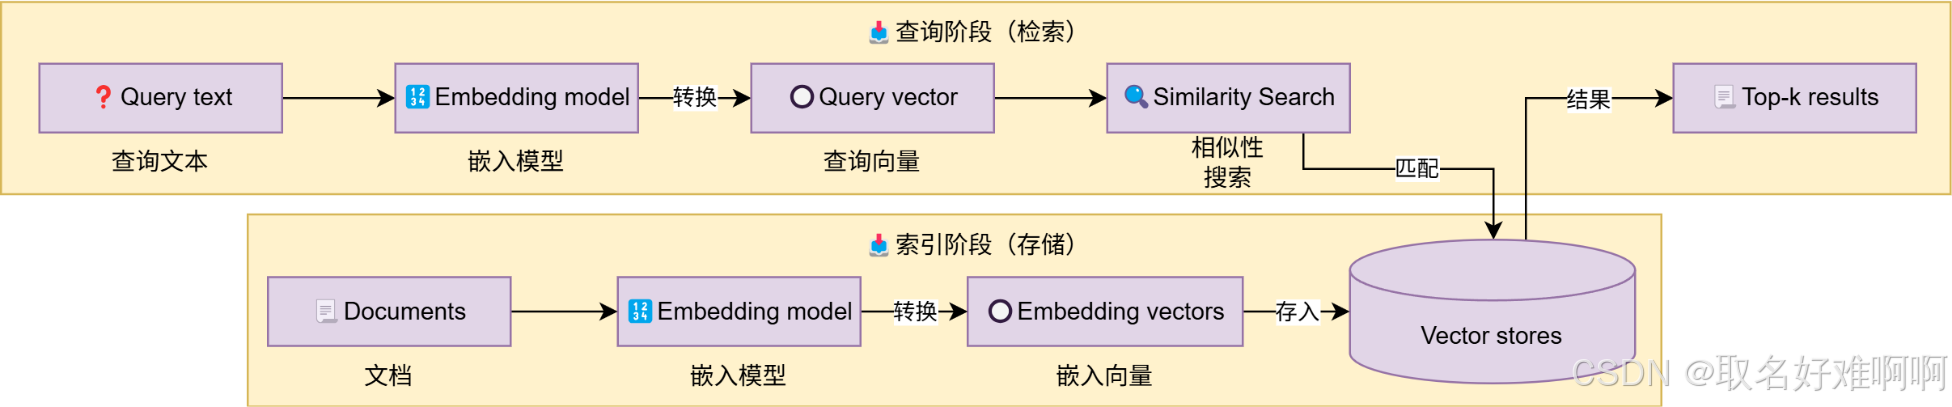
这个是一个典型的向量存储应用,也就是 RAG 流程,主要涉及到两部分的动作:
- 如何文本转向量。
- 创建向量存储之后,基于向量存储完成。
- 存入向量:add_documents
- 删除向量:delete
- 向量检索:similarity_search
上面三个方法都是 LangChain 提供了向量操作。
1.1 内部向量存储
go
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.document_loaders import CSVLoader

# InMemoryVectorStore 内存向量存储核心类
vector_store = InMemoryVectorStore(
    # 文本转向量模型, 告诉向量存储文本转向量的模型是什么,方便底层调用转向量
    embedding=DashScopeEmbeddings()
)


loader = CSVLoader(
    file_path="./data/info.csv",
    encoding="utf-8",
    source_column="source",     # 指定本条数据的来源是哪里,也就是指定哪一列是来源,类似每一行的主键吧
)

documents = loader.load()

# id1 id2 id3 id4 ...
# 向量存储的 新增、删除、检索
vector_store.add_documents(
    documents=documents,        # 被添加的文档,类型:list[Document]
    ids=["id"+str(i) for i in range(1, len(documents)+1)] # 给添加的文档提供id(字符串)  list[str]
)

# 删除  传入[id, id...]
vector_store.delete(["id1", "id2"])

# 检索 返回类型list[Document]
result = vector_store.similarity_search(
    "Python 是不是简单易学",
    3       # 检索的结果要几个
)

print(result)

# [Document(id='id5', metadata={'source': '传智教育', 'row': 4}, page_content='source:
# 传智教育\ninfo: Python学起来很简单的'), Document(id='id7', metadata={'source': '黑马程序员', 'row': 6},
# page_content='source: 黑马程序员\ninfo: 努力带来成就,Python助力辉煌'), Document(id='id8', metadata={'source': '黑马程序员', 'row': 7},
# page_content='source: 黑马程序员\ninfo: 学习Python的时候也要记得好好休息打打篮球')]
内部向量存储用了 InMemoryVectorStore,也就是存内存的,一重启内存就清空了,所以有内部向量存储也会有外部向量存储。
1.2 外部向量存储
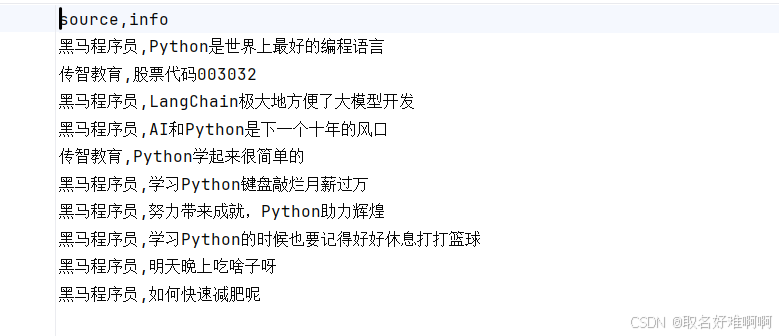
外部向量存储我们这里学习 Chroma 向量数据库,本质上也是用文件存储,首先确保 langchain-chroma chromadb 这两个库安装了的,如果没有安装得用 pip install,然后将 vector_store 替换成 Chroma,同时创建 Chroma 的时候提供表名和本地存储的文件夹,其他代码都不用动。./data/info.csv 的内容如下。
go
from langchain_chroma import Chroma
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.document_loaders import CSVLoader

vector_store = Chroma(
    # 数据库表名
    collection_name="test",
    # 嵌入模型,提供文本转向量模型
    embedding_function=DashScopeEmbeddings(),
    # 指定数据存放的文件夹
    persist_directory="./chroma_db"
)


loader = CSVLoader(
    file_path="./data/info.csv",
    encoding="utf-8",
    source_column="source",     # 指定本条数据的来源是哪里
)

documents = loader.load()
# id1 id2 id3 id4 ...
# 向量存储的 新增、删除、检索
vector_store.add_documents(
    documents=documents,        # 被添加的文档,类型:list[Document]
    ids=["id"+str(i) for i in range(1, len(documents)+1)] # 给添加的文档提供id(字符串)  list[str]
)

# 删除  传入[id, id...]
vector_store.delete(["id1", "id2"])

# 检索 返回类型list[Document]
result = vector_store.similarity_search(
    "Python是不是简单易学呀",
    3,        # 检索的结果要几个
    # 表示过滤,只要 source 是 黑马程序员 的结果
    filter={"source": "黑马程序员"}
)

print(result)
最后结果输出如下:
go
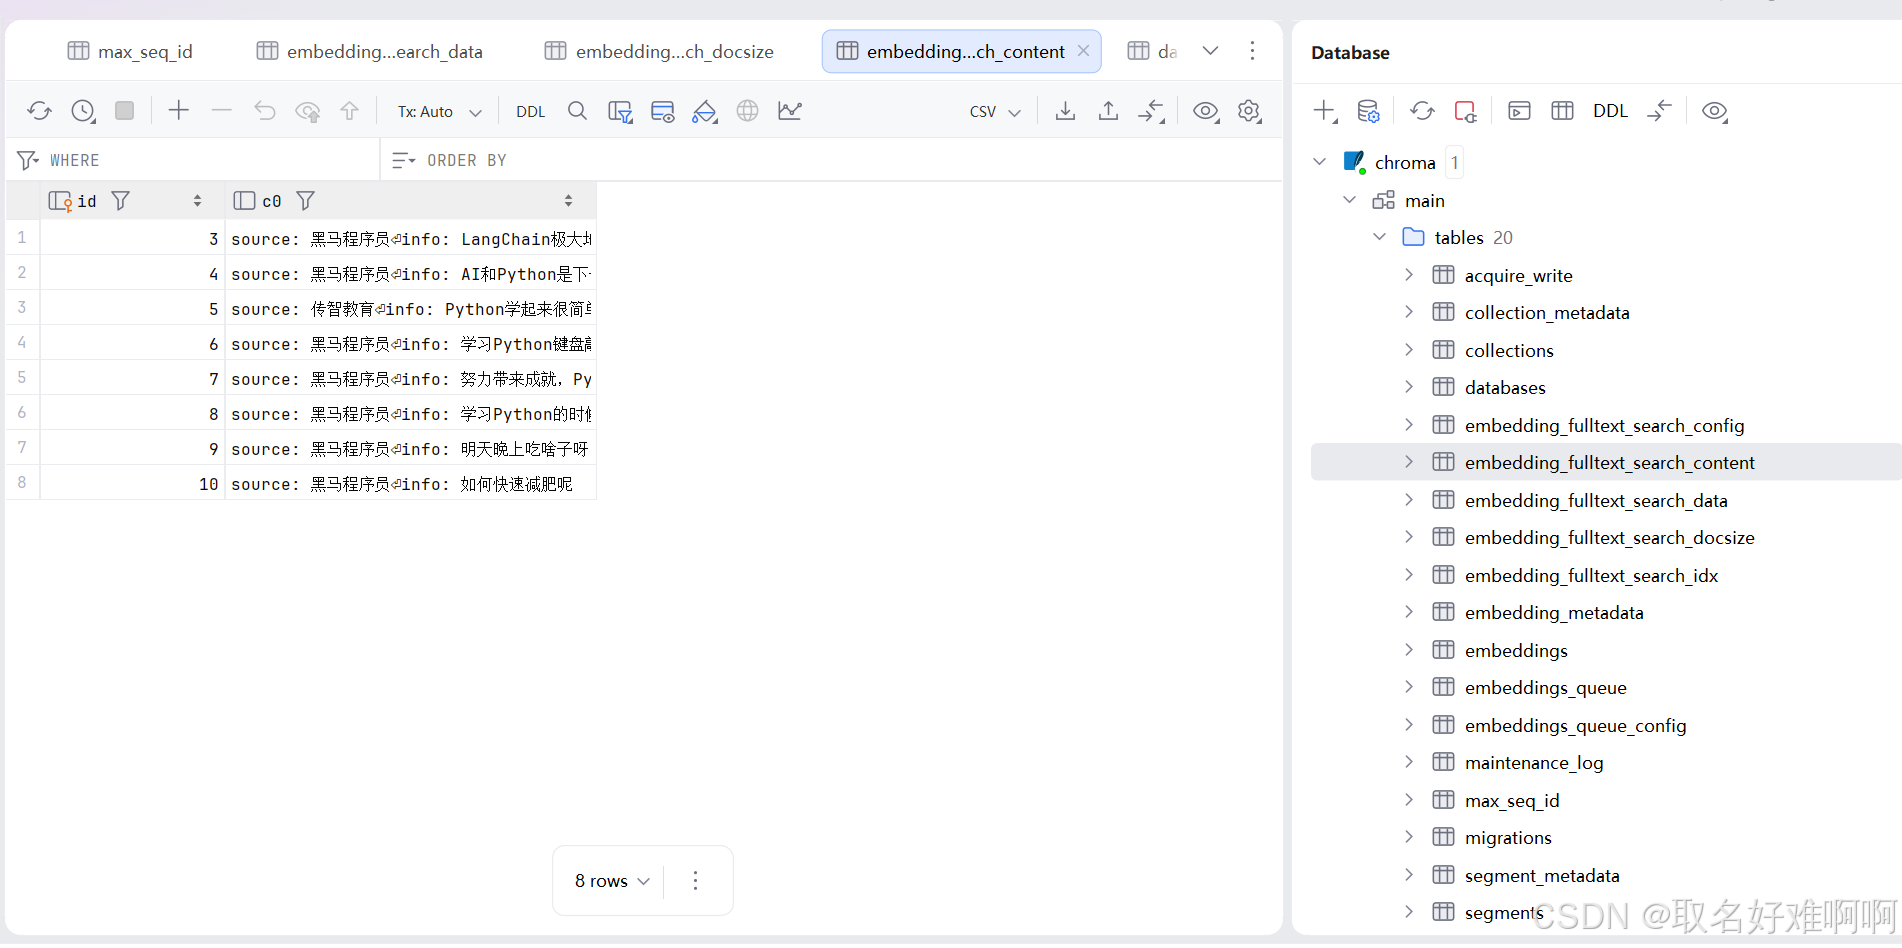
[Document(id='id7', metadata={'row': 6, 'source': '黑马程序员'}, page_content='source: 黑马程序员\ninfo: 努力带来成就,Python助力辉煌'), Document(id='id8', metadata={'row': 7, 'source': '黑马程序员'}, page_content='source: 黑马程序员\ninfo: 学习Python的时候也要记得好好休息打打篮球'), Document(id='id6', metadata={'source': '黑马程序员', 'row': 5}, page_content='source: 黑马程序员\ninfo: 学习Python键盘敲烂月薪过万')]同时可以看到 db 里面已经存储向量了。
2. 检索向量构建提示词询问模型
用户输入提示词之后,我们需要从向量库里面找出相关的数据,一起打包给大模型返回。
go
"""
提示词:用户的提问 + 向量库中检索到的参考资料
"""
from langchain_community.chat_models import ChatTongyi
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser


def print_prompt(prompt):
    print(prompt.to_string())
    print("=" * 20)
    return prompt


model = ChatTongyi(model="qwen3-max")
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "以我提供的已知参考资料为主,简洁和专业的回答用户问题。参考资料:{context}。"),
        ("user", "用户提问:{input}")
    ]
)

vector_store = InMemoryVectorStore(embedding=DashScopeEmbeddings(model="text-embedding-v4"))

# 准备向量资料, 往里面添加一些数据, add_texts 传入列表, 把列表里面的字符串转成向量存进去
vector_store.add_texts(
    ["减肥就是要少吃多练", "在减脂期间吃东西很重要,清淡少油控制卡路里摄入并运动起来", "跑步是很好的运动哦"])

input_text = "怎么减肥?"

# 检索向量库, 最多能返回两个结果, result 就是 [Document] 类型的
result = vector_store.similarity_search(input_text, 2)

# 拼接文档的内容
reference_text = "["
for doc in result:
    reference_text += doc.page_content
    reference_text += " end "
reference_text += "]"

# 构建请求链
chain = prompt | print_prompt | model | StrOutputParser()

# 执行结果
res = chain.invoke({"input": input_text, "context": reference_text})
print(res)
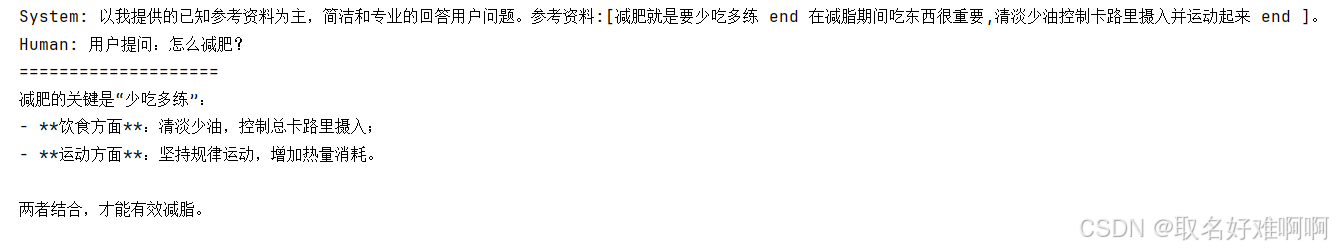
输出结果如下。
3. RunnablePassthrough 的使用
这一小节主要来看下如何把向量检索也加入链条里面,RunnablePassthrough 就可以完成这个功能,因为上面例子中 InMemoryVectorStore 不是 Runnable 的实例,所以没办法入链。
入链之后构建链我们希望是 chain = retriever | prompt | model | StrOutputParser,也就是将用户输入先去找到匹配的向量数据,然后统一交给 prompt 构建提示词,再交给 model,最后将返回结果交给 StrOutputParser 解析。
但是现实就是 retriever 的 invoke 方法返回的结果是 list[Document],输入是 str。而 prompt 的输入是 dict 类型,返回值是 PromptValue,因此不匹配!!! 而且这里有一个更严重的问题就是用户的提问丢失了,因为 retriever 没有将用户输入也返回,只返回匹配的结果。
go
"""
提示词:用户的提问 + 向量库中检索到的参考资料
"""
from langchain_community.chat_models import ChatTongyi
from langchain_core.documents import Document
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser


def print_prompt(prompt):
    print(prompt.to_string())
    print("=" * 20)
    return prompt


model = ChatTongyi(model="qwen3-max")
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "以我提供的已知参考资料为主,简洁和专业的回答用户问题。参考资料:{context}。"),
        ("user", "用户提问:{input}")
    ]
)

# InMemoryVectorStore 不是 Runnable 的实例,所以没办法入链
vector_store = InMemoryVectorStore(embedding=DashScopeEmbeddings(model="text-embedding-v4"))

# 准备向量资料, 往里面添加一些数据, add_texts 传入列表, 把列表里面的字符串转成向量存进去
vector_store.add_texts(
    ["减肥就是要少吃多练", "在减脂期间吃东西很重要,清淡少油控制卡路里摄入并运动起来", "跑步是很好的运动哦"])

input_text = "怎么减肥?"

# langchain中向量存储对象,有一个方法:as_retriever,可以返回一个Runnable接口的子类实例对象
# search_kwargs 代表最大返回几个结果
# retriever 的顶层接口就是 Runnable 接口, 因此可以入链
retriever = vector_store.as_retriever(search_kwargs={"k": 2})

"""
retriever:
    - 输入:用户的提问       str
    - 输出:向量库的检索结果  list[Document]
prompt:
    - 输入:用户的提问 + 向量库的检索结果   dict
    - 输出:完整的提示词                 PromptValue
"""

def format_func(docs: list[Document]):
    if not docs:
        return "无相关参考资料"

    formatted_str = "["
    for doc in docs:
        formatted_str += doc.page_content
    formatted_str += "]"

    return formatted_str

# chain = retriever | prompt | model | StrOutputParser
chain = (
        {"input": RunnablePassthrough(), "context": retriever | format_func } | prompt | print_prompt | model | StrOutputParser()
)

res = chain.invoke(input_text)
print(res)
上面是整体流程的代码,我们主要来看下 chain 的构建。
go
chain = (
        {"input": RunnablePassthrough(), "context": retriever | format_func } | prompt | print_prompt | model | StrOutputParser()
)
下面是问题的流程,问千问的。
go
                         ┌─→ RunnablePassthrough()  → 原样输出 → 赋给 key "input"
                         │
"你的问题" → RunnableParallel
                         │
                         └─→ retriever | format_func → 检索+格式化 → 赋给 key "context"
可以看到我们代码里面调用 invoke 把用户提问传进去之后,通过 RunnableParallel 并行提交给 dict 的每一个 value,RunnablePassthrough 会原样输出赋值给 input,context 会经过 retriever 先接受用户输入,然后调用 invoke 查询匹配的结果,再将结果传递给 format_func 转成字符串给 context,最终第一个 dict 的结构就是:
go
{
	"input": 用户原始问题,
	"context": 用户原始问题查询出来的向量匹配结果
}
将这个 dict 传递给 prompt 构成最终提示词,下面的流程就不用多说了。
至于为什么 dict 能作为第一个输入,那是因为 Runnable 的 __or__ 方法可以接受一个 Mapping[str, Runnable[Any, Other] 类型的输入,dict 是这个类的子类,因此也可以作为输入传进去。
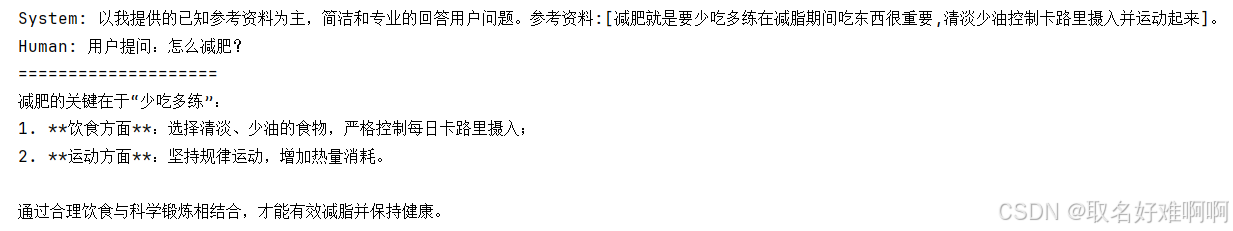
最终输出结果如下。
其实我感觉自己实现一个类,然后重写里面的 invoke 方法,将输入结果返回出去,将这个类替换 RunnablePassthrough 应该也可以。
如有错误,欢迎指出!!!!