本文摘要:慢查询为空而 P99 上涨,排查时应用层拿不到函数级耗时证据。用 cProfile 按 tottime 排序并过滤业务文件,可把耗时钉到具体的阻塞函数。
一、问题与结论
慢查询日志里一条记录都没有,数据库侧 CPU、连接数曲线都正常,压测下接口 P99 却在抬升。排查链路在 DB 侧断裂,故障被推给应用层,而应用侧没有现成指标能指出是哪个函数吃掉了时间。
RT 增量不在 SQL 执行:某个 async def 端点里的同步调用(同步 DB 驱动、requests、同步写文件、超大对象 json.dumps)占住事件循环,后续请求只能排队等它返回;这段等待计入 RT,却不落在任何数据库指标上。
结论先行:在 workers=1 的 uvicorn 进程里挂 cProfile,用 pstats 按 tottime 排序、以业务文件名正则过滤,可以把阻塞函数钉到具体端点。但证据在排序口径、线程范围、进程边界、profiler 开销四个变量失控时会自洽地指向错误对象,重点是证据怎么拿,以及这四种失败情形怎么防。
二、排查与选择依据
先拆分 RT 增量的三类来源,慢查询日志只覆盖第一类:
| 耗时来源 | DB 侧可见 | 应用侧表现 |
|---|---|---|
| SQL 执行本身 | 是 | 慢查询日志有记录 |
| Python 侧计算/序列化/同步 IO | 否 | 端点耗时上升 |
| 事件循环排队等待 | 否 | 端点耗时上升,单请求内部测不出这段等待 |
第三类是本文目标。选 cProfile 的理由:标准库、无第三方依赖、确定性记录每次调用与返回、可导出 .prof 离线复核、粒度到函数而非端点。代价同样明确:它对每次调用都计时,异步服务里协程切换次数极多,开启后 RT 会整体抬高。
替代方案与取舍
| 手段 | 选择条件 | 代价 | 边界 |
|---|---|---|---|
cProfile + pstats |
需要函数粒度证据、可重启、可短期加压 | 开销随调用次数上升 | 只记录启用它的线程,多进程需对齐 |
| asyncio 开发者模式(慢回调警告) | 只想证明存在阻塞回调 | 几乎零侵入,只到协程粒度 | 不给出协程内是哪个函数慢 |
| 采样类 profiler(第三方) | 只能附着已运行进程、担心确定性开销 | 引入依赖,需核对其时间语义 | 采样可能漏掉短促尖峰 |
time.perf_counter() 自埋点 |
已有怀疑对象 | 只覆盖埋了点的调用 | 对未知热点无能为力 |
不该用 cProfile 的场合:多进程或多 worker 未隔离、阻塞在工作线程或 C 扩展内部、生产需要常开时,改用采样类工具或 APM;只想快速确认"存在阻塞",先开 asyncio 开发者模式更省事。
三、关键原理
async def 端点跑在事件循环线程上,其内部的同步阻塞会推迟该循环上所有就绪任务;def 端点与 def 依赖由 Starlette 的线程池执行,阻塞被隔离到工作线程。
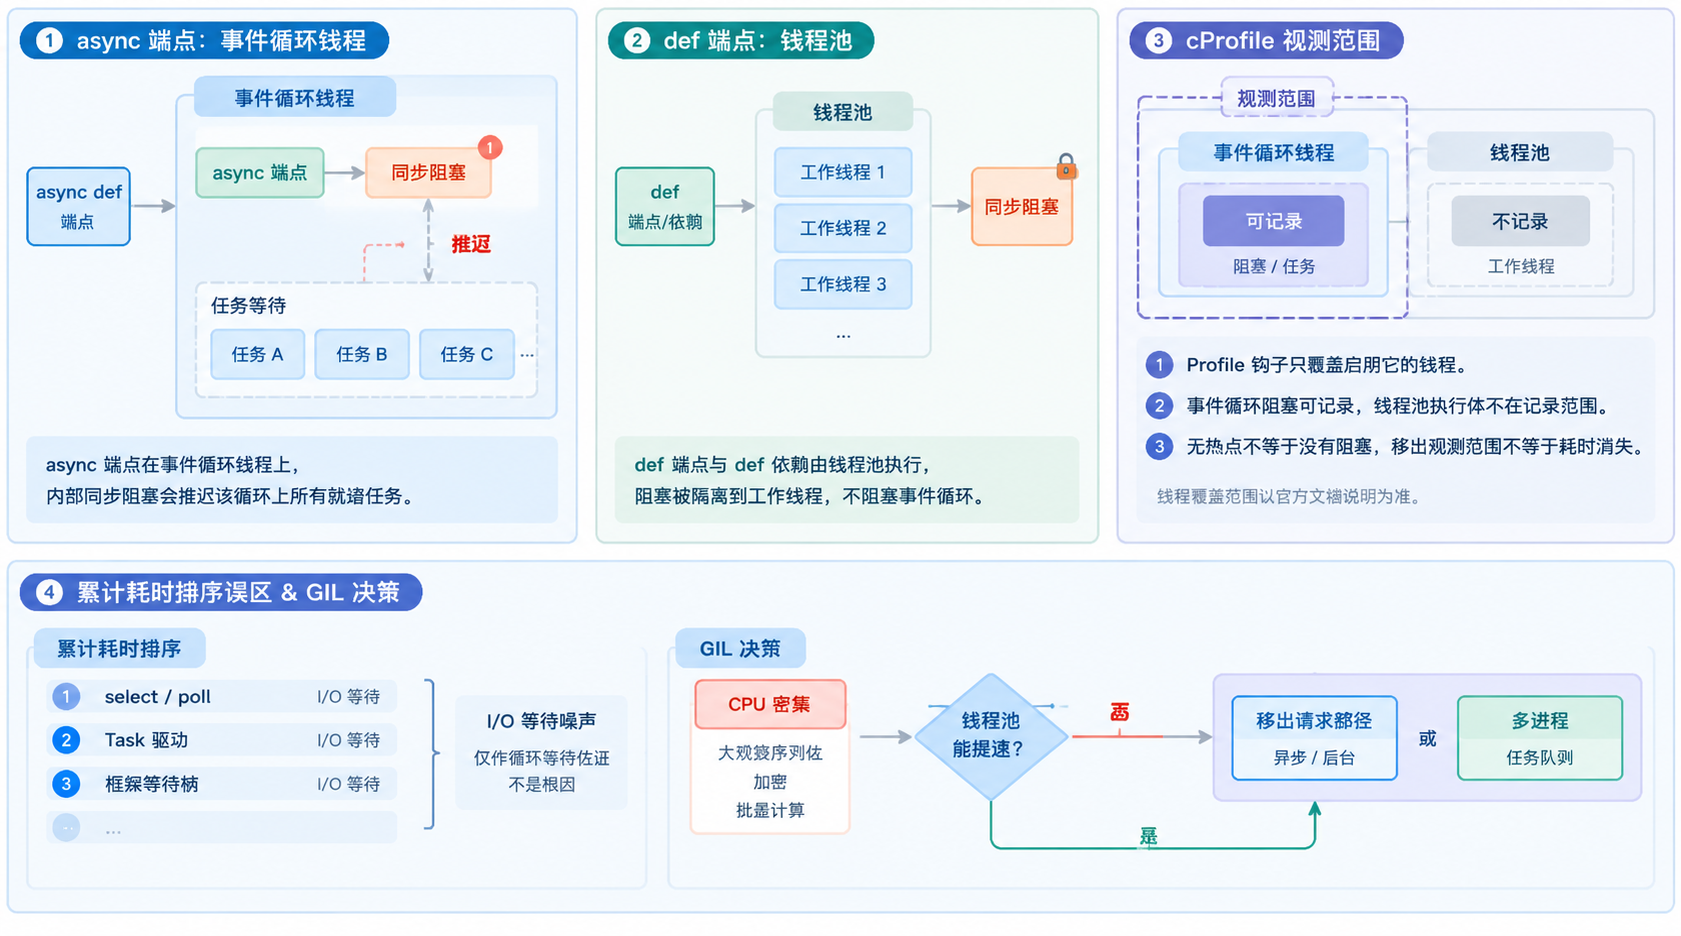
cProfile.Profile 的钩子只覆盖启用它的那个线程,由此有两个推论:事件循环线程上的阻塞能被记录,线程池里的执行体不在记录范围------"profile 里没热点"不等于"没有阻塞";反之,把端点改成 def 后 cProfile 看起来干净,也不代表耗时消失,只是移出了观测面。线程覆盖范围以官方文档的说明为准。
不加过滤地按累计耗时排序,selector 的 select/poll 等 I/O 等待帧与 Task 驱动帧常占榜首。事件循环大部分墙钟时间在等 I/O,那是噪声不是根因,框架帧只作"循环在等"的佐证。
还有 GIL:若阻塞实际是 CPU 密集(大对象序列化、加密、批量计算),丢进线程池并不能提高吞吐,同一时刻仍只有一个线程执行 Python 字节码,此时要么把计算移出请求路径,要么改多进程或多进程任务队列。
四、可运行示例
环境为 Python 3 + fastapi + uvicorn,无其他依赖,耗时数字须本地实测后填入。time.sleep 只是替身,换成任何同步阻塞调用结论一致。
app.py:
python
import os
import time
from contextlib import asynccontextmanager

from fastapi import FastAPI

BLOCK_MS = int(os.environ.get("BLOCK_MS", "40"))

@asynccontextmanager
async def lifespan(app: FastAPI):
    yield

app = FastAPI(lifespan=lifespan)

@app.get("/fast")
async def fast():
    return {"ok": True}

@app.get("/cpu")
async def cpu_route():
    # time.sleep 只是替身:同步 DB 驱动 / requests / 大对象 json.dumps 同理
    time.sleep(BLOCK_MS / 1000.0)
return {"blocked_ms": BLOCK_MS}run_prof.py:
python
import cProfile
import pstats

import uvicorn

def main():
    prof = cProfile.Profile()
    prof.enable()
    try:
        # 复现固定 workers=1、不加 --reload,否则 profiler 落不到事件循环所在进程
        uvicorn.run("app:app", host="127.0.0.1", port=8000,
                    workers=1, log_level="warning")
    except KeyboardInterrupt:
        pass
    finally:
        prof.disable()
        prof.dump_stats("loop.prof")

    st = pstats.Stats("loop.prof")
    st.strip_dirs()
    st.sort_stats("tottime").print_stats(30, r"app\.py")    # 起点:只看业务文件
    st.sort_stats("tottime").print_stats(30)                # 对照:噪声有多大
    st.sort_stats("tottime").print_callers(20, r"app\.py")  # 谁调用了可疑函数

if __name__ == "__main__":
main()load.py:
python
import threading
import time
import urllib.request

BASE = "http://127.0.0.1:8000"

def run(path, n_threads=8, n_each=50):
    out = []

    def hit():
        for _ in range(n_each):
            t0 = time.perf_counter()
            with urllib.request.urlopen(BASE + path) as r:
                r.read()
            out.append(time.perf_counter() - t0)

    ts = [threading.Thread(target=hit) for _ in range(n_threads)]
    t0 = time.perf_counter()
    for t in ts:
        t.start()
    for t in ts:
        t.join()
    s = sorted(out)
    q = lambda p: s[min(len(s) - 1, int(len(s) * p))] * 1000
    print(f"{path}: n={len(s)} wall={time.perf_counter() - t0:.2f}s "
          f"p50={q(.5):.1f}ms p99={q(.99):.1f}ms")

for p in ("/fast", "/cpu"):
    run(p)
操作步骤:先用普通方式起服务,跑一轮 python load.py 记基线;再 python run_prof.py 起服务,跑完全相同 的负载;Ctrl+C 停止后查看三张表。
预期输出 :/cpu 的 p50/p99 显著高于 /fast(数值待实测填入,本文未验证,不给编造数字);loop.prof 第一张表里 cpu_route 及其调用的阻塞帧 tottime 靠前;第二张表榜首是事件循环的 I/O 等待帧;第三张表显示可疑函数确由 cpu_route 触发而非启动阶段代码。
实际输出 :逐项核对上文三张表,并记录「不 profile」与「profile」两轮的 p50/p99 差值------这个差就是 profiler 开销,必须当作数据看待。再开 asyncio 开发者模式跑同负载(阈值参数名与默认值以官方文档为准),慢回调警告应指向 cpu_route,两份证据一致才下结论。
常见失败:loop.prof 里只有启动帧、看不到业务函数,多半是进程边界没对齐------workers=N 或 --reload 让 profiler 落在不跑事件循环的子进程上。修复:复现固定 workers=1、不用 --reload;多进程部署时在每个 worker 进程内单独 dump_stats,文件名带上 pid。
五、验证结果与边界
证据确认后再修,两种改法各有边界:
| 改法 | 效果 | 代价 | 不适用 |
|---|---|---|---|
换 httpx.AsyncClient 等异步驱动 |
事件循环不再被占 | 引入异步客户端,连接池生命周期要与 lifespan 对齐 |
目标库没有维护中的异步接口 |
交给线程池(端点改 def 或 run_in_threadpool) |
阻塞隔离到工作线程 | 线程池槽位有限,高并发下排队 | CPU 密集受 GIL 限制,需改多进程 |
四种会让 cProfile 给出错误结论的情形:排序口径错,把 I/O 等待帧当阻塞源;阻塞在工作线程,cProfile 根本没记录;profiler 自身开销摊薄占比或放大现象;进程边界没对齐。规避办法是固定 tottime 加业务文件过滤作为起点、框架帧只作佐证、同负载跑两轮量化开销,并用 asyncio 开发者模式交叉验证。
适用边界:单进程、单事件循环、可重启、可短期加压的定位阶段。多进程未隔离、阻塞在工作线程或 C 扩展内部、生产常开、需要捕捉短促尖峰时,都不该依赖本文方案。cProfile 不是唯一手段,它在函数粒度与离线复核上有优势,在线程覆盖、开销、多进程与短尖峰捕捉上有短板,短板部分需用上表的替代方案补上。