10 月 8 日 GitHub Trending 上,rea 单日新增 7,744 星,累计 19,367 星。我在 Electron 项目上实测了一周,把可用的工作流整理一份。证据和适配层两点上,rea 对国内中小团队的真实价值反倒比 Trending 上看到的数字更直接。
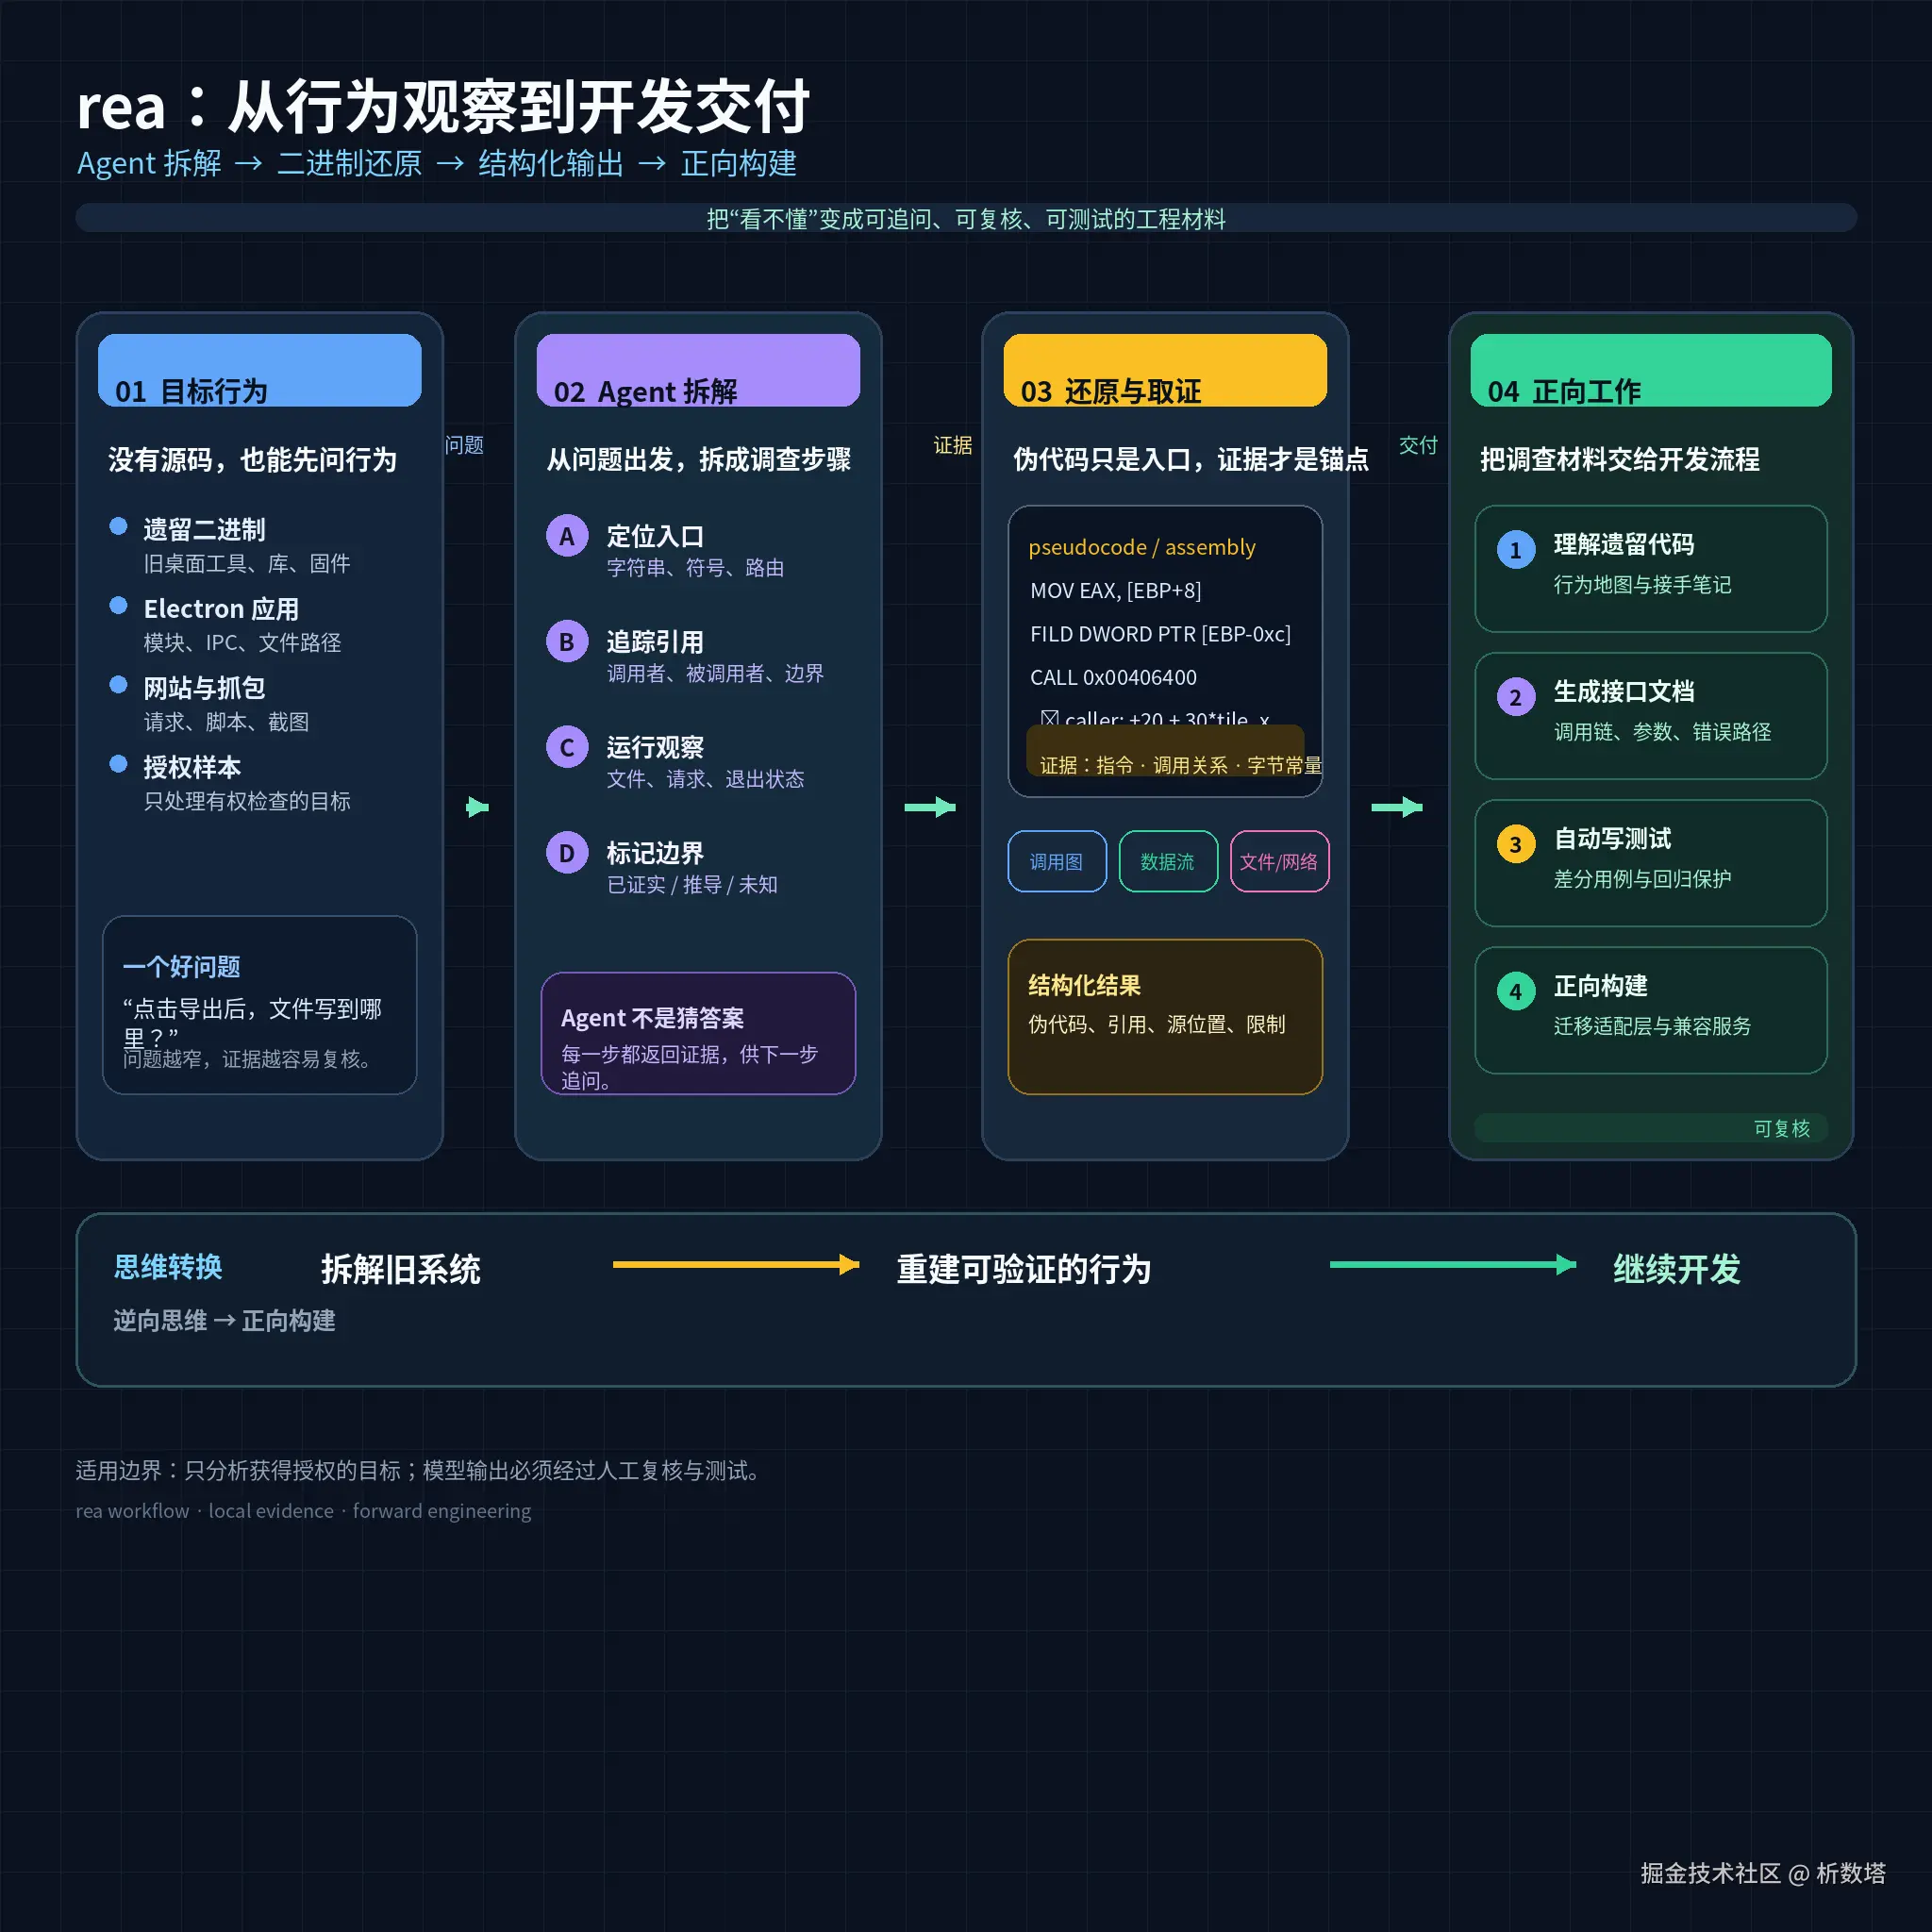
图:rea 的四列工作流 :: 目标行为 → Agent 拆解 → 还原与取证 → 正向构建。
安装与初始化
bash
npx rea-agents setup
# 进入交互式安装:选择后端 Hopper / Ghidra / IDA
# JavaScript 静态分析不需要原生引擎
# CLI 与 Agent 共享同一套调查步骤
安装后会产生 .rea/ 工作目录、<target>.rea-proj.json 配置文件,以及 MCP 工具注册信息。Agent 通过 MCP 拿到工具结果,CLI 也能独立调用同一套调查步骤。建议项目根目录加 .gitignore 排除 .rea/。
场景一:Electron 应用的导出链路取证
旧版桌面应用里"导出 CSV"按下去没反应,源码已经丢了。我们按下面这条链路做了调查:
javascript
// 1. 入口(渲染进程)
notes.exportCsv()

// 2. IPC 通道(preload)
contextBridge.exposeInMainWorld('notes', {
  export: () => ipcRenderer.invoke('notes:export'),
})

// 3. 主进程(handler)
ipcMain.handle('notes:export', async (_e, payload) => {
  const data = await loadNotes()
  const csv = await csvFromNotes(data)
  await downloadToUserDir(csv, 'notes.csv')
  return { ok: true, path: '~/Downloads/notes.csv' }
})

// 4. 文件落盘
// /Users/<user>/Downloads/notes.csv
让 Agent 顺着链路走:
text
Q: 找出 exportCsv() 从触发到落盘之间的全部调用与文件路径,给每步附源位置。
A:
  - 入口 notes.exportCsv() → src/renderer/notes.js:42
  - IPC 通道 notes:export → src/preload/index.js:18
  - 主进程 handler → src/main/ipc/notes.js:7
  - 文件 output → ~/Downloads/notes.csv(via Downloads 渠道)
  - 失败分支:取消选择目录时返 { ok: false, code: 'E_CANCEL' }
  - 未解:未观察到 timeout 退出码
这就是一张行为地图:谁调用谁、数据在哪拐弯、文件在何时产生。接手者从入口逐层核对权限、编码、失败路径,比从零读二进制强得多。
场景二:原生模块 :: DX-Ball 案例的数字
rea 官方 Native 指南里,DX-Ball 把一个原生函数逆向还原成 C,重新编译后跑用例:
text
指标        原生函数     重新实现的 C 函数
输入用例     3,205 个    3,205 个
编译字节     63 字节     63 字节(位级一致)
差分通过率   100%        100%
普通团队不必追求这个数字。它想说的是:能拿到稳定输入、明确输出、可在 CI 重跑的差分结果,已经足以支撑任何规模的模块重构。测试断言要落在可观察行为上,绑死内部函数名等于绑定到一份迟早过时的实现细节。
bash
# 行为记录,准备输入
rea run --input=normal.txt,boundary.txt,error.txt \
        --record=stdout,file-diff,network,exit \
        --target=./legacy-app.exe

# 差分测试
rea diff --record=./.rea/run-20261008.json \
         --baseline=master
场景三:整理接口卡片,按证据逐项填
内部 RPC 写得糙,调用方却散在各处。让 Agent 按证据填接口卡片比让模型"凭印象"写 API 文档靠谱得多。每张卡片要包含下面这些字段:
yaml
card:
  name: notes.export
  type: ipc-main
  caller: src/renderer/notes.js:42 (via preload bridge)
  handler: src/main/ipc/notes.js:7
  input: { ids: string[], format: 'csv' | 'json' }
  output: { ok: boolean, path?: string, code?: string }
  side_effects:
    - file_write: ~/Downloads/notes.csv
  errors:
    - E_CANCEL (source: notes.js:23 :: observe)
    - E_TIMEOUT (source: unverified)
  references:
    - file: src/main/ipc/notes.js
      line: 7-29
卡片里区分"已观察到"、"由代码推导"、"仍未知"三类标注。每条结论都有源位置,将来版本更新重新跑调查,文档跟着更新。生成的 Markdown 放进仓库,CI 加一道 rea diff --check 卡住行为偏差。
场景四:迁移适配层 :: 旧程序和新工程之间的桥
调查走完之后的归宿常常是适配层。旧程序只剩可执行文件时,按这个顺序推进:
每一步都保留授权边界:只分析有权检查的目标,不把逆向结果直接当成可发布代码。逆向回答旧程序做了什么,正向工程回答新程序怎样保持同样的结果。
别忘了:LLM 会幻觉
2025 年的两项研究先后指出:
- Frontiers in Computer Science 的比较研究把 LLM 方法与传统形式化逆向并列评估。结论是模型方法在语义正确性上与传统方法有差距,能否支撑后续正向工程要看证据链(见【引用5】)。
- arXiv 的二进制可视化 Agent 工作报告,小程序生成的调用图质量差异很大(见【引用6】)。
这两件事印证同一个教训:模型会幻觉、过度抽象、写出不稳定规格。证据链抵消这些偏差,每条结论都要有源位置、有调用路径、有最小复现步骤。三件事缺一,结论只能当草稿。
落地只走四步
- 选一个你有权检查、又有明确行为的旧模块,先问一个窄问题。
- 要求 Agent 同时返证据、限制和未解分支,别只收一段摘要。
- 把结果转成行为地图和接口卡片,再写一组差分测试。
- 测试稳定后,才把迁移适配层、重构代码或文档合入仓库。
把逆向放回开发流程,它承担的是调查和取证。新程序能否继续维护,要看这些材料有没有变成文档、测试和适配层。rea 把原本依赖个人经验的过程,拆成 Agent 能追问、开发者能复核、CI 能执行的工程步骤。我们建议从一个授权的旧模块开始:找出入口,列出证据,跑一组差分测试。只要结果能复现,文档和测试就能留下;工具会换,证据链才是能带进下一个版本的资产。