第 8 题:拓扑排序------四个小朋友怎样排队?
考点
有向无环图、拓扑排序
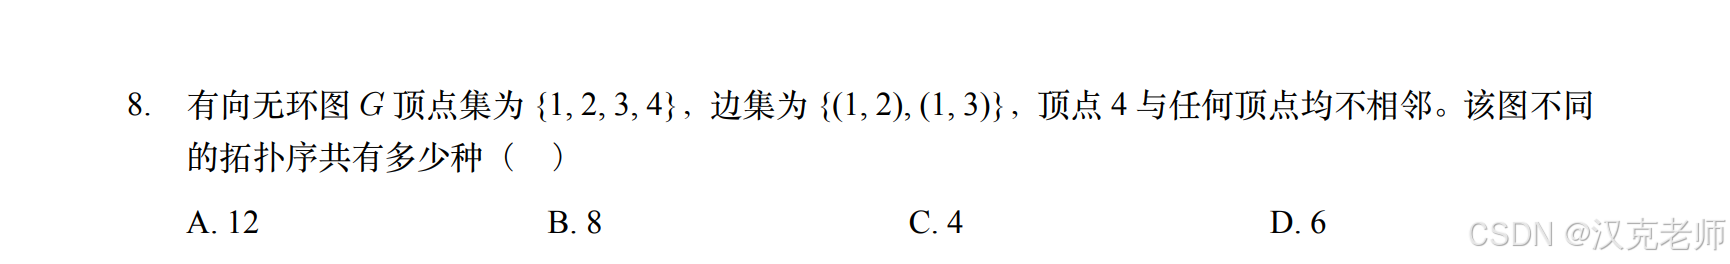
题目给出一个有向无环图:
-
顶点:{1,2,3,4}
-
边:{(1,2),(1,3)}
-
顶点 4 与任何顶点都不相邻。
问:这个图有多少种不同的拓扑序?
-
A. 12
-
B. 8
-
C. 4
-
D. 6
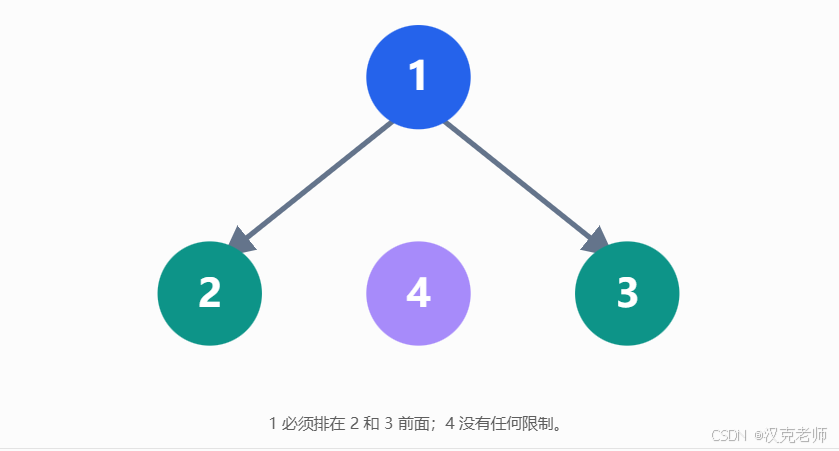
第一步:把图画出来
边 (1, 2) 表示 1 指向 2,边 (1, 3) 表示 1 指向 3。
第二步:理解什么叫拓扑序
拓扑序就是给图中的顶点排队,并且满足所有箭头的要求。
例如:
1, 2, 3, 4
是合法的,因为 1 在 2、3 前面。
但:
2, 1, 3, 4
不合法,因为 1 指向 2,1 必须排在 2 前面。
因此,我们只需要记住:
-
1 必须在 2 前面。
-
1 必须在 3 前面。
-
2 和 3 之间没有先后限制。
-
4 可以排在任何位置。
第三步:先决定 1 的位置
因为 1 必须排在 2、3 前面,所以 1 不可能排在最后,也不可能排在 2 或 3 后面。
我们分情况讨论。
情况一:1 排在第 1 位。
剩下的 2、3、4 可以任意排列:
3! = 6
种。
情况二:1 排在第 2 位。
那么 2 和 3 都必须排在 1 后面。
第 1 位只能由 4 占据,因此只剩下 2、3、4 的排列方式受到限制,具体只有:
4, 1, 2, 3
4, 1, 3, 2
共 2 种。
所以总数为:
6+2 = 8
正确答案:B(8)。
小结
拓扑排序不是要求所有点都按编号排列,而是要求所有箭头的先后关系都成立。
遇到这种题,先找出"谁必须在谁前面",再分类计数,通常比直接枚举全部排列更清晰。
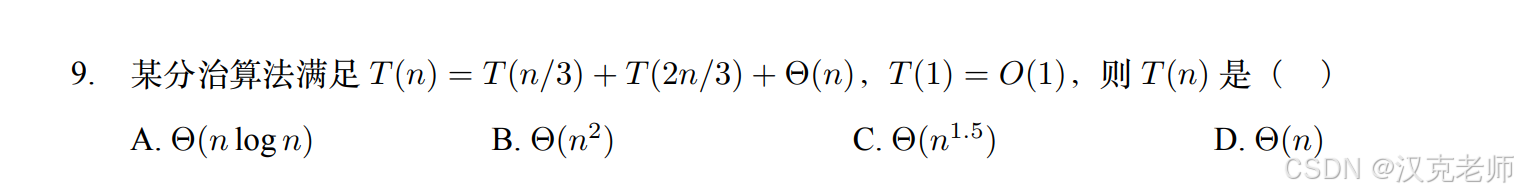
第 9 题:分治算法------把大任务拆成两个小任务
考点
分治算法、时间复杂度
题目给出:
T(n) = T(n/3) + T(2n/3) + Θ(n)
并且:
T(1) = O(1)
问:T(n) 的渐进时间复杂度是什么?
-
A. Θ(nlogn)
-
B. Θ(n^2)
-
C. Θ(n^{1.5})
-
D. Θ(n)
第一步:看懂题目要求
想象你要完成一个大任务,规模是 n。
你把它分成两份:
-
第一份规模是 n / 3。
-
第二份规模是 2n / 3。
除了完成这两个小任务,你还要花费 Θ(n) 的时间来分配任务、整理结果等。
因此:
T(n)=T(n/3)+T(2n/3)+Θ(n)
这里的 Θ(n) 可以理解为:额外工作量与 n 成正比。
第二步:画出分治的任务树
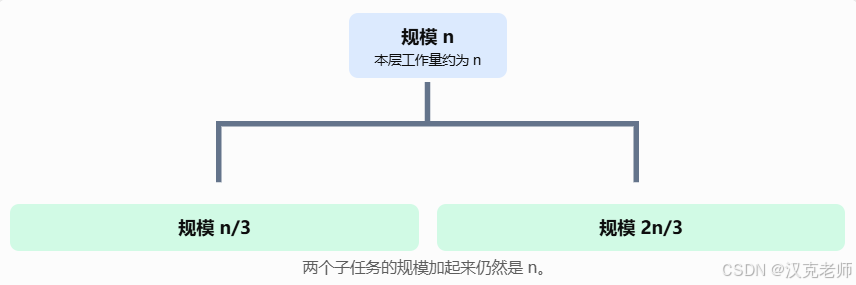
一点特别重要:
第一层的工作量大约是 n,
第二层所有子任务的规模总和仍然约为 n。
继续分下去,每一层的总工作量都可以理解为约 n。
第三步:一共有多少层?
每次沿着最大的子任务继续走,规模会变成原来的 2/3。
经过 k层后,规模大约为:
当它下降到 1 左右时,递归就结束了。
因此:
≈1
整理可得:
换成渐进复杂度的写法,就是:
k=Θ(logn)
第四步:总工作量是多少?
每一层的总工作量约为 n,而层数约为 logn。
所以:
T(n)=Θ(n)×Θ(logn)
最终得到:
正确答案:A。
小结
分治题可以先问两个问题:
-
每一层的总工作量是多少?
-
一共需要多少层?
这道题每层约为 n,一共约有 logn层,所以得到 nlogn。
注意:不能只看"分成了两个子问题",还必须看子问题的规模以及每层的总工作量。
第 10 题:树的直径与重心------树上最远的两座城市在哪里?
考点
树、直径、重心
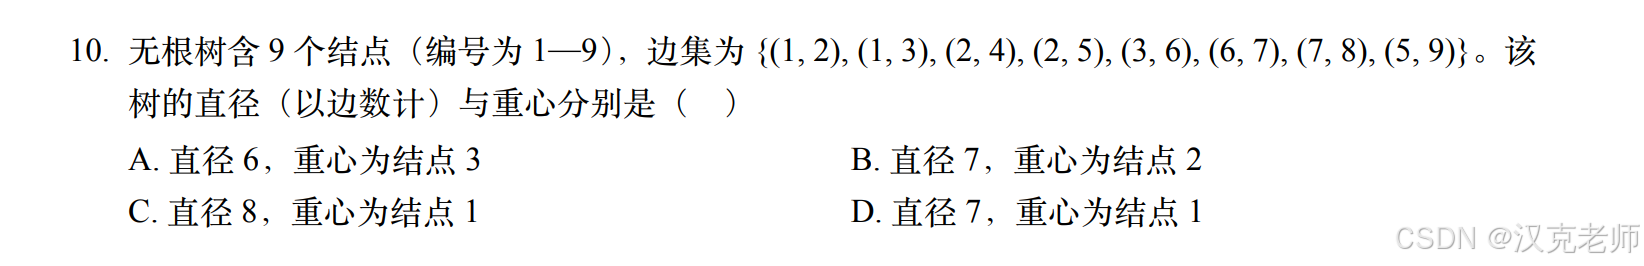
题目给出一棵有 9 个结点的无根树,边如下:
(1,2),(1,3),(2,4),(2,5),(3,6),(6,7),(7,8),(5,9)
问:树的直径(按边数计算)和重心分别是什么?
-
A. 直径 6,重心为结点 3
-
B. 直径 7,重心为结点 2
-
C. 直径 8,重心为结点 1
-
D. 直径 7,重心为结点 1
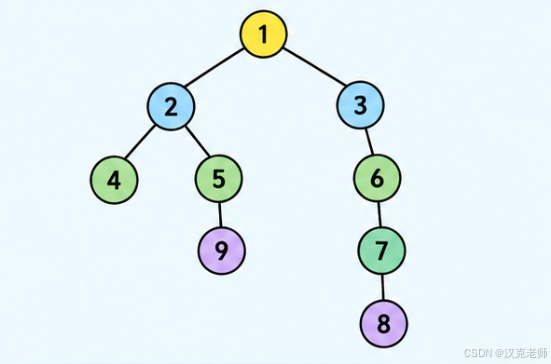
第一步:把树画出来
根据题目中的边,可以画出下面的结构:
第二步:什么是树的直径?
树的直径就是:任意选择两个结点,它们之间的距离可能达到的最大值。
这里的距离按经过的边数计算,不是经过的结点数。
观察这棵树,可以发现最长的一条路径是:
9→5→2→1→3→6→7→8
我们数一数:
| 路径 | 经过的边数 |
|---|---|
| 9 → 5 | 1 |
| 5 → 2 | 2 |
| 2 → 1 | 3 |
| 1 → 3 | 4 |
| 3 → 6 | 5 |
| 6 → 7 | 6 |
| 7 → 8 | 7 |
所以,树的直径为 7。
注意:这条路径一共有 8 个结点,但只有 7 条边。题目明确要求按边数计算,因此答案不是 8。
第三步:什么是树的重心?
树的重心和几何中心不是一回事。
想象你要把一棵树形结构从某个结点切开。切掉这个结点后,树会分成若干个连通部分。
如果选择一个结点切掉后,剩下的所有部分中,最大的那一部分尽可能小,那么这个结点就是树的重心。
这棵树一共有 9 个结点。
我们分别检查结点 1 和结点 2。
如果删除结点 1:
-
左侧部分:结点 2、4、5、9,共 4 个。
-
右侧部分:结点 3、6、7、8,共 4 个。
最大部分有 4 个结点。
如果删除结点 2:
-
结点 4 单独成为一部分,有 1 个结点。
-
结点 5、9 成为一部分,有 2 个结点。
-
另一侧的结点 1、3、6、7、8,共 5 个。
最大部分有 5 个结点。
删除结点 1 后,最大的部分只有 4 个结点;删除结点 2 后,最大的部分有 5 个结点。
因此,结点 1 更符合重心的定义。
正确答案:D(直径 7,重心为结点 1)。
小结
-
树的直径:找最远的两个结点之间的最长路径。
-
树的重心:删除后,最大连通部分尽可能小的结点。
这两个概念名字相似,但定义完全不同,不要混淆。
第 11 题:缩点后的有向无环图------最少需要添加几条边?
考点
强连通分量、缩点、有向无环图
题目说:一张有向图缩点后得到一个有向无环图(DAG),其中:
-
一共有 6 个顶点。
-
入度为 0 的顶点有 3 个。
-
出度为 0 的顶点有 4 个。
问:为了使原图变成强连通图,至少需要添加多少条有向边?
-
A. 7
-
B. 6
-
C. 4
-
D. 3
第一步:认识入度和出度
想象每个结点是一座城市,箭头是单向道路。
-
入度:有多少条箭头指向这个城市。
-
出度:有多少条箭头从这个城市指向外面。
入度为 0 的结点,没有其他结点能直接沿箭头进入它。
出度为 0 的结点,没有箭头从它通向其他结点。
在有向无环图中,入度为 0 的点称为源点,出度为 0 的点称为汇点。
第二步:什么叫强连通?
强连通的意思是:
对于任意两个结点 u 和 v,都能从 u沿有向边到达 v,也能从 v 到达 u。
简单说,每个城市都必须能通过单向道路到达其他所有城市。
第三步:记住缩点后的经典结论
对于一个已经缩点、且包含至少两个顶点的有向无环图,最少需要添加的边数为:
其中:
-
S:入度为 0 的顶点数。
-
T:出度为 0 的顶点数。
为什么?
每个源点都需要获得进入它的路径,每个汇点都需要获得离开它的路径。通过合理连接这些源点和汇点,可以把整个图串成一个能够互相到达的环。
这条结论是有向图算法中的经典定理。
第四步:代入题目数字
题目给出:
S=3,T=4
因此:
max(3,4) = 4
正确答案:C(4)。
小结
遇到这种题,如果题目明确说的是"缩点后得到的 DAG",就要想到强连通分量的经典结论。
需要注意:如果缩点后只剩一个顶点,图已经强连通,不需要添加边;本题有 6 个顶点,不属于这种特殊情况。
第 12 题:6 个结点能组成多少种不同的二叉树?
考点
二叉树形态、卡特兰数
题目问:含有 6 个结点的不同形态二叉树有多少棵?
结点不带标号,并且区分左右子树。
-
A. 42
-
B. 429
-
C. 132
-
D. 720
第一步:什么叫不同形态?
我们先看只有 3 个结点的二叉树。
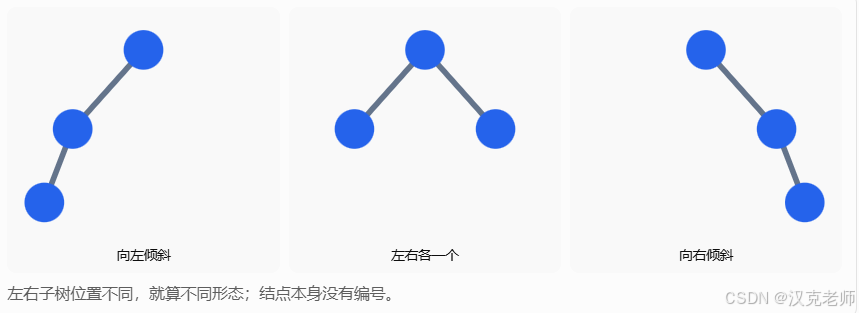
当结点数量增加时,可能的形态数量增长得非常快。
这道题有一个专门的数学工具:卡特兰数(Catalan number)。
第二步:为什么二叉树数量和卡特兰数有关?
假设一棵二叉树有 n个结点。
根结点占用 1 个结点,剩下 n−1 个结点要分给左子树和右子树。
如果左子树有 i 个结点,那么右子树就有:
n−1−i
个结点。
因此,可以得到递推式:
其中:
空树也算一种形态,这是递推公式的起点。
通项公式:
第三步:逐步计算
前几个卡特兰数是:
| 结点数 n | 不同形态的数量 |
|---|---|
| 0 | 1 |
| 1 | 1 |
| 2 | 2 |
| 3 | 5 |
| 4 | 14 |
| 5 | 42 |
| 6 | 132 |
因此,6 个结点对应:
正确答案:C(132)。
第四步:怎样帮助记忆?
卡特兰数不只用在二叉树上,还出现在合法括号序列、某些入栈出栈方案计数等问题中。
如果考试直接问 6 个结点的不同形态二叉树数量,可以通过递推计算,或者记住前几个常用结果。
但要特别注意:题目说"不带标号,区分左右子树",这是形态计数,不是给 6 个结点分别编号后的二叉树数量。
第 13 题:字符串的前缀与后缀------找出首尾相同的小片段
考点
字符串、真前缀、真后缀
给定字符串:
string S = "ababaabab";问:所有既是真前缀又是真后缀的非空子串,其长度之和是多少?
-
A. 4
-
B. 6
-
C. 7
-
D. 5
第一步:什么是前缀?
字符串的前缀,就是从开头开始截取的一段。
例如:
S = ababaabab它的前缀包括:
a
ab
aba
abab
ababa
...
什么叫真前缀?
不能是字符串本身。
因此,整个 ababaabab 不算真前缀。
第二步:什么是后缀?
后缀就是从字符串末尾开始截取的一段。
例如:
S = ababaabab它的后缀包括:
b
ab
bab
abab
aabab
...
同样,真后缀也不能是整个字符串。
第三步:找出既是前缀又是后缀的片段
我们从较短的长度开始检查。
| 长度 | 前缀 | 后缀 | 是否相同 |
|---|---|---|---|
| 1 | a |
b |
否 |
| 2 | ab |
ab |
是 |
| 3 | aba |
bab |
否 |
| 4 | abab |
abab |
是 |
| 5 | ababa |
aabab |
否 |
| 6 | ababaab |
baabab |
否 |
| 7 | ababaab? |
--- | 重新按字符串位置判断 |
我们只需要正确找到所有相同的非空真前缀和真后缀。这里的字符串长度为 9:
下标: 0 1 2 3 4 5 6 7 8
字符: a b a b a a b a b
前缀 ab 与后缀 ab 相同,长度为 2。
前缀 abab 与后缀 abab 相同,长度为 4。
其他长度的前缀与后缀都不相同。
第四步:求长度之和
2+4=6
正确答案:B(6)。
小结
这道题最稳妥的方法是:
-
明确字符串长度。
-
从长度 1 开始,分别取前缀和后缀。
-
比较两段字符串是否相同。
-
排除整个字符串本身。
-
把符合条件的长度相加。
注意:本题只要求真前缀和真后缀,不是要求所有相同子串,也不是要求最长公共子串。
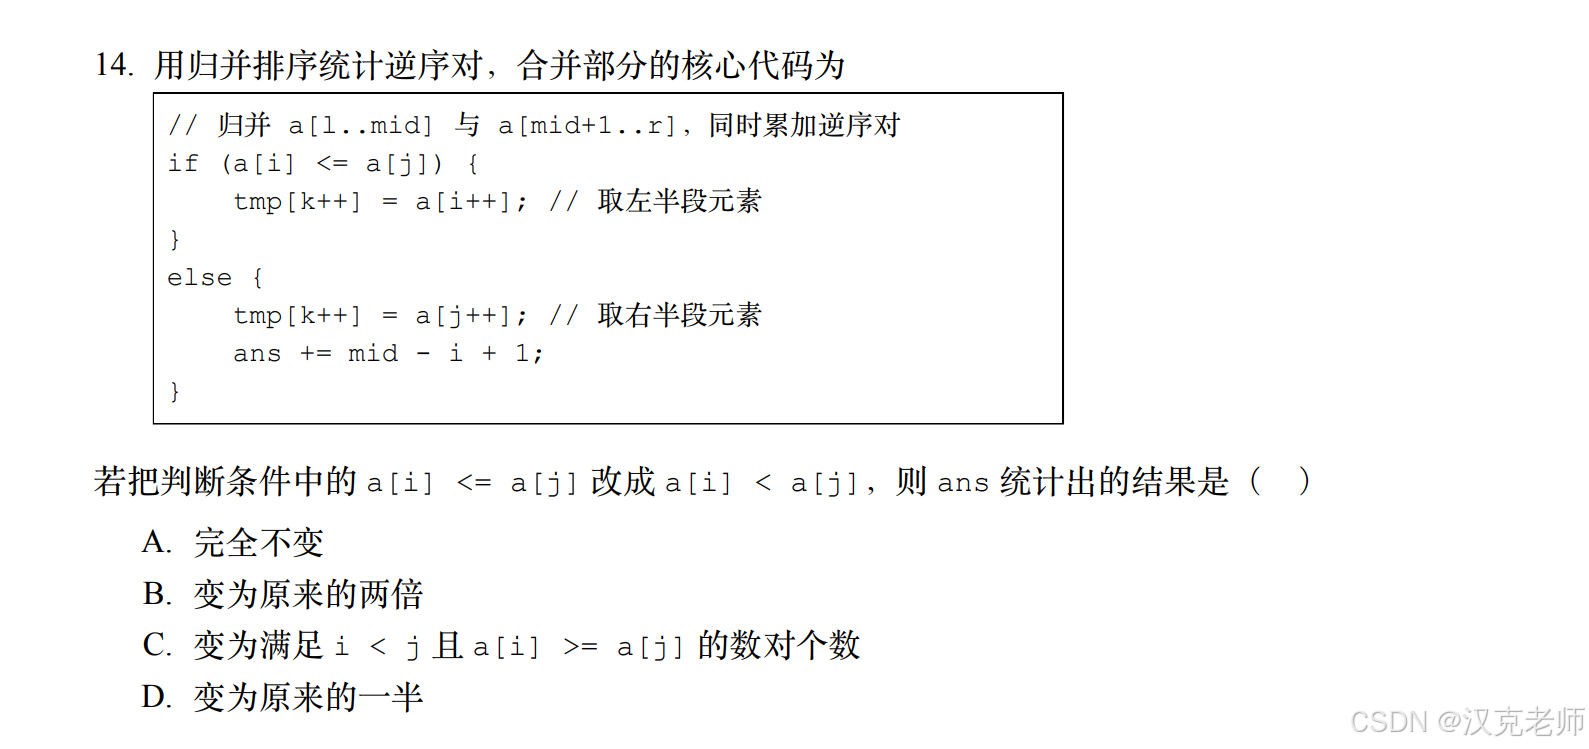
第 14 题:归并排序统计逆序对------相等的数字算不算?
考点
归并排序、逆序对、比较运算符
题目给出归并排序统计逆序对的核心代码:
if (a[i] <= a[j]) {
    tmp[k++] = a[i++];
}
else {
    tmp[k++] = a[j++];
    ans += mid - i + 1;
}
如果把判断条件中的:
a[i] <= a[j]改成:
a[i] < a[j]那么 ans 统计出的结果会变成什么?
-
A. 完全不变
-
B. 变为原来的两倍
-
C. 变为满足 i<j 且 ai ≥ aj 的数对个数
-
D. 变为原来的一半
第一步:什么是逆序对?
想象有一排数字:
3 1 2如果一个数字在前面,另一个数字在后面,但前面的数字更大,就形成一个逆序对。
例如:
-
(3, 1)是逆序对,因为 3>1 。 -
(3, 2)是逆序对,因为 3>2 。 -
(1, 2)不是逆序对,因为 1<2 。
所以,这组数字一共有 2 个逆序对。
通常,逆序对的定义要求:
i < j, ai > aj
注意,这里是严格大于号 >,不是大于等于号 >=。
第二步:归并排序为什么能够统计逆序对?
归并排序会把数组分成左右两部分,并让左右两部分分别有序。
假设左边是:
2 4 6右边是:
1 3 5如果当前左边数字是 4,右边数字是 3,那么右边的 3 比左边的 4 小。
因为左边已经排好序,所以 4 后面的 6 也一定比 3 大。
因此,右边的 3 会与左边的 4、6 形成逆序对,一共 2 个。
代码:
ans += mid - i + 1;就是一次性统计左边从 i 到 mid 的所有数字与当前右边数字构成的逆序对数量。
第三步:原来的 <= 有什么作用?
原代码是:
if (a[i] <= a[j]) {
    tmp[k++] = a[i++];
}
else {
    tmp[k++] = a[j++];
    ans += mid - i + 1;
}
如果两个数字相等,例如:
左边:2
右边:2
那么:
2 <= 2结果为真。
程序进入 if 分支,取出左边的数字,不会增加 ans。
这很合理,因为相等的数字不构成通常定义下的逆序对。
第四步:改成 < 后会发生什么?
修改后:
if (a[i] < a[j]) {
    tmp[k++] = a[i++];
}
else {
    tmp[k++] = a[j++];
    ans += mid - i + 1;
}
现在,如果左右两边的数字相等:
2 < 2结果为假!
程序会进入 else 分支,并执行:
ans += mid - i + 1;这意味着:相等的数字也会被计入统计结果。
因此,修改后的程序统计的不是严格逆序对,而是满足以下条件的数对:
i < j, ai ≥ aj
其中既包括前面的数字大于后面的数字,也包括两者相等的情况。
正确答案:C。
第五步:用一个例子验证
数组:
2 2原来的逆序对数量为 0,因为两个数字相等。
但修改后的程序会将这对相等的数字也计入统计。
| 比较条件 | 两个数字相等时 | 是否计入 |
|---|---|---|
a[i] <= a[j] |
进入 if |
否 |
a[i] < a[j] |
进入 else |
是 |
小结
这是一个非常经典的程序阅读陷阱。
< 和 <= 只差一个等号,但当程序统计的是数量时,这个等号可能直接改变答案。
做题时一定要问:边界相等时,程序到底会进入哪个分支?
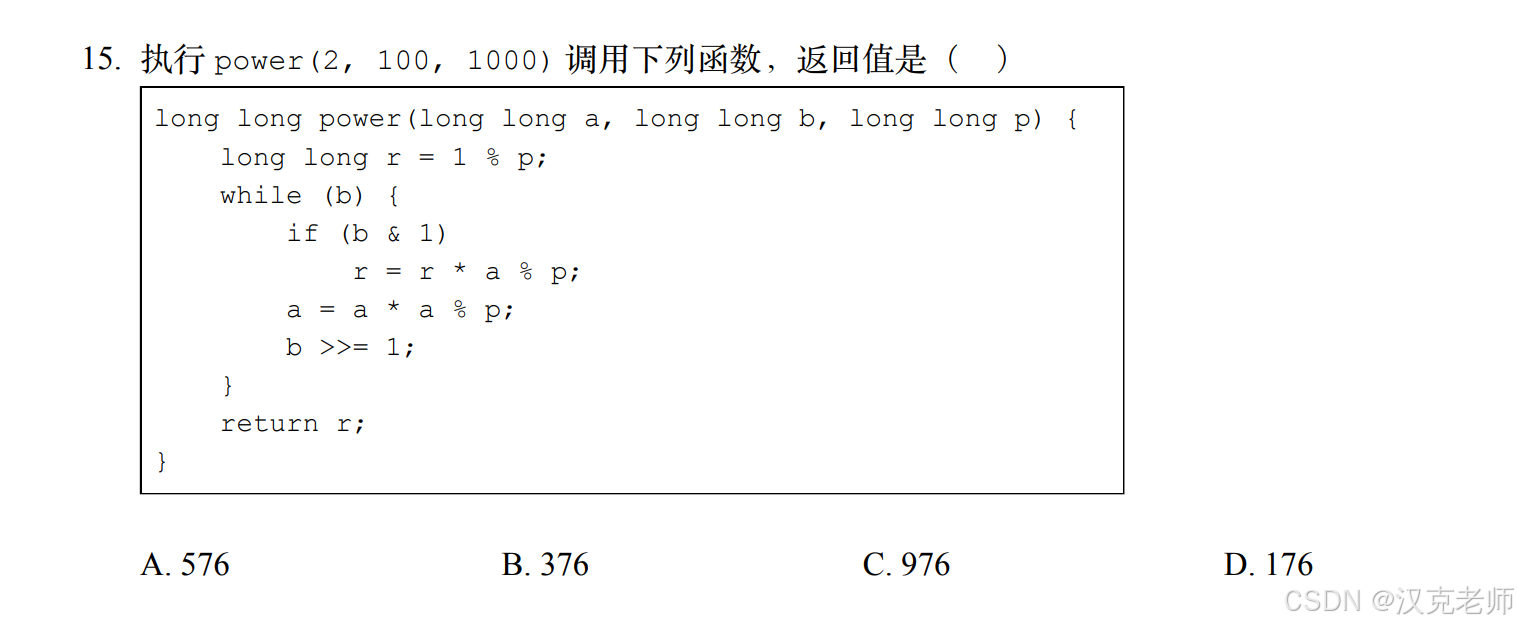
第 15 题:快速幂
考点
快速幂、二进制拆分、取模
题目给出下面的函数:
long long power(long long a, long long b, long long p) {
    long long r = 1 % p;

    while (b) {
        if (b & 1)
            r = r * a % p;

        a = a * a % p;
        b >>= 1;
    }

    return r;
}
执行:
power(2, 100, 1000)返回值是多少?
-
A. 576
-
B. 376
-
C. 976
-
D. 176
第一步:题目到底要求什么?
我们要求:
也就是计算 除以 1000 的余数。
如果从 2 开始,连续乘 100 次,数字会变得非常大,普通整数无法保存这么大的完整结果。
快速幂的思路是:
把乘方拆成平方,再利用指数的二进制表示决定什么时候乘进答案。
第二步:理解代码中的三个关键操作
1. b & 1:检查指数是不是奇数
if (b & 1)如果 b 是奇数,那么 b & 1 为 1;如果 b 是偶数,则为 0。
例如:
5 的二进制是 101,末位是 1 → 奇数
6 的二进制是 110,末位是 0 → 偶数
所以,只有指数为奇数时,才执行:
r = r * a % p;2. a = a * a % p:不断平方
a = a * a % p;每次循环,都把当前的底数平方,并取模。
这样就能依次得到:
指数每次翻倍,不需要一个一个乘。
3. b >>= 1:指数除以 2
b >>= 1;这是右移一位,相当于对非负整数进行整除 2。
例如:
100 → 50 → 25 → 12 → 6 → 3 → 1 → 0当 b 变成 0,循环就结束。
第三步:手算关键结果
为了避免数字太大,我们始终只保留除以 1000 的余数。
首先:
所以:
继续平方:
只保留后三位:
再平方:
因此:
第四步:把 拆开
注意:
100=80+20
所以:
我们已经得到:
因此:
= 176 * 576 = 101376
所以,最终余数为:
正确答案:B(376)。
第五步:为什么快速幂这么重要?
假设指数从 100 变成 1,000,000,000。
如果使用普通循环,每次乘一次底数,就需要进行大量运算。
快速幂每次将指数除以 2,因此只需要大约:
O(logb)
次循环。
指数很大时,这种优化就非常重要。
本题记忆口诀
指数除以二,底数不断平方;奇数乘进答案,每一步都取模。
第 8---15 题答案汇总
| 题号 | 正确选项 | 核心考点 |
|---|---|---|
| 8 | B | 拓扑排序与合法排列计数 |
| 9 | A | 分治递推式、时间复杂度 |
| 10 | D | 树的直径与重心 |
| 11 | C | DAG 缩点、强连通图 |
| 12 | C | 二叉树形态、卡特兰数 |
| 13 | B | 字符串真前缀与真后缀 |
| 14 | C | 归并排序统计逆序对 |
| 15 | B | 快速幂、取模 |
给小学生的学习建议
这 8 道题的难度差异比较大。要分三层学习:
-
先理解题目: 第 8 题、第 10 题、第 13 题,可以先通过画图、列举和比较来建立直觉。
-
再理解算法: 第 9 题、第 14 题、第 15 题,重点看清递推关系、分支条件和循环过程。
-
最后记住经典结论: 第 11 题的强连通图加边公式、第 12 题的卡特兰数,适合在理解后整理成知识卡片。
提高级初赛的学习目标,不只是知道答案,更重要的是看到题目时,能够识别它考查的知识,再一步一步推导出结果。这样遇到新的题目和代码变形时,学生才能真正做到举一反三。