K-means聚类
K-means聚类属于无监督学习 中最经典、最实用的迭代式聚类算法。
无监督学习 :
不需要标签数据,算法**自主发现数据中的规律、相似性和差异性**(核心任务是聚类)。
聚类:目标是将相似的数据点归为一组,形成不同的簇(cluster)
【类比理解】:整理没有标签的照片,根据照片内容、颜色、场景等特征,将它们分为风景、人物、美食等不同的组别,这就是聚类的思想。
-
算法核心思想:迭代优化
-
含义:寻找K个中心点(Centroids),算法通过不断优化这些中心点的位置,最终将数据划分为K个簇。
-
K-means算法的详细流程:
-
1、初始化:随机选择K个点作为初始中心点。
-
2、计算距离与分配 :计算每个点到K个中心点的欧氏距离。
d=(x1−x2)2+(y1−y2)2 d = \sqrt{(x_1 - x_2)^2 + (y_1 - y_2)^2} d=(x1−x2)2+(y1−y2)2
-
3、分配簇标签:将每个数据点分配给最近的中心点,形成K个簇(每个点会得到簇标签0到K-1)。
-
4、更新中心点:计算每个簇内所有点的坐标平均值,将该平均位置作为新的中心点。
-
5、判断收敛:重复步骤2-4,直到中心点位置不再发生显著变化或达到最大迭代次数。
-
-
-
K值的选择(肘部法则):
K值选择是K-means算法中关键问题之一。K值过小会导致不同类型的数据被错误归为一组;K值过大会导致过渡分割,失去聚类的意义。
- 计算不同K值下的Inertia(簇内误差平方和),绘制K值与Inertia的曲线。
- 寻找曲线的"拐点",该点对应的K值通常是较优选择。
-
Inertia误差指标:衡量每个数据点到其所属簇的中心点的距离平方和
-
计算方式:先计算每个点(Xi)到其所属簇中心点(μci)的欧氏距离,将距离求平方;然后将所有数据点的距离平方值累加。
Inertia=∑i=1n∥xi−μci∥2 Inertia = \sum_{i=1}^{n} \| x_i - \mu_{c_i} \|^2 Inertia=i=1∑n∥xi−μci∥2
-
指标含义:
- Inertia 越小:说明簇内的点越紧密,聚类效果越好。
- 随 K 值增加而减少:K 值越大,每个簇越小,数据点离其中心点越近,Inertia 自然越小。
⚠️ 特别警告(不要盲目追求最小值) :
当 K 等于数据点总数时,每个点自己就是一个簇,Inertia 等于 0,但这毫无意义。需要在聚类质量(低 Inertia)和簇数量(合理的 K 值)之间寻找平衡。
-
-
案例:鸢尾花分类
第一步:超参数调优(模型选择)
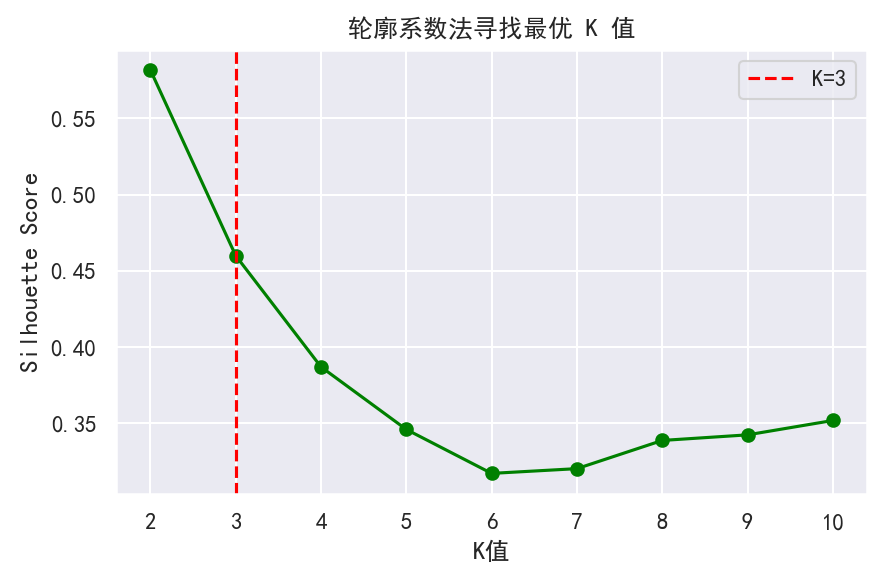
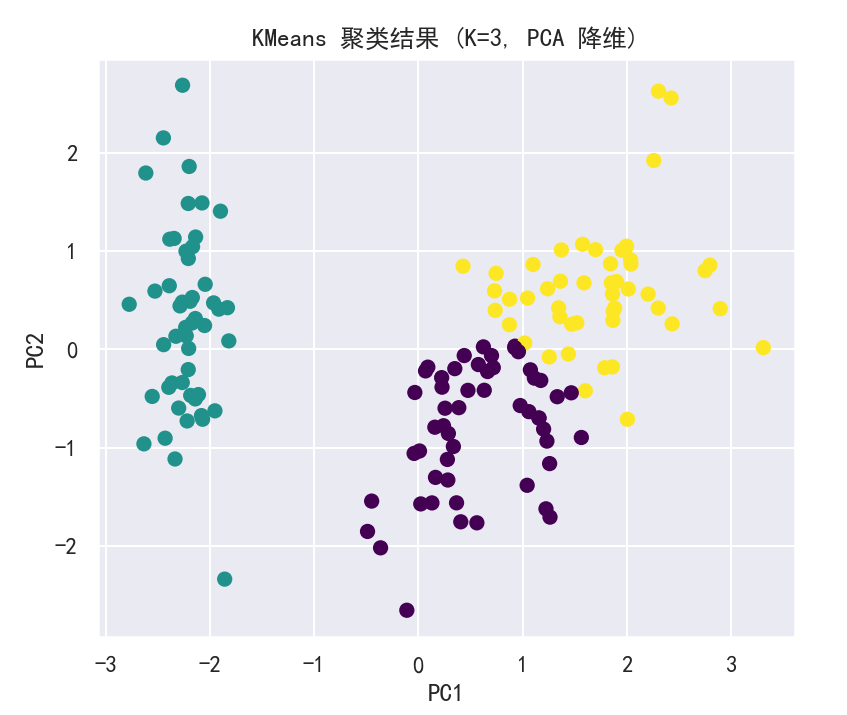
pythonimport matplotlib.pyplot as plt from sklearn.datasets import load_iris from sklearn.cluster import KMeans from sklearn.decomposition import PCA from sklearn.metrics import silhouette_score import seaborn as sns plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei'] # 黑体优先,备选微软雅黑 plt.rcParams['axes.unicode_minus'] = False # 解决负号变成方框 sns.set(font="SimHei") # seaborn热力图也要指定字体 # 1. 加载数据 iris = load_iris() x = iris.data y_true = iris.target # 保留真实标签,最后用来对比,聚类时不使用 # 2. 特征标准化(必需!!!) from sklearn.preprocessing import StandardScaler scaler = StandardScaler() x_scaled = scaler.fit_transform(x) # --- 肘部法则寻找最优 K 值 --- inertias = [] K_range_elbow = range(1, 11) # 肘部法则从 K=1 开始算 for k in K_range_elbow: model = KMeans(n_clusters=k, random_state=42, n_init=10) model.fit(x_scaled) inertias.append(model.inertia_) # 绘制肘部法则曲线 plt.figure(figsize=(6, 4)) plt.plot(K_range_elbow, inertias, marker='o', color='blue') plt.xlabel('K值') plt.ylabel('Inertia (簇内误差平方和)') plt.title('肘部法则寻找最优 K 值') plt.axvline(x=3, color='red', linestyle='--', label='拐点在 K=3') plt.legend() plt.tight_layout() plt.show() # --- 轮廓系数法寻找最优 K 值 --- sil_scores = [] K_range_sil = range(2, 11) # 轮廓系数必须从 K=2 开始算 for k in K_range_sil: model = KMeans(n_clusters=k, random_state=42, n_init=10) labels = model.fit_predict(x_scaled) score = silhouette_score(x_scaled, labels) sil_scores.append(score) # 绘制轮廓系数曲线 plt.figure(figsize=(6, 4)) plt.plot(K_range_sil, sil_scores, marker='o', color='green') plt.xlabel('K值') plt.ylabel('Silhouette Score') plt.title('轮廓系数法寻找最优 K 值') plt.axvline(x=3, color='red', linestyle='--', label='K=3') plt.legend() plt.tight_layout() plt.show() # --- 用最优 K 聚类 + PCA 可视化 --- best_k = 3 model = KMeans(n_clusters=best_k, random_state=42, n_init=10) labels = model.fit_predict(x_scaled) pca = PCA(n_components=2) x_pca = pca.fit_transform(x_scaled) plt.figure(figsize=(6, 5)) plt.scatter(x_pca[:, 0], x_pca[:, 1], c=labels, cmap='viridis', s=40) plt.title(f'KMeans 聚类结果 (K={best_k}, PCA 降维)') plt.xlabel('PC1') plt.ylabel('PC2') plt.show()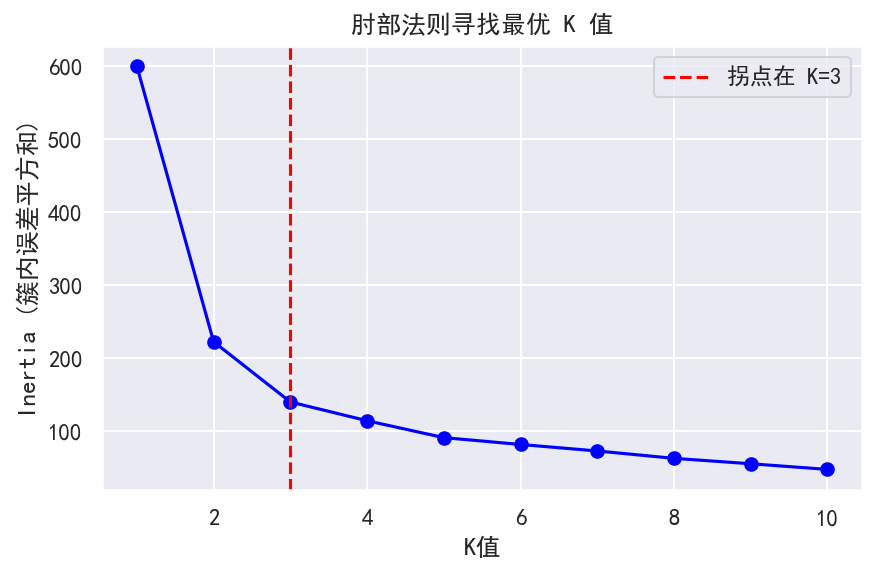
第二步:模型构建与应用
pythonfrom sklearn.cluster import KMeans from sklearn.datasets import load_iris # 1、 加载数据 iris = load_iris() x = iris.data y_true = iris.target # 保留真实标签,最后用来对比,聚类时不使用 # 2、 特征标准化(必需!!!) from sklearn.preprocessing import StandardScaler scaler = StandardScaler() x_scaled = scaler.fit_transform(x) # 3、模型 + 训练预测 k_optimal = 3 kmeans = KMeans( n_clusters=k_optimal, random_state=42, n_init=10 # 设置多次运行,取最优 ) clusters = kmeans.fit_predict(x_scaled) # 同时完成训练和预测,返回每个点的簇标签 # 5. 评估(计算轮廓系数) # 5.1: 内部指标 from sklearn.metrics import silhouette_score, davies_bouldin_score # 轮廓系数:衡量每个点与其所在簇的相似度以及与其他簇的分离度。范围:[-1, 1],越大越好(接近1) score = silhouette_score(x_scaled, clusters) print(f"轮廓系数: {score:.3f}") # 通常0.35 ~ 0.5很好,以上不错 # DB指数:基于簇内距离与簇间距离的比值。范围:[0,+∞),值越小越好,接近0表示聚类质量高 db_score = davies_bouldin_score(x_scaled, clusters) print(f"DB指数: {db_score:.3f}") # 5.2: 外部指标 from sklearn.metrics import adjusted_rand_score, normalized_mutual_info_score # 范围:[-1, 1],越大越好,通常0.4 ~ 0.6不错,0.6 ~ 0.8很不错,以上很好 ari = adjusted_rand_score(y_true, clusters) # 范围:[0, 1],越大越好,通常0.5 ~ 0.7不错,以上很好 nmi = normalized_mutual_info_score(y_true, clusters) print(f"ARI: {ari:.3f}, NMI: {nmi:.3f}") --------------------------------------------------------------------------------- 轮廓系数: 0.460 DB指数: 0.834 ARI: 0.620, NMI: 0.659 --------------------------------------------------------------------------------- -
常见问题与解决方案:
问题类别 问题描述 解决方案 忽略数据标准化 年龄(20-60)和收入(20000-200000)量纲差异巨大,收入会主导聚类结果。 使用StandardScaler将所有特征转换为均值0、标准差1的分布。 盲目选择K值 随意设置K=3或K=5,没有依据。 使用肘部法则、轮廓系数等方法,结合业务需求确定K值。 处理非球形簇 数据呈现月牙形、环形等复杂形状,K-means效果差。 考虑使用DBSCAN、层次聚类等能处理任意形状簇的算法。 忽略异常值 极端值严重影响中心点计算,导致聚类偏差。 在聚类前进行异常值检测和处理,或使用鲁棒的聚类算法。 -
K-means性能提升技巧:
实用技巧 说明 特征标准化 K-means基于距离计算,不同量纲的特征会导致某些特征主导聚类结果。使用StandardScaler或MinMaxScaler进行标准化,确保所有特征在同一尺度上。 K-means++初始化 sklearn默认使用K-means++算法选择初始中心点,它比随机初始化更智能,能大幅减少陷入局部最优的风险。 多次运行取最优 通过 n_init参数设置算法运行多次(默认10次),选择inertia最小的结果。这能有效避免因初始化不当导致的糟糕结果。使用Mini-batch K-means 对于超大规模数据集,使用 MiniBatchKMeans。它每次只使用部分数据更新中心点,速度快但牺牲了一些精度。适合百万级以上的数据。