文章目录
-
- [1 研究背景](#1 研究背景)
- [2 实验数据集](#2 实验数据集)
- [3 整体分析流程](#3 整体分析流程)
-
- [3.1 数据读取](#3.1 数据读取)
- [3.2 数据预处理](#3.2 数据预处理)
- [3.3 数据标准化](#3.3 数据标准化)
- [3.4 降维与分类](#3.4 降维与分类)
- [3.5 效果评估](#3.5 效果评估)
- [4 核心方法说明](#4 核心方法说明)
-
- [4.1 主成分分析(PCA)](#4.1 主成分分析(PCA))
- [4.2 支持向量机(SVM)](#4.2 支持向量机(SVM))
- [4.3 线性判别分析(LDA)](#4.3 线性判别分析(LDA))
- [5 PCA降维可视化结果](#5 PCA降维可视化结果)
- [6 PCA+SVM分类结果](#6 PCA+SVM分类结果)
- [7 LDA分类与可视化结果](#7 LDA分类与可视化结果)
- [8 总结与展望](#8 总结与展望)
-
- [8.1 核心结论](#8.1 核心结论)
- [8.2 后续展望](#8.2 后续展望)
1 研究背景
光谱定性分析的核心是通过光谱特征区分不同物质,在食品安全检测、药品真伪鉴别、材料品类识别等场景中应用广泛。和预测物质浓度的定量分析不同,定性分析的重点是分类判别。
目前光谱定性分析常用的模式识别思路主要有三类:
- 主成分分析(PCA):无监督降维,多用于直观展示数据的聚类分布;
- PCA+支持向量机(SVM):先降维再用分类器建模,适合高维小样本数据;
- 线性判别分析(LDA):有监督降维,同时实现分类和可视化,目标是最大化类别间的区分度。
本文基于一套多物质近红外光谱数据集,系统对比了PCA可视化、PCA+SVM分类、LDA分类三种方案的实际效果,为光谱定性分析的方法选型提供参考依据。
2 实验数据集
本次实验使用4种不同物质的近红外光谱数据,数据集构成与特点如下:
- 样本规模:每种物质设置多个浓度梯度(如10%、20%、30%、50%),每个浓度重复采集15条光谱,总共约240条有效样本;
- 光谱参数:波长覆盖范围400--1800 nm,单条光谱包含约1400个数据点,属于典型的高维数据;
- 存储结构:数据以文本格式保存,按"物质名称-浓度"分层存放,方便批量读取和自动解析类别标签。
该数据集既包含同一物质不同浓度带来的类内波动 ,也包含不同物质的类间差异,样本量适中、维度高,适合用来检验分类算法的鲁棒性。
3 整体分析流程
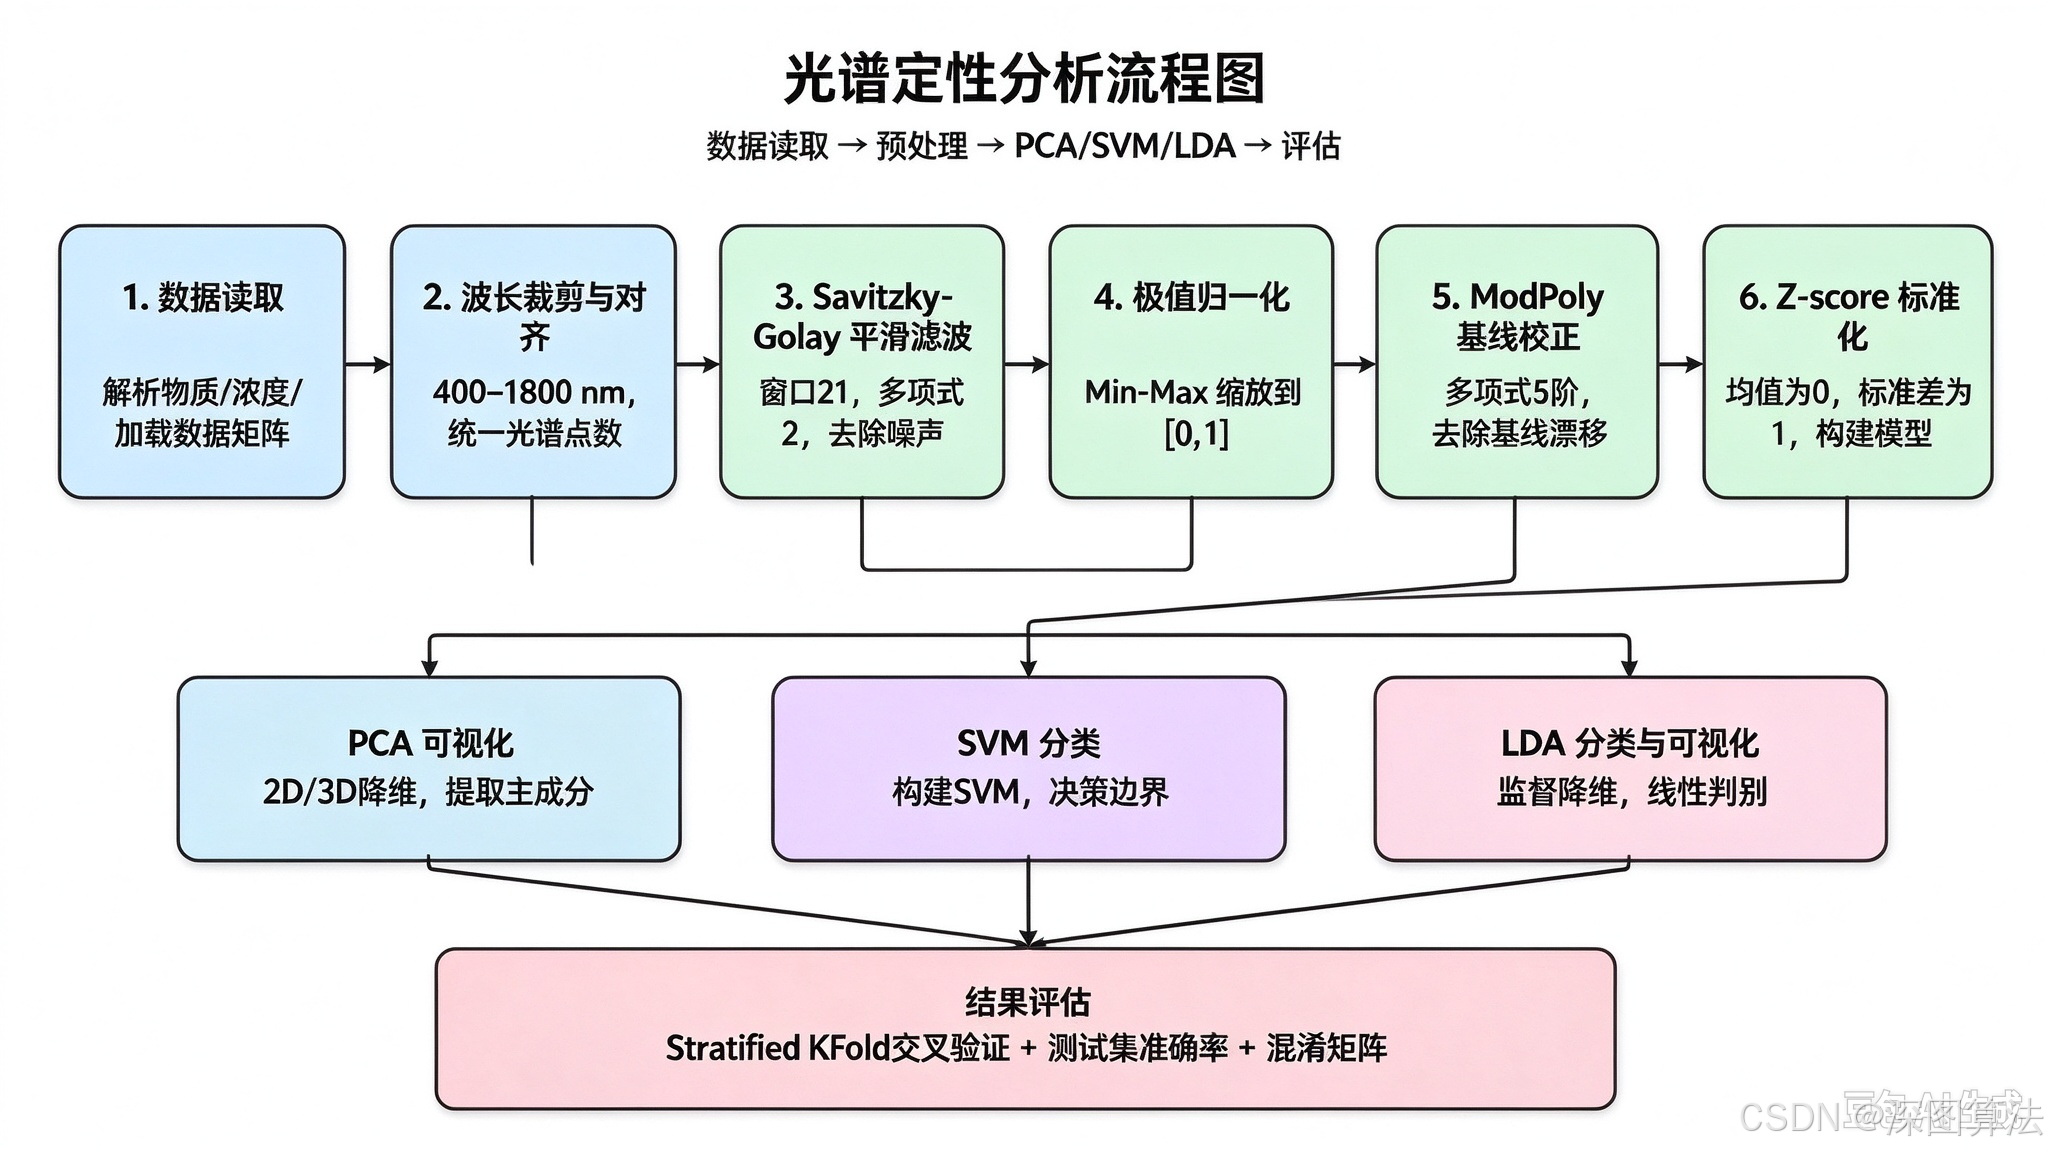
整个分析遵循"数据读取---预处理---标准化---降维分类---效果评估"的标准光谱分析范式,完整流程如下图所示:
3.1 数据读取
递归扫描目标文件夹下的所有光谱文件,根据文件夹层级自动解析出物质类别和浓度标签,同时加载"波长-强度"形式的光谱数据矩阵。
3.2 数据预处理
原始光谱普遍存在噪声干扰、基线漂移、强度尺度不一等问题,需要依次完成以下处理:
- 波长截取:统一保留400--1800 nm区间的有效数据;
- Savitzky--Golay平滑滤波:窗口大小21、多项式阶数5,在保留光谱峰形的同时去除高频随机噪声;
- 极值归一化:将光谱强度统一缩放至0,1区间,消除不同样本间的绝对强度差异;
- ModPoly基线校正:采用5阶多项式迭代拟合(最多迭代200次),去除荧光、散射导致的基线漂移;
- 长度对齐:将所有光谱统一到相同长度(取样本长度众数),保证数据维度一致。
3.3 数据标准化
对预处理后的光谱矩阵做Z-score标准化,使每个波长维度的均值为0、标准差为1,消除量纲差异对后续模型的影响。
3.4 降维与分类
本文设计三组对比方案,覆盖从无监督探索到有监督分类的不同场景:
- PCA降维可视化:将数据降至2维、3维,直观观察样本自然聚类情况;
- PCA+SVM分类:先通过PCA降至2维,再用RBF核SVM训练分类模型;
- LDA分类与可视化:直接对全量光谱做LDA,同时实现降维可视化和分类预测。
3.5 效果评估
采用分层5折交叉验证评估模型在训练集(70%数据)上的稳定性,用**独立测试集(30%数据)**计算最终泛化准确率,同时结合混淆矩阵、决策边界图做可视化诊断。
4 核心方法说明
4.1 主成分分析(PCA)
PCA是最常用的无监督降维方法,核心思路是通过正交变换,把高维数据投影到少数几个"主成分"方向上,这些方向保留了原始数据最多的方差信息。
本文用PCA把光谱降到2维和3维,目的是直观查看不同物质的样本是否自然聚集,初步判断数据的可分性。
4.2 支持向量机(SVM)
SVM是一种监督分类算法,通过找到"间隔最大的分类超平面"来划分类别。对于非线性可分的数据,可以通过核函数(本文用RBF径向基核)把数据映射到更高维空间,转化为线性可分问题。
本文先通过PCA把数据降到2维再输入SVM,既降低计算量,也方便画出分类决策边界进行可视化分析。
4.3 线性判别分析(LDA)
LDA是一种有监督的降维+分类 方法,它的目标不是保留最多数据方差,而是找到最优投影方向------让"同类样本尽可能聚在一起,不同类样本尽可能离得远"。
对于K类分类任务,LDA最多能生成K-1个判别方向。本文使用lsqr求解器并加入自动收缩策略,提升小样本场景下的模型稳定性。
5 PCA降维可视化结果
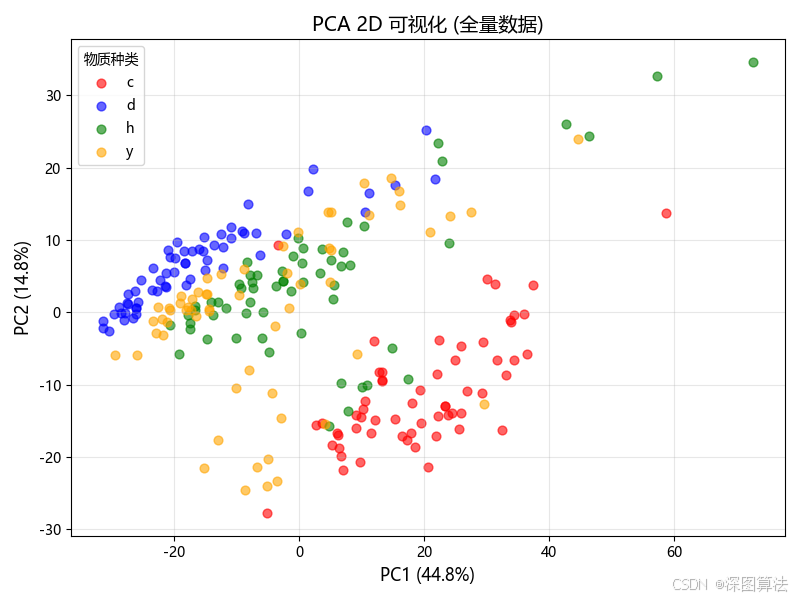
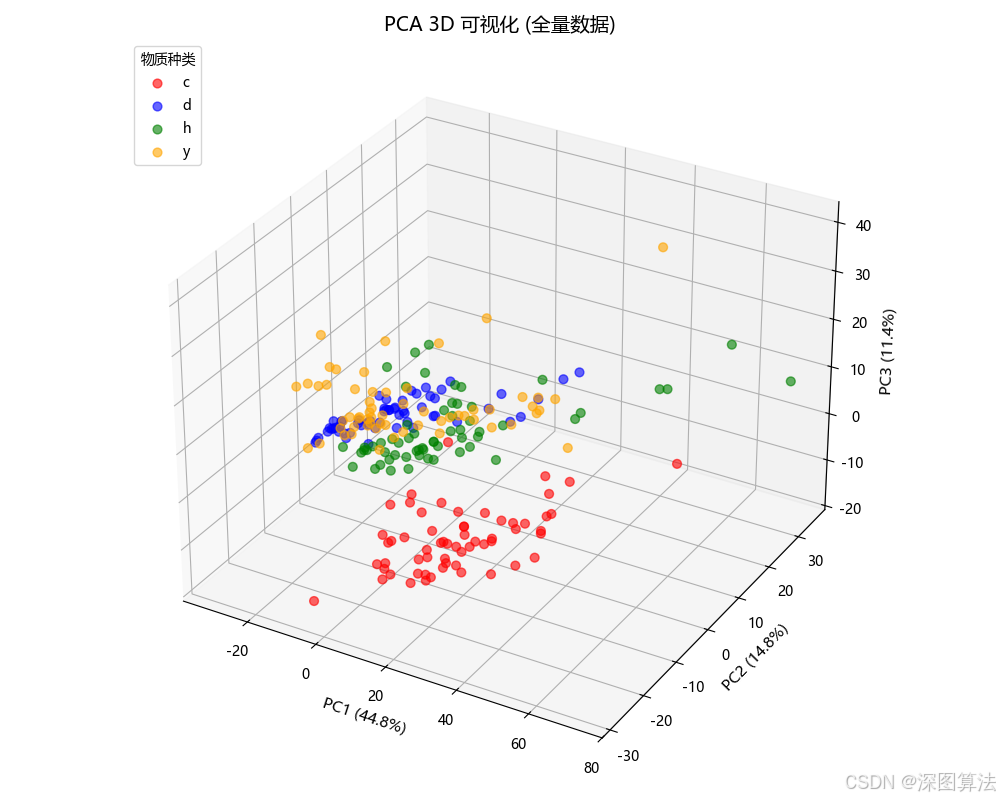
首先对标准化后的全量光谱做PCA降维,计算主成分的解释方差占比:
- 前2个主成分累计解释方差约59.6%(PC1占44.8%,PC2占14.8%);
- 前3个主成分累计解释方差约71.0%(新增PC3占11.4%)。
这说明光谱数据具备较好的低维结构,大部分有效信息可以用少数主成分代表。
|----------------------------------------------------------------------------|----------------------------------------------------------------------------|
|  |
 |
| 图1:2个主成分 | 图2:3个主成分 |
从可视化结果可以观察到:
- 二维图(图1):不同物质的样本呈现出一定的聚类趋势,但类别之间有明显重叠,尤其是蓝、黄、绿三类样本交织较多,只有红色样本分离度相对较好;
- 三维图(图2):加入第三个主成分后,各类别的分布轮廓更清晰,部分二维重叠的样本在三维空间中被拉开,但整体依然存在不少交织区域。
小结:无监督的PCA只能初步展现数据的聚类趋势,仅靠PCA无法实现精准分类。这也说明光谱中既存在类别差异信息,也受浓度波动、噪声等因素干扰,需要引入监督学习算法进一步提升分类效果。
6 PCA+SVM分类结果
将数据通过PCA降至2维后,使用RBF核SVM训练分类模型,核心性能指标如下表:
| 指标 | 数值 |
|---|---|
| 交叉验证准确率(均值±2σ) | 0.8030 ± 0.2048 |
| 测试集准确率 | 0.8194 |
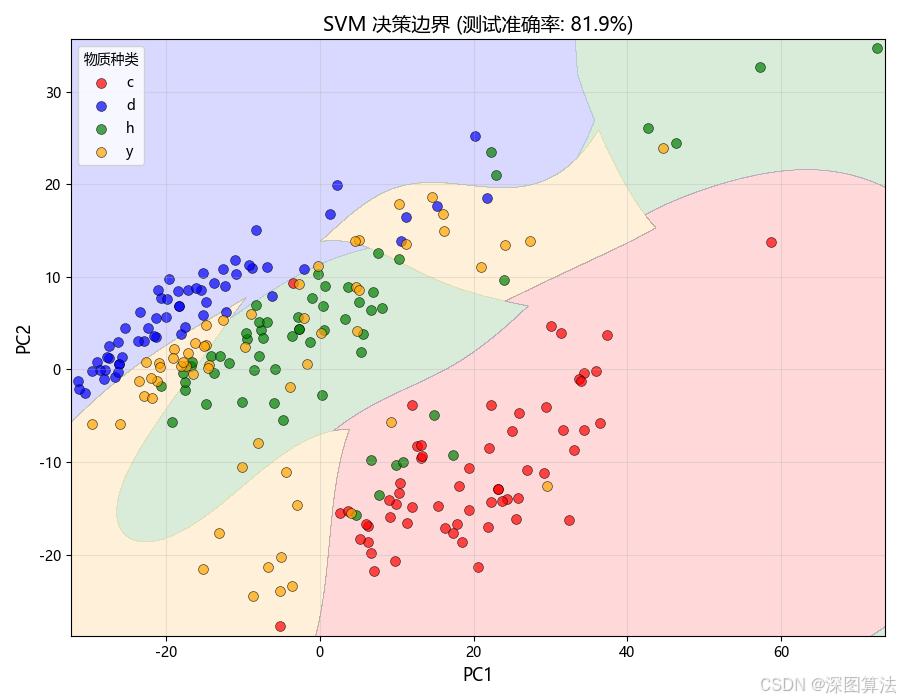
模型的分类决策边界和混淆矩阵如下图所示:
SVM决策边界和混淆矩阵如下图:
|----------------------------------------------------------------------------|----------------------------------------------------------------------------|
|  |
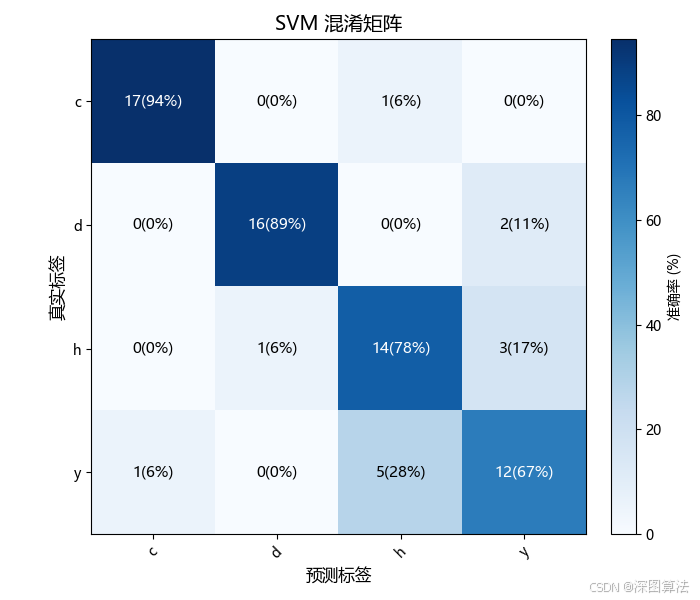 |
| 图1:SVM决策边界 | 图2:SVM混淆矩阵 |
结合图表分析:
- 从决策边界看,红色和蓝色样本大部分能被正确划分,但黄色和绿色样本区域重叠较多,难以清晰区分;
- 从混淆矩阵看,绝大多数样本分类正确,仅少量样本被误判。整体81.94%的测试准确率说明,PCA降维基本保留了类别区分所需的核心信息,结合SVM的非线性分类能力,可以实现较好的分类效果。
7 LDA分类与可视化结果
直接对标准化后的全光谱数据做LDA分类(不经过PCA预降维),同时利用LDA的降维特性做二维可视化,模型核心性能指标如下:
| 指标 | 数值 |
|---|---|
| 交叉验证准确率(均值±2σ) | 0.9792 ± 0.0264 |
| 测试集准确率 | 0.9444 |
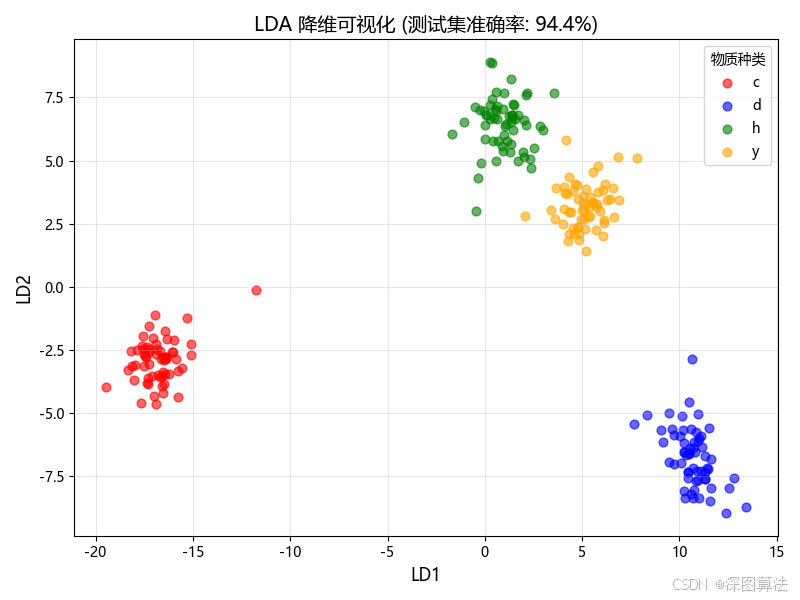
LDA的降维散点图和混淆矩阵如下图:
|----------------------------------------------------------------------------|----------------------------------------------------------------------------|
|  |
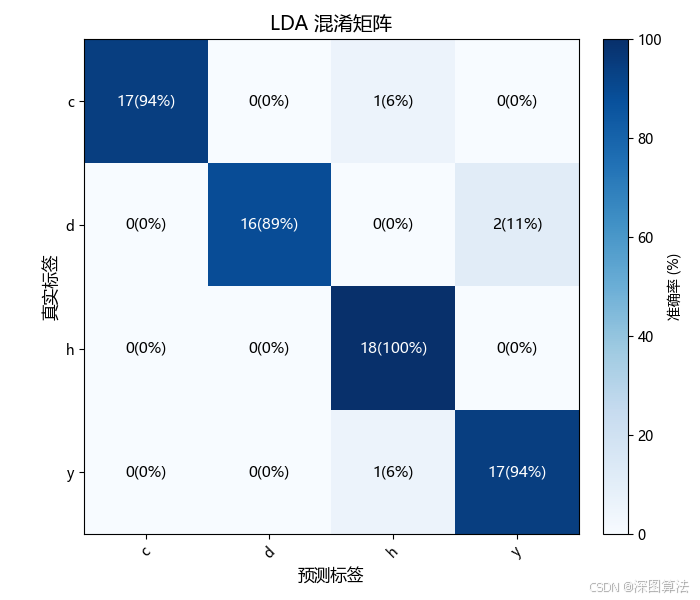 |
| 图1:LDA降维可视化 | 图2:LDA混淆矩阵 |
结果分析:
- 从降维图可以看到,LDA投影后,四类样本各自聚集非常紧凑,类别之间几乎没有重叠,分离效果远好于无监督的PCA;
- 从混淆矩阵看,测试集上绝大多数样本都被正确分类,仅极个别样本出现误判,94.44%的测试准确率显著高于PCA+SVM方案。
这说明作为监督方法,LDA能主动提取和"物质类别"相关的光谱特征,最大化类间差异,分类效果更优。
8 总结与展望
8.1 核心结论
本文基于多物质近红外光谱数据集,对比了三种常用的光谱定性分析方案,主要结论如下:
- PCA适合做探索性可视化:它能直观展现高维光谱的低维聚类结构,前3个主成分可保留71%的信息,可用于初步判断数据可分性、排查异常样本,但无法直接实现精准分类。
- PCA+SVM适合轻量化分类场景:该方案测试准确率达81.94%,先降维再分类的思路计算量小、速度快,还能直观展示决策边界,适合计算资源有限、需要快速出结果的场景。
- LDA分类性能最优:测试准确率达到94.44%,同时兼具降维可视化能力。作为监督降维方法,它能精准聚焦类别差异,是本数据集下的最优方案,适合对准确率要求高的定性分析场景。
- 预处理是结果可靠的基础:滤波、归一化、ModPoly基线校正等步骤,有效去除了噪声和基线漂移的干扰,是后续分类模型能稳定发挥作用的前提。
8.2 后续展望
本次实验验证了传统模式识别方法在光谱定性分析中的有效性。未来可以进一步探索深度学习(如一维CNN)、集成学习等方法,在更大规模、成分更复杂的数据集上验证效果,进一步提升模型的泛化能力和鲁棒性。
注:文中图表与数值均为示例运行结果,实际效果会因数据分布、随机种子不同而略有差异,建议本地运行代码后替换对应内容。