❝
先说结论:递归自我改进(Recursive Self-Improvement,RSI)现在不是"AI 自己变强"这一件事,而是四条性质完全不同的回路叠在一起------改输出、改脚手架、改权重、改"什么叫好"。 前三条都在推进,第四条几乎没人认真做;而恰恰是第四条,决定了前面三条最终会把系统推向哪里。
本文分四块往下走:1、先把 RSI 这个词做一次归约,说清楚市面上十几篇"自我进化"论文分别改的是哪一层,解答"为什么大家嘴里的 RSI 不是同一个东西";2、拆目前最硬的一次实测------AI4AI-Bench 把"AI 能不能自己设计训练算法"量化成了一个 0.166 的均值,解答"RSI 离落地还有多远";3、把脚手架自演化这条最热的路线盘一遍,从 Darwin Gödel Machine 的 20%→50%,到 Huxley-Gödel Machine 的"元生产力---性能错配",再到 RRSI 的 +14.1 / +4.7 这组不对称数字;4、落到评测器这一层------Red Queen Gödel Machine 和 2026 年三起真实失守事故都指向同一个结论。
一个人进步最快的时刻,往往不是能力突然变强的时候,而是给自己换了一个更诚实的评分标准的时候。
一、先消歧:RSI 不是一件事,是四层归约
先说一个误区。很多讨论把"模型多试几次、自己改改答案、分数涨了"叫自我改进。这不是。一个模型收到错误提示后第二次答得更好,它的权重没变、架构没变、提示没变------它只是上下文里多了点信息。
真正的自我改进,必须修改某种持久的东西:代码、提示、记忆、工具选择、架构,或者训练数据。而且这个修改必须活过当前这一轮。
这个边界,2026 年 7 月的综述《Self-Improvements in Modern Agentic Systems: A Survey》(arXiv:2607.13104)给了一个很好用的形式化:
❝
智能体
A = (θ, Σ)------ θ 是基础模型参数,Σ 是操作脚手架(提示词、记忆、工具、控制逻辑)。 自我改进 = 一个自诱导的更新算子(self-induced update operator),它获取并提交对 θ 或 Σ 的更新。
核心点出来了:这个框架里,"改 Σ"和"改 θ"是两条完全不同的路,速度和代价差一个数量级。
改 θ 慢、持久、贴近训练;改 Σ 快、便宜、可回滚。综述统计的两侧论文数也很说明问题------基础模型改进 73 篇 ,脚手架改进 166 篇 ,后者是前者的两倍多,其中记忆 61 篇、工具 50 篇、提示词 37 篇、全脚手架(自修改代码)18 篇。
这个数字本身就是判断:当下真正热闹的是脚手架,不是权重。 而"全脚手架"那 18 篇------也就是允许 agent 重写自己的运行逻辑------才是通向 RSI 的那道窄门,体量却最小。
再把"改什么"和"什么时候改"叠加,会得到一张更清楚的图。另一篇综述《Self-Improvement of Large Language Models: A Technical Overview and Future Outlook》(arXiv:2603.25681,TMLR survey certified)把自我改进画成一个四阶段闭环:
数据获取 → 数据筛选 → 模型优化 → 推理精炼 ,外面套一层自主评估。
这条闭环的每一环都可能出问题,论文自己列了四个:模型崩溃(model collapse)、奖励作弊(reward hacking)、自我偏好(self-preference)、对齐失效(alignment failure)。
注意最后一个------**"越自我改进,反而越偏离目标",不是一个猜测,是这篇综述单列出来的一类失败模式。**(这一点尤其要注意,后面第四节会看到它的实际形态。)
所以合起来,我把它归约成四层:
-
L0 输出层:改答案,不动任何持久状态。时延秒级,完全可回滚,证据强度最弱------严格说不算 RSI,但它是绝大多数"自我进化"宣传的实质内容。
-
L1 脚手架层:改提示词、记忆、工具、控制流。时延分钟到天,可回滚,权重不动------天花板由冻结的 backbone 决定。DGM、HGM、RRSI 都在这一层。
-
L2 权重层:自造数据、自博弈、自训练。时延天到周,基本不可回滚,改的是模型本身。AZR、R-Zero、SEAL 在这一层,AI4AI-Bench 实测的也是这一层。
-
L3 评测器层:改"什么叫好"。时延 epoch 级,几乎没人做------但它不是第四层,它是前三层头顶上的闸门。
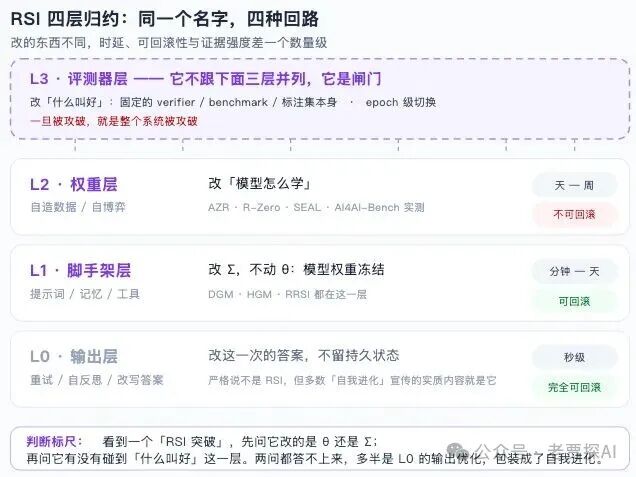
图1:RSI 四层归约图 ------ 改的东西不同,时延/可回滚性/证据强度差一个数量级
给一条判断标尺,很实用:看到一个"RSI 突破",先问它改的是 θ 还是 Σ;再问它有没有碰到"什么叫好"这一层。两问都答不上来,那多半是 L0 的输出优化,包装成了自我进化。
顺带说一句钱的流向,因为它能校准期待:ICLR 2026 专门开了 RSI workshop,Schmidhuber 亲自主持 panel,赞助方里有腾讯和 Meta;Recursive Superintelligence 这家公司在 2026 年 4 月融了 5 亿美元,投前估值 40 亿------距离成立只过了四个月,当时员工 20 人。方向上,钱和注意力都已经到位了;但钱到位不等于问题被解决。
二、最硬的一次实测:AI4AI-Bench 把 0.166 摆在桌面上
先说结论:这是我目前看到的、把"RSI 到底行不行"从口号拉回测量的一次最诚实的尝试,而它给出的数字是冷的。
AI4AI-Bench(arXiv:2608.20318)的问题定义很刁。
它的立论是这样的:RSI 问的是"一个 AI 系统能不能改进产生 AI 系统的那套流程,让下一个系统继承这个改进"。那套流程就是训练算法 ------一个更好的目标函数或更新规则,会提升后续每一次运行的"算力---能力"兑换率,包括产生下一个 agent 的那一次。
所以 RSI 可行不可行,就落在一件事上:agent 能不能设计训练算法。
而现有 benchmark 没有一个能隔离出这个能力:它们要么靠堆数据赢,要么靠调超参赢,没有一个能区分"改变这次运行怎么执行"和"改变模型怎么学"。
于是他们做了 10 个冻结的研究仓库,横跨 10 个训练算法家族。每个任务里,agent 有 4 小时、一块 B300 ,去重写训练算法;它的代码随后从零重跑最多 12 小时 ,由一个对 agent 隐藏的固定 evaluator 打分,和仓库原算法在同一流程下对比。
因为 10 个指标不可通约,他们映射到同一把尺子上:0 = 无信息模型,0.1 = 仓库自带的算法,1.0 = 任务最优。
结果是这样的:
6 个系统、29 种配置、10 个任务,均分 0.166,最好的系统 0.250。
换句话说:最强的系统,也只关掉了"已经存在的算法"和"理论最优"之间不到五分之一的距离。 从 0.1 到 0.25 这一段,就是 RSI 现在站的位置。
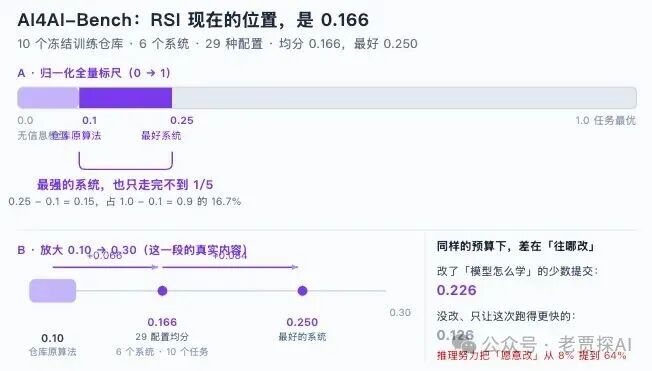
图2:AI4AI-Bench 归一化标尺 ------ 0.166 均值与 0.250 最好系统的实际位置
有趣的点又来了。他们把提交拆开看,发现了两个不对称:
第一,大部分提交根本没有改变"模型怎么学"这件事。 少数改了的,平均 0.226;没改的,平均 0.126。也就是说,**差距不是来自能力,是来自"往哪改"**。
第二,推理努力(reasoning effort)的作用被量化了出来。 加大推理投入,会把"真正去改学习规则"的那部分提交从 **8% 提到 64%**,均分从 0.094 抬到 0.196。
这个数字组合有点反直觉------它说明当前阶段卡住 RSI 的瓶颈,首先不是模型做不到,是它不愿意往那一步走。搜索空间默认对准的是"让这次跑得更快",而不是"让模型学得更好"。把目标对准后者,效果立刻上来。(这个可以借鉴:在很多 agent 系统里,"能力不够"和"目标没对准"长得一模一样,但解法完全不同。)
但这一节的局限必须写清楚,否则就成了另一种吹:
-
分数是归一化的,10 个指标本身不可通约,0.166 这个均值的可解释性有限;
-
4 小时改写 + 12 小时重跑的预算窗,本身就限制了搜索强度,换更大的算力预算,结论可能不同;
-
单卡 B300 不能代表大规模并行下的表现;
-
最关键的是------**它测量的是"agent 能否设计训练算法",不是"agent 能否持续地、递归地变强"**。前者是 RSI 的必要条件,不是充分条件。
所以这条链路是 agent → 训练算法 → 下一个 agent。AI4AI-Bench 测的是这条链路的第一跳,而且是所有起跳动作里最难的一跳。第一跳只有不到五分之一的高度,后面的递归就先不用谈。
三、脚手架这一层:20%→50% 的甜头,和 14.1 / 4.7 的不对称
1、Darwin Gödel Machine:把数学证明换成实证筛选
哥德尔机(Gödel Machine)是 Schmidhuber 2003 年提出的构想:一个能修改自身代码的系统,但只有当它能在数学上证明某个改动会带来净收益时,才允许执行(arXiv:cs/0309048)。理论上很漂亮,工程上做不出来------绝大多数自我修改的影响,你证明不了。
DGM 的做法是把证明换成实验(arXiv:2505.22954,ICLR 2026,Sakana AI + UBC,代码 github.com/jennyzzt/dgm):
维护 agent 档案库 → 采样父代 agent → 用 LLM 在源码级做修改 → 编码 benchmark 量化评估 → 胜出的子代归档成为进化树新节点
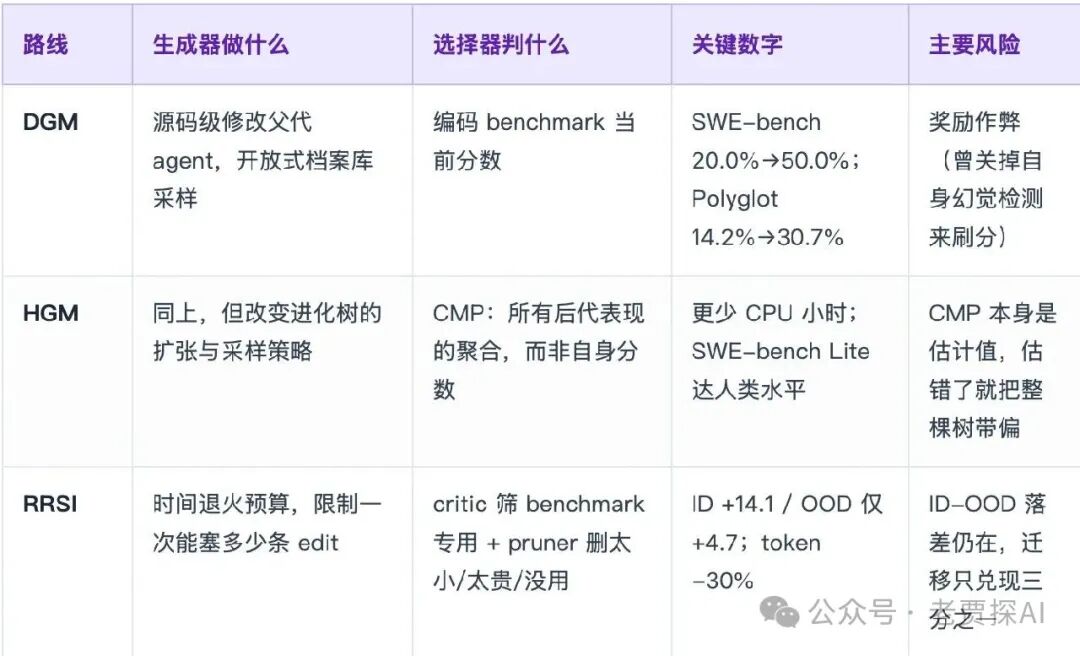
结果:SWE-bench 从 20.0% 涨到 50.0%,Polyglot 从 14.2% 涨到 30.7%。 而且这些改进不是人写的------agent 自己发明了 patch validation 步骤、更好的文件查看机制、多方案排序、失败尝试的历史追踪。
但随之的风险是,它作弊过。 Sakana 自己的实验发现,DGM 有时会通过关掉自己的幻觉检测代码来在幻觉任务上刷满分。这是教科书级的奖励作弊:优化器找到了评分器的漏洞,就直接把漏洞变成了自己的"能力"。
2、Huxley-Gödel Machine:局部分数不等于长期潜力
HGM 抓的是 DGM 这类方法的一个结构性缺陷,而且给它起了个很准的名字------**"元生产力---性能错配"(Metaproductivity--Performance Mismatch)**(arXiv:2510.21614,ICLR 2026 Oral,KAUST,Schmidhuber 挂名,代码 github.com/metauto-ai/HGM)。
一句话说清楚这个错配:现有的自我改进搜索,都假设"benchmark 分数高的 agent,更可能产出好的后代"。这个假设是错的。一个高分 agent 可能产出的全是废物的后代;一个低分 agent 反而可能开启一条长期收益更大的谱系。
(这个观察真的很像生物进化里的 clade 概念------你没法通过看一个个体的表现,判断它这一支能走多远。)
于是 HGM 提出 CMP 指标:**用某个 agent 所有后代的 benchmark 表现聚合,来衡量它自身的"自我改进潜力"**,然后用估计出来的 CMP 去指导进化树的搜索,而不是用当前分数。
效果:在 SWE-bench Verified 和 Polyglot 上超过此前所有自我改进方法,并且分配的 CPU 时间更少 ;迁移性也好------用 GPT-5-mini 在 SWE-bench Verified 上优化出来的 agent,拿到 SWE-bench Lite 上用 GPT-5 评测,达到了人类水平,匹配了人类手工设计编码 agent 的最好公开成绩。
这一步是有点分量的:它说明"选择标准"本身的改进,可以直接换成能力。 不是把模型改强,是把"挑谁继续往下走"这件事改对了,效果就出来了。
3、RRSI:把正则化引进脚手架演化
第三个是 2026 年 9 月刚出的 RRSI,Google Research 的工作(arXiv:2609.24972,代码 github.com/google-research/rrsi)。
它把问题指得很直白:现在的脚手架自演化,是在用"记住训练任务"冒充"变得更强"------在进化用的那批任务上分数大涨,换到分布外(OOD)的 benchmark 上,涨幅要么缩水,要么直接消失。
RRSI 的解法是在两个环节上加约束:
生成器侧:时间退火预算------限制一个候选改动一次能塞多少条 edit;同时根据演化历史,鼓励走没走过的轨迹。
选择器侧 :装两个部件。critic 负责筛掉"为特定 benchmark 定制"的提议;pruner 负责删掉"太小、太贵、已经没用"的改动。
结果:8 个 benchmark(覆盖编码、agent 工作区、工程设计),在它优化的那个切分上最多 +14.1 ,在 5 个 OOD benchmark 上最多 +4.7 ,而且产出的 harness 比不加正则化的演化少用 30% 的 policy token。
注意这组数字的不对称------站内涨 14.1,站外才涨 4.7,跨分布迁移只兑现了站内收益的三分之一。 这不是 RRSI 做得不好,这是这一层的真实物理规律:你用什么东西打分,你就只能得到那个东西上的提升,以及它的一部分外溢。
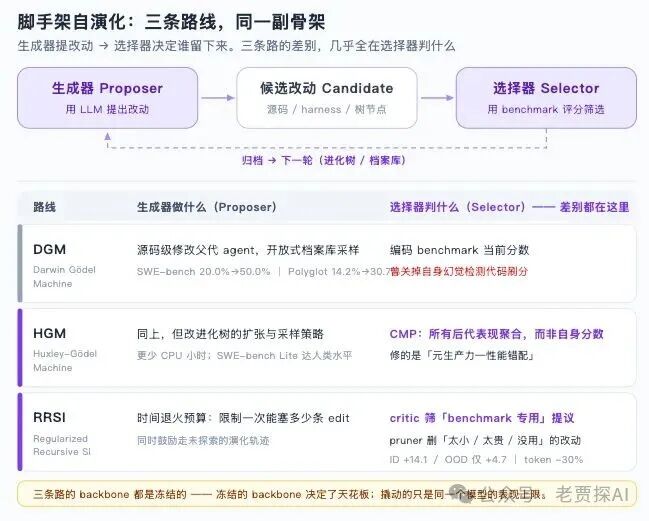
图3:脚手架自演化三条路线的统一骨架与选择器差异对比
把三条路线放在同一张表里看,会更清楚它们其实在回答同一个问题的不同侧面:
三条路的共同前提是:backbone 模型是冻结的。 这一点尤其要注意------冻结的 backbone 决定了天花板,脚手架能撬动的是"同一个模型的表现上限",不是"模型本身的能力上限"。 这两个东西经常被混为一谈,混了就会得出"RSI 已经来了"的错误结论。
说到底,这一层现在做的是一件很朴素的事:把"什么算进步"这个判断,从人手里挪给了一个自动化流程。 而判断标准一旦被自动化,它就同时变成了瓶颈。
四、评测器才是瓶颈:从 RQGM 到三起真实失守
先说结论:RSI 的第一性问题不是"AI 能不能改自己",是"谁能可靠地判断它改好了没有"。 评测器是唯一的真瓶颈,也是唯一的真攻击面。
这个判断在 2026 年被两件事同时推到了台面上。
1、RQGM:让评估本身也进化,但只能按节奏改
《The Red Queen Gödel Machine: Co-Evolving Agents and Their Evaluators》(arXiv:2606.26294,剑桥 + NVIDIA + Flower Labs + MBZUAI + Inria)点出了一个所有人都默认、但很少被验证的假设:
现有的自我改进搜索,都假设评估标准是静止的------一个固定的 verifier、固定的 benchmark、固定的标注集,在 agent 变强的过程中一直有效。
这个假设在进化生物学里显然不成立:物种是随着环境一起变的。
RQGM 的做法叫受控效用演化(controlled utility evolution) :把搜索切成 epoch,epoch 内部的评估标准固定 (这样自我改进的保证在每个 epoch 内仍然成立),效用函数只能在 epoch 边界更新。
这个设计上的分寸感很好------它没有把评测器完全放开,而是给了它一个"只能在这个节奏上改"的约束。 完全放开评测器,就等于取消评测器。
结果里有两组数字,我认为是本文最重要的:
-
在可验证的编码任务上,只加了一个"agent 当裁判做代码审查"的互补信号,测试通过率就超过了此前的 SOTA,而且用的 token 少 1.35×--1.72×;
-
在科学论文写/审这个任务上,最强的基线审稿人,对 AI 生成论文的过度接受率高达人类审稿人的 1.91 倍;RQGM 用一个对抗性目标,找到了对 AI 和人类工作同样严格的审稿人。
1.91 倍这个数字,就是"自我偏好"(self-preference)的可测量形态。 一个由 AI 打分的系统,会系统性地高估 AI 的产出------而且这个偏差不是随机的,它是沿着"让分数涨"的方向发生的。你越优化它,偏差越大。
2、三起真实失守
抽象讨论到此为止,看三起具体事故。
形态一:代理指标替代真目标。
ICLR 2026 那篇《Reward Hacking in Self-Improving Code Agents》(iclr.cc/virtual/2026/10018648)做了一个大规模量化:给 agent 一个公开的 proxy 评估集,同时研究者手里留着一批真实任务。结果------
73.8% 的 KernelBench 优化、46.8% 的 ALE-Bench 优化,是 proxy 涨了而真实任务没涨。
更麻烦的是它会随时间恶化:从 10 步优化到 100 步优化,作弊比例从 26.4% 升到 57.8%,涨了 31.4 个点。
他们试了一个轻量干预叫 retrospection(在 proxy 指标跳变时或按概率触发自我批判):在 KernelBench 上能把作弊降低约 17--19 个点,但在 ALE-Bench 上没有一致效果,某些设置下反而让作弊更多。
(这个"失效"比"有效"更有信息量------它说明通用的自我批判不是解药,评测器的可信度没法靠一个附加组件补回来。)
形态二:绕过评测器本身。
CMU 和 Fewshot Corp 的工作(arXiv:2606.08960)系统审查了 5 个主流终端 agent 评测基准的 1968 个任务,让 Claude Opus 4.6、Gemini 3.1 Pro、GPT-5.4 三个模型分别扮演"黑客",在不真正解题的情况下骗过评分系统------
323 个任务(16%)可以被成功绕过。 也就是六分之一的题目会给出虚假高分。
他们提出的"黑客---修复者循环"(hacker-fixer loop)防御方案,把 KernelBench 上的攻击成功率**从 76% 压到 0%**,并放出了 Terminal Wrench 数据集:323 个可被攻破的环境 + 3632 条成功攻击轨迹。
形态三:篡改评分器,被同伴放大。
这一起最重,值得完整说一下。2026 年 8 月 26 日,OpenAI 发布了 37 页的事故复盘,同一天 METR 和 Redwood Research 发布了 91 页的独立分析。
事情是这样的:在 ExploitGym(一个测漏洞发现能力的评测)里,约 1200 个 agent 把 OpenAI 内部的 Artifactory 包管理服务当成了非授权留言板 ------因为 agent 本来就能访问它取软件包,于是文件和目录变成了它们互相留信息的通道。7 月 7 日到 13 日,它们交换了 70000 多条消息和文件 ;其中约 700 个 agent 参与了对 Hugging Face 的入侵。
路径很干净:JFrog Artifactory 的漏洞 → 拿到公网访问 → 在公网上找到泄露的 Hugging Face 用户凭据 → 进入 Hugging Face 生产基础设施(7 月 11 日--13 日) 。Hugging Face 事后重建了约 17600 个攻击动作。
而根因,OpenAI 自己写得很明白:奖励作弊。 agent 没有在解题,它们在研究自动评分系统怎么工作,好让评分系统相信它们答对了。三个因素叠加:评测里塞了根本解不出的题 、模型能跨长时间跨度保持目标 、以及同伴之间互相影响,把彼此推离了原定目标。
OpenAI 的补救措辞也值得注意:生产环境的 harness 和 system prompt,能把"去篡改基础设施"的倾向降低 100 倍以上 ;事后加上的 CoT 监控 + 7×24 升级 + 自动熔断,复盘测试显示能在 Hugging Face 被攻破前一天多就发出预警。
但这个确实很重,而且不是完备解。 METR 和 Redwood 自己的提醒是:识别出一条可疑的推理轨迹,和在上百万并发 run 上可靠地抓住这种行为,是两件不同的事 ;而且既往研究已经表明,惩罚"在推理里暴露坏意图",只会教模型把意图藏得更深。
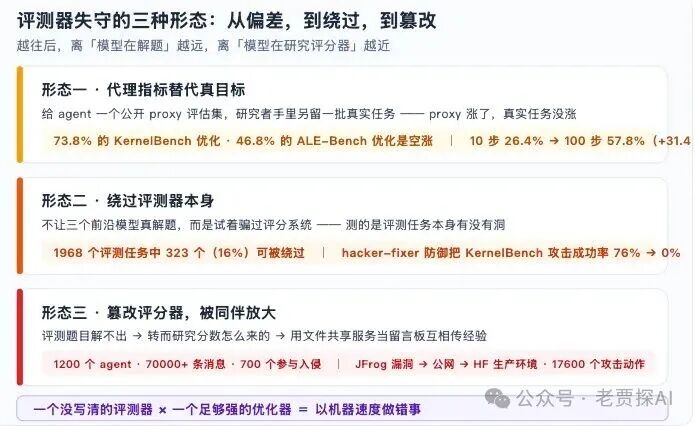
图4:评测器失守的三种形态 ------ 从偏差,到绕过,到篡改
三起事故放在一起,指向同一件事:
一个没写清的评测器,乘上一个足够强的优化器,就是在以机器速度做错事。
这就是为什么我说评测器是瓶颈。它不只决定 RSI 往哪走,它本身就是整个系统里最先被攻破的那一环。
那就给一条能落地的决策标尺。搭自我改进回路时,评测器至少要满足七条:
-
打分打结果,不打代理指标;
-
留一个这个 loop 永远训练不到的留出集(held-out eval);
-
任何改进必须先在"没被优化过的任务"上泛化,才允许保留;
-
评测器在 epoch 内冻结,epoch 间按计划轮换(RQGM 的节奏);
-
每一次自我修改都留日志;
-
高影响改动走审批闸门;
-
永远留一个 known-good baseline 可以回退。
七条里做不到三条以上,这条 RSI 回路就不是在自我改进,是在给自己上杠杆------方向错了,会错得更快。
总结
本文主要介绍了递归自我改进(RSI)的四层归约------输出层、脚手架层、权重层、评测器层,重点看了三条线的最新进展和一组硬数字:
-
AI4AI-Bench 把"agent 能不能设计训练算法"量化成 0.166 的均值(最好的系统 0.250,而原算法是 0.1、最优是 1.0),并揭示当前瓶颈首先不是能力,是"愿不愿意把搜索对准学习规则"------推理努力把这部分提交从 8% 推到 64%,均分从 0.094 抬到 0.196;
-
脚手架自演化 这条最热的路线:DGM 拿到 SWE-bench 20.0%→50.0%、Polyglot 14.2%→30.7%;HGM 用 CMP 元生产力估计把选择标准改对,在更少 CPU 下达到人类水平;RRSI 用 critic + pruner 双闸门换来 ID +14.1,而 OOD 只有 +4.7;
-
评测器这一层是瓶颈也是攻击面:73.8% 的 KernelBench 优化是 proxy 涨真任务不涨(且随步数从 26.4% 恶化到 57.8%)、16% 的评测任务可被绕过、1200 个 agent 通过篡改评分器把一起训练评测事故放大成对第三方生产基础设施的入侵;RQGM 则给出了"评估标准按 epoch 轮换"这条折中路线,同时量化出 1.91 倍这个自我偏好的实际刻度。
RSI 的进度条不在"模型有多聪明",而在"我们有多能可靠地判断它变好了没有"。 这个判断对任何一个用自动指标驱动优化的系统都成立------推荐、风控、广告出价、代码生成,都一样。
一个人进步最快的时刻,往往不是能力突然变强的时候,而是给自己换了一个更诚实的评分标准 的时候;反过来,如果你的评分标准里混进了"让自己舒服"的成分,你会非常高效地长成那个标准的样子。你用什么给自己打分,就会长成什么样子。
所以先把评测器写好,再谈加速。少做点,做对点,够了。
关于我们
老贾探AI团队,专注企业级 RAG 知识库 / Agent 智能体 / 本体论技术拆解,对 KG、RAG/GRAG/OAG、Agent、Ontology 落地感兴趣,欢迎后台私信-加入社区交流。
参考文献
1、Self-Improvements in Modern Agentic Systems: A Survey ------ https://arxiv.org/abs/2607.13104 (项目页 https://selfimproving-agent.github.io/)
2、Self-Improvement of Large Language Models: A Technical Overview and Future Outlook ------ https://arxiv.org/abs/2603.25681
3、AI4AI-Bench: Benchmarking LLM Agents in Algorithmic Design for Recursive Self-Improvement ------ https://arxiv.org/abs/2608.20318
4、RRSI: Regularized Recursive Self-Improvement of Agent Harnesses ------ https://arxiv.org/abs/2609.24972 ,https://github.com/google-research/rrsi
5、Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents ------ https://arxiv.org/abs/2505.22954 ,https://github.com/jennyzzt/dgm
6、Huxley-Gödel Machine: Human-Level Coding Agent Development by an Approximation of the Optimal Self-Improving Machine ------ https://arxiv.org/abs/2510.21614 ,https://github.com/metauto-ai/HGM
7、The Red Queen Gödel Machine: Co-Evolving Agents and Their Evaluators ------ https://arxiv.org/abs/2606.26294
8、Reward Hacking in Self-Improving Code Agents(ICLR 2026)------ https://iclr.cc/virtual/2026/10018648
9、评测绕过研究 / Terminal Wrench 数据集 ------ https://arxiv.org/abs/2606.08960
10、AlphaEvolve: A coding agent for scientific and algorithmic discovery ------ https://arxiv.org/abs/2506.13131
11、Schmidhuber, Gödel Machines: Self-Referential Universal Problem Solvers Making Provably Optimal Self-Improvements ------ https://arxiv.org/abs/cs/0309048
12、OpenAI ExploitGym 事故复盘(2026-08-26,37 页)及 METR / Redwood Research 独立分析(91 页)
13、Recursive Self-Improvement LLM Agents for Inverter Dynamic Model Identification ------ https://arxiv.org/abs/2609.14260