注意:该项目只展示部分功能,如需了解,文末咨询即可。
本文目录
- [1 开发环境](#1 开发环境)
- [2 系统设计](#2 系统设计)
- [3 系统展示](#3 系统展示)
- [3.1 功能展示视频](#3.1 功能展示视频)
- [3.2 大屏页面](#3.2 大屏页面)
- [3.3 分析页面](#3.3 分析页面)
- [3.4 基础页面](#3.4 基础页面)
- [4 更多推荐](#4 更多推荐)
- [5 部分功能代码](#5 部分功能代码)
1 开发环境
发语言:python
采用技术:Spark、Hadoop、Django、Vue、Echarts等技术框架
数据库:MySQL
开发环境:PyCharm
2 系统设计
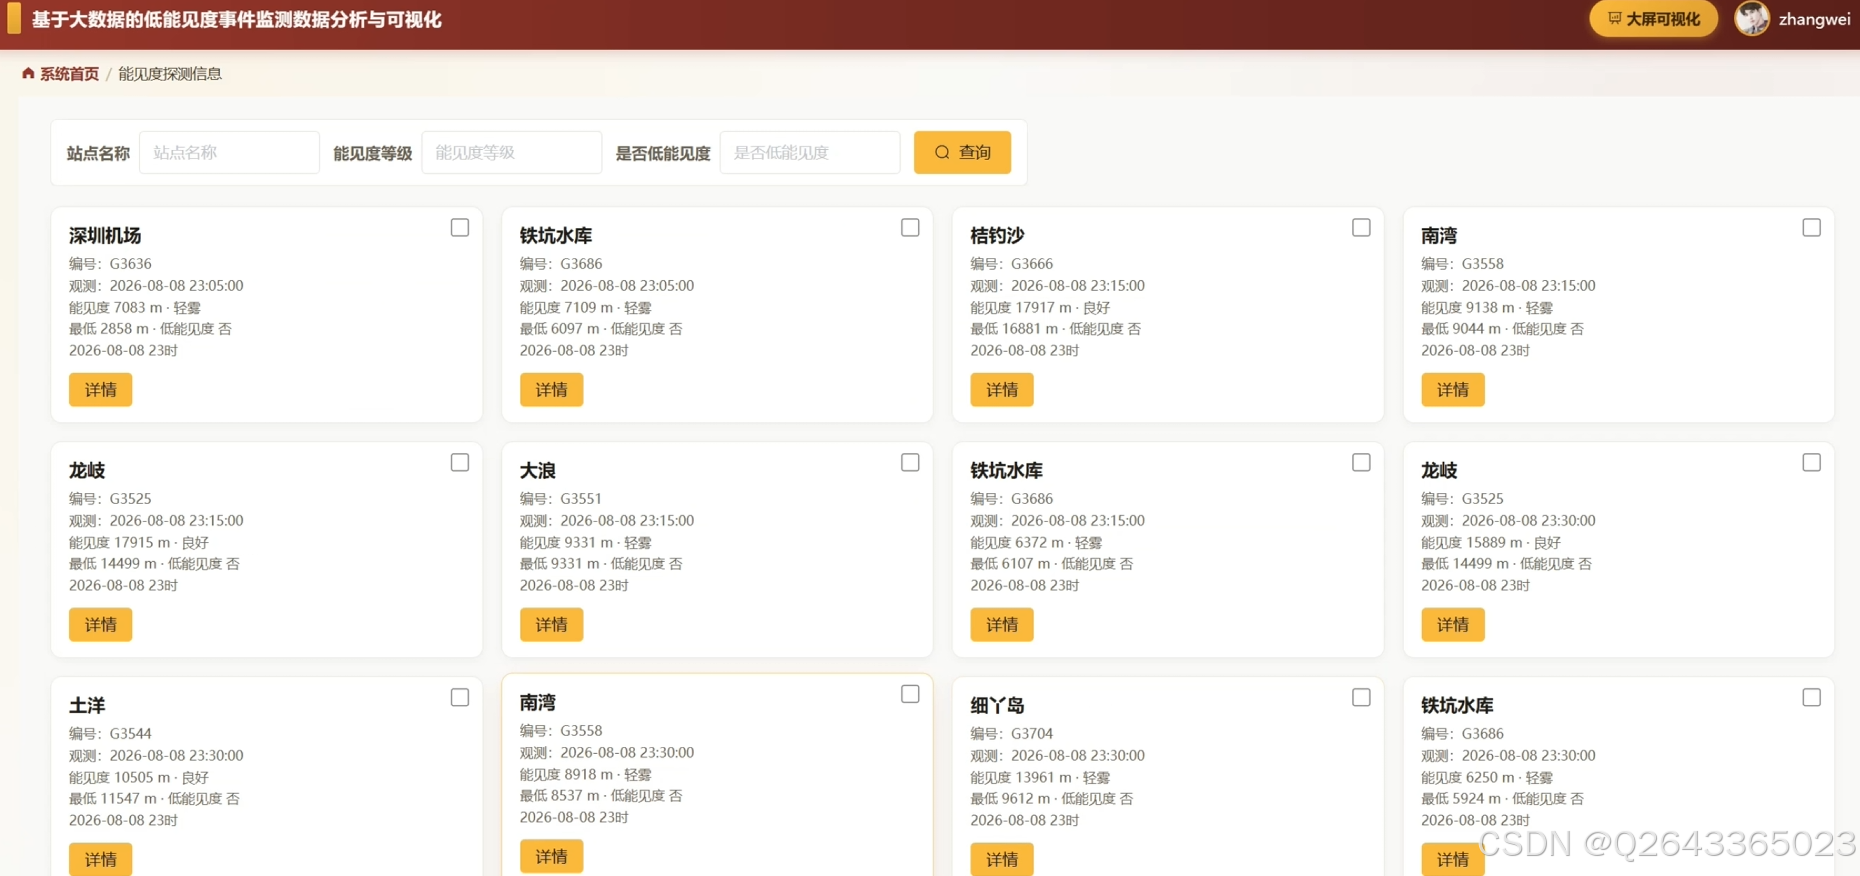
随着深圳市气象局能见度探测数据持续积累,低能见度事件监测面临数据量大、字段多、站点差异明显、人工统计效率低等问题。原始数据文件为"能见度探测数据_2920000902986.csv",包含站号、数据时间、本小时最低能见度出现时间、本小时最低能见度、能见度、站名、十分钟能见度等字段,能见度以0.1米为单位记录,并存在时间字段空白、最低能见度少量缺失、十分钟能见度全为"-"等情况。为支撑低能见度事件的系统化分析,开发 LowVisibilityAnalysis 系统,采用 Hadoop HDFS 进行数据上传与存储,借助 PySpark 完成数据清洗、聚合和建模,并将站点对比、时序演变、等级分布、日内节律、波动特征与风险洞察等结果按业务主题写入 output 目录,形成可复用的低能见度监测数据分析与可视化基础。
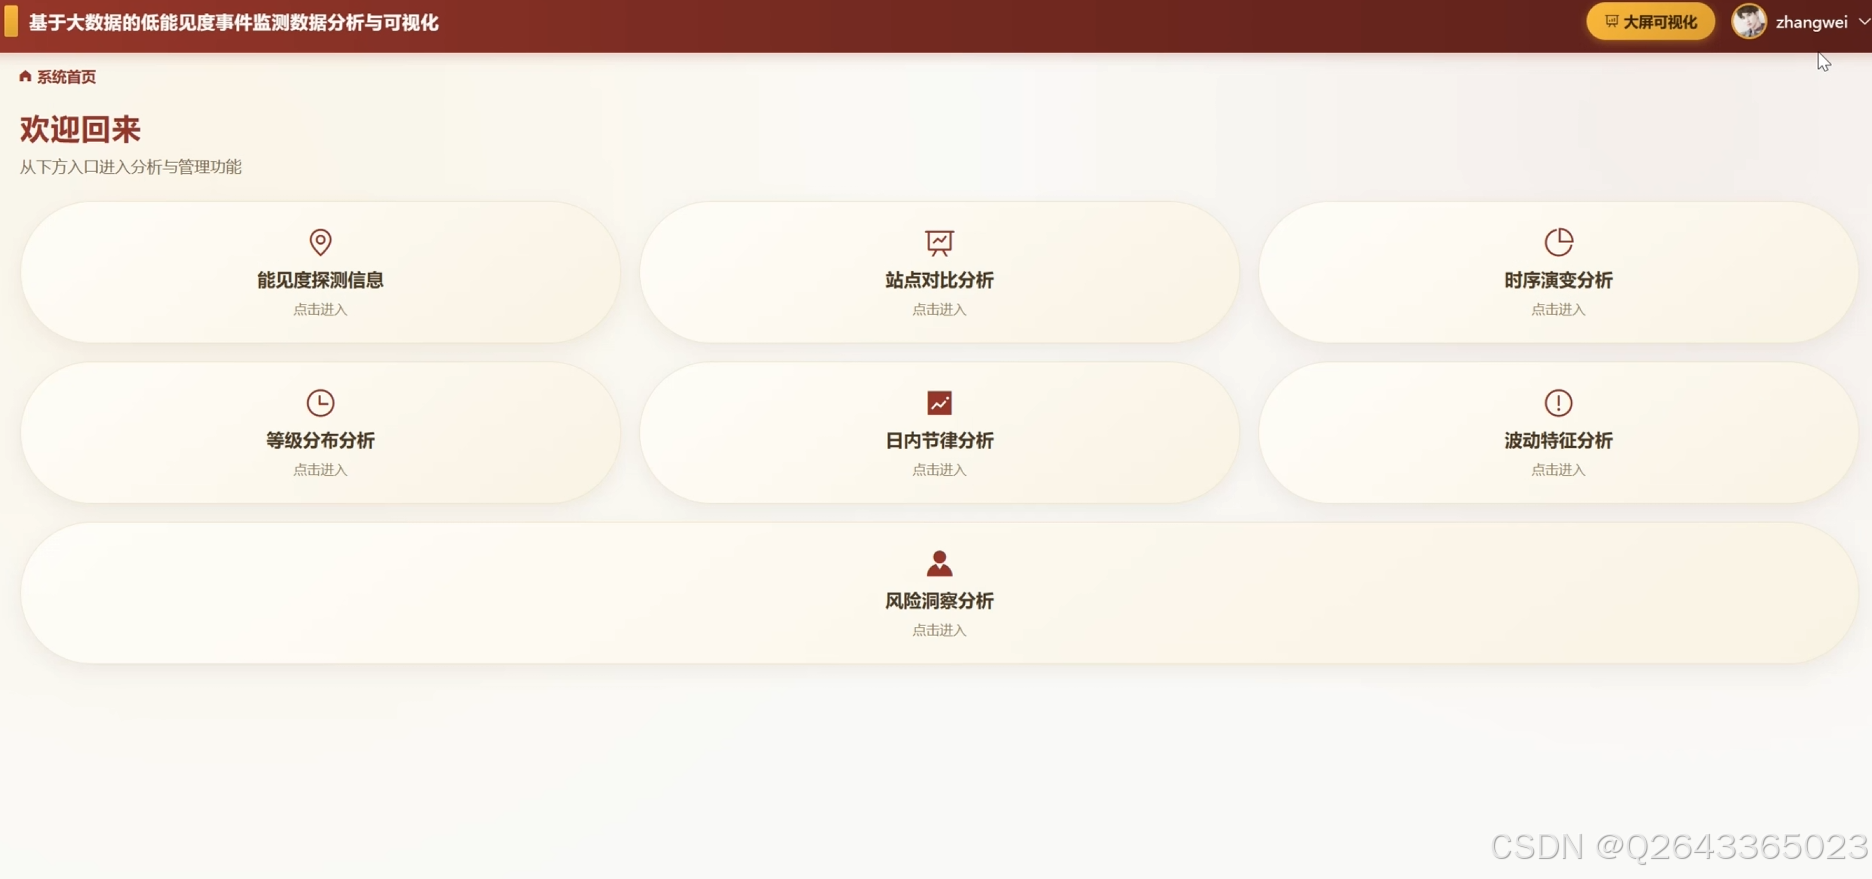
基于Hadoop+Spark的低能见度易雾站点识别与可视化分析系统以深圳市气象局能见度探测数据为对象,围绕基于大数据的低能见度事件监测数据分析与可视化展开。系统读取"能见度探测数据_2920000902986.csv",借助 Hadoop HDFS 完成项目目录创建、原始数据上传与预处理结果存储,使用 PySpark 进行分布式读取、清洗、聚合、统计和机器学习建模。预处理环节完成表头英文化、data_time 去空白与解析、能见度0.1米到米换算、min_visibility_m 缺失填补、min_vis_minute 空值保留、ten_min_visibility 统一为"未记录",并生成 obs_date、obs_hour、obs_weekday、vis_level、is_low_vis、is_visibility_cap 等派生字段。分析环节覆盖站点对比、时序演变、等级分布、日内节律、波动特征和风险洞察六个主题,输出站点平均与最低能见度、雾级频次、离散度、极值、日趋势、等级结构、雾级事件规模、小时与分钟节律、站点小时热力、同步低能、日波动、量程上限占比、K-Means 风险分群、Isolation Forest 异常事件和周期24小时季节分解等结果,形成低能见度监测分析的数据链路与业务输出。
数据上传与预处理研究:系统检查 Hadoop SafeMode,重建 HDFS 项目目录,上传原始数据;预处理完成字段映射、时间解析、单位换算、缺失处理和派生字段生成,并输出预处理 CSV。
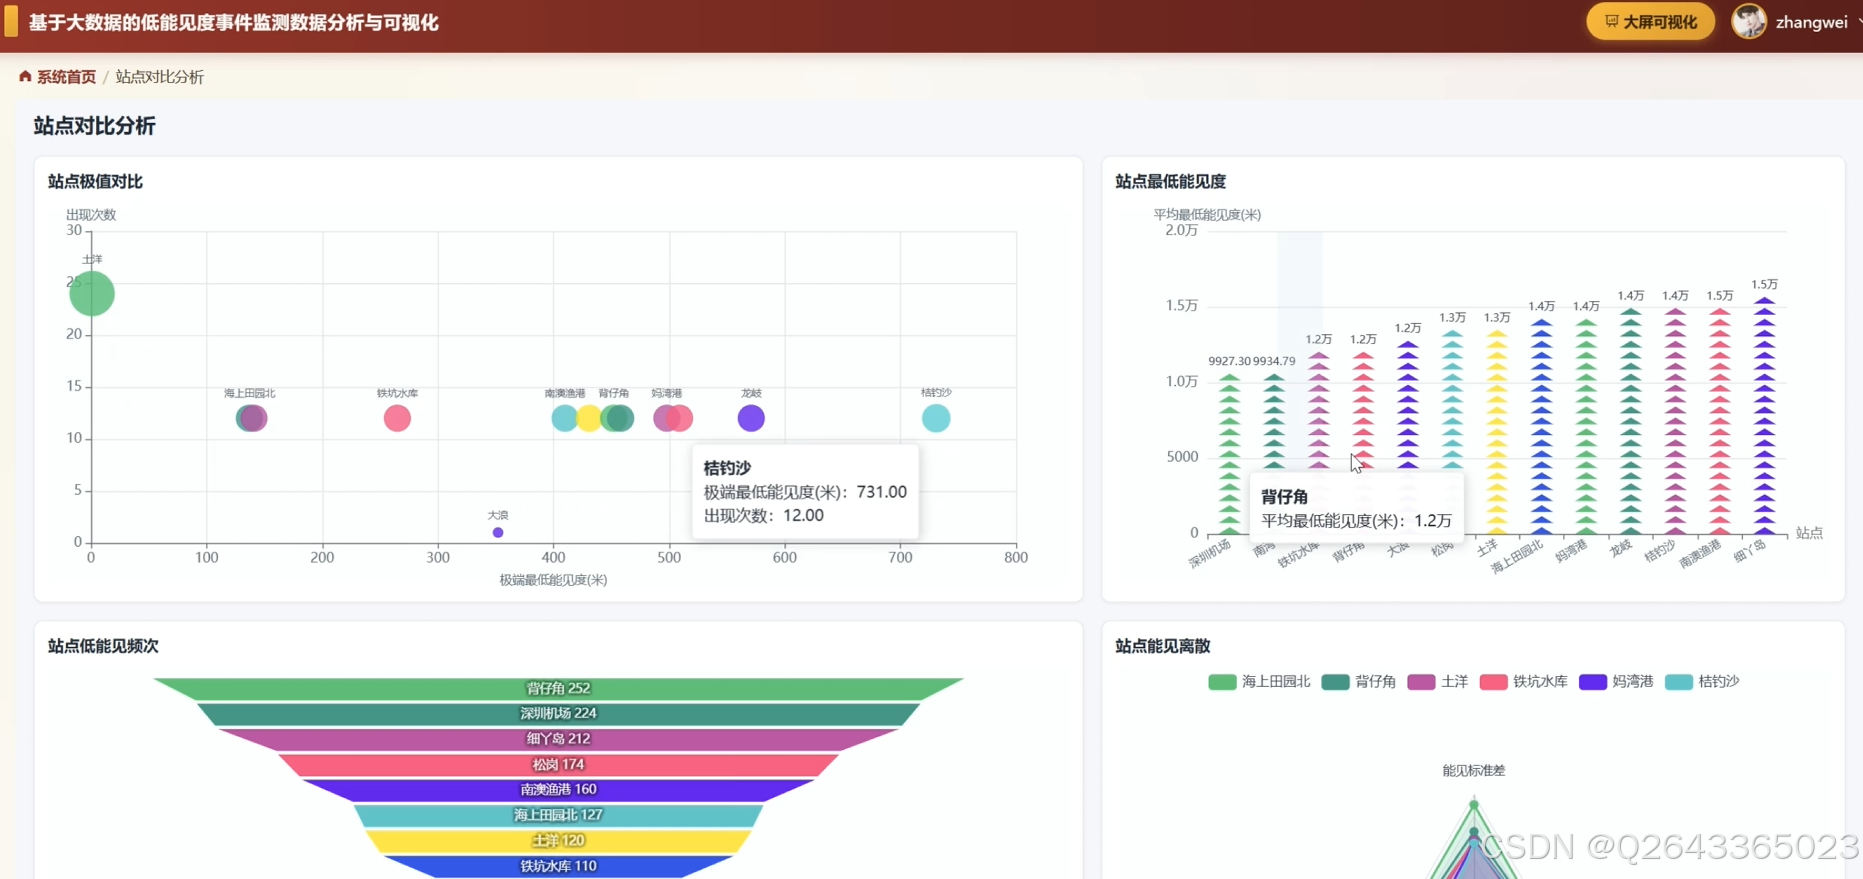
站点对比研究:围绕各站瞬时能见度均值、中位数、最低能见度均值、中位数、雾级次数与占比、标准差、四分位距和极值出现次数展开对比,识别偏暗站、偏亮站和高波动站。
时序演变研究:按 obs_date 聚合日均能见度、日最低能见度、低能见日频趋势,并对深圳机场、妈湾港、南澳渔港、背仔角、海上田园北等重点站进行日趋势对比。
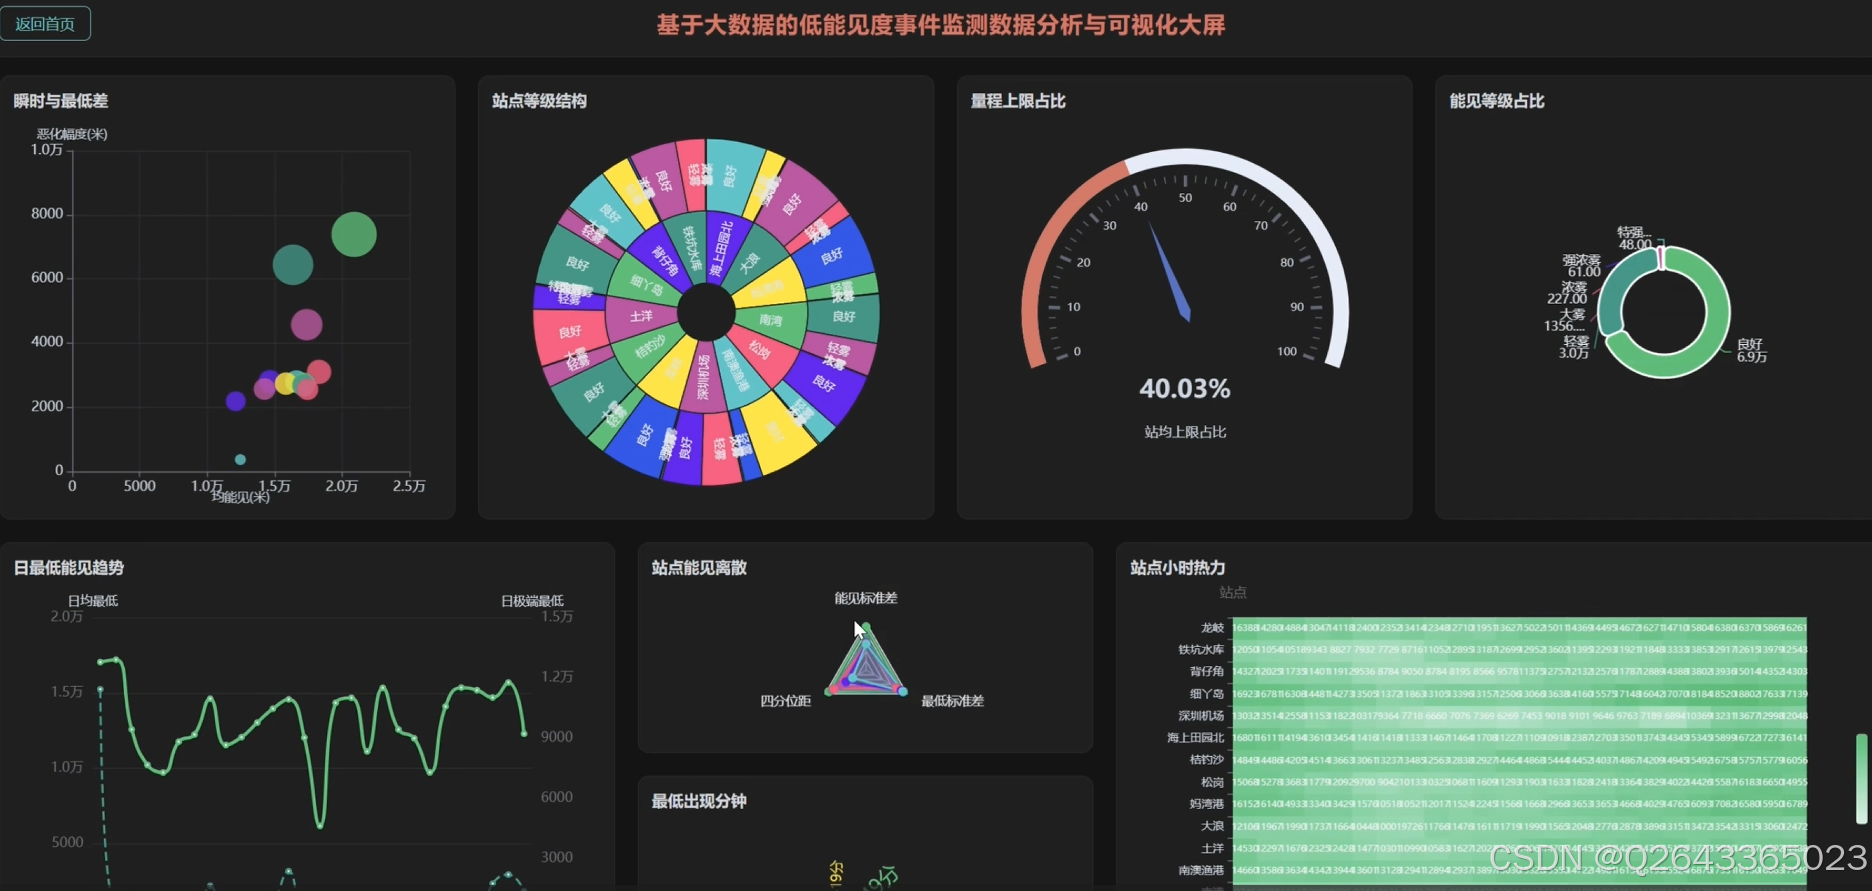
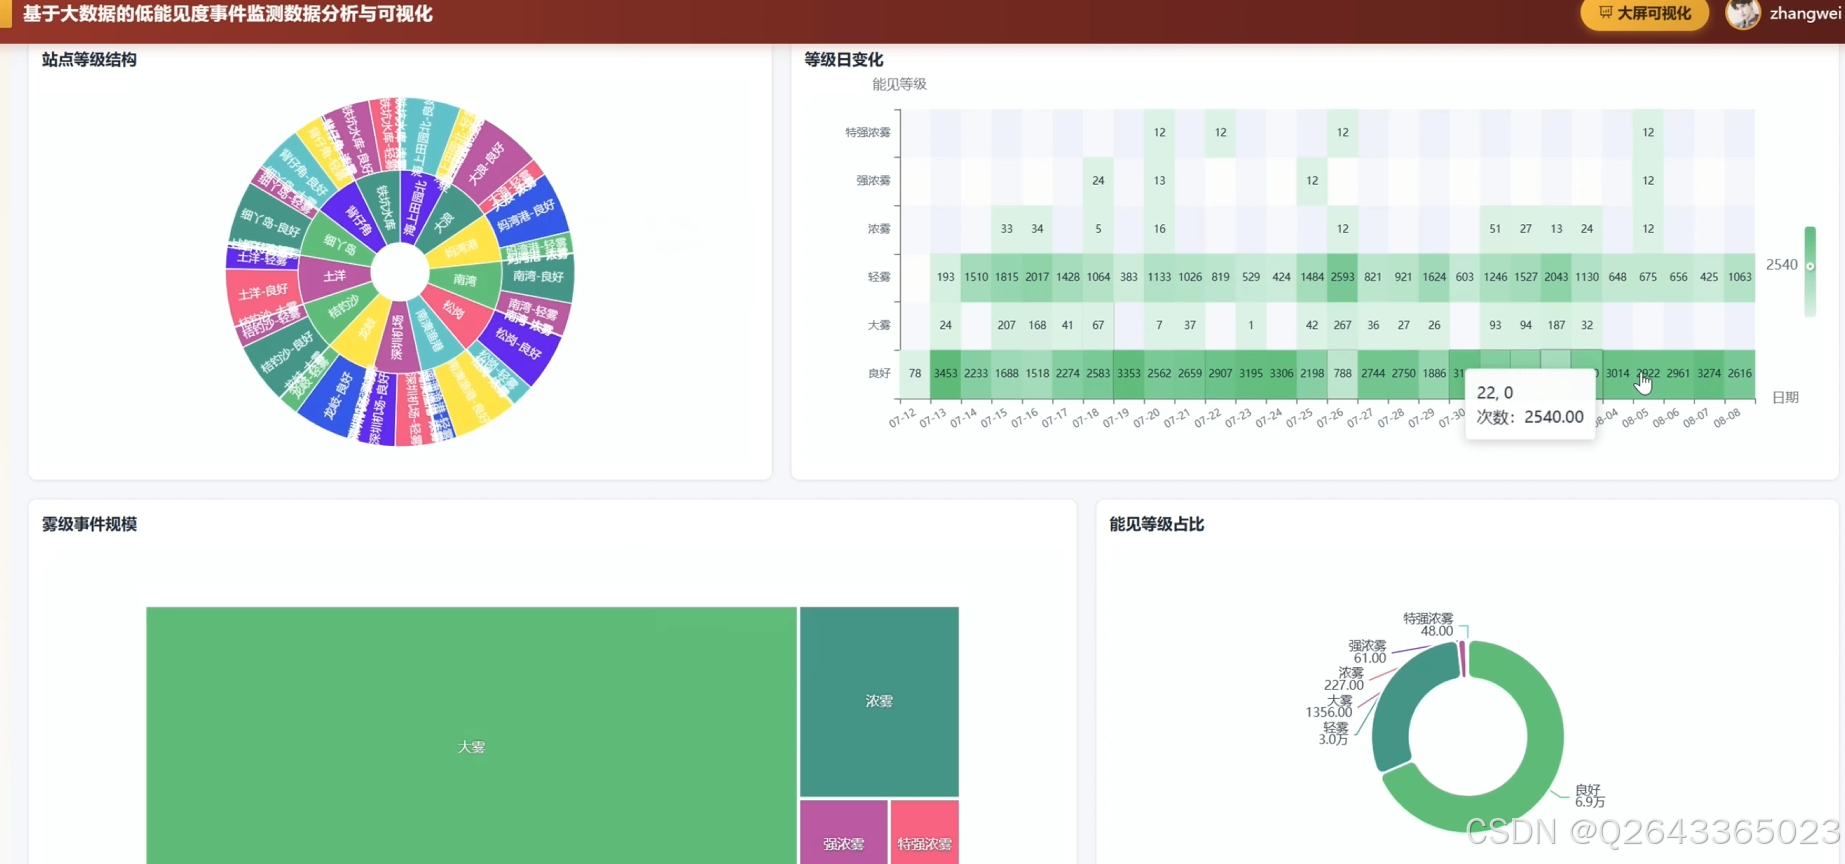
等级分布研究:基于 min_visibility_m 划分良好、轻雾、大雾、浓雾、强浓雾、特强浓雾等等级,统计整体占比、站点等级结构、雾级事件规模和日×等级变化。
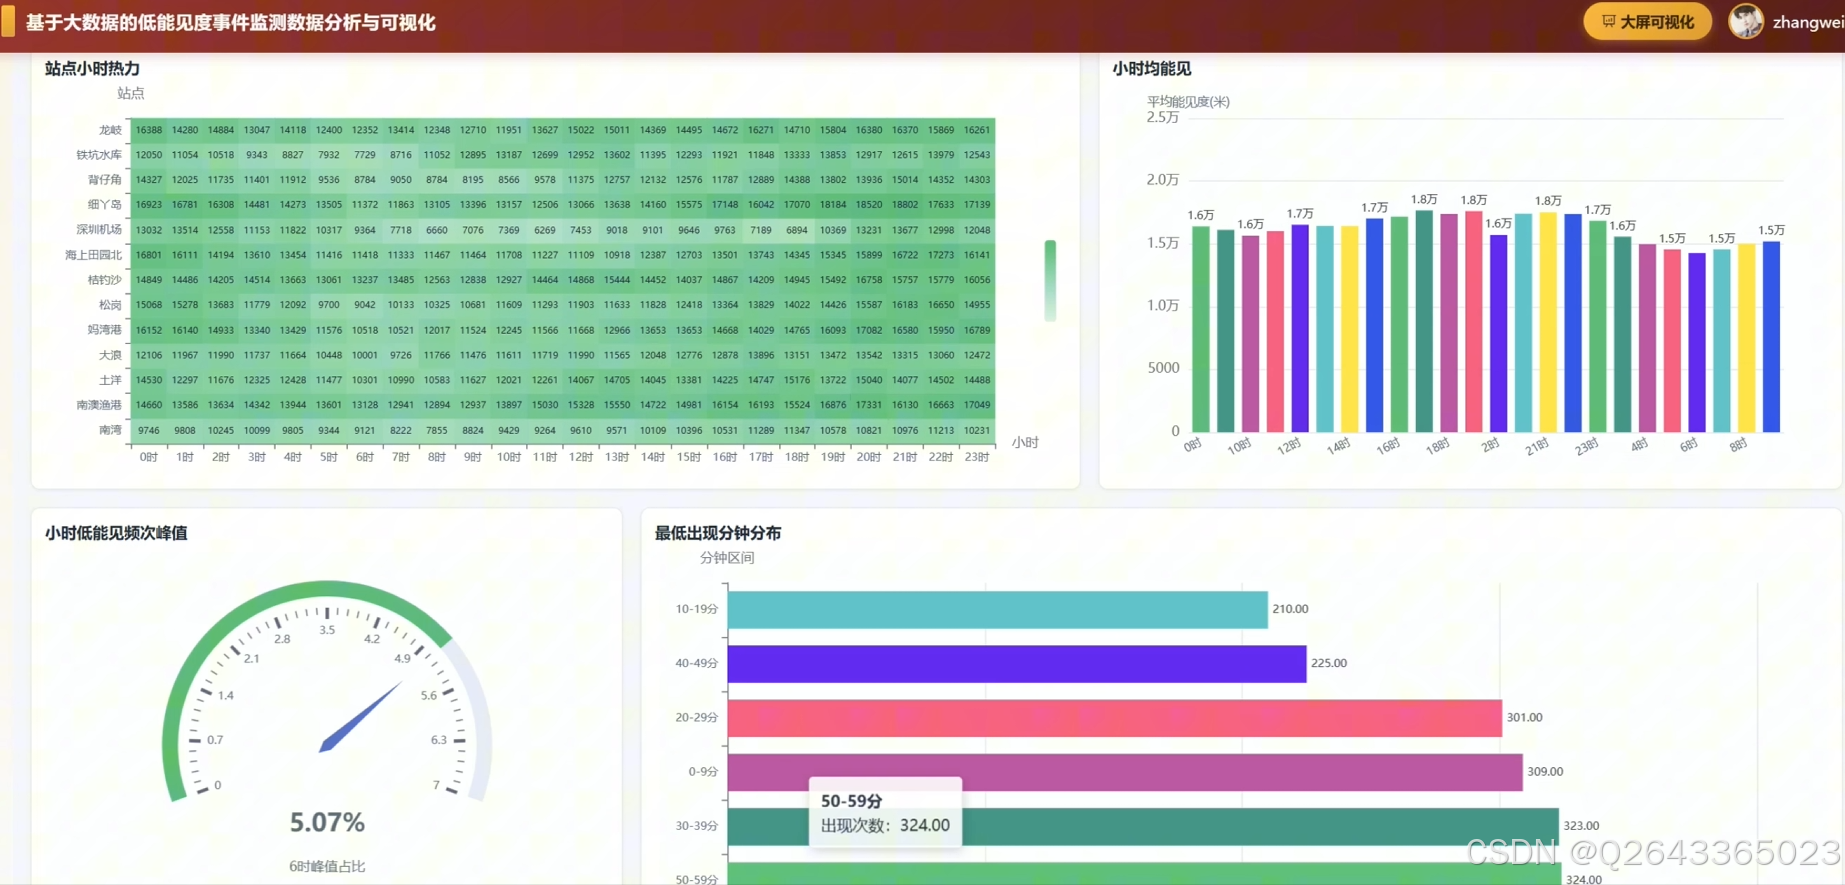
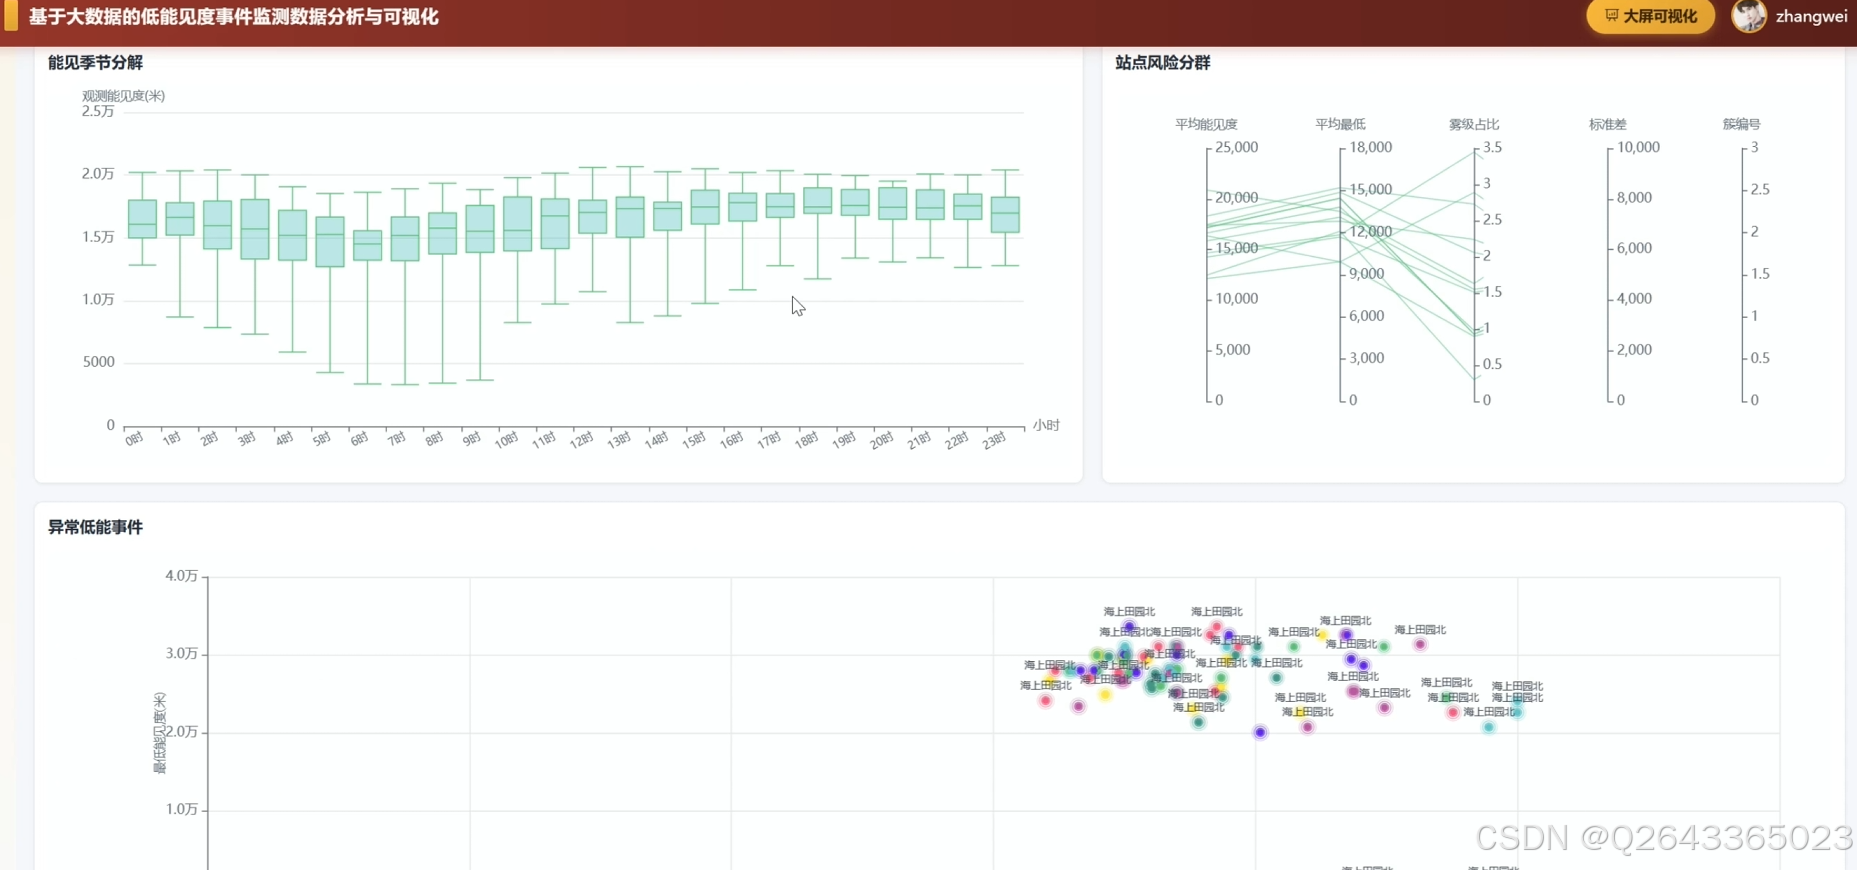
日内节律研究:分析0---23时平均能见度与低能见频次,统计雾级样本最低值出现分钟的10分钟桶分布,并生成站点×小时平均最低能见度热力结果。
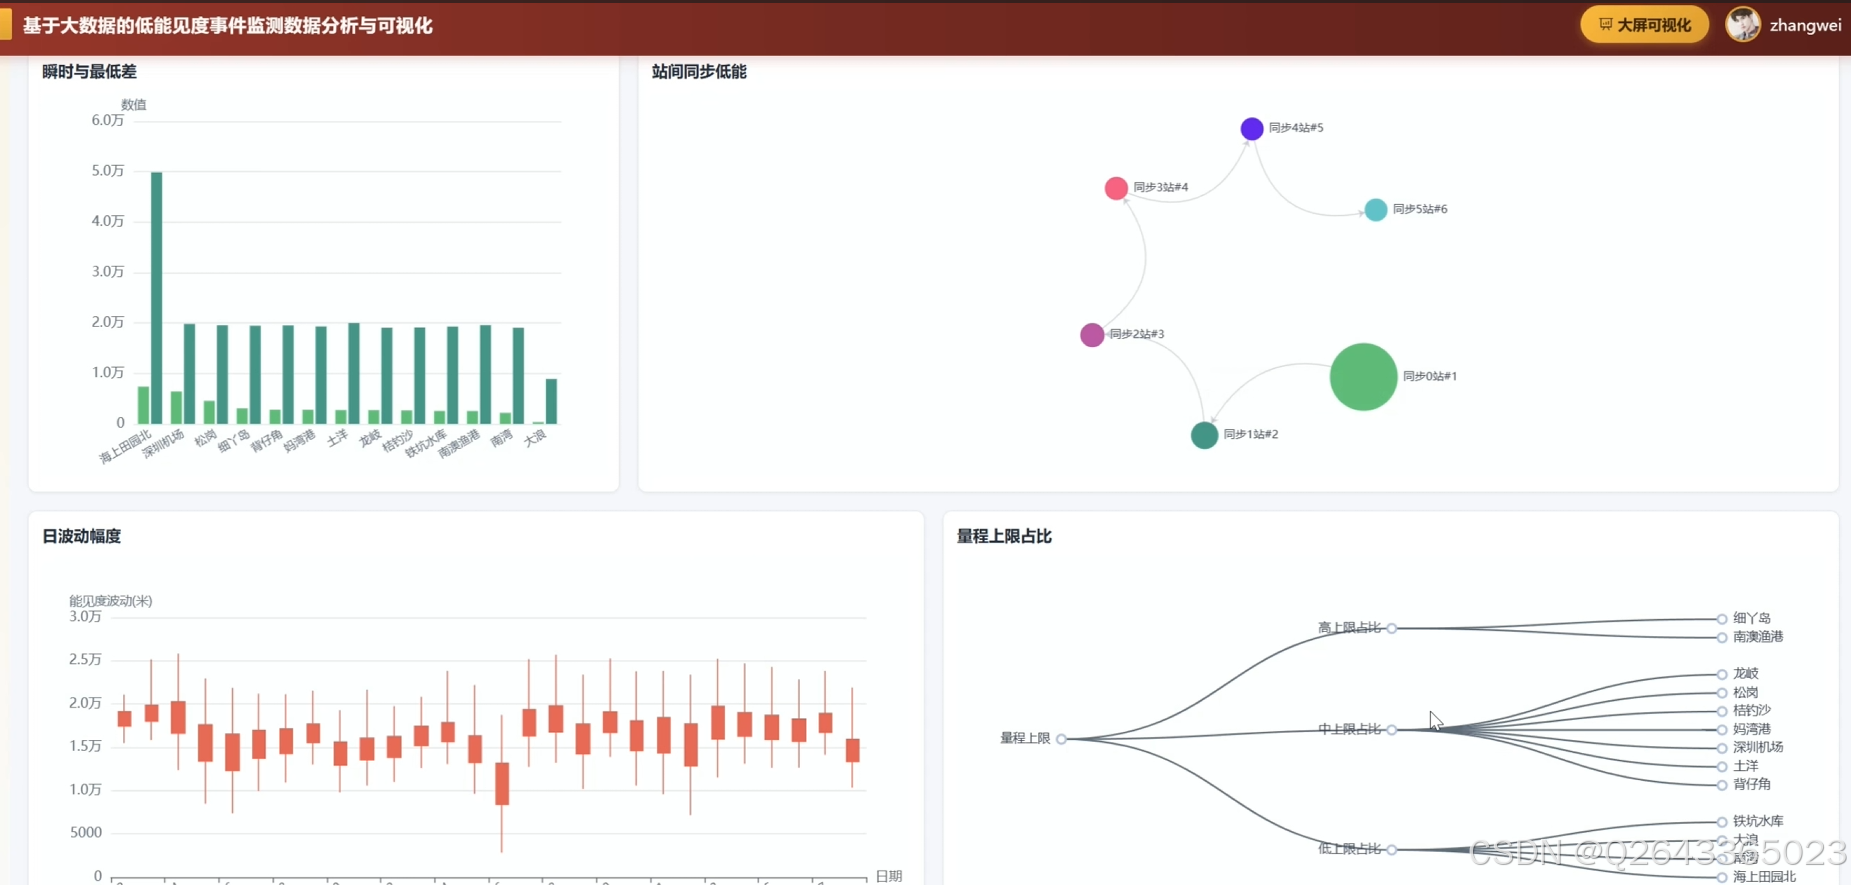
波动特征研究:计算瞬时能见度与最低能见度差值、同一 data_time 下同步雾级站点数分布、日能见度极差与标准差、各站触及20000米或50000米量程上限的占比。
风险洞察研究:在站点特征上使用 K-Means 聚类并按簇心雾级占比贴风险标签;使用 Isolation Forest 输出异常低能事件 Top 清单;对小时平均能见度序列进行周期24小时加法季节分解,输出 observed、trend、seasonal、residual 分量。
3 系统展示
3.1 功能展示视频
基于大数据的低能见度事件监测数据分析与可视化
!!!请点击这里查看功能演示!!!
3.2 大屏页面
3.3 分析页面
3.4 基础页面
4 更多推荐
从大模型到多模态:2027届计算机毕设最值得冲的AI选题方向
选对毕设题目,等于答辩过了一半,哪些能做,哪些会把你坑到延毕
5 部分功能代码
python
def station_low_vis_freq_analysis(input_df):
    """1.3 站点低能见频次:各站雾级(<1000m)次数与占比。"""
    base = input_df.filter(col('min_visibility_m').isNotNull())

    result = base.groupBy('station_name').agg(
        spark_count(lit(1)).alias('sample_count'),
        spark_sum(F.when(col('min_visibility_m') < 1000, 1).otherwise(0)).alias('low_vis_count'),
    ).withColumn(
        'low_vis_ratio',
        spark_round(col('low_vis_count').cast(DoubleType()) / col('sample_count') * 100, 2)
    ).orderBy(desc('low_vis_count'))

    out_path = os.path.join(
        script_dir, 'output', 'station_compare_analysis',
        'station_low_vis_freq_analysis.csv'
    )
    pdf = result.toPandas()
    for c in pdf.columns:
        if pdf[c].dtype.kind in 'fc':
            pdf[c] = pdf[c].round(2)
    pdf.to_csv(out_path, encoding='utf-8', index=False)
    return result
def daily_avg_vis_trend_analysis(input_df):
    """2.1 日均能见趋势:按日聚合平均瞬时能见度。"""
    base = input_df.filter(col('obs_date').isNotNull())

    result = base.groupBy('obs_date').agg(
        spark_count(lit(1)).alias('sample_count'),
        spark_round(spark_avg('visibility_m'), 2).alias('avg_visibility_m'),
        spark_round(spark_avg('min_visibility_m'), 2).alias('avg_min_visibility_m'),
    ).orderBy(asc('obs_date'))

    result = result.withColumn('obs_date', col('obs_date').cast(StringType()))

    out_path = os.path.join(
        script_dir, 'output', 'time_trend_analysis',
        'daily_avg_vis_trend_analysis.csv'
    )
    pdf = result.toPandas()
    pdf['obs_date'] = pdf['obs_date'].astype(str)
    for c in pdf.columns:
        if pdf[c].dtype.kind in 'fc':
            pdf[c] = pdf[c].round(2)
    pdf.to_csv(out_path, encoding='utf-8', index=False)
    return result
源码项目、定制开发、文档报告、PPT、代码答疑
希望和大家多多交流 ↓↓↓↓↓