论文名称:《JARVIS or Ultron? A Survey on the Safety and Security Threats of Computer-Using Agents》
作者:Ada Chen,Yongjiang Wu,Junyuan Zhang,Jingyu Xiao
单位:卡内基梅隆大学、香港中文大学、香港科技大学
收录期刊 :ACL 2026(第64届国际计算语言学协会年会)、A类
论文链接 :https://aclanthology.org/2026.acl-long.2106.pdf
目录
[一、Computer-Using Agent(CUA)的相关定义](#一、Computer-Using Agent(CUA)的相关定义)
[1.1 CUAs分类](#1.1 CUAs分类)
[1.2 Agent Framework(CUA的架构------三个核心组件)](#1.2 Agent Framework(CUA的架构——三个核心组件))
[2.1 Intrinsic threats(内部威胁)](#2.1 Intrinsic threats(内部威胁))
[2.1.1 受影响的组件:Perception(感知模块)](#2.1.1 受影响的组件:Perception(感知模块))
[(1)UI Understanding and Grounding Difficulties(UI 理解与落地困难)](#(1)UI Understanding and Grounding Difficulties(UI 理解与落地困难))
[2.1.2 受影响的组件:Brain(大脑模块)](#2.1.2 受影响的组件:Brain(大脑模块))
[(2)Scheduling Errors (调度错误)](#(2)Scheduling Errors (调度错误))
[(5)Excessive Context Length(上下文长度过长)](#(5)Excessive Context Length(上下文长度过长))
[(6)Social and Cultural Concerns(社会和文化关注)](#(6)Social and Cultural Concerns(社会和文化关注))
[(7)Response Latency(响应延迟)](#(7)Response Latency(响应延迟))
[2.1.3 受影响的组件:Action(行动模块)](#2.1.3 受影响的组件:Action(行动模块))
[(8)API Call Errors(API 调用错误)](#(8)API Call Errors(API 调用错误))
[2.2 Extrinsic threats(外部威胁)](#2.2 Extrinsic threats(外部威胁))
[(1)Adversarial Attack(对抗性攻击)](#(1)Adversarial Attack(对抗性攻击))
[(2)Prompt Injection Attack(提示注入攻击)](#(2)Prompt Injection Attack(提示注入攻击))
[(3)Jailbreak Attack(越狱攻击)](#(3)Jailbreak Attack(越狱攻击))
[(4)Memory Attack(记忆攻击)](#(4)Memory Attack(记忆攻击))
[(5)Backdoor Attack(后门攻击)](#(5)Backdoor Attack(后门攻击))
[(6)Reasoning Gap Attack(推理间隙攻击)](#(6)Reasoning Gap Attack(推理间隙攻击))
[(7)System Sabotage Attack(系统破坏攻击)](#(7)System Sabotage Attack(系统破坏攻击))
[(8)Web Hacking Attack(网络黑客攻击)](#(8)Web Hacking Attack(网络黑客攻击))
[1.Environmental Constraints 环境约束](#1.Environmental Constraints 环境约束)
[2.Input Validation 输入验证](#2.Input Validation 输入验证)
[3.Defensive Prompting 防御性提示](#3.Defensive Prompting 防御性提示)
[4.Data Sanitization 数据清理](#4.Data Sanitization 数据清理)
[5.Adversarial Training 对抗性训练](#5.Adversarial Training 对抗性训练)
[6.Output Monitoring 输出监控](#6.Output Monitoring 输出监控)
[7.Model Inspection 模型检验](#7.Model Inspection 模型检验)
[8.Cross Verification 交叉验证](#8.Cross Verification 交叉验证)
[9.Continuous Learning and Adaptation 持续学习和适应](#9.Continuous Learning and Adaptation 持续学习和适应)
[10.Transparentize 透明化](#10.Transparentize 透明化)
[11.Topology-Guided 拓扑引导策略](#11.Topology-Guided 拓扑引导策略)
[12.Perception Algorithms Synergy 感知算法协同](#12.Perception Algorithms Synergy 感知算法协同)
[13.Planning-Centric Architecture Refinement 以规划为中心的架构精细化](#13.Planning-Centric Architecture Refinement 以规划为中心的架构精细化)
[14.Pre-defined Regulatory Compliance 预定义的监管合规性](#14.Pre-defined Regulatory Compliance 预定义的监管合规性)
[四、评估和基准测试Evaluation and Benchmarking](#四、评估和基准测试Evaluation and Benchmarking)
[4.1 数据集 Dataset](#4.1 数据集 Dataset)
[4.2 评估指标Metrics](#4.2 评估指标Metrics)
[4.2.1 Task Completion Metrics 任务完成指标](#4.2.1 Task Completion Metrics 任务完成指标)
[4.2.2 Intermediate Step Metrics 中间步骤指标](#4.2.2 Intermediate Step Metrics 中间步骤指标)
[4.2.3 Safety and Robustness Metrics 安全和健壮性指标](#4.2.3 Safety and Robustness Metrics 安全和健壮性指标)
[5.1 Rule-based Measurements 基于规则的测量](#5.1 Rule-based Measurements 基于规则的测量)
[5.2 LLM-as-a-judge Measurements 基于LLM的测量](#5.2 LLM-as-a-judge Measurements 基于LLM的测量)
[5.3 Manual Judge Measurements 手动判断测量](#5.3 Manual Judge Measurements 手动判断测量)
[六、Discussion 讨论](#六、Discussion 讨论)
[6.1 Key Insights 主要见解](#6.1 Key Insights 主要见解)
[6.2 未来方向](#6.2 未来方向)
摘要
最近,人工智能驱动的与计算机设备的交互已经从基本原型工具发展到复杂的、基于LLM(large language model)的系统,这些系统可以在GUI(graphical user interfaces,图形用户界面)中模拟类似人类的操作。现在,我们见证了计算机使用智能体(Computer-Using Agents,CUAs)的出现,它能够自主执行任务,例如导航桌面程序、网页和移动应用程序。然而,随着这些智能体能力的增长,它们也带来了新的安全和安保风险。LLM驱动的推理中的漏洞,加上多软件组件集成和多模式输入的额外复杂性,进一步使安全格局复杂化。
在本文中,我们提出了一个关于CUAs安全和安全威胁的系统知识。我们进行了全面的文献回顾,并根据四个研究目标提炼出我们的结论:(i)定义适合安全分析的CUA;(ii)对CUAs中当前的安全威胁进行分类;(iii)提出现有防御策略的全面分类;(iv)总结用于评估CUAs安全和性能的主流基准、数据集和评估指标。在这些见解的基础上,我们的工作为未来的研究人员提供了探索未知漏洞的结构化基础,并为实践者设计和部署安全的计算机使用智能体(CUAs)提供了可行的指导。
一、Computer-Using Agent(CUA)的相关定义
定义(OpenAI,2025a):
a Computer-Using Agent (CUA) is an LLM-based system that combines multimodal perception, advanced reasoning, and tool-use capabilities to perceive and interact with graphical user interfaces (GUIs) and external applications just like human users.
计算机使用智能体(CUA)是一个基于LLM的系统,它结合了多通道感知、高级推理和工具使用能力,像人类用户一样来感知图形用户界面(GUI)和外部应用程序并与之交互。
1.1 CUAs分类
- OS Agent
operate within general computing devices
通过与操作系统的环境和接口交互来执行任务
- GUI Agent
Agents that interact specifically with graphical user interfaces to control applications and perform tasks that would typically require human interaction with visual elements
- Web Agent
navigate and interact with web environments
- Device-control Agent
agents that manage and control various hardware devices
1.2 Agent Framework(CUA的架构------三个核心组件)
-
Perception 感知模块(enables agent to gather information from its environment)
-
Brain 大脑模块(serve as the decision-making unit ,process the information)
-
Action 行动模块(execute the decisions made by brain)
二、当前安全威胁的分类
针对CUAs的安全分类,将分为两大类:Intrinsic threats(内部威胁) 和 Extrinsic threats(外部威胁)。
-
Intrinsic threats(内部威胁) :源于智能体本身的固有方面,包括训练过程、配置或固有限制。
-
Extrinsic threats(外部威胁) :由外部实体 发起的,例如恶意攻击者 或用户,他们试图利用agents(智能体)与周围环境交互中的漏洞或利用智能体的内在问题来触发不安全行为。
对于每一个威胁,从三个维度进行描述:来源 (环境、提示、模型或使用者,标记为主要或次要)、智能体受影响的组件 (感知、大脑或行动模块)和威胁模型(对手或用户驱动的场景)
2.1 Intrinsic threats(内部威胁)
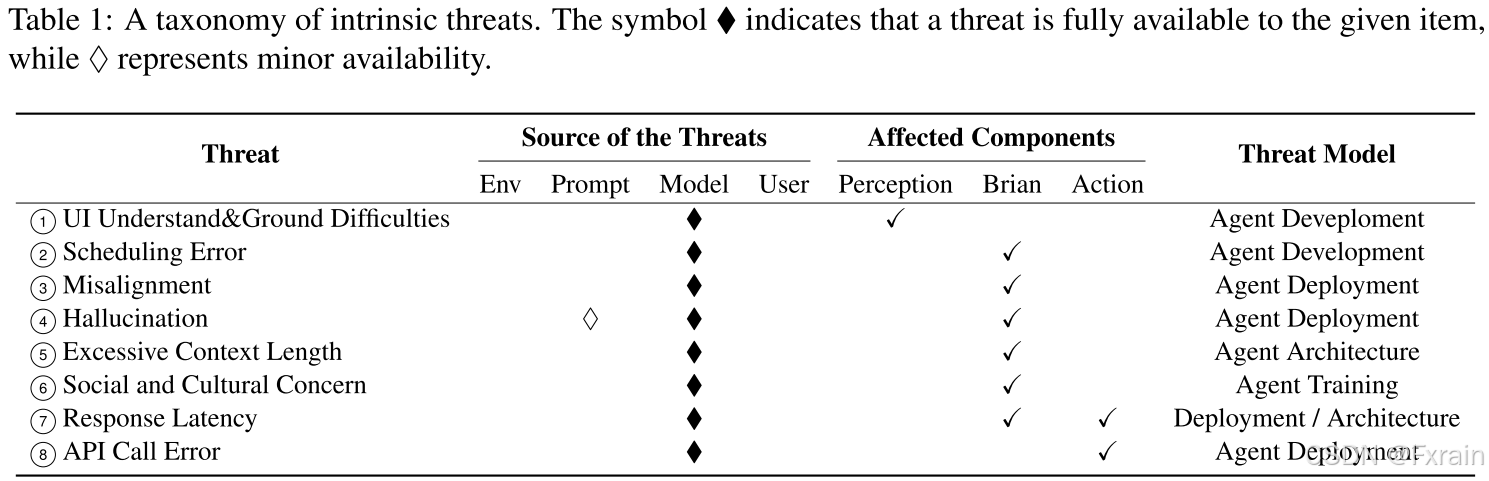
2.1.1 受影响的组件:Perception(感知模块)
感知模块负责接收模型输入信息,并识别任务特定元素,例如UI界面截图、HTML元素或其他环境观察信息。
(1)UI Understanding and Grounding Difficulties(UI 理解与落地困难)
UI 理解与落地困难指的是模型在使用语义、用户意图、外部知识的准确感知方面面临的挑战。现有UI数据集中的固有缺陷加剧了这些挑战,如静态表示、有限的交互多样性和分辨率限制。
2.1.2 受影响的组件:Brain(大脑模块)
大脑模块负责reasoning (推理)、memory (记忆)和planning(规划)功能。
(2)Scheduling Errors (调度错误)
调度错误指的是CUA在管理执行顺序、并发或动作时间方面的内部失败,导致意外的或不稳定的行为。当智能体需要执行复杂的指令和相互依赖的子任务时,这些问题尤为突出。Current planning modules(当前规划模块)通常依赖于外部工具或特定应用程序的API在解释环境并将预测的操作转化为执行步骤,但是缺乏健壮的内部规划机制导致CUA容易受到这类错误的影响。
(3)Misalignment(目标错位)
当智能体的内在推理与现实世界的上下文或用户意图不正确地对齐时,就会发生错位。这个问题源于LLM固有的缺陷,它导致决策与环境要求或用户说明不同步,导致意想不到的有害的行为。
(4)Hallucination(幻觉)
幻觉指的是CUA智能体生成的输出,例如事实、行动或API调用,不是根据实际环境、任务上下文或用户输入,这源于对智能体缺乏足够的训练以及它们对特定任务的知识和上下文的掌握有限。
(5)Excessive Context Length(上下文长度过长)
对模型的累积输入和历史交互数据超过或接近模型的输入容量,导致性能下降。
(6)Social and Cultural Concerns(社会和文化关注)
CUA在准确识别、尊重和遵守不同社会规范、文化敏感性和道德期望方面面临的挑战。
(7)Response Latency(响应延迟)
响应延迟是指user input(用户输入) 和agent's corresponding output or action(智能体的相应输出或操作) 之间的延迟,通常由模型推理时间、复杂的推理过程或大型上下文处理过程引起。它通常是由多种因素引起的,其中**Brain Component(大脑部分)**的推理时间起着主要作用。在金融交易或医疗诊断等关键领域,这些问题可能具有严重的安全影响。
2.1.3 受影响的组件:Action(行动模块)
行动模块负责将智能体的输出转换为一系列可执行的操作。由于这些行为涉及与未经验证的网站或API提供商的交互,这也带来了一些安全风险。
(8)API Call Errors(API 调用错误)
API调用错误是指在构造API调用时,CUA无法正确推断、选择或格式化所需参数的能力。虽然通用LLM在推理和规划方面表现出很强的能力,但它们在API调用过程中经常表现出不准确,特别是在参数填充方面。
2.2 Extrinsic threats(外部威胁)
由外部对手发起的攻击载体,利用智能体与其环境交互中的漏洞攻击或颠覆智能体的决策过程。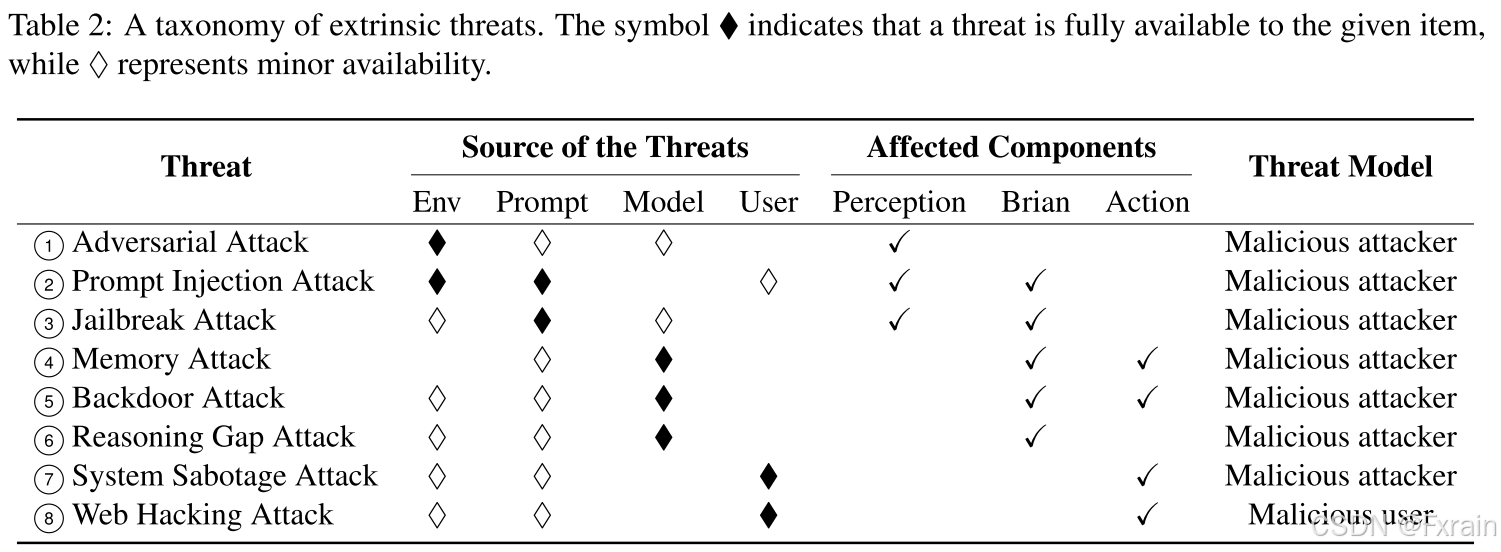
(1)Adversarial Attack(对抗性攻击)
故意操纵智能体的输入数据或环境以诱导其产生有害或无意的行为。在特定环境中操作的CUAs,例如与网页、计算机接口或移动程序交互时,特别容易受到特定于环境的对抗性攻击。
(2)Prompt Injection Attack(提示注入攻击)
利用CUAs的设计,将精心编制的指令嵌入到智能体的输入中,使其绕过安全规则或忽略原始目的并执行有害命令。大多数现有的提示注入攻击可以分为两种主要类型:Direct Prompt Injection(直接提示注入) 和Indirect Prompt Injection(间接提示注入)。
-
Direct Prompt Injection(直接提示注入):将敌对命令直接嵌入到用户的输入(提示)中
-
Indirect Prompt Injection(间接提示注入):将误导性指令或不安全内容注入到智能体的环境或外部数据源中
(3)Jailbreak Attack(越狱攻击)
越狱攻击通过重新措辞查询或向智能体的输入中注入额外的指令,绕过了CUAs预定义的护栏和安全机制,使智能体产生有害或未经授权的输出。
(4)Memory Attack(记忆攻击)
记忆攻击的目标是CUA持久的上下文,例如存储的任务计划、过去的交互以及检索到的文档,以影响未来的推理和行为。这些攻击通常分为两类:Memory Extraction(内存提取) 和Memory Injection(内存注入)。
-
Memory Extraction(内存提取):目标是通过设计的提示从存储的内存中恢复敏感信息
-
Memory Injection(内存注入):使用恶意记录毒化内存,随后在执行过程中检索到这些恶意记录
(5)Backdoor Attack(后门攻击)
后门攻击涉及到在CUA的training(训练)或fine-tuning(微调)阶段 插入恶意后门,以便之后当特定触发器出现在用户的输入或者智能体的观察中时,智能体执行意外或者有害的行为。这一类攻击可以直接在查询和环境数据中放置触发器。
(6)Reasoning Gap Attack(推理间隙攻击)
推理间隙攻击利用CUA的多通道感知与其内部推理之间的不匹配,向一个或多个通道注入冲突或模糊的信号,从而导致智能体得出不正确的推理并执行意外动作。
(7)System Sabotage Attack(系统破坏攻击)
系统破坏攻击诱骗智能体执行破坏性操作--例如损坏内存、损坏关键文件或暂停基本进程--这些操作会直接损坏主机系统或其基础设施。
(8)Web Hacking Attack(网络黑客攻击)
网络黑客攻击选择CUAs来自主识别和利用网站中的安全漏洞,例如SQL注入等,引导智能体通过精心设计的提示,有效地将它们(这些漏洞)转换为恶意用户的工具。
三、现有防御策略归纳
从三个维度对防御策略进行分类:其目标组件(环境、提示、模型或用户,标记为主要或次要)、其加强的智能体框架元素(感知模块、大脑模块或行动模块)以及其应对的目标威胁。
1.Environmental Constraints 环境约束
环境约束是一种安全机制,指限制或调解智能体与其操作环境的互动,以防止有害行为或恶意剥削。
2.Input Validation 输入验证
输入验证是一种安全措施,验证和清理用户的输入,以防止系统处理恶意或无意的命令
3.Defensive Prompting 防御性提示
防御性提示是指一种安全技术,通过构建提示来保护语言模型智能体,以防止敌意操纵并确保模型符合预期的行为。
4.Data Sanitization 数据清理
数据清理是指从训练数据集中检测并删除恶意或被破坏的数据以确保模型的完整性和安全性的过程。
5.Adversarial Training 对抗性训练
通过将对抗性范例纳入训练过程来增强模型的复原力和稳健性
6.Output Monitoring 输出监控
持续观察和评估智能体的输出,以确保它们与用户意图一致,不会产生不需要的操作
7.Model Inspection 模型检验
通过检查内部模型行为和参数 来检测恶意操作或受损逻辑,通常分为两个子方法:Anomaly Detection(异常检测) 和Weight Analysis(权重分析)。
-
Anomaly Detection(异常检测):侧重于监视智能体在推理或交互过程中的行为,以检测与预期模型输出或通信拓扑的偏差。
-
Weight Analysis(权重分析):检查训练模型的内部参数,以识别指示后门植入的隐藏触发因素或异常值分布。
8.Cross Verification 交叉验证
交叉验证是多智能体系统中的一种协同防御策略,多个智能体独立处理相同的任务或指令,并验证彼此的输出,以确保一致性和正确性。
9.Continuous Learning and Adaptation 持续学习和适应
智能体根据新的交互、环境或用户反馈动态更新其内部模型的能力,从而提高其长期安全性和稳健性。这种策略通常分为两个子方法:Self-Evolution Mechanisms(自我进化机制) 和User Feedback Integration(用户反馈集成)。
-
Self-Evolution Mechanisms(自我进化机制):指智能体根据过去的经验和结果自主调整其推理或决策策略的能力;
-
User Feedback Integration(用户反馈集成):利用来自人类用户的反馈来重新调整智能体的行为与用户预期。
10.Transparentize 透明化
透明化是指实施各种机制,提高CUAs的透明度和可解释性,从而改善其运作中的信任和安全。主要包含两个子方法:Explainable AI (XAI) Techniques (可解释AI技术) 和Audit Logs(审计日志)。
-
Explainable AI (XAI) Techniques (可解释AI技术) :涉及开发使用户理解CUAs决策过程的方法
-
Audit Logs(审计日志):记录智能体所做的行动和决定,以提供其操作的可追溯历史。
11.Topology-Guided 拓扑引导策略
通过分析和利用智能体之间的结构关系来检测和缓解对手威胁,从而增强多代理系统的安全性。这种方法包括两个方面:Agent Network Flow Analysis (智能体网络流分析) 和Resilience Planning(弹性规划)。
-
Agent Network Flow Analysis (智能体网络流分析):监视智能体之间的通信和交互模式,以识别可能指示安全漏洞的异常;
-
Resilience Planning(弹性规划) :侧重于将智能体网络拓扑设计为对潜在攻击具有健壮性。包括边缘修建等策略,切断与受危害智能体的连接,以防止恶意信息的传播。
12.Perception Algorithms Synergy 感知算法协同
感知算法协同是指将互补的感知模块组合在一起,以获得更忠实、紧凑和抗噪声的用户界面表示的一系列技术。
13.Planning-Centric Architecture Refinement 以规划为中心的架构精细化
改进CUA与推理相关的架构以确保可靠的调度、低响应延迟和精确地API调用。
14.Pre-defined Regulatory Compliance 预定义的监管合规性
设计CUA以遵守既定的法律、标准和道德准则,确保其运营符合社会规范和法律要求。这一战略包括两个主要方面:Adherence to Standards(遵守标准)指的是具体的监管框架以及为CUAs遵守的预定义的行业标准。Ethical Guidelines(道德准则)涉及将道德考虑融入智能体的设计和运营。
四、评估和基准测试Evaluation and Benchmarking
4.1 数据集 Dataset
- Web-based Scenario
基于Web的场景,评估在浏览器环境中智能体操作的安全性,这些基准主要集中于评估智能体响应安全敏感输入和交互的行为,包括提示注入、隐私暴露和违反社会规范。
- Mobile-based Scenario
在真实移动环境中评估CUA。在真实移动环境中,智能体面临着独特的挑战,例如有限的屏幕尺寸、基于触摸的交互、多样化的应用行为和资源限制。这些基准旨在捕捉移动平台特有的安全风险和操作复杂性,包括处理动态用户界面状态和安全敏感操作。
- General-purpose Scenario
考虑通用的安全评估,跨越了不同的工具、风险和交互环境。
**Tool-use scenario (工具使用场景)**指对使用工具的CUAs进行评估,重点是识别和解决因与不同外部工具交互而产生的安全漏洞。它旨在系统地调查智能体在执行涉及多个工具包和敌对条件的复杂任务时的故障和风险,从而促进开发更安全和更可靠的CUAs。
Mixed/hybrid environments (混合场景) 是指智能体跨多个异构接口和平台运行的评估方案,例如Web浏览器、操作系统、外壳程序和代码执行器。此设置旨在评估复杂、相互关联的环境中CUAs的稳健性和安全性,这些环境涉及不同的风险源--包括环境、用户起源和界面异常,并挑战智能体在现实和动态环境中安全管理多回合、多用户和对抗性交互的能力。
**Broader risk-awareness and multidimensional safety (更广泛的风险意识和多维安全)**指超越特定工具或环境的评估工作,旨在对CUAs面临的各种风险类型制定全面的分类和分析。这些工作强调对智能体行为的多个安全维度的整体评估,包括隐私、交互稳健性和风险意识,以衡量智能体识别和缓解广泛风险的程度,以及他们在交互过程中遇到的各种异常条件下的弹性。
4.2 评估指标Metrics
4.2.1 Task Completion Metrics 任务完成指标
- Task Success Rate (TSR) 任务成功率
测量智能体达到其预期最终目标的任务比例
- Helpfulness
评估智能体如何很好地完成用户指令,平衡任务成功、连贯推理和安全性
4.2.2 Intermediate Step Metrics 中间步骤指标
- Step Success Rate (SSR) 步进成功率
评估多步骤任务中每个单独步骤的准确性
- Total Correct Prefix
测量与事实一致的正确有序步骤的最长初始序列
4.2.3 Safety and Robustness Metrics 安全和健壮性指标
- Attack Success Rate (ASR) 攻击成功率
衡量智能体产生不安全或非预期结果的对抗性任务的比例,作为对抗性脆弱性的主要指标。
- Completion Under the Policy (CuP)
测量智能体在没有违反任何策略的情况下完成的任务的比例,表示严格遵守安全或使用规则。
- F1 Score
将准确率和召回率结合到调和均值中,以评估智能体在二进制分类中的准确性,例如区分安全和不安全标签。
- Refusal Rate(RR) 拒绝率
测量当面临不安全或不允许的请求时,智能体正确拒绝的任务的比例
- Leakage Rate(LR)泄露率
衡量智能体无意中泄露敏感或隐私信息的评估运行比例
- Attempt Rate (AR) 尝试比率
捕获智能体尝试遵循敌对指令的频率,即使它从未完成有害任务
- Cultural and Social Norms Metrics
评估智能体在互动中对社会期望的敏感度
- Awareness Coverage Rate (AC-R) 认知覆盖率
量化智能体准确识别潜在的文化或社会规范违规行为的用户查询的比例
- Educational Rate (Edu-R)
衡量智能体在检测到违规行为后是否提供适当的指导或纠正反馈
- Effectiveness
评估智能体在交互日志中正确识别和描述安全风险的能力
- Toxicity Score (TS) 毒性评分
估计代理的响应包含有毒、攻击性或有害内容的可能性
五、Measurements测量
5.1 Rule-based Measurements 基于规则的测量
使用预定义的确定性规则或算法来对照客观标准评估CUA行为,而不需要人类或LLM判断。基于规则的评估易于扩展,但很难捕获细微差别的、依赖于上下文的行为,从而限制了它们检测各种不安全尝试的能力。
5.2 LLM-as-a-judge Measurements 基于LLM的测量
利用大语言模型的上下文理解和推理能力,例如GPT4等通用模型或微调模型,在固定规则不足的复杂或开放式场景中评估智能体行为。虽然高度灵活,但基于LLM的评估可能会带来可变性、成本增加和偶尔的不一致。
5.3 Manual Judge Measurements 手动判断测量
依赖于人工评估员来评估智能体的行为或输出,这使得它对于需要细微判断、上下文理解或复杂推理的任务至关重要。尽管对于含糊的情况,人工评估具有很高的准确性和可解释性,但人工评估是劳动密集型的,难以衡量,并且受个人偏见的影响,这限制了其在大规模基准中的广泛使用。
六、Discussion 讨论
6.1 Key Insights 主要见解
-
Real-Time and Multimodal Emphasis (实时和多模态强调)
CUAs在动态、GUI驱动的环境中响应,这对低延迟推理、多模式接地和OnDevice资源使用提出了严格要求。
-
Grounding and Perception Gaps (接地和感知差距)
许多CUA在安全基准方面表现不佳,因为它们的用户界面基础仍然脆弱,误解了视觉和结构线索,并患有多模式幻觉,突显出需要更全面的培训和测试场景,以应对不同的威胁模型。
-
Limited Experimental Scenarios(有限的实验场景)
许多CUAs在高度限制的环境中进行试验,无法捕捉到现实世界中风险任务的广度。
-
Transparency Deficits(透明度缺陷)
缺乏可见的安全政策和来自CUA提供商的系统评估结果。
6.2 未来方向
-
Integrated Defense Mechanisms (综合防御机制)
集成用于可信度检查的模块
利用多智能体方法执行特定于角色的安全任务
如何高效、智能地集成不同的防御机制
-
Real-time Comprehensive Benchmarking (实时全面基准)
更动态的基准对于捕捉现实世界的复杂性至关重要。
未来的评估应该包括需要高级领域专业知识的任务,以及测试智能体在具有挑战性的条件和适应性攻击下的弹性。
-
Transparency and Accountability (透明度和问责性)
定义可扩展的自动化机制
-
Human-in-the-Loop Safeguards
纳入实时的人类监督、交互式风险警告和可解释的智能体理论
允许自适应的人工监督,在高风险部署中平衡自主性和安全性