我的笔记本电脑,CPU 是 Intel 的 Ultra X7 358H,在之前文章《Ultra X7 358H 笔记本电脑,本地部署当红炸子鸡 Qwen3.8-27B-Q4,实测生成速度 5.6 tok/s》中,已完成 Qwen3.8-27B-Q4 模型的本地部署。 但是实际生成速度太慢了,于是便想寻找一个适用于本机的用于编码的最强大模型,Deepseek Harness Desktop + Deepseek V4.1 Flash 给我选型了 Qwen3.6-35B-A3B,并帮我部署成功。
实际运行截图
随便输入一个问题,最后有速度统计,21.0 tok/s:
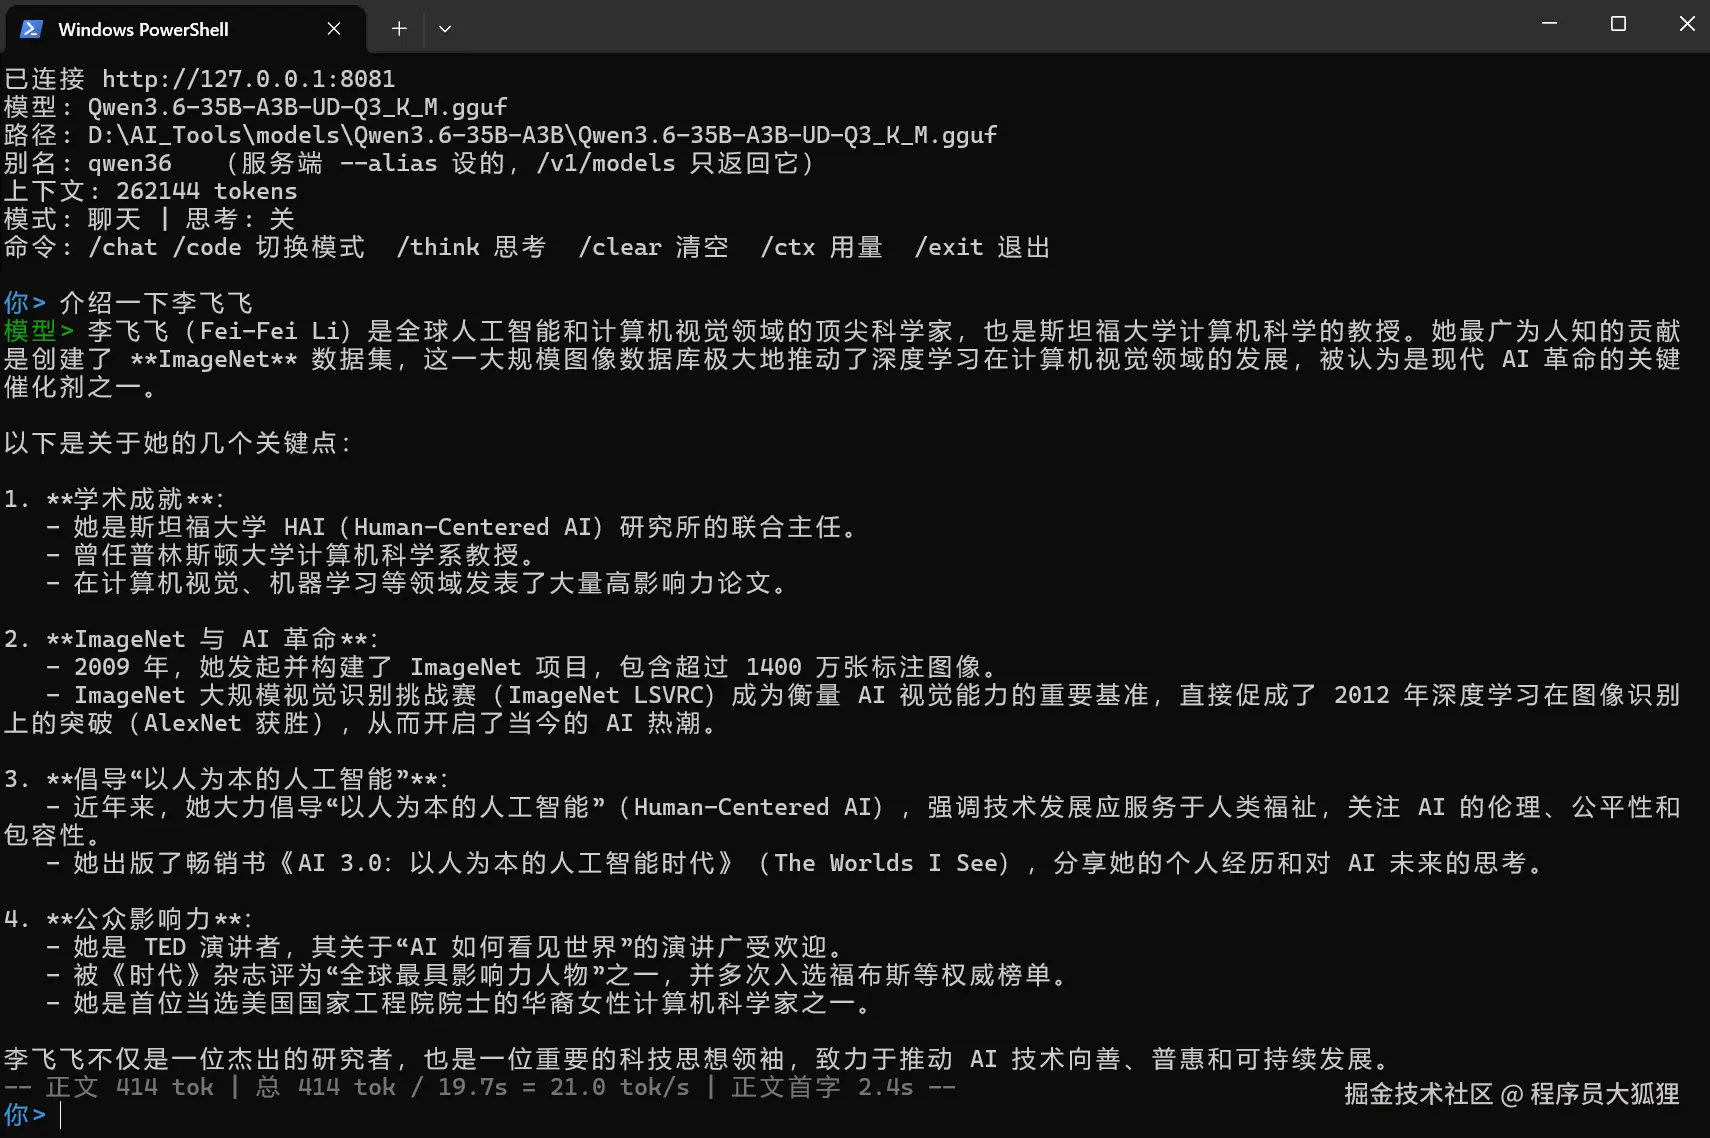
下面是 AI 的总结报告(Deepseek Harness Desktop + Deepseek V4.1 Flash):
概述
目标:在这台没有 NVIDIA 显卡 的笔记本上,搭一套本地、离线、能用于编码 的大模型。
最终方案:llama.cpp + SYCL 跑 Qwen3.6-35B-A3B(UD-Q3_K_M 量化,15.46 GiB) 。
实测 23~24 tok/s ,官方 SWE-bench Verified 73.4 ,上下文实测可开到模型原生的 256K。
本文所有数字均为本机实测,来源见文末。
结论摘要
| 项目 | 结果 |
|---|---|
| 模型 | unsloth/Qwen3.6-35B-A3B-GGUF → UD-Q3_K_M(15.461 GiB) |
| 引擎 | llama.cpp 0.5.0-dev(IntelLLVM 2025.3.3 编译的 SYCL 版) |
| 速度 | 23~24 tokens/s (对比 dense 27B 的 4.5~6 tok/s,快 4~5 倍) |
| 首字延迟 | 0.5~1.6 s(关闭思考模式);开思考需等 800~3000 token 的推理 |
| 上下文 | 4k/32k/64k/128k/192k/256k 全部实测可加载;用满原生上限 |
| 上下文内存开销 | 32k 仅 599 MiB 、256k 仅 3.79 GiB(不含 15.46 GiB 权重) |
| 编程能力 | SWE-bench Verified 73.4 、Terminal-Bench 2.0 51.5 、SWE-bench Pro 49.5 |
| 加载耗时 | 46~51 秒 |
| 日常建议 | 上下文用 32k~64k;256k 装得下但填满提示词要约 45 分钟 |
选型过程
先否掉了 Unsloth
最初的方向是用 Unsloth 装本地模型。核实后否掉,原因有三:
- Unsloth 是微调框架,纯推理用它没有优势;
- 它对 Intel GPU 的支持是"能训练",推理加速路径(vLLM)只有 Linux;
- 本机已有可用的 llama.cpp + SYCL,那才是这台机器上正确的推理引擎。
(Unsloth 那套环境仍留在 D:\AI_Tools\unsloth,约 6 GB,不训练的话可以删。)
再否掉了 Qwen3-Coder-Next(能力最强但装不下)
Qwen3-Coder-Next 是 2026-02 发布的旗舰编程智能体,SWE-bench Verified 约 70.6~71.3 。 但它是基于 Qwen3-Next-80B-A3B 的 80B MoE,体积直接把本机排除:
| 量化 | 体积 | 判断 |
|---|---|---|
| Q4_K_M(官方) | 45.09 GiB | ❌ 需 ≥48 GiB 显存/统一内存 |
| 最小的 TQ1_0 | 17.64 GiB | ❌ 仍超本机上限 |
| IQ2_XXS | 21.71 GiB | ❌ 需约 2 bit,质量与速度都不划算 |
本机实测的权重预算上限是约 15.5 GiB(见 4.3 节),所以 80B 级模型无法考虑。
也否掉了 Qwen3.5-27B(跑分最高但太慢)
Qwen3.5-27B 的 SWE-bench Verified 是 75.0 ,比下面选中的模型还高。但它是 dense 27B:
- 本机实测 dense 27B 只有 4.5~6 tok/s
- 编码是长输出、多轮交互任务,速度是体验的决定因素
- 而 MoE 的 35B-A3B 只激活约 3B 参数,快 4~5 倍
最终选中 Qwen3.6-35B-A3B
它的官方定位就是 "Agentic Coding Power" ,且实测跑分反超 Coder-Next:
| 基准 | Qwen3.6-35B-A3B | Qwen3-Coder-Next | Qwen3.5-27B | Qwen3-Coder-30B-A3B |
|---|---|---|---|---|
| SWE-bench Verified | 73.4 | 70.6~71.3 | 75.0 | 60.4 |
| SWE-bench Multilingual | 67.2 | 62.8~64.3 | 69.3 | --- |
| SWE-bench Pro | 49.5 | 42.7/38.7 | 51.2 | --- |
| Terminal-Bench 2.0 | 51.5 | 34.2/36.2 | 41.6 | --- |
| 权重体积(可用量化) | 15.46 GiB | 45.09 GiB | ~16 GiB | 12.86~17.28 GiB |
| 架构 | MoE(激活 ~3B) | MoE(激活 3B) | dense | MoE(激活 3.3B) |
决定性的三点:跑分不低于旗舰、体积能塞进本机、MoE 架构跑得快。
下载前的可行性验证(省钱省时间)
在花 2 小时下载前,先用 GGUF 头部探针确认架构被本机 llama.cpp 支持:
ini
general.architecture = qwen35moe        ← 关键
qwen35moe.block_count      = 40
qwen35moe.context_length   = 262144
qwen35moe.expert_count     = 256
qwen35moe.attention.head_count_kv = 2
而本机源码 src/llama-arch.cpp 里存在 LLM_ARCH_QWEN35MOE, "qwen35moe" → 无需重新编译 llama.cpp。
部署环境
硬件
| 项目 | 实测值 |
|---|---|
| 机型 | HONOR MagicBook JGC-N(BIOS 1.04 / 2026-04-07) |
| CPU | Intel Core Ultra X7 358H |
| GPU | Intel Arc B390 (集成显卡,驱动 32.0.101.8509),无独立显卡 |
| 显存 | 无独立显存,与系统内存共享 |
| 物理内存 | 31.55 GiB(板载焊接,不可扩容) |
| 磁盘 | C: 300 GB(可用 175 GB)/D: 624 GB(可用 545 GB) |
| 系统 | Windows 11(build 26200) |
关键系统设置
ini
HKLM\SYSTEM\CurrentControlSet\Control\GraphicsDrivers\MemoryManager
    SystemPartitionCommitLimitPercentage = 80   (dword 0x50,出厂为 57 / 0x39)
这一项决定了显卡能提交多少系统内存 。57% 时 32k 上下文就会失败, 80% 后 64k~256k 才可用(详细 A/B 验证见《显存与内存实测报告》)。 改完必须重启 。回滚用 D:\AI_Tools\igpu-shared-restore-57.reg。
引擎与模型
| 项目 | 路径 / 参数 |
|---|---|
| 引擎 | D:\AI_Tools\llama.cpp\build\bin\llama-server.exe(0.5.0-dev,SYCL) |
| 模型 | D:\AI_Tools\models\Qwen3.6-35B-A3B\Qwen3.6-35B-A3B-UD-Q3_K_M.gguf |
| 体积 | 15.461 GiB(16,600,710,112 字节) |
| 启动参数 | -ngl 99 -c 32768 -np 1 --cache-type-k q8_0 --cache-type-v q8_0 --jinja |
三个参数都有实测依据,都不能省:
-ngl 99:本机 llama.cpp 编译时未启用 Level Zero API,只能读到静态的显存上报值(16.46 GiB), 自动层分配会偏保守。必须显式指定把全部层放 GPU。-np 1:默认 4 个并行槽位,每槽位各留一份循环状态。单用户降到 1 个槽位 省 449 MiB(RS buffer 598.50 → 149.62 MiB,35B-A3B 为 62.81 MiB),与上下文长度无关。q8_0KV 量化:把 KV cache 压到 8 bit,是本机能开大上下文的前提之一。
实测参数
速度
| 测试 | 结果 |
|---|---|
| 生成速度(tg) | 23~24 tok/s(多次一致) |
| 首字延迟(关思考) | 0.5~1.6 s |
| 首字延迟(开思考) | 需先产出 800~3000 token 推理,约 36~44 s 后才出正文 |
| 提示处理(pp) | 约 97 tok/s |
| 模型加载 | 46~51 s |
横向对比 :同机 dense 27B 为 4.5~6 tok/s、pp 54 tok/s → 35B-A3B 快 4~5 倍。
上下文能力与内存开销(-np 1 + q8 KV)
| 上下文 | KV buffer | RS buffer | 计算缓冲* | 非权重合计 |
|---|---|---|---|---|
| 4096 | 42.50 MiB | 62.81 MiB | 84.56 MiB | 190 MiB |
| 32768 | 340.00 MiB | 62.81 MiB | 196.56 MiB | 599 MiB |
| 65536 | 680.00 MiB | 62.81 MiB | 324.56 MiB | 1067 MiB |
| 131072 | 1360.00 MiB | 62.81 MiB | 580.56 MiB | 2003 MiB |
| 196608 | 2040.00 MiB | 62.81 MiB | 836.56 MiB | 2939 MiB |
| 262144 | 2720.00 MiB | 62.81 MiB | 1092.56 MiB | 3875 MiB |
* 计算缓冲 = SYCL compute + Host compute
全部档位实测可加载,直到模型原生的 262144(256K)上限。
为什么这么便宜------llama.cpp 打印的这行给出了答案:
arduino
KV buffer size = 680.00 MiB (65536 cells, 10 layers, 1/1 seqs), K (q8_0): 340.00, V (q8_0): 340.0040 层里只有 10 层有 KV cache (full_attention_interval = 4),其余 30 层是线性/循环状态 (ssm.state_size = 128)。所以 KV 每 token 仅约 10.6 KiB , 而 dense 27B 是约 34 KiB (65 层里 16 层全注意力)------便宜 3.2 倍。
内存预算(为什么只能选 15.5 GiB 以内的权重)
同一时刻采样:
markdown
各进程工作集合计 : 14.59 GiB
系统实际占用     : 30.82 GiB
                   ─────────────
约 16 GiB 在进程之外(内核 / 驱动 / SYCL 运行时)实测结论:系统内存占用 ≈ 权重 × 1.6 + 5.8 GiB(Windows 基线) 。 代入 15.46 GiB 权重 = 30.5 GiB,在 31.55 GiB 里刚好放下(加载后仅剩 0.72 GiB 空闲)。 所以权重上限约 15.5 GiB,20 GiB 级模型必换页。
必须知道的三个坑
思考模式必须关掉
这是本机最影响体验的一点。实测:
| 设置 | 结果 |
|---|---|
| 默认(开思考) | 生成 3000 token 全是思考内容,正文一个字都没有,耗时 128 秒 |
enable_thinking=false |
首字 0.5s,23 tok/s,直接给答案 |
实现方式:请求体加
json
"chat_template_kwargs": {"enable_thinking": false}本机提供的两个客户端(网页版 / 终端版)都已默认关闭,需要深度推理时才手动开。
系统内存只剩 0.72 GiB,跑模型前关浏览器
加载后系统负载约 95~97%,一个 Edge 窗口就能把模型推进页面文件。 终端客户端只占几 MB,比网页版更适合这台机器。
长上下文"装得下"≠"等得起"
按实测 pp 约 97 tok/s 估算,填满不同上下文所需的提示词处理时间:
| 上下文 | 填充耗时(估算) |
|---|---|
| 32k | 约 5.6 分钟 |
| 64k | 约 11 分钟 |
| 256k | 约 45 分钟 |
所以 256k 是"技术上可用",日常还是 32k~64k。
怎么用
启动
bat
:: 网页版(自动开 32k 上下文)
D:\AI_Tools\chat-q36.cmd

:: 终端版(省内存,这台机器更推荐)
D:\AI_Tools\chat-q36.cmd cli
启动器会自动检测 8080/8092/8081 端口,发现已有服务就复用,不会重复加载第二份(一份就是 15 GiB)。
临时开更大的上下文
bat
D:\AI_Tools\llama-server.cmd D:\AI_Tools\models\Qwen3.6-35B-A3B\Qwen3.6-35B-A3B-UD-Q3_K_M.gguf 65536 8080接入编辑器(Continue / aider 等)
arduino
接口地址: http://127.0.0.1:8080/v1
API Key : 任意(本机无鉴权)
模型名  : Qwen3.6-35B-A3B-UD-Q3_K_M.gguf
若客户端支持自定义请求体,记得带 enable_thinking=false。
验证方法(可复现)
| 想验证什么 | 命令 |
|---|---|
| 各上下文的内存分配明细 | run.cmd scripts\probe_buffers.py 32768 65536 --np 1 --model <gguf> |
| 某上下文能否加载 + 出词 | run.cmd scripts\test_ctx_load.py 65536 |
| 读任意 GGUF 的架构与原生上下文 | run.cmd scripts\gguf_info.py <gguf> |
| 阶梯分配测显存上限 | run.cmd scripts\check_xpu_memory.py 22 1.2 |
文件清单
| 文件 | 作用 |
|---|---|
D:\AI_Tools\chat-q36.cmd |
一键启动 35B-A3B(网页 / 终端) |
D:\AI_Tools\llama-server.cmd |
通用服务启动器(-ngl 99 -np 1 + q8 KV 已内置) |
D:\AI_Tools\chat.html |
单文件网页客户端(流式、思考折叠、token/s) |
D:\AI_Tools\unsloth\scripts\chat_cli.py |
终端客户端(/chat /code /think /clear) |
D:\AI_Tools\models\Qwen3.6-35B-A3B\ |
模型本体 |
D:\AI_Tools\显存与内存实测报告.md |
显存/内存机制的完整实测报告(两个模型对比) |
附:数据来源
- 模型体积、架构、专家数:HF 仓库 API + 本地 GGUF 头部(
gguf_info.py) - 官方跑分:
Qwen/Qwen3.6-35B-A3B模型卡表格 - 速度(23~24 tok/s)、加载耗时、上下文内存明细:本机 llama.cpp
-lv 5输出与 API 实测 - 显存额度 A/B 结论:改注册表前后各重启一次后的对照实验
- 所有内存数字均来自 llama.cpp 自身的 buffer 分配明细,不使用"系统空闲内存"这类不可靠指标
本文所有数字均为本机实测值,非估算或引用。