上周团队复盘一个内部 Agent 的账单,发现一个反直觉的结论:花的钱最多的,不是它写的那些文档,而是它一天做的那上万次小判断。
这条线索把我引到了一个 2026 年 9 月才出现的新品类------专用决策模型。这篇不谈概念,只谈工程:它到底省在哪、架构怎么切、什么时候不该用。
一、先把问题定义清楚:什么叫"判断"
在 Agent 里,"写"和"判断"是两件完全不同的事。
```python
这是"判断"(输出空间有限、可枚举)
route = decide(message) # 返回: {"billing": 0.92, "tech": 0.06, "other": 0.02}
这是"表达"(输出空间无限)
reply = generate(message) # 返回: 一段自由文本
```
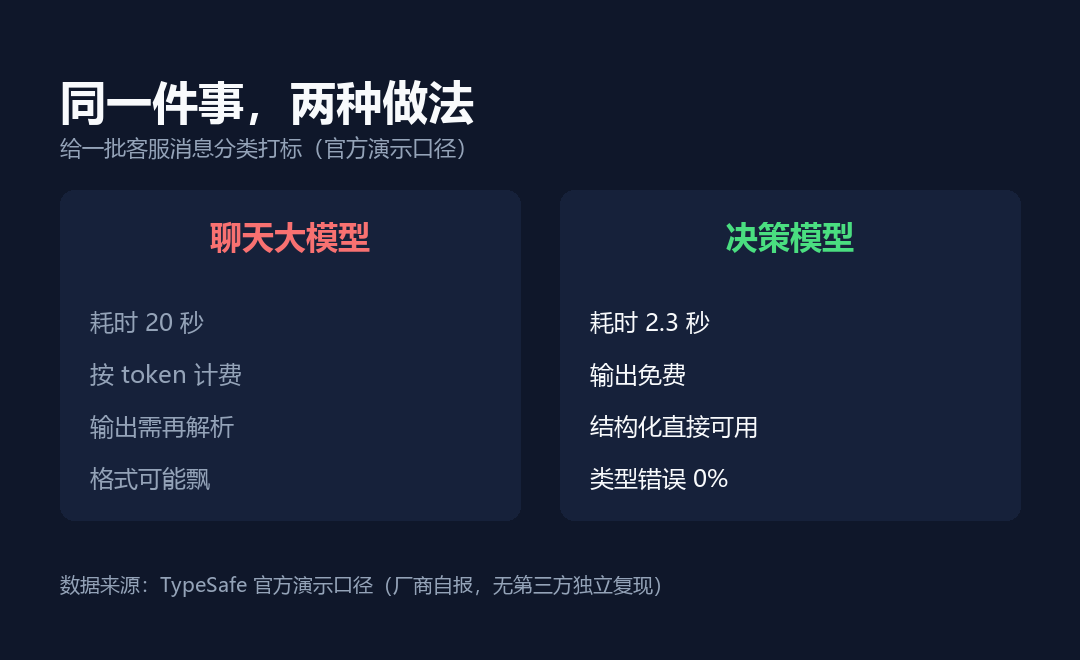
问题在于,过去我们用同一个工具干这两件事------都调通用大模型。于是"这条消息是不是投诉"这种只有两个答案的问题,也要走一轮完整的文本生成,然后从生成的散文里解析出结论。
代价是三重的:
-
延迟:以秒计,而不是毫秒;
-
成本:按生成 token 计费,而输出里真正有用的可能只有 3 个字符;
-
脆弱:解析依赖格式稳定,模型一"发挥",下游流程就断。
二、专用决策模型做了什么
2026-09-15,TypeSafe 发布 Jev,给出的答案是把这条路的后半段砍掉:
| 原语 | 签名 | 输出 |
|------|------|------|
| `noul` | 是/否问题 | `float` 概率(0--1) |
| `choice` | 从 ≤255 个选项里选 | `str` + 每项概率 |
| `score` | 在 2--10 级标尺打分 | `float` + 概率分布 |
关键设计是输出空间预先声明:
```json
{
"questions": {
"category": {
"type": "choice",
"instructions": "这条工单属于哪一类?",
"criteria": { "billing": "账单/退款", "tech": "技术故障", "other": "其他" }
}
}
}
```
因为答案只能落在你声明的空间里,所以类型错误在结构上不可能发生(官方称 0%,且明确说明"这不是实测值,是 schema 保证")。返回还带 `confidence`,用于校准决策阈值。
定价策略也顺着这个逻辑走:输入 $0.042/百万 token,输出免费。原因很简单------决策任务的输出本来就极短,按输出计费在商业上讲不通。
三、架构怎么切:三层
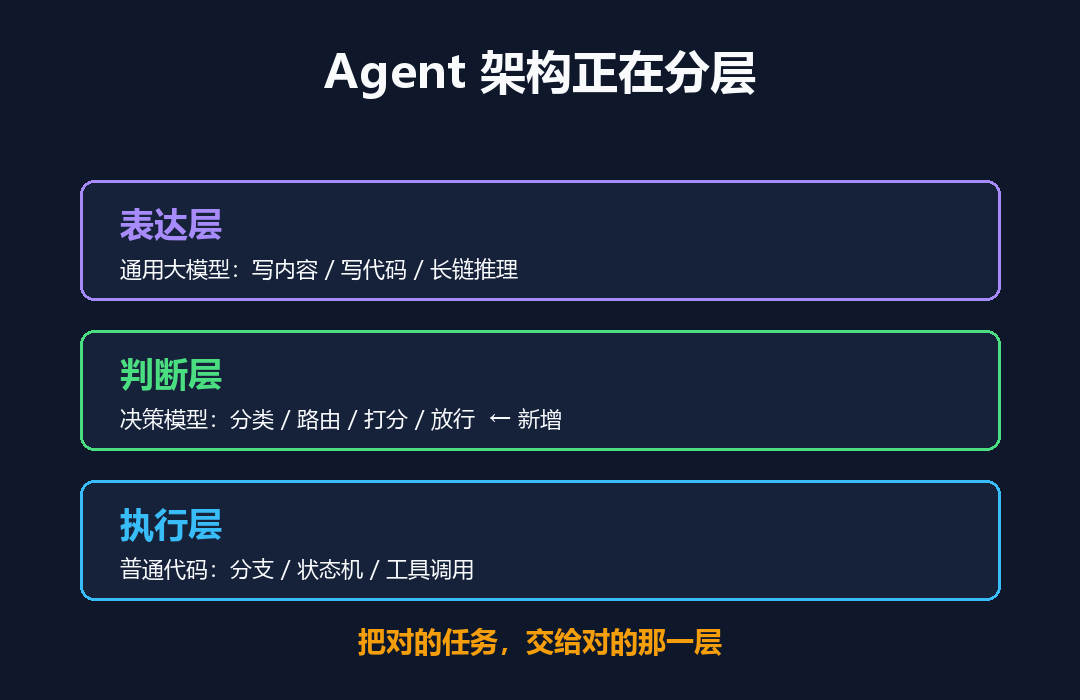
我的结论是,Agent 应该显式分成三层:
```
┌──────────────────────────────────────┐
│ 表达层 通用大模型 → 写内容 / 写代码 │
├──────────────────────────────────────┤
│ 判断层 决策模型 → 分类 / 路由 / 打分 │ ← 新增
├──────────────────────────────────────┤
│ 执行层 普通代码 → 分支 / 状态机 │
└──────────────────────────────────────┘
```
判断层的准入条件只有一个:答案能不能提前枚举。
- 能枚举 → 决策模型(快、便宜、结构稳)
- 不能枚举 → 大模型(比如"帮我写段产品文案")
成本模型要跟着改
不要再按"每百万 token 单价"比价,用单位任务成本:
```
单位任务成本 = 单价 × 平均调用轮次 × 成功率修正
```
举个例子:模型 A 单价便宜 50%,但要 3 轮调用才能做对;模型 B 单价高一些,一轮做对。算总账,B 更省。 决策模型的价值恰恰在于把"轮次"和"失败重试"这两项压到接近 0。
四、什么时候不该用
这是我最想强调的部分。决策模型不是万能药:
- 答案列不出来 → 用大模型。硬凑选项只会让准确率崩掉;
- 调用量很小 → 直接写 if/else 或调大模型更划算,不值得为它引入一套新依赖;
- 需要长链推理 → 决策模型只做"一次判断",不解决"多步规划";
- 需要保证判断正确 → 它保证的是结构正确 ,不是答案正确。置信度是参考,不是保证。
五、国内落地的现实路径
必须说清楚:Jev 没有对中国大陆开放,权重不开源,只能在它的 API 上调。 对数据不能出网的团队,这条路直接堵死。
现实做法是开源复现 + 本地部署 :用开源权重(如 Cloudflare 10-01 发布的 Clef/Clef-flash,Apache 2.0,且完全兼容 Jev 的 API 格式)在自己机房起一个决策服务,业务系统 HTTP 调用。值得一提的是,Cloudflare 直接抄了 Jev 的请求格式------这反而让 Jev 的接口成了这个品类的事实标准,切换成本因此变得很低。
六、一份落地自检
动手前,拿系统过五个问题:
-
这些判断能不能提前枚举所有答案?
-
一天发生多少次?(上万次才值得)
-
对延迟敏感吗?
-
现在的做法是不是"规则维护不动"或"大模型太贵太慢"?
-
数据能不能出网?
答对三个,就值得花半天做个验证:拿真实的 20--30 个任务,跑一遍完成率和总消耗,比看任何榜单都可靠。
三句话
判断不是写作,而是选择。
多轮试错的便宜,才是真的贵。
省钱的从来不是换个更便宜的模型,而是把对的任务交给对的那一层。
写在最后
大模型负责表达,决策模型负责判断------把作家从收发室的岗位上撤下来。
省钱的从来不是换个更便宜的模型,而是把对的任务交给对的那一层。
*这是《AI 成本账》系列第 4 篇。下一篇拆"Agent 的失败重试到底吃掉了多少预算",关注不迷路。*
*数据来源:TypeSafe Jev 官方发布(2026-09-15);Cloudflare Clef 发布(2026-10-01,Apache 2.0);葡萄城技术团队分析(博客园);Flavio Copes / Steve Kinney 技术解读;DataCamp、innFactory 第三方评述。所有性能与价格数字均为厂商自报口径,尚无大规模第三方独立复现。*