上一篇从成本公式切入,讲了「单位任务成本 = 单价 × 平均轮次 × 成功率修正」。这一篇只谈落地:当账单被重试吃掉时,工程上到底改哪几处代码。
一、先给重试定个性:它不是 bug,是架构缺口
很多人把重试当成「偶发异常」。但从度量角度看,重试是必然发生的:只要判断型任务用「生成再解析」的方式做,格式漂移就会触发下游解析失败;只要长任务没有状态落库,进程一重启就得从头再来。
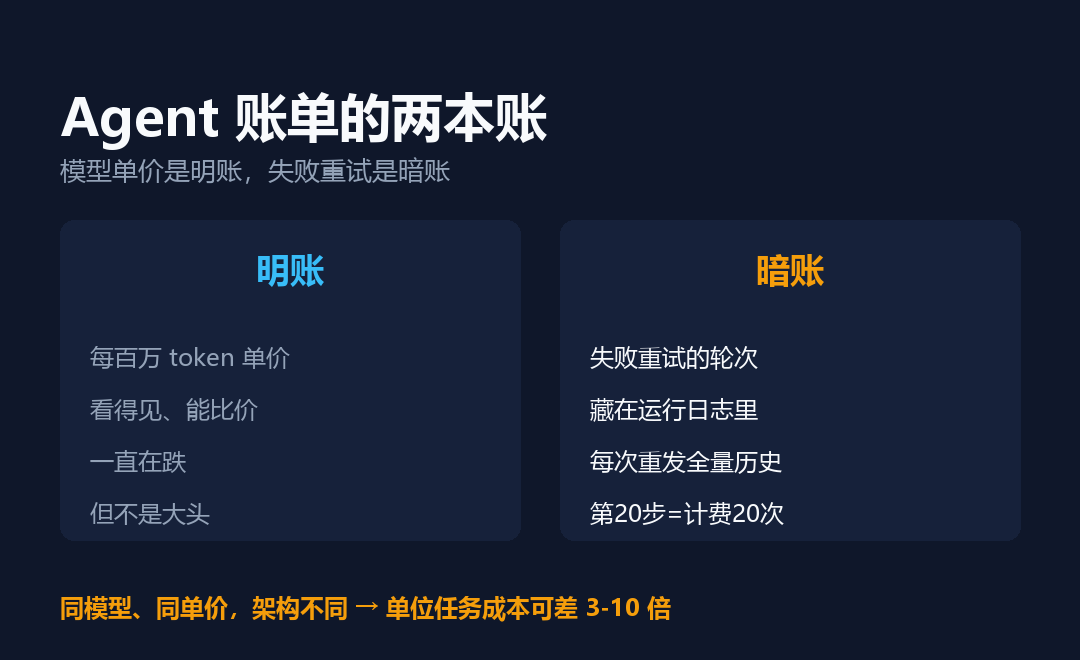
Splunk《The Hidden Cost of Agentic AI》(2026-06)给出的口径是:单个 Agent 任务的 token 消耗,是单次聊天调用的 5 到 30 倍 。同一份文档评估任务,单次结构化处理约 1.34 美元/轮,换成迭代式 Agent 后成本显著上升(MightyBot,2026-07)。
所以第一件事不是「修 bug」,而是承认:重试不是意外,而是架构没有兜住的那部分成本。
二、重放机制:为什么第 20 步那么贵
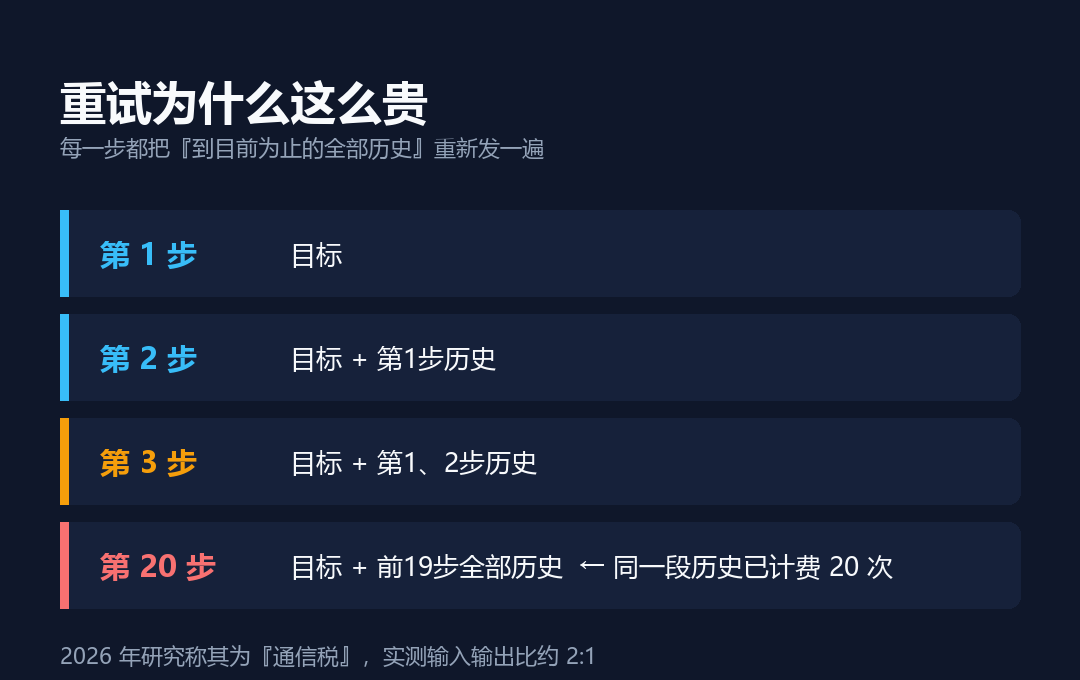
Agent 每步都会把「到目前为止的全部上下文」重新发给模型:
```
step 1: 目标 → 调用
step 2: 目标 + step1 全量历史 → 调用
step 3: 目标 + step1,2 全量历史 → 调用
...
step N: 目标 + step1..N-1 全量历史 → 调用
```
第 N 步的输入长度是 O(N),累计输入是 O(N²)。2026 年一项研究把这种开销称为**「通信税」(communication tax)** ,并测出约 2:1 的输入输出比 ------花出去的钱里,一大半在反复描述「已经发生过什么」。
重放是成本的非线性来源,也是工程上唯一值得动刀的地方。
你付的不是一次调用的钱,而是它失败几次的钱。
三、四类改法,按性价比排序
1. 幂等 + 断点续跑(最省钱,优先级最高)
把长任务拆成有状态的小步骤,每步落库;失败从断点续跑,而不是整段重来。这一条直接砍掉「重放历史」的轮次,是收益最大的改动。
```python
def run_step(state):
if state.done(step_id): # 幂等:已完成的步骤直接跳过
return state.result(step_id)
out = call_model(build_prompt(state, step_id))
state.save(step_id, out) # 落库,供续跑
return out
```
2. 结构化输出替代「生成再解析」
能枚举答案的判断,用 schema 约束输出,别让下游正则去猜自由文本。这会让「格式错误」这一类失败从根上消失。
```python
resp = client.chat.completions.create(
model="...",
response_format={"type": "json_schema", "json_schema": SCHEMA},
)
```
3. 上下文做减法
输入 token 是重试成本的主要载体。稳定前缀走 prompt caching,已完成步骤的细节折叠成摘要------压缩输入 = 直接降本。
4. 硬阈值熔断
给单任务设「最大轮次 / 最大花费」,超限直接停止并报警。看不见的花钱最危险,能熔断的成本才可控。
四、先埋三个点,再谈优化
优化之前得能看见。最小可用度量集只有三个数:
| 指标 | 口径 | 用途 |
|------|------|------|
| 平均轮次 | 单任务调用次数 / 任务数 | 直接乘进成本公式 |
| 一次通过率 | 首轮即成功的任务占比 | 定位高重试环节 |
| 输入输出比 | 输入 token / 输出 token | 判断「重放」有多严重 |
把这三个数按任务类型 拆开统计,重试成本会自己浮出来。微软 2026-10-09 发布的 AX Practitioner Playbook 也强调了同一件事的进阶版:「读数告诉你什么坏了,轨迹才告诉你为什么坏」------即从「失败计数」升级到「轨迹归因」,其配套方法对 Azure Cosmos DB Agent Kit 产出了 46 项改进。
五、一张落地清单
-
每一步是否把全部历史重发?→ 改增量/摘要。
-
有没有幂等 + 断点续跑?→ 没有就加状态落库。
-
判断型任务用结构化输出还是生成再解析?→ 前者。
-
有没有最大轮次/花费阈值?→ 加熔断。
-
知不知道自己的平均轮次 与一次通过率?→ 埋点。
五问里三个答不上来,账单里大概率有一块看不见的重试成本。
写在最后
单价是明账,重试是暗账。 降单价靠换模型,降总账靠改结构------省钱靠的不是换更便宜的模型,而是改结构,而结构恰好是工程侧最可控的部分。
*数据来源:Splunk《The Hidden Cost of Agentic AI》(2026-06);MightyBot《Token Economics of AI Agents in 2026》(引用 2026-07 实测);Microsoft《Introducing the Agent Experience (AX) Practitioner Playbook》(2026-10-09);Concordia University 2026「通信税」研究。金额与倍数均为公开口径,未经独立复现。*