目录
- 前言
- 一、问题定义:三个误区,让十七篇永远拼不成一张图
- [二、核心方案:三层图 + 一个按「检索方式」摆的坐标系](#二、核心方案:三层图 + 一个按「检索方式」摆的坐标系)
-
- [2.1 三个反直觉判断(全篇灵魂)](#2.1 三个反直觉判断(全篇灵魂))
- [2.2 地图数据:每一格是数据,不是一段文字](#2.2 地图数据:每一格是数据,不是一段文字)
- [2.3 三层图怎么用:从一句抱怨,到一段代码](#2.3 三层图怎么用:从一句抱怨,到一段代码)
- [2.4 成熟度:只引用开篇的四套递进,不另立新档](#2.4 成熟度:只引用开篇的四套递进,不另立新档)
- 三、代码实战:一个纯标准库的全息地图导航器
-
- [3.1 地图是数据:十八篇一格,一篇一句决策](#3.1 地图是数据:十八篇一格,一篇一句决策)
- [3.2 拿处境一查:症状表是入口,主篇+关联篇一起给](#3.2 拿处境一查:症状表是入口,主篇+关联篇一起给)
- [3.3 打勾查缺口:症状轴管不到的那一半](#3.3 打勾查缺口:症状轴管不到的那一半)
- [3.4 图不许悬空:把纪律落成一个函数](#3.4 图不许悬空:把纪律落成一个函数)
- 四、踩坑记录:三个"元坑"
- 五、选型对比:把一堆知识编成"可查的东西",三种做法
-
- [5.1 十八篇全息索引(副表,地图数据本体)](#5.1 十八篇全息索引(副表,地图数据本体))
- [5.2 「你系统缺哪块」自检 10 问](#5.2 「你系统缺哪块」自检 10 问)
- [六、总结 + 专栏闭环 + 留给读者的下一程](#六、总结 + 专栏闭环 + 留给读者的下一程)
- [附录 A:十八篇全息索引(含来源全称)](#附录 A:十八篇全息索引(含来源全称))
- [附录 B:症状 → 主篇 → 关联篇完整表](#附录 B:症状 → 主篇 → 关联篇完整表)
- [附录 C:四大支柱 × 系统阶段 骨架网格](#附录 C:四大支柱 × 系统阶段 骨架网格)
- [附录 D:导航器算法说明](#附录 D:导航器算法说明)
前言
上一篇《金融级 AI 落地》我结尾留了一句话:"金融级那一层判据一个不新造,全是前面立过的;可你手里那堆零件,还缺一张总图。"今天来还这笔账------这也是大模型工程化这个专栏的收官篇:不谈新东西,只回答一句"遇到这个,该看哪篇"。
先讲个让我语塞的事。前阵子一个做技术负责人的朋友,微信上甩来一个问题:"系统上线半年,最近用户投诉变多了,我该先动哪一块?"我手里握着十七篇,每一篇都站得住,可盯着这句话,一时答不利索------投诉变多,是幻觉多、是检索烂,还是成本把某条链悄悄降级了?我脑子里十七篇同时在闪,哪篇都对,就是拼不成一句"先看哪篇、抓这个决策、抄那段代码"。
那一刻我想通了:这十七篇缺的不是内容,是一张图。大模型工程化 走到落地,最难的一步从来不是"会不会",而是"遇到这个,该看哪篇"。
一、问题定义:三个误区,让十七篇永远拼不成一张图
我复盘了自己和身边人用这个专栏的方式,三个误区,一个比一个耽误事。
误区一:把专栏当线性教程,从头读到尾。 我一开始也是这么想的------按顺序读最踏实。可现实是:你不是"从零开始学",你是"手里有一套系统、卡在某处"。线性读法的问题是,它按我的写作顺序排,不按你的处境排;读到第 8 篇时你早忘了第 2 篇的判据长什么样,等真出问题,脑子里是一团糊,不是一张图。
误区二:收藏夹吃灰。 十七篇点过收藏、存过书签,然后呢?真要查的时候,是在收藏夹里从头翻------把"检索"退化成"翻找"。一篇篇都对,可它们之间那些"遇到 A 就看 B"的连线,一篇正文里从来没有画出来过。
误区三:每篇都读懂了,就是拼不起来。 这是最隐蔽、也最普遍的。单看第 8 篇 Trace,你懂了;单看第 2 篇评测,你也懂了。可"幻觉变多"这四个字进来,你并不知道它该先去第 8 篇定位根因、再回第 2 篇看评测报没报警。单篇成立 ≠ 十七篇能拼------中间缺的是那张把处境和篇目连起来的检索图。
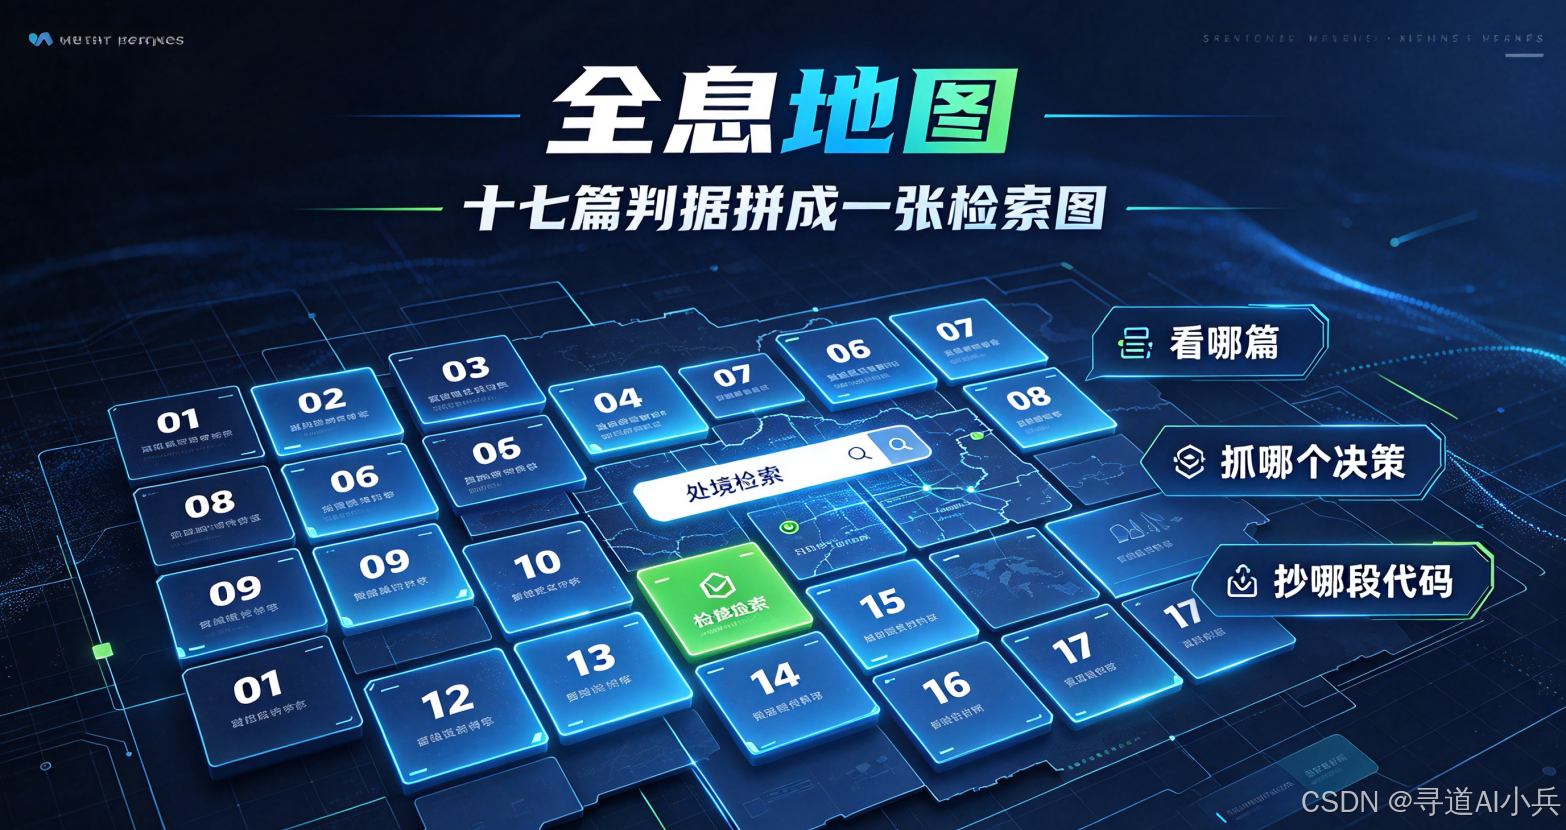
先把结论撂这儿:收官要做的不是"把十七篇再讲一遍",是编一张图------输入一句大实话处境("幻觉变多""成本月月涨""不敢发版"),直接吐出「看哪篇 + 抓哪个决策 + 抄哪段代码」;而且这张图自己不悬空:每条索引指向的那篇、那段代码,都真实在册。 落点是一个纯标准库、离线可跑、可断言的"全息地图导航器"。
二、核心方案:三层图 + 一个按「检索方式」摆的坐标系
整篇的主线就一句:前面十七篇造了十七套零件,开篇《四大支柱》给了一副骨架------这一篇把零件合回骨架,再叠一个"拿处境一查"的检索入口。它不挖新题,只把已经成立的东西编成一张能查、能自证的图。
三层图共用同一份地图数据,这是它和"十七篇串讲"最大的不同:同一份数据,换个入口渲染三次,不是三篇各写各的作文。
bash
全息地图(一层数据、三种用法)
│
├─ ① 骨架网格(宏观定位图)        ------ 给架构层/决策层看「全貌长什么样、十七篇各在哪」
│     横轴 = 关注面(质量保障 / 运行时韧性 / 可观测 / 持续进化 / 底座 / 专题 / 行业)
│     纵轴 = 系统阶段(建设 → 上线 → 运行 → 进化)
│     每一格 = 一篇(一句核心决策 + 一个代码落点)
│
├─ ② 症状检索(症状检索图)        ------ 给执行层/新人查「遇到这个,看哪篇」(核心问题的正面答案)
│     输入:一句大实话处境("幻觉变多"/"成本月月涨"/"不敢发版")
│     输出:主篇 + 关联篇 + 核心决策 + 代码落点
│
└─ ③ 覆盖度自查(你的系统作战图)  ------ 补症状轴覆盖不到的「能力空白」
      输入:拿系统现状对自检 10 问逐格打勾(yes/no)
      输出:缺口 + 该回哪篇补 + 严重度
坐标系为什么不按「写作顺序」、按「检索方式」摆? 这是我第一版翻车的直接教训(见踩坑①)。按写作顺序排出来的东西,本质是一张目录------它回答"第 5 篇讲了啥",不回答"我该怎么办"。读者查图时手里攥的是一句抱怨,不是一个篇号。所以图的横纵轴必须是读者能对号入座的两样东西:"我卡在系统的哪一段"(阶段)和"这是哪一类问题"(关注面)。线性的目录换成二维的坐标,图才查得动。
2.1 三个反直觉判断(全篇灵魂)
这三个判断是我编这张图时反复撞墙撞出来的,也是它区别于"合集/大全集"的地方:
判断一:收官的第一性是「能查到」,不是「讲全」。 我一开始想"把十七篇的精华都塞进图里",结果图越编越厚、越厚越查不动。后来翻过来------一篇只占一个主格 + 一句核心决策,细节一律回原篇。全集查不动,不如索引查得动。
判断二:地图会烂。 工具会换、评测框架会升级、监管口径会变,任何一张"写死结论"的图,三个月后都在骗人。所以只焊结构(处境→篇→决策→落点这条链),细节标复核日期,不编死数字。图烂了,改数据就行,导航逻辑一行不动------这也是我把它落成一个数据结构、而不是一段文字的根本原因。
判断三:图不能悬空。 索引指向空处,比没索引更坏------读者照着抄,会一头撞进空里。这一条我对自己最狠:我过去有几篇自己的落点就是悬空的(踩坑③会当场摊开),所以这条纪律不是要求你,是要求我。
2.2 地图数据:每一格是数据,不是一段文字
这是整张图存在的前提------把"一篇"拆成可查询的字段。每个字段的"为什么"都写进 docstring:
python
@dataclass
class MapEntry:
    """地图上的一格 = 一篇的检索卡(不是一段介绍)。
    一篇只留"一句核心决策 + 一个落点",别的不写------这是"收敛 > 全面"的落点。
    """
    seq: str            # 篇序号("00".."17")------图上引用一律写全称,不用内部编号
    title: str          # 主题
    area: str           # 关注面(存全称,如"支柱三·全链路可观测(3.2 Trace)";展示用 _short_area 去括号细则)
    stage: str          # 系统阶段:建设 → 上线 → 运行 → 进化(开篇记"总纲")
    decision: str       # 一句核心决策(原文原句,不重述、不扩写)
    code_landing: str   # 代码落点(有 demo / 代码嵌于正文 / 无 demo 之一,绝不是随便一个路径)
    symptoms: list[str] # 关联症状标签:这个处境,会查到我
    source: str         # 依据来源:写全「第 N 篇《主题》」
这里最吃劲的是 code_landing 那一个字段。它只取三种值之一------有 demo、代码嵌于正文、无 demo,绝不允许编一个假路径填进去。你只需要知道这一篇的代码到底怎么抄:
- 有 demo(文章里有完整能跑的 demo,可直接抄):第 5--17 篇;
- 代码嵌于正文(没有独立 demo,代码以片段形式嵌在正文里):第 1、2、3、4、11 篇;
- 无 demo(开篇总纲)(开篇本来就是总纲,没有代码):开篇。
为什么这个字段要这么较真?因为整张图的价值全在"指向实处"。一个落点填错,读者抄代码就抄到空处,前面十七篇的信任一次赔光。所以这条纪律不能靠自觉,得焊进代码------落成 check_references()(见 3.4)。
2.3 三层图怎么用:从一句抱怨,到一段代码
把三层接起来看一遍就清楚了。假设你现在手里就攥着那句"用户投诉变多了":
- 第 1 步,进症状检索(第②层)。 把"幻觉变多""RAG 正确率一个月比一个月差"这类症状各查一遍,图告诉你:幻觉这条,主篇是第 8 篇《OTel + LangFuse 全链路 Trace》(先要有 Trace,才定位得了根因到底是知识库、检索、路由还是模型),关联第 2 篇《Golden Set + CI 评测》和第 11 篇《知识库防腐坏》。一句话症状,直接落到篇。
- 第 2 步,抓主篇的核心决策。 第 8 篇那句"可观测不是加监控面板,是把每个裁决点变成结构化 span、用 trace_id 串成链------工具是最后一步,不是第一步",就是你这一步要抓的决策;要不要抄它那段代码、抄哪段,回原篇看细节。图只给入口,不替你走完。
- 第 3 步,回覆盖度自查(第③层)确认根子。 症状轴只回答了"有征兆了看哪篇",它答不了"你根本没有这个能力"。所以还得拿自检 10 问(评测集 / 自动对基线 / 灰度熔断 / Prompt 版本化 / 网关 / 护栏 / 强约束 / Trace / 成本账本 / 反馈闭环+知识库巡检)逐格打勾------如果"Trace"这一格本来就是空的,那第 1 步指到第 8 篇,其实是在指一个你还没建的底座。
顺序很重要:先症状定位"看哪篇",再自查确认"补哪块",最后回原篇抄代码。 跳过自查,你会拿着第 8 篇的 Trace 方案,却不知道自己连评测集都没有------根子比这更靠前、更基础。这也是三层图不能只留一层的理由:症状检索管"眼前这一下",覆盖度自查管"有没有底子"。
2.4 成熟度:只引用开篇的四套递进,不另立新档
收官篇最容易犯的错,是"为了收得漂亮",自己新造一套统一的成熟度分档。我不造。开篇《四大支柱》的总览速查表里,成熟度是按支柱各给五档递进的,一共四套,没有一套放之四海皆准的统一措辞:
| 支柱 | 成熟度自评(L1→L5,引自开篇《四大支柱》速查表) |
|---|---|
| 质量保障支柱 | L1 无评测 → L2 有评测集 → L3 CI 自动化 → L4 灰度+熔断 → L5 全自动飞轮 |
| 运行时韧性支柱 | L1 直连 API → L2 单模型封装 → L3 多模型路由 → L4 多层安全护栏 → L5 全自动容灾自愈 |
| 全链路可观测支柱 | L1 无监控 → L2 基础延迟/QPS → L3 全链路 Trace → L4 成本分拆 → L5 告警自愈自动化 |
| 持续进化支柱 | L1 无反馈 → L2 人工收集反馈 → L3 自动沉淀样本 → L4 离线评测闭环 → L5 在线质量飞轮 |
这张表怎么用?覆盖度自查里,你对着自检 10 问打勾的同时,顺手看一眼"我大概在哪个支柱的哪一档"。别把四套硬拼成一套------质量保障的 L4 是"灰度+熔断",可观测的 L4 是"成本分拆",它们本来就不是一把尺子。我把这套原样引用、不重命名------图要的是能查到,不是显得体系化。
三、代码实战:一个纯标准库的全息地图导航器
"拿处境一查就指到实处、且图自己不悬空"正是本篇区别于"十七篇串讲"的唯一硬落点。所以这一篇的落点是一个离线可跑、纯标准库、无 API key、无第三方依赖的导航器:把地图编码成数据,跑通"输入处境 → 命中主篇+关联篇 → 给核心决策+落点;对现状打勾 → 报缺口;核引用 → 报悬空"。一篇串讲不用跑也能看,一张能查、能自证的图不跑就不知道查不查得到、指得准不准。
文件就两个:
yml
holomap/
├── mini_holomap.py        # 主代码:MapEntry/Symptom/NavResult/CoverageReport
│                          #         + load_map/load_symptoms/load_registry
│                          #         + locate/coverage_gaps/check_references
│                          #         + explain_entry/render_map/build_demo(纯标准库,离线可跑)
└── test_mini_holomap.py   # 9 个断言,锁"症状一换指向就换 / 主篇+关联篇 / 缺能力定位到篇 /
                           #   引用不悬空 / 每条带决策+落点 / 引用写全称 / 十八篇不漏 /
                           #   地图是数据一改就变 / 无匹配老实报"
正文只贴关键节选、为便于阅读对 docstring 做了略精简、对函数体做了少量省略。没露面的辅助函数 ------_short_area(去掉关注面括号细则)、_print_nav(打印一次检索结果)、render_map(渲染骨架网格)------都在 holomap/mini_holomap.py 里。别照抄正文片段去拼,直接跑整个文件 (cd holomap && python mini_holomap.py)。
3.1 地图是数据:十八篇一格,一篇一句决策
python
def load_map() -> list[MapEntry]:
    """十八篇地图数据------每篇一格,title/decision/area/code_landing/source 逐字取自研究素材第一节的十八篇索引表。"""
    return [
        MapEntry(
            seq="08", title="OTel + LangFuse 全链路 Trace",
            area="支柱三·全链路可观测(3.2 Trace)", stage="运行",
            decision='可观测不是"加监控面板",是把每个裁决点变成结构化 span 事件、用 trace_id 串成链------工具是最后一步,不是第一步。',
            code_landing="有 demo",
            symptoms=["幻觉变多找不到根因", "人肉拼日志"],
            source="第 8 篇《OTel + LangFuse 全链路 Trace》",
        ),
        # ...... 00 到 17,十八篇一格,一行不少
    ]
注意第 8 篇的落点写的是"有 demo"------它真实有段能跑、能抄的 demo,就如实记"有 demo"。地图是照镜子,不是画饼;磁盘上是什么就写什么,绝不为了好看编一个更唬人的落点。
3.2 拿处境一查:症状表是入口,主篇+关联篇一起给
python
def locate(scenario, symptoms, entries=None) -> NavResult:
    """按症状检索:输入一句大实话处境,出「主篇 + 关联篇 + 核心决策 + 代码落点」。

    为什么匹配不到时返回带 note 的空结果、不硬塞最近的一篇:
    图的本事在收、在准,不在"什么都能接住"。把"这条我图上没有"老实说出来,
    比塞给读者一篇不相干的更负责------这也是"图不许悬空"的镜像:不许指向空处,也不许硬指。
    """
    text = (scenario or "").strip()
    hit = None
    for s in symptoms:              # 三级匹配:先精确,再"症状是查询子串",最后才模糊片段------短查询不抢跑
        if text == s.text:
            hit = s
            break
    # ......(后两级包含匹配略,全量见 holomap/mini_holomap.py)
    if hit is None:
        return NavResult(scenario=scenario, primary=None, related=[], entries=[],
                         note=f"「{scenario}」在十八篇里查不到对应症状------可能超出本专栏范围,不硬塞。")
    m = {e.seq: e for e in (entries if entries is not None else load_map())}
    primary = m.get(hit.primary_seq)
    related = [m[s] for s in hit.related_seqs if s in m]
    return NavResult(scenario=scenario, primary=primary, related=related,
                     entries=([primary] if primary else []) + related, note=...)
症状表本身也是数据,一行一条:
python
def load_symptoms() -> list[Symptom]:
    return [
        Symptom("幻觉变多", "08", ["02", "11"]),      # 主篇第 8 篇,关联第 2、11 篇
        Symptom("成本月月涨", "09", ["05", "07"]),
        Symptom("不敢发版", "03", ["02", "04"]),
        # ......
    ]
"一个症状命中主篇 + 关联篇",不是装饰。 "幻觉变多"的主篇是第 8 篇 Trace------先有 Trace 才定位得了根因;可根因往往就藏在第 2 篇的评测报警或第 11 篇的知识库腐坏里。只给一篇,等于替读者把路走窄了。
3.3 打勾查缺口:症状轴管不到的那一半
python
COVERAGE_ITEMS = (
    ("评测集", ("02",)), ("自动对基线", ("02",)), ("灰度熔断", ("03",)),
    ("Prompt 版本化", ("04",)), ("网关", ("05",)), ("护栏", ("06",)),
    ("强约束", ("07",)), ("Trace", ("08",)), ("成本账本", ("09",)),
    ("反馈闭环+知识库巡检", ("10", "11")),        # 一个能力项,可以指多篇
)

def coverage_gaps(landscape: dict[str, bool]) -> CoverageReport:
    """拿系统现状逐格打勾,报缺口 + 该回哪篇补。缺键按"没有"处理。"""
    m = {e.seq: e for e in load_map()}
    missing, suggested = [], []
    for name, seqs in COVERAGE_ITEMS:
        if not landscape.get(name, False):
            missing.append(name)
            for s in seqs:
                if s in m and s not in suggested:
                    suggested.append(s)
    return CoverageReport(missing=missing, suggested_seqs=suggested, summary=...)
3.4 图不许悬空:把纪律落成一个函数
整篇最该抄走的一段。落点的三种合法取值焊进 check_references(),任何指向空处的落点当场报错:
python
# 没有独立 demo 的两个显式标记------它们是"合法标记",不是路径,绝不当悬空处理;
# 但这个词绝不能长得像一个路径,否则就成了"假装有落点"。
NO_CODE_MARKERS = {"代码嵌于正文", "无 demo(开篇总纲)"}

# 有独立 demo 的落点------就"有 demo"一种;不写"成品/散件"或仓库路径,
# 因为读者要的是"能不能直接抄",不是"作者磁盘上整理成什么样"。
LANDING_STATES = {"有 demo"}

def check_references(entries, registry) -> list[str]:
    """引用完整性核对:图上每条索引指向的篇、指向的落点,都必须真实在册。
    返回问题清单,空列表 = 图干净、不悬空。
    """
    problems = []
    seqs = {e.seq for e in entries}
    for i in range(18):                                    # 完整性:十八篇一篇不能漏
        if f"{i:02d}" not in seqs:
            problems.append(f"缺篇:第 {i} 篇不在图里------覆盖十八篇的完整性核对失败")
    for e in entries:
        if e.source not in registry:
            problems.append(f"{e.seq}: 来源引用[{e.source}]不在册------是否写全「第 N 篇《主题》」?")
        if e.code_landing not in registry:
            problems.append(f"{e.seq}: 代码落点[{e.code_landing}]不在册------悬空引用(落点不是「有 demo / 代码嵌于正文 / 无 demo」)")
    return problems
跑一遍 demo,六条确定性结论就都出来了:
bash
$ cd holomap && python mini_holomap.py
# [场景 1] 换一句症状 -> 指向就换
#   处境「幻觉变多」  → 主篇:第 8 篇《OTel + LangFuse 全链路 Trace》
#   处境「成本月月涨」→ 主篇:第 9 篇《Token 成本六维优化》
# [场景 3] 缺某块能力 -> 覆盖度自查定位到对应篇
#   自检 10 问,缺 2 项:评测集、Trace------按最短的那块板,回第 2 篇《Golden Set + CI 评测》、第 8 篇补。
# [场景 4] 图不许悬空:引用一改,check_references 立刻报悬空
#   修正后的图:干净、无悬空
#   把第 3 篇的落点改成一个「假路径」后:
#   · 03: 代码落点[假路径]不在册------悬空引用(落点不是「有 demo / 代码嵌于正文 / 无 demo」)
# [场景 5] 无匹配处境老实报「可能超出本专栏范围」,不硬塞
#   处境「怎么给猫铲屎」→ 「怎么给猫铲屎」在十八篇里查不到对应症状------可能超出本专栏范围。
场景 4 那条悬空不是编的,就是我自己的老账------先拿自己开刀。这就是下面要摊开讲的第三个坑。
四、踩坑记录:三个"元坑"
前面十七篇踩的是技术坑,这一篇踩的是"编图"本身的坑------我管它叫元坑,因为它们错的是方法,不是某行代码。
坑一:第一版按写作顺序排成表,结果是目录,不是图。 我第一版很顺手:从第 1 篇排到第 17 篇,每篇配一句摘要、一个链接。做完自我感觉良好,拿给一个新人看,他问了我一句:"我现在卡在'成本月月涨',从哪一行开始看?"我愣住了------他得从第 1 行扫到第 17 行。按我的写作顺序排,是目录;按你的检索方式排,才是图。 修复很直接:把表推倒,改成"症状(读者嘴里的话)→ 篇 → 决策"的检索结构,篇号退到后面当属性。
坑二:第二版网格切太细,切成迷宫。 发现要能查之后,我一激动把关注面切成了十几格、阶段切成五层,横纵一乘,几十个格子,每一格还塞进三四个解释。结果比目录还难用------图的本事在收,不在放。 一篇只占一个主格 + 一句核心决策,其余回原篇。删到最后,横轴 7 个关注面、纵轴 4 个阶段,一篇一格,一屏看得完,图才活了。
坑三(第一手证据,先拿自己开刀):我过去几篇的落点,自己就是悬空的。 这是"图不许悬空"这条纪律的由来,我不美化。复盘时我把自己前十七篇的落点逐条对了一遍磁盘,四处对不上,原文照录:
| 篇 | 正文声称的落点 | 磁盘实际 | 判定 |
|---|---|---|---|
| 第 2 篇《Golden Set + CI 评测》 | 有成套评测 demo(评测脚本 + 黄金集 + CI 门禁) | 什么都没有 | 悬空(demo 实为嵌于正文) |
| 第 3 篇《灰度发布 + 自动熔断》 | 有 4 个文件的成品 demo(熔断器 / 影子对比 / 灰度配置 / 测试) | 什么都没有 | 悬空(正文写成品,实为嵌于正文) |
| 第 4 篇《Prompt 即代码(版本管理)》 | 有成品的版本管理 demo + 测试 | 什么都没有 | 悬空(正文自认嵌于正文,与成品声明冲突) |
| 第 11 篇《知识库防腐坏》 | 有成品 demo | 什么都没有 | 悬空(文件缺失,demo 实为嵌于正文) |
根因 :早期几篇写作时,我在正文里"描述"了一套理想的工程结构(成套评测、成品 demo 这些),但它们从没真正落盘------demo 就嵌在文章里。正文声称的落点,和我磁盘上真实有的东西,是两回事,我当时没意识到这中间有条沟。
修复 :① 地图上这四篇如实记成"代码嵌于正文"------demo 就嵌在正文里,不编一个看起来像路径的假落点;② 把这条纪律落成 check_references()------以后任何一篇落点填错,跑一遍就报悬空。我先拿自己开刀,再说"图不许悬空"------自己墙上有裂缝,才有资格要求你把索引钉牢。
五、选型对比:把一堆知识编成"可查的东西",三种做法
编这张图之前,我认真比过三种做法。结论是:按处境的检索图是唯一能同时满足"能查、能对账、能自证"的做法。
| 维度 | ① 按写作顺序的目录 | ② 全文搜索 | ③ 按处境的检索图(本篇 demo) |
|---|---|---|---|
| 组织的维度 | 时间(第几篇) | 关键字 | 处境 × 关注面 × 阶段 |
| 能不能按处境查 | 不能,得自己扫 | 能,但靠关键词命中,召回看用词 | 能,一句大实话症状直接落篇 |
| 结论能不能对到依据 | 能,但得自己翻 | 不能,搜出的是零散段落 | 能,每条带核心决策 + 出处全称 |
| 覆盖不覆盖缺口 | 不覆盖 | 不覆盖 | 覆盖,覆盖度自查补"能力空白" |
| 指向空处怎么办 | 无规范,易出现死链 | 无索引,谈不上悬空 | check_references() 当场报悬空 |
| 时效性 | 改一篇正文即全乱 | 随正文走 | 只改数据,导航逻辑不动 |
| 推荐指数 | ★★☆(当目录用) | ★★☆(当临时查词用) | ★★★★★(当检索入口用) |
一句人话:只有检索图回答"我现在遇到这个,该看哪篇、抓哪个决策、抄哪段代码"------这正好是十七篇从没回答过的那个问题。
5.1 十八篇全息索引(副表,地图数据本体)
这是整张图的数据本体,十八篇一篇不少。"代码落点"列按三种取值如实写,来源全称见附录 A(正文表不重复列来源):
| 篇 | 主题 | 关注面 | 阶段 | 核心决策(一句) | 代码落点 | 关联症状 |
|---|---|---|---|---|---|---|
| 00 | 四大支柱(开篇) | 开篇(总纲) | 总纲 | 算法定义 AI 的能力天花板,工程化守住 AI 的商用生命线。 | 无 demo(开篇总纲) | 不知道从哪下手看起 |
| 01 | 概率坍塌·给LLM输出加锁 | 支柱二·运行时韧性 | 运行 | 不求模型次次对,只求契约次次立。 | 代码嵌于正文 | 模型输出解析失败 |
| 02 | Golden Set + CI 评测 | 支柱一·质量保障 | 建设 | 格式靠代码锁,内容靠评测兜;评测不是打分,是报警。 | 代码嵌于正文 | 线上效果比评测差一截 |
| 03 | 灰度发布 + 自动熔断 | 支柱一·质量保障 | 上线 | "上线"从赌一次运气,变成有护栏、能自动回滚的过程。 | 代码嵌于正文 | 不敢发版 |
| 04 | Prompt 即代码(版本管理) | 支柱一·质量保障 | 建设 | 哈希是身份、回滚是新增、模板要纯净、路由在网关。 | 代码嵌于正文 | 回滚找不到版本 |
| 05 | LLM 网关选型 | 支柱二·运行时韧性 | 建设 | 网关不是"多一层代理",是运行时韧性的统一入口。 | 有 demo | key 散在多个环境变量 |
| 06 | OWASP 安全护栏 | 支柱二·运行时韧性 | 运行 | 安全不是写给模型看的,是挂在链路两端的代码。 | 有 demo | 敏感信息被念出来 |
| 07 | JSON Schema 强约束 | 支柱二·运行时韧性 | 运行 | 格式对不对和泄露不泄露一样,是代码闸的事。 | 有 demo | 模型吐的 JSON 不合规 |
| 08 | OTel + LangFuse 全链路 Trace | 支柱三·全链路可观测 | 运行 | 可观测是把每个裁决点变成结构化 span 事件、用 trace_id 串成链。 | 有 demo | 幻觉变多找不到根因 |
| 09 | Token 成本六维优化 | 支柱三·全链路可观测 | 运行 | 省钱第一步不是省,是建账本。 | 有 demo | 成本月月涨 |
| 10 | Human-in-the-Loop 反馈闭环 | 支柱四·持续进化 | 进化 | 回流三步少一步,就是投毒。 | 有 demo | 评测越评越高线上越差 |
| 11 | 知识库防腐坏 | 支柱四·持续进化 | 进化 | 快照/切库/回归门全是"换版本 + 可回滚",不是原地 UPDATE。 | 代码嵌于正文 | RAG 正确率逐月下滑 |
| 12 | 数据工程底座 | 底座 | 建设 | 版本/血缘/权限三张表,生产换数据、逻辑一行不改。 | 有 demo | 补一份文档半天没了 |
| 13 | LLMOps 不完全指南 | 底座 | 建设 | LLMOps 管的不是模型,是"一次可信发布的完整身份"。 | 有 demo | 回滚不知回哪版 |
| 14 | Multi-Agent 协作实战 | 专题 | 建设 | 多 Agent 管的不是节点,是边。 | 有 demo | 多 Agent 上线就翻车 |
| 15 | 开源工具箱 30+ 选型地图 | 专题 | 建设 | 选型地图不是工具清单,是"我处在这个处境该看哪几个"的查询。 | 有 demo | 工具选不出来 |
| 16 | 政企国产化避坑 | 行业 | 上线 | 政企国产化的坑八成不是技术坑,选型是道准入题。 | 有 demo | 政企过不了验收 |
| 17 | 金融级 AI 落地 | 行业 | 运行 | 金融级 AI 的第一性不是"跑得动",是"能举证"。 | 有 demo | 监管来函要复现一笔决策 |
5.2 「你系统缺哪块」自检 10 问
拿系统现状逐格打勾,缺哪格就回哪篇补------这是 coverage_gaps() 的检查项:
- 有没有一套分层评测集(Golden Set)?------没有回第 2 篇《Golden Set + CI 评测》。
- 评测有没有 CI 化、改了就自动对基线?------没有回第 2 篇《Golden Set + CI 评测》。
- 发版有没有灰度 + 自动熔断?------没有回第 3 篇《灰度发布 + 自动熔断》。
- Prompt 有没有做版本化、可 diff、可回滚?------没有回第 4 篇《Prompt 即代码(版本管理)》。
- 有没有统一网关、key 不散落?------没有回第 5 篇《LLM 网关选型》。
- 有没有安全护栏、挂两端?------没有回第 6 篇《OWASP 安全护栏》。
- 有没有 JSON Schema 强约束这道代码闸?------没有回第 7 篇《JSON Schema 强约束》。
- 有没有全链路 Trace、trace_id 串成链?------没有回第 8 篇《OTel + LangFuse 全链路 Trace》。
- 有没有 token 账本、成本可分拆?------没有回第 9 篇《Token 成本六维优化》。
- 反馈有没有闭环、知识库有没有巡检?------没有回第 10 篇《Human-in-the-Loop 反馈闭环》和第 11 篇《知识库防腐坏》。
补最短的那块板------不是把十问全打勾,是先把最要命的那一格补上。
六、总结 + 专栏闭环 + 留给读者的下一程
十七篇造零件,这一篇把零件合回开篇那副骨架,再叠一个"拿处境一查"的入口------图不是第十七篇的续、也不靠新题撑场,它是这十八篇的另一种读法:遇到这个,看那篇。 收官篇没有"下一篇预告",因为它就是终点;但它给你留了三条起步线:
- 今天就动手 :拿自检 10 问给自己系统逐格打勾,补最短的那块板,别贪多。
- 每年复核一次 :地图会烂------工具、框架、口径都在变;结构不用动,把
code_landing、复核日期和结论重新核一遍。 - 格子补透了,回来聊:哪一格你补通了、或者发现图上少了一条该有的线,欢迎回来告诉我------这张图的下一版,靠的是用过它的人。
专栏写到这儿收尾。往后再遇到问题,不用再从第一行扫到最后一行。
附录 A:十八篇全息索引(含来源全称)
| 篇 | 主题 | 代码落点 | 来源(写全「第 N 篇《主题》」) |
|---|---|---|---|
| 00 | 四大支柱(开篇) | 无 demo(开篇总纲) | 开篇《四大支柱》 |
| 01 | 概率坍塌·给LLM输出加锁 | 代码嵌于正文 | 第 1 篇《概率坍塌·给LLM输出加锁》 |
| 02 | Golden Set + CI 评测 | 代码嵌于正文 | 第 2 篇《Golden Set + CI 评测》 |
| 03 | 灰度发布 + 自动熔断 | 代码嵌于正文 | 第 3 篇《灰度发布 + 自动熔断》 |
| 04 | Prompt 即代码(版本管理) | 代码嵌于正文 | 第 4 篇《Prompt 即代码(版本管理)》 |
| 05 | LLM 网关选型 | 有 demo | 第 5 篇《LLM 网关选型》 |
| 06 | OWASP 安全护栏 | 有 demo | 第 6 篇《OWASP 安全护栏》 |
| 07 | JSON Schema 强约束 | 有 demo | 第 7 篇《JSON Schema 强约束》 |
| 08 | OTel + LangFuse 全链路 Trace | 有 demo | 第 8 篇《OTel + LangFuse 全链路 Trace》 |
| 09 | Token 成本六维优化 | 有 demo | 第 9 篇《Token 成本六维优化》 |
| 10 | Human-in-the-Loop 反馈闭环 | 有 demo | 第 10 篇《Human-in-the-Loop 反馈闭环》 |
| 11 | 知识库防腐坏 | 代码嵌于正文 | 第 11 篇《知识库防腐坏》 |
| 12 | 数据工程底座 | 有 demo | 第 12 篇《数据工程底座》 |
| 13 | LLMOps 不完全指南 | 有 demo | 第 13 篇《LLMOps 不完全指南》 |
| 14 | Multi-Agent 协作实战 | 有 demo | 第 14 篇《Multi-Agent 协作实战》 |
| 15 | 开源工具箱 30+ 选型地图 | 有 demo | 第 15 篇《开源工具箱 30+ 选型地图》 |
| 16 | 政企国产化避坑 | 有 demo | 第 16 篇《政企国产化避坑》 |
| 17 | 金融级 AI 落地 | 有 demo | 第 17 篇《金融级 AI 落地》 |
附录 B:症状 → 主篇 → 关联篇完整表
| 一句大实话处境 | 主篇 | 关联篇 |
|---|---|---|
| 幻觉变多 | 第 8 篇《OTel + LangFuse 全链路 Trace》 | 第 2 篇《Golden Set + CI 评测》、第 11 篇《知识库防腐坏》 |
| 成本月月涨 | 第 9 篇《Token 成本六维优化》 | 第 5 篇《LLM 网关选型》、第 7 篇《JSON Schema 强约束》 |
| 不敢发版 | 第 3 篇《灰度发布 + 自动熔断》 | 第 2 篇《Golden Set + CI 评测》、第 4 篇《Prompt 即代码(版本管理)》 |
| 模型吐的 JSON 解析失败 | 第 7 篇《JSON Schema 强约束》 | 第 1 篇《概率坍塌·给LLM输出加锁》 |
| 敏感信息被念出来 | 第 6 篇《OWASP 安全护栏》 | 第 8 篇《OTel + LangFuse 全链路 Trace》 |
| 线上效果比评测差一截 | 第 2 篇《Golden Set + CI 评测》 | 第 8 篇《OTel + LangFuse 全链路 Trace》、第 10 篇《Human-in-the-Loop 反馈闭环》 |
| RAG 正确率一个月比一个月差 | 第 11 篇《知识库防腐坏》 | 第 12 篇《数据工程底座》、第 8 篇《OTel + LangFuse 全链路 Trace》 |
| 评测越评越高、线上却越来越差 | 第 10 篇《Human-in-the-Loop 反馈闭环》 | 第 2 篇《Golden Set + CI 评测》 |
| 多 Agent 上线就翻车 | 第 14 篇《Multi-Agent 协作实战》 | 第 8 篇《OTel + LangFuse 全链路 Trace》 |
| 工具选不出来 | 第 15 篇《开源工具箱 30+ 选型地图》 | --- |
| 政企过不了验收 | 第 16 篇《政企国产化避坑》 | 第 6 篇《OWASP 安全护栏》、第 13 篇《LLMOps 不完全指南》 |
| 监管来函要复现一笔决策 | 第 17 篇《金融级 AI 落地》 | 第 8 篇《OTel + LangFuse 全链路 Trace》、第 10 篇《Human-in-the-Loop 反馈闭环》 |
| 换模型一行配置上生产、回滚不知回哪版 | 第 13 篇《LLMOps 不完全指南》 | 第 12 篇《数据工程底座》、第 4 篇《Prompt 即代码(版本管理)》 |
| 补一份文档半天没了 | 第 12 篇《数据工程底座》 | 第 11 篇《知识库防腐坏》 |
附录 C:四大支柱 × 系统阶段 骨架网格
| 关注面 | 建设 | 上线 | 运行 | 进化 |
|---|---|---|---|---|
| 支柱一·质量保障 | 第 2 篇《Golden Set + CI 评测》、第 4 篇《Prompt 即代码(版本管理)》 | 第 3 篇《灰度发布 + 自动熔断》 | --- | --- |
| 支柱二·运行时韧性 | 第 5 篇《LLM 网关选型》 | --- | 第 1 篇《概率坍塌·给LLM输出加锁》、第 6 篇《OWASP 安全护栏》、第 7 篇《JSON Schema 强约束》 | --- |
| 支柱三·全链路可观测 | --- | --- | 第 8 篇《OTel + LangFuse 全链路 Trace》、第 9 篇《Token 成本六维优化》 | --- |
| 支柱四·持续进化 | --- | --- | --- | 第 10 篇《Human-in-the-Loop 反馈闭环》、第 11 篇《知识库防腐坏》 |
| 底座 | 第 12 篇《数据工程底座》、第 13 篇《LLMOps 不完全指南》 | --- | --- | --- |
| 专题 | 第 14 篇《Multi-Agent 协作实战》、第 15 篇《开源工具箱 30+ 选型地图》 | --- | --- | --- |
| 行业 | --- | 第 16 篇《政企国产化避坑》 | 第 17 篇《金融级 AI 落地》 | --- |
附录 D:导航器算法说明
三个函数,一条主线,全部 O(篇数),纯标准库:
locate(scenario, symptoms, entries=None):三级匹配------先精确,再"症状是查询的子串"(用户给的更细),最后才"查询是症状的子串"(用户只给片段);顺序反了,短查询("评测")会抢跑错指。命中则取primary_seq建主篇、related_seqs建关联篇;未命中返回primary=None的空结果 + 一句"可能超出本专栏范围"的 note。匹配不到不硬塞------图的诚实性高于覆盖率。coverage_gaps(landscape):遍历COVERAGE_ITEMS(自检 10 问),landscape缺键按"没有"处理;缺项收进missing,对应篇收进suggested_seqs(去重)。先报"缺",再报"去哪补",两件事分开。check_references(entries, registry):两件事------① 完整性:00--17十八篇一篇不能漏;② 悬空:每条source、每个code_landing必须在registry(在册篇目全称 + 在册落点三种取值)里,否则报悬空。返回问题清单,空 = 干净。
在册口径:在册落点 = "有 demo"、"代码嵌于正文"、"无 demo(开篇总纲)"三种。其余任何字符串不在在册清单内,一律报悬空。
数据 vs 逻辑 :load_map() / load_symptoms() / load_registry() 是数据,locate / coverage_gaps / check_references 是逻辑。地图会烂------改数据、不碰逻辑,这是这套导航器能被长期维护的唯一前提。
🎯 更多专栏系列文章可以查看博客主页📑 👍 若文章对你有所触动,恳请点赞 ⭐ 关注 ⭐ 收藏