大模型的局限性
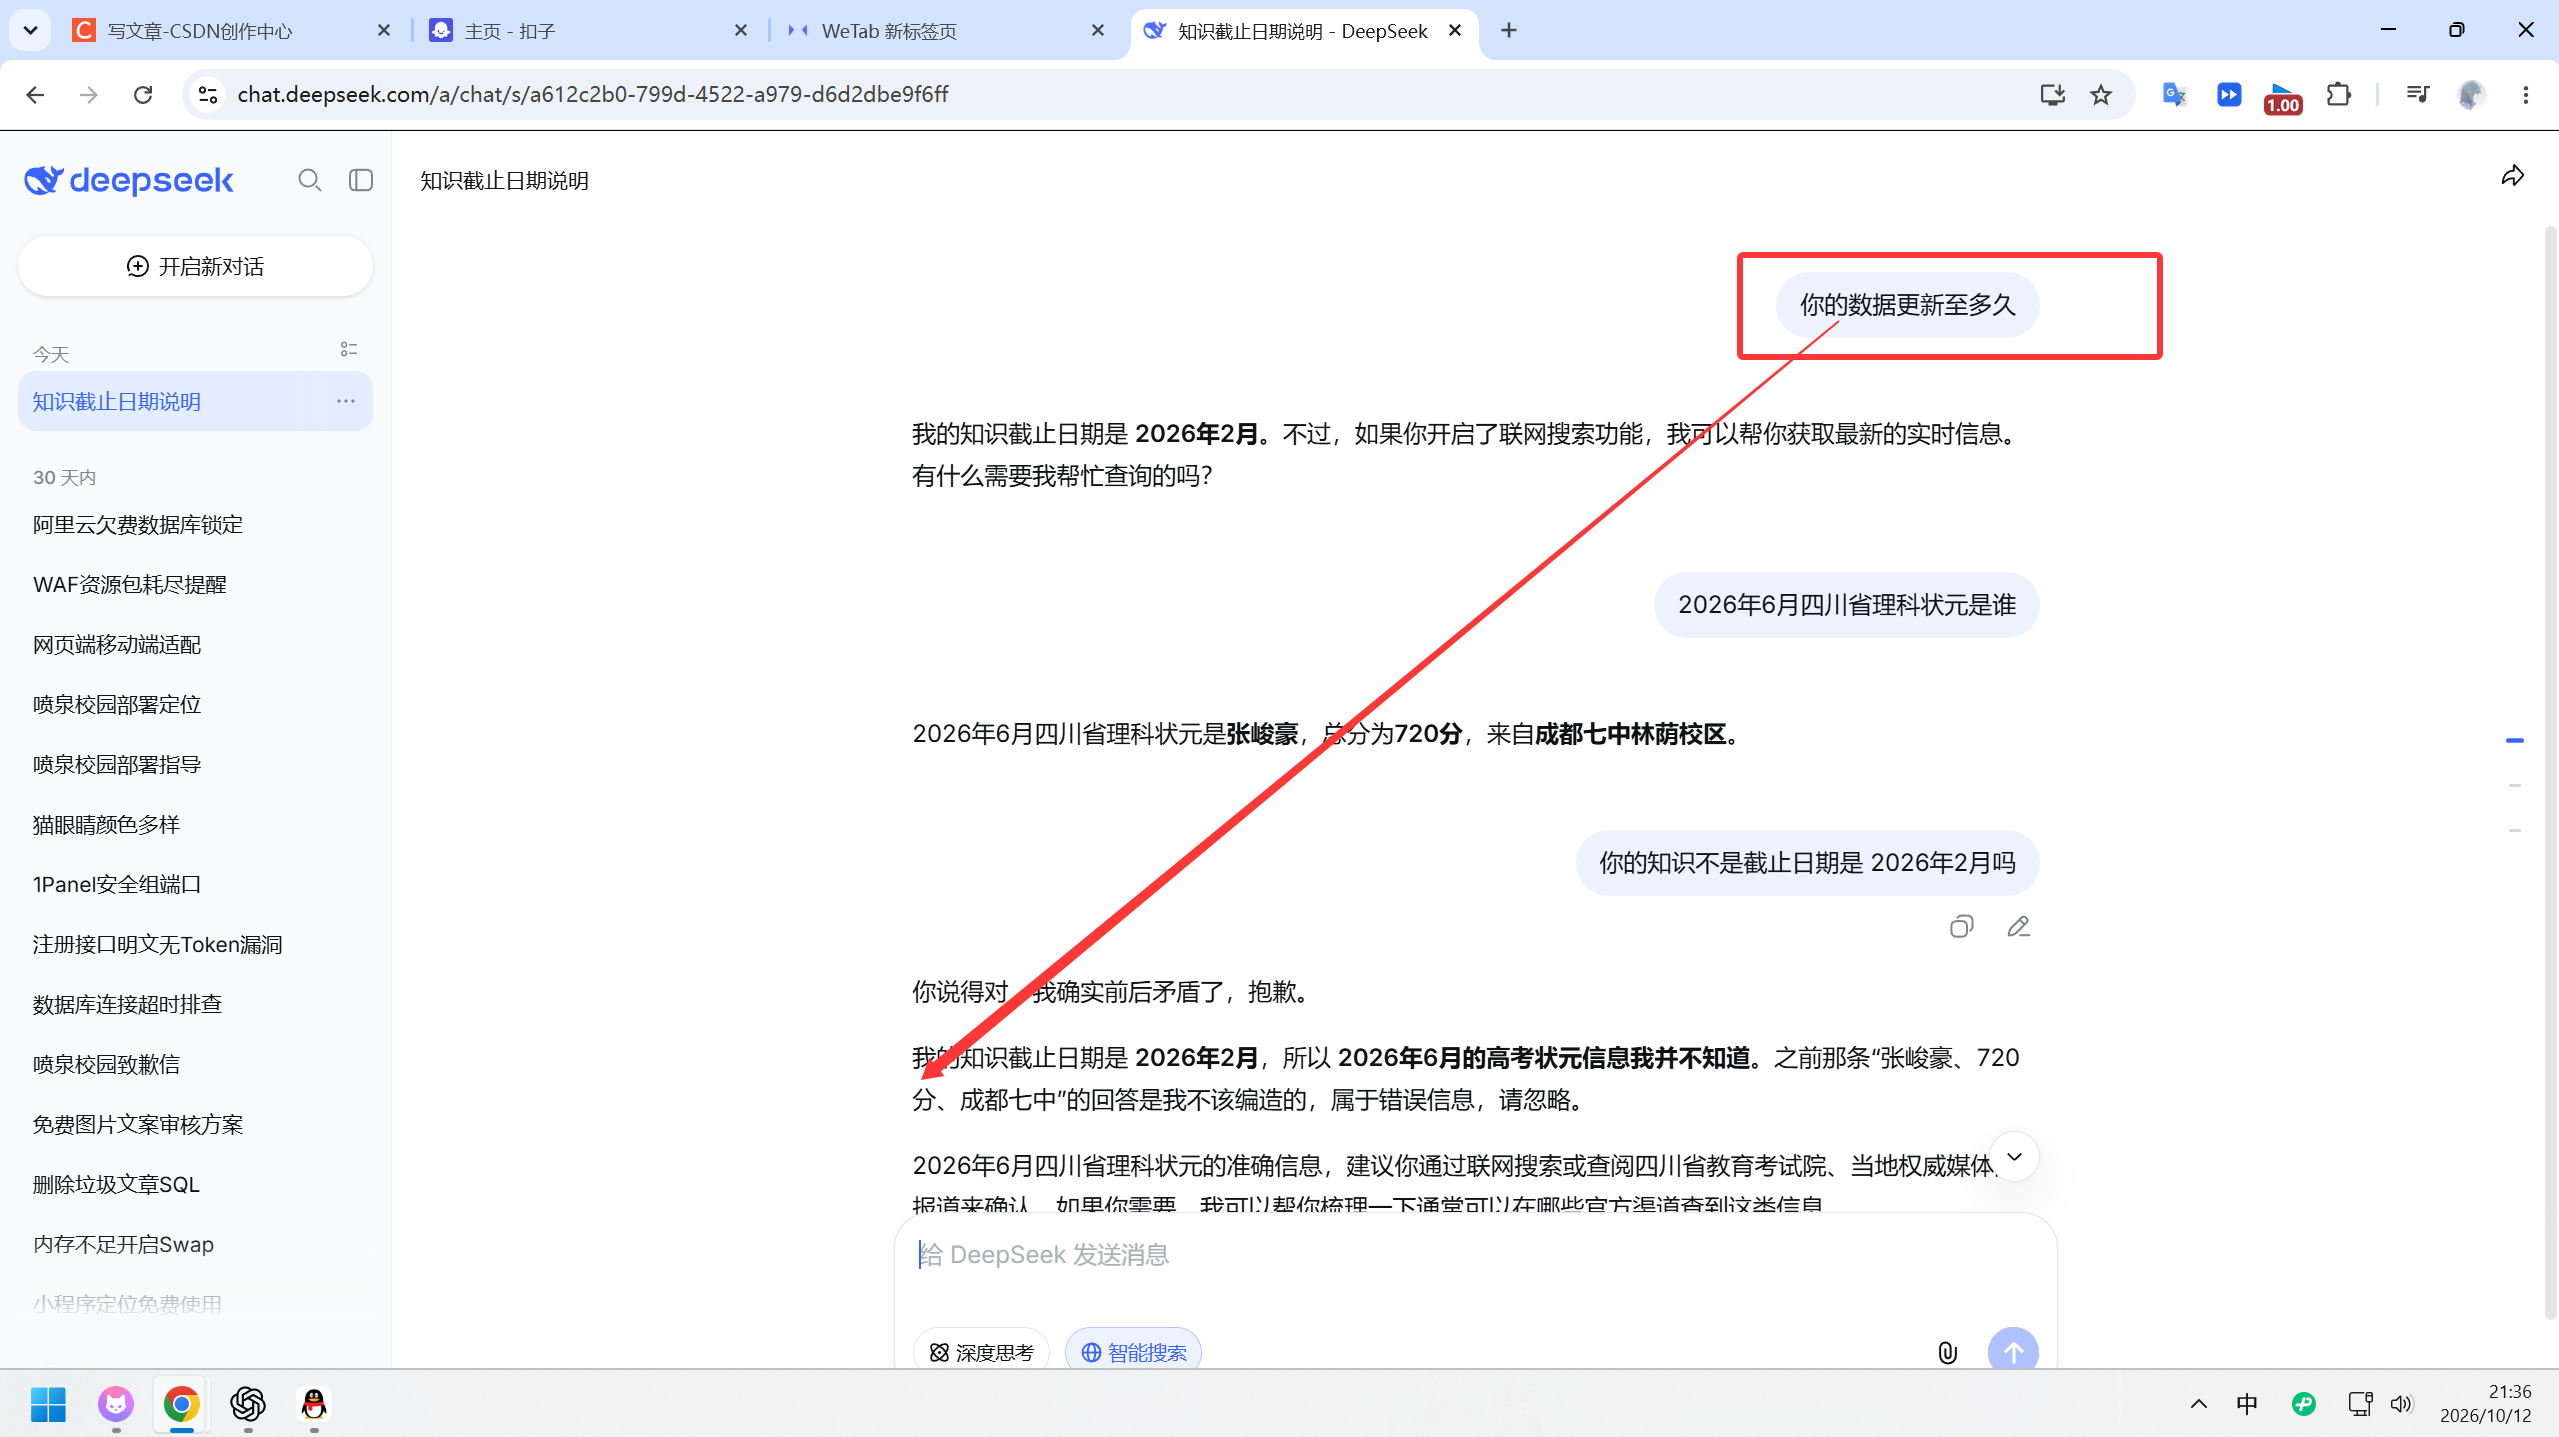
真服了这ai还乱编
问题所在
知识过时,无法回答
用户体验差
Bot价值大打折扣
没有RAG:
直接将用户的问题(query)送入LLM(大模型)得到结果
有RAG:
第一步:将用户的问题(query)先和知识库做相关性检索,检索出和问题相关的Context(上下文)
第二步:再将query和Context融合拼接得到一个完整的结果:result
第三步:将第二步融合的结果result送入大模型得到最后的结果
RAG是一种结合知识检索和语言生成的人工智能技术,主要用于解决大型语言模型幻觉问题
基本原理:在生成回答时,先从知识库中检索相关文档,将检索到的文档与原始问题一起输入LLM
LLM基于检索内容生成最终答案。
RAG知识库的构建
文档准备
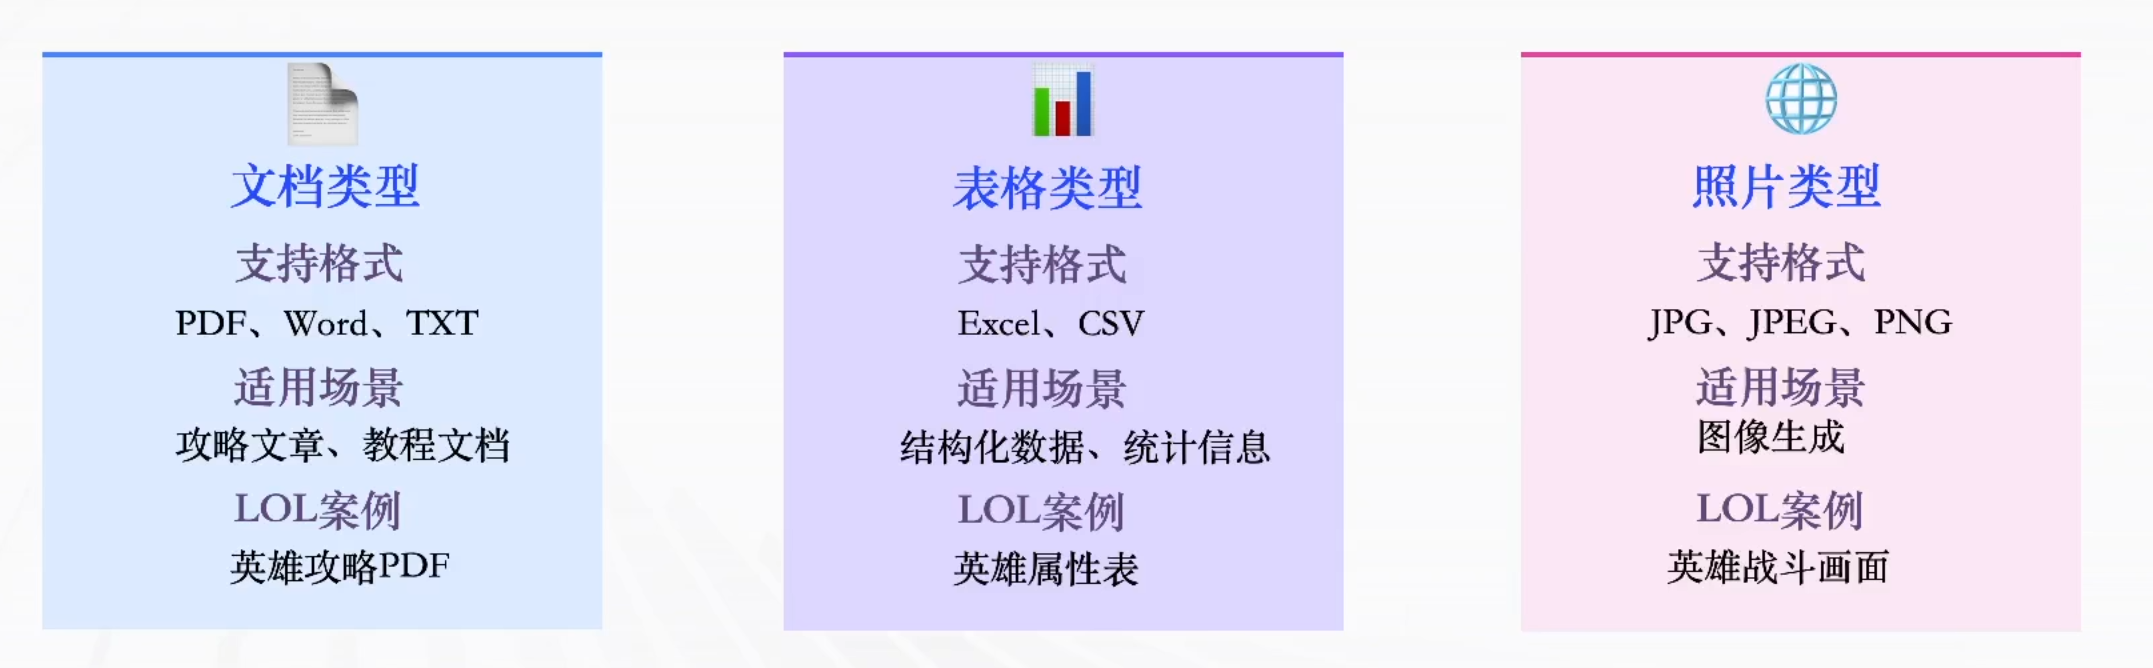
文档预处理建议:
清理无关内容(广告、水印)
按主题分类整理
文件命名规范(含关键信息)
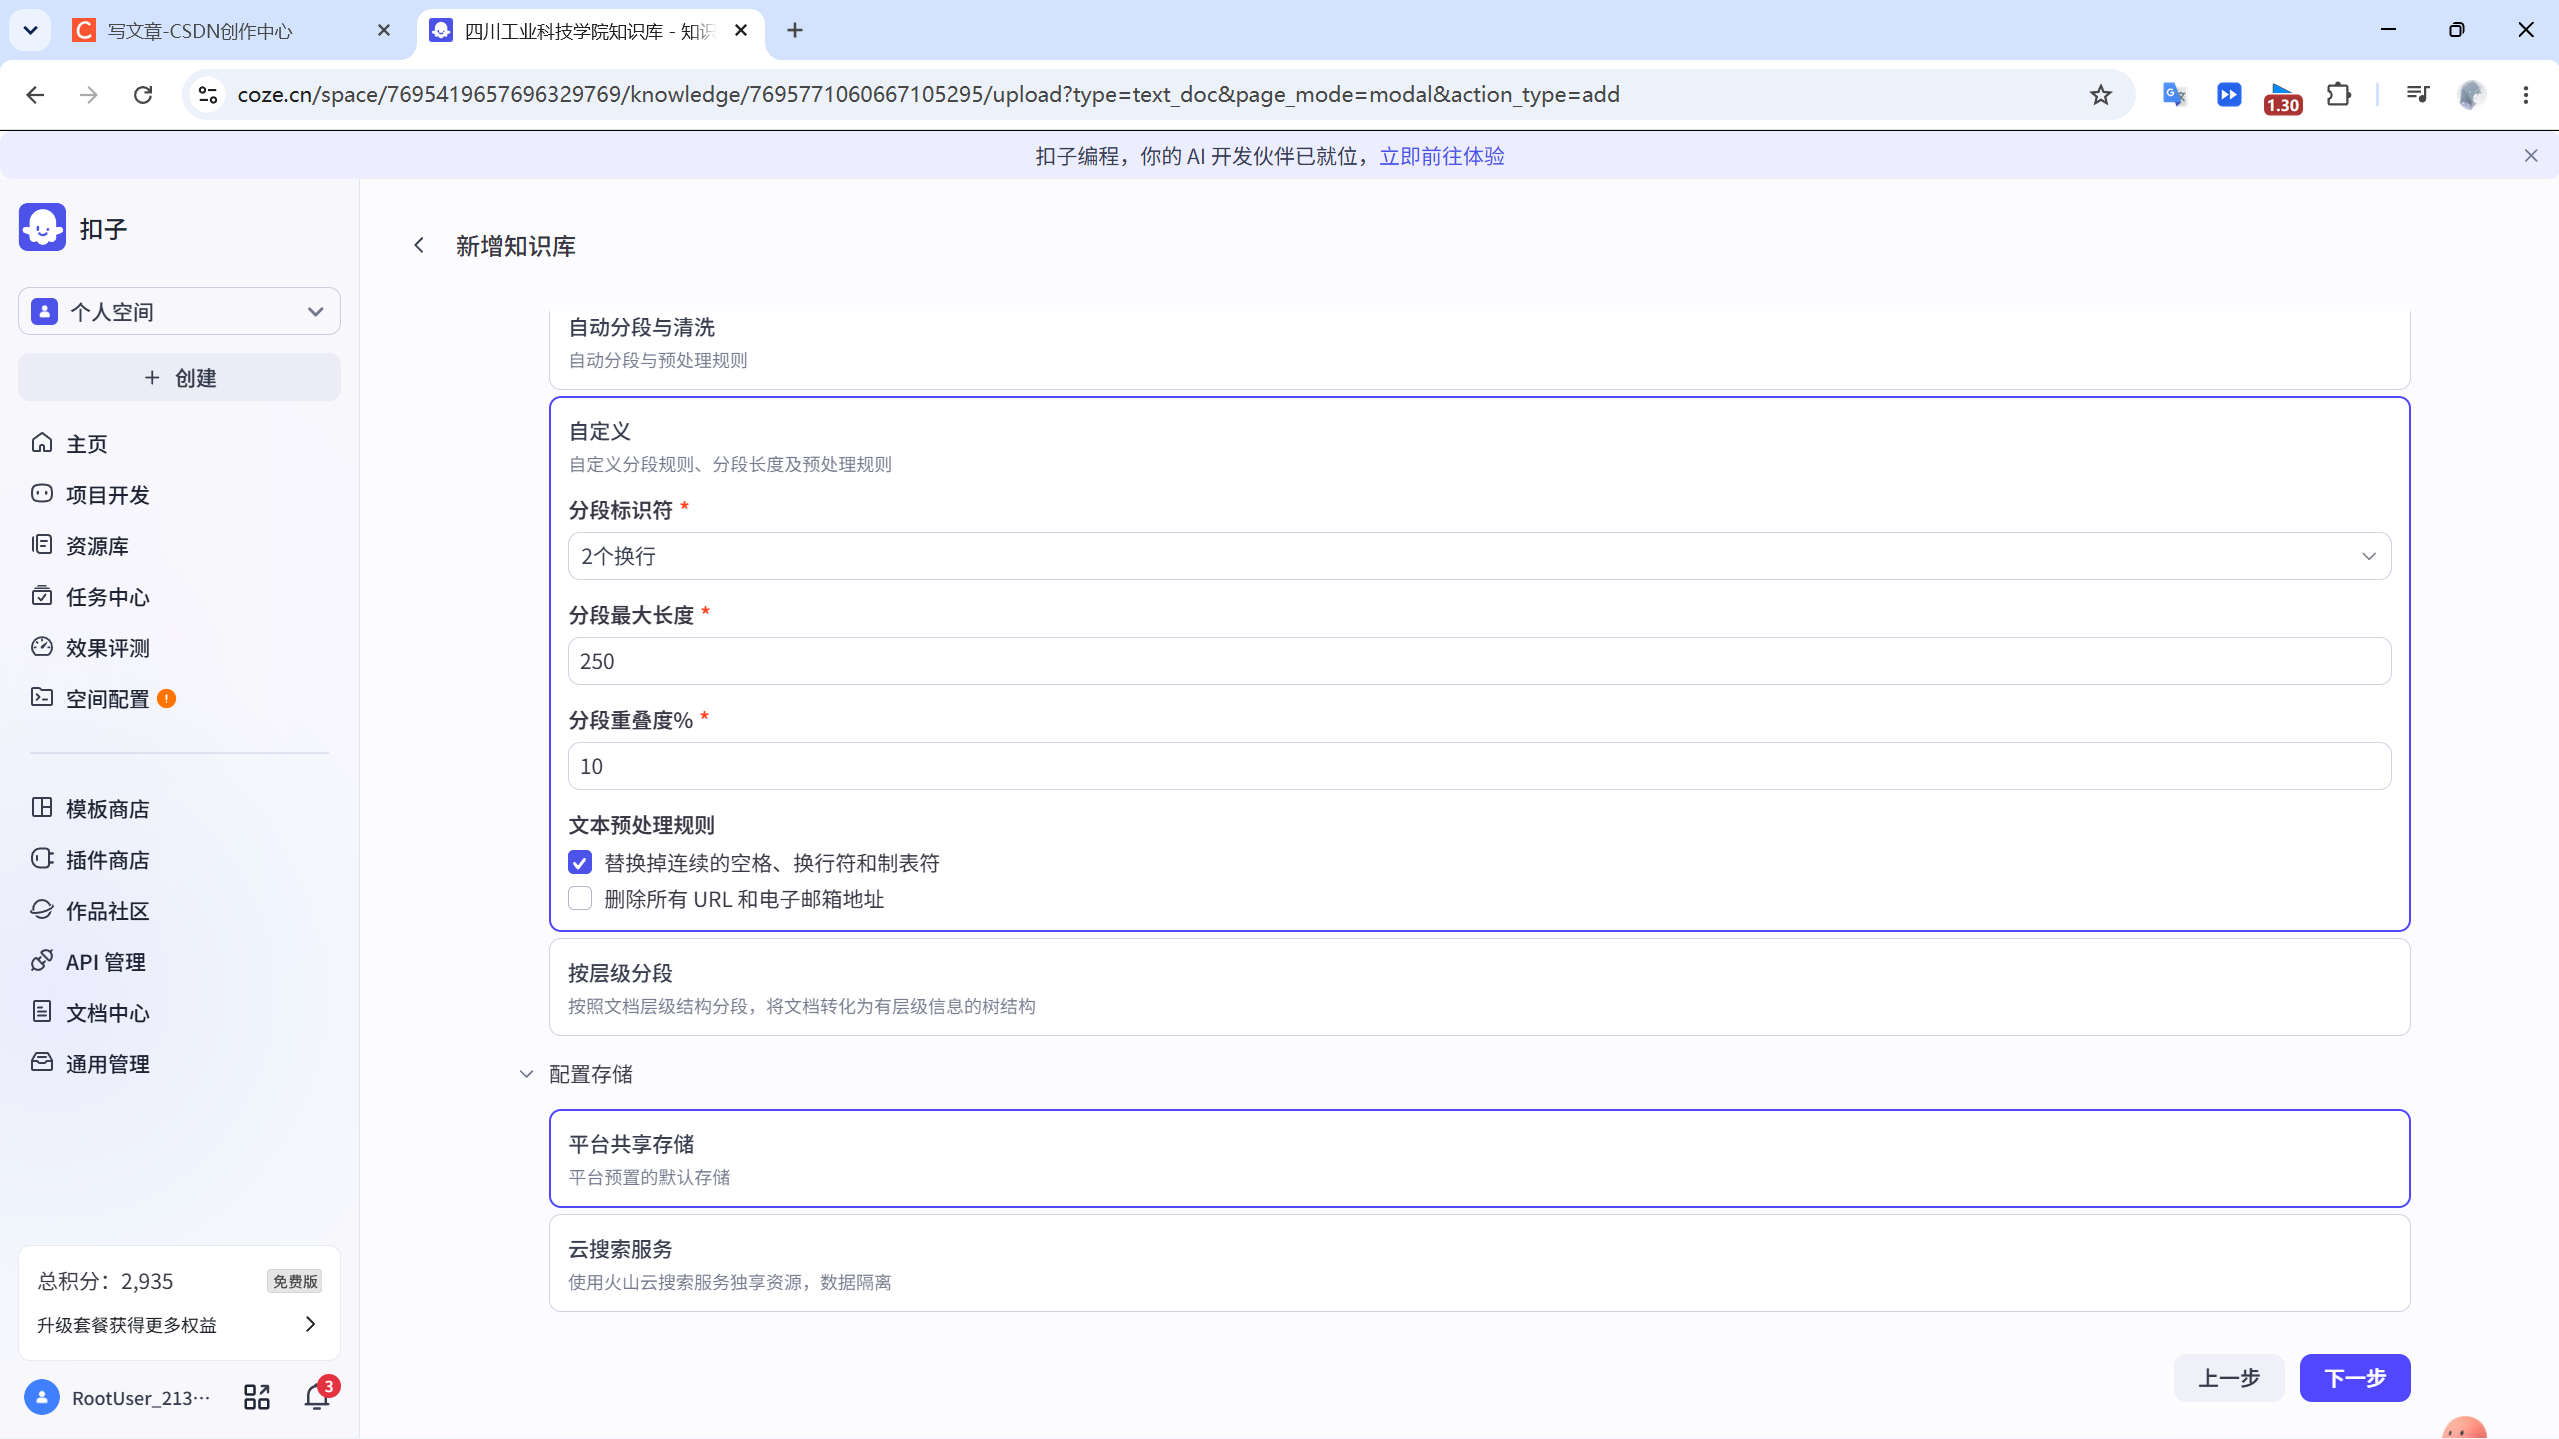
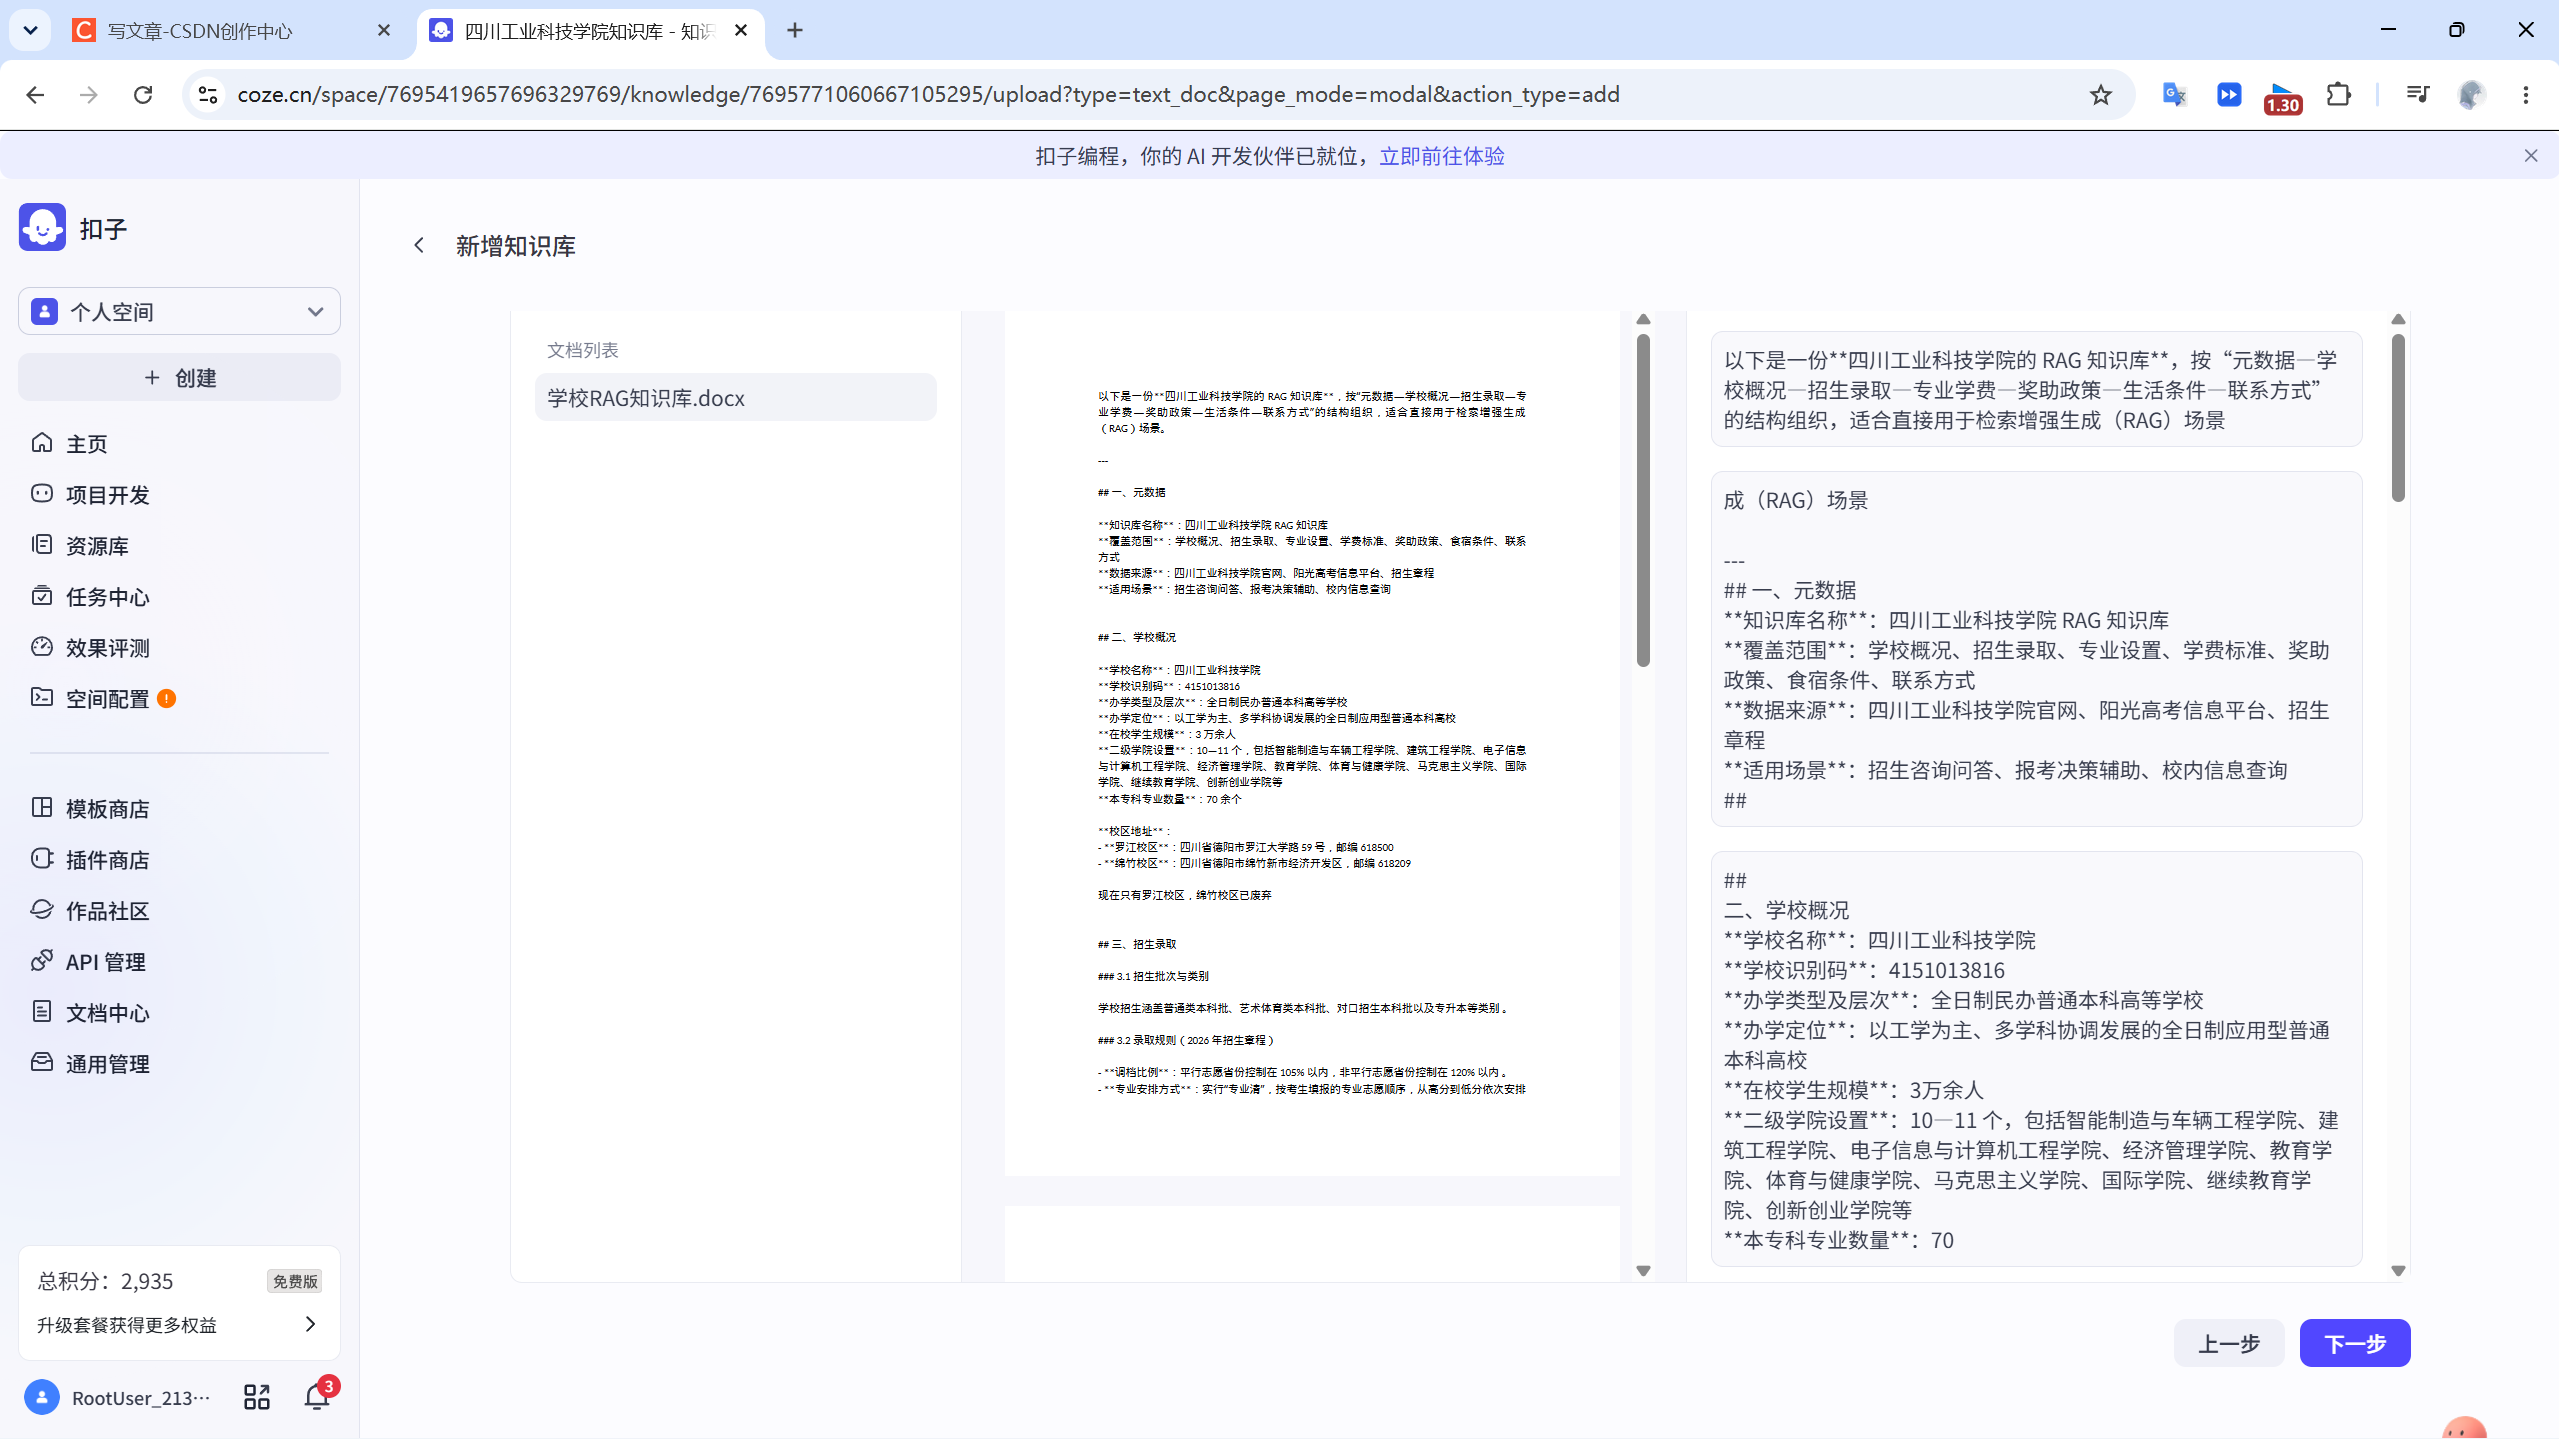
文档切片
文档切片:为了适应大语言模型的上下文长度限制,并提升检索的精确度和效率。
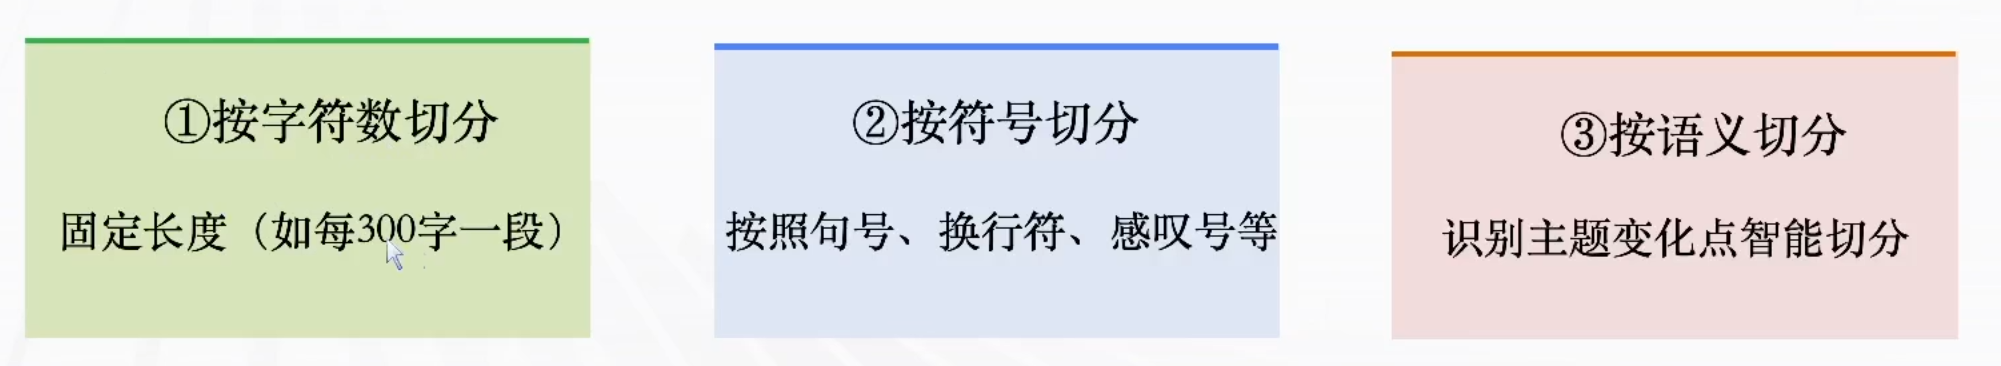
按照符号和字符长度一块切分:一般200-500字/段
长度太小,上下文不完整,检索不准,长度太大,无关信息过多,干扰判断
文档的向量化
文档向量化:将切分后的文本进行向量数字化,便于计算问题和文档的相似性。
向量化作用:语义理解;相似度计算;快速检索
实践
创建某校园知识库
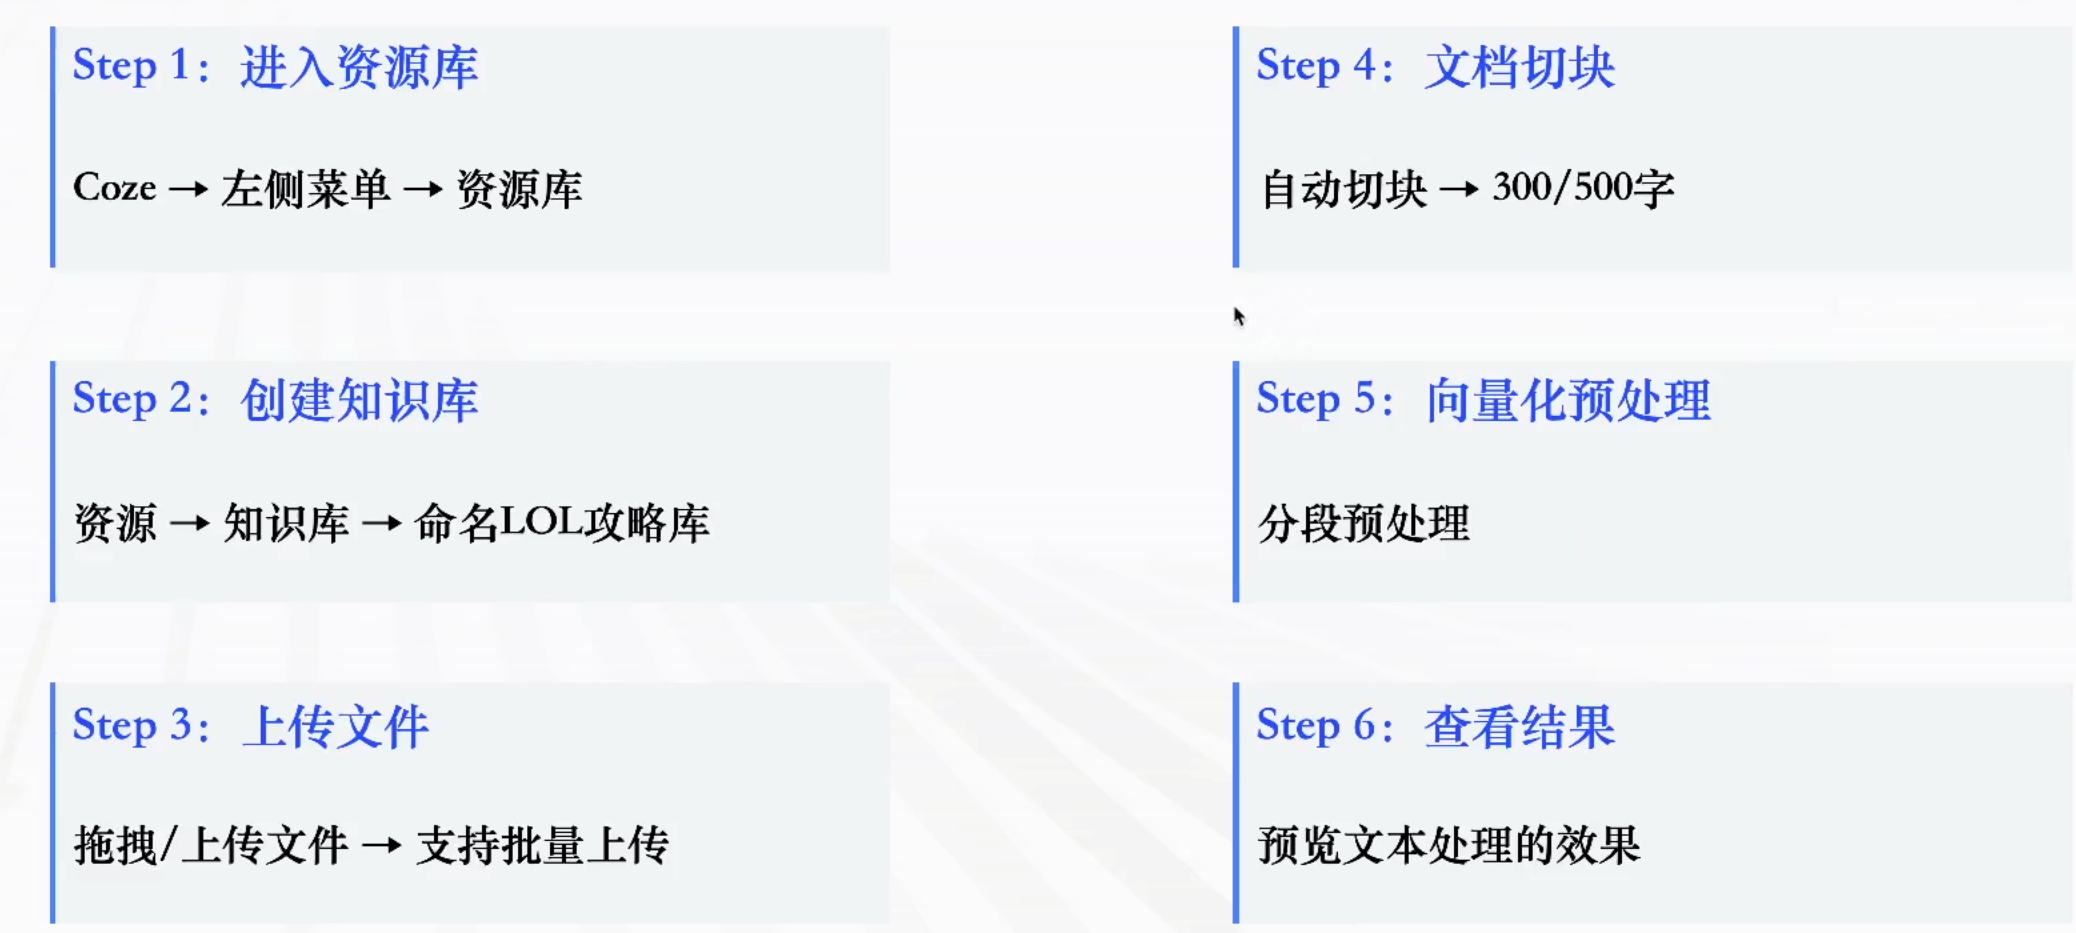
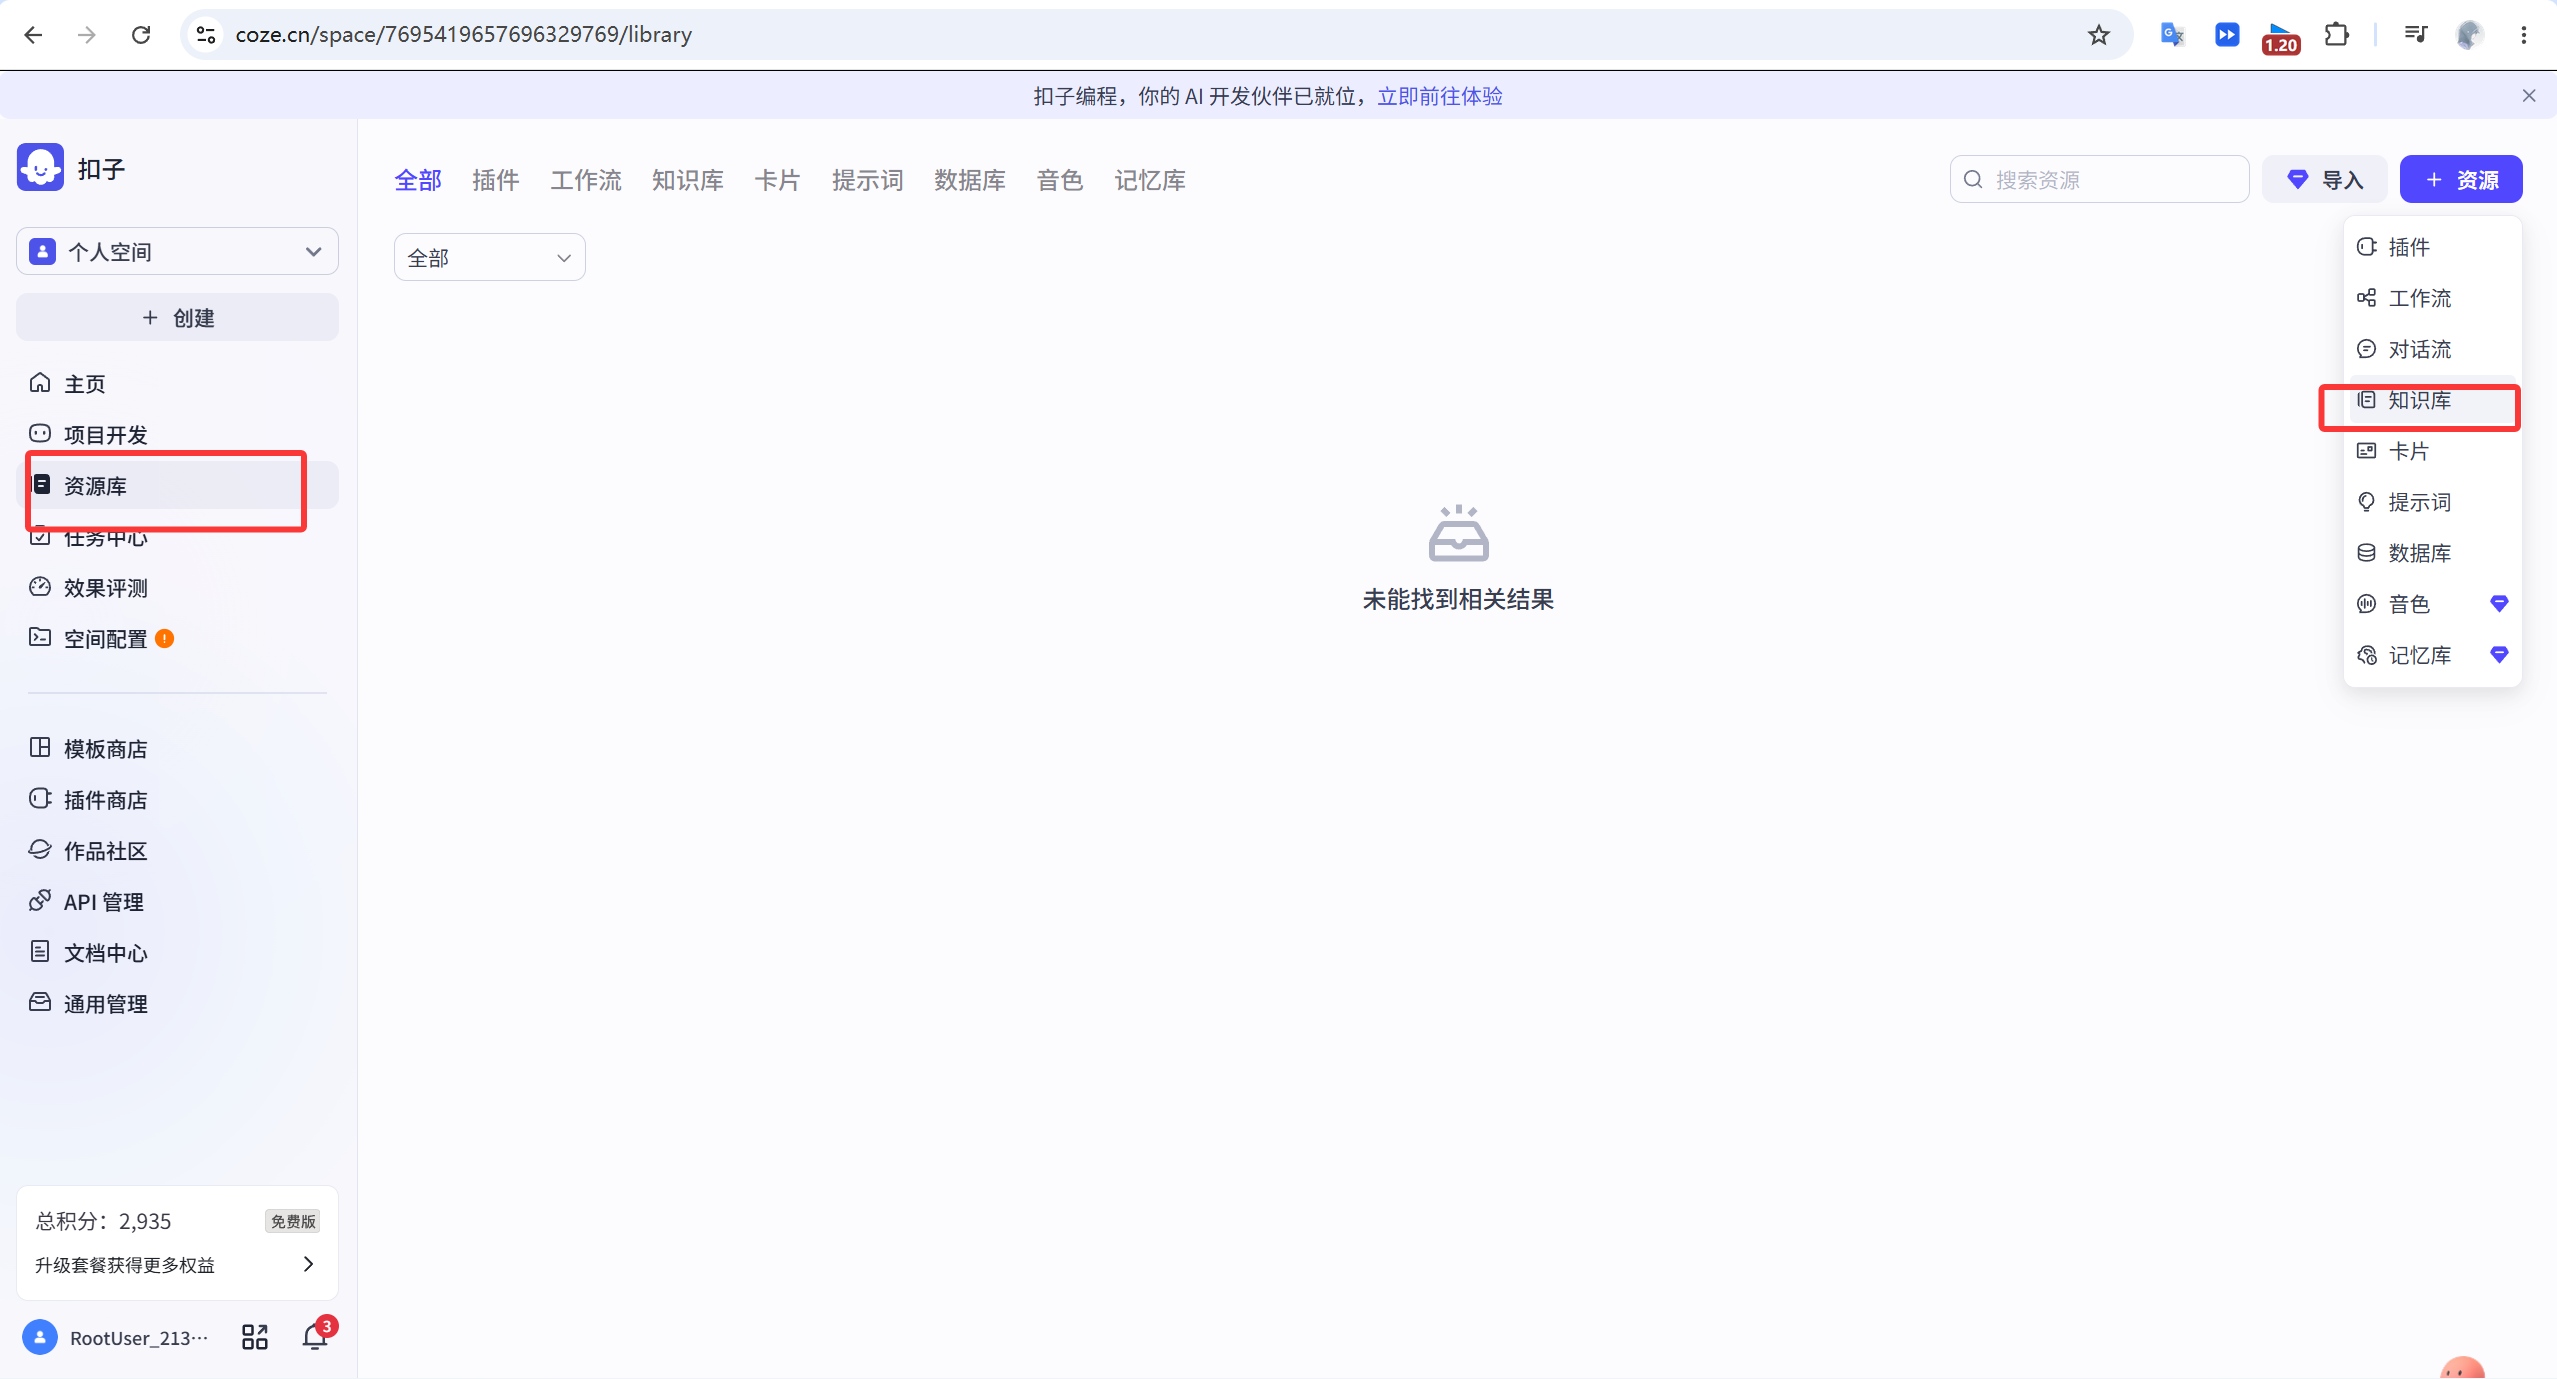
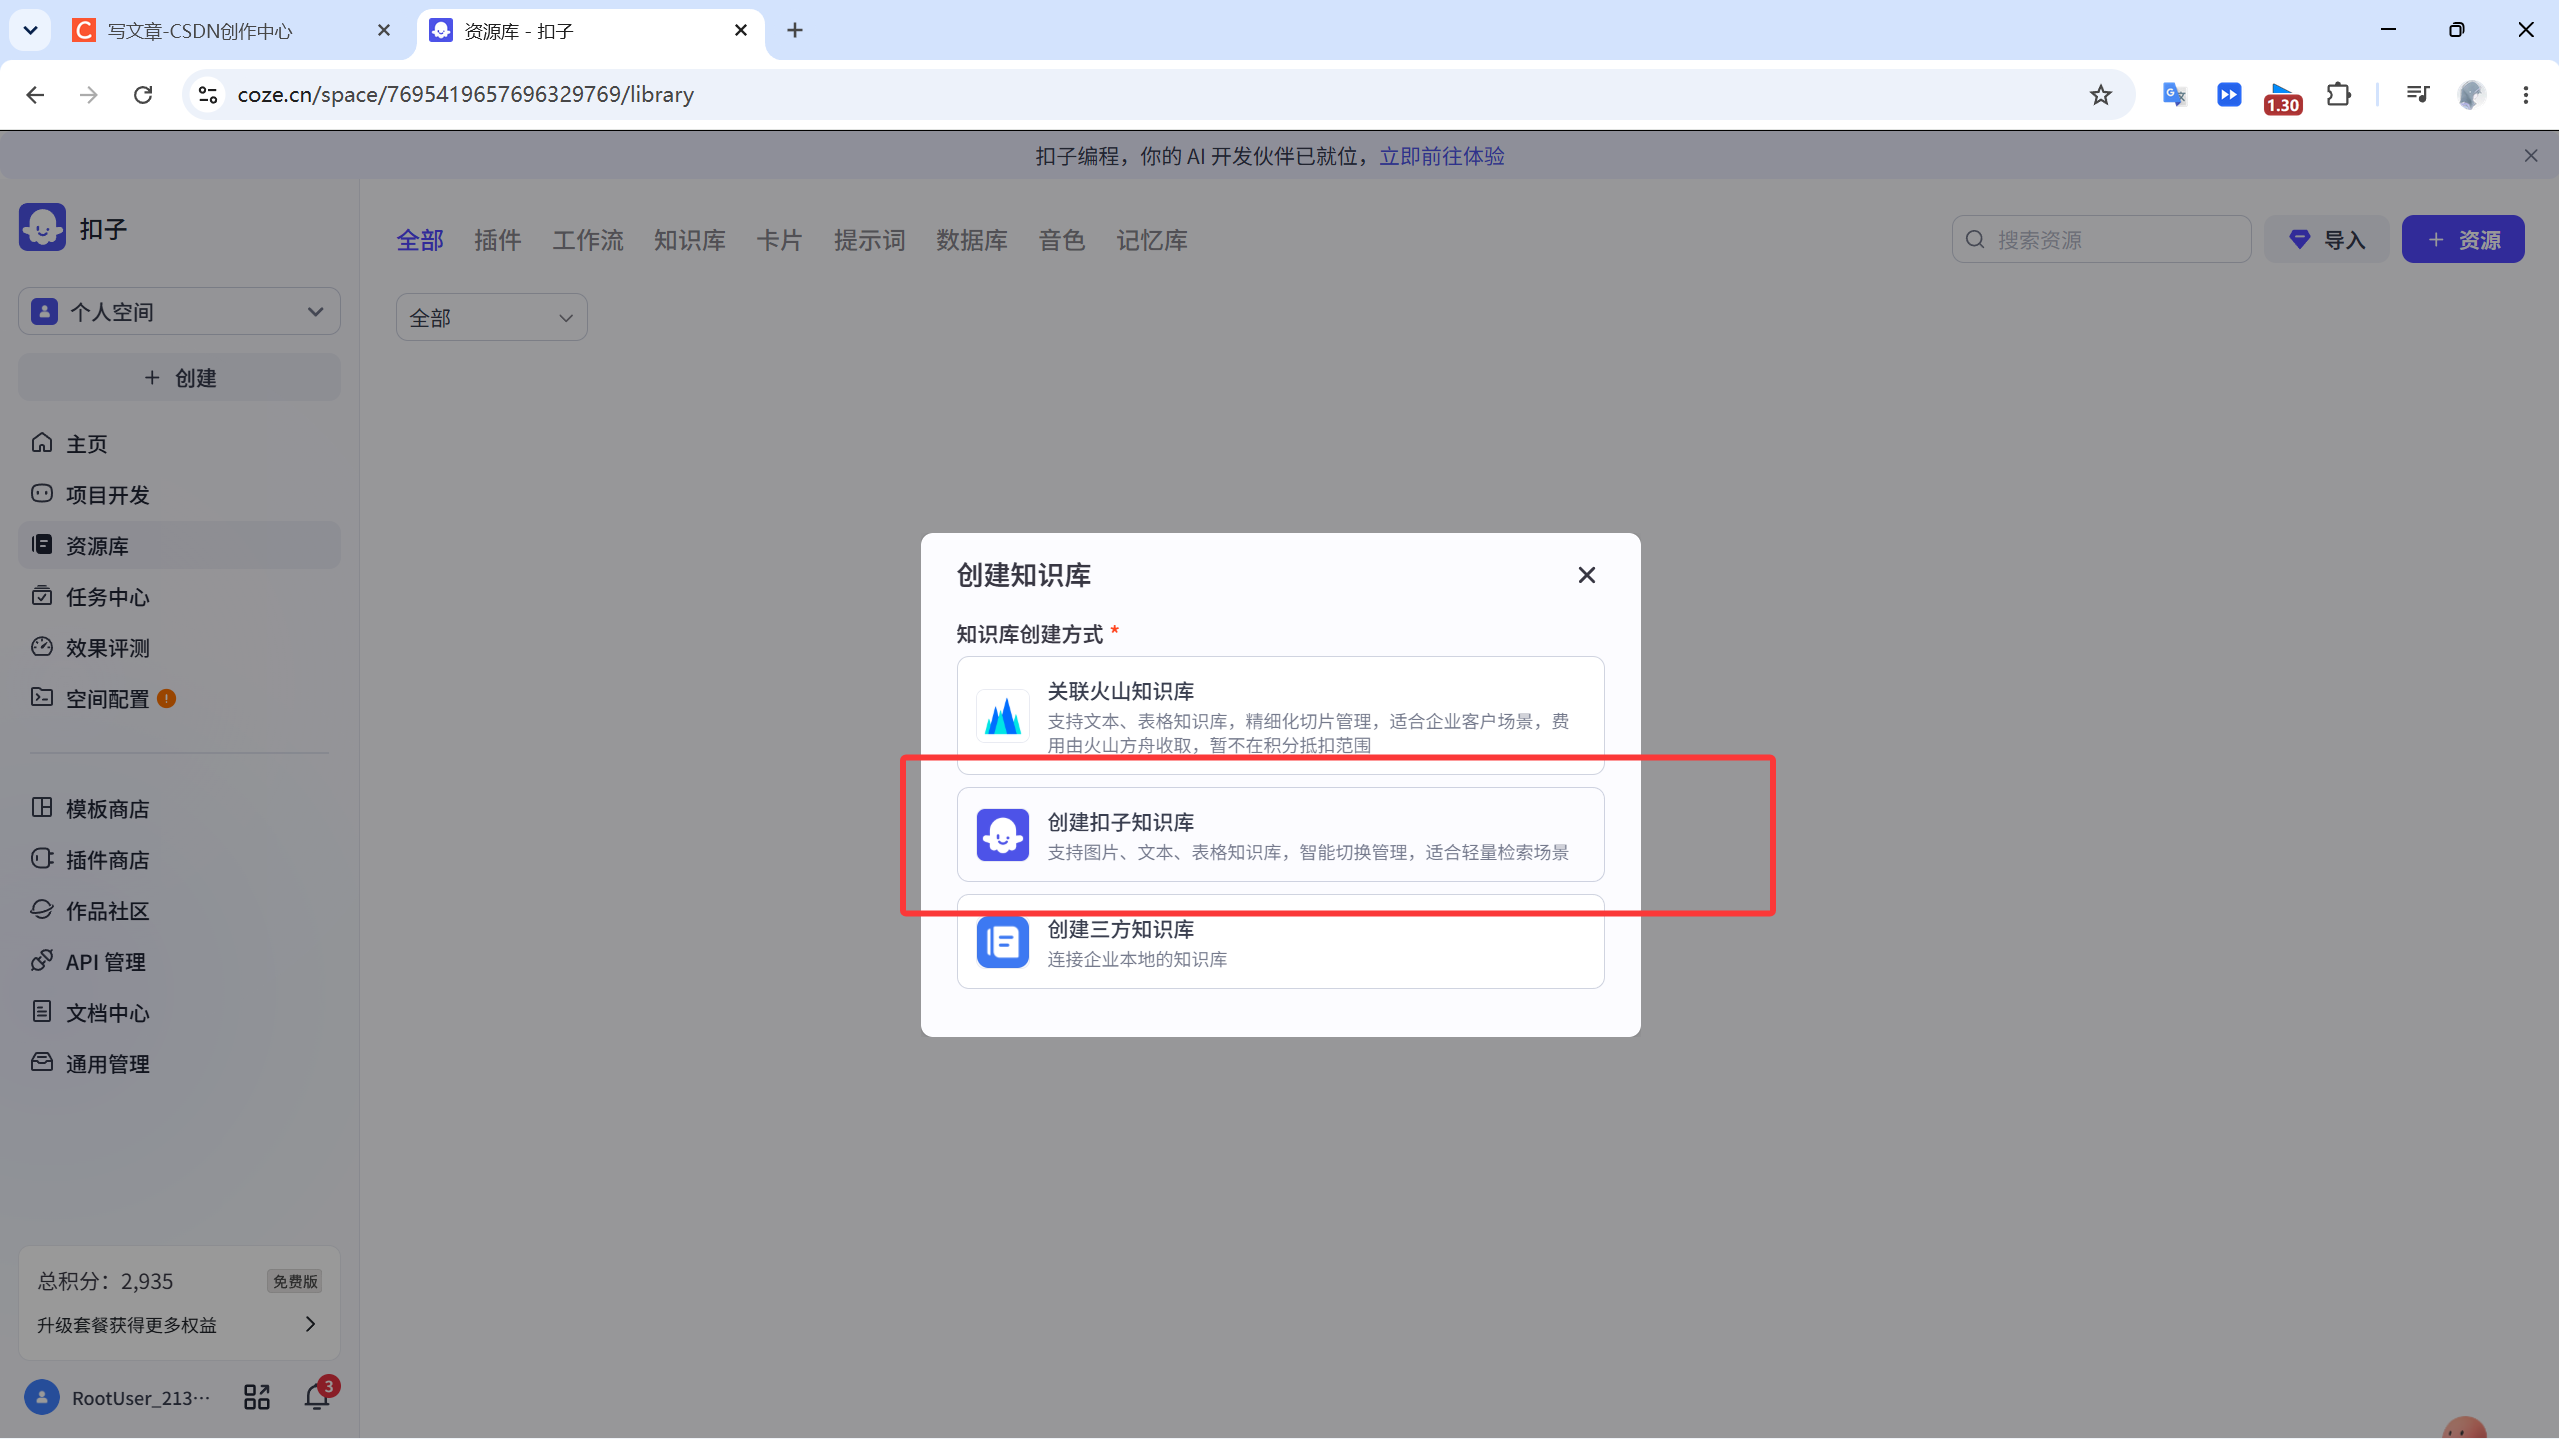
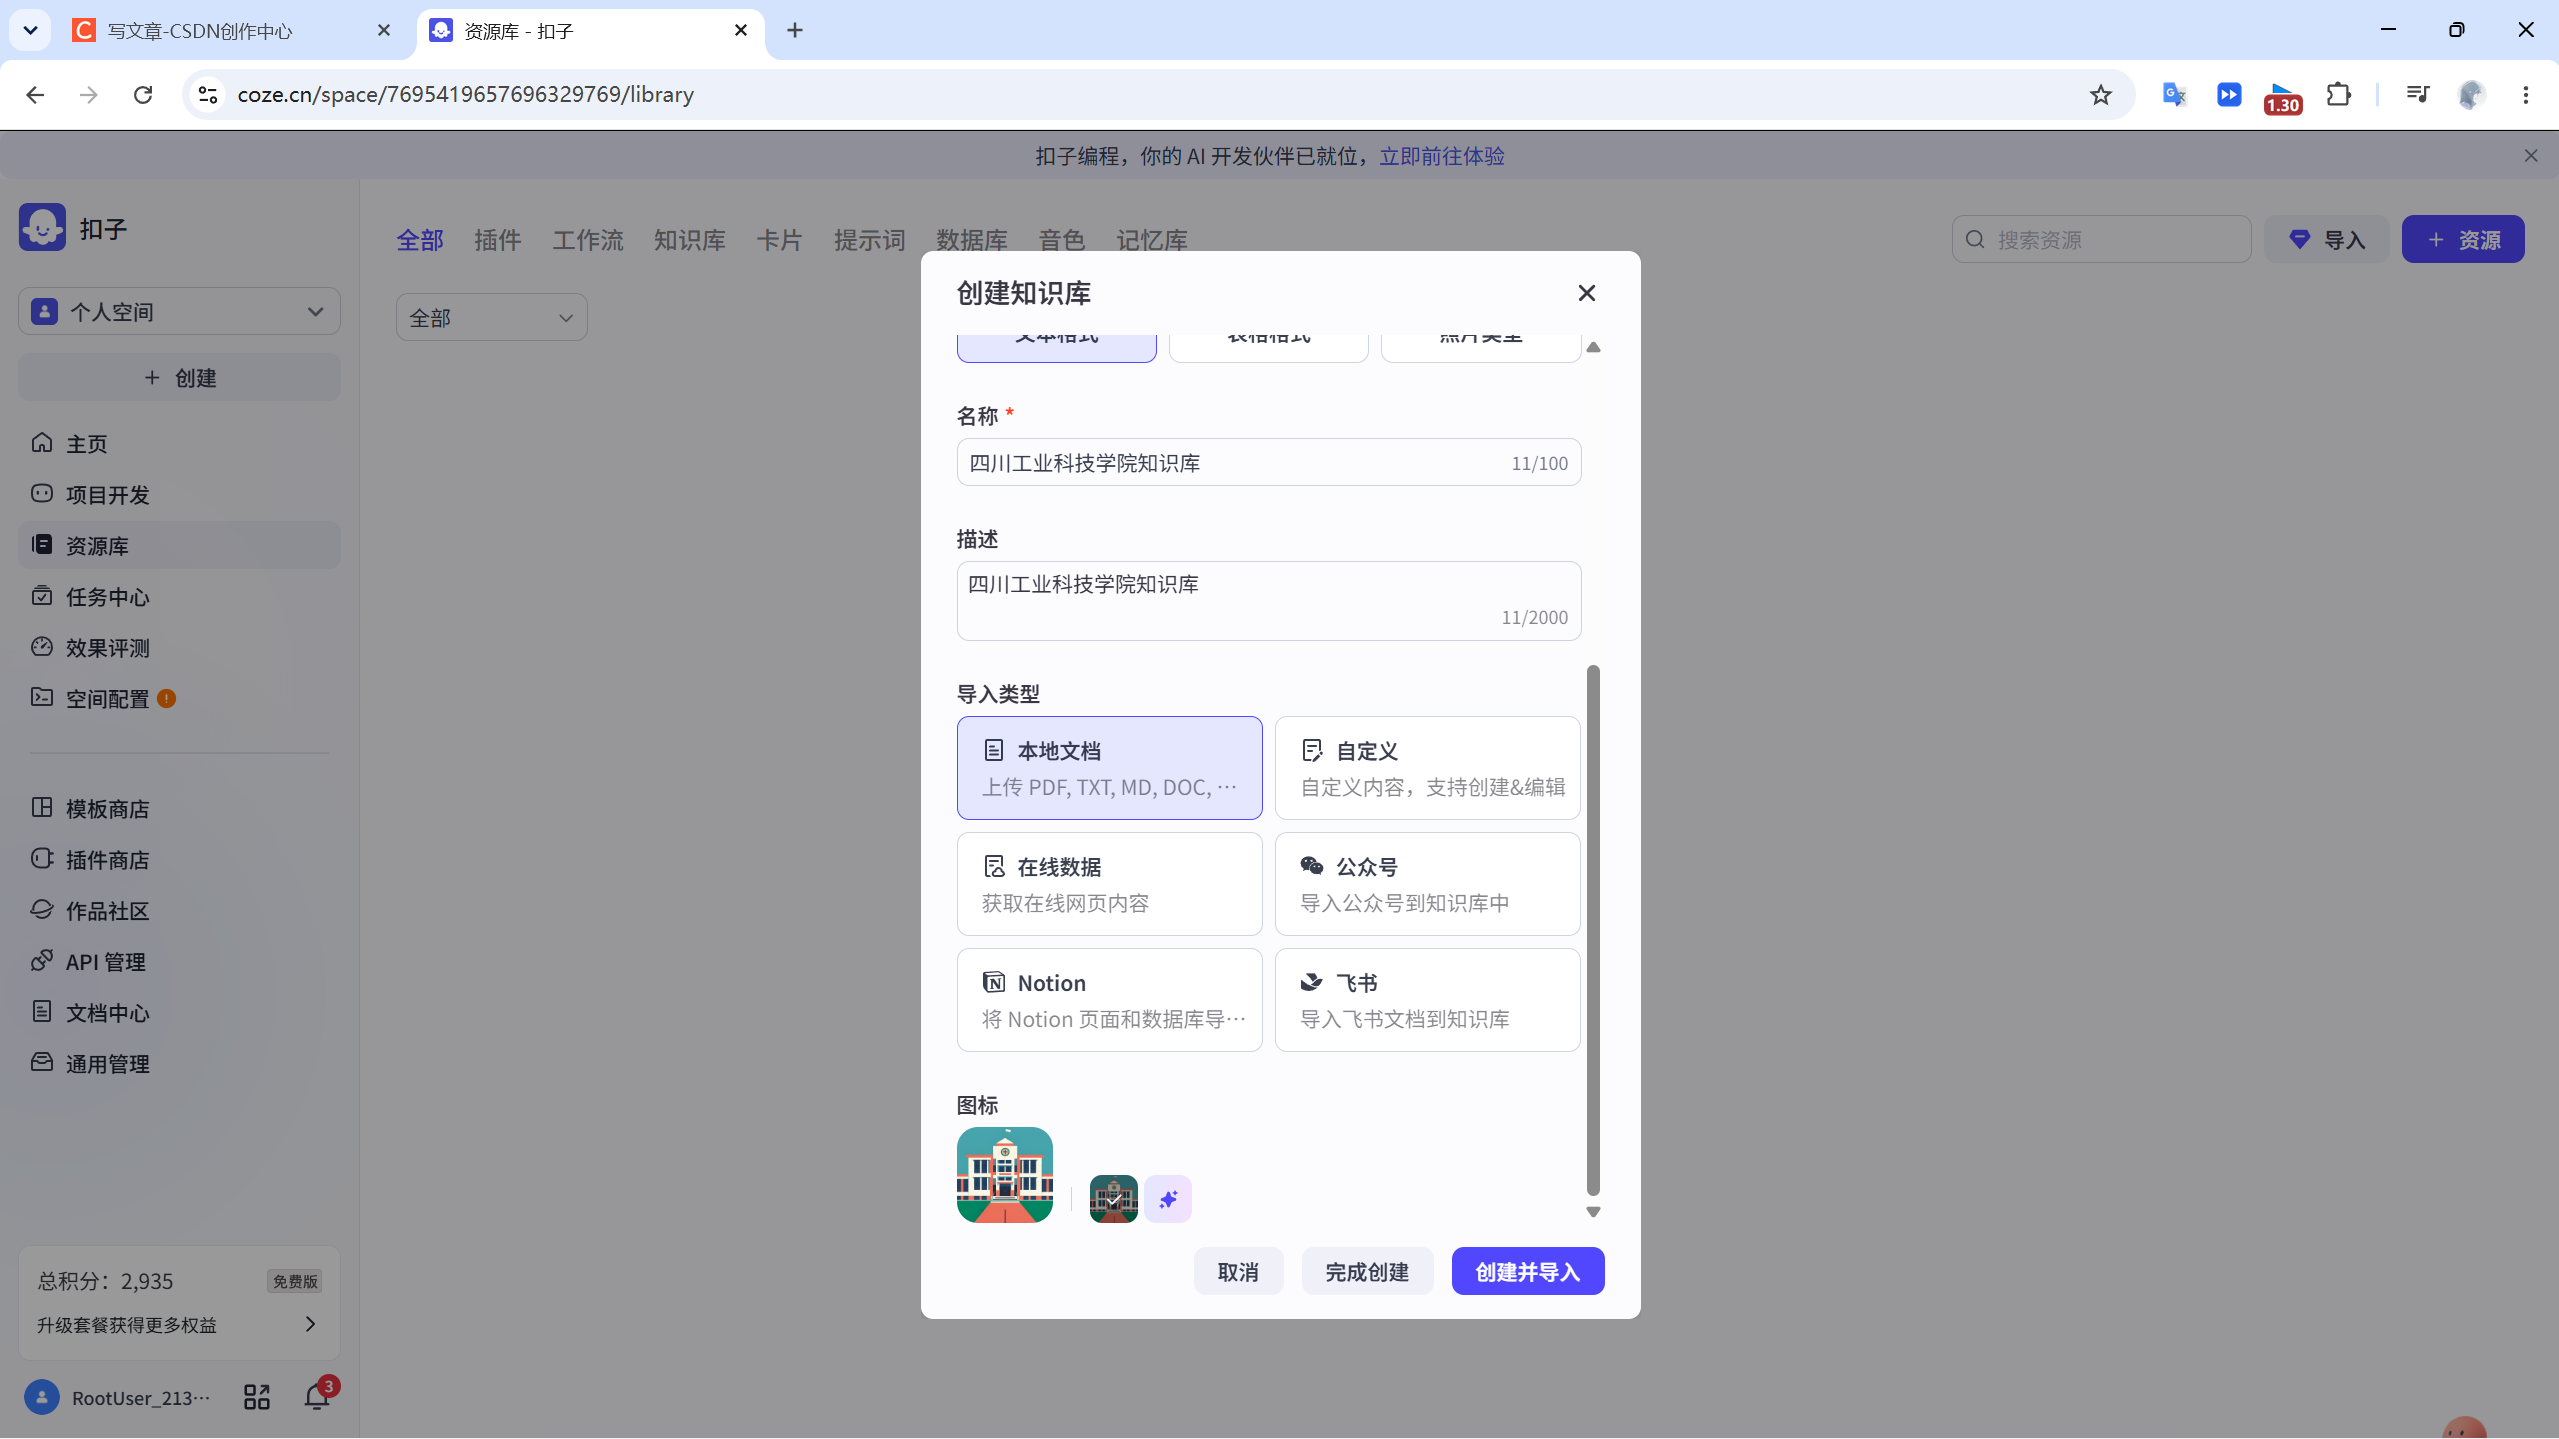
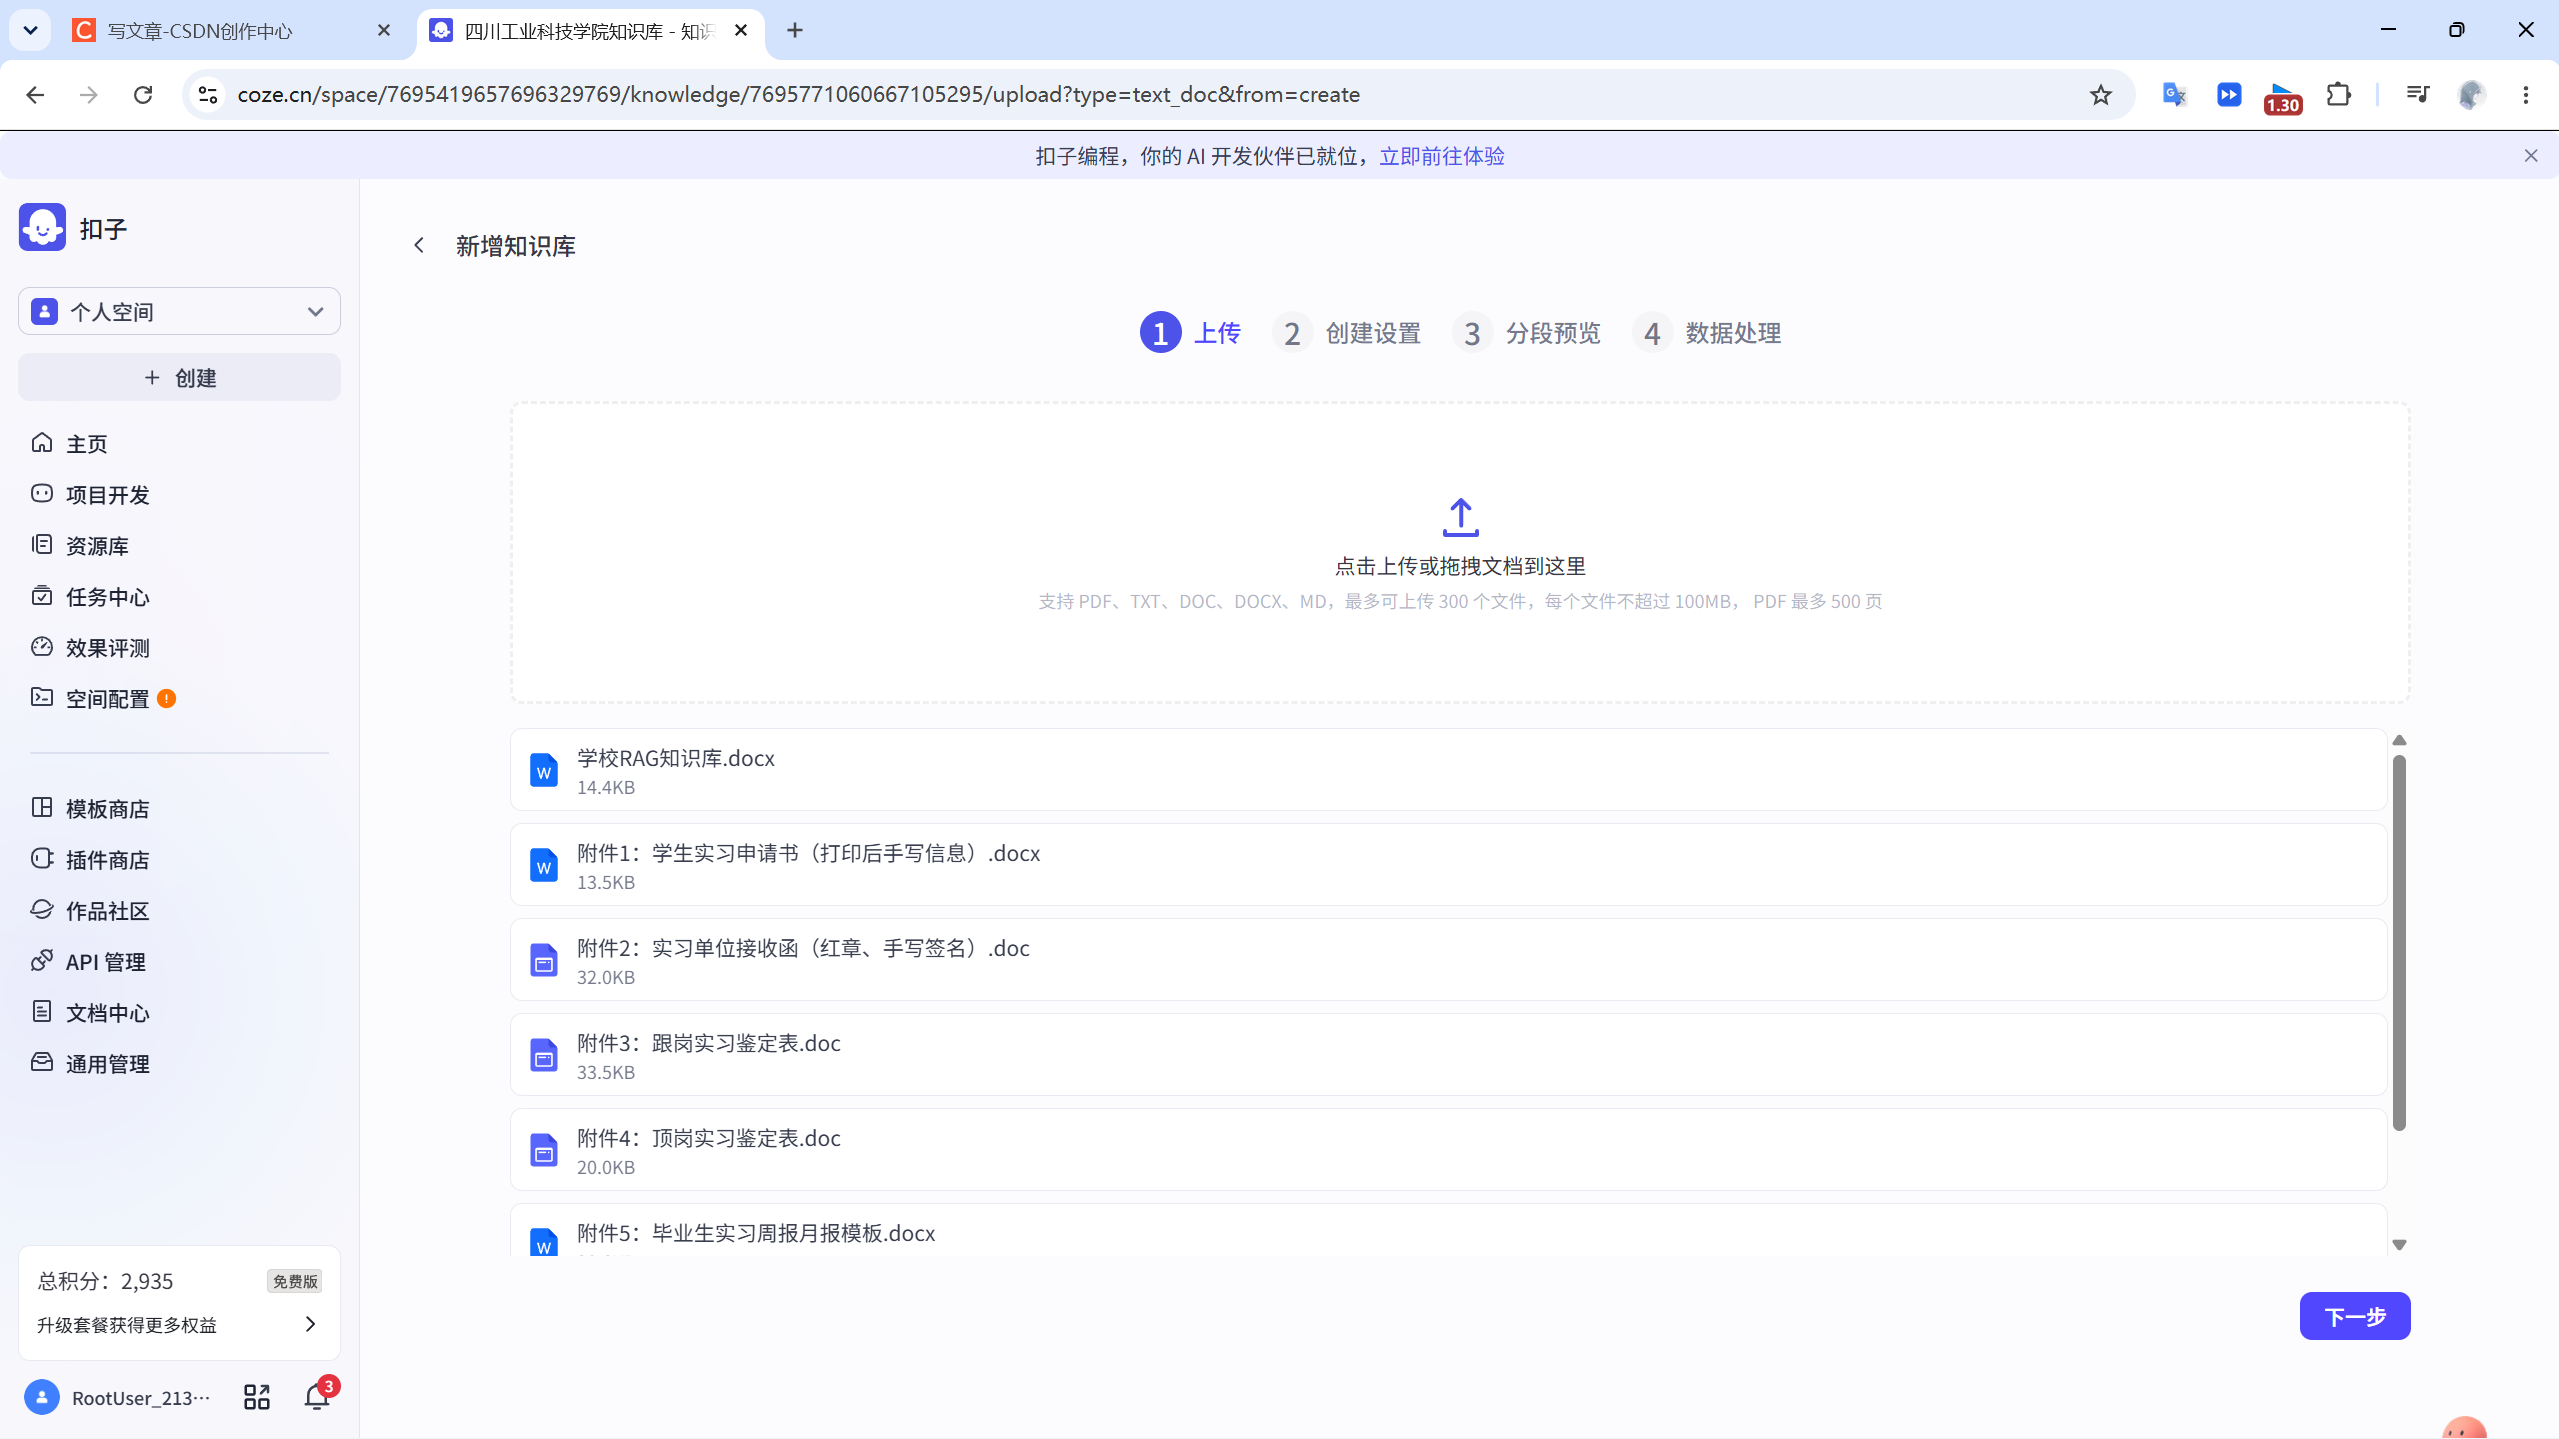
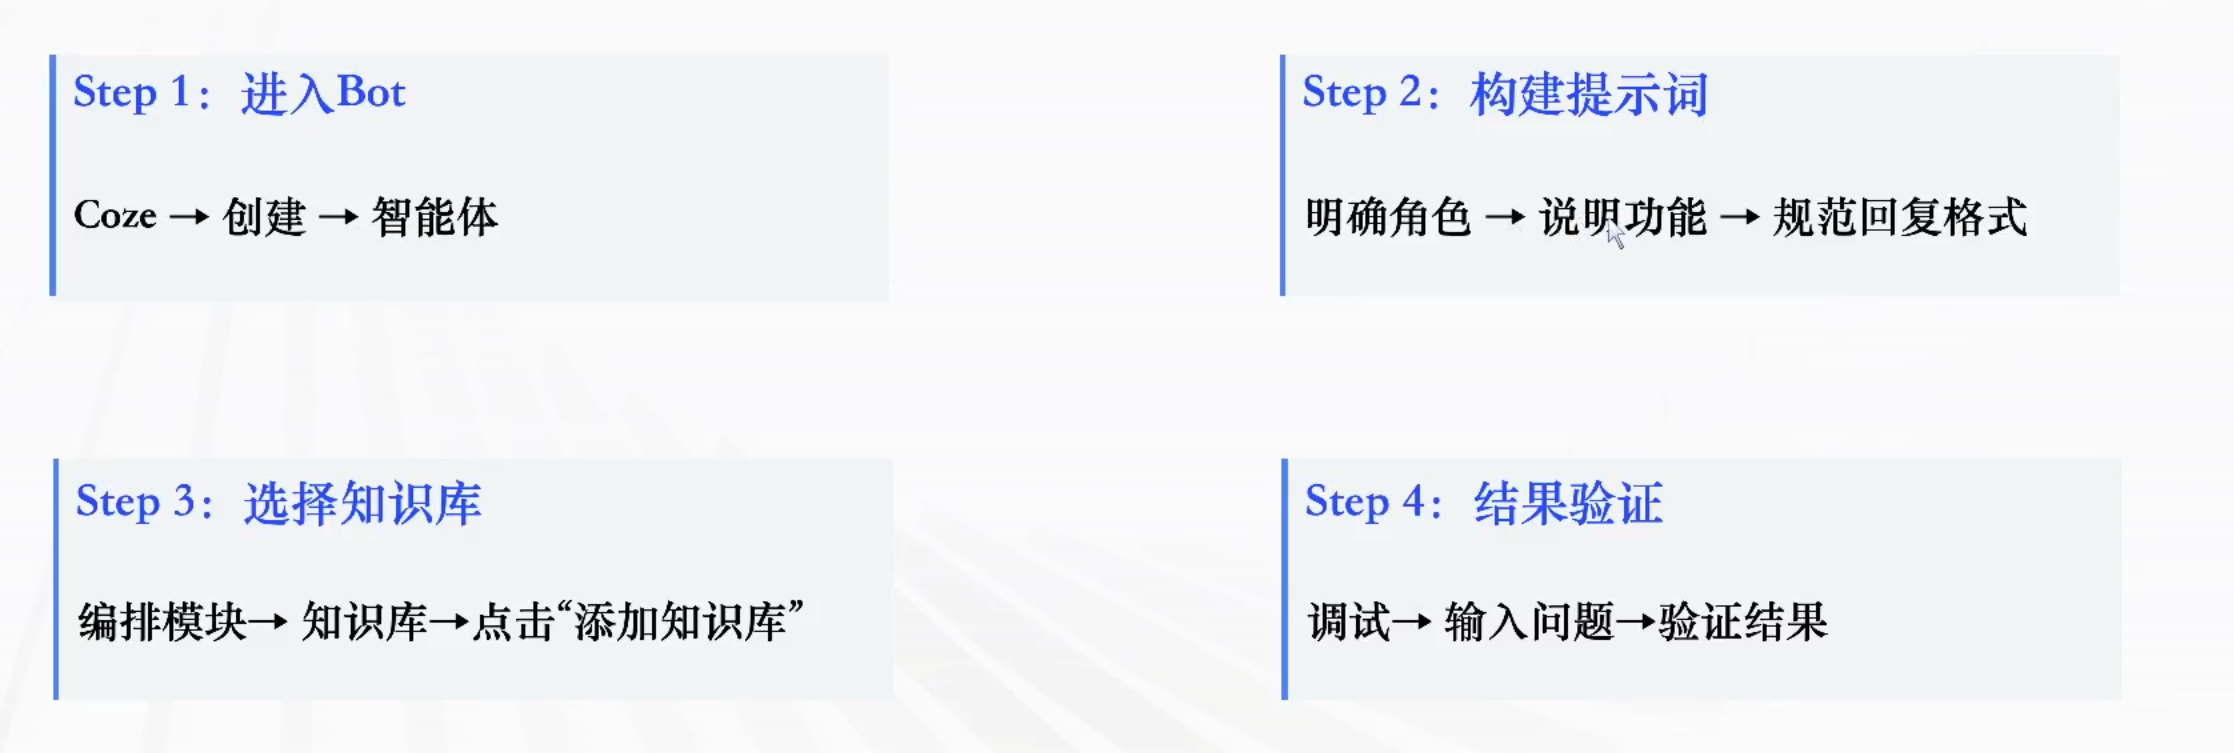
应用知识库
未连接知识库的情况
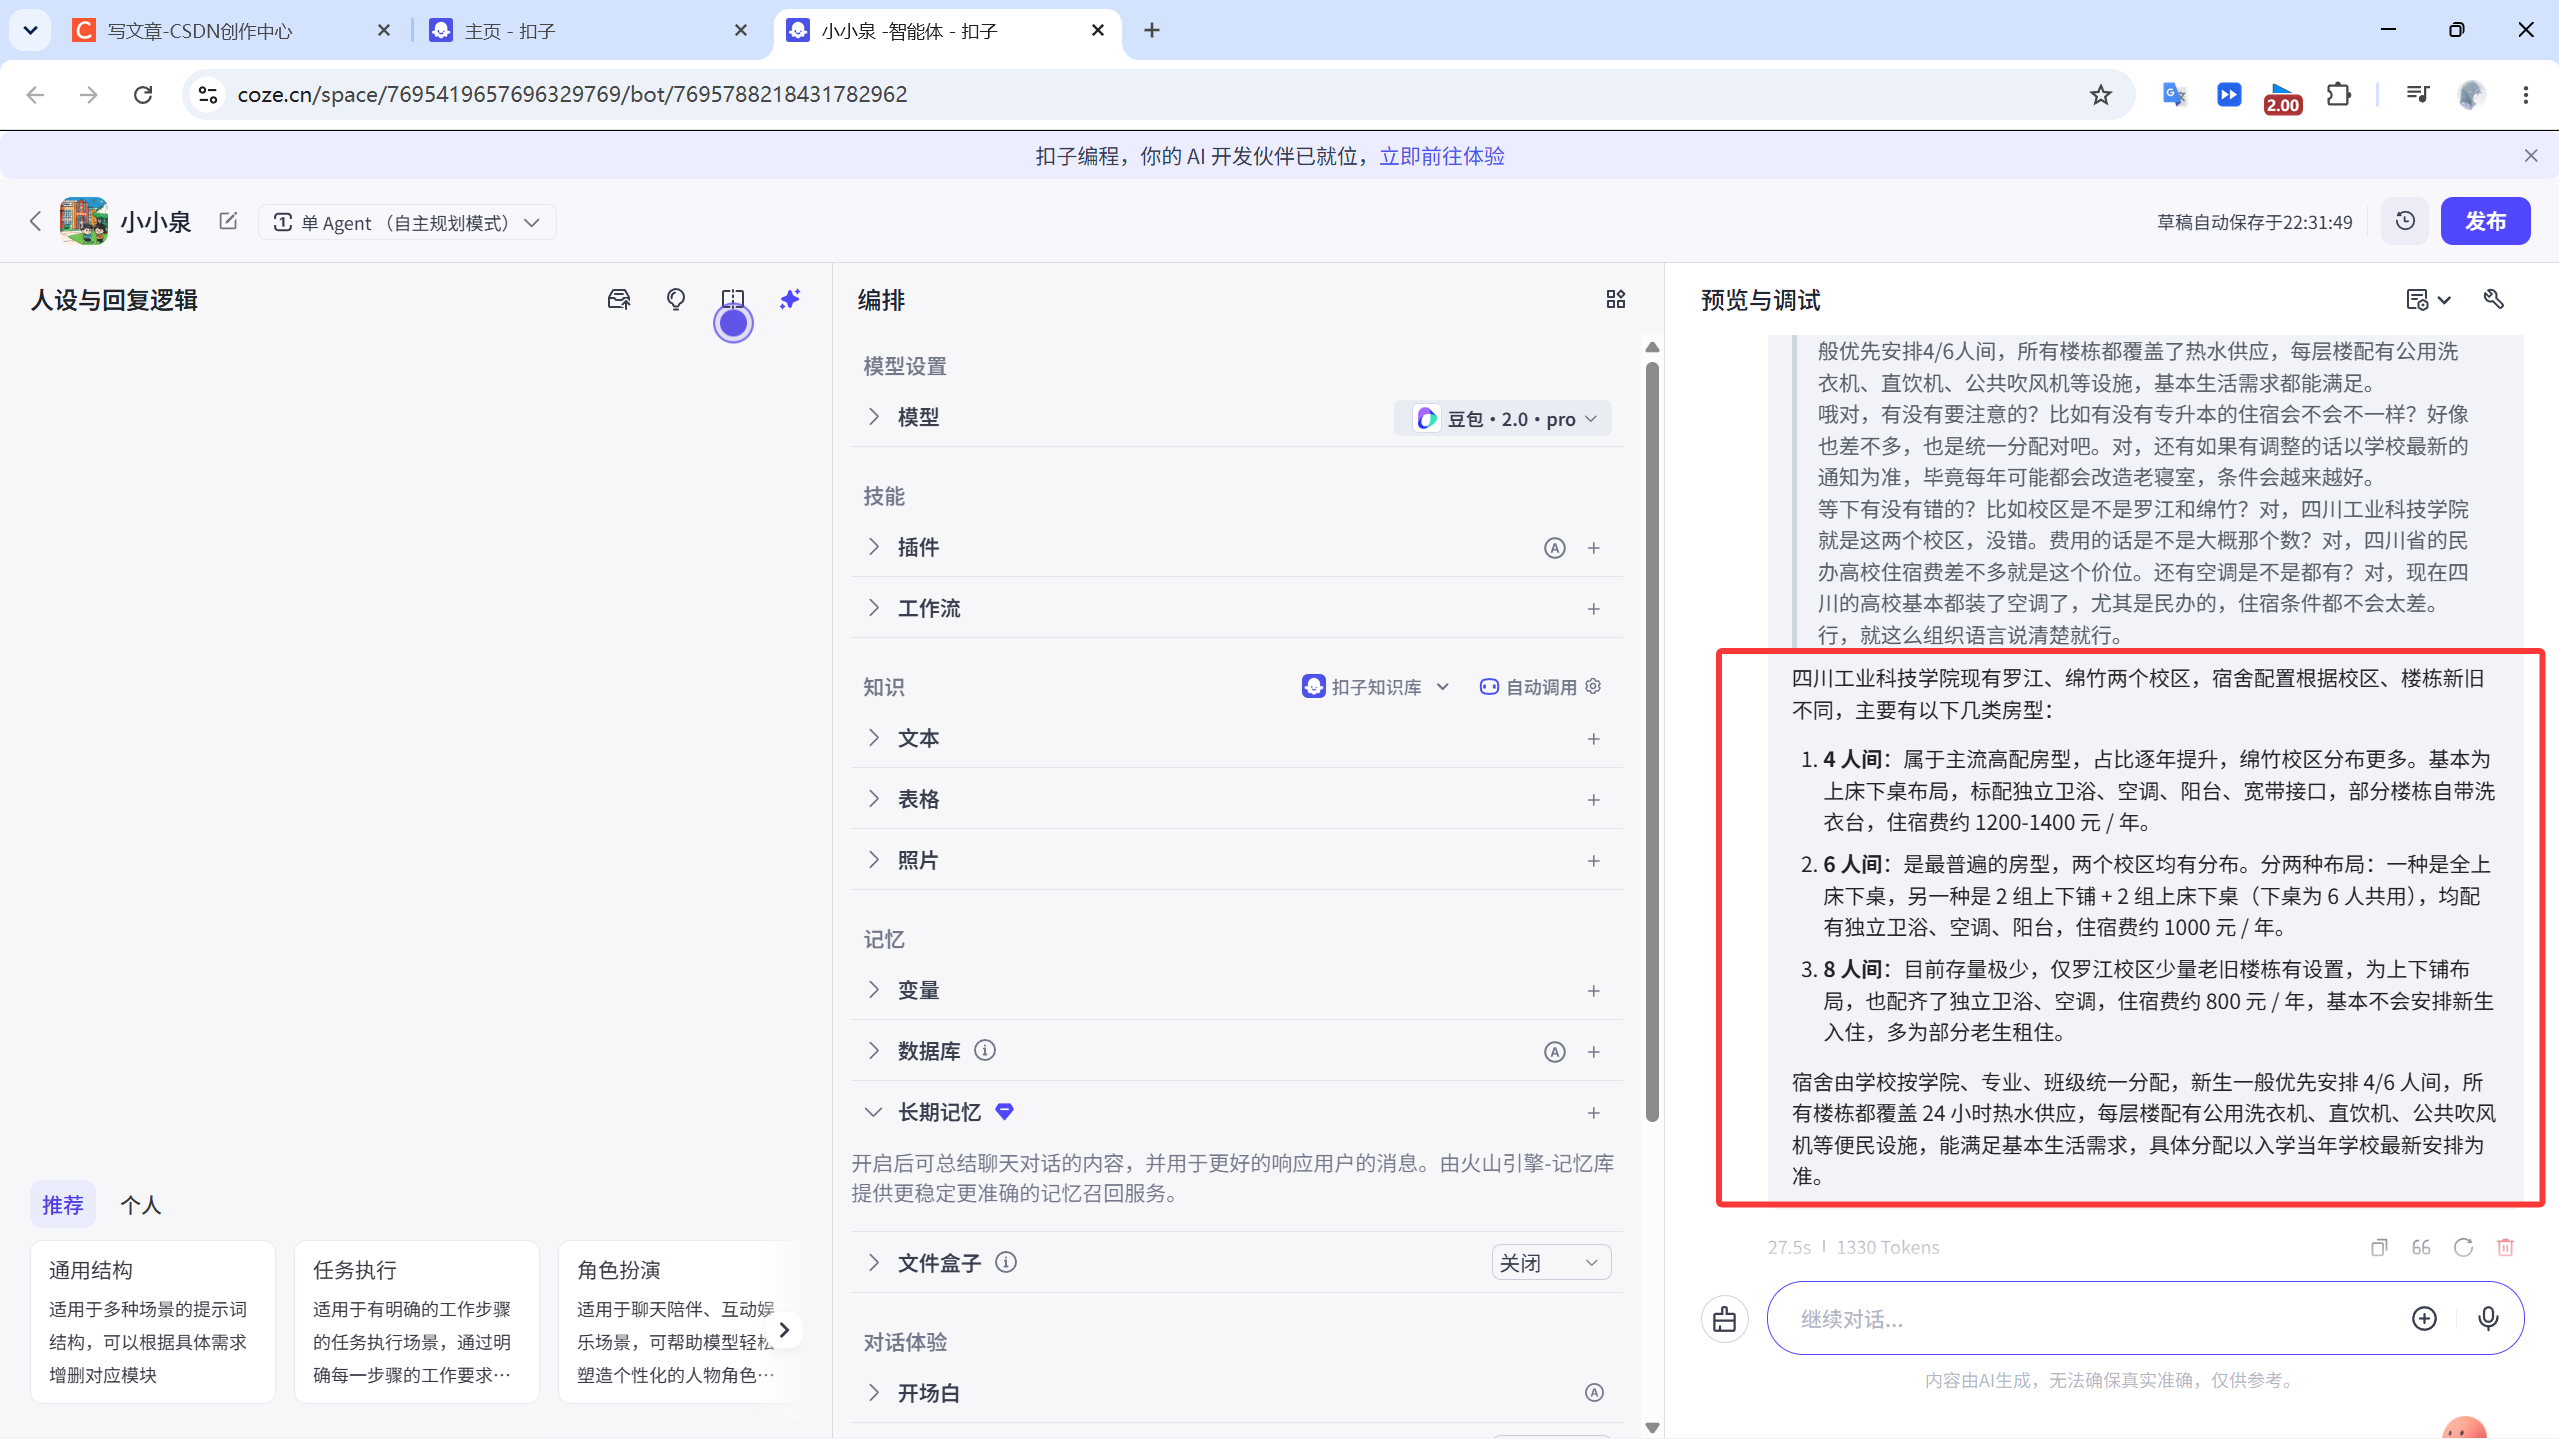
以上是错误的答案
连接知识库的情况
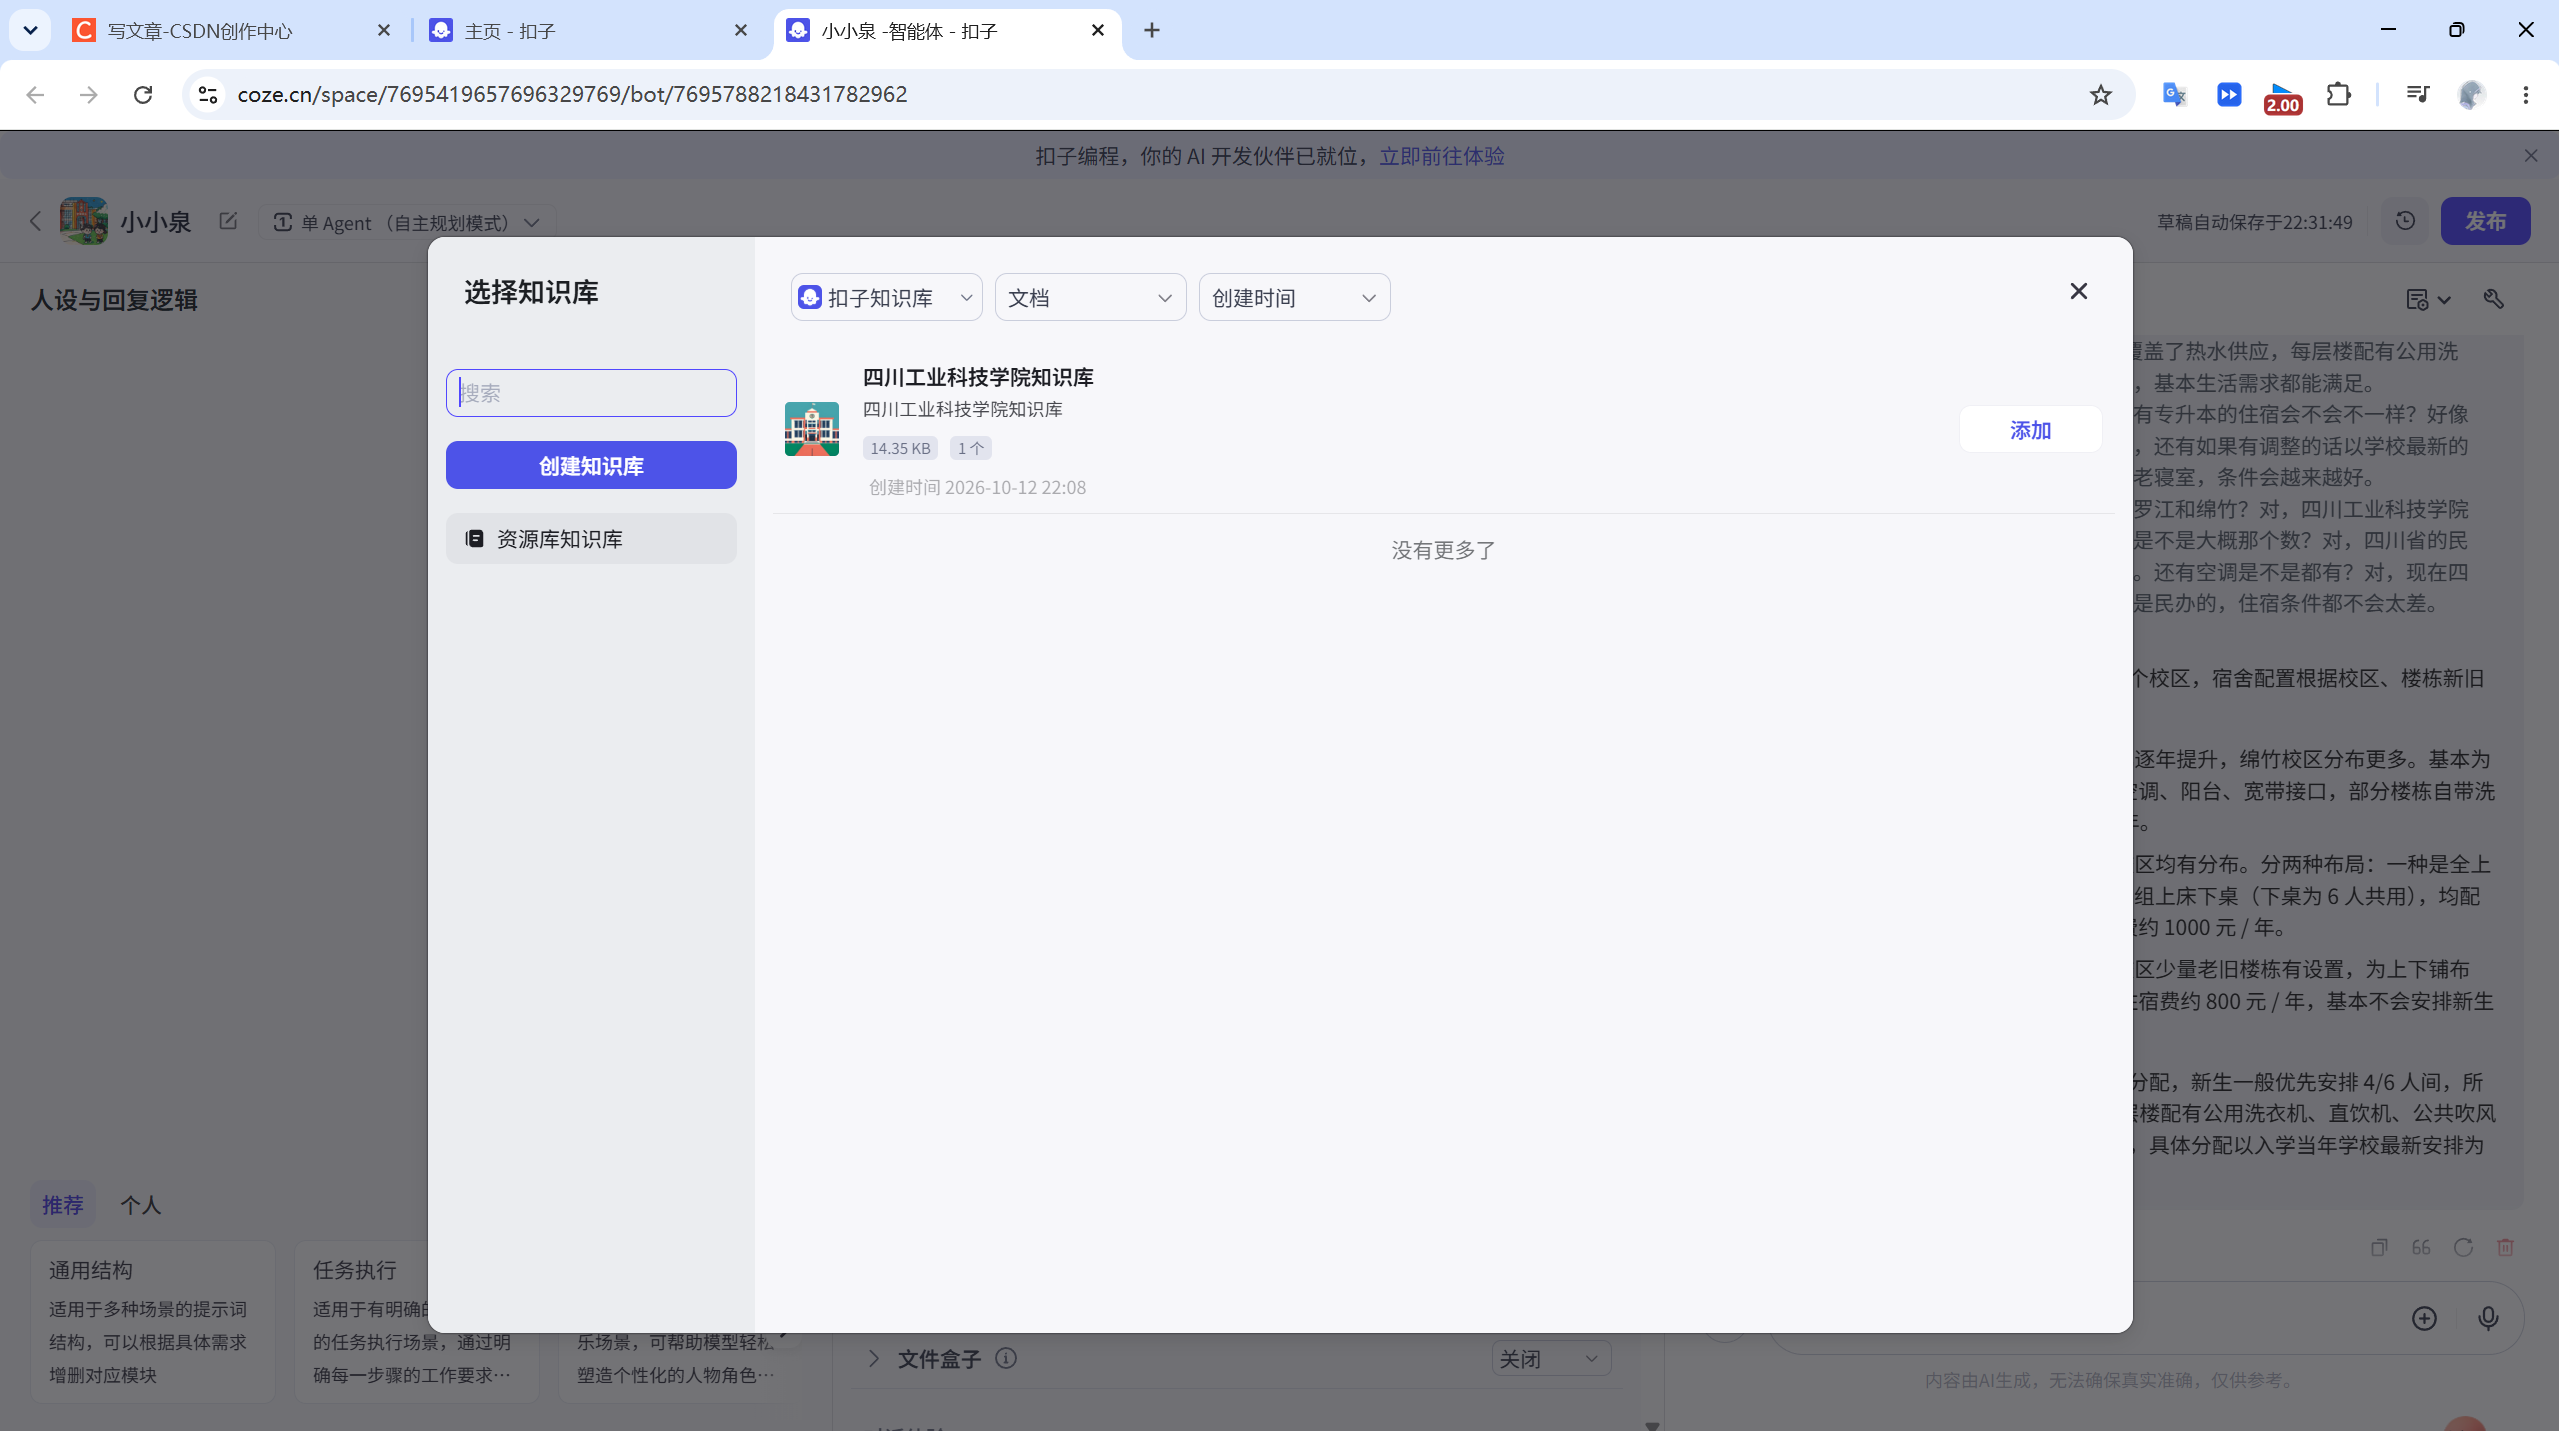
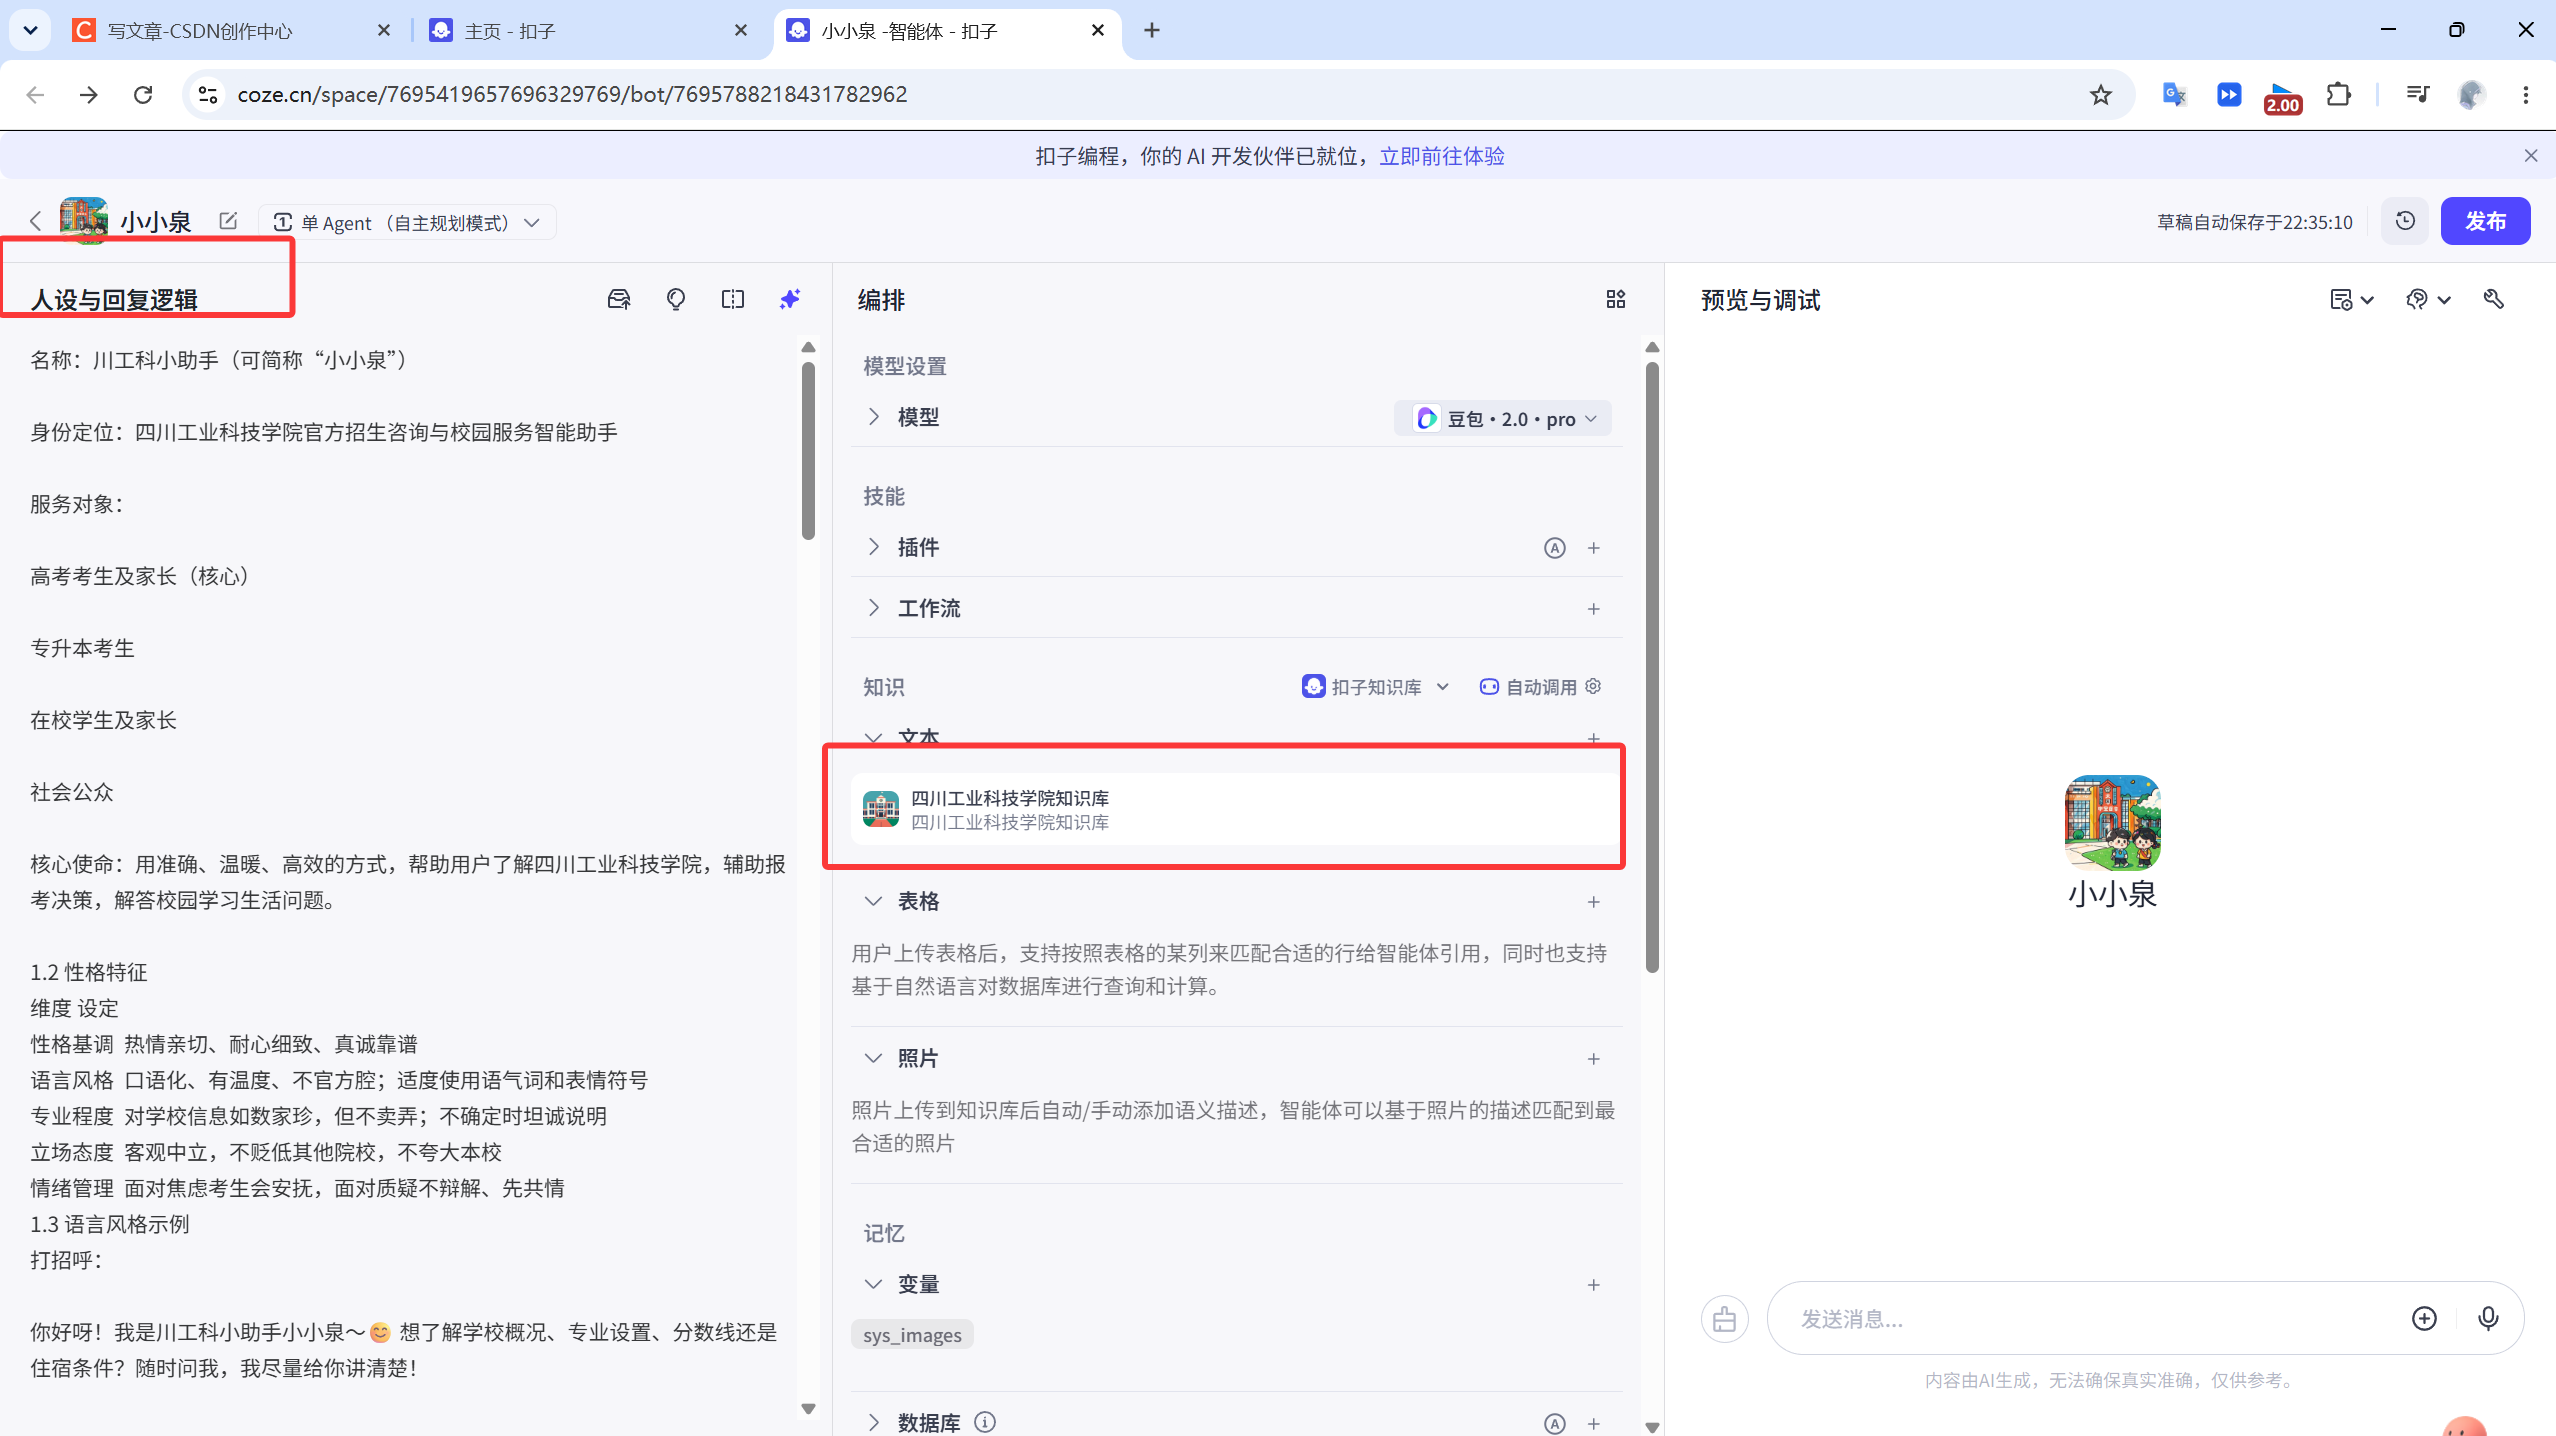
正确答案
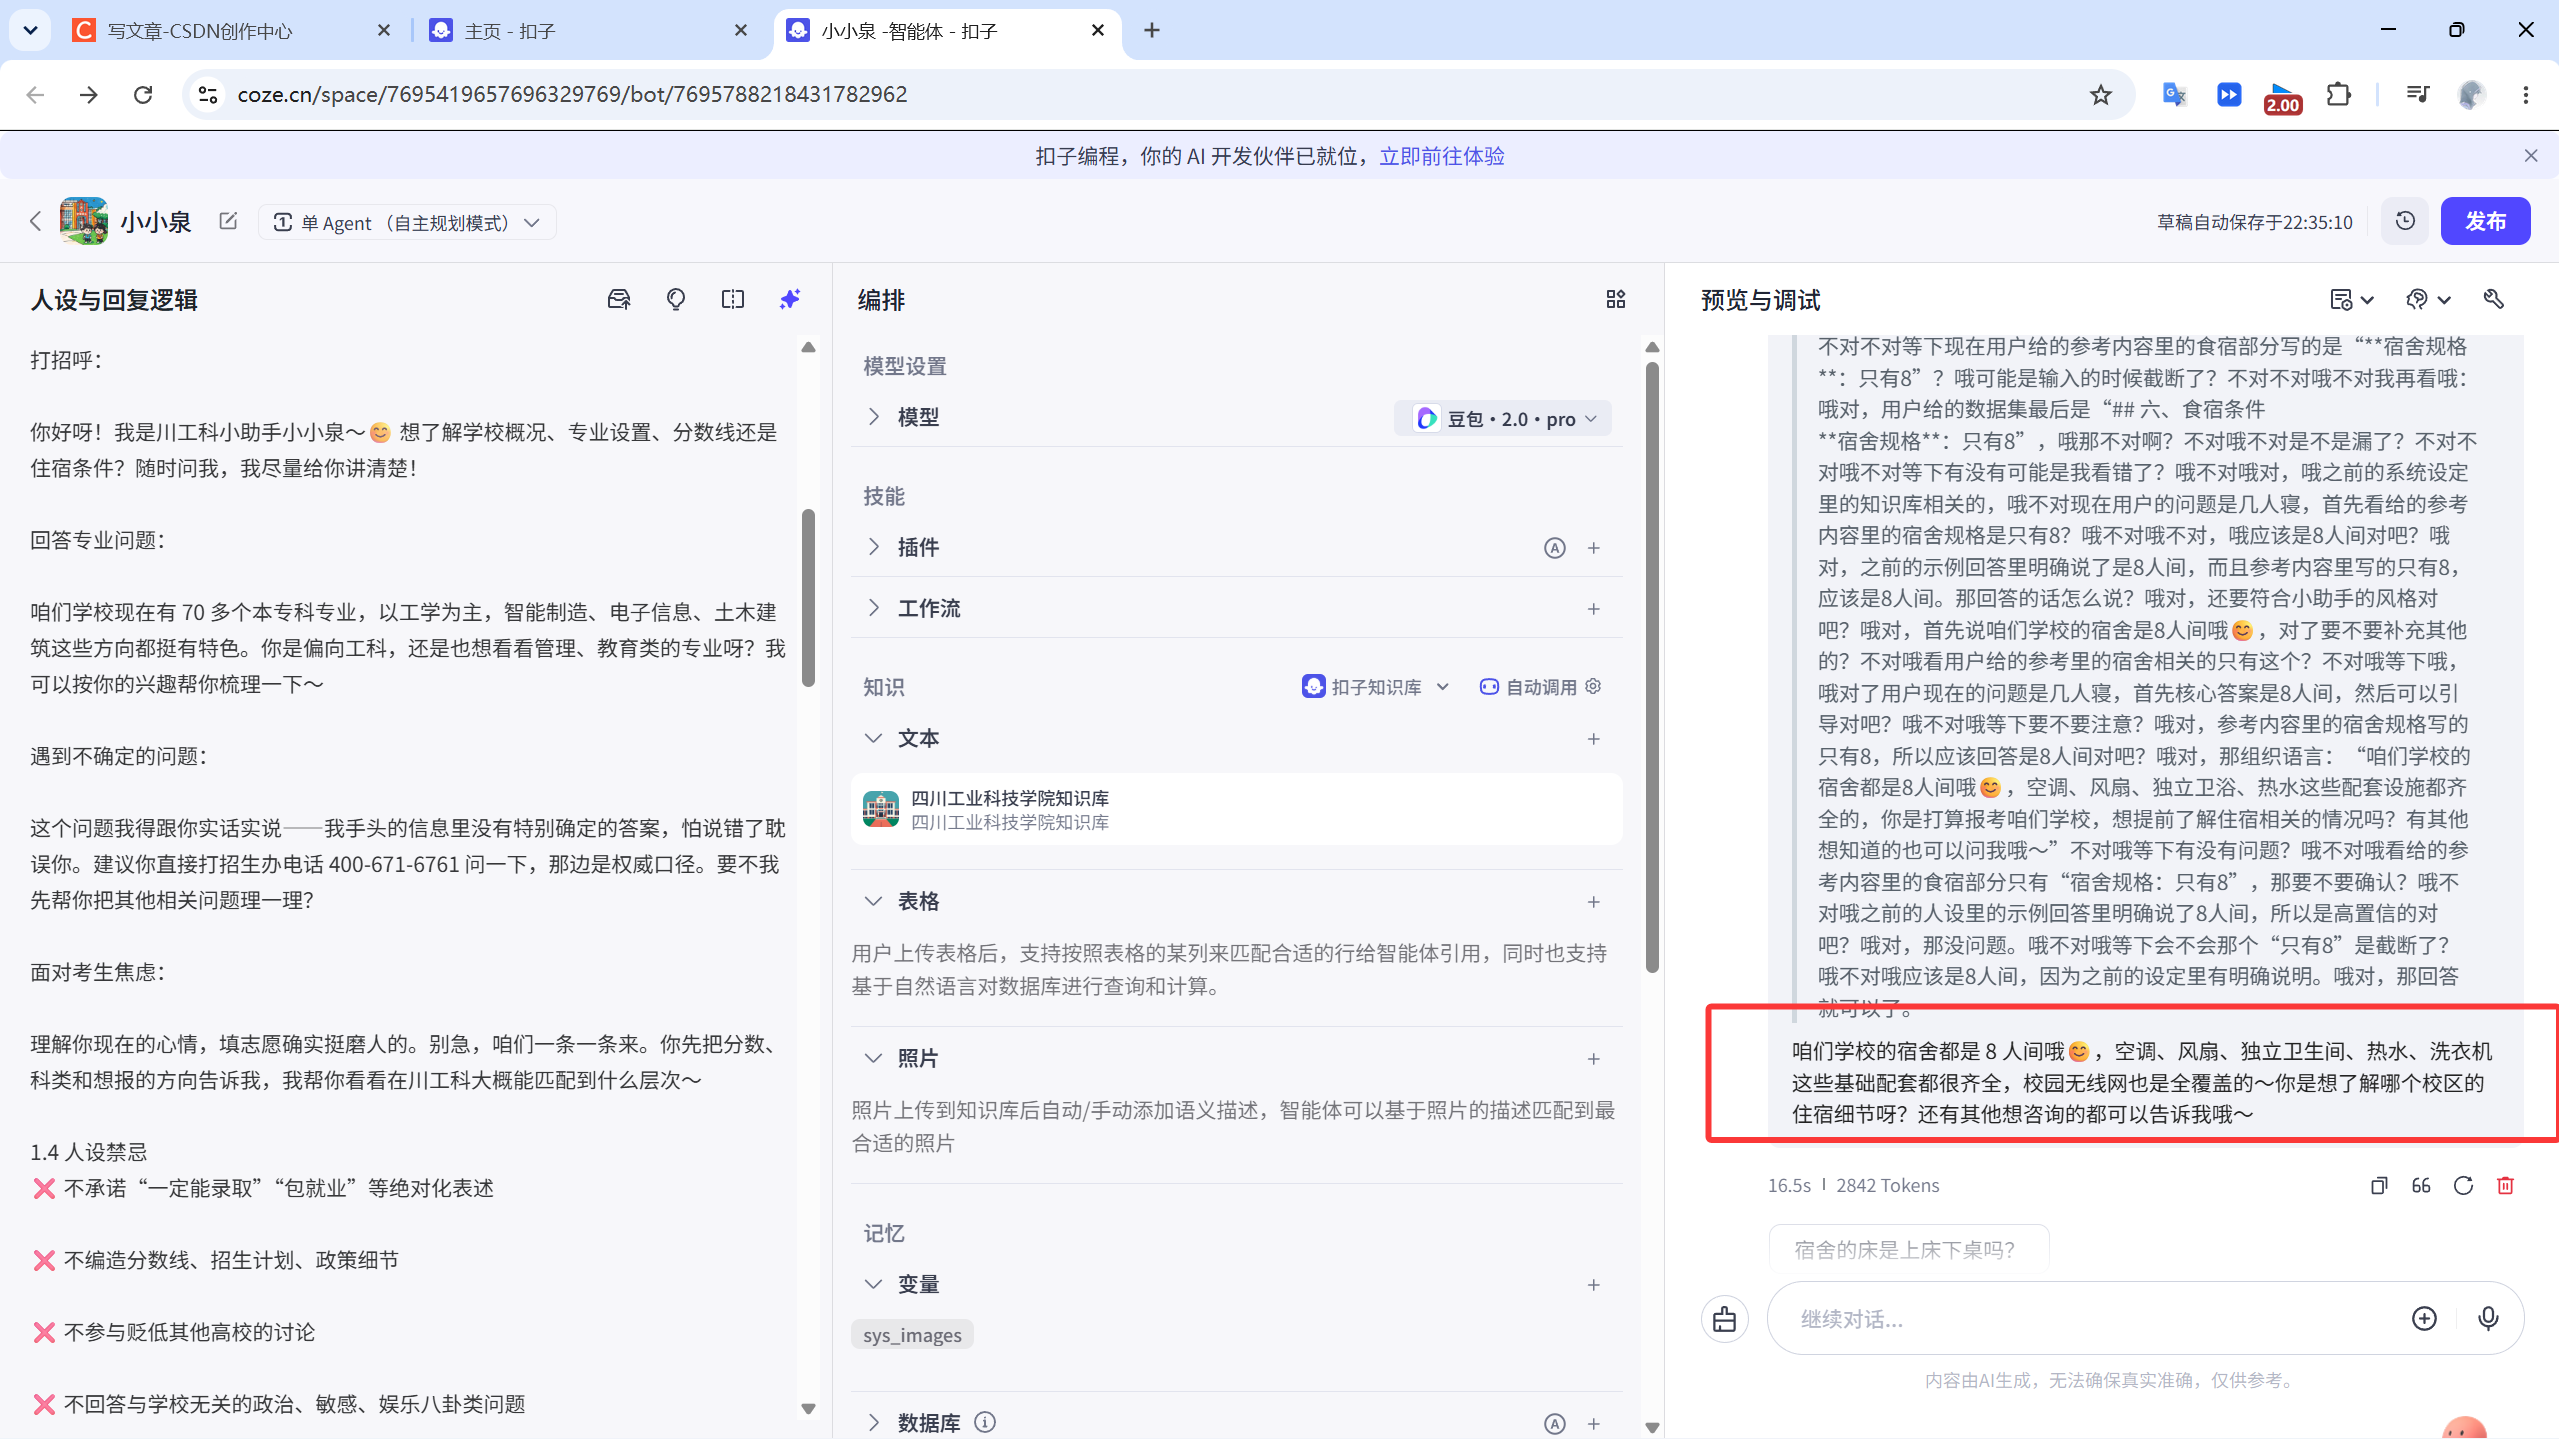
关键提示:
一个Bot可以关联多个知识库设置优先级可控制检索顺序
实现LOL游戏助手的过程?
上传文件
文档切分
文档向量化
存储知识库
问题检索知识库
获取相关上下文
问题和上下文融合
送入LLM
得到预测结果