RESEARCH EXPRESS
TPAMI 2026
DuS-DiFuse · 异构退化鲁棒图像融合
PART 01
核心信息
• 论文名称:Towards Heterogeneous-Degradation-Robust Image Fusion with Controllable Generative Modulation
• 作者:Lei Cao,Hao Zhang,Peng Zhang,Daiguo Zhou,Jiayi Ma*
• 单位:武汉大学电子信息学院;小米 MiLM Plus
• 论文链接:
https://ieeexplore.ieee.org/document/11658665
• 代码链接:暂无
PART 02
问题切入:真实的融合场景不只包含"有噪音"的情况
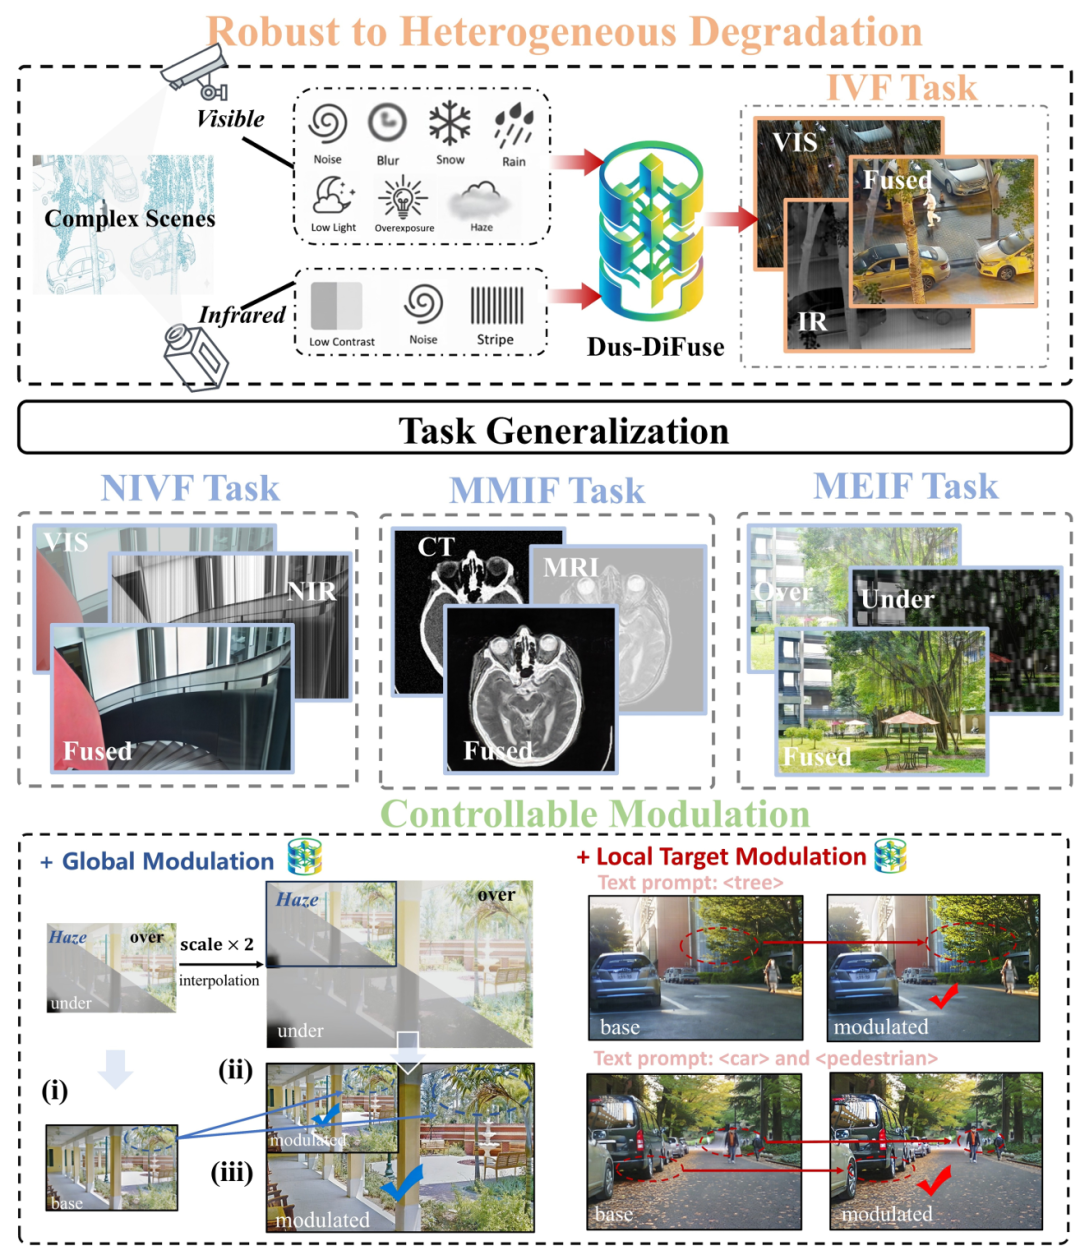
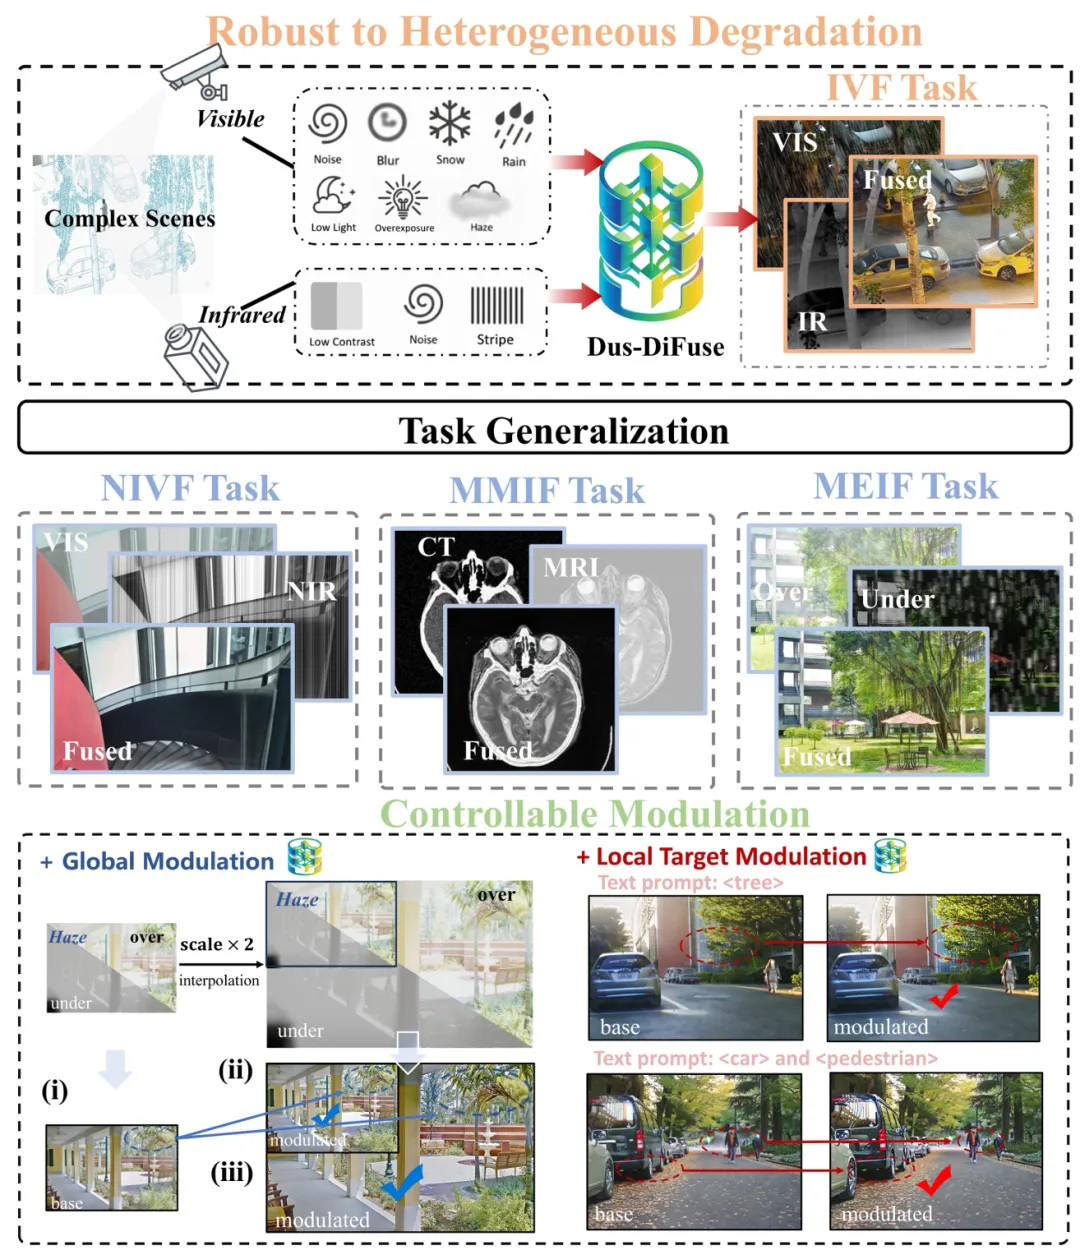
DuS-DiFuse的能力概览------异构退化鲁棒、跨任务泛化、可控生成调制
为什么要做重新的问题定义
传统的鲁棒融合一般把退化看作一个固定的标签:低照度、噪声、模糊等,或者是事先设定好的几种组合。但是论文指出真实的场景更加接近类型不断变化,强度也随着跨级变化,参数还会持续地发生变化,不同的模态会退化得不一样。因此,"先复原、后融合"的简单方式,在两个特征空间中会反复建模,并且还会引入模态偏置。
第二个痛点更为重要:退化到一定程度的时候,并不是只让物体变暗或者变模糊就可以了,还可能会出现语义遗漏(semantic omission)。比如行人的轮廓被雪、雾、低对比度或者压缩伪影所吞没,单纯的加强原有的纹理也不能够恢复已经消失的目标语义。
因此作者把问题写成从退化并且语义不完整输入,映射到退化被抑制、语义更加完整、目标更加明显的融合结果。该定义将"鲁棒融合"从低层恢复到可控生成式语义恢复。
PART 03
总体框架:双流潜空间扩散,把融合、生成和调制、耦合调制耦合起来
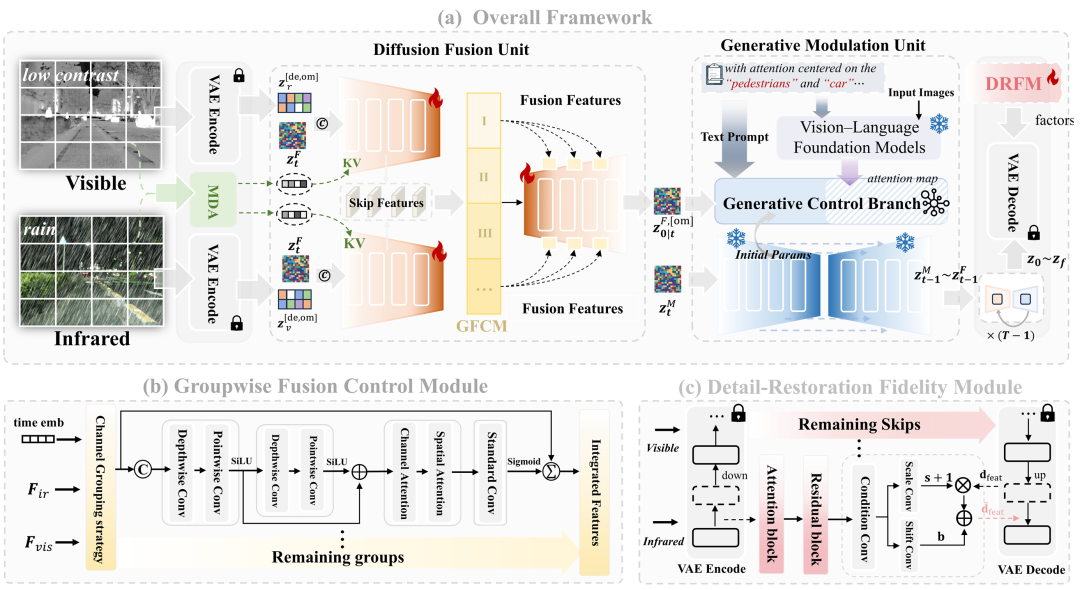
DuS-DiFuse推理架构中包含Diffusion Fusion Unit、GFCM、Generative Modulation Unit以及DRFM
DuS-DiFuse 一张图读懂
主要由两股扩散流构成。第一条是Diffusion Fusion Unit :负责识别退化,在潜空间去退化,并把多源信息在扩散特征层融合;第二条是Generative Modulation Unit调用预训练潜扩散先验,在文本和局部注意图的引导之下恢复语义,并且加强指定的目标。
最核心的设计并不是简单的把两个网络串联起来,而是在于step-wise posterior modulation反向采样每一环节之间相互耦合:融合流首先给出"退化已经被压制下去但是语义仍然不完整"的干净估计,然后作为生成调制流的后验条件;经过调节之后的状态又会反馈到下一道融合更新中去。
退化输入和增强监督分别是从原始多源序列中构造出来的。
因此该模型并不是按照"复原完再融合、融合完再生成"的三段式流水线来工作的,在同一个反向轨迹中一起进行优化退化去除、信息聚合和语义恢复。
PART 04
方法细节:MDA+GFCM+生成式调制+DRFM
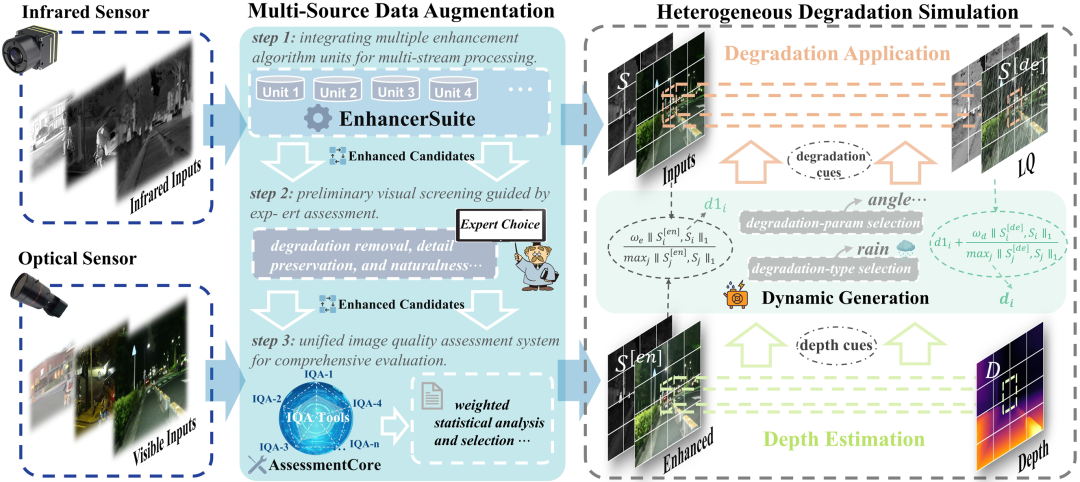
异构退化数据生成。增加分支可以得到比较干净的监督,原始序列上叠加动态退化生成训练输入
四个关键模块
① MDA:使CLIP先学会"理解退化"。作者在CLIP视觉编码器之后接分类头、回归头:分类有13个类别,退化程度不同,回归退化的程度也不同。经过微调之后的MDA给潜扩散提供了退化的类型和强度的先验信息。
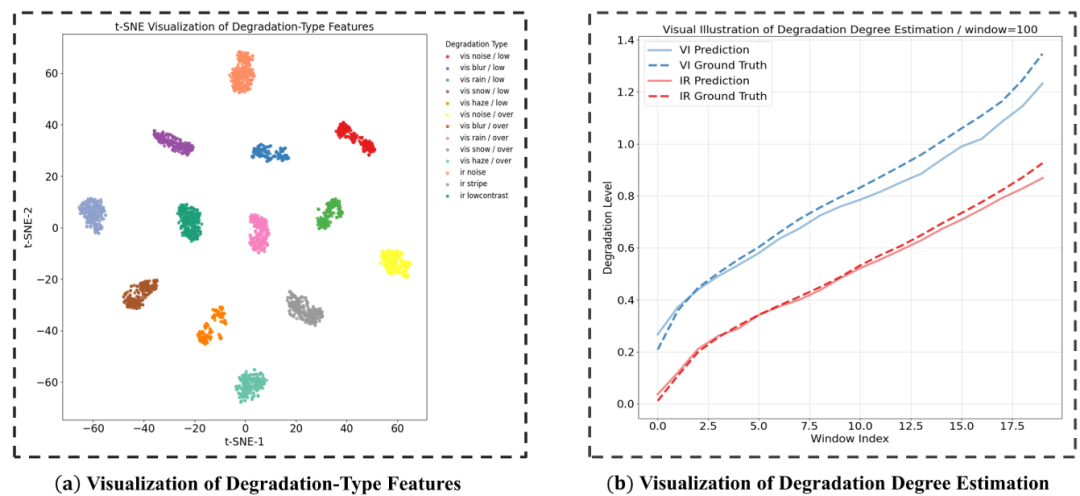
经过微调之后CLIP特征的退化类别聚类和强度响应
Diffusion Fusion Unit 使用v-parameterization把噪声和干净潜变量组合成一个速度目标
② GFCM:在相应的尺度上进行组间的融合。可见光和红外扩散特征被分到K组里,每一组都是FusionControlBlock聚合之后再送入解码器进行预测融合方向。相比于mean/max或者直接FCM,分组对应尺度的融合可以更好的保持一致的反向轨迹。
GFCM中组级别的特征聚合
给每一个clean estimate施加梯度、像素以及结构一致性的约束
③ Generative Modulation:把文本指定的目标"补回来"。视觉-语言基础模型首先生成局部attention map,然后把指定的目标区域保留下来,并且把其他区域设置为语义退化上下文,让扩散分支学会定向恢复。
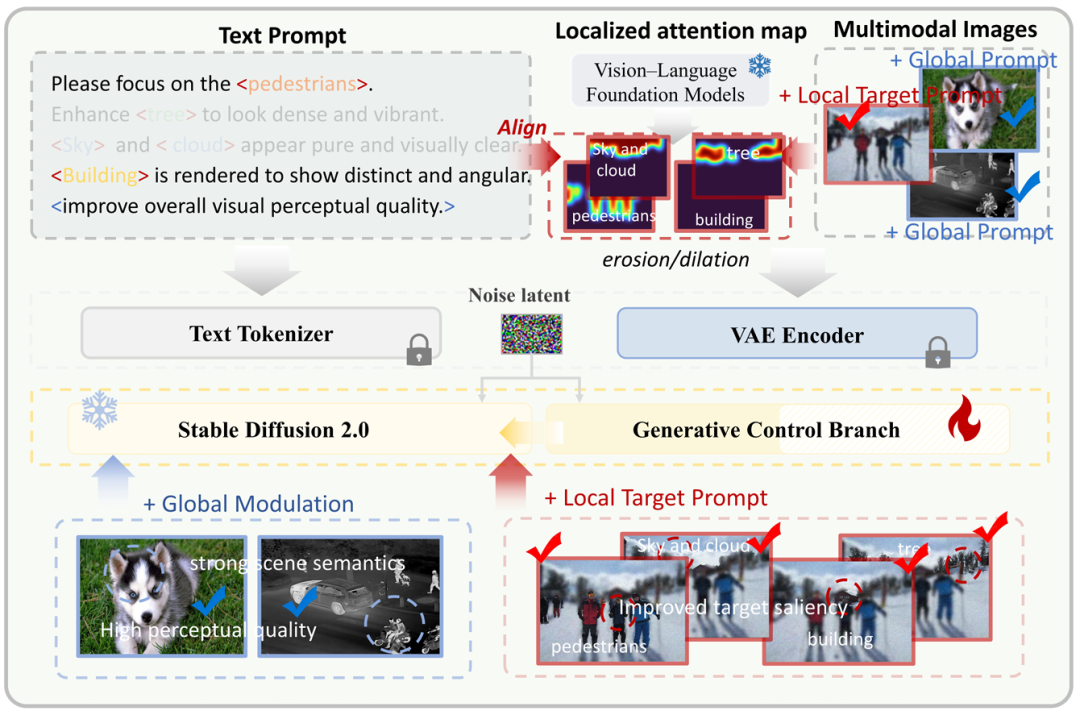
文本提示、局部注意图和生成式控制分支的整体机制
式(19):局部目标调制训练目标。
式(22):融合流的clean estimate用作生成调制的后验条件。
④ DRFM:补偿VAE解码过程中所造成的纹理缺失。从多个源图像的VAE编码器中提取出多层skip features,并经过注意力以及残差块来生成条件特征,然后再用SFT对解码特征进行缩放和偏置调制。
式(25)中DRFM对VAE解码特征空间上的特征变换。
这四个模块各司其职:MDA 负责识别退化,GFCM 负责融合,生成调制负责语义,DRFM 负责细节。
PART 05
实验:同一个模型去完成四个不同类型的融合任务,并且还要承受真实的退化
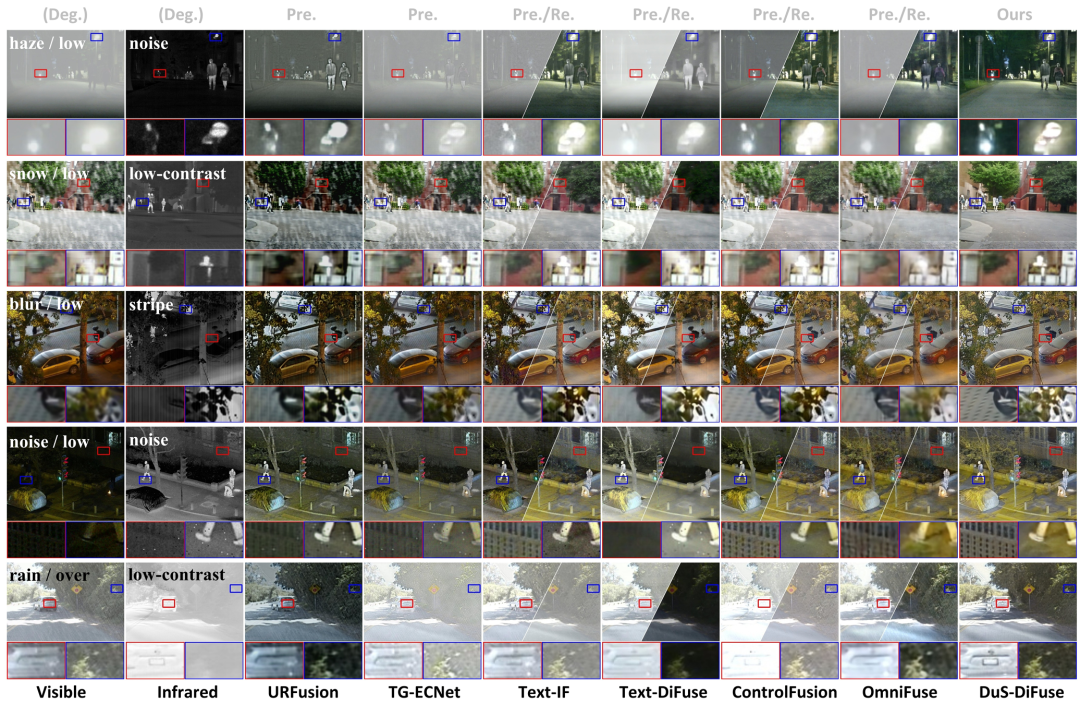
在红外-可见光复杂的退化情况下进行定性的比较
不仅仅是在IVF上做漂亮的图片
训练分为三个阶段:首先对Diffusion Fusion Unit进行训练,然后对Generative Modulation Unit进行训练,最后只对DRFM进行训练。退化鲁棒融合训练集来源于LLVIP、MSRS、RoadScene一共2084对;生成语义恢复部分从ImageNet、COCO、LLVIP清洗得到大约115 万张图片。
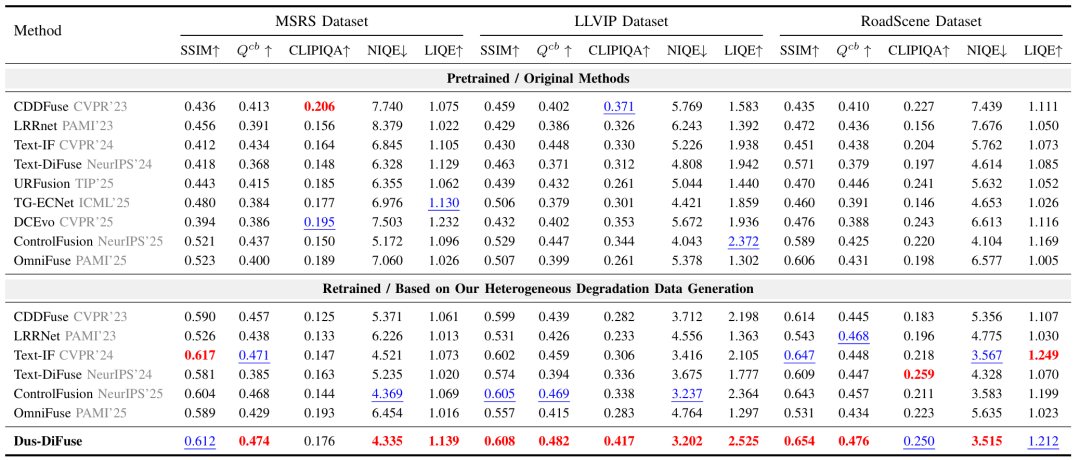
Table I:MSRS、LLVIP、RoadScene 复杂退化下的定量结果。
在 IVF 方面,DuS-DiFuse 在三个数据集的 SSIM/Qcb 上都保持了领先或者处于第二梯队的地位;LLVIP上CLIPIQA达到0.417 、NIQE 为3.202 、LIQE 为2.525。更进一步的是,作者对于可训练基线又使用了相同的异构退化生成流程进行retrain,从而避免了只和"原始模型"做不公平比较的情况。
在跨任务方面,模型不进行任务专用重训就直接进入到NIVF、MMIF、MEIF。在SICE多曝光任务中,DuS-DiFuse的SSIM/Qcb/CLIPIQA/NIQE分别为0.523/0.382/0.492/3.405;Nirscene上SSIM值为0.809,NIQE值为3.492。
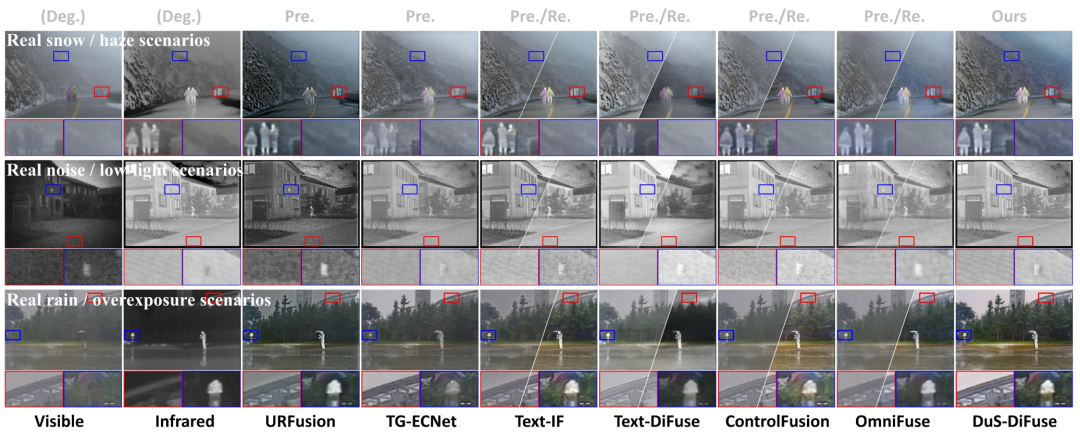
AWMM-100k、TNO、M3FD的真实退化场景对比
在真实的雪/雾、低光照噪声、过曝雨天等场景中,DuS-DiFuse依然表现得非常稳定。这里的并不是说哪一个指标得了第一名不是因为不同的退化、不同的任务以及真实的场景中都没有明显的失效。
PART 06
生成调制到底有没有用呢?从全局质量以及下游任务的角度来考虑
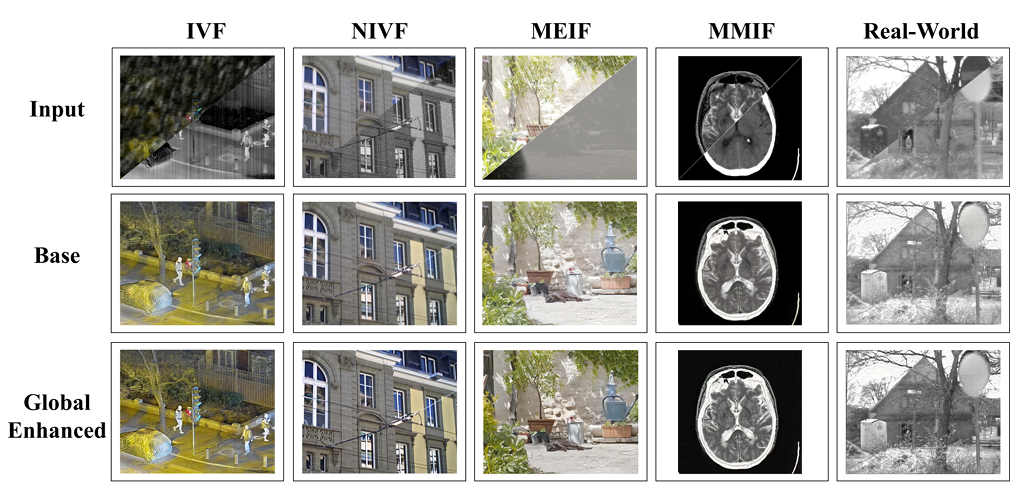
全局生成调制前后,多个融合场景的视觉变化
由"好看"转为"可感知"
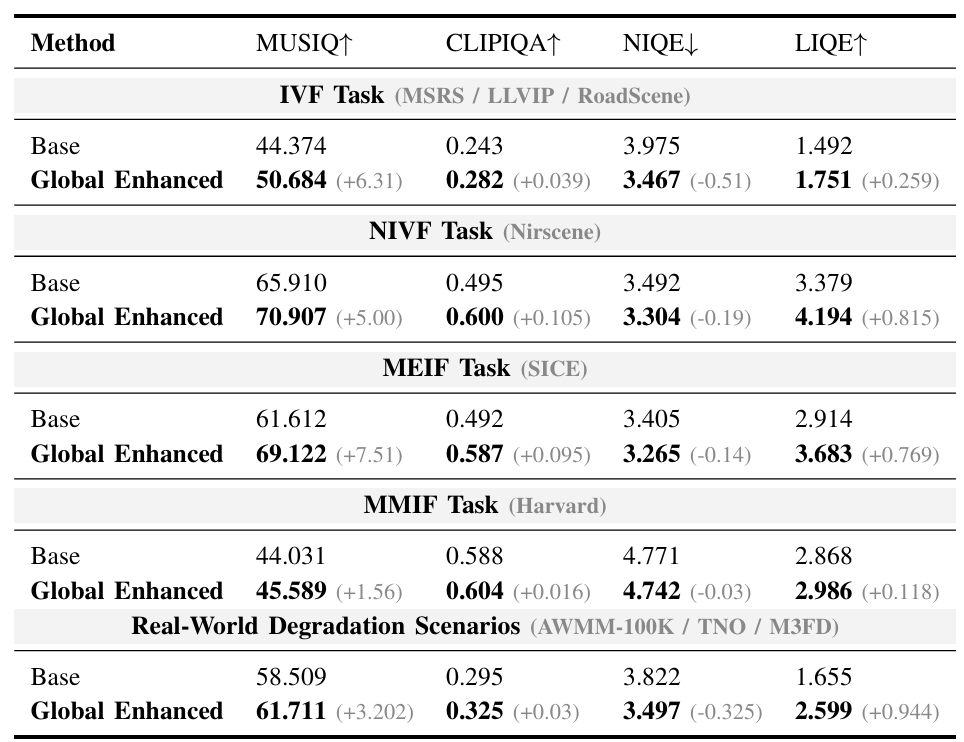
全局调制前后无参考感知指标的变化
Global Enhanced 在所有的任务中都会提高MUSIQ、CLIPIQA、LIQE,并且降低NIQE。比如 IVF 的 MUSIQ 由 44.374 升至50.684(+6.31) ;MEIF 由原来的 61.612 提高到了69.122(+7.51)。因此生成先验不仅对局部目标有效,而且可以提高整个自然度以及细节的表现。
局部调制会比较有趣一些。在给定"Please focus on pedestrians/cars"的提示之后,模型利用attention map对指定区域进行生成式的语义恢复。作者不仅展示了热力图,还继续对YOLOv5和SegFormer进行下游任务的训练。
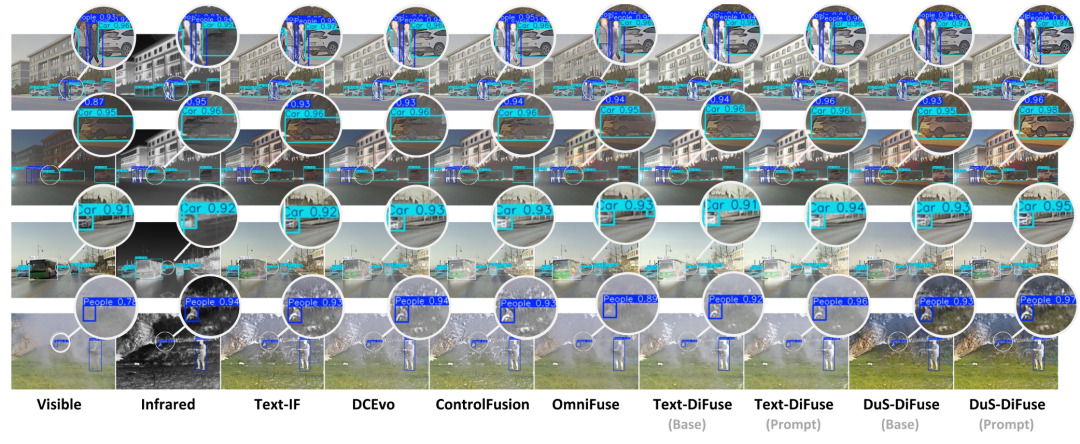
目标检测可视化。Prompt 版本进一步提高目标语义完整性和检测置信度。
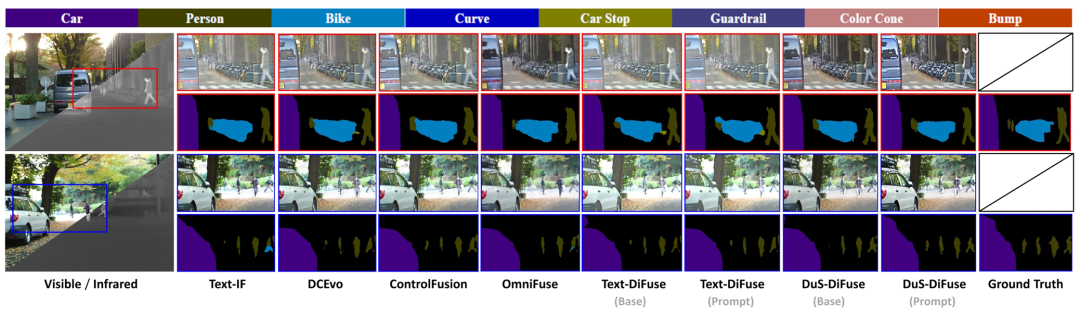
语义分割可视化。Prompt 版本对于车辆、行人、自行车等目标的结构更加完整。
在目标检测中,Ours(Prompt)的mAP@0.5/mAP@0.5:0.95达到0.804/0.542=1.46;语义分割mIoU达到**57.24%**增幅不大,但是方向很重要:文本调制不光是把图像"调亮",而且在一定程度上使下游更容易找到目标。
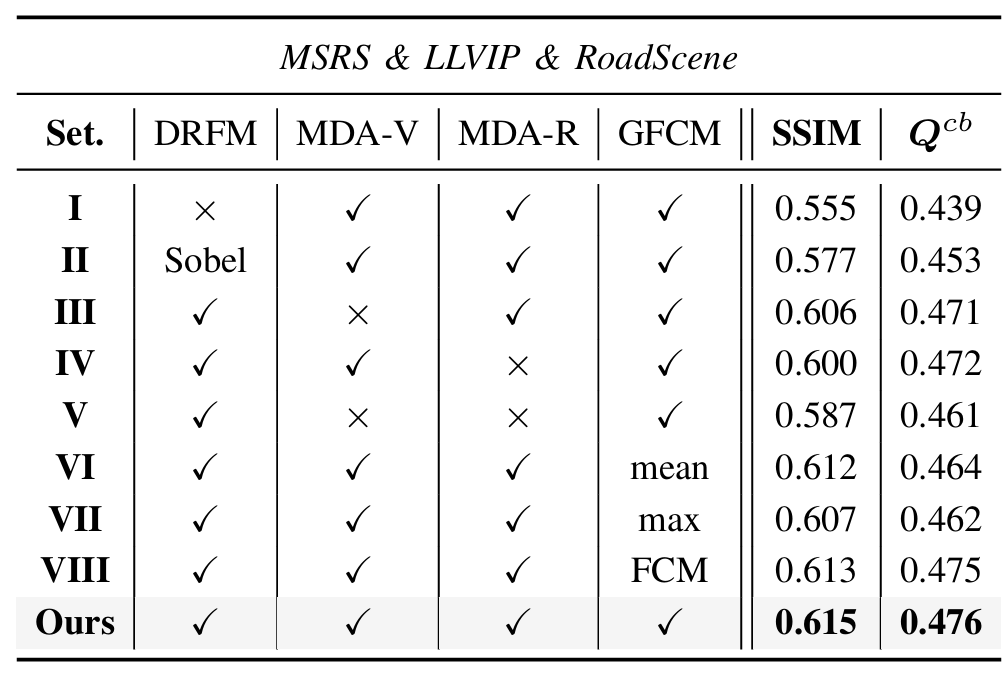
Table VII:DRFM、MDA 和 GFCM 的消融。完整的模型SSIM/Qcb=0.615/0.476。
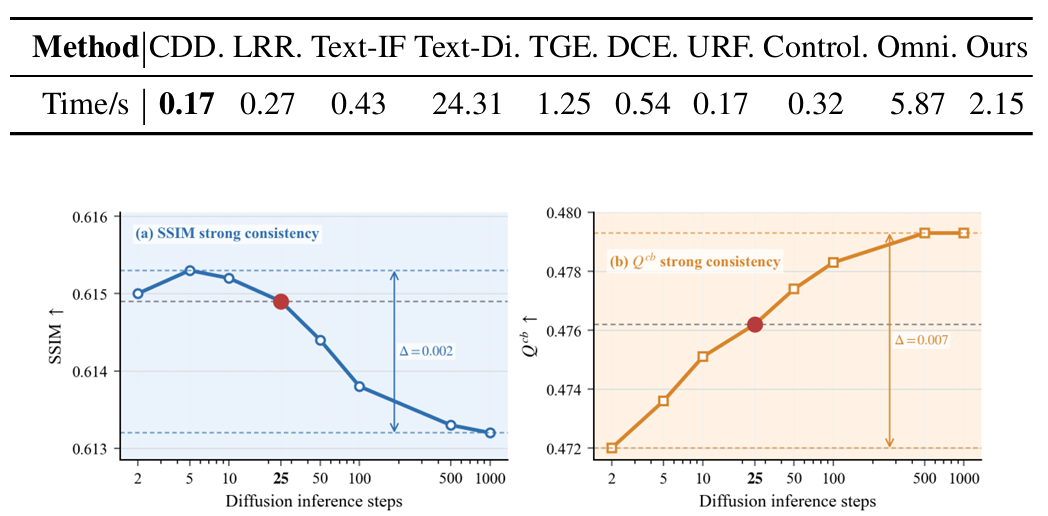
推理效率和扩散步数的分析。默认25步,结构/纹理指标对于步数比较稳定
消融也将模块职责拆分得很清楚:去掉DRFM之后细节保真降低;去掉MDA之后就出现了模态特异退化残留;把 GFCM 改为 mean/max 会使融合的质量降低。从效率的角度来看,在 480×640 的 100 套图像基准中 DuS-DiFuse 平均2.15秒/对比轻量级CNN要慢一些,但是比Text-DiFuse(24.31s)、OmniFuse(5.87s)都要快得多。
PART 07
该项工作的意义在于把"鲁棒融合"向前推进了一步,即生成式恢复
总结
DuS-DiFuse 想要让图像融合模型能够在真实的复杂场景中同时具有退化能力、融合能力和语义恢复能力不是把它们拆分成互相不通的孤立模块。
它最值得重视的地方有两点。第一,异构退化训练和MDA先验 使模型由"固定的退化配方"向更加动态化的类型、强度和参数组合转变;第二,生成式调制把传统的损失加权或者局部增强的方式推到"恢复缺失语义"这一层面上来。
但是这样的方法也存在一定的成本:扩散推理仍然比轻量融合网络慢一些,生成式恢复需要特别注意语义真实性和幻觉风险。论文用下游检测/分割以及多任务实验给出积极证据,在安全关键场景下,未来还需要更加严格地验证生成行为,并且要设置更为严格的可验证生成约束。
从整体上看,本文对"真实世界鲁棒图像融合"的能力进行了重新定义:不仅需要融合可见的信息,还需要识别退化、恢复被遮蔽的语义,并且允许用户用文字来控制恢复重点。
往期推荐