文章目录
题目链接:LCR 114. 火星词典
题目解析
拓扑排序 (Topological sorting )要解决的问题是 如何给一个有向无环图的所有节点排序。
有向无环图 (Directed Acyclic Graph, 缩写 DAG),是一种 边有方向且没有环形结构的图结构。
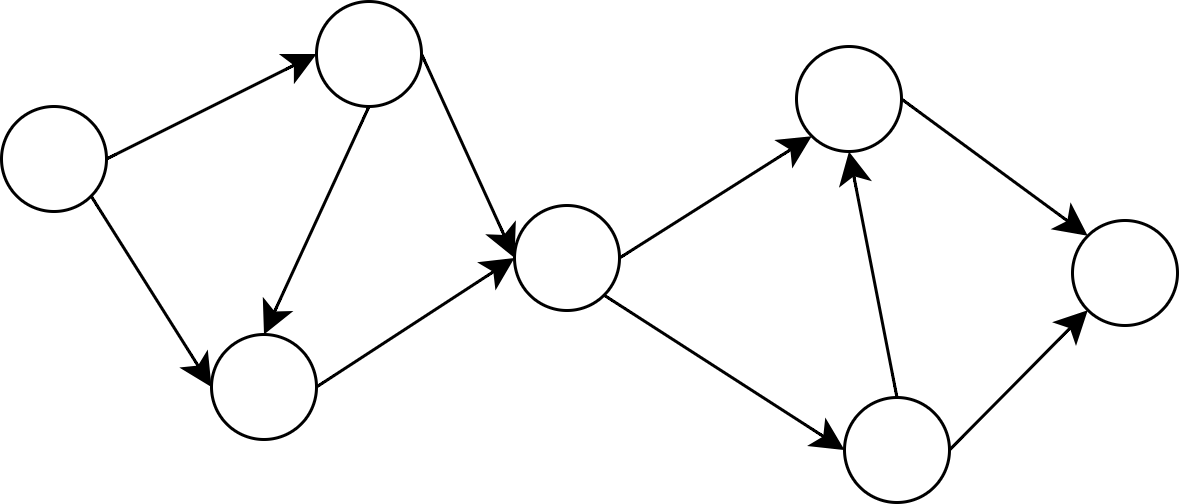
拓扑排序的起始点是 顶点(入度为0的节点),将顶点排序完毕后,从该顶点发出的有向边全部会被删除,这使得被指向的节点的入度数会减1,当入度数为0时这个节点就成为新了的顶点,然后下一轮从该顶点开始排序,以此重复,直到没有顶点为止。
- 入度:表示指向某节点的有向边数量,
- 出度:表示从该节点发出的有向边数量
构造拓扑序列步骤:
- 从图中选择一个入度为零的点
- 输出该顶点,从图中删除此顶点及其所有的出边
重复上面两步,直到所有顶点都输出,拓扑排序完成,或者图中不存在入度为零的点,此时说明图是有环图,拓扑排序无法完成,陷入死锁。
例子:做一道 青椒炒肉 的过程图如下
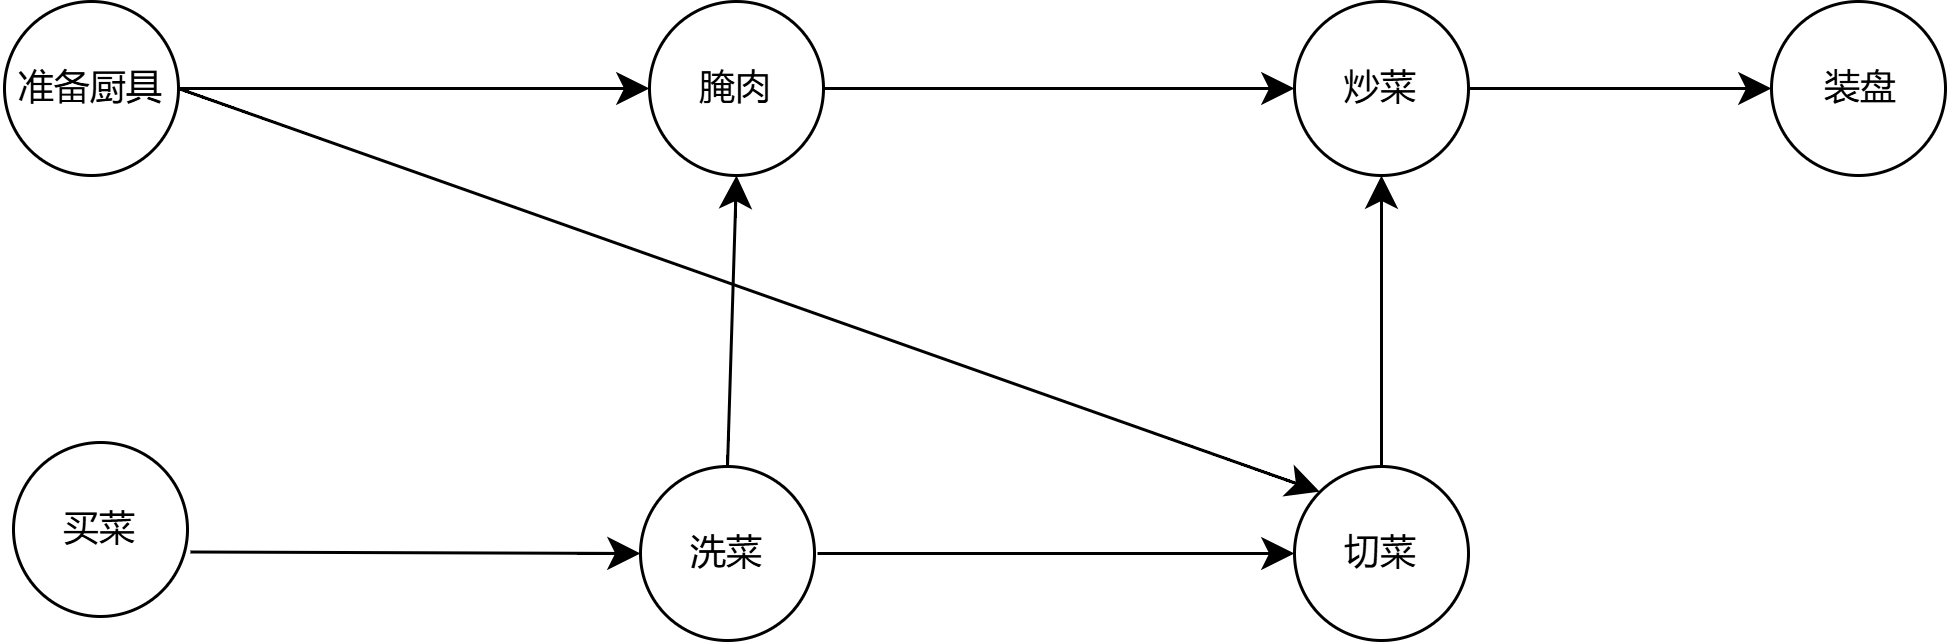
按照流程图中的顺序一步一步做出来这道菜的过程,就相当于是 拓扑排序 的过程。
拓扑排序的目标是将所有节点排序,可能出现多个不同的排序结果:
- 买菜 ---> 准备厨具 ---> 洗菜 ---> 腌肉 ---> 切菜 ---> 炒菜 ---> 装盘
- 准备厨具 ---> 买菜 ---> 洗菜 ---> 腌肉 ---> 切菜 ---> 炒菜 ---> 装盘
- 准备厨具 ---> 买菜 ---> 洗菜 ---> 切菜 ---> 腌肉 ---> 炒菜 ---> 装盘
- 准备厨具 ---> 腌肉 ---> 买菜 ---> 洗菜 ---> 切菜 ---> 炒菜 ---> 装盘
如何实现拓扑排序?借助队列,一次多源 BFS 即可:
- 先将所有入度为0的节点放入队列
- 层序遍历:先拿出队首元素并添加到结果中,然后将从该队首元素发出的边全部删去,再判断与这些边相连的节点的入度减一之后的值是否为0(若为0就再加入队列中)
题目给出一个字符串列表 words,作为一门使用英语字母但字典顺序不同的外星文语言的 词典,这个词典中的字符串已经是有序的(按照外星文语言的字典顺序排序)。
我们需要根据这个词典还原出这种语言中已知的字母顺序,并 按照字母递增顺序 排列。若不存在合法字母顺序就返回 ""。若存在多种可能的合法字母顺序,返回其中 任意一种 序列即可。
字符串 s 字典顺序小于 字符串 t 有两种情况:
- 在第一个不同字母处,如果
s中的字母在这门外星语言的字母顺序中位于t中字母之前,那么s的字典顺序小于t。 - 如果前面
min(s.length, t.length)字母都相同,那么s.length < t.length时,s的字典顺序也小于t。
例1:words = ["wrt","wrf","er","ett","rftt"]
将 wrt 分别与 wrf、er、ett 和 rftt进行对比,然后分别对其余字符串一一比较:
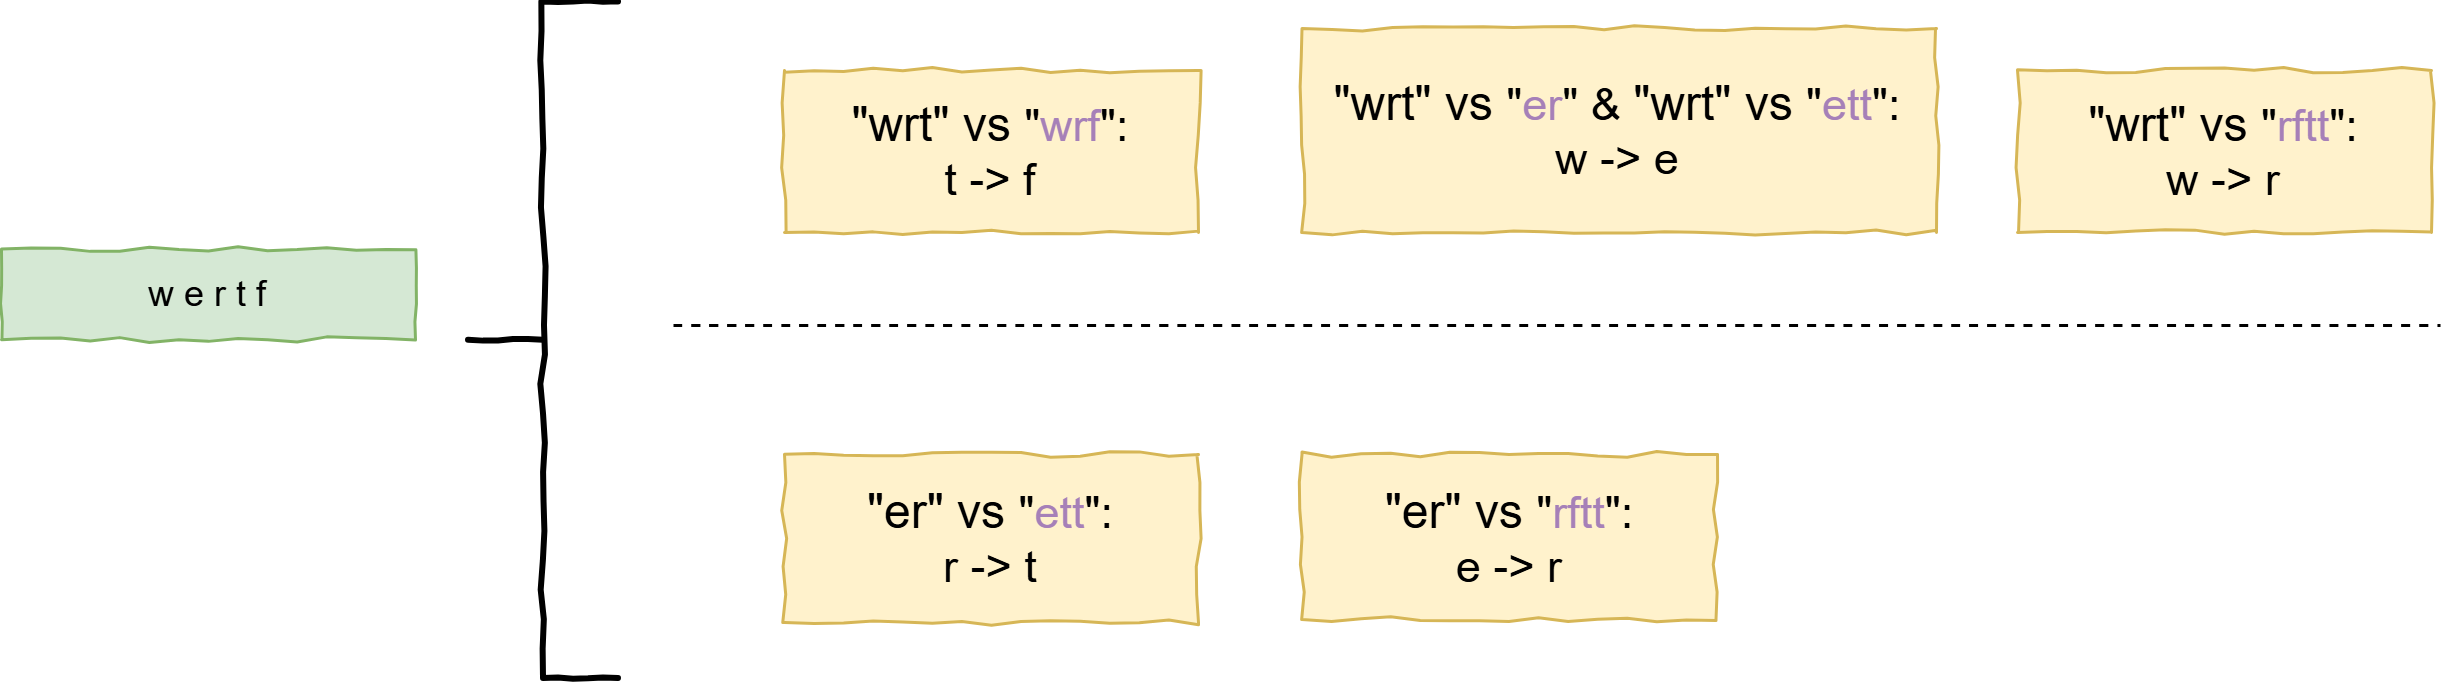
可以得到有向无环图:
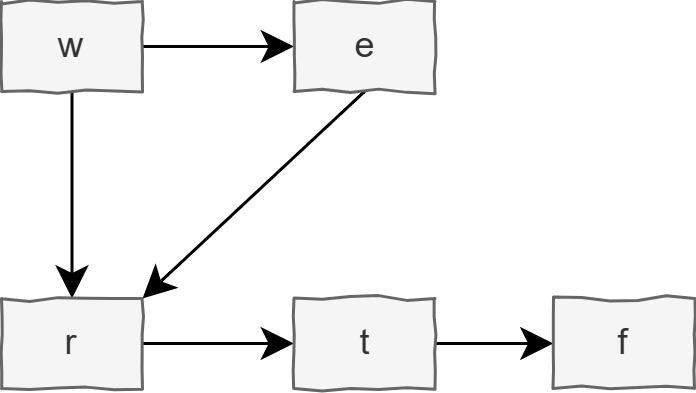
对这个有向无环图进行拓扑排序可以得到:w -> e -> r -> t -> f,最终的序列是:wertf。
例2:words = ["z","x","z"]
由于不存在合法的字母顺序,返回 ""。
算法原理
要解决这道题,分为以下几个步骤:
- 先统计信息(即根据
words中的字符串得出字母的字典顺序),这一步同时也进行建图 - 题目要求我们返回字典顺序,相当于建图完成之后我们需要返回这张图的拓扑序列,因此接下来是 拓扑排序:先遍历入度数组(在建图时就存入所有节点的入度值),将入度为0的节点放入队列中;然后层序遍历,逐一取出队首元素并加入到结果序列中,同时要将所有被队首元素所指的节点的入度值减一,然后需要判断该节点的入度值是否为0,若为0就要加入到队列中
- 当拓扑排序结束后,此时图中所有节点的入度值应都是0,如果还有节点的入度不为0,说明图中有环------即无法得出有效的字典顺序,返回
""即可;若全部节点的入度都是0,就可以返回结果序列。
建图
在构造拓扑序列之前,首先要根据题目抽象出图结构。
我们用 邻接表 来表示图的结构,代码实现有两种方式:
- 对于字符串类型的数据,我们通常用 哈希表 (Map < String, List < String >> edges)作为邻接表来映射 "节点,相连的节点列表"。
- 对于整数类型的数据,我们通常用 链表(List< List< Integer >> edges)作为邻接表,用下标(前提是数据从0开始计数)作为 "节点",链表的值作为 "与该节点相连的节点列表"。(也可以使用哈希表来映射:Map < Integer, List < Integer >> edges)
- 本题的邻接表采用哈希表来实现,并且可能会出现重复情况(比如例1中比较
wrt与er和比较wrt与ett这两种情况都能得到w -> e,此时出现重复),而邻接表中不希望出现重复的情况,此时我们将哈希表的结构改成:Map < Character , Set < Character > >。
java
Map<Character, Set<Character>> edges = new HashMap<>();本题的建图是在统计信息的时候一同进行的,具体的过程:
- 先遍历词典
words,将其中出现的所有字符串相互进行比较(使用双指针,逐个字符遍历),可以得出字母的先后顺序(如例1中的wrt与wrf,这两个只有最后一个字符不相同,于是得出字典序 t 在 f 前,抽象成图则是 t -> f)。 - 当两个字符串的字符不相等,我们就得到一组信息,然后将这组信息存入邻接表
edges中,然后直接结束本轮比较即不需要继续比较这两个字符串了
入度数组
本题我们在进行拓扑排序的过程中还需要知道节点的入度值,因此我们为了方便,可以用一个入度数组 in 来记录图中所有节点的入度值。
java
int[] in = new int[numCourses];但是,由于本题无法事先知道会出现哪些字母,而且直接开辟一个长度为 26 的数组也太过浪费,因此我们将入度数组的结构也改成哈希表:Map < Character, Integer >,存储特定的字母及其入度值的映射。
java
Map<Character, Integer> in = new HashMap<>();
- 注意:使用哈希表结构必须要在使用前初始化!否则会报错。
- 具体的初始化操作:遍历题目所给的字符串列表
words,然后将里面出现的所有字母都添加进入度数组,对应的入度值设置为0
细节问题
我们需要针对一种特殊情况进行处理,下面给出一个例子:str1 = "abc",str2 = "ab"。
当我们对这两个字符串进行比较,并不会认为这是个非法情况,原因是我们比较的时候为了不越界会取较短的字符串长度,遍历到字符 b 就会停止。
但是题目明确给出:字符串 s 与 t,如果前面 min(s.length, t.length) 字母都相同,那么 s.length < t.length 时,s 的字典顺序也小于 t 。 也就是说当两个字符串的前面 n 个字母都相同时,前一个字符串的长度只有小于后一个字符串的长度才合法,此时字符串 s 的字典顺序小于字符串 t。
对于我们这个例子,"abc" 和 "ab" 的比较只会比较 2 次,并且两个字符串的 "ab" 字母都相同,但是 "abc" > "ab",因此这个例子不合法,我们应该返回 ""。
解决的办法:
在结束两个字符串的比较之后,我们需要特别判断一下当前用于比较的指针的位置是否等于 str2 的长度,同时这个位置还比 str1 的长度小,若都满足就是上面例子的情况,直接返回 ""。
代码实现
java
class Solution {
    public String alienOrder(String[] words) {
        Map<Character, Set<Character>> edges = new HashMap<>();
        Map<Character, Integer> in = new HashMap<>(); // 记录入度值
        // 初始化,将words中所有单词的字符记录下来,入度均为0
        for (String word : words) {
            for (int j = 0; j < word.length(); j++) {
                char ch = word.charAt(j);
                in.put(ch, 0);
            }
        }

        // 遍历收集信息
        int len = words.length;
        for (int i = 0; i < len; i++) {
            char[] word = words[i].toCharArray();
            for (int j = i+1; j < len; j++) {
                char[] nextWord = words[j].toCharArray();
                int n1 = word.length, n2 = nextWord.length;
                // 比较两个字符串
                int n = Math.min(n1, n2);
                int k = 0;
                for (; k < n; k++) {
                    char a = word[k], b = nextWord[k];
                    if (a != b) {
                        // a在b之前,即:a -> b
                        if (!edges.containsKey(a)) {
                            edges.put(a, new HashSet<>());
                        }
                        if (!edges.get(a).contains(b)) { // 防止重复
                            edges.get(a).add(b);    // 存入邻接表
                            in.put(b, in.get(b)+1); // 更新b的入度值
                        }
                        // 有一个字符不相同后面就不继续比较了
                        break;
                    }
                }
                // 细节问题
                if (k == n2 && k < n1) {
                    // 不合法
                    return "";
                }
            }
        }

        // 拓扑排序
        Queue<Character> queue = new LinkedList<>();
        // 把入度为0的字符加入队列
        for (char ch : in.keySet()) {
            // 找到入度值为0的字符
            if (in.get(ch) == 0) {
                // 放入队列
                queue.offer(ch);
            }
        }
        // 层序遍历
        StringBuilder ans = new StringBuilder();
        while (!queue.isEmpty()) {
            char top = queue.poll(); // 取出队首元素
            ans.append(top);
            for (char ch : edges.getOrDefault(top, new HashSet<>())) {
                // 将与队首元素相连的字符的入度值减一
                in.put(ch, in.get(ch)-1);
                // 判断减一之后的入度值是否为0,若为0则加入队列
                if (in.get(ch) == 0) {
                    queue.offer(ch);
                }
            }
        }

        // 判断是否还有入度不为0的字符,若有就返回空字符串,否则返回结果
        for (char ch : in.keySet()) {
            if (in.get(ch) != 0) {
                // 返回空字符串
                return "";
            }
        }
        // 返回结果
        return ans.toString();
    }
}
完