Linux进程间通信(一):从匿名管道、命名管道到进程池,深入理解Pipe、FIFO与文件描述符
🔥 星恒随风: 个人主页 ❄️ 个人专栏: 《指针合集》 | 《C语言基础》 | 《数据结构》 | 《机器学习导论》 | 《前端基础》 | 《python基础》 | 《C++从入门到入土》 | 《Linux的学习之旅》 ✨ 数据即知识,压缩即智能
文章目录
- Linux进程间通信(一):从匿名管道、命名管道到进程池,深入理解Pipe、FIFO与文件描述符
- 一、为什么进程之间不能随意访问彼此的数据?
-
- [1.1 回顾进程的独立性](#1.1 回顾进程的独立性)
- [1.2 进程为什么需要独立?](#1.2 进程为什么需要独立?)
- [1.3 进程间通信的基本思想](#1.3 进程间通信的基本思想)
- 二、进程间通信的目的和分类
-
- [2.1 进程间通信的目的](#2.1 进程间通信的目的)
-
- [2.1.1 数据传输](#2.1.1 数据传输)
- [2.1.2 资源共享](#2.1.2 资源共享)
- [2.1.3 事件通知](#2.1.3 事件通知)
- [2.1.4 进程控制](#2.1.4 进程控制)
- [2.2 Linux中常见的IPC机制](#2.2 Linux中常见的IPC机制)
- 三、什么是管道?
-
- [3.1 从Shell命令开始理解](#3.1 从Shell命令开始理解)
- [3.2 管道的基本模型](#3.2 管道的基本模型)
- [3.3 管道和普通文件有什么关系?](#3.3 管道和普通文件有什么关系?)
- 四、匿名管道:pipe()函数
-
- [4.1 函数原型](#4.1 函数原型)
- [4.2 为什么需要两个文件描述符?](#4.2 为什么需要两个文件描述符?)
- 五、先实现一个最简单的管道实验
-
- [5.1 单进程管道读写](#5.1 单进程管道读写)
- [5.2 为什么这里要添加字符串结束符?](#5.2 为什么这里要添加字符串结束符?)
- 六、fork()之后,父子进程如何共享管道?
-
- [6.1 先创建管道,再创建子进程](#6.1 先创建管道,再创建子进程)
- [6.2 从文件描述符角度理解](#6.2 从文件描述符角度理解)
- [6.3 为什么需要关闭不使用的端口?](#6.3 为什么需要关闭不使用的端口?)
- 七、使用匿名管道实现父子进程通信
-
- [7.1 完整代码](#7.1 完整代码)
- [7.2 为什么子进程使用_exit()?](#7.2 为什么子进程使用_exit()?)
- [7.3 为什么父进程要调用waitpid()?](#7.3 为什么父进程要调用waitpid()?)
- 八、从内核角度理解管道的本质
-
- [8.1 管道并不是父进程的一块普通内存](#8.1 管道并不是父进程的一块普通内存)
- [8.2 管道中的数据是否具有消息边界?](#8.2 管道中的数据是否具有消息边界?)
- 九、管道的四种典型读写情况
-
- [9.1 管道为空,但是仍存在写端](#9.1 管道为空,但是仍存在写端)
- [9.2 管道已满,但是仍有读端](#9.2 管道已满,但是仍有读端)
- [9.3 所有写端关闭](#9.3 所有写端关闭)
- [9.4 所有读端关闭](#9.4 所有读端关闭)
- 十、PIPE_BUF:为什么要关注原子写入?
-
- [10.1 什么是原子性?](#10.1 什么是原子性?)
- [10.2 PIPE_BUF的作用](#10.2 PIPE_BUF的作用)
- [10.3 查看PIPE_BUF](#10.3 查看PIPE_BUF)
- 十一、从管道理解Shell中的"|"
-
- [11.1 ls | wc -l究竟发生了什么?](#11.1 ls | wc -l究竟发生了什么?)
- [11.2 为什么需要dup2?](#11.2 为什么需要dup2?)
- [11.3 和之前MiniShell的关系](#11.3 和之前MiniShell的关系)
- 十二、进程池:为什么要提前创建多个子进程?
-
- [12.1 从普通任务执行开始](#12.1 从普通任务执行开始)
- [12.2 进程池的基本结构](#12.2 进程池的基本结构)
- [12.3 如何把任务发送给Worker?](#12.3 如何把任务发送给Worker?)
- 十三、使用C++11实现一个简单进程池
-
- [13.1 实现完整代码](#13.1 实现完整代码)
- [13.2 编译运行](#13.2 编译运行)
- [13.3 为什么需要循环读取一个int?](#13.3 为什么需要循环读取一个int?)
- [13.4 为什么Worker需要关闭历史管道?](#13.4 为什么Worker需要关闭历史管道?)
- [13.5 为什么要先关闭全部通道,再等待子进程?](#13.5 为什么要先关闭全部通道,再等待子进程?)
- 十四、命名管道:FIFO
-
- [14.1 匿名管道有什么局限?](#14.1 匿名管道有什么局限?)
- [14.2 什么是FIFO?](#14.2 什么是FIFO?)
- [14.3 使用命令创建FIFO](#14.3 使用命令创建FIFO)
- [14.4 使用mkfifo()创建](#14.4 使用mkfifo()创建)
- 十五、FIFO的打开规则
-
- [15.1 只读方式打开](#15.1 只读方式打开)
- [15.2 只写方式打开](#15.2 只写方式打开)
- [15.3 非阻塞模式](#15.3 非阻塞模式)
- 十六、使用FIFO实现两个独立进程通信
-
- [16.1 服务端server.c](#16.1 服务端server.c)
- [16.2 客户端client.c](#16.2 客户端client.c)
- [16.3 编译](#16.3 编译)
- [16.4 测试](#16.4 测试)
- 十七、匿名管道和命名管道有什么区别?
- 十八、课后扩展:为我们的MiniShell添加管道功能
-
- [18.1 建议增加什么数据结构?](#18.1 建议增加什么数据结构?)
- [18.2 如何处理两个命令?](#18.2 如何处理两个命令?)
- 十九、常见问题与错误总结
-
- [19.1 管道是普通磁盘文件吗?](#19.1 管道是普通磁盘文件吗?)
- [19.2 匿名管道只能在父子进程之间使用吗?](#19.2 匿名管道只能在父子进程之间使用吗?)
- [19.3 为什么read()一直阻塞?](#19.3 为什么read()一直阻塞?)
- [19.4 为什么写端关闭后read()仍然能读到数据?](#19.4 为什么写端关闭后read()仍然能读到数据?)
- [19.5 为什么进程池无法正常退出?](#19.5 为什么进程池无法正常退出?)
- [19.6 为什么多个write()的数据会被一次read()读取?](#19.6 为什么多个write()的数据会被一次read()读取?)
- [19.7 PIPE_BUF就是管道总容量吗?](#19.7 PIPE_BUF就是管道总容量吗?)
- [19.8 FIFO文件是否存储了真正的通信数据?](#19.8 FIFO文件是否存储了真正的通信数据?)
- 总结
前言:为什么进程之间需要通信?
在前面的 Linux 进程控制中,我们已经学习了:
c
fork()
execvp()
waitpid()
并且利用这些接口实现了一个简单的 MiniShell。
我们知道,fork() 能够创建子进程,execvp() 可以将子进程的程序映像替换成其他程序。
但是这里还有一个问题:
父进程和子进程能不能直接交换数据?
例如,我们希望实现:
bash
ls | wc -lls 负责输出当前目录下的文件名,而 wc -l 负责统计输入数据的行数。
两个程序分别运行在不同进程中,却能够完成协作。
这就需要用到:
进程间通信(Inter-Process Communication,IPC)。
本篇将按照以下顺序展开:
- 认识进程间通信的目的与分类。
- 理解进程独立性与内核通信资源。
- 学习匿名管道
pipe()。 - 从文件描述符角度理解父子进程通信。
- 掌握管道阻塞、EOF、SIGPIPE 和原子写入规则。
- 使用 C++11 和匿名管道实现简单进程池。
- 学习命名管道 FIFO,实现无亲缘关系进程间通信。
- 将管道和之前的 MiniShell 结合,理解
ls | wc -l。
一、为什么进程之间不能随意访问彼此的数据?
1.1 回顾进程的独立性
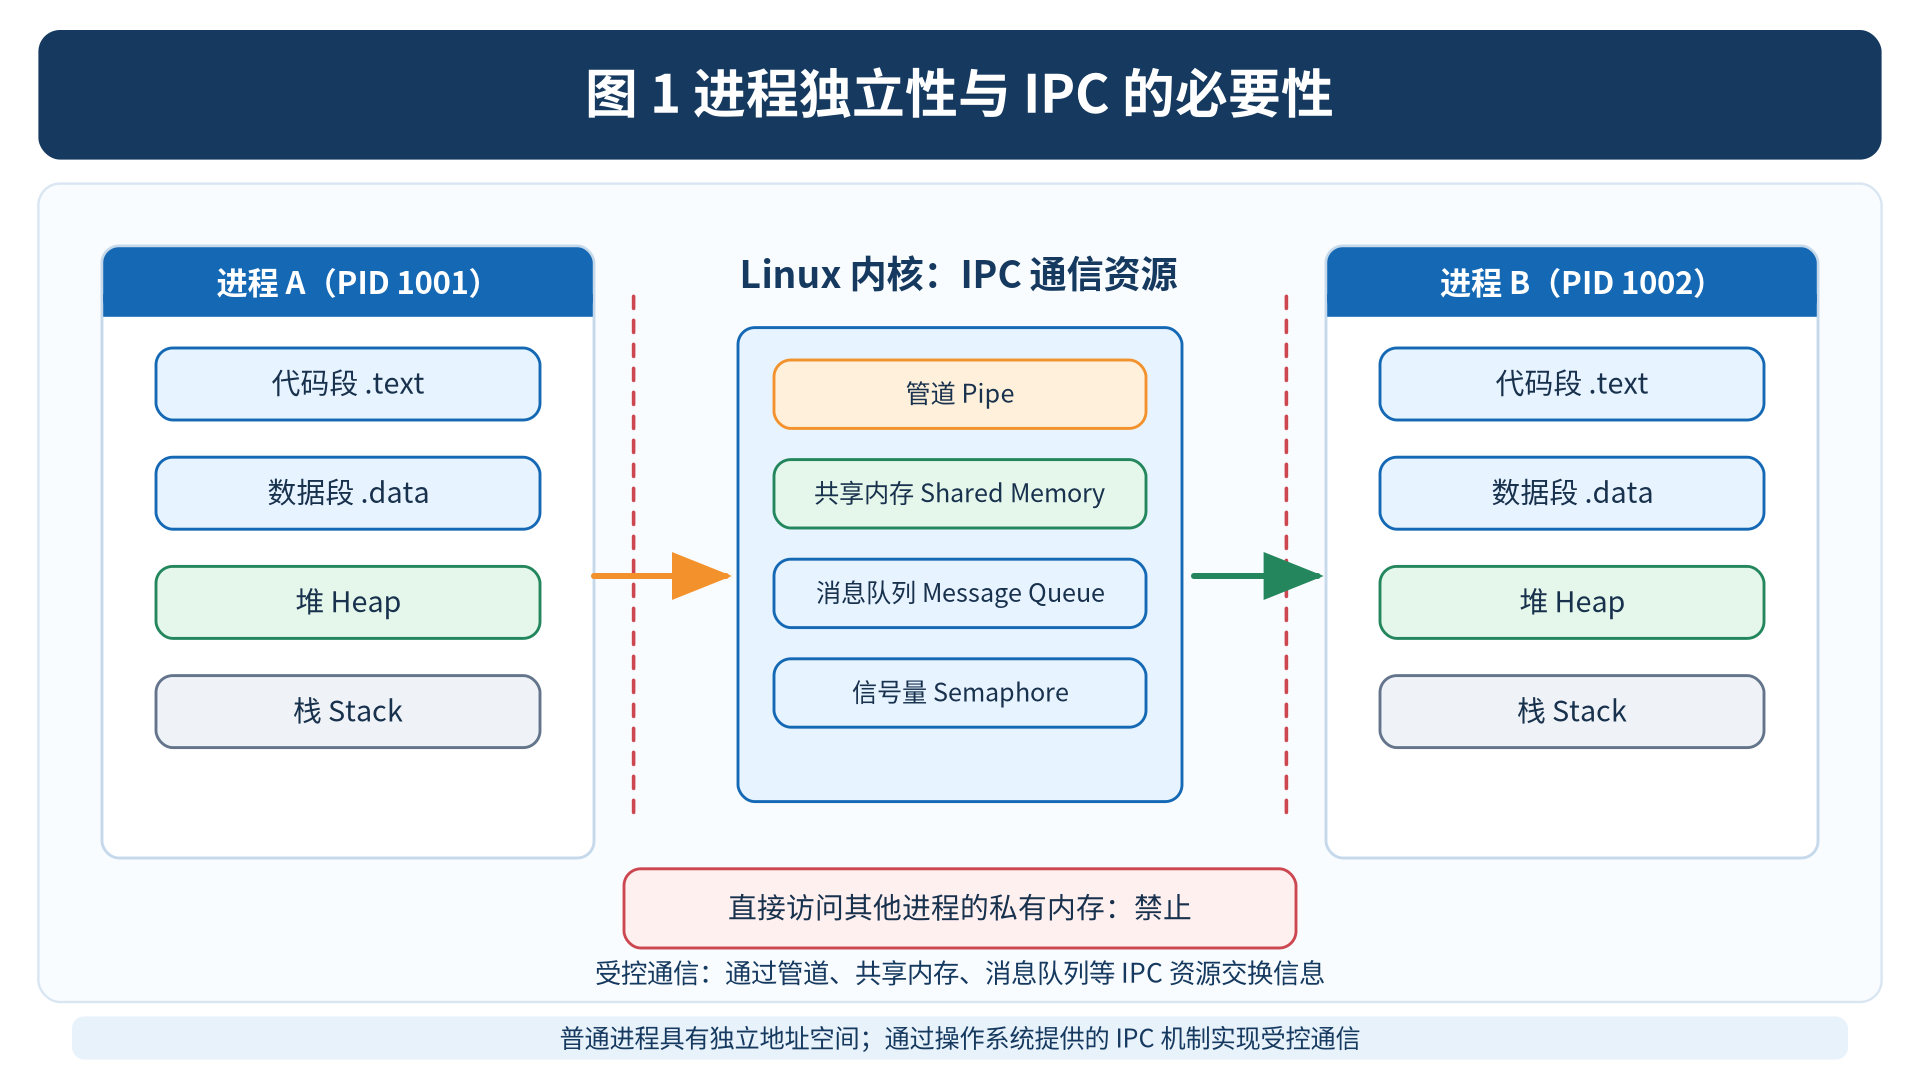
在前面的进程管理学习中,我们知道 Linux 进程具有各自的虚拟地址空间。
例如:
c
#include <stdio.h>
#include <unistd.h>

int main(void)
{
    int value = 100;

    pid_t pid = fork();

    if (pid == 0)
    {
        value = 200;
        printf("child: %d\n", value);
    }
    else
    {
        sleep(1);
        printf("parent: %d\n", value);
    }

    return 0;
}
编译:
bash
gcc fork_test.c -o fork_test运行后,通常得到:
text
child: 200
parent: 100
这说明:
子进程修改自己地址空间中的变量,并不会自动修改父进程对应的变量。
虽然 fork() 之后父子进程的虚拟地址空间最初具有相似内容,但两者的普通可写内存通常通过写时复制机制保持独立。
1.2 进程为什么需要独立?
如果每个进程都能够任意修改其他进程的内存,系统就很难保证:
- 不同程序之间的隔离性。
- 进程数据的完整性。
- 程序运行的稳定性。
- 操作系统的安全性。
但是,进程之间也经常需要协作。
例如浏览器与其他服务进程交换信息,或者服务器将任务分发给多个工作进程。
所以问题就变成:
既要保证进程之间的独立性,又要允许它们通过受控方式交换数据。
1.3 进程间通信的基本思想
一个重要的思路是:
由操作系统内核提供或管理通信资源,让不同进程通过这些资源交换数据。
例如管道:
父进程将数据写入内核管道,子进程再从管道中读取。
或者共享内存:
操作系统允许两个进程将同一块共享内存映射到各自的虚拟地址空间。
二、进程间通信的目的和分类
2.1 进程间通信的目的
IPC 主要用于以下几类场景。
2.1.1 数据传输
一个进程将数据发送给另一个进程。
例如:
bash
ls | wc -lls 的输出被传递给 wc。
2.1.2 资源共享
多个进程需要访问同一份共享资源。
例如多个进程访问一块共享内存。
2.1.3 事件通知
一个进程向另一个进程通知某种事件已经发生。
例如生产者通知消费者:
text
新的数据已经准备好2.1.4 进程控制
一个进程监控或控制其他进程的执行。
例如调试器通过相应的进程跟踪机制观察被调试进程。
2.2 Linux中常见的IPC机制
可以按照课件将 IPC 分为三组:
| 分类 | 主要方式 |
|---|---|
| 管道 | 匿名管道、命名管道 |
| System V IPC | 消息队列、共享内存、信号量 |
| POSIX IPC | 消息队列、共享内存、信号量等 |
此外,实际 Linux 开发中还经常使用 Unix Domain Socket、网络 Socket 等机制进行进程间通信。
本篇重点学习管道。
下一篇重点介绍 System V IPC。
三、什么是管道?
3.1 从Shell命令开始理解
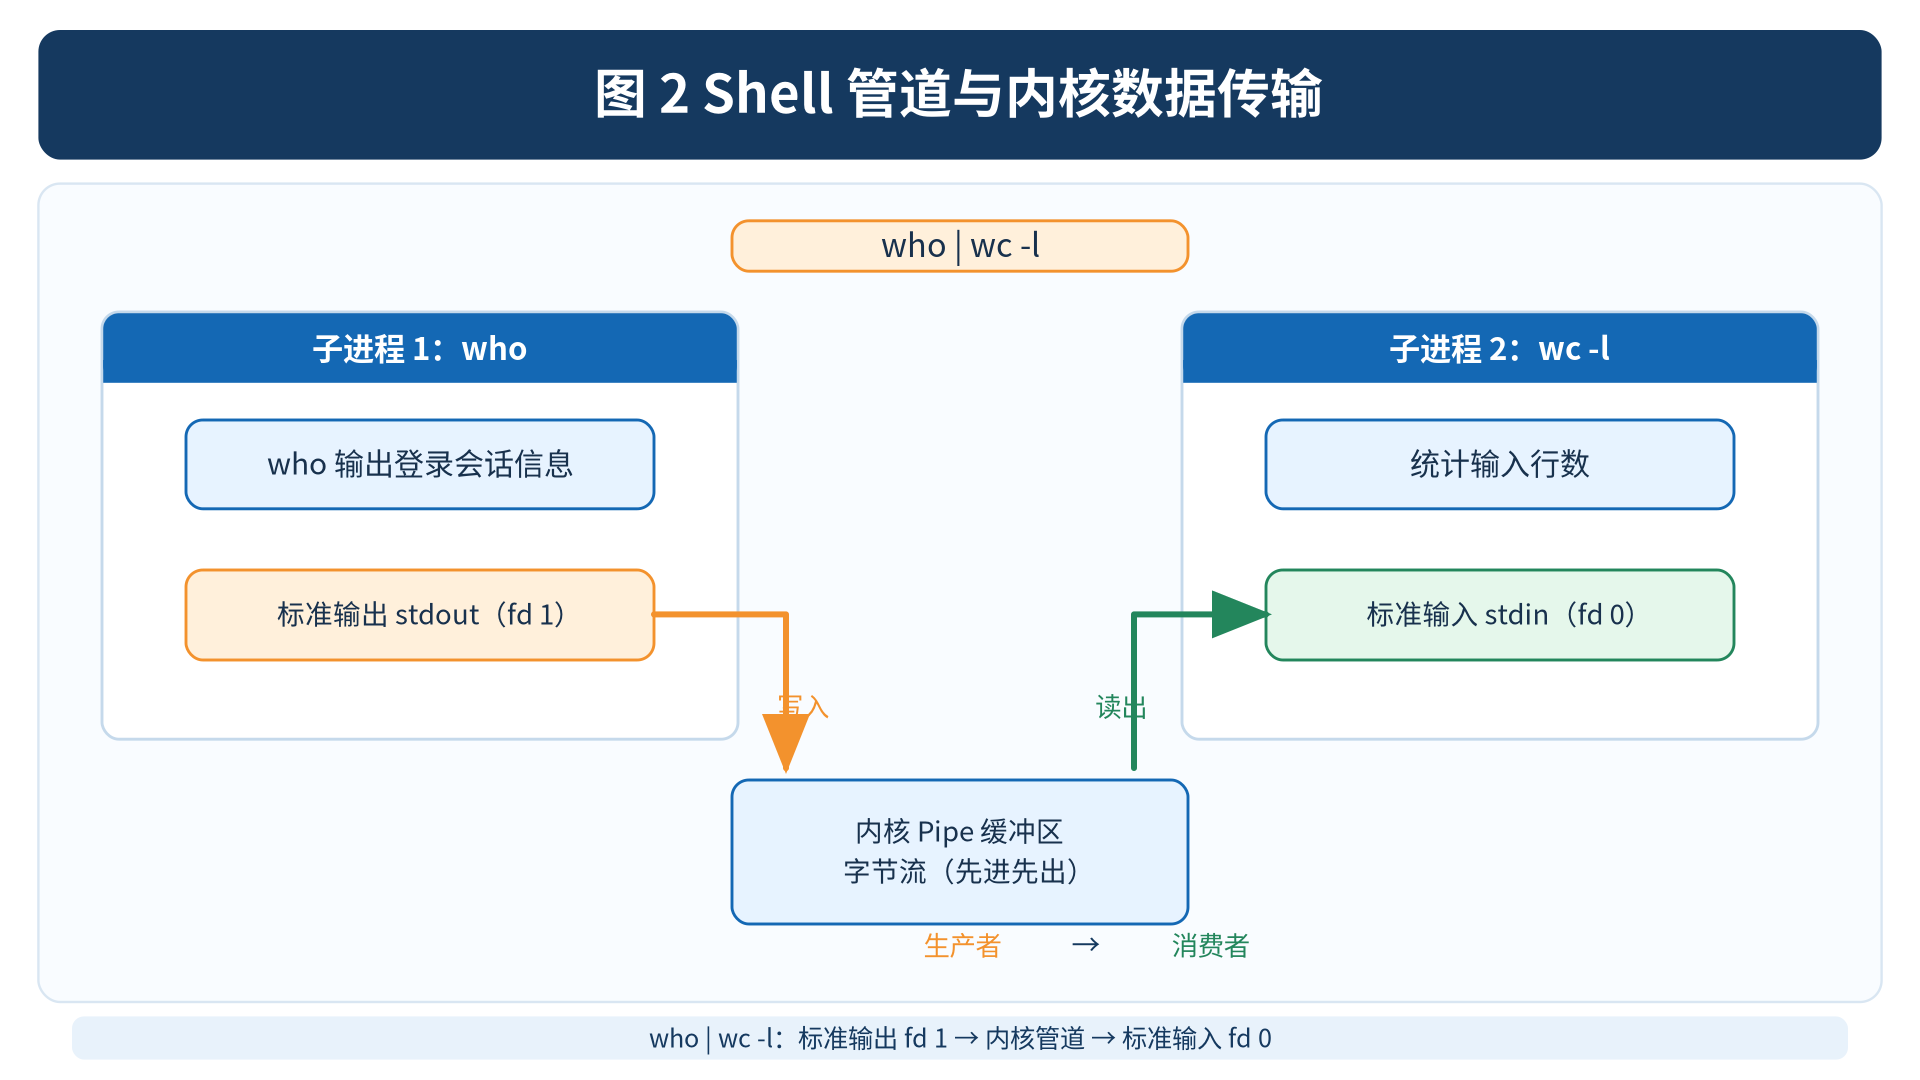
先在 Linux 终端执行:
bash
who | wc -l其中:
bash
who用于显示当前登录用户会话的信息。
bash
wc -l用于统计输入内容的行数。
中间的:
text
|是 Shell 的管道操作符。
它的作用是:
让前一个程序的标准输出,成为后一个程序的标准输入。
因此,who 不需要知道 wc 的存在,wc 也不需要知道数据来自哪个程序。
两者只需要按照约定读写自己的标准输入和标准输出即可。
3.2 管道的基本模型
可以将管道理解为:
text
进程A
  |
  | 写入数据
  v
内核管道
  |
  | 读取数据
  v
进程B
管道中的数据由内核管理。
因此,即使两个进程具有独立的地址空间,也能够通过管道完成数据传输。
3.3 管道和普通文件有什么关系?
之前学习基础 IO 时,我们知道:
c
read()
write()
close()
可以通过文件描述符操作普通文件。
而管道同样通过文件描述符进行读写。
这是 Linux 文件抽象的重要体现。
但管道与普通磁盘文件并不完全相同:
- 管道通常用于传输临时数据。
- 管道数据按照字节流形式被读取。
- 管道没有普通文件意义上的可随意调整的文件偏移量。
- 管道通常不能使用
lseek()随意定位。
四、匿名管道:pipe()函数
4.1 函数原型
c
#include <unistd.h>

int pipe(int pipefd[2]);
参数:
c
pipefd[2]是一个长度为 2 的整数数组。
调用成功后:
c
pipefd[0]表示管道读端。
c
pipefd[1]表示管道写端。
返回值:
| 返回值 | 含义 |
|---|---|
0 |
创建成功 |
-1 |
创建失败,设置 errno |
例如:
c
int pipefd[2];

if (pipe(pipefd) < 0)
{
    perror("pipe");
    return 1;
}
4.2 为什么需要两个文件描述符?
因为匿名管道提供两个方向不同的访问端点:
c
pipefd[0]  // 读端
pipefd[1]  // 写端
假设:
text
pipefd[0] = 3
pipefd[1] = 4
那么进程可以使用:
c
write(4, "hello", 5);将数据写入管道。
然后:
c
read(3, buffer, sizeof(buffer));读取数据。
注意,这只是描述符编号示例,实际编号由操作系统根据当前进程可用的描述符分配。
五、先实现一个最简单的管道实验
5.1 单进程管道读写
先不使用 fork(),只验证管道本身能否工作。
c
#include <stdio.h>
#include <string.h>
#include <unistd.h>

int main(void)
{
    int pipefd[2];

    if (pipe(pipefd) < 0)
    {
        perror("pipe");
        return 1;
    }

    const char* msg = "hello pipe";

    if (write(pipefd[1], msg, strlen(msg)) < 0)
    {
        perror("write");
        close(pipefd[0]);
        close(pipefd[1]);
        return 1;
    }

    char buffer[100] = {0};

    ssize_t n = read(
        pipefd[0],
        buffer,
        sizeof(buffer) - 1
    );

    if (n < 0)
    {
        perror("read");
        close(pipefd[0]);
        close(pipefd[1]);
        return 1;
    }

    buffer[n] = '\0';

    printf("read: %s\n", buffer);

    close(pipefd[0]);
    close(pipefd[1]);

    return 0;
}
编译:
bash
gcc pipe_test.c -o pipe_test运行:
bash
./pipe_test预期输出:
text
read: hello pipe整个过程:
pipe()创建内核管道。write()将数据写入管道。read()从管道读取数据。close()关闭两个描述符。
虽然这个实验还没有涉及两个进程,但已经验证了管道最基本的工作方式。
5.2 为什么这里要添加字符串结束符?
因为:
c
read()读取的是原始字节。
并不会自动在末尾添加:
c
'\0'所以我们需要使用:
c
buffer[n] = '\0';才能安全地将读取结果当作 C 风格字符串打印。
六、fork()之后,父子进程如何共享管道?
这是匿名管道最重要的部分。
6.1 先创建管道,再创建子进程
通常的实现顺序是:
c
pipe(pipefd);

fork();
为什么不先 fork() 再创建管道?
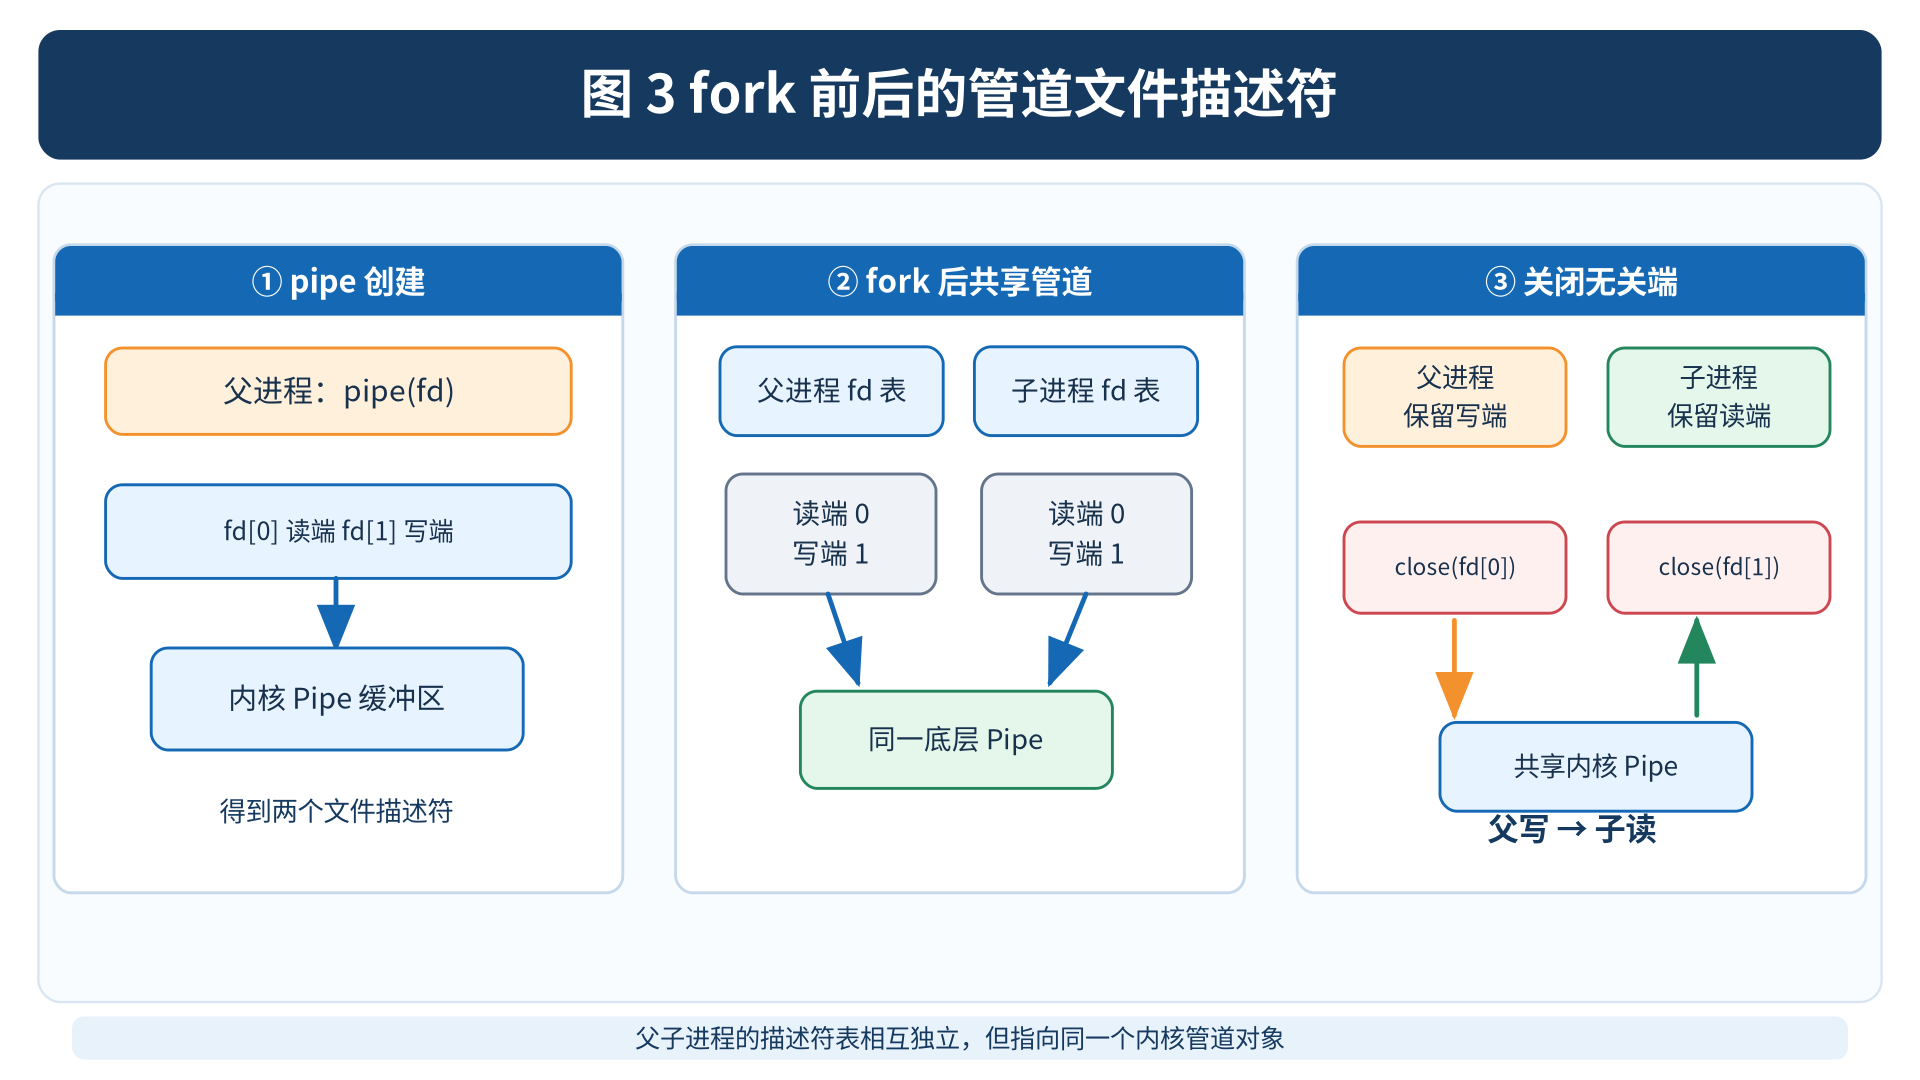
因为我们希望子进程继承父进程已经打开的管道文件描述符。
在 fork() 之后,子进程会继承父进程的文件描述符引用。
因此,父子进程可以分别使用同一条管道的读端和写端。
6.2 从文件描述符角度理解
假设父进程已经创建管道:
text
pipefd[0] = 3
pipefd[1] = 4
在 fork() 之前,只有父进程持有这两个描述符。
fork() 之后:
- 父进程仍然拥有管道读端和写端。
- 子进程也继承了对应的管道读端和写端。
- 两个进程中的描述符引用关联到同一条内核管道。
所以它们不需要通过共享普通变量来完成通信。
6.3 为什么需要关闭不使用的端口?
假设约定:
text
父进程负责写入

子进程负责读取
那么:
父进程不需要使用管道读端。
子进程不需要使用管道写端。
因此:
c
// 父进程
close(pipefd[0]);
以及:
c
// 子进程
close(pipefd[1]);
这不仅是为了节省文件描述符。
更重要的是:
管道是否到达 EOF、是否产生 SIGPIPE,与读写端是否仍然存在有效引用密切相关。
后面会进一步解释。
七、使用匿名管道实现父子进程通信
7.1 完整代码
下面实现:
text
父进程发送字符串
子进程接收字符串pipe_fork.c:
c
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void)
{
    int pipefd[2];

    if (pipe(pipefd) < 0)
    {
        perror("pipe");
        return 1;
    }

    pid_t pid = fork();

    if (pid < 0)
    {
        perror("fork");

        close(pipefd[0]);
        close(pipefd[1]);

        return 1;
    }

    if (pid == 0)
    {
        // 子进程只负责读取
        close(pipefd[1]);

        char buffer[128] = {0};

        ssize_t n = read(
            pipefd[0],
            buffer,
            sizeof(buffer) - 1
        );

        if (n < 0)
        {
            perror("read");
            close(pipefd[0]);
            _exit(1);
        }

        buffer[n] = '\0';

        printf(
            "child[%ld] received: %s\n",
            (long)getpid(),
            buffer
        );

        fflush(stdout);

        close(pipefd[0]);

        _exit(0);
    }

    // 父进程只负责写入
    close(pipefd[0]);

    const char* msg = "hello from parent";

    if (write(pipefd[1], msg, strlen(msg)) < 0)
    {
        perror("write");
    }

    close(pipefd[1]);

    waitpid(pid, NULL, 0);

    return 0;
}
编译:
bash
gcc -Wall -Wextra pipe_fork.c -o pipe_fork运行:
bash
./pipe_fork预期输出类似:
text
child[12345] received: hello from parentPID 会根据实际运行情况变化。
7.2 为什么子进程使用_exit()?
这是与前面进程控制知识的联系。
fork() 之后,父子进程可能拥有各自的标准 IO 用户态缓冲内容。
exit() 会执行标准库的退出处理,包括刷新相关输出缓冲。
而 _exit() 不执行标准 C 库的正常退出处理。
因此在子进程结束前,我们显式:
c
fflush(stdout);然后:
c
_exit(0);以保证上面的 printf() 输出正常显示。
7.3 为什么父进程要调用waitpid()?
因为子进程退出后,父进程需要回收其退出状态。
否则,如果父进程一直不回收已经终止的子进程,就可能产生僵尸进程。
这一点与前面的进程控制学习完全一致。
八、从内核角度理解管道的本质
8.1 管道并不是父进程的一块普通内存
虽然父进程调用:
c
pipe(pipefd);创建了管道,但管道的核心状态和缓冲由内核管理。
可以理解为:
text
父进程
  |
  | write()
  v
内核管道缓冲
  |
  | read()
  v
子进程
父子进程通过内核维护的通信对象完成数据交换。
8.2 管道中的数据是否具有消息边界?
没有。
匿名管道提供的是字节流服务。
例如父进程连续调用:
c
write(fd, "hello", 5);
write(fd, "world", 5);
子进程不一定恰好分两次读取:
text
hello
world
也可能一次读取:
text
helloworld或者在不同读取调用中分别取得其中一部分。
因此:
一次 write() 不一定对应一次 read()。
如果程序需要传递多个独立任务,就需要自己约定数据格式。
例如:
text
固定长度消息或者:
text
消息长度 + 消息内容这在后面的进程池实验中尤其重要。
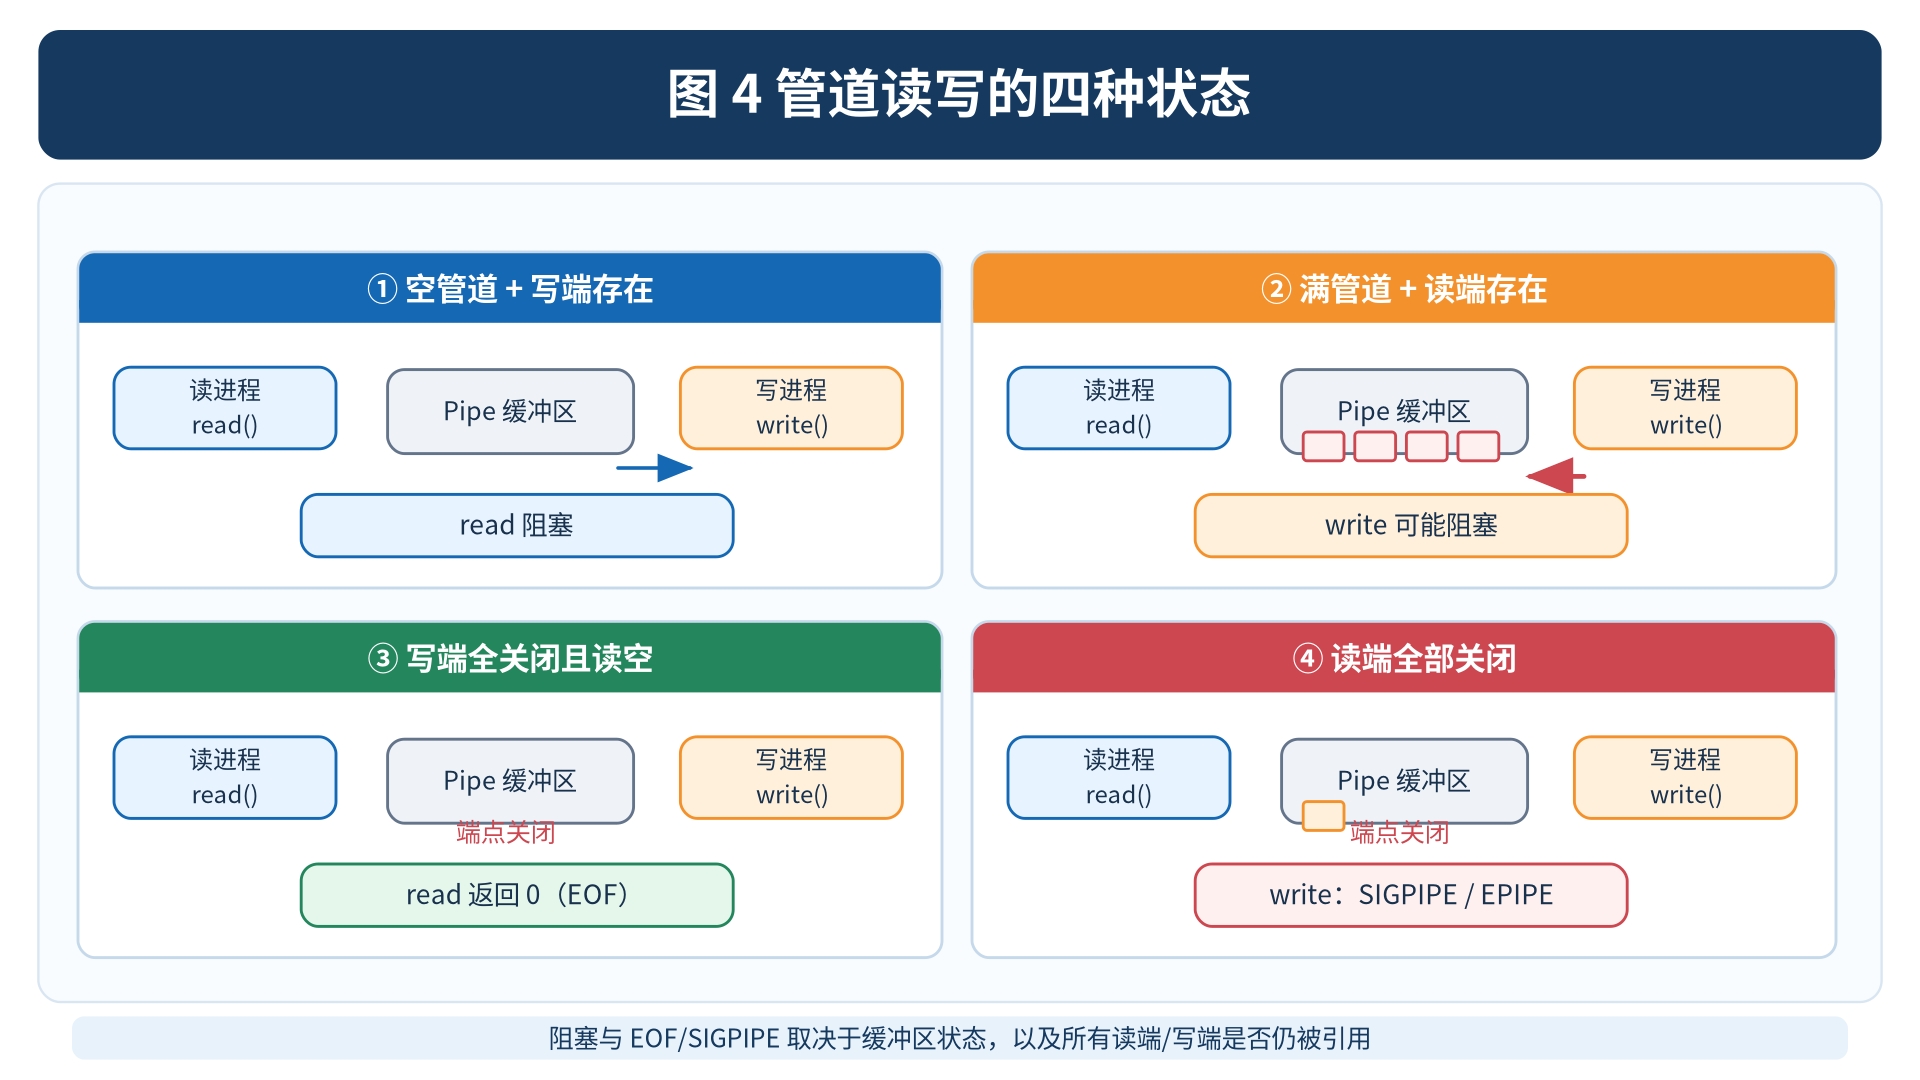
九、管道的四种典型读写情况
课件特别强调了管道的读写规则。
这里按照读端、写端的状态进行分析。
9.1 管道为空,但是仍存在写端
假设管道中暂时没有数据:
c
read(pipefd[0], buffer, sizeof(buffer));如果没有设置非阻塞模式:
text
read()通常会阻塞等待其他进程写入数据。
如果设置了:
c
O_NONBLOCK在仍存在写端但暂时没有可读数据时,read() 通常返回 -1,并设置:
c
errno = EAGAIN;9.2 管道已满,但是仍有读端
如果管道缓冲区已经满了:
c
write(pipefd[1], buffer, len);阻塞模式下,写操作可能等待其他进程从管道中读取数据。
非阻塞模式下,写操作可能返回 EAGAIN,或者在满足条件时先写入部分数据。
因此不能假设:
c
write()一次就一定能够写完所有数据。
9.3 所有写端关闭
假设:
text
没有任何有效的管道写端引用读端把管道中已经存在的数据读取完毕以后:
c
read()返回:
text
0这个返回值表示到达 EOF。
特别注意:
read 返回 0 并不等同于管道暂时没有数据。
只有当管道没有剩余数据,并且所有写端都已关闭时,才会出现这种 EOF 行为。
9.4 所有读端关闭
如果没有任何进程再持有管道读端,此时继续:
c
write()通常会触发:
text
SIGPIPE信号。
默认情况下,该信号可能终止写入进程。
如果进程忽略或屏蔽 SIGPIPE,对应写入操作通常可以通过:
text
EPIPE错误反映读端已经不存在。
十、PIPE_BUF:为什么要关注原子写入?
10.1 什么是原子性?
假设两个进程同时向同一条管道写入数据。
进程 A:
text
AAAA进程 B:
text
BBBB我们希望每个进程的一次完整写入不会被其他写入插入。
这就是原子写入需要解决的问题。
10.2 PIPE_BUF的作用
POSIX 对管道规定了:
text
PIPE_BUF这个与写入原子性相关的大小界限。
当一次写入的数据长度不超过 PIPE_BUF 时,在满足相应条件的情况下,管道能够保证这次写入不会与其他进程的写入交错。
如果一次写入的数据长度超过 PIPE_BUF,就不再具有同样的防交错保证。
需要注意:
PIPE_BUF不是管道缓冲区的总容量。
它描述的是一次写入的原子性保证范围。
10.3 查看PIPE_BUF
可以使用:
c
long n = fpathconf(fd, _PC_PIPE_BUF);查询相应文件描述符的原子写入界限。
例如在 Linux 上,常见的 PIPE_BUF 值为 4096 字节,但具体代码不应该把这个数字当作所有 Unix 系统的固定常量。
十一、从管道理解Shell中的"|"
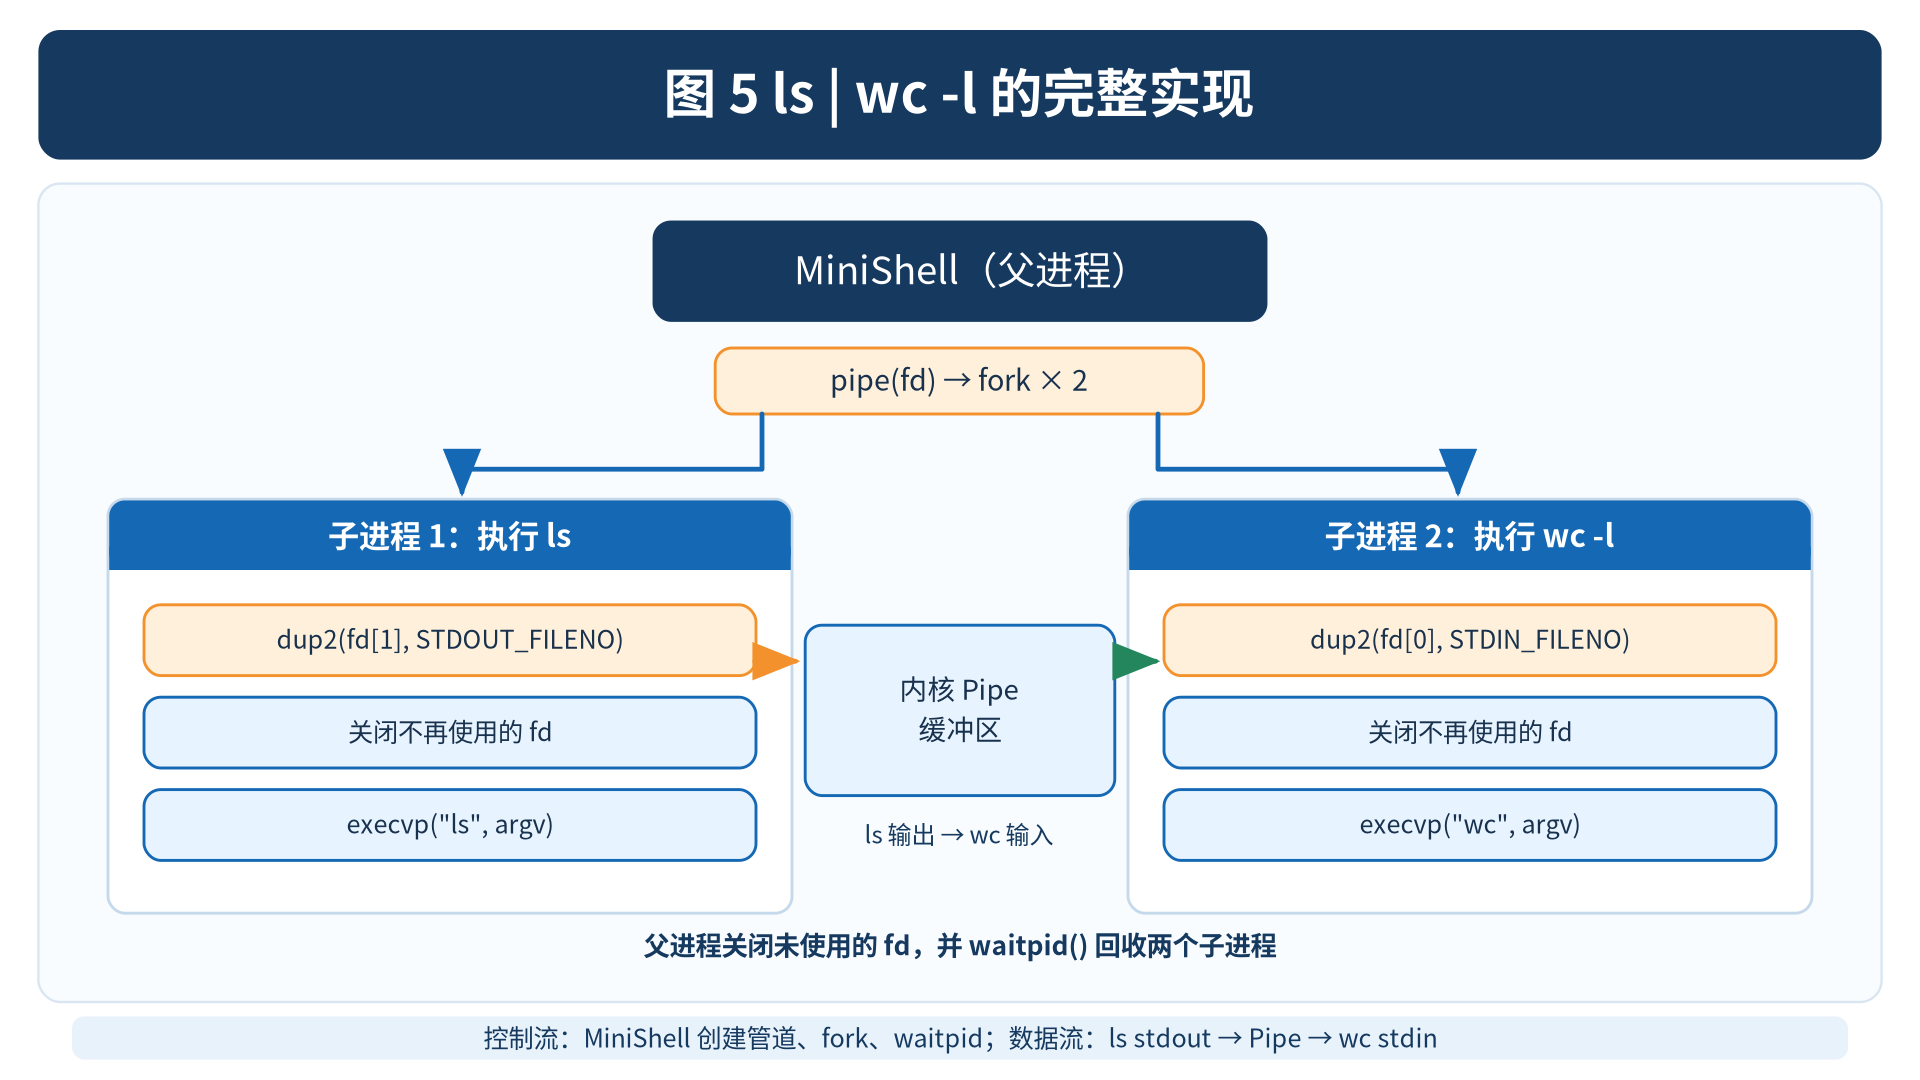
11.1 ls | wc -l究竟发生了什么?
现在重新观察:
bash
ls | wc -lShell 大致需要完成:
- 创建匿名管道。
- 创建用于执行
ls的子进程。 - 创建用于执行
wc -l的子进程。 - 将
ls的标准输出重定向到管道写端。 - 将
wc的标准输入重定向到管道读端。 - 关闭多余的管道文件描述符。
- 等待相应子进程结束。
这里最重要的接口是:
c
dup2()11.2 为什么需要dup2?
对于第一个子进程:
c
dup2(pipefd[1], STDOUT_FILENO);使:
text
标准输出fd 1引用管道写端。
对于第二个子进程:
c
dup2(pipefd[0], STDIN_FILENO);使:
text
标准输入fd 0引用管道读端。
因此 ls 仍然向标准输出写数据,wc 仍然从标准输入读数据。
两个程序都不需要知道 Shell 是如何建立管道的。
11.3 和之前MiniShell的关系
我们之前已经实现了:
text
fork()
execvp()
waitpid()
以及:
text
open()
dup2()
实现了普通输入输出重定向。
因此增加管道功能时,核心不是重新发明进程执行流程,而是:
为不同的子进程建立正确的标准输入、标准输出连接。
十二、进程池:为什么要提前创建多个子进程?
12.1 从普通任务执行开始
假设服务器需要处理很多任务。
最简单的方式是:
text
接收一个任务
    |
    v
fork一个子进程
    |
    v
执行任务
    |
    v
子进程退出
如果任务很多,频繁创建和销毁进程就会带来额外的系统开销。
于是可以考虑:
提前创建多个工作进程,让它们反复处理任务。
这就是进程池(Process Pool)的一种基本思想。
12.2 进程池的基本结构
例如:
text
Master
  |
  +-- Worker 1
  |
  +-- Worker 2
  |
  +-- Worker 3
其中:
text
Master负责分发任务。
text
Worker负责执行任务。
工作进程可以循环等待新的任务,而不是执行一次后立即退出。
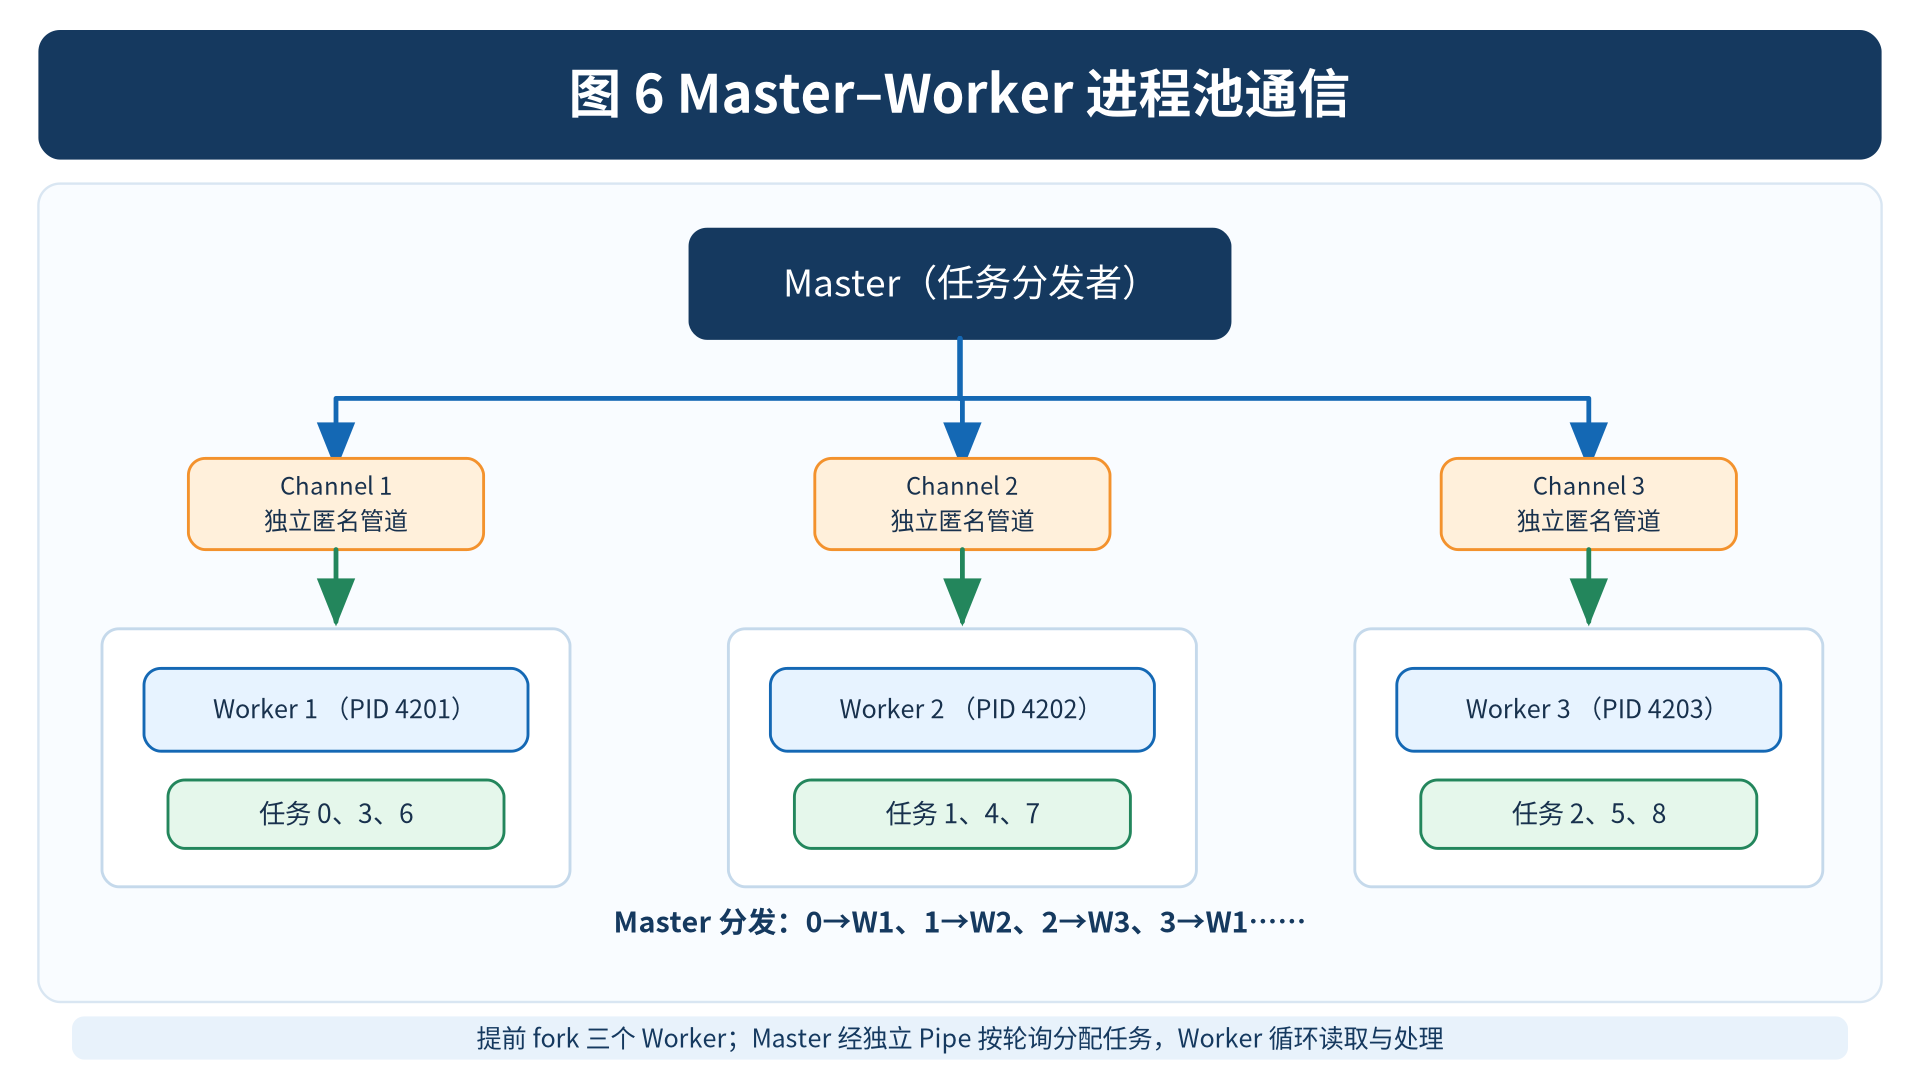
12.3 如何把任务发送给Worker?
我们已经学过匿名管道。
因此,可以让 Master 为每个 Worker 建立一条管道:
text
Master
  |
  +-- Pipe1 --> Worker1
  |
  +-- Pipe2 --> Worker2
  |
  +-- Pipe3 --> Worker3
Master 将任务编号写入相应管道。
Worker 从自己的管道读取任务编号,然后执行对应的任务。
十三、使用C++11实现一个简单进程池
本节参考课件中:
text
Channel.hpp
ProcessPool.hpp
Task.hpp
Main.cc
的组织思路,保留:
- Channel 保存通信描述符与工作进程 PID。
- Master 负责创建子进程。
- 通过管道发送任务编号。
- Worker 循环读取任务。
- Master 关闭通道后,Worker 通过 EOF 退出。
为了便于第一次学习,先合并成单文件实现。
13.1 实现完整代码
process_pool.cpp:
cpp
#include <cerrno>
#include <cstdio>
#include <cstdlib>
#include <iostream>
#include <vector>

#include <unistd.h>
#include <sys/wait.h>

using namespace std;

// 保证完整写入指定字节数
bool WriteAll(int fd, const void* data, size_t length)
{
    const char* p = static_cast<const char*>(data);

    while (length > 0)
    {
        ssize_t n = write(fd, p, length);

        if (n < 0 && errno == EINTR)
        {
            continue;
        }

        if (n <= 0)
        {
            return false;
        }

        p += n;
        length -= static_cast<size_t>(n);
    }

    return true;
}

// 读取一个完整int任务
// 1:成功
// 0:读到EOF
// -1:出错
int ReadTask(int fd, int& task)
{
    char* p = reinterpret_cast<char*>(&task);

    size_t left = sizeof(task);

    while (left > 0)
    {
        ssize_t n = read(fd, p, left);

        if (n < 0 && errno == EINTR)
        {
            continue;
        }

        if (n < 0)
        {
            return -1;
        }

        if (n == 0)
        {
            return left == sizeof(task) ? 0 : -1;
        }

        p += n;
        left -= static_cast<size_t>(n);
    }

    return 1;
}

// 一条通信通道
struct Channel
{
    int wfd;
    pid_t pid;
};

int main()
{
    constexpr int workers = 3;

    vector<Channel> channels;

    cout.flush();

    // 1. 创建进程池
    for (int i = 0; i < workers; ++i)
    {
        int fds[2];

        if (pipe(fds) < 0)
        {
            perror("pipe");
            return 1;
        }

        pid_t pid = fork();

        if (pid < 0)
        {
            perror("fork");

            close(fds[0]);
            close(fds[1]);

            return 1;
        }

        if (pid == 0)
        {
            // Worker不写自己的管道
            close(fds[1]);

            // 关闭从Master继承的历史通道写端
            for (const auto& ch : channels)
            {
                close(ch.wfd);
            }

            int task = 0;
            int result = 0;

            // 反复读取并执行任务
            while ((result = ReadTask(fds[0], task)) == 1)
            {
                cout << "worker "
                     << getpid()
                     << " executes task "
                     << task
                     << endl;
            }

            close(fds[0]);

            _exit(result == 0 ? 0 : 1);
        }

        // Master只负责向这个Worker写任务
        close(fds[0]);

        channels.push_back(Channel{fds[1], pid});
    }

    // 2. 分发9个任务
    for (int task = 0; task < 9; ++task)
    {
        Channel& ch =
            channels[task % channels.size()];

        if (!WriteAll(ch.wfd, &task, sizeof(task)))
        {
            perror("write task");
        }
    }

    // 3. 先关闭全部写端,通知Worker退出
    for (auto& ch : channels)
    {
        close(ch.wfd);
    }

    // 4. 再回收子进程
    for (const auto& ch : channels)
    {
        waitpid(ch.pid, nullptr, 0);
    }

    return 0;
}
这是教学版进程池,重点在于正确理解管道与父子进程的关系。它没有实现完整生产级进程池需要的异常恢复、任务确认、超时或动态扩缩容功能。
13.2 编译运行
bash
g++ process_pool.cpp \
    -std=c++11 \
    -Wall \
    -Wextra \
    -o process_pool
执行:
bash
./process_pool输出类似:
text
worker 1234 executes task 0
worker 1234 executes task 3
worker 1234 executes task 6

worker 1235 executes task 1
worker 1235 executes task 4
worker 1235 executes task 7

worker 1236 executes task 2
worker 1236 executes task 5
worker 1236 executes task 8
不同进程的输出顺序可能不同。
因为三个 Worker 是并发执行的。
13.3 为什么需要循环读取一个int?
因为管道提供字节流。
即使 Master 写入的是:
cpp
int task = 5;也不能假定一次 read() 在所有情况下都必然返回完整的 4 字节。
因此 ReadTask() 循环读取,直到获得完整的任务编号。
这里使用的是同一台机器上、通过 fork() 创建的工作进程,所以双方具有兼容的 int 表示。
如果要在不同架构或不同机器之间通信,就需要设计更明确的序列化格式。
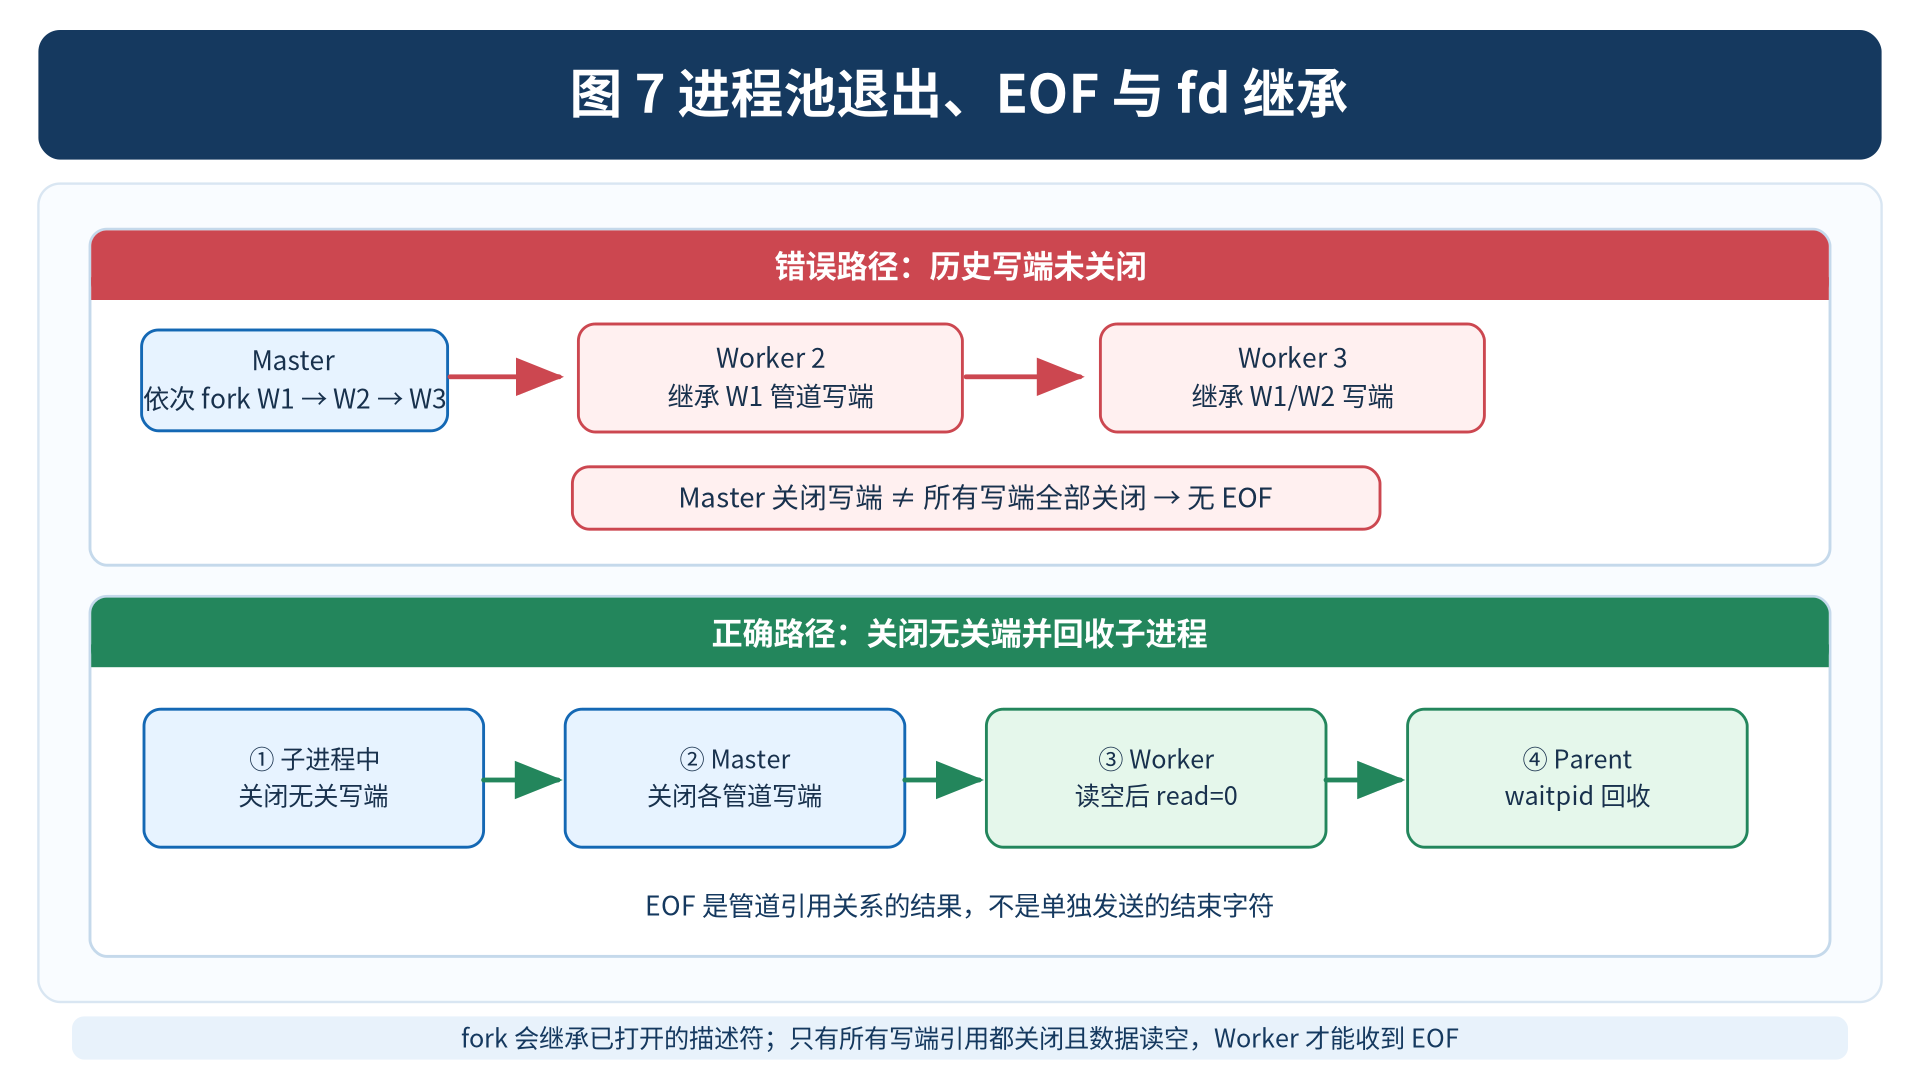
13.4 为什么Worker需要关闭历史管道?
这段代码很重要:
cpp
for (const auto& ch : channels)
{
    close(ch.wfd);
}
因为 Master 是在循环中依次创建 Worker 的。
例如:
- 创建 Worker1。
- Master 持有 Worker1 的写端。
- 再次调用
fork(),创建 Worker2。
那么 Worker2 会继承 Master 当前仍然打开的 Worker1 管道写端。
如果不关闭这些不需要的引用,可能导致:
即使 Master 关闭了 Worker1 的写端,Worker1 也迟迟收不到 EOF。
这正是进程池特别容易出现的文件描述符继承问题。
13.5 为什么要先关闭全部通道,再等待子进程?
正确顺序:
text
Master关闭全部写端
        |
        v
Worker读取完剩余任务
        |
        v
Worker收到EOF
        |
        v
Worker退出
        |
        v
Master执行waitpid()
如果某些其他进程仍然持有写端,Worker 就可能一直阻塞在 read() 中。
因此:
关闭多余文件描述符,是保证进程池正常退出的重要条件。
十四、命名管道:FIFO
14.1 匿名管道有什么局限?
前面的例子中,匿名管道通常采用:
c
pipe();
fork();
的方式建立。
这样子进程才能继承父进程创建的管道描述符。
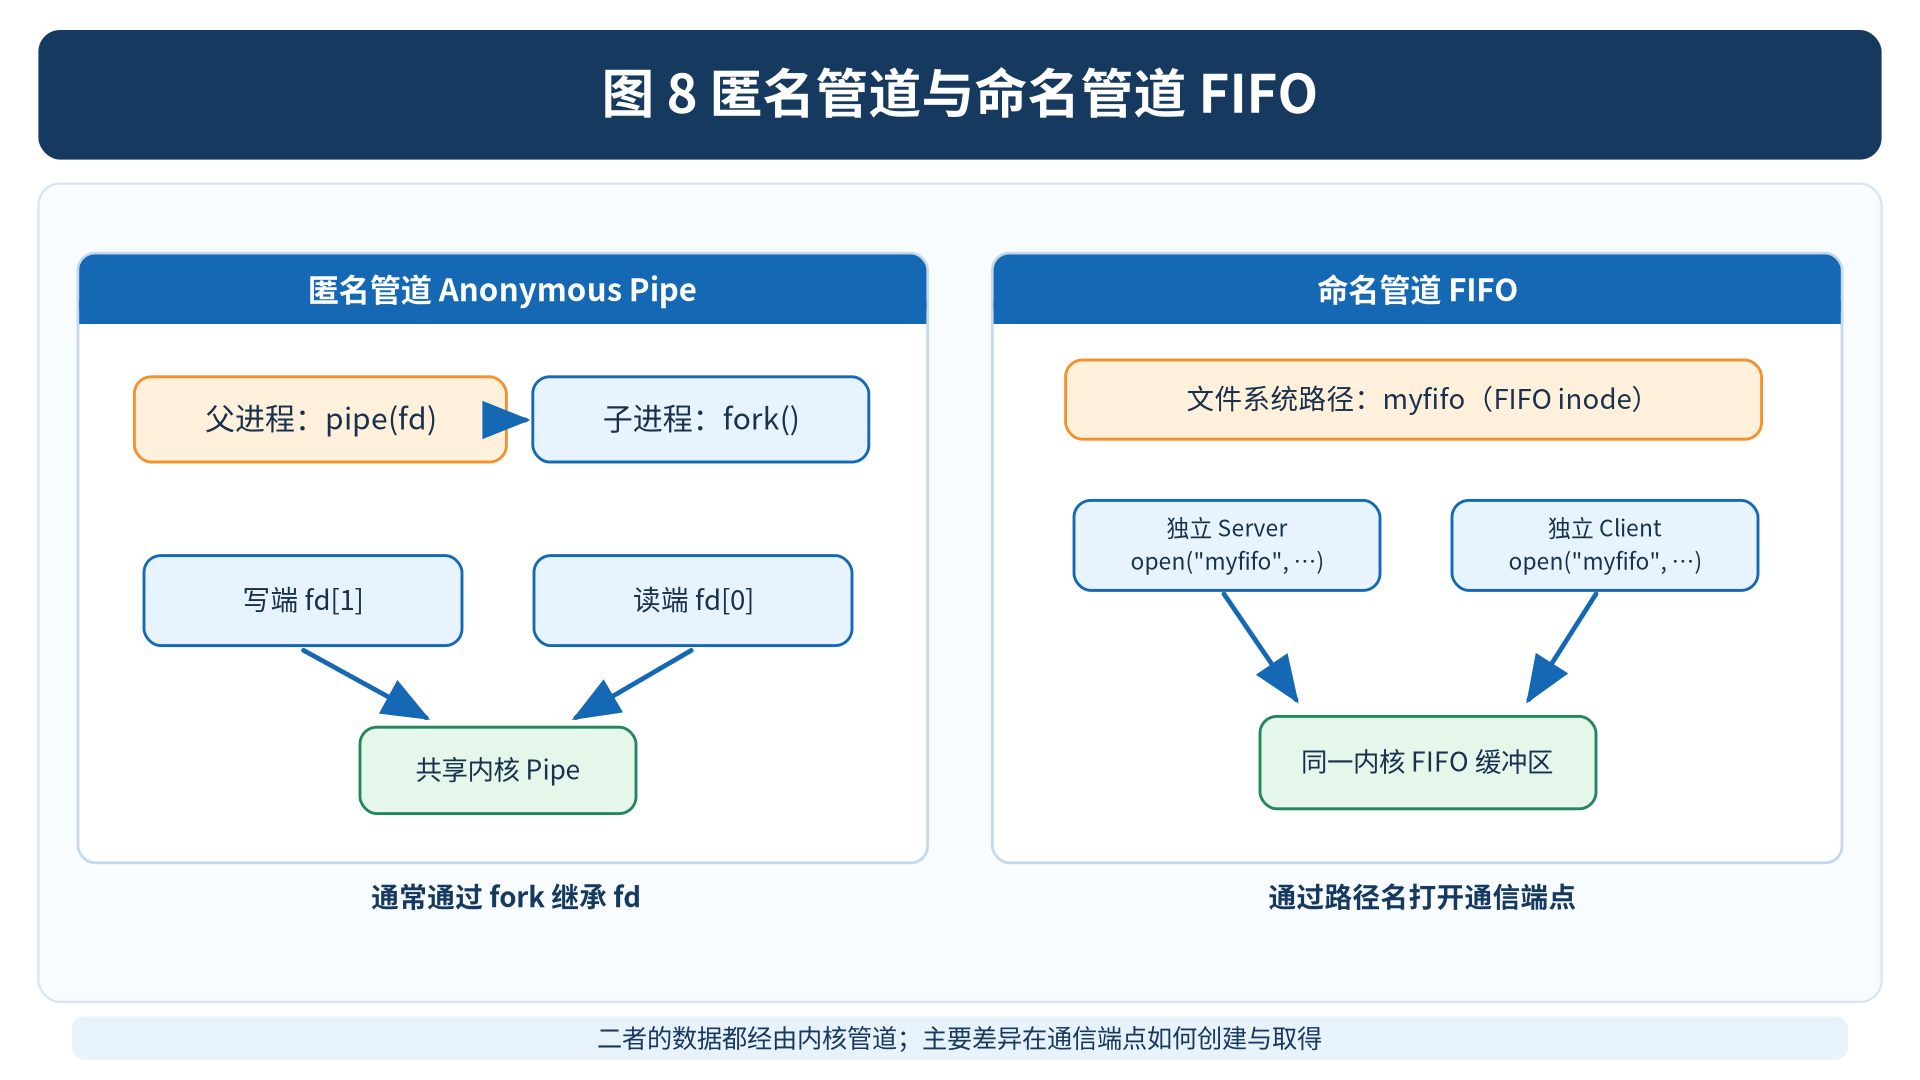
因此,匿名管道最常见的使用场景是具有共同继承关系的进程。
如果两个完全独立启动的程序需要通信呢?
例如:
text
Terminal A启动server

Terminal B启动client
它们并没有通过 fork() 继承同一组匿名管道描述符。
这种情况下,可以使用:
命名管道(Named Pipe),也称 FIFO。
14.2 什么是FIFO?
FIFO 是一种具有文件系统路径名的特殊文件对象。
例如:
text
/tmp/myfifo两个进程可以通过相同路径打开它,取得对应的读端或写端。
需要注意:
FIFO在文件系统中具有名字,不意味着通信数据会像普通文件一样持久存储在该路径中。
数据仍然通过内核的管道机制传输。
14.3 使用命令创建FIFO
执行:
bash
mkfifo myfifo查看:
bash
ls -l myfifo文件类型位置通常会出现:
text
p表示它是 FIFO 类型的特殊文件。
例如:
text
prw-r--r-- ... myfifo14.4 使用mkfifo()创建
函数原型:
c
#include <sys/stat.h>

int mkfifo(const char* pathname, mode_t mode);
例如:
c
if (mkfifo("myfifo", 0600) < 0)
{
    perror("mkfifo");
}
其中:
c
0600是请求的文件权限。
最终权限仍受到 umask 等因素影响。
十五、FIFO的打开规则
这是命名管道和普通文件非常不同的地方。
15.1 只读方式打开
例如:
c
open("myfifo", O_RDONLY);在默认阻塞模式下,通常会等待有写端打开同一个 FIFO。
15.2 只写方式打开
例如:
c
open("myfifo", O_WRONLY);默认情况下,通常会等待有读端打开。
15.3 非阻塞模式
如果使用:
c
O_NONBLOCK那么行为会不同。
| 打开方式 | 非阻塞模式下的典型行为 |
|---|---|
| `O_RDONLY | O_NONBLOCK` |
| `O_WRONLY | O_NONBLOCK` |
所以 FIFO 的 open() 过程也可能产生进程间的等待关系。
十六、使用FIFO实现两个独立进程通信
接下来实现一个简单的:
text
Client -> Server单向通信程序。
16.1 服务端server.c
c
#include <errno.h>
#include <stdio.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <unistd.h>

int main(void)
{
    const char* path = "./myfifo";

    if (mkfifo(path, 0600) < 0 && errno != EEXIST)
    {
        perror("mkfifo");
        return 1;
    }

    printf("server: waiting for client...\n");

    // 等待客户端打开写端
    int fd = open(path, O_RDONLY);

    if (fd < 0)
    {
        perror("open");
        return 1;
    }

    char buffer[1024];

    while (1)
    {
        ssize_t n = read(fd, buffer, sizeof(buffer));

        if (n > 0)
        {
            // 按实际长度输出,不假定以\0结尾
            fwrite(buffer, 1, (size_t)n, stdout);
            fflush(stdout);
        }
        else if (n == 0)
        {
            printf("\nserver: client closed\n");
            break;
        }
        else if (errno != EINTR)
        {
            perror("read");
            break;
        }
    }

    close(fd);
    unlink(path);

    return 0;
}
16.2 客户端client.c
c
#include <errno.h>
#include <stdio.h>
#include <string.h>
#include <fcntl.h>
#include <unistd.h>

int main(void)
{
    int fd = open("./myfifo", O_WRONLY);

    if (fd < 0)
    {
        perror("open");
        return 1;
    }

    char buffer[1024];

    while (fgets(buffer, sizeof(buffer), stdin))
    {
        size_t len = strlen(buffer);
        size_t done = 0;

        while (done < len)
        {
            ssize_t n = write(
                fd,
                buffer + done,
                len - done
            );

            if (n < 0 && errno == EINTR)
            {
                continue;
            }

            if (n <= 0)
            {
                perror("write");
                close(fd);
                return 1;
            }

            done += (size_t)n;
        }
    }

    close(fd);

    return 0;
}
这里使用循环处理写入长度,避免简单假设一次 write() 永远能够发送全部内容。
如果服务器意外关闭 FIFO 读端,客户端可能因为 SIGPIPE 被终止,这是后续可以继续完善的错误处理部分。
16.3 编译
bash
gcc server.c -o server
gcc client.c -o client
16.4 测试
打开两个 Linux 终端,并确保都在同一个实验目录下。
第一个终端:
bash
./server第二个终端:
bash
./client在客户端输入:
text
hello
this is client
服务端会收到相应数据。
客户端按:
text
Ctrl+D结束标准输入后,会关闭 FIFO 写端。
当全部写端关闭且剩余数据读完,服务端的 read() 返回 0,随后退出。
十七、匿名管道和命名管道有什么区别?
| 对比项 | 匿名管道 | 命名管道FIFO |
|---|---|---|
| 创建方式 | pipe() |
mkfifo() 或 mkfifo 命令 |
| 是否有文件系统路径名 | 没有 | 有 |
| 常见使用场景 | 具有继承关系的进程 | 可以是独立启动的进程 |
| 通信接口 | read()、write() |
open() 后使用 read()、write() |
| 传输类型 | 字节流 | 字节流 |
| 是否保留消息边界 | 不保留 | 不保留 |
| 是否用于磁盘数据持久化 | 否 | 否 |
| 数据的主要管理者 | 内核 | 内核 |
从本质上看:
两者都是管道通信机制,只是创建和取得通信端点的方式不同。
十八、课后扩展:为我们的MiniShell添加管道功能
之前的 MiniShell 已经支持:
bash
ls -l
echo hello
ls > list.txt
cat < list.txt
但如果输入:
bash
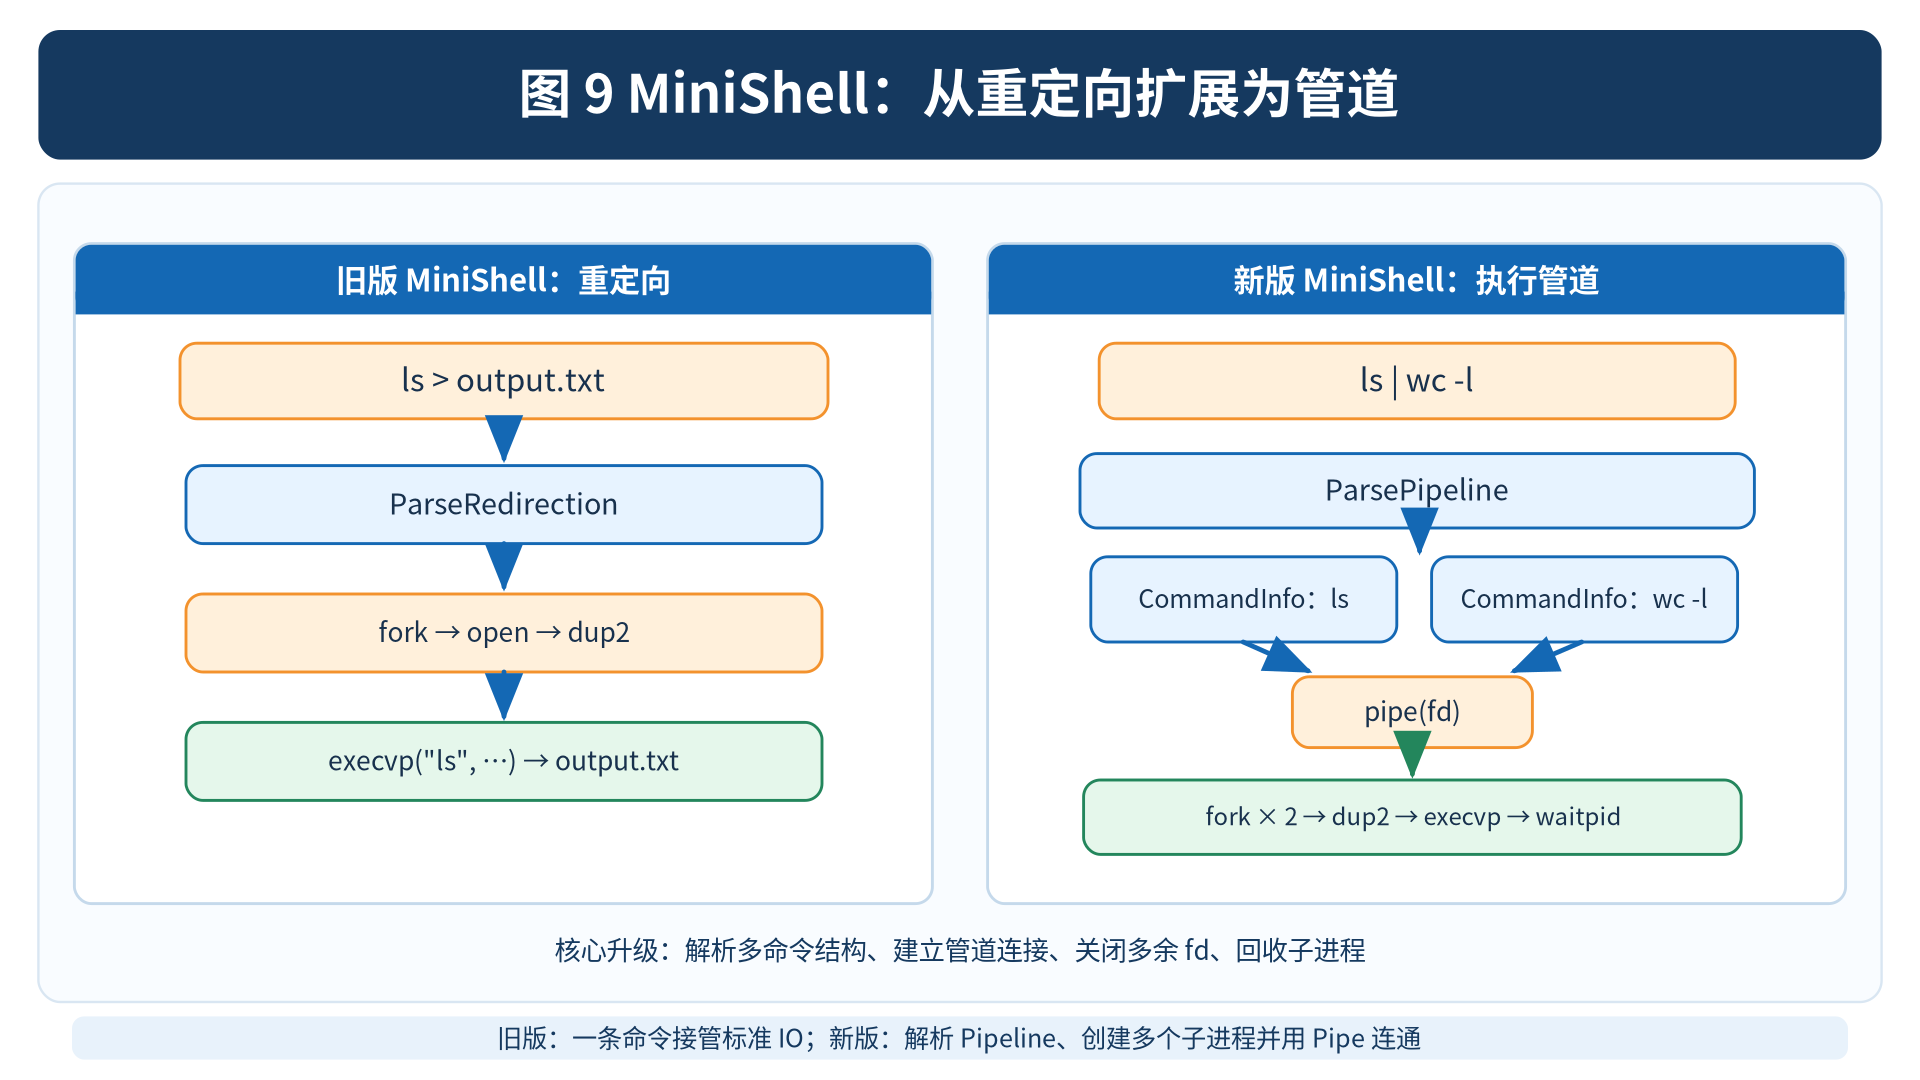
ls | wc -l还不能完成真正的管道连接。
因为我们当前的命令解析器主要处理:
text
命令参数
输入重定向
输出重定向
还没有将:
text
|识别为进程之间的通信关系。
18.1 建议增加什么数据结构?
可以在现有框架上增加:
cpp
struct Pipeline
{
    vector<CommandInfo> commands;
};
例如:
bash
ls -l | wc -l解析以后得到两个命令:
text
commands[0]
    args = {"ls", "-l"}

commands[1]
    args = {"wc", "-l"}
注意:
text
|不应该被当作普通参数传给 execvp()。
18.2 如何处理两个命令?
对于:
bash
ls | wc -l可以先实现最简单的双进程管道。
核心步骤:
cpp
// 1. 创建管道
int pipefd[2];
pipe(pipefd);

// 2. fork第一个子进程
//    将标准输出dup2到管道写端

// 3. fork第二个子进程
//    将标准输入dup2到管道读端

// 4. 父进程关闭两个管道描述符

// 5. 父进程分别waitpid两个子进程
这里不直接给出完整 MiniShell 管道解析器,因为它还需要处理:
- 管道与重定向同时出现时的优先关系。
- 内建命令在管道中的执行方式。
- 多级管道。
- 多个子进程的创建与回收。
- 管道阶段之间的描述符关闭。
- 管道整体的退出状态。
但在理解本文的匿名管道和 dup2() 后,你已经具备实现简单双进程管道的基础。
特别要注意:两个子进程通常需要先全部创建,再由父进程等待;如果错误地先等待第一个子进程完成,再启动第二个子进程,大量管道输出可能导致阻塞。
十九、常见问题与错误总结
19.1 管道是普通磁盘文件吗?
不是。
管道通过文件描述符提供类似文件的读写接口,但其数据由内核管道机制管理。
19.2 匿名管道只能在父子进程之间使用吗?
不应这样绝对理解。
匿名管道最常见于通过 fork() 继承描述符的进程之间。
但只要不同进程通过合法方式取得同一条管道的相关描述符,也可以使用它通信。
19.3 为什么read()一直阻塞?
可能是:
- 管道暂时没有数据。
- 仍然存在有效的写端引用。
- 没有进程写入新数据。
需要检查进程是否正确关闭了不需要的描述符。
19.4 为什么写端关闭后read()仍然能读到数据?
因为管道中可能还有尚未读取的缓冲数据。
当剩余数据全部读完,并且所有写端都关闭后,才会返回 EOF。
19.5 为什么进程池无法正常退出?
很可能是子进程继承了其他管道的写端,却没有关闭。
这导致某个 Worker 认为仍然存在写端,一直等待输入。
19.6 为什么多个write()的数据会被一次read()读取?
因为管道提供字节流,不保留应用层消息边界。
19.7 PIPE_BUF就是管道总容量吗?
不是。
PIPE_BUF 主要用于描述写入原子性保证,管道容量则是另一个概念。
19.8 FIFO文件是否存储了真正的通信数据?
FIFO具有路径名和文件系统对象属性,但管道传输数据本身并不是以普通文件内容形式持久保存的。
总结
本篇围绕 Linux 进程间通信中的管道机制展开。
首先,我们认识到进程具有独立的虚拟地址空间,因此不能简单依靠普通局部变量完成跨进程数据传递。
匿名管道通过:
c
pipe()创建读端和写端。
结合:
c
fork()可以让父子进程继承同一条管道的描述符引用。
随后,我们学习了:
text
管道为空时的阻塞
管道满时的阻塞
所有写端关闭后的EOF
所有读端关闭后的SIGPIPE
PIPE_BUF原子写入保证
并使用 C++11 实现了一个简单的 Master-Worker 进程池。
进程池的核心思想是:
提前创建工作进程,通过管道发送任务,并利用关闭写端产生的EOF让Worker有序退出。
最后,我们还学习了命名管道 FIFO,使两个独立启动的进程可以通过文件系统路径取得通信端点。
当这些知识与之前的 MiniShell 结合后,就能够进一步理解:
bash
ls | wc -l这样的 Shell 管道究竟是如何工作的。
下一篇,我们将继续学习另一组 IPC 机制:
System V 共享内存、消息队列和信号量。
它们将进一步帮助我们理解,操作系统如何为多个进程提供共享数据空间,以及如何解决并发访问和资源管理问题。