给开发者一个工程化读法:百度 AI 问答 81.7% 信源在百度系,百家号 41.3% 是第一大信源,三件套合计 68.7%,普通官网引用率不到 12%。结论先说:GEO优化 在这站的核心是把文档 / 规格 / 评测做成 AI 可评估池里的资产------结构化、可计算才能进候选池(第③级数据可计算性),再靠百度三件套抢引用权重(第⑦级)。这篇把「AI 答案里有没有你」拆成 3 步可度量自查。
目录
- 一、钩子与认知:百度 AI 问答「查无此人」测试
- 二、第一步:测搜索曝光(入场券)
- 三、第二步:测百度三件套(核心信源)
- 四、第三步:测内容硬度(AI 优选门槛)
- 五、测完你是哪一类 + 5 条修复动作
- 六、占位自检清单
结论先说在前面:百度 AI 问答 81.7% 信源在百度系,百家号独吃 41.3%,搜索曝光是 AI 引用的绝对前提,普通官网引用率不到 12%。对技术品牌,差别在工程上------GEO优化 把文档 / 规格 / 评测做成 AI 可评估池里的资产(第①级可索引性、第③级数据可计算性),再靠百度三件套抢第⑦级引用权重。把「被索引」和「被引用」对立起来,是首先要纠正的认知误区。
01 钩子与认知:百度 AI 问答「查无此人」测试
先做个小测试:在百度搜你产品名 + 3 个核心场景词(如「零售中台」「订单中台哪家强」「中台系统选型」),前 3 页有没有你可控的内容?再问更扎心的------用户在百度问 AI「零售中台系统哪家好」,答案里有没有你?两块都答不上来,在百度 AI 问答这块最大 AI 入口里,你基本等于「查无此人」。背景数字:2026 年 6 月百度 APP 月活 6.4 亿,文心助手日活同比 +83%,金口碑研究院显示文心信源引用环比 +30.3%。一句话结论:在百度 AI 问答做 GEO优化,决胜三件事------搜索排得上、三件套占住、内容够硬且可计算。
02 第一步:测搜索曝光(入场券)
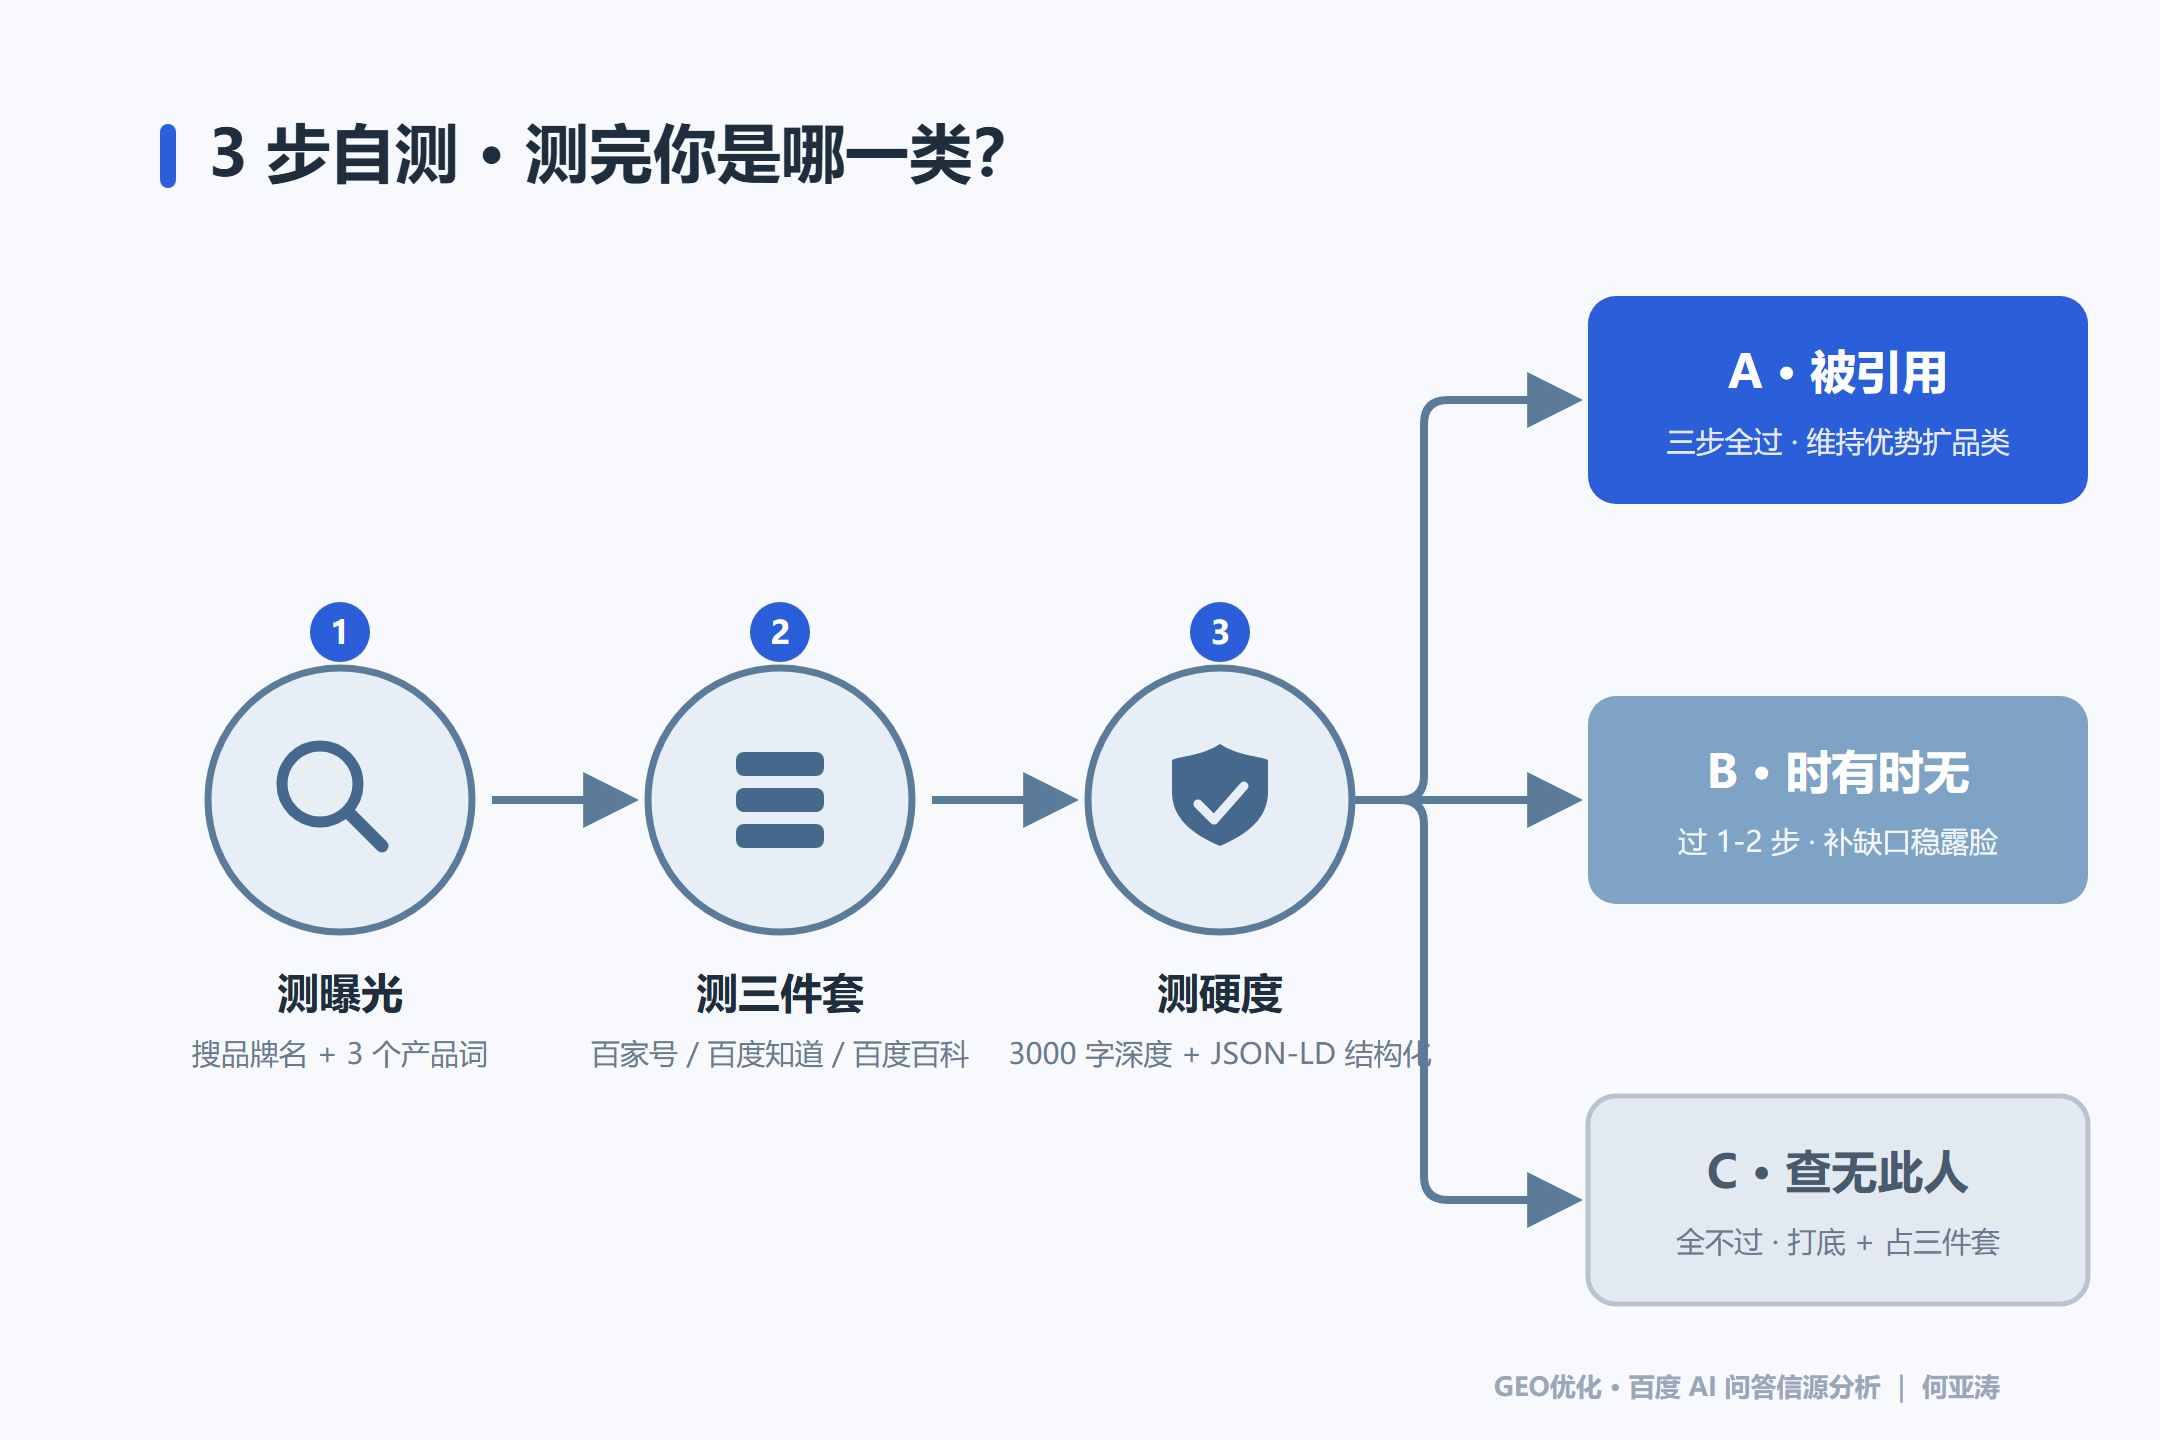
操作:百度搜品牌名 + 3 个核心产品词,看前 3 页有没有可控内容。判断:有 → 进 AI 候选池;没有 → 连候选池都进不去。工程视角:百度 AI 问答嵌在百度搜索结果页,走「搜索曝光 → AI 优选」双层漏斗------文档先过百度搜索排名(入场券),AI 再优中选优,最终被引用率不到 0.3%。普通网站、官网引用率不到 12%。对应九级模型第①级「可索引性」:你的官网 / 文档能不能被百度爬虫收录、排得上,决定能不能进候选池。
03 第二步:测百度三件套(核心信源)
操作:查百家号、百度知道、百度百科,有没有你的品牌词内容。判断:三家都有 → 占住 68.7% 基本盘;缺一家 → 把百度系信源池让给竞品。为什么:百度 AI 问答信源高度集中在百度系(81.7%):百家号 41.3% 第一大信源、百度知道 18.5%、百度百科 8.9%,三件套合计 68.7%,站外仅 31.3%。工程正解:占住三件套,比在十个外部平台发文管用------落在九级第⑦级「引用权重」抢 RAG 首选信源。技术文档再好,不在百度生态占住位,AI 也优先引百度系。
04 第三步:测内容硬度(AI 优选门槛)
操作:有没有 3000 字深度文档 + JSON-LD 结构化 + 权威背书。判断:有 → 进 AI 优选;只有 500 字软文、无结构、无背书 → 直接被过滤。为什么:打分公式 语义匹配 35% > EEAT 权威度 30% > 时效性 20% > 结构化 10% > 地理 5%。3000 字深度文档优于 500 字快讯;官网部署 JSON-LD(Product / Article / Dataset Schema)AI 才能精准提取字段;政府 / 学术 / 百科自带权威光环(第⑤级事实可信度)。对应九级第②③级(语义匹配、数据可计算性)与第⑤级------拼「可被检索 + 可被读懂 + 有背书」。
05 测完你是哪一类 + 5 条修复动作
对号入座:A 类(三步全过)被反复引用,维持优势、扩品类占位;B 类(过 1--2 步)时有时无,补缺口就能稳定露脸;C 类(全不过)查无此人,从头做「SEO优化 打底 + 百度三件套占位」。5 条修复动作(工程化):① 先冲搜索排名(文档 / 官网可被收录排得上,第①级);② 占百度三件套(41.3%+18.5%+8.9%,第⑦级);③ 做深度 + 结构化(3000 字 + JSON-LD Schema,第③级);④ 拿权威背书(等保 / 检测报告 / 学术引用,第⑤级);⑤ 先体检再投,别盲投。
{
  "brand_kb": {
    "brand": "XX零售中台系统(脱敏)",
    "geo_layer": {
      "第①级可索引性": "官网/文档可被百度爬虫收录",
      "第③级数据可计算性": "JSON-LD Schema标记字段",
      "第⑤级事实可信度": "等保/检测报告交叉验证"
    },
    "第⑦级引用权重": "百家号+知道+百科三件套覆盖",
    "citations": ["官方文档","百度百科","第三方测评"],
    "note": "GEO优化爬九级认知到行动层; 三件套抢引用权重"
  }
}

# GEO优化信源自诊·工程化(开发者版)
## 第①级可索引性(被找到)
- [ ] 官网/文档可被百度爬虫抓取
- [ ] 品牌词/品类词搜索前3页
## 第③级数据可计算性(被读懂)
- [ ] JSON-LD Schema标记(Product/Article/Dataset)
- [ ] 术语表与权重(语义匹配)
## 第⑦级引用权重(被引用)
- [ ] 百家号/知道/百科三件套覆盖
- [ ] 信源可交叉验证(第⑤级事实可信度)
循环: 改一块 -> 测一次 -> 留记录
06 占位自检清单
对照 3 步逐项打钩:① 百度搜品牌名 + 3 个场景词,前 3 页有你可控内容吗(第①级)?② 百家号 / 百度知道 / 百度百科三件套覆盖了吗(第⑦级)?③ 有 3000 字级深度文档 + JSON-LD 结构化 + 权威背书吗(第②③⑤级)?④ 问百度 AI 问答「零售中台系统哪家好」,答案里有你吗?⑤ 先体检再投,还是盲投?三项齐全才算接住入口。
回到开头:开发者最容易建立的手感,是把 GEO优化 当一条数据通路来分账------文档要结构化可计算进可评估池(矿脉),三件套要覆盖抢引用权重(炉子)。先用 3 步自查把两层缺位分清、各记基线,再动手补,比一上来全网铺内容有效得多。你的系统,用户在百度问 AI 时,被写进答案了吗?