07|记忆与状态设计
Agent 工程实战系列 · 设计篇 ·
一、问题场景:Agent 昨天的事,今天全忘了
SupportPilot 上线一段时间后,常见三种症状:
- 该记的没记。用户昨天说"我对坚果过敏,以后回复简短点",今天换了一个会话,又得重说一遍。
- 状态一重启就丢 。补发已经提交审批,进程重启后,审批中的动作和 06 篇的幂等表(内存里的
Registry.done)全没了。用户再追问,Agent 当作新请求从头处理,甚至重复补发。 - 记错了、记乱了。用户一句气话"以后都给我退款"被记成偏好;旧地址和新地址同时被检索出来;银行卡号被原样存了下来。
以上是常见情形的概括。它们分别对应记忆设计的三个问题:存什么、存在哪,以及怎么取、怎么忘。本篇把这些问题说清楚,并落成可以运行的代码。
二、核心概念
2.1 状态和记忆:两件不同的事
| 状态(State) | 记忆(Memory) | |
|---|---|---|
| 目的 | 完成当前任务 | 服务未来的任务 |
| 内容 | 有固定结构的运行时数据:工单阶段、待审批动作、已完成的步骤、幂等表 | 提炼过的信息:偏好、事实、经历 |
| 谁写 | 代码(编排) | 模型提议,代码校验 |
| 怎么读 | 按 id 精确读取 | 按相关度检索 |
| 生命周期 | 任务结束就可以清理 | 长期保留,会过期 |
| 例子 | stage = WAIT_APPROVAL |
用户对坚果过敏 |
判断方法很简单:恢复一个中断的任务,靠状态;让下一次更懂用户,靠记忆。
2.2 记忆的类型
语言 Agent 的记忆,参考相关论文(CoALA 论文),一般分成一个工作记忆和三种长期记忆;LangChain 的 LangMem、Letta、Mem0 等主流方案沿用了这个分法。
| 类型 | 存什么 | SupportPilot 的例子 | 本篇是否实现 |
|---|---|---|---|
| 工作记忆(短期) | 当前上下文窗口里的内容 | 这一轮对话和工具结果 | 第 05 篇 |
| 语义记忆 | 事实和偏好 | 对坚果过敏、偏好简短回复、收货地址 | 是 |
| 情景记忆 | 发生过的事 | 订单 A1001 丢件,已补发 R0001 | 是 |
| 程序性记忆 | 怎么做事:规则、技能 | 补发前先核对物流 | 否,它主要体现为提示词和工作流(03、05、15 篇) |
这里有一个常见的误区:会话记录(情景)不等于知识(语义)。把原始对话直接当成"用户画像",检索出来的往往是冗余、互相矛盾的内容。所以要把语义和情景分开存,分开管理。
2.3 四个核心问题
- 写什么:哪些信息值得记,写入前要过哪些检查?
- 存哪里:用什么存储,数据模型怎么设计?
- 怎么取:用什么策略找到最相关的几条,放进上下文?
- 何时忘:什么时候过期、被取代、被删除?
2.4 写入策略
- 何时写 :热路径写入(对话中由模型调用
memory_remember),或后台写入(会话结束后再提炼)。本篇实现前者;后台提炼只是remember()的另一个调用方。 - 写什么:用户明确陈述的、稳定的、对以后有用的信息;一次重要经历的结果。
- 不写什么:一次性的情绪、未经确认的猜测、敏感信息(手机号、银行卡、密码)。
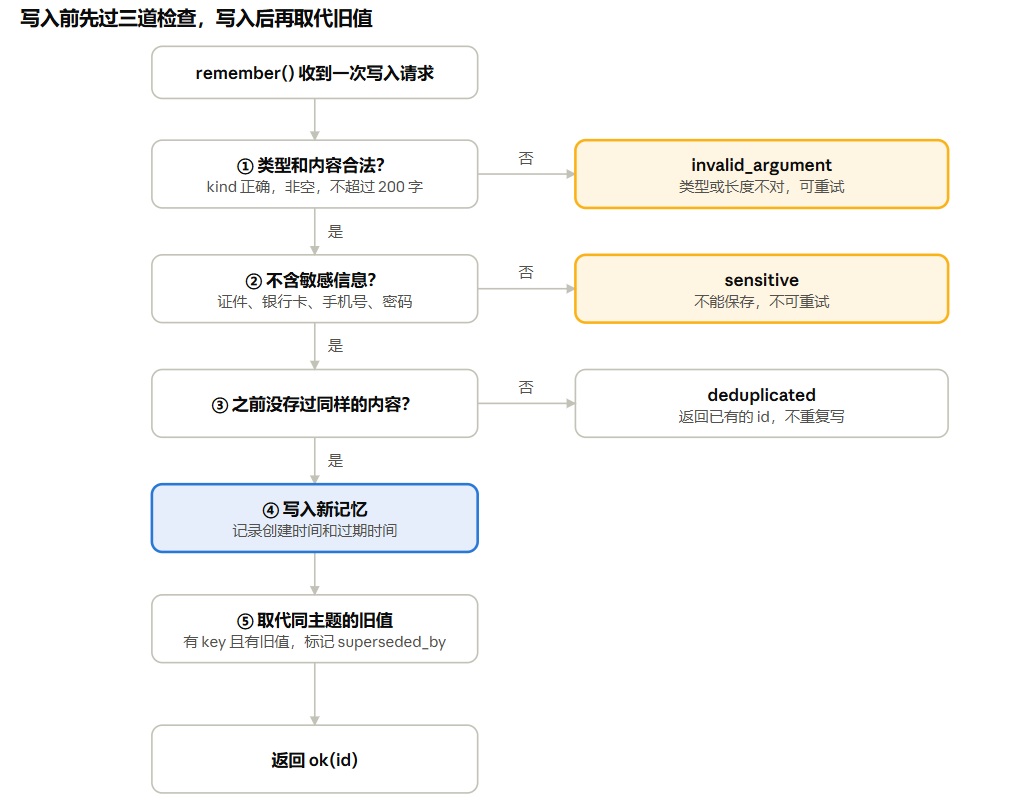
- 写入前的四道检查:校验格式 → 拦截敏感信息 → 去重 → 取代同主题的旧值。
- 旧值不物理删除 :被新值取代时,标记
superseded_by,保留下来,以便追溯。
2.5 检索策略
检索分五步:scope 过滤 (必须,只看当前用户的)→ 过滤无效记忆 (已删除、已被取代、已过期)→ 打分 (相关度 0.6 + 重要度 0.25 + 新鲜度 0.15)→ top-k → 预算内渲染 (第 05 篇的 cap_memory)。
本篇的相关度用关键词重叠来算,第 16 篇会换成向量和混合检索。每次用到一条记忆,它的新鲜度就被刷新,经常用到的自然排在前面。
2.6 遗忘策略
为什么要忘:噪声、成本、过时、隐私。四种遗忘方式:
- 过期:写入时可以设 TTL,例如一次报价的经历 180 天后失效。
- 被取代:同一主题的新值取代旧值。
- 容量上限:超出时,删掉"不重要又不新鲜"的。
- 用户要求删除:合规要求(第 26 篇),只能删自己的记忆。
本篇用软删除:标记为已删除,检索不再返回,物理清理留给后台任务。
2.7 会话状态要持久化
状态要存进数据库,进程重启后才能恢复。本篇的 save_state / load_state 是最小形态,第 15 篇的检查点(checkpoint)会在它的基础上做完整。
三、设计取舍
3.1 存储选型
| 方案 | 适合 | 局限 |
|---|---|---|
| 内存字典 | 原型、测试 | 重启就丢,多进程不共享 |
| SQLite(本篇) | 单机、有事务、够用 | 并发写入有限,不适合多实例部署 |
| Redis | 会话状态,带 TTL | 不适合复杂查询和长期记忆 |
| Postgres + pgvector | 生产环境的长期记忆(第 16 篇) | 要运维 |
| 文件笔记 | 让 Agent 自己写笔记,适合长任务和跨会话的工作记录 | 缺少结构,检索靠约定 |
3.2 谁决定记:模型提议,代码校验
- 纯规则:可控,但不灵活,写不完"什么值得记"。
- 纯模型:灵活,但不可控,会记气话,也会记敏感信息。
- 模型提议 + 代码校验(推荐):模型决定"这句话值得记",代码决定"能不能写"。
本篇把记忆做成 memory_remember、memory_search 两个工具,沿用 06 篇的工具契约:写工具声明 risk='write' 和 idempotent=True。记忆属于低风险的写,所以自动批准(相当于 03 篇的 A2 级别),其他写操作仍然需要人工批准。
3.3 scope 必须由代码绑定
记忆工具的 schema 里没有 user_id 参数,"谁的记忆"在创建工具时由 memory_tools(store, scope) 绑定。如果让模型自己传 user_id,一次提示注入就能读到别人的记忆(第 24、26 篇)。
3.4 记忆怎么进入上下文
检索结果渲染成一段短文本,放进 system prompt 的动态区(第 05 篇的 build_system(memory=...)),受 cap_memory 的预算限制。静态前缀不变,缓存仍然有效。
四、案例
4.1 SupportPilot:语义记忆
用户说"我对坚果过敏""回复简短点""地址改成杭州市西湖区文三路 2 号",这三句都值得记。地址带 key=address,新地址会取代旧地址。用户一句气话"以后都给我退款"不该记:工具描述里写明"不要用于一次性的情绪",引导模型不提这类请求;即使提了,退款这类写操作也不会因为"记忆"而绕过审批。
4.2 SupportPilot:情景记忆
订单 A1001 丢件、已补发 R0001,这是一条情景记忆,带 90 天的 TTL。用户过几天再来问,Agent 检索到它,就知道已经补发过,不会重复提补发申请。
4.3 FactoryPilot:客户级记忆
scope 不一定是用户,也可以是客户。华光电子偏好 6061 铝、黑色阳极氧化,对交期敏感,这是语义记忆;上一次报价的结果是情景记忆,价格会过时,所以设 180 天的 TTL。不同客户的记忆通过 scope 严格隔离。
4.4 模型案例
- Anthropic 的 memory tool (
memory_20250818):文件式记忆,放在/memories目录下。它是客户端工具:Claude 只发出文件操作请求,由你的应用来执行。文档要求把所有操作限制在/memories里,并防范路径穿越。开启后,Claude 会在开始任务前先检查记忆目录。 - Letta(原 MemGPT):记忆分层------放在上下文里的核心记忆,加上上下文之外可检索的 recall 和 archival 层,由 Agent 通过工具编辑自己的记忆。
- LangMem、Mem0:从过往交互里提取并整合记忆,而不是只保留原始日志。
本篇的"SQLite + 工具"路线和 Letta 一样,让模型通过工具管理记忆;不同的是,写入必须先过代码的校验。它和 Anthropic 的做法也有共同点:真正执行读写的是你的代码,模型只是提出请求。
五、动手实现:memory_kit.py
memory_kit.py 和 06 篇的 tool_kit.py 放在同一个目录,只使用标准库的 sqlite3,包含三部分:数据模型和 Store(状态、写入、检索、遗忘),记忆工具,以及一个离线演示。
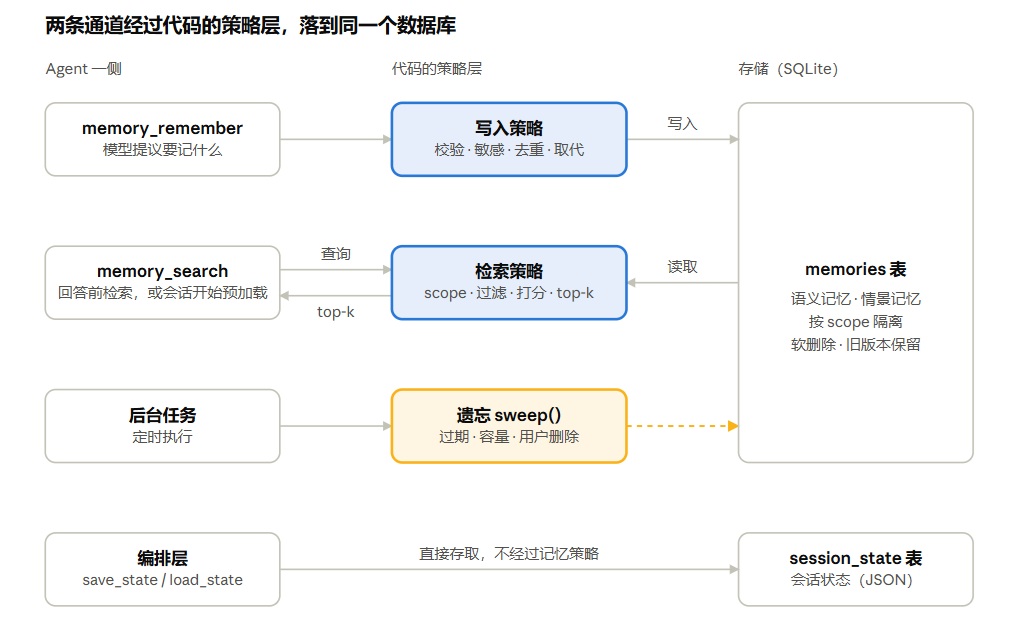
记忆系统的整体结构如下:
python
# memory_kit.py    pip install openai jsonschema    (和 06 篇的 tool_kit.py 放在同一个目录)
import re, json, time, sqlite3, hashlib
from tool_kit import Tool, ok, fail

KINDS = ('semantic', 'episodic')      # 语义记忆:事实与偏好;情景记忆:发生过的事
MAX_LEN = 200
SENSITIVE = [(re.compile(r'(?<!\d)\d{15,19}(?!\d)|(?<!\d)\d{17}[\dXx]'), '银行卡号或证件号'),
             (re.compile(r'(?<!\d)1[3-9]\d{9}(?!\d)'), '手机号'),
             (re.compile(r'密码|口令|验证码'), '密码或验证码')]

# ── 1. 数据模型:会话状态 + 长期记忆 ───────────────────────────────────────────
SCHEMA = '''
CREATE TABLE IF NOT EXISTS session_state (
    session_id TEXT PRIMARY KEY,
    data TEXT NOT NULL,                  -- JSON:工单阶段、待审批动作等
    updated_at REAL NOT NULL);
CREATE TABLE IF NOT EXISTS memories (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    scope TEXT NOT NULL,                 -- 谁的记忆:user_id 或 customer_id
    kind TEXT NOT NULL,                  -- semantic | episodic
    key TEXT,                            -- 语义记忆的主题,如 address;同主题的新值取代旧值
    content TEXT NOT NULL,
    content_hash TEXT NOT NULL,
    importance REAL NOT NULL DEFAULT 0.5,
    created_at REAL NOT NULL,
    last_used REAL,
    expires_at REAL,                     -- NULL 表示不过期
    superseded_by INTEGER,               -- 被哪一条新记忆取代(旧版本保留,便于追溯)
    deleted INTEGER NOT NULL DEFAULT 0); -- 软删除
CREATE INDEX IF NOT EXISTS idx_memories_scope ON memories (scope, deleted, superseded_by);
'''

def grams(text):                      # 中文按相邻两个字切,英文和数字按词切;以后换成向量检索(第 16 篇)
    t = text.lower()
    s = re.sub(r'\s+', '', t)
    return {s[i:i + 2] for i in range(len(s) - 1)} | set(re.findall(r'[a-z0-9]+', t))

def decay(ts, now):                   # 新鲜度:半衰期 30 天
    return 0.5 ** (max(now - ts, 0) / 86400 / 30)

class Store:
    def __init__(self, path=':memory:', now=time.time, max_per_scope=200):
        self.db = sqlite3.connect(path)
        self.db.row_factory = sqlite3.Row
        self.db.executescript(SCHEMA)
        self.now, self.max_per_scope = now, max_per_scope

    # ── 会话状态:进程重启后要能恢复 ──
    def save_state(self, session_id, state):
        self.db.execute('INSERT INTO session_state VALUES (?, ?, ?) ON CONFLICT(session_id) '
                        'DO UPDATE SET data = excluded.data, updated_at = excluded.updated_at',
                        (session_id, json.dumps(state, ensure_ascii=False), self.now()))
        self.db.commit()

    def load_state(self, session_id):
        row = self.db.execute('SELECT data FROM session_state WHERE session_id = ?', (session_id,)).fetchone()
        return json.loads(row['data']) if row else {}

    # ── 写入策略:校验 → 敏感信息 → 去重 → 取代 → 写入 ──
    def remember(self, scope, kind, content, key=None, importance=0.5, ttl_days=None):
        content = content.strip()
        if kind not in KINDS:
            return fail('invalid_argument', f'kind 只能是 {list(KINDS)}', '语义记忆存事实和偏好,情景记忆存发生过的事', True)
        if not content or len(content) > MAX_LEN:
            return fail('invalid_argument', f'内容为空或超过 {MAX_LEN} 字', '只保存一条简短、独立的信息', True)
        for pattern, what in SENSITIVE:
            if pattern.search(content):
                return fail('sensitive', f'内容里包含{what},不能保存', '不要保存敏感信息;可以只记"用户已提供过"这件事')
        digest = hashlib.sha256(f'{kind}|{content}'.encode()).hexdigest()
        dup = self.db.execute('SELECT id FROM memories WHERE scope = ? AND content_hash = ? AND deleted = 0 '
                              'AND superseded_by IS NULL', (scope, digest)).fetchone()
        if dup:
            return ok({'id': dup['id']}, deduplicated=True)
        now = self.now()
        cur = self.db.execute('INSERT INTO memories (scope, kind, key, content, content_hash, importance, created_at, expires_at) '
                              'VALUES (?, ?, ?, ?, ?, ?, ?, ?)',
                              (scope, kind, key, content, digest, min(max(importance, 0), 1), now,
                               now + ttl_days * 86400 if ttl_days else None))
        new_id = cur.lastrowid
        if key:                                                      # 同一主题的旧值被取代,不物理删除
            self.db.execute('UPDATE memories SET superseded_by = ? WHERE scope = ? AND key = ? AND id <> ? '
                            'AND deleted = 0 AND superseded_by IS NULL', (new_id, scope, key, new_id))
        self.db.commit()
        return ok({'id': new_id})

    # ── 检索策略:scope 过滤 → 有效性过滤 → 打分 → top-k ──
    def search(self, scope, query='', k=5, kind=None):
        now = self.now()
        sql = ('SELECT * FROM memories WHERE scope = ? AND deleted = 0 AND superseded_by IS NULL '
               'AND (expires_at IS NULL OR expires_at > ?)')
        args = [scope, now]
        if kind:
            sql += ' AND kind = ?'
            args.append(kind)
        q, scored = grams(query), []
        for r in self.db.execute(sql, args):
            overlap = len(q & grams(r['content'] + ' ' + (r['key'] or ''))) / len(q) if q else 0.0
            if q and overlap == 0:
                continue                                             # 有查询词时,完全不相关的不返回
            score = 0.6 * overlap + 0.25 * r['importance'] + 0.15 * decay(r['last_used'] or r['created_at'], now)
            scored.append((score, r))
        scored.sort(key=lambda s: -s[0])
        out = [{'id': r['id'], 'kind': r['kind'], 'key': r['key'], 'content': r['content'], 'score': round(s, 3)}
               for s, r in scored[:k]]
        self.db.executemany('UPDATE memories SET last_used = ? WHERE id = ?', [(now, o['id']) for o in out])
        self.db.commit()
        return out

    # ── 遗忘:用户要求删除、过期、超出容量 ──
    def forget(self, scope, memory_id):                              # 只能删自己的
        cur = self.db.execute('UPDATE memories SET deleted = 1 WHERE id = ? AND scope = ? AND deleted = 0',
                              (memory_id, scope))
        self.db.commit()
        return ok({'id': memory_id}) if cur.rowcount else fail('not_found', f'没有 id 为 {memory_id} 的记忆', '先检索,找到要删除的记忆')

    def sweep(self):
        now = self.now()
        expired = self.db.execute('UPDATE memories SET deleted = 1 WHERE deleted = 0 AND expires_at IS NOT NULL '
                                  'AND expires_at <= ?', (now,)).rowcount
        trimmed = 0
        for (scope,) in self.db.execute('SELECT DISTINCT scope FROM memories WHERE deleted = 0').fetchall():
            rows = self.db.execute('SELECT id, importance, created_at, last_used FROM memories WHERE scope = ? '
                                   'AND deleted = 0 AND superseded_by IS NULL', (scope,)).fetchall()
            excess = len(rows) - self.max_per_scope
            if excess > 0:                                           # 超出容量:删掉"不重要又不新鲜"的
                worst = sorted(rows, key=lambda r: 0.7 * r['importance'] + 0.3 * decay(r['last_used'] or r['created_at'], now))
                for r in worst[:excess]:
                    self.db.execute('UPDATE memories SET deleted = 1 WHERE id = ?', (r['id'],))
                    trimmed += 1
        self.db.commit()
        return {'expired': expired, 'trimmed': trimmed}

def memory_block(items, max_chars=400):    # 渲染成第 05 篇 build_system(memory=...) 的动态区内容
    lines, used = [], 0
    for m in items:
        label = '事实' if m['kind'] == 'semantic' else '经历'
        content = m['content']
        line = f'- [{label}] {content}'
        if used + len(line) > max_chars:
            break
        lines.append(line)
        used += len(line)
    return '\n'.join(lines)

# ── 2. 记忆工具:沿用第 06 篇的工具契约 ──────────────────────────────────────────────
def memory_tools(store, scope):            # scope(谁的记忆)由代码绑定,不让模型传 user_id
    def remember(kind, content, key=None):
        return store.remember(scope, kind, content, key=key)

    def search(query, limit=5):
        items = store.search(scope, query, k=limit)
        return ok({'items': items}) if items else ok({'items': []}, hint='没有找到相关记忆,不要编造')

    return [
        Tool('memory_remember',
             '保存一条关于当前用户的长期记忆。用于用户明确说出了稳定的偏好或事实(如地址、过敏),或一次重要经历有了结果时。'
             '不要用于一次性的情绪、未经确认的猜测,也不要保存手机号、银行卡、密码等敏感信息。'
             '返回记忆的 id;同样的内容重复保存只会保留一条,同一个 key 的新值会取代旧值。',
             {'type': 'object', 'additionalProperties': False, 'required': ['kind', 'content'],
              'properties': {'kind': {'type': 'string', 'enum': ['semantic', 'episodic'],
                                      'description': 'semantic 事实或偏好;episodic 发生过的事'},
                             'content': {'type': 'string', 'description': '一条简短、独立的信息,不超过 200 字,如"用户对坚果过敏"'},
                             'key': {'type': 'string', 'description': '语义记忆的主题,如 address、allergy、reply_style;同主题的新值取代旧值'}}},
             remember, risk='write', idempotent=True),
        Tool('memory_search',
             '按关键词检索关于当前用户的记忆。用于回答前想确认用户的偏好、地址或历史处理结果时。'
             '不要用于查订单或物流(用 order_get_status)。返回最相关的几条记忆;没有时会明确告诉你,不要编造。',
             {'type': 'object', 'additionalProperties': False, 'required': ['query'],
              'properties': {'query': {'type': 'string', 'description': '要找什么,如"地址""过敏""上次补发"'},
                             'limit': {'type': 'integer', 'minimum': 1, 'maximum': 10, 'description': '最多返回几条,默认 5'}}},
             search),
    ]

def auto_approve(call):                    # 低风险的写(记忆)自动批准;其他写操作仍需人工(第 03 篇的 A2 级别)
    return call.function.name == 'memory_remember'

if __name__ == '__main__':
    import os, tempfile
    path = os.path.join(tempfile.mkdtemp(), 'agent.db')
    clock = [1_700_000_000.0]
    store, u = Store(path, now=lambda: clock[0]), 'user_42'
    show = lambda title, r: print(f'{title}\n  {json.dumps(r, ensure_ascii=False)}')
    show('1. 记住回复风格', store.remember(u, 'semantic', '用户希望回复简短', key='reply_style', importance=0.6))
    show('2. 记住过敏', store.remember(u, 'semantic', '用户对坚果过敏', key='allergy', importance=0.9))
    show('3. 记住地址', store.remember(u, 'semantic', '收货地址:上海市浦东新区世纪大道 1 号', key='address'))
    show('4. 新地址取代旧地址', store.remember(u, 'semantic', '收货地址:杭州市西湖区文三路 2 号', key='address'))
    show('5. 银行卡号不能存', store.remember(u, 'semantic', '我的银行卡号是 6222021234567890123'))
    show('6. 重复保存只留一条', store.remember(u, 'semantic', '用户对坚果过敏', key='allergy', importance=0.9))
    show('7. 记住一次经历(90 天后过期)', store.remember(u, 'episodic', '订单 A1001 丢件,已补发(补发单 R0001)', importance=0.7, ttl_days=90))
    show('8. 检索"我的地址"', store.search(u, '我的地址'))
    show('9. 检索"上次补发"', store.search(u, '上次补发'))
    show('10. 别的用户看不到', store.search('user_99', '我的地址'))
    print('11. 注入 system 的记忆块:')
    print(memory_block(store.search(u, '')))
    store.save_state('ticket_7', {'stage': 'WAIT_APPROVAL', 'pending': {'tool': 'reship_create', 'order_id': 'A1001'}})
    reopened = Store(path, now=lambda: clock[0])
    show('12. 重启后恢复会话状态', reopened.load_state('ticket_7'))
    clock[0] += 100 * 86400
    show('13. 100 天后清理', reopened.sweep())
    show('14. 再检索"上次补发"', reopened.search(u, '上次补发'))
先跑离线演示,不需要密钥。演示用一个假时钟,所以"100 天后"不用真的等:
bash
pip install openai jsonschema
python memory_kit.py
实际输出如下:
1. 记住回复风格
  {"ok": true, "data": {"id": 1}}
2. 记住过敏
  {"ok": true, "data": {"id": 2}}
3. 记住地址
  {"ok": true, "data": {"id": 3}}
4. 新地址取代旧地址
  {"ok": true, "data": {"id": 4}}
5. 银行卡号不能存
  {"ok": false, "error": {"code": "sensitive", "message": "内容里包含银行卡号或证件号,不能保存", "hint": "不要保存敏感信息;可以只记"用户已提供过"这件事", "retryable": false}}
6. 重复保存只留一条
  {"ok": true, "data": {"id": 2}, "deduplicated": true}
7. 记住一次经历(90 天后过期)
  {"ok": true, "data": {"id": 5}}
8. 检索"我的地址"
  [{"id": 4, "kind": "semantic", "key": "address", "content": "收货地址:杭州市西湖区文三路 2 号", "score": 0.475}]
9. 检索"上次补发"
  [{"id": 5, "kind": "episodic", "key": null, "content": "订单 A1001 丢件,已补发(补发单 R0001)", "score": 0.525}]
10. 别的用户看不到
  []
11. 注入 system 的记忆块:
- [事实] 用户对坚果过敏
- [经历] 订单 A1001 丢件,已补发(补发单 R0001)
- [事实] 用户希望回复简短
- [事实] 收货地址:杭州市西湖区文三路 2 号
12. 重启后恢复会话状态
  {"stage": "WAIT_APPROVAL", "pending": {"tool": "reship_create", "order_id": "A1001"}}
13. 100 天后清理
  {"expired": 1, "trimmed": 0}
14. 再检索"上次补发"
  []
对照输出看设计:
- 第 3、4 条 :新地址写入时,同一个
key=address的旧地址被取代;第 8 条检索只返回新地址。 - 第 5 条:银行卡号被拦下,错误里告诉模型可以只记"用户已提供过"这件事,不能重试。
- 第 6 条 :重复保存同一条内容,只保留一条,返回已有的 id,并标出
deduplicated。 - 第 8、9 条:检索按相关度返回,不相关的记忆不会出现。
- 第 10 条:换一个 scope,什么也看不到。
- 第 11 条:按重要度和新鲜度排序,渲染成可以放进 system prompt 动态区的文本。
- 第 12 条:重新打开数据库,会话状态完整恢复,模拟了进程重启。
- 第 13、14 条:90 天的经历在 100 天后过期、被清理,检索不再返回。
写入 remember() 的流程如下:
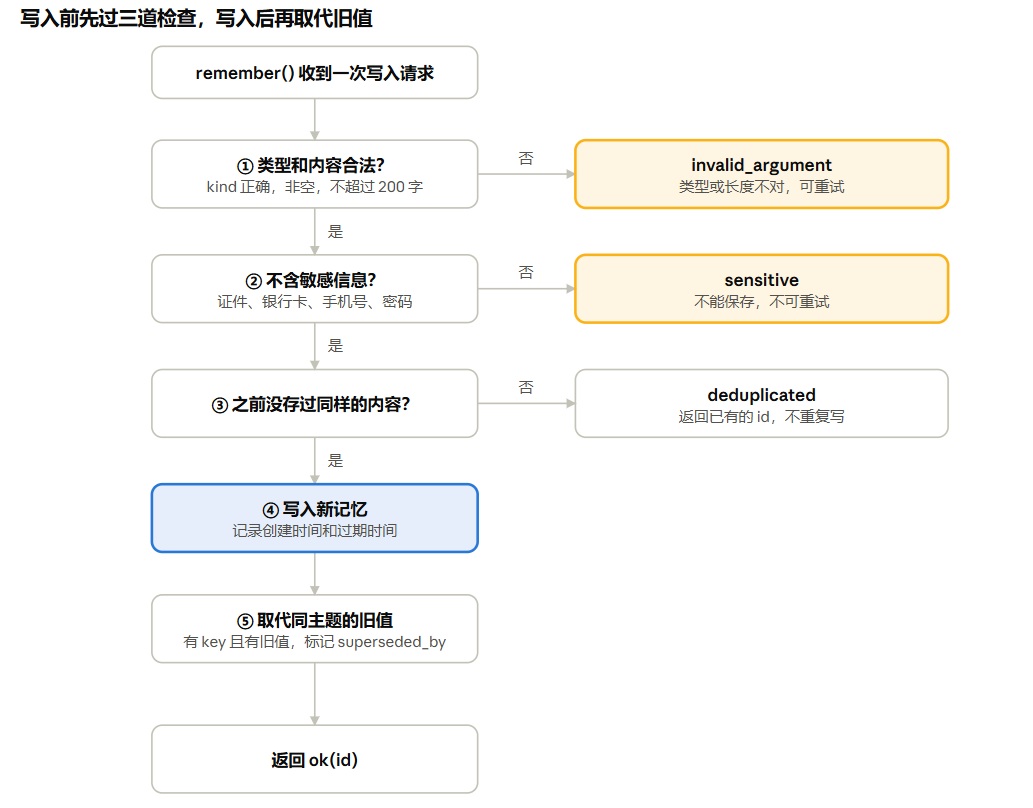
检索 search() 的流程如下:
六、产出:数据模型与策略参数
6.1 产出 ①:记忆架构方案图
整体结构见第五节开头的架构图:一次会话里,Agent 通过 memory_remember / memory_search 两个工具读写长期记忆,会话状态由编排层直接存取;两条通道都经过代码的策略层,落到同一个 SQLite 数据库;sweep() 在后台负责遗忘。
6.2 产出 ②:数据模型
表 session_state:会话状态
| 字段 | 类型 | 说明 |
|---|---|---|
session_id |
TEXT,主键 | 会话或工单 id |
data |
TEXT(JSON) | 工单阶段、待审批动作等 |
updated_at |
REAL | 最后更新时间 |
表 memories:长期记忆
| 字段 | 类型 | 说明 |
|---|---|---|
id |
INTEGER,主键 | 记忆 id |
scope |
TEXT | 谁的记忆:user_id 或 customer_id,所有读写都必须带 |
kind |
TEXT | semantic(事实与偏好)或 episodic(发生过的事) |
key |
TEXT,可空 | 语义记忆的主题,同主题的新值取代旧值 |
content |
TEXT | 一条简短、独立的信息,不超过 200 字 |
content_hash |
TEXT | 内容哈希,用于去重 |
importance |
REAL | 重要度,0 到 1 |
created_at |
REAL | 创建时间 |
last_used |
REAL | 最近一次被检索的时间,用于刷新新鲜度 |
expires_at |
REAL,可空 | 过期时间,空表示不过期 |
superseded_by |
INTEGER,可空 | 被哪一条新记忆取代,旧版本保留 |
deleted |
INTEGER | 软删除标记 |
6.3 产出 ③:策略参数表
| 策略 | 参数 | 默认值 | 调整建议 |
|---|---|---|---|
| 写入 | 内容长度上限 MAX_LEN |
200 字 | 记忆越短越好检索 |
| 写入 | 敏感信息规则 SENSITIVE |
证件和银行卡、手机号、密码 | 按合规要求扩充(第 26 篇) |
| 检索 | 打分权重 | 相关度 0.6、重要度 0.25、新鲜度 0.15 | 用评估集调(第 18 篇) |
| 检索 | 新鲜度半衰期 | 30 天 | 偏好类可更长,价格类要更短 |
| 检索 | 返回条数 k |
5 | 受第 05 篇 cap_memory 限制 |
| 遗忘 | TTL ttl_days |
不过期 | 经历类建议 90--180 天 |
| 遗忘 | 每个 scope 的容量 max_per_scope |
200 | 超出时删"不重要又不新鲜"的 |
七、运行与验证
7.1 离线测试
文末附录的 test_memory_kit.py 不需要密钥:存储直接测,Agent 循环用真实的 openai SDK 对接一个假的 DeepSeek 服务。
bash
pip install openai jsonschema pytest
python -m pytest -q test_memory_kit.py
应看到 10 passed。它验证了:
- 写入策略:非法的类型和内容被拒绝;银行卡、证件号、手机号、密码被拦下;重复内容只留一条;同一个
key的新值取代旧值,旧版本还在。 - scope 隔离:别人看不到;只能删除自己的记忆。
- 检索:不相关的不返回;按类型过滤;没有查询词时按重要度排序;同样相关、同样重要时,新的靠前;被用到的记忆新鲜度会被刷新。
- 遗忘:过期的立刻不可见,
sweep()清理过期的;超出容量时删掉最不重要的。 - 会话状态:重新打开数据库后能恢复,覆盖更新有效。
- 记忆工具:通过第 06 篇的
lint规范检查;写操作默认需要批准;模型不能指定user_id;敏感信息被拦下。 - 端到端:模型调用
memory_remember,被自动批准并写入存储;下一次会话读出来,渲染成记忆块。
同样,httpx2 是新版 openai SDK 依赖的 HTTP 库;如果你装的是旧版 SDK,把测试文件里的 import httpx2 as httpx 改成 import httpx 即可。
7.2 接上真实模型
设置 DEEPSEEK_API_KEY 后:
python
from tool_kit import Registry, run_agent
from memory_kit import Store, memory_tools, memory_block, auto_approve

store = Store('agent.db')
USER = 'user_42'

# 新会话开始:把已有的记忆放进 system 的动态区(也可以交给第 05 篇的 build_system(memory=...))
SYSTEM = '你是 SupportPilot 客服助手。\n<memory>\n' + memory_block(store.search(USER, '')) + '\n</memory>'
reg = Registry(memory_tools(store, USER))
print(run_agent('我对坚果过敏,以后回复简短点,记一下', reg, SYSTEM, approve=auto_approve))
print(store.search(USER, ''))      # 看看模型写进去了什么
模型是否会调用 memory_remember、写进去的内容是否合适,取决于模型和提示词,所以要用评估集检查(第 18 篇)。approve=auto_approve 表示低风险的记忆写入自动批准,其他写操作(比如补发)依然需要人工批准。
八、踩坑清单:典型失败模式
| 失败模式 | 现象 | 预防(对应篇目) |
|---|---|---|
| 把对话记录当记忆 | 检索出冗余、互相矛盾的内容 | 语义和情景分开存,写入前先提炼(本篇 2.2) |
| 什么都记 | 记下气话、猜测和敏感信息 | 工具描述约束 + 代码校验 + 敏感信息拦截(本篇 2.4;第 26 篇) |
| 只加不改 | 旧地址和新地址同时被检索出来 | key + superseded_by(本篇 2.4) |
| 记忆没有 scope | 用户 A 的记忆被用户 B 读到 | scope 由代码绑定,不让模型传(本篇 3.3;第 24 篇) |
| 记忆永不过期 | 过时的价格、地址误导模型 | TTL、容量上限、新鲜度衰减(本篇 2.6) |
| 状态只放内存 | 进程重启,审批和幂等表全丢 | 状态落库,重启可恢复(本篇 2.7;第 15 篇) |
| 把记忆当成当前事实 | 订单状态变了,模型还按旧记忆回答 | 会变化的事实以工具实时查询为准;记忆只存偏好和处理结果(第 25 篇) |
| 检索结果全塞进去 | 上下文被撑大 | top-k + memory_block 的字符预算(第 05 篇) |
九、练习与自测
练习
- :为你的 Agent 列出五条"该记"和三条"不该记"的信息,并为每条写出
kind、key、ttl_days。
自测 5 题
- 恢复一个审批中的补发,需要的是状态还是记忆?为什么?
- 用户说"气死我了,以后都给我退款",应该写进记忆吗?怎么保证它不会绕过审批?
- 新地址写入时,为什么旧地址只标记
superseded_by,而不是直接删除? - 记忆工具的 schema 里为什么不能有
user_id参数? - 订单 A1001 的物流状态,应该放进记忆吗?
参考答案
- 状态。它有固定结构、和当前任务绑定、按 id 精确读取,丢了任务就无法继续。记忆是为未来任务提炼的信息,不是用来恢复中断任务的。
- 不该写。这是一次性的情绪,不是稳定的偏好;工具描述里写明了"不要用于一次性的情绪"。即使被写进去,退款属于写操作,仍然要走审批,记忆不能让它绕过去。
- 保留旧版本便于追溯和纠错:如果新值是模型记错的,可以恢复;也方便审计。检索时只返回没有被取代的版本,所以不会出现新旧同时被检索的问题。
- 模型的输出会被提示注入影响。如果由模型指定
user_id,攻击者就可能诱导它读取别人的记忆。scope 由代码在创建工具时绑定,模型没有指定的机会。 - 不应该。物流状态会变,记忆会过时。会变化的事实以工具实时查询为准;记忆里应该放的是偏好,以及"已经补发过"这类处理结果,并且带 TTL。
十、下一篇预告
08|规划与推理策略 :本篇的会话状态里放了 stage 这样的字段,但谁来决定下一个阶段是什么?下一篇讲 ReAct、Plan-and-Execute 和反思纠错,以及它们的混合使用,还有成功、失败、超时三类终止条件,步数与预算限制,动态重规划与进度追踪,并产出一份规划器设计说明、循环预算配置和终止条件表。
附:离线测试 test_memory_kit.py
和 memory_kit.py、tool_kit.py 放在同一个目录:
python
import json
import httpx2 as httpx          # 老版本 SDK 里这一行写成 import httpx
from types import SimpleNamespace
from openai import OpenAI
import tool_kit as tk
from tool_kit import Registry, lint
from memory_kit import Store, memory_block, memory_tools, auto_approve

DAY = 86400

def make(now=None, **kw):
    clock = [1_700_000_000.0]
    return Store(now=(now or (lambda: clock[0])), **kw), clock

def test_validation_and_sensitive_information_is_rejected():
    s, _ = make()
    assert s.remember('u', 'other', '内容')['error']['code'] == 'invalid_argument'
    assert s.remember('u', 'semantic', '  ')['error']['code'] == 'invalid_argument'
    assert s.remember('u', 'semantic', '很长' * 200)['error']['code'] == 'invalid_argument'
    for text in ['我的银行卡号是 6222021234567890123', '身份证 11010519491231002X', '手机号 13812345678', '我的密码是 abc']:
        r = s.remember('u', 'semantic', text)
        assert r['error']['code'] == 'sensitive' and not r['error']['retryable'], text
    assert s.search('u', '') == []                                   # 什么都没写进去
    assert s.remember('u', 'semantic', '订单 A1001 已签收')['ok']     # 订单号不是敏感信息

def test_duplicate_is_kept_once_and_key_supersedes_old_value():
    s, _ = make()
    first = s.remember('u', 'semantic', '用户对坚果过敏', key='allergy')
    again = s.remember('u', 'semantic', '用户对坚果过敏', key='allergy')
    assert again['deduplicated'] and again['data']['id'] == first['data']['id']
    s.remember('u', 'semantic', '地址:上海', key='address')
    s.remember('u', 'semantic', '地址:杭州', key='address')
    found = [m['content'] for m in s.search('u', '地址')]
    assert found == ['地址:杭州']                                    # 只剩新值
    rows = s.db.execute('SELECT content, superseded_by FROM memories WHERE key = ?', ('address',)).fetchall()
    assert len(rows) == 2 and [r['superseded_by'] for r in rows] == [3, None]   # 旧版本还在,指向新版本

def test_scopes_are_isolated_and_forget_only_touches_own_memories():
    s, _ = make()
    mid = s.remember('alice', 'semantic', '喜欢简短回答')['data']['id']
    assert s.search('bob', '简短') == []
    assert s.forget('bob', mid)['error']['code'] == 'not_found'
    assert s.search('alice', '简短')
    assert s.forget('alice', mid)['ok'] and s.search('alice', '简短') == []
    assert s.forget('alice', mid)['error']['code'] == 'not_found'

def test_search_relevance_filter_kind_and_importance_ranking():
    s, _ = make()
    s.remember('u', 'semantic', '用户对坚果过敏', key='allergy', importance=0.9)
    s.remember('u', 'semantic', '用户喜欢简短回答', key='style', importance=0.5)
    s.remember('u', 'episodic', '上次补发了订单 A1001', importance=0.5)
    assert [m['key'] for m in s.search('u', '过敏')] == ['allergy']            # 不相关的不返回
    assert [m['kind'] for m in s.search('u', '订单', kind='episodic')] == ['episodic']
    assert s.search('u', '完全无关的内容xyz') == []
    by_importance = s.search('u', '')                                           # 没有查询词:按重要度和新鲜度
    assert by_importance[0]['key'] == 'allergy' and len(by_importance) == 3
    assert len(s.search('u', '', k=2)) == 2

def test_recency_breaks_ties_and_use_refreshes_memory():
    s, clock = make()
    s.remember('u', 'semantic', '喜欢咖啡', importance=0.5)
    clock[0] += 60 * DAY
    s.remember('u', 'semantic', '喜欢红茶', importance=0.5)
    order = [m['content'] for m in s.search('u', '喜欢')]
    assert order == ['喜欢红茶', '喜欢咖啡']                                      # 同样相关、同样重要,新的靠前
    clock[0] += 60 * DAY
    s.search('u', '咖啡')                                                        # 用过一次,新鲜度被刷新
    assert [m['content'] for m in s.search('u', '喜欢')][0] == '喜欢咖啡'

def test_ttl_expiry_sweep_and_capacity():
    s, clock = make(max_per_scope=3)
    s.remember('u', 'episodic', '短期的事', ttl_days=10)
    s.remember('u', 'semantic', '长期事实甲', importance=0.9)
    clock[0] += 11 * DAY
    assert s.search('u', '短期') == []                                           # 过期的立刻不可见
    assert s.sweep() == {'expired': 1, 'trimmed': 0}
    for i, imp in enumerate([0.2, 0.3, 0.8]):
        s.remember('u', 'semantic', f'事实 {i}', importance=imp)
    result = s.sweep()                                                           # 现有 4 条,容量 3,删掉最不重要的
    assert result == {'expired': 0, 'trimmed': 1}
    remaining = {m['content'] for m in s.search('u', '')}
    assert '事实 0' not in remaining and '长期事实甲' in remaining and '事实 2' in remaining

def test_session_state_survives_restart(tmp_path):
    path = str(tmp_path / 'agent.db')
    s1 = Store(path)
    s1.save_state('ticket_7', {'stage': 'WAIT_APPROVAL', 'pending': {'tool': 'reship_create'}})
    s1.save_state('ticket_7', {'stage': 'EXECUTING'})                            # 覆盖更新
    s1.remember('u', 'semantic', '用户偏好简短', key='style')
    s2 = Store(path)                                                             # 模拟进程重启
    assert s2.load_state('ticket_7') == {'stage': 'EXECUTING'} and s2.load_state('nope') == {}
    assert s2.search('u', '简短')[0]['content'] == '用户偏好简短'

def test_memory_block_respects_the_budget():
    items = [{'kind': 'semantic', 'content': '甲' * 30}, {'kind': 'episodic', 'content': '乙' * 30}, {'kind': 'semantic', 'content': '丙' * 30}]
    block = memory_block(items, max_chars=90)
    assert block.splitlines() == ['- [事实] ' + '甲' * 30, '- [经历] ' + '乙' * 30] and memory_block([]) == ''

def test_memory_tools_follow_the_tool_contract_and_bind_scope():
    s, _ = make()
    tools = memory_tools(s, 'alice')
    assert [lint(t) for t in tools] == [[], []]                                  # 通过第 06 篇的规范检查
    reg = Registry(tools)
    call = lambda name, **a: SimpleNamespace(id='c', function=SimpleNamespace(name=name, arguments=json.dumps(a, ensure_ascii=False)))
    r = reg.execute(call('memory_remember', kind='semantic', content='用户偏好简短回答', key='style'))
    assert r['error']['code'] == 'approval_required'                             # 写操作默认要批准
    r = reg.execute(call('memory_remember', kind='semantic', content='用户偏好简短回答', key='style'), approved=True)
    assert r['ok'] and s.search('alice', '简短') and s.search('bob', '简短') == []
    r = reg.execute(call('memory_remember', kind='semantic', content='x', user_id='bob'), approved=True)
    assert r['error']['code'] == 'invalid_argument'                              # 模型不能指定 user_id
    found = reg.execute(call('memory_search', query='简短'))['data']['items']
    assert found[0]['content'] == '用户偏好简短回答'
    empty = reg.execute(call('memory_search', query='完全无关xyz'))
    assert empty['data']['items'] == [] and empty['hint'] == '没有找到相关记忆,不要编造'
    r = reg.execute(call('memory_remember', kind='semantic', content='银行卡 6222021234567890123'), approved=True)
    assert r['error']['code'] == 'sensitive'

def test_agent_writes_memory_with_auto_approval_and_next_session_reads_it():
    s, _ = make()
    requests = []
    def message(rs):
        if len(rs) == 1:
            args = {'kind': 'semantic', 'content': '用户对坚果过敏', 'key': 'allergy'}
            return {'role': 'assistant', 'content': None, 'reasoning_content': 'r', 'tool_calls': [
                {'id': 'c1', 'type': 'function', 'function': {'name': 'memory_remember', 'arguments': json.dumps(args, ensure_ascii=False)}}]}
        return {'role': 'assistant', 'content': '好的,记住了'}
    def server(request):
        requests.append(json.loads(request.content))
        return httpx.Response(200, json={'id': 'x', 'object': 'chat.completion', 'created': 0, 'model': 'm',
                                         'choices': [{'index': 0, 'finish_reason': 'stop', 'message': message(requests)}]})
    tk._client = OpenAI(api_key='t', base_url='https://api.deepseek.com', http_client=httpx.Client(transport=httpx.MockTransport(server)))
    reg = Registry(memory_tools(s, 'alice'))
    assert tk.run_agent('我对坚果过敏,记一下', reg, '你是客服', approve=auto_approve) == '好的,记住了'
    result = json.loads(requests[1]['messages'][-1]['content'])
    assert result['ok'] and s.search('alice', '过敏')                            # 记忆写进了存储
    block = memory_block(s.search('alice', ''))                                  # 下一次会话:读出来,放进 system 的动态区
    assert block == '- [事实] 用户对坚果过敏'