《Agentic Design Patterns》第 18 章导读:Guardrails 安全模式
本文是对开源书籍《Agentic Design Patterns》第 18 章的解读与导读,内容忠实呈现原文,并附个人思考。
原书在线阅读:https://adp.xindoo.xyz/ | 翻译项目代码仓库:https://github.com/xindoo/agentic-design-patterns
前面我们聊了很多"怎么让智能体更能干"的模式------规划、协作、记忆、学习、推理......但能力越强,风险也越大。
一个只会聊天的 AI 说错话了,大不了道个歉;但一个能调用工具、操作数据、自主决策的智能体,如果出了问题,可能造成真实的损失------金钱损失、法律风险、声誉损害,甚至安全事故。
第 18 章讲的 Guardrails(护栏,也叫安全模式) ,就是给智能体装上"安全带"和"刹车":确保智能体安全、合道德、按预期运行,防止有害、有偏见、不合规的输出和行为。
一、什么是 Guardrails
Guardrails(护栏)这个比喻很形象------就像公路两边的护栏,它不是限制你开车,而是防止你冲出马路、掉到沟里。
护栏的主要目的不是限制智能体的能力,而是确保它运行得稳健、可靠、有益。它是安全措施,也是指导机制------对于构建负责任的 AI 系统、减轻风险、维护用户信任至关重要。
护栏可以在多个层面实施:
| 防护层级 | 做法 | 防什么 |
|---|---|---|
| 输入验证/清理 | 过滤恶意内容、验证输入格式 | 有害输入、越狱攻击、格式错误 |
| 提示词级别 | 通过系统指令设置行为约束 | 偏离角色、不当行为 |
| 工具使用限制 | 约束智能体能用哪些工具、能做什么操作 | 越权操作、滥用工具 |
| 输出过滤/后处理 | 分析生成响应中的毒性、偏见、错误信息 | 有害输出、错误信息 |
| 外部审核 API | 调用专门的内容审核服务 | 各种违规内容 |
| 人机协同 | 关键决策让人来把关 | 高风险错误 |
书中还提到一个实用技巧:用计算成本更低的小模型来做"快速额外保障"------预先筛选输入,或者对主模型的输出做双重检查,发现策略违规。便宜、快速、不影响主模型的性能------性价比很高。
二、七大应用场景
护栏在几乎所有严肃的 AI 应用中都是必须的。书中列举了七个典型场景:
- 客服聊天机器人:防止生成冒犯性语言、不正确或有害的建议(比如瞎给医疗/法律建议)。检测到有毒输入,就拒绝或者转人工。
- 内容生成系统:确保生成的文章、营销文案、创意内容符合准则、法律和道德标准,避免仇恨言论、错误信息、露骨内容。
- 教育导师/助手:防止给出错误答案、推广偏见观点、进行不当对话。内容过滤 + 遵守课程标准。
- 法律研究助手:防止智能体给出明确的法律建议或者冒充律师------它只能帮你找资料,真要法律意见得找真人。
- 招聘和 HR 工具:过滤歧视性语言或标准,确保候选人筛选和员工评估的公平性,防止偏见。
- 社交媒体内容审核:自动识别和标记仇恨言论、错误信息、暴力内容。
- 科学研究助手:防止伪造研究数据或得出缺乏证据的结论,强调需要实证验证和同行评审。
这些场景的共同特点是:AI 出错的代价很高------可能伤害用户、违反法律、损害声誉。护栏就是代价高昂的错误和用户之间的那道防线。
三、CrewAI 实践:分层防御的内容策略执行者
书中给了一个很完整的 CrewAI 示例,展示了怎么用"智能体 + Pydantic 验证 + 结构化输出"来构建输入护栏。
核心思路是这样的:
- 定义安全策略:把所有规则写成详细的提示词,告诉一个专门的"策略执行智能体"要检查什么;
- 结构化输出:要求智能体输出严格的 JSON 格式(合规/不合规、原因、触发了哪些策略);
- Pydantic 验证:用 Pydantic 模型校验输出格式,确保 JSON 合法、字段正确;
- 技术护栏函数:验证不通过就阻断,通过了就放行。
策略内容涵盖了四大类风险:
1. 指令颠覆(越狱)
- "忽略之前的规则"、"重置你的记忆"之类的命令;
- 要求披露内部编程或机密操作细节;
- 其他欺骗性策略。
2. 禁止内容
- 歧视性或仇恨言论;
- 危险活动(自残、非法行为、身体伤害、危险物质);
- 露骨材料;
- 辱骂性语言。
3. 无关或离题讨论
- 政治评论、宗教话语;
- 敏感社会争议(没有建设性目标的);
- 闲聊(体育、娱乐、个人生活);
- 学术作弊请求(代写论文、直接给作业答案)。
4. 专有或竞争信息
- 诋毁自家品牌或服务;
- 讨论竞争对手。
评估原则是:只要违反了任何一条,就是不合规;有歧义就默认合规。 这是一个很重要的设计选择------宁可不拦,也别误拦。
四、Vertex AI 实践:工具调用回调
除了输入/输出层面的护栏,工具调用层面也需要防护。书中展示了 Google ADK 中的 before_tool_callback 机制:
python
def validate_tool_params(tool, args, tool_context):
    """工具执行前的验证回调"""
    expected_user_id = tool_context.state.get("session_user_id")
    actual_user_id = args.get("user_id_param")

    if actual_user_id and actual_user_id != expected_user_id:
        # 用户 ID 不匹配,阻止工具执行
        return {
            "status": "error",
            "error_message": "工具调用被阻止:用户 ID 验证失败。"
        }

    return None  # 返回 None = 允许执行

root_agent = Agent(
    model='gemini-2.0-flash-exp',
    name='root_agent',
    before_tool_callback=validate_tool_params,  # 每个工具调用前都会触发
    tools=[...]
)
这个回调就像工具的"安检员"------每次调用工具之前,先检查参数合不合法、有没有越权。比如用户 A 不能通过工具去查用户 B 的数据,这种越权行为就在回调里被拦住。
这是最小权限原则的具体体现:智能体只能做它该做的事,不能越界。
五、构建可靠智能体的工程原则
书中最后一部分讲得很好------它没有把护栏当作一个孤立的功能,而是把它放在"可靠软件工程"的大框架里。
核心观点是:别把智能体当什么"全新的东西",把它当作一个复杂软件系统来对待,用传统软件工程已经验证过的最佳实践来构建它。
书中列举了几个关键原则:
检查点和回滚
就像数据库的事务一样------每个检查点是一个经过验证的"已提交"状态,出了问题可以回滚到上一个检查点。这把错误恢复变成了主动测试和质量保证策略的核心部分。
模块化和关注点分离
一个"全能"的单体智能体是脆弱且难调试的。最佳实践是设计一个由较小的、专门的智能体和工具组成的协作系统------数据检索专家、分析专家、沟通专家,各司其职。模块化提高了灵活性、实现了故障隔离,各个模块可以独立优化、更新和调试。
结构化日志实现可观测性
可靠的系统是你能理解的系统。对于智能体,这意味着不仅要看到最终输出,还要捕获它的"思维链"------调用了什么工具、收到了什么数据、推理过程是什么、决策的置信度多少。这些对于调试和性能调优至关重要。
最小权限原则
智能体应该只拥有完成任务所需的最少权限。设计用来总结新闻的智能体,就只能访问新闻 API,不能读私人文件,也不能跟其他公司系统交互。这大大限制了潜在错误或恶意利用的"爆炸半径"。
这四条原则------容错、模块化、可观测性、严格安全------加在一起,就把一个"能跑的智能体"变成了一个"生产级、可信赖的系统"。
六、速览
- 问题背景:随着智能体和 LLM 变得越来越自主,如果不加约束,它们可能带来风险------行为不可预测、生成有害/有偏见/不道德/不准确的输出、可能造成真实世界损害。它们还容易受到对抗性攻击(如越狱)。没有适当控制,智能体系统可能以意外方式行事,导致用户信任丧失,让组织面临法律和声誉损害。
- 解决方案:护栏(安全模式)为管理智能体固有风险提供了标准化方案。它作为多层防御机制,确保智能体以符合道德、符合预期目的的方式运行。在各个阶段实施------验证输入阻止恶意内容、过滤输出捕获不良响应、通过提示词设置行为约束、限制工具使用、为关键决策集成人机协同监督。目标不是限制能力,而是引导行为,确保系统值得信赖、可预测、有益。
- 实践建议:任何 AI 智能体输出可能影响用户、系统或业务声誉的应用,都应该实施护栏。对于面向客户的角色(聊天机器人)、内容生成平台、以及处理金融/医疗/法律等领域敏感信息的自主智能体,护栏至关重要。用它来执行道德准则、防止错误信息传播、保护品牌安全、确保法律和监管合规。
七、可视化总结
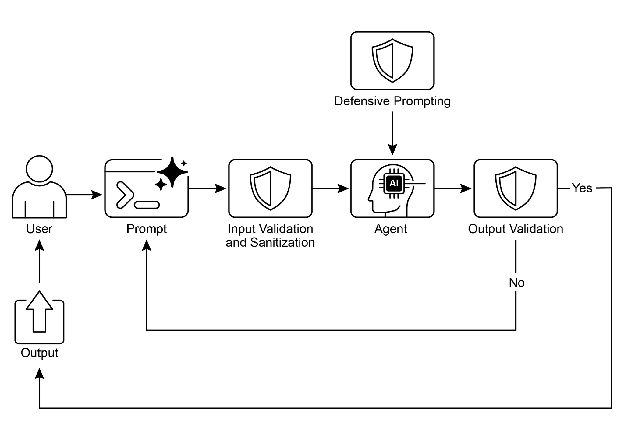
图 1:Guardrail 设计模式------多层防御确保智能体安全、合规、按预期运行。
关键要点
- 护栏对于构建负责任、符合道德、安全的智能体很重要------防止有害、有偏见、离题的响应;
- 可以在多个阶段实施:输入验证、输出过滤、行为提示词、工具使用限制、外部审核;
- 不同护栏技术的组合,提供最强大的保护;
- 护栏需要持续监控、评估和改进,以适应不断演变的风险和用户交互;
- 有效的护栏对于维护用户信任和保护智能体及开发者的声誉至关重要;
- 构建可靠的生产级智能体,要把它们当作复杂软件,应用传统软件工程的最佳实践------容错、状态管理、健壮测试。
结语与个人思考
Guardrails 这一章,讲的是 AI 开发中最不"性感"但最重要的话题之一。
大家都喜欢聊"智能体有多聪明"、"能做多少事",但很少有人聊"出了问题怎么办"、"怎么保证它不闯祸"。然而,一个 AI 系统能不能真正落地,往往不取决于它最强的能力有多强,而取决于它最坏的情况有多可控。
护栏的本质,是给 AI 的能力设边界。这个边界不是为了限制它,而是为了让它在边界内可以放心地发挥最大能力。就像孙悟空的紧箍咒------有了它,唐僧才敢让孙悟空去打妖怪;没有它,谁知道他会不会闯出更大的祸?
但护栏也不是越多越好、越严越好。太松了,起不到保护作用;太紧了,智能体的能力被过度限制,变成了没用的"傻子"。怎么在"安全"和"有用"之间找到平衡点,是每个团队都需要根据自己的场景去权衡的。
我觉得护栏的发展有几个趋势值得关注:
第一个趋势是从"规则"到"学习"。早期的护栏主要是基于规则的------关键词过滤、正则匹配、黑白名单。现在越来越多的护栏用 LLM 来做------让一个专门的 LLM 来判断"这段内容合不合规"。好处是能理解更复杂的语义、能处理更微妙的情况;坏处是 LLM 本身也可能犯错,而且成本更高。
第二个趋势是从"单层"到"多层"。单一的防护手段很容易被绕过------你防得住输入,防不住输出;防得住输出,防不住工具调用。真正可靠的系统,是多层防御------输入检查、提示词约束、工具验证、输出过滤、人工审核,一层一层叠起来。就算某一层被突破了,还有下一层兜着。
第三个趋势是从"静态"到"动态"。风险是不断演变的------今天的防护手段,明天可能就被新的越狱方法绕过了。所以护栏不能是一劳永逸的,需要持续监控、持续更新、持续对抗。这其实是一场攻防之间的猫鼠游戏,永远没有终局。
最后,我想说的是:护栏不只是技术问题,更是责任问题。 技术上怎么做护栏,可以学、可以优化;但要不要认真做护栏,取决于开发者和组织有没有把"安全"和"负责任"放在心上。在 AI 能力越来越强的今天,这个问题可能比"技术怎么做"更重要。
下一步,建议阅读第 19 章 评估与监控(Evaluation and Monitoring)------看看怎么量化地衡量智能体好不好、怎么持续跟踪它的表现。
本文基于开源书籍《Agentic Design Patterns》(https://github.com/xindoo/agentic-design-patterns ,在线阅读 https://adp.xindoo.xyz/ )整理,供学习交流,版权归原作者所有。