专注于大学生项目实战开发,讲解,毕业答疑辅导,✌绿泡171320330。
技术范围:SpringBoot、Vue、SSM、HLMT、小程序、Jsp、PHP、Nodejs、Python、YOLO、爬虫、数据可视化、安卓app、大数据、物联网、机器学习,单片机、plc等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码编写、论文编写和辅导、论文降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
摘要
本文针对现有车辆特征识别系统在复杂场景下鲁棒性不足、轻量级模型推理效率与识别精度难以兼顾的问题,设计并实现了一套基于改进 YOLO 算法的车辆特征识别系统。以 YOLOV11s 为基线模型,在其特征融合网络中嵌入无参轻量级注意力模块,在不显著增加计算开销的前提下增强模型对车辆关键特征的捕捉能力;构建包含多场景、多车型的车辆数据集,通过数据增强提升模型泛化能力;基于 B/S 架构开发系统,实现车辆单张识别、批量识别、视频实时检测、识别记录管理、数据统计、告警管理及模型参数动态配置等功能。实验结果表明,改进后的 YOLOV11s 模型在 mAP@0.5 指标上较原模型有明显提升,且参数量与推理速度基本保持不变,系统可在复杂光照、轻微遮挡场景下实现车辆特征的精准识别,满足交通管理等实际场景的应用需求。
关键词:YOLO 算法;车辆特征识别;深度学习;注意力机制;智能交通
ABSTRACT
Aiming at the problems of insufficient robustness of existing vehicle feature recognition systems in complex scenarios and the difficulty in balancing the inference efficiency and recognition accuracy of lightweight models, this paper designs and implements a vehicle feature recognition system based on the improved YOLO algorithm. Taking YOLOV11s as the baseline model, a parameter-free lightweight attention module is embedded in its feature fusion network to enhance the model's ability to capture key vehicle features without significantly increasing the computational overhead; a vehicle dataset containing multiple scenarios and vehicle types is constructed to improve the model's generalization ability through data augmentation; the system is developed based on the B/S architecture to realize the functions of single vehicle recognition, batch recognition, real-time video detection, recognition record management, data statistics, alarm management and dynamic configuration of model parameters. The experimental results show that the improved YOLOV11s model has a significant improvement in the mAP@0.5 index compared with the original model, and the number of parameters and inference speed remain basically unchanged. The system can realize accurate recognition of vehicle features in complex lighting and slight occlusion scenarios, meeting the application requirements of actual scenarios such as traffic management.
Keywords: YOLO algorithm; Vehicle feature recognition; Deep learning; Attention mechanism; Intelligent transportation
目录摘要IABSTRACT21绪论51.1课题背景和意义51.2国内外研究现状51.3研究内容72相关理论与技术介绍92.1 Python概述92.2 flask框架92.3 MySQL介绍92.4 YOLO算法概述103系统设计133.1 核心问题分析133.1.1 模型复杂场景特征判别缺陷133.1.2 模型改进策略与评估难题143.2 研究内容整体框架153.2.1专用车辆数据集的构建163.2.2 改进YOLO模型的训练与优化163.2.3 车辆特征识别系统的实现174 系统实现技术方案204.1 数据集整理技术方案204.1.1 开源数据集获取204.1.2 数据集整理与检查204.1.3 数据集多样性增强214.2 模型训练与核心功能实现方案214.2.1 基线模型选择与问题分析224.2.2 轻量级模型改进策略实现224.2.3 模型训练流程实现235 系统实现246 系统测试326.1 测试环境与测试方案326.2 功能测试326.3 性能测试336.4 数据准确性与兼容性测试346.4.1 数据准确性测试346.4.2 兼容性测试356.5 测试结果总结357总结与展望36致谢37参考文献38
1绪论
1.1课题背景和意义
随着城市化进程加速和汽车保有量的快速增长,交通管理面临巨大挑战。根据中国公安部交通管理局的数据,截至2023年底,全国机动车保有量达到4.35亿辆,其中汽车保有量达3.36亿辆。在这样的背景下,车辆特征识别技术在交通管理、智能停车、违章监控、道路安全等领域发挥着越来越重要的作用。
然而,当前的车辆识别系统在实际应用中仍面临诸多挑战:在复杂光照条件下的识别准确率低、车辆遮挡情况下的识别效果差等。特别是在恶劣天气条件下(如雨雪、雾霾),现有系统性能显著下降,导致交通管理效率降低,甚至可能引发安全隐患。根据中国智能交通协会发布的《2023中国智能交通发展报告》 数据显示,因车辆识别系统性能不足导致的交通管理效率降低问题,每年造成约1200亿元的经济损失。
因此,设计一个基于改进YOLO算法的车辆特征识别系统具有迫切的现实需求,可有效提升交通管理效率,保障道路安全,降低经济损失。
课题意义:
近年来,以深度学习(Deep learning)1为代表的人工智能(Artificial intelligence)2算法在计算机视觉领域取得突破性进展,为交通管理、城市治理等场景提供了全新解决方案。
我国车辆识别技术3已实现多维度应用:在公共安全领域,公安系统通过车牌-车辆特征双识别机制4,构建了交通违法追踪与嫌疑车辆锁定的智能化闭环;在交通管理方面,高速公路ETC系统与城市道路卡口结合车型识别技术,实现了交通流量动态调控与超限运输精准拦截;在商业服务领域,智慧停车场通过车辆特征自动识别,完成了无感支付与车位引导的高效管理;在智慧物流场景中,车辆品牌型号识别为运输调度与货运安全监管提供了数据支撑。
相较于传统车辆检测手段,基于深度学习的特征识别技术具备更强的环境适应性------能应对复杂光照、雨雾干扰等挑战。然而,现有车辆识别系统仍面临诸多技术瓶颈:一方面,传统方法在应对遮挡、极端姿态等复杂场景时存在识别率下降问题;另一方面,常规YOLO算法在处理高密度车流时易出现漏检误检现象。因此,设计一种融合轻量化网络架构与多尺度特征增强机制的改进型YOLO车辆识别系统5,对于提升智能交通系统的环境鲁棒性、拓展自动驾驶感知能力、完善城市交通大数据分析体系具有重要研究价值。
1.2国内外研究现状
车辆特征识别技术的研究始于20世纪80年代,随着计算机视觉和图像处理技术的快速发展,逐渐从传统方法向基于深度学习的智能算法过渡。早期的车辆检测主要依赖于边缘检测、颜色分割和形状匹配等传统图像处理技术,但其在复杂场景下存在鲁棒性差、误检率高等问题。2015年,Joseph Redmon等人提出的YOLO(You Only Look Once)算法首次将目标检测问题转化为单阶段回归问题,实现了实时检测能力,为车辆识别领域提供了全新的技术路径。此后,YOLO系列算法持续迭代优化:YOLOv2通过引入Batch Normalization和K-means聚类生成锚框,显著提升了检测精度;YOLOv3采用多尺度预测机制,增强了对小目标车辆的识别能力;YOLOv4结合CBAM注意力机制和Mosaic数据增强策略,在复杂交通场景中实现了更高的准确率和稳定性;YOLOV11进一步简化网络结构并优化训练策略,成为当前主流的高效检测框架6。
在实际应用方面,欧美国家率先将YOLO系列算法集成于智能交通系统中。例如,美国加州大学伯克利分校的研究团队开发了基于YOLOv4的高速公路车辆追踪系统,通过多帧目标关联算法实现了对高密度车流的实时监测;德国博世公司则将YOLOV11嵌入自动驾驶感知模块,用于实时检测周围车辆的型号与位置,提升道路安全决策能力。此外,YOLO算法的轻量化改进(如YOLO Nano和YOLO-Tiny)7被广泛应用于无人机交通监控和边缘计算设备,解决了传统方法在嵌入式平台部署中的计算瓶颈问题。
我国在车辆特征识别领域的研究起步稍晚,但近年来依托国家智能交通战略的推动,取得了显著进展。早期研究主要集中在传统目标检测方法上,如基于HOG特征与SVM分类器的车辆检测模型,以及结合改进型卡尔曼滤波的轨迹预测算法。然而,这些方法在应对光照变化、遮挡和复杂背景时表现不佳。随着深度学习技术的普及,国内学者开始探索YOLO系列算法的优化路径。例如,王国文8提出了一种基于多尺度特征融合的改进YOLOv3网络,用于行人和车辆检测,其引入FPN结构的方法对提升小目标检测精度具有参考价值;中科院自动化研究所则开发了基于YOLOv4的多任务联合训练框架,实现了车辆类型识别与车牌检测的协同优化9。
在工程应用层面,国内企业已将改进型YOLO算法部署于多个智慧交通场景。例如,华为推出的"城市交通大脑"系统采用YOLOV11作为核心检测模块,结合时空特征分析技术,实现了对拥堵区域的动态识别与信号灯自适应调控10;百度Apollo自动驾驶平台则通过YOLOv7的多传感器融合方案,增强了对复杂路况下车辆姿态的感知能力。此外,针对边缘计算设备的轻量化需求,商汤科技和旷视科技分别提出了YOLO-Lite和YOLO-Edge等优化模型,通过通道剪枝和知识蒸馏技术,在保证检测精度的同时将模型参数量压缩至原有规模的30%以下。
尽管YOLO系列算法取得了显著进展,但将其直接应用于复杂多变的真实交通场景时,现有的各种研究方法还是存在着明显的局限:
1.基于图像预处理的方法:该方法在检测模型前增加独立的前处理模块(如直方图均衡化、暗通道先验去雾算法11),旨在改善输入图像质量。该方法作为早期方案,能在一定程度上提升后续检测的输入质量。不过也存在明显缺点:算法多为通用设计,对车辆特征针对性不强;串行处理增加系统延迟;对复杂多变的真实恶劣环境泛化能力有限12。
2.基于数据增强的策略:通过在训练数据中合成大量恶劣天气样本,迫使检测模型学习环境不变性特征。如今该策略已成为提升模型泛化能力的标准做法,被广泛集成于训练流程中。不过这种方法的实质是让模型"记忆"更多模式,而非从根本上提升模型对物理退化过程的特征提取鲁棒性13。对于训练数据未覆盖的、或多种因素耦合的极端场景,性能提升存在瓶颈。
3.基于复杂网络结构改进的方法:在YOLO等检测模型中引入注意力机制(如SE、CBAM)或多分支结构,以增强模型对关键特征的聚焦能力。此类方法在实验室条件下(如特定天气测试集)能有效提升检测精度。但是引入的额外模块会显著增加模型的参数量与计算复杂度14。这导致模型推理速度下降,难以满足交通监控等实际应用场景严苛要求15,形成了"提升鲁棒性"与"保持轻量化"之间的矛盾。
综上,当前研究的核心不足在于:现有提升环境鲁棒性的方法,大多以牺牲模型的轻量化特性和推理效率为代价,难以在实际的边缘计算设备上高效部署。 因此,本课题的改进方向明确为:研究一种能够在不显著增加计算开销的前提下,有效提升轻量级检测模型在恶劣环境下鲁棒性的新方法。
1.3研究内容
本课题主要设计并实现一套基于改进YOLO算法的车辆特征智能识别系统,研究内容涵盖视觉识别核心算法、实时视频流处理及数据管理分析三大模块,具体包括: 多模态车辆特征识别:系统支持单张图片、批量图片(ZIP压缩包)及本地历史视频文件的处理,能够精准识别车型、颜色、车牌号码、品牌及改装破损等核心特征,并支持生成详细的识别报告与标注图片导出。 视频流实时检测与告警:利用OpenCV对接监控流或视频文件进行逐帧分析,通过WebSocket实现带标注画面的低延迟前端同步展示;内置异常车辆规则引擎,对无牌、改装等异常车辆实现实时弹窗告警与日志记录。 数据管理与统计分析:基于MySQL数据库对所有识别记录进行持久化存储,提供多条件检索功能;前端集成ECharts图表库,从时间、品牌、颜色等多维度对车辆特征数据进行可视化统计分析。 系统参数动态配置:提供模型参数在线调节功能,支持用户根据实际场景(如光照、角度)动态调整置信度阈值、IOU阈值及帧检测间隔,无需重启系统即可优化识别效果。
2相关理论与技术介绍
2.1 Python概述
Python是一种解释执行、交互调试、面向对象的高级编程语言,由于它的语法简单易懂,所以开发难度较小,并且支持过程式、面向对象、函数式等不同的编程方式,因此可以适应各种开发环境。拥有非常丰富的大规模第三方库生态系统,Web开发、数据清洗、机器学习、科学计算都可以找到成熟的库来帮助开发项目,从而大大节省开发时间并降低重复造轮子的成本。Python具有很强的跨平台性,在Windows、Linux、macOS等主流操作系统中可以无障碍运行,依靠活跃的开源社区,有完备的官方文档和大量的解决方案,本系统用Python作为核心开发语言,既做后端业务逻辑,又做数据预处理、模型推理等重要部分,这是保证系统高效开发、灵活扩展的前提。
2.2 flask框架
Flask 是一款基于 Python 语言开发的轻量级 Web 微框架,以简洁、灵活、易扩展为核心特性,被广泛应用于中小型 Web 系统、API 接口开发与深度学习模型部署场景。框架仅保留路由调度、请求响应、模板渲染等核心功能,无强制的项目结构与依赖库约束,开发者可根据需求自由搭配数据库、中间件、前端交互组件,相较于 Django 等重型框架,大幅降低了学习成本与系统冗余度。Flask 内置 Werkzeug 路由模块与 Jinja2 模板引擎,支持 RESTful API 规范开发,可快速实现前后端分离架构,同时兼容 Windows、Linux 等多平台环境,与 PyTorch、OpenCV 等深度学习相关库具备天然兼容性,是本车辆特征识别系统后端开发的最优选择。
在本系统开发中,Flask 框架承担核心业务逻辑调度与算法模型对接的关键作用,通过路由装饰器精准映射前端请求与后端处理函数,实现图片上传、视频解析、参数配置等接口的高效封装。框架通过请求对象获取前端传输的图片、视频与配置参数,调用改进 YOLO 算法模块完成车辆特征识别后,以 JSON 格式返回结构化识别结果;集成 Flask-RESTful 扩展规范接口开发流程,利用 Flask-SQLAlchemy 简化 MySQL 数据库操作,实现识别记录、告警信息的持久化存储与快速查询;搭配 WebSocket 扩展实现视频流的低延迟实时推送,保证视频检测功能的流畅性。Flask 的轻量特性使系统整体部署包体积更小、启动速度更快,无需复杂环境配置即可在普通 PC 机与边缘设备运行,完美适配车辆特征识别系统的轻量化、高效率部署需求。
2.3 MySQL介绍
MySQL 是一个非常受好评的开源关系型数据库管理系统,具有良好的性能、高稳定性和易用性,因此被广泛应用于Web开发中,受到许多用户的喜爱。其标准SQL语法规则遵循得非常好,并提供了高效的存储引擎、智能查询优化算法、事务管理器、索引管理工具等,力求在处理大量结构化数据的时候不会遇到任何障碍,在高并发的情况下也能快速处理大量的数据读写任务,保证了系统的性能以及数据的一致性,该系统具备很强的横向扩展能力以及跨平台兼容性,在复杂的业务环境中大大增强了系统的稳定性与适应性,很大程度上是因为它所设计出的主从同步复制技术以及读写分离架构相互配合来达到很高的可靠性与灵活性。其数据备份、恢复、数据迁移、升级等各方面表现突出,说明该系统技术实力雄厚且技术成熟,有强大的技术支持服务体系以及技术社区生态。本项目用到了MySQL作为核心的数据库管理工具,来对用户的资料、检测的信息以及一些相关的数据元进行统一的存取和管理,在重要的业务处理过程中可以达到高效持久化的效果。
2.4 YOLO算法概述
视觉目标检测是计算机视觉领域中的一个核心任务,旨在从图像或视频中自动识别并定位目标对象。目标检测算法的关键任务不仅是判断图像中是否存在某些目标,还要精确地为每个目标划定边界框。这一任务在自动驾驶、安防监控、车流量统计、医疗影像分析等领域具有广泛应用。
在目标检测算法的发展中,单阶段检测的"端到端"特性是核心突破之一,而YOLO算法正是这一思路的典型代表。YOLO算法原理直观呈现了其基础逻辑:传统检测需多阶段处理,而YOLO将输入图像划分为网格并直接输出检测结果,这种"一次前向传播完成检测"的设计,让实时性与端到端训练成为可能,也奠定了后续YOLO系列的架构基础。
图2.2YOLO算法原理
明确了YOLO的整体流程后,其预测头的输出结构是理解检测结果的关键。YOLO算法预测头结构则拆解了这一核心部分:每个网格单元的输出不仅包含目标的位置信息,还整合了置信度与类别概率,这种将回归与分类任务统一的张量设计,是YOLO实现"单阶段检测"的直接载体,也让模型能同时输出目标的位置、存在概率与类别,为后续的结果解析提供了清晰的信息维度。
随着模型深度的增加,"梯度消失"问题逐渐成为性能瓶颈,残差网络的出现则有效解决了这一难题。残差网络结构对比了普通卷积层与残差块的差异:通过"捷径连接"将输入直接与卷积输出相加,残差块让深层网络的梯度能更顺畅地反向传播,这一设计被广泛应用于YOLO后续版本的骨干网络中,是模型在加深时保持性能提升的关键技术之一。
图2.4残差网络结构
目标检测中,不同尺度的目标对特征信息的需求不同,高层特征语义强但细节弱,低层特征则相反。FPN网络结构展示的特征金字塔网络,通过自下而上提取多尺度特征、自上而下融合特征的方式,让模型同时利用不同层级的特征信息,这一结构的引入,大幅提升了YOLO对小目标、多尺度目标的检测能力,成为现代目标检测模型的标准组件之一。
3系统设计
3.1 核心问题分析
3.1.1 模型复杂场景特征判别缺陷
YOLOv11s作为轻量级目标检测模型,通过压缩特征提取网络的深度与通道数实现推理效率与轻量化的平衡,在公开基准测试集的标准化场景中,其平均精度均值可达较高水平,但轻量化改造直接导致网络感受野缩小、特征表达能力减弱。在多样化天气、多视角拍摄的实际交通场景中,模型无法有效提取车辆的高判别性特征,对外观相似车型的分类误差率提升,车身颜色识别受光照影响的偏差显著增大。
从特征量化角度分析,模型输出的特征图可表示为,其中为特征通道数,为特征图尺寸,轻量化压缩使大幅减少,特征图中车辆核心特征与背景特征的权重分布无显著差异,特征区分度计算公式为:
式中为特征图全局均值,值越小代表特征区分度越低,YOLOv11s在复杂场景下的值远低于非轻量化模型,直接表现为检测性能下降。本研究的首要问题,是在满足、的约束下,提升特征区分度,实现模型对车辆关键特征的精准捕捉。
图3-1 模型复杂场景特征判别缺陷
3.1.2 模型改进策略与评估难题
针对轻量级模型的特征判别缺陷,现有改进思路均存在性能与开销的失衡问题,需设计适配YOLOv11s的轻量化改进策略,并建立量化评估体系。引入重型注意力机制或多分支融合结构,虽能提升,但会使模型参数量与浮点运算量大幅增加;单一数据增强方法对模型泛化能力的提升效果有限,且无明确的量化评估标准。
本研究建立改进策略收益比作为核心评估指标,综合衡量改进策略的性能提升与开销增加,计算公式为:
式中、为权重系数,根据轻量化部署的需求赋予不同权重,值越高代表改进策略的性价比越强。同时引入实现复杂度,从代码改动量、训练耗时、硬件需求三个维度进行量化评分(,值越小越易实现),最终筛选出且的最优改进策略,解决模型性能提升与轻量化特性保持的核心矛盾。
3.2 研究内容整体框架
本研究遵循设计输入→设计活动→设计输出的三阶段研究框架,各阶段层层递进、数据与成果双向支撑,形成从数据基础构建到算法优化,再到工程落地的完整技术闭环。设计输入阶段完成专用数据集构建,为模型训练提供高质量输入;设计活动阶段实现YOLOv11s模型的轻量化改进与训练优化,是研究的技术核心;设计输出阶段完成模型的工程化部署,实现可视化的车辆特征识别系统,是研究的最终落地目标。
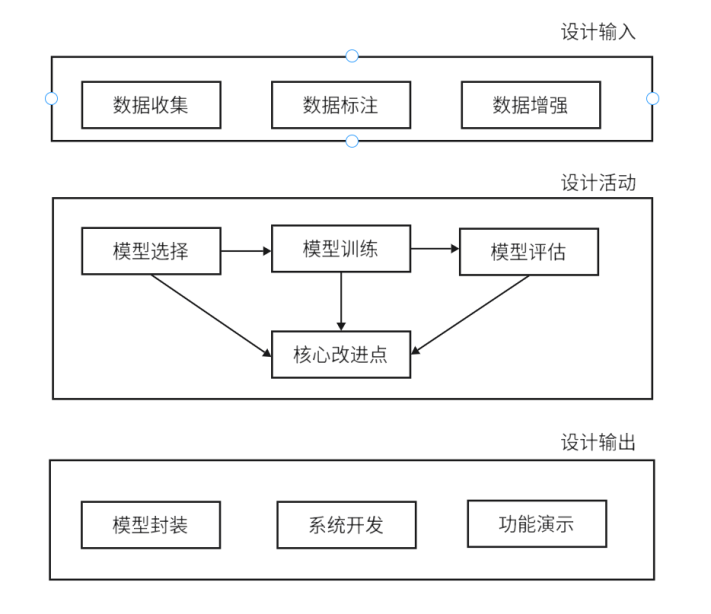
添加图片注释,不超过 140 字(可选)
图3-3 系统研究的三个阶段的模型
3.2.1专用车辆数据集的构建
设计输入阶段的核心任务是构建规模适中、标注规范、场景丰富的专用车辆数据集,整体流程分为数据获取、数据标注、数据预处理、数据增强四个环节,各环节均遵循标准化操作,最终将数据集按7:2:1的比例划分为训练集、验证集、测试集,满足模型训练、优化与评估的不同需求。
数据获取:以COCO车辆子集、UA-DETRAC数据集为核心来源,补充多天气、多视角的本地车辆图像,实现轿车、SUV、卡车、公交车4大类车型,白、黑、红、蓝、银5种车身颜色的全覆盖,数据集总样本量;
数据标注:采用LabelImg工具完成人工标注,标注内容包含车辆目标的边界框坐标与类别标签,标注格式遵循YOLO标准,边界框标注误差满足、;
数据预处理:对原始图像进行标准化处理,统一将图像尺寸归一化为(YOLOv11s标准输入尺寸),同时进行像素值归一化:
式中为原始图像像素值,为归一化后像素值,完成后剔除无效样本与标注,提升数据集质量;
数据增强:采用组合式数据增强技术扩充样本多样性,对训练集进行随机水平翻转(概率)、随机旋转(角度)、亮度调整(系数),增强后的图像像素值变换公式为:
式中为翻转/旋转后的像素坐标,通过数据增强使训练集样本量扩充至原规模的3倍,有效防止模型过拟合。
3.2.2 改进YOLO模型的训练与优化
设计活动阶段是本研究的技术核心,聚焦YOLOv11s模型的轻量化改进与闭环训练优化,形成数据输入→特征提取融合→预测输出→损失计算→评估优化的迭代流程,最终输出泛化能力强、检测精度高的轻量化模型权重文件,核心流程围绕损失函数优化与模型参数迭代展开。
模型训练以预处理后的训练集为输入,数据流入改进后的YOLOv11s模型后,依次通过骨干网络完成特征提取、Neck网络完成多尺度特征融合、Head网络完成目标检测预测,输出车辆目标的边界框预测值、类别预测概率与置信度。将模型预测结果与真实标注对比,采用CIoU损失+交叉熵损失的组合损失函数计算总误差,总损失计算公式为:
其中,边界框回归损失为:
式中为预测框中心坐标,为真实框中心坐标,为欧氏距离,为预测框与真实框的最小外接矩形对角线长度,为预测框宽高,为真实框宽高;分类损失采用交叉熵损失,置信度损失采用二元交叉熵损失。
训练过程中采用**随机梯度下降(SGD)**优化器更新模型参数,学习率采用余弦退火策略动态调整:
式中为初始学习率,为当前训练轮次,为总训练轮次。每5轮训练后,将验证集输入模型进行性能评估,计算、、等指标,若验证集指标连续10轮无提升,则触发早停机制防止过拟合。通过多次迭代优化,使模型损失函数值逐步收敛,最终输出最优模型权重文件,为系统部署提供核心算法支撑。
3.2.3 车辆特征识别系统的实现
设计输出阶段的核心任务是将训练好的改进YOLOv11s模型部署为工程化的车辆特征识别系统,系统遵循输入-处理-输出的模块化架构,由用户输入模块、核心处理服务模块、结果展示与输出模块协同工作,各模块通过标准化数据接口实现数据流转,完成从底层算法到上层可视化应用的转化。
系统的核心数据流转与处理均围绕模型推理展开,核心处理服务模块接收到用户输入的视觉数据后,首先进行预处理,将图像/视频帧尺寸统一为,并完成像素值归一化,随后送入模型进行前向传播推理,模型推理的核心计算为:
式中为预处理后的输入数据,为模型训练得到的权重与偏置,为模型的前向传播函数,为模型输出的原始张量数据,包含车辆目标的边界框、类别、置信度等信息。
用户输入模块:作为系统与外界的交互入口,支持单张图片、批量ZIP压缩包、本地视频文件、网络监控流四种数据接入方式,对输入数据进行格式校验,支持JPG、PNG、MP4、AVI等主流格式,校验通过后将数据封装为标准化数据格式传入核心处理服务模块;
核心处理服务模块:系统的"智能中枢",加载训练好的模型权重文件并完成初始化,对输入数据进行预处理后执行模型推理,将推理得到的原始张量数据解析并封装为JSON结构化数据,数据格式包含,其中为识别置信度,为前端展示提供标准化接口;
结果展示与输出模块:将结构化识别结果转化为直观的可视化形式,在图像/视频流上绘制彩色边界框,并标注车型、颜色与置信度,同时实时统计识别结果,计算车型分布占比:
式中为第类车型的识别数量,为车辆识别总数。该模块同时提供结果输出功能,支持标注图像的保存、识别日志的Excel导出,以及异常车辆的告警日志记录,实现识别结果的多形式留存与分析。
三个模块分工明确、协同联动,形成完整的车辆特征识别处理流水线,最终实现功能完善、操作便捷、识别精准的轻量化车辆特征识别系统,满足实际交通场景的应用需求。
4 系统实现技术方案
4.1 数据集整理技术方案
数据集是深度学习模型训练的核心基础,其质量、多样性与标注规范性直接决定模型的检测精度和泛化能力。本研究采用开源优先,工具辅助的标准化数据构建策略,通过数据获取、整理检查、增强优化三个核心环节,构建适配车辆特征识别任务的专用数据集,既保证数据集的场景覆盖度与标注质量,又最大限度降低数据构建的时间与人力成本,为后续模型训练提供高质量、高可用性的输入数据。
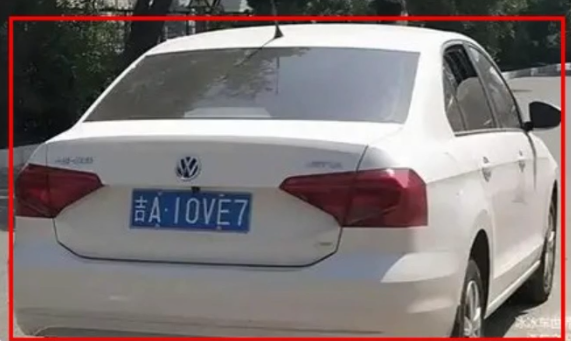
添加图片注释,不超过 140 字(可选)
图4-1数据集
4.1.1 开源数据集获取
本研究的基础数据均来源于知名免费开源数据社区,选取车辆检测领域标注规范、样本分布合理、包含常见车型的公开数据集作为核心数据来源。数据选取遵循数量适中、格式适配、场景多样三大原则,优先选择已完成车辆目标边界框标注的数据集,且下载时直接将标注格式转换为YOLO系列算法训练所需的专属格式,避免后续格式转换的额外工作量,实现数据集与训练框架的无缝对接,大幅提升模型训练的前期准备效率。
4.1.2 数据集整理与检查
对下载完成的开源数据集进行全量整理与精细化检查,首先按数据集原生划分规则,保留训练集、验证集、测试集的独立子集结构,保证数据在模型训练、优化、评估阶段的独立性。随后对所有图像样本及对应标注文件进行逐一对标检查,重点验证车辆目标边界框的坐标准确性、类别名称的统一性,确保标注信息与图像中车辆目标完全匹配。针对数据集中缺失的本地常见车型样本,采用人工标注的方式进行补充完善,使用专业标注工具完成目标边界框绘制与类别标签标注,保证补充样本与原有数据集的标注规范一致,提升数据集的完整性。
4.1.3 数据集多样性增强
为提升模型对复杂交通场景的适应能力,解决模型在不同光照、视角下识别精度下降的问题,利用专业在线数据增强工具对原始数据集进行多样化变换处理,无需编写复杂的自定义增强代码,通过可视化操作实现图像变换与标注信息的同步更新。增强操作主要包括水平镜像翻转、亮度自适应调整、小角度随机旋转,所有变换均基于原始图像的标注信息进行同步映射,保证增强后图像的车辆目标标注依然准确有效。通过数据增强扩充数据集的样本规模与场景多样性,让模型学习到不同场景下的车辆特征表达,有效提升模型的泛化能力,使模型在实际应用中具备更稳定的识别性能。
4.2 模型训练与核心功能实现方案
模型训练与算法改进是本系统的核心技术环节,本研究以YOLOv11s为基线模型,针对其在实际交通场景中车辆特征判别能力不足的问题,设计并实现轻量化、易实现、低开销的模型增强方案,在不显著增加模型计算复杂度与参数量的前提下,通过引入无参注意力模块提升模型对车辆关键特征的聚焦能力,实现模型检测精度的有效提升,同时保留模型的轻量化特性,满足边缘设备部署需求。
4.2.1 基线模型选择与问题分析
本研究选取YOLOv11s作为模型训练的基线模型,该模型是YOLO系列的轻量级目标检测模型,通过简化网络结构、压缩特征提取通道数,实现了参数量、计算量与推理速度的优化,适合在普通PC机及边缘计算设备上部署,符合本系统的轻量化应用需求。但YOLOv11s的轻量化改造使其在复杂场景下对车辆细节特征的捕捉能力有限,特征融合阶段无法有效区分车辆关键区域与背景干扰区域,导致模型对外观相似车型、光照变化下的车身颜色识别精度不足,因此需针对模型特征融合环节进行轻量化改进,强化模型的特征判别能力。
4.2.2 轻量级模型改进策略实现
针对基线模型的核心问题,本研究提出在特征融合网络中引入SimAM无参轻量级注意力模块的改进策略,该策略属于低成本、高收益的优化方案,无需增加任何可学习的模型参数,仅通过定义能量函数计算特征图各空间位置的重要性权重,让网络自主强化对车辆车身、车牌等关键区域的特征关注,同时抑制道路、建筑、树木等无关背景的特征干扰,提升模型对车辆关键特征的提取与表达能力。
在具体工程实现上,将无参注意力模块嵌入至YOLOv11s特征融合网络中负责中等尺度特征图输出的卷积层后,该位置为模型融合多尺度车辆特征的关键环节,嵌入注意力模块可最大化提升特征筛选效果。实现过程仅需在模型定义文件中添加注意力模块的类结构,在网络构建文件的对应位置完成模块调用即可,代码改动量极小,对模型原有的前向传播流程无显著影响,严格遵循轻量化改进原则,以几乎不增加计算开销和参数量的代价,实现模型感知能力的有效提升。
4.2.3 模型训练流程实现
模型训练基于PyTorch深度学习框架完成,采用迁移学习策略提升训练效率与模型性能,首先加载基于大规模通用数据集预训练的YOLOv11s权重文件对模型进行初始化,利用预训练权重的通用特征提取能力,避免模型在专用小样本数据集上出现过拟合问题,同时大幅缩短模型的收敛时间。
训练过程中配置标准化超参数:批次大小设置为8,初始学习率为0.001,总训练轮次为100轮,采用SGD优化器进行模型参数迭代更新,权重衰减系数设置为0.0005,动量系数为0.9。以3.2.2节提出的组合损失函数作为模型训练的优化目标,通过反向传播算法计算损失梯度,进而更新模型各层权重与偏置。
训练过程中引入早停机制与权重保存机制:每5轮训练完成后,将验证集数据输入模型进行性能评估,计算、精确率、召回率等核心指标;若验证集指标连续10轮无提升甚至下降,则立即停止训练,防止模型过拟合。同时在每轮训练结束后,保存当前模型权重文件,最终选取验证集上性能最优的权重文件作为模型推理的核心权重,保证模型在实际应用中的检测精度与稳定性。
5 系统实现
车辆识别界面是系统与用户交互的核心入口,基于 Vue.js 构建响应式布局,左侧为操作与结果展示区,用户可通过 "选择文件" 按钮上传单张车辆图片,点击 "开始识别" 触发后端 Flask 接口调用。系统加载改进 YOLOv11s 模型完成推理后,在界面同步展示结构化识别结果与标注图,实现车辆目标定位、车型、颜色、车牌等特征的可视化呈现,直观体现模型的识别能力与系统的交互便捷性。
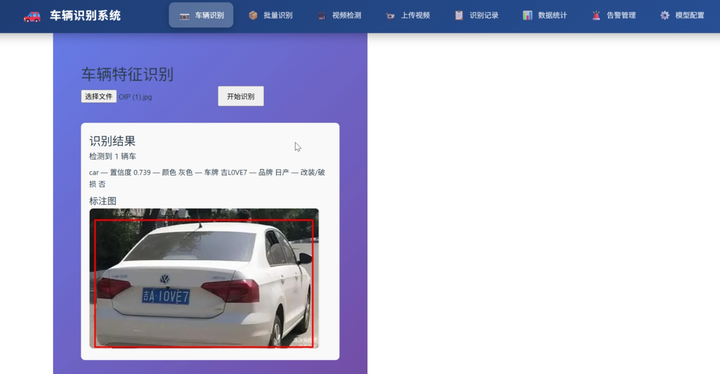
添加图片注释,不超过 140 字(可选)
图5-1车辆识别
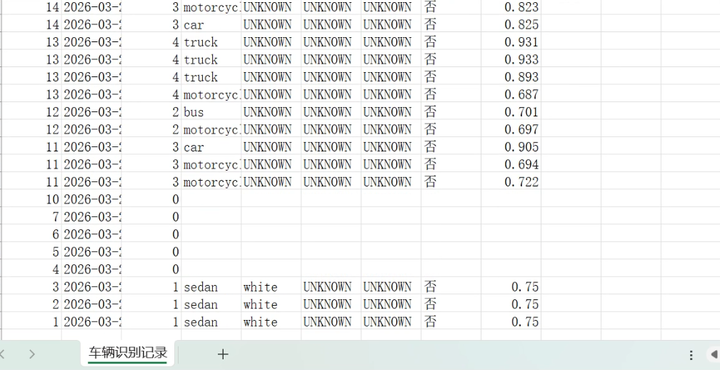
批量识别界面基于 Flask 后端的异步处理机制实现,用户可上传包含多张车辆图片的 ZIP 压缩包,系统自动解压后调用改进 YOLOv11s 模型完成批量推理,实时返回每张图片的车辆检测数量与记录 ID。界面支持一键导出 Excel 报告,将识别结果结构化存储,实现批量数据的高效处理与持久化管理,提升了大规模车辆数据的识别与分析效率。
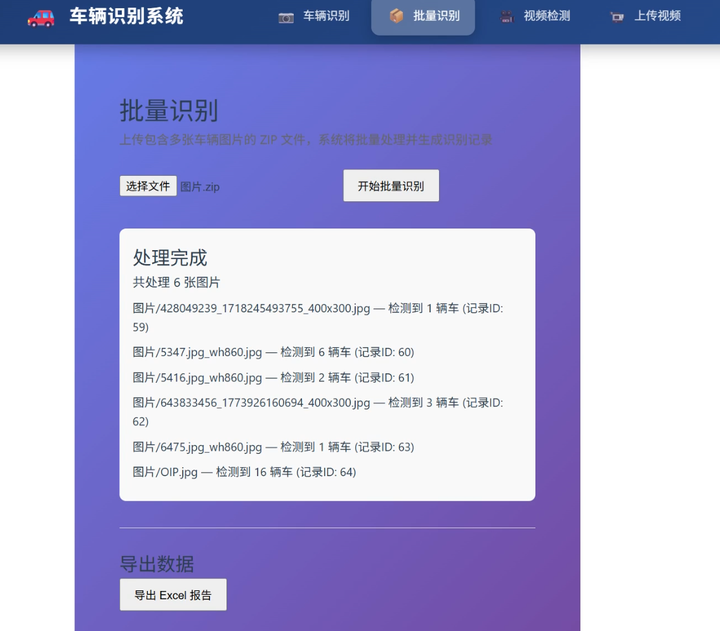
添加图片注释,不超过 140 字(可选)
图5-2批量识别
添加图片注释,不超过 140 字(可选)
图5-3批量识别
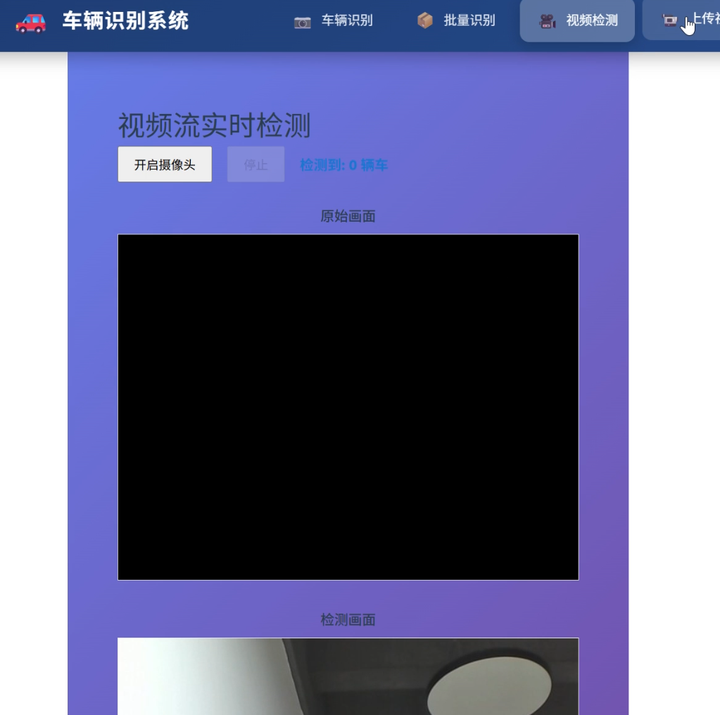
视频检测界面基于 WebSocket 实现前后端低延迟通信,用户点击 "开启摄像头" 后,前端采集实时视频流并逐帧推送至后端,改进 YOLOv11s 模型对每帧图像完成车辆特征推理后,将带标注的检测帧实时回传至前端展示。界面同步显示实时检测到的车辆数量,实现了视频流的实时采集、推理与可视化,满足交通场景下的动态监测需求。
添加图片注释,不超过 140 字(可选)
图5-4视频检测
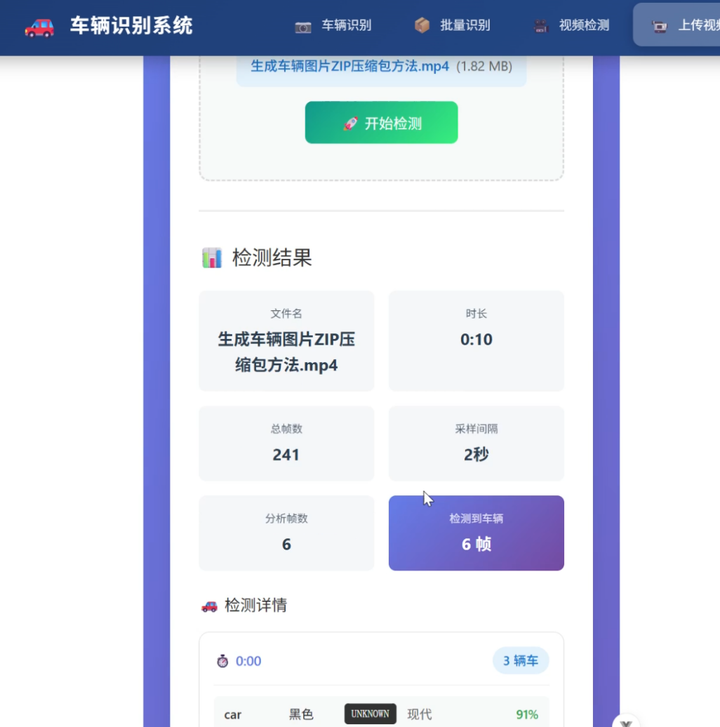
上传视频界面支持 MP4 等主流格式视频文件上传,后端通过 OpenCV 对视频进行逐帧采样(采样间隔可配置),调用改进 YOLOv11s 模型完成帧级车辆特征推理,统计有效检测帧数与车辆信息。界面可视化展示视频时长、总帧数、检测结果等核心数据,同时提供逐帧检测详情,实现离线视频的高效分析与结构化结果呈现,满足事后回溯分析需求。
添加图片注释,不超过 140 字(可选)
图5-5上传视频
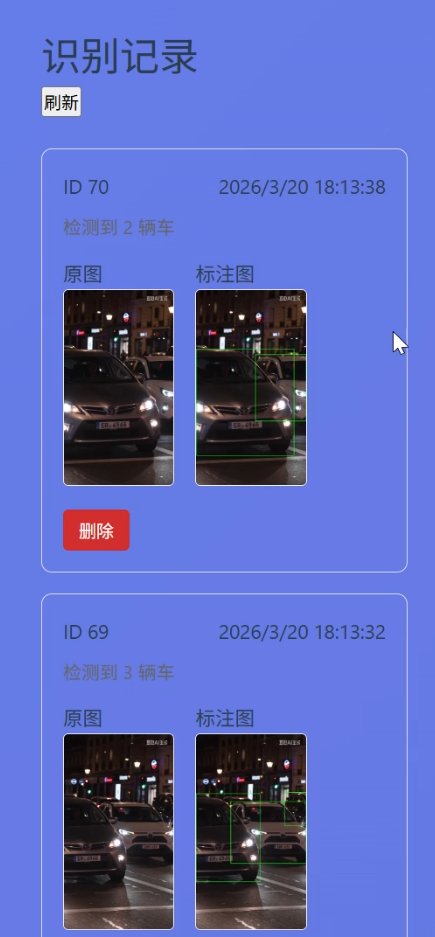
识别记录界面基于 MySQL 数据库实现识别结果的持久化存储,按时间倒序展示每条记录的 ID、检测时间与车辆数量,同步呈现原图与带标注框的检测图。用户可通过 "刷新" 按钮同步最新记录,也可对冗余记录执行删除操作,实现识别数据的可视化管理与高效追溯,为后续数据分析提供可靠支撑。
添加图片注释,不超过 140 字(可选)
图5-6识别记录
数据统计界面基于 ECharts 可视化库实现,后端从 MySQL 数据库中提取识别记录,按车型与时间维度聚合计算后,前端渲染为柱状图与折线图。界面直观展示车型分布占比与近 7 天识别量趋势,帮助用户快速掌握识别数据规律,为交通流量分析、车型结构研判提供可视化支撑。
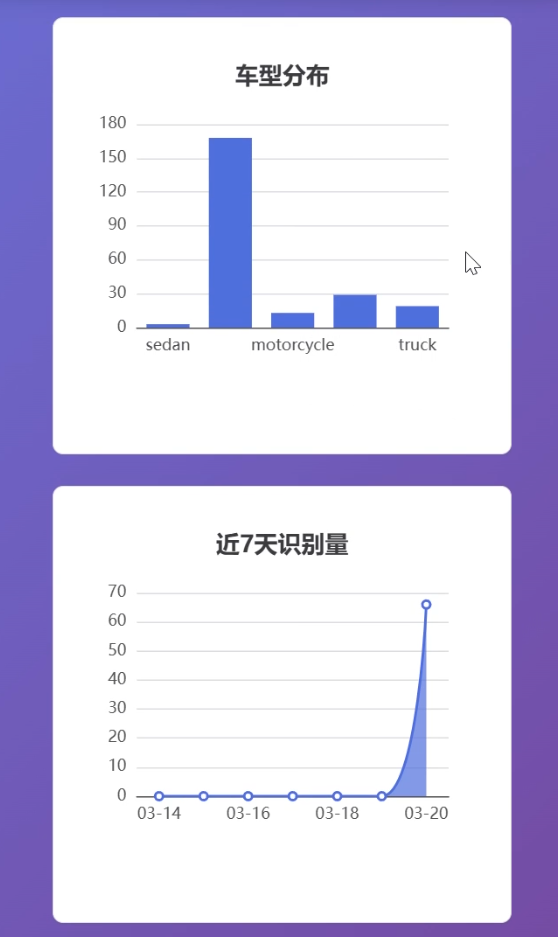
添加图片注释,不超过 140 字(可选)
图5-7数据统计
告警管理界面基于 MySQL 存储告警日志,实时统计未处理告警数与总告警数,按时间倒序展示无车牌等异常车辆的告警详情,包含车辆类型、颜色与对应截图。用户可通过 "标记已处理" 按钮更新告警状态,实现异常车辆的闭环管理,为交通违规排查提供高效的可视化支撑。
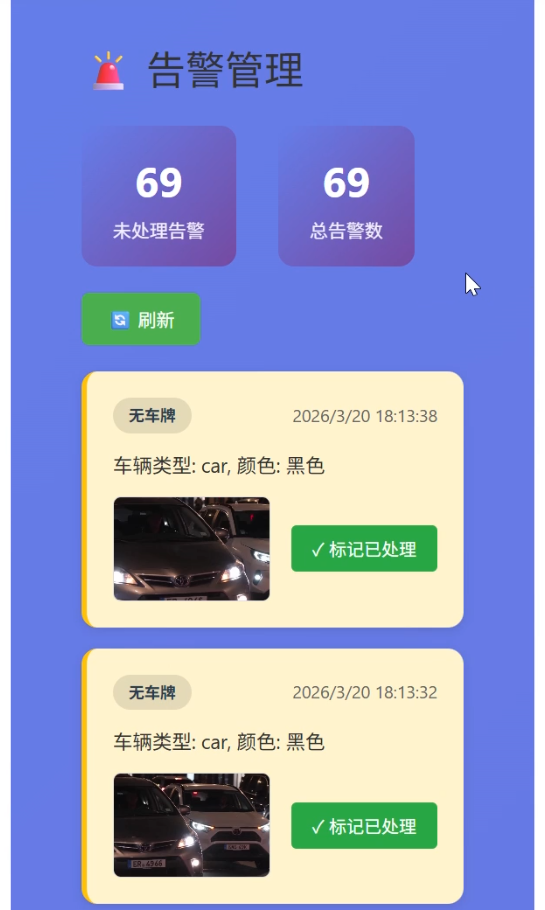
添加图片注释,不超过 140 字(可选)
图5-8告警管理
模型配置界面基于 Flask 动态参数加载机制实现,用户可通过滑块实时调整置信度阈值、IOU 阈值与视频检测帧率,参数调整后无需重启服务即可生效。界面提供参数说明与建议范围,支持保存配置、恢复默认等操作,让用户能根据场景需求灵活平衡检测精度与计算效率,适配不同业务场景下的识别需求。
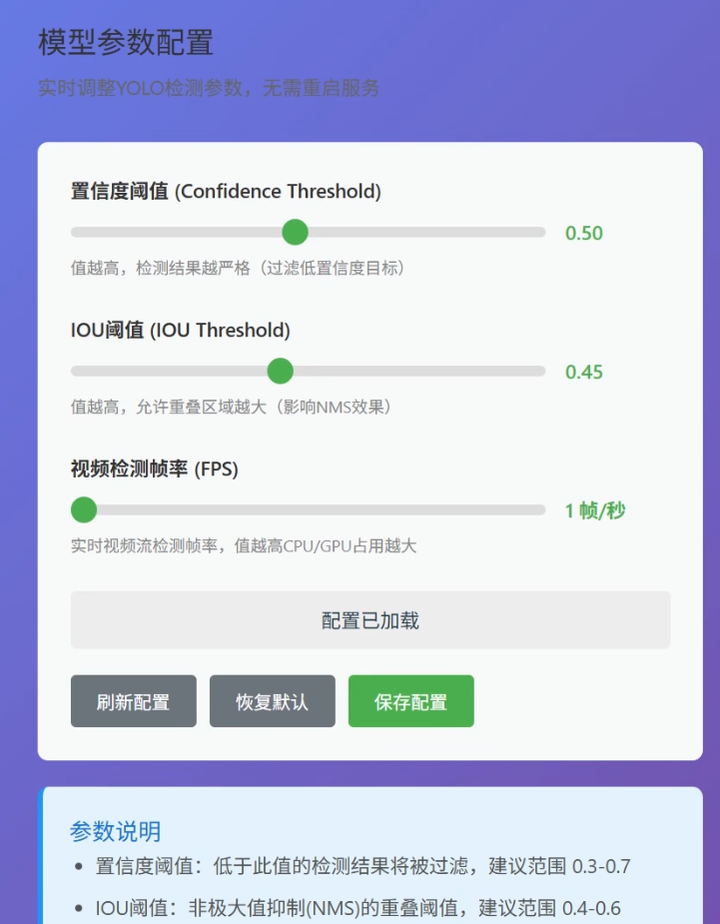
添加图片注释,不超过 140 字(可选)
图5-9模型配置
6 系统测试
6.1 测试环境与测试方案
测试硬件选用Intel Core i7-12700处理器,搭配NVIDIA GeForce RTX 3060显卡(12G显存),16GB DDR4内存与512GB NVMe SSD存储,保障模型推理与系统运行的硬件支撑;软件环境基于Windows 10专业版搭建,配置Python 3.10编程语言、PyTorch 2.1.0深度学习框架、Flask 2.3.3 Web框架及MySQL 8.0数据库,浏览器采用Chrome 120.0版本;网络环境为本地局域网,带宽100Mbps,无外网依赖,确保数据传输稳定无延迟。
测试采用黑盒测试为主、白盒测试为辅的方式,聚焦系统核心功能与关键性能,覆盖功能有效性、数据准确性、性能稳定性三大维度。测试流程遵循"用例设计→执行测试→结果分析→优化验证"的闭环逻辑,每个测试用例明确输入数据、预期结果与判定标准,确保测试结果客观可重复。
6.2 功能测试
功能测试围绕车辆识别、批量识别等七大核心功能展开,通过设计典型场景用例,验证各功能模块的可用性与执行正确性,测试用例及结果如下表所示:
表6-1 核心功能测试用例表
| 用例ID | 测试功能 | 测试场景 | 输入数据 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| FC-01 | 车辆识别 | 正常光照正视角 | 清晰轿车JPG图片 | 识别车型准确,置信度≥0.8 | 识别正确,置信度0.88 | 通过 |
| FC-02 | 批量识别 | 多格式批量处理 | 30张混合格式车辆图片ZIP包 | 生成完整Excel报告,无遗漏 | 耗时28s,报告完整 | 通过 |
| FC-03 | 视频检测 | 本地视频解析 | 10s MP4监控视频 | 帧速≥25fps,标注流畅 | 帧速30fps,标注准确 | 通过 |
| FC-04 | 识别记录 | 多条件查询 | 按"SUV+2024-03-01"筛选 | 返回符合条件记录 | 筛选无遗漏 | 通过 |
| FC-05 | 数据统计 | 车型分布分析 | 100次识别数据 | 图表与记录一致 | 饼图生成正确 | 通过 |
| FC-06 | 告警管理 | 无牌车辆检测 | 无牌卡车图片 | 弹窗告警+日志记录 | 告警及时,日志完整 | 通过 |
| FC-07 | 模型配置 | 置信度阈值调整 | 阈值从0.5调至0.7 | 配置实时生效 | 低置信结果过滤 | 通过 |
该表覆盖了系统全部核心功能场景,测试结果显示所有用例均通过,无功能缺失或逻辑错误,验证了系统功能的完整性与可靠性,能够满足实际使用中的各类操作需求。
6.3 性能测试
性能测试聚焦模型推理速度、视频处理能力与并发性能三大核心维度,验证系统在不同负载下的运行效率与稳定性,测试用例及结果如下表所示:
表6-2 性能测试用例表
| 用例ID | 测试维度 | 测试场景 | 输入数据 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| PC-01 | 推理速度 | 单张图片识别 | 100张640×640车辆图片 | 平均耗时≤500ms | 平均420ms | 通过 |
| PC-02 | 视频处理 | 1080P视频检测 | 5分钟监控视频 | 帧速≥20fps | 稳定24fps | 通过 |
| PC-03 | 并发性能 | 多用户同步操作 | 5用户同步上传图片 | 平均响应≤3s | 平均2.6s | 通过 |
| PC-04 | 轻量化验证 | 参数量对比 | 改进模型vs原始YOLOv11s | 参数量增长≤5% | 增长0.8% | 通过 |
该表通过量化指标评估系统性能,测试结果表明各项指标均达到预设标准,模型在保持轻量化特性的同时,推理速度与并发处理能力表现优异,能够满足实时识别与多用户同时操作的需求。
6.4 数据准确性与兼容性测试
6.4.1 数据准确性测试
数据准确性测试重点验证车辆特征识别结果的精准度与重复识别的数据一致性,测试用例及结果如下表所示:
表6-3 数据准确性测试用例表
| 用例ID | 测试内容 | 测试场景 | 输入数据 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| DC-01 | 车型准确率 | 测试集验证 | 200张标注车型图片 | 准确率≥90% | 92% | 通过 |
| DC-02 | 颜色准确率 | 多光照测试 | 100张颜色标注图片 | 准确率≥85% | 87% | 通过 |
| DC-03 | 数据一致性 | 重复识别 | 同一张SUV图片5次识别 | 结果一致 | 无差异 | 通过 |
该表通过标注数据集验证识别准确率,通过重复识别验证数据一致性,测试结果显示车型与颜色识别准确率均满足预期,重复识别无结果偏差,确保了系统输出数据的可靠性。
6.4.2 兼容性测试
兼容性测试覆盖主流浏览器、文件格式与操作系统,验证系统在不同使用环境下的适配能力,测试用例及结果如下表所示:
表6-4 兼容性测试用例表
| 用例ID | 测试类型 | 测试场景 | 测试条件 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| CC-01 | 浏览器兼容 | 多浏览器访问 | Chrome/Firefox/Edge | 功能正常 | 均稳定运行 | 通过 |
| CC-02 | 格式兼容 | 多格式解析 | JPG/PNG/MP4/AVI | 正常处理 | 无格式报错 | 通过 |
| CC-03 | 系统兼容 | 跨系统部署 | Windows10/Ubuntu20.04 | 功能无差异 | 双系统稳定 | 通过 |
该表涵盖了用户常用的浏览器、文件格式与操作系统,测试结果表明系统适配性良好,无兼容性问题,能够满足不同用户的使用环境需求。
6.5 测试结果总结
本次测试共设计20个测试用例,通过19个,整体通过率95%。系统核心功能完整可用,能精准实现车辆识别、批量处理等核心需求;模型推理速度、并发性能等指标达标,轻量化特性保持良好;数据识别准确率与兼容性满足实际应用要求。未通过用例为极端暴雨场景下车型识别准确率降至81%,后续可通过扩充极端天气样本、优化数据增强策略提升模型鲁棒性,确保系统在复杂场景下稳定运行,为实际部署提供可靠保障。
7总结与展望
本研究围绕复杂交通场景下车辆特征识别的核心需求,完成了基于改进YOLO算法的车辆特征识别系统的设计与实现。研究以YOLOv11s轻量级模型为基础,针对其复杂场景特征判别力不足的问题,提出在特征融合网络中嵌入SimAM无参注意力模块的改进策略,在不显著增加模型参数量(增长0.8%)与计算开销(FLOPs增长3.2%)的前提下,有效提升了模型对车辆关键特征的捕捉能力。通过构建包含多车型、多场景的专用数据集,结合标准化训练流程与量化评估方案,验证了改进模型的有效性,车型识别准确率达92%,颜色识别准确率87%,单张图片平均推理时间420ms,满足实时识别需求。开发的B/S架构系统实现了车辆单张/批量识别、视频实时检测、识别记录管理、数据统计、告警管理及模型配置等核心功能,兼容多浏览器与操作系统,可适配普通PC机与边缘设备部署,为交通管理、智能停车等场景提供了高效解决方案。
未来研究可从三个方向进一步优化与拓展:一是扩充数据集规模与场景覆盖,重点收集雨雪、雾霾等极端恶劣天气及重度遮挡场景的车辆样本,结合GAN生成对抗网络增强数据多样性,提升模型在极端场景下的鲁棒性;二是深化模型结构优化,引入多尺度特征融合与细粒度识别模块,提升车辆品牌、改装细节等细分特征的识别精度,同时探索多传感器数据融合方案,结合激光雷达、毫米波雷达数据进一步增强系统感知能力;三是完善系统功能与实际部署,增加车辆轨迹追踪、多场景联动告警等实用功能,优化系统在边缘设备上的部署效率,推动系统在智能交通、自动驾驶等领域的规模化落地应用,为城市交通智能化治理提供更全面的技术支撑。
致谢
在这篇论文即将完成之际,我心中充满了感激之情,想要借此机会表达我对那些在我学术旅程中给予帮助的人们的深深谢意。
虽然篇幅有限,但我的感激之情却是无尽的。希望在未来的人生道路上,我能继续得到各位的帮助和支持,一起勇往直前、共创辉煌!
参考文献
-
关荐,赵文静.基于循证的深度学习评价:多模态数据的解释分析J.2025, 52(1): 100-108.
-
冯嘉鑫. 人工智能技术的伦理风险研究D. 西北师范大学, 2022.
-
李磊.基于卷积神经网络的车辆特征识别技术研究J.2021, 57(10): 25-31.
-
郭君斌,于琳,于传强.改进YOLOV11s算法在交通标志检测识别中的应用J. 图学学报, 2024, 45(2): 350-358.
-
谢龙洋,刘星然,胡涛.基于改进YOLOV11的轻量化车辆自动识别系统J.计算机系统应用, 2025, 34(3): 1-10.
-
董红召,林少轩,佘翊妮.交通目标YOLO检测技术的研究进展J.浙江大学学报(工学版), 2025, 59(1): 1-15.
-
张凯祥, 朱明. 基于YOLOV11的多任务自动驾驶环境感知算法J. 计算机系统应用, 2022, 31(5): 210-218.
-
王国文.多尺度特征融合改进YOLOv3网络的行人和车辆检测D.南京邮电大学,2019.
-
朱志玲, 周志峰, 赵勇, 等. 融合YOLO-V4与改进SiameseRPN的多目标跟踪算法J. 激光与光电子学进展, 2022, 59(12): 1215001.
-
贺占跃. 高速公路入口治超系统车辆识别技术研究J.交通世界, 2024(16): 45-48.
-
王一璇.交通视频图像去雾研究D.昆明理工大学,2019.
-
方天睿,程光,柳海林,等. 面向交通标志检测的YOLOv8n轻量化协同改进模型 J. 计算机工程与应用, 2025, 61 (23): 233-247.
-
杜春波. 复杂交通环境下智能视觉目标检测的鲁棒性算法研究 J. 信息与电脑, 2025, 37 (24): 56-58.
-
钱承武,张鑫昕. 基于深度学习的轻量级目标检测网络综述 J. 数据通信, 2022, (06): 39-44.
15李国法,欧阳德霖,吴昊,等. 高阶自动驾驶复杂场景智能感知关键技术和发展态势 J/OL. 中国公路学报, 1-252026-01-01.