👋 欢迎阅读
🔥 愿旖旎· 个人主页
📘学习专栏: 《算法专栏》《LangChain学习》《贪心算法》
🌄 钱塘江上潮信来,今日方知我是我
✨当前学习内容 : 《LangGraph》
📑 目录
-
[四、时间旅行(Time Travel)](#四、时间旅行(Time Travel))
一、前置讲解
在进入正文前,先花 10 秒了解本篇会反复用到的核心概念,带着印象去读正文,学习效率更高。
✂️ 前置知识一:消息修剪(trim_messages)
按token 数 裁剪历史消息,接近上下文窗口上限时只保留最近的一段。
🗑️ 前置知识二:消息删除(RemoveMessage)
按消息 id 精确删掉历史消息,甚至清空整段历史。
📝 前置知识三:消息总结(summary 字段)
不删也不丢信息:把旧对话压缩成摘要 存进状态,用摘要代替冗长历史。
⏸️ 前置知识四:中断(interrupt)与 Command(resume=...)
在流程关键点暂停 ,等人工输入 后再从存档恢复执行。
🕰️ 前置知识五:时间旅行(Time Travel)
拿到历史检查点 就能改状态、重放 ,用来定位错误 和探索替代路径。
二、信息处理:让历史消息不再无限增长
2.1 修剪信息
大多数 LLM 都有一个最大支持的上下文窗口 。决定何时截断消息 的一种方法,是对消息历史记录 中的令牌 进行计数 ,并在接近该限制 时截断。
💡 消息裁剪的具体方法可以参考 LangChain 篇章的内容,这里直接把裁剪嵌进图节点里。
代码示例:
python
from langchain_core.messages.utils import trim_messages
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, MessagesState
# ---------- 1. 定义模型 ----------
model = init_chat_model(model="deepseek-chat", model_provider="deepseek", temperature=0)
# ---------- 2. token 计数函数 ----------
# 逐条消息数 token 再求和
def count_tokens(messages):
return sum(model.get_num_tokens(m.content) for m in messages)
# ---------- 3. 定义模型节点(带消息裁剪)----------
def call_model(state: MessagesState):
"""调用 LLM,但先裁剪历史消息,只保留最近的若干 token"""
# 只保留最近的 128 个 token 的消息
messages = trim_messages(
state["messages"],
# strategy:裁剪策略
# "last" = 保留后半部分(丢弃最早的,保留最新的)
# "first" = 保留前半部分(丢弃最新的,保留最早的)
strategy="last",
# token_counter:计算 token 数量的函数
token_counter=count_tokens,
# max_tokens:裁剪后剩余消息的总 token 上限
max_tokens=128,
# start_on:裁剪后第一条(最靠前)的消息必须是 "human"(用户消息)
start_on="human",
# end_on:裁剪后最后一条消息必须是 "human" 或 "tool"(工具返回消息)
end_on=("human", "tool"),
)
response = model.invoke(messages)
return {"messages": [response]}
# ---------- 4. 构建图 ----------
checkpointer = InMemorySaver()
builder = StateGraph(MessagesState)
builder.add_node("call_model", call_model)
builder.add_edge(START, "call_model")
graph = builder.compile(checkpointer=checkpointer)
# ---------- 5. 多轮对话(同一个 thread_id,历史会累积)----------
config = {"configurable": {"thread_id": "1"}}
graph.invoke({"messages": "hi, my name is bob"}, config)
graph.invoke({"messages": "write a short poem about cats"}, config)
graph.invoke({"messages": "now do the same but for dogs"}, config)
# 最后一问
final_response = graph.invoke({"messages": "what's my name?"}, config)
final_response["messages"][-1].pretty_print()运行结果:
I don't know your name💡 这个结果不是 bug,而是修剪的代价 :
max_tokens=128加上strategy="last",意味着"我叫 bob"那句早已被裁掉 ,模型看到的只是最近一段对话(主要在聊猫和狗的诗),所以它真的不知道你的名字 。这说明修剪能省 token,但会丢信息------接着往下看两种补救思路。
2.2 删除消息
也可以从图状态 中删除消息 来管理消息历史记录 。当想删除特定消息 或清除整个消息历史记录时,这非常有用。
代码示例:
python
from langchain_core.messages import RemoveMessage
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, MessagesState
# ---------- 1. 定义模型 ----------
model = init_chat_model(model="deepseek-chat", model_provider="deepseek", temperature=0)
# ---------- 2. 定义模型节点(手动删除早期消息)----------
def call_model(state: MessagesState):
"""调用 LLM,消息过多时手动删除最早的一批"""
messages = state["messages"]
# 消息超过 6 条时,删除最早的 6 条
if len(messages) > 6:
# RemoveMessage(id=消息id):按 id 删除指定消息
return {
"messages": [RemoveMessage(id=m.id) for m in messages[:6]]
}
response = model.invoke(messages)
return {"messages": [response]}
# ---------- 3. 构建图 ----------
checkpointer = InMemorySaver()
builder = StateGraph(MessagesState)
builder.add_node("call_model", call_model)
builder.add_edge(START, "call_model")
graph = builder.compile(checkpointer=checkpointer)
# ---------- 4. 多轮对话(累积历史)----------
config = {"configurable": {"thread_id": "1"}}
graph.invoke({"messages": "hi, my name is bob"}, config)
graph.invoke({"messages": "write a short poem about cats"}, config)
graph.invoke({"messages": "now do the same but for dogs"}, config)
final_response = graph.invoke({"messages": "what's my name?"}, config)
# ---------- 5. 查看结果 ----------
for message in final_response["messages"]:
message.pretty_print()运行结果:
================================ Human Message =================================
what's my name?💡 输出里只剩一条用户消息 ,原因有两层:一是第四轮进来时消息已经 7 条 (3 组问答 + 新提问),触发
len(messages) > 6;二是这一轮直接return了删除指令、没有调用模型 ,所以状态里删掉最早 6 条后,正好只剩刚进来的这一条提问 。也就是说,这一轮的作用是"清理历史",而不是"回答问题"。
2.3 总结消息
实际上,修剪或删除消息 也会存在问题:可能因剔除消息 而丢失信息 。因此某些应用 更希望把消息历史记录 进行总结 ------把旧的对话内容 总结成简短摘要 ,保留关键信息 ,以代替冗长的历史记录。
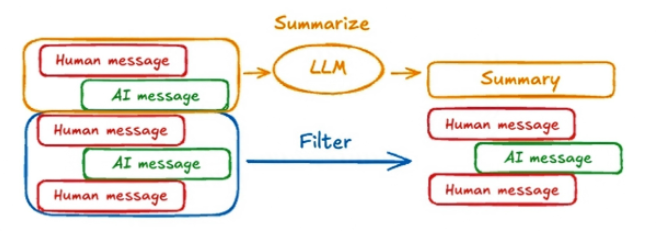
做法是先把 State 进行扩展 ,除了对话记录 ,再加一个总结摘要字段:
python
from langgraph.graph import MessagesState
class State(MessagesState):
summary: str现在的设计要求是:
| 要求 | 说明 |
|---|---|
| 对话记录 | 记录新的对话与结果 |
| 摘要 | 每次对话完成,需要进行总结 |
| 删除历史 | 完成总结摘要后 ,可以删除历史对话 |
这样,每次调用 LLM 时,就可以根据【新的请求 】与【总结摘要信息 】共同构建提示词来完成请求。
代码示例:
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage, RemoveMessage
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, MessagesState


# ---------- 1. 定义模型 ----------
model = init_chat_model(model="deepseek-chat", model_provider="deepseek", temperature=0)


# ---------- 2. 自定义状态(MessagesState + 额外字段 summary)----------
# MessagesState 是 LangGraph 提供的【状态模板】,它内部自带了 messages 字段:
#     class MessagesState(TypedDict):
#         messages: Annotated[list[AnyMessage], add_messages]
#                        ↑字段名                    ↑合并规则:追加(不是覆盖)
# AnyMessage:任意类型的消息(HumanMessage、AIMessage、ToolMessage 都属于它)
# Annotated[类型, 附加信息]:给类型附加额外说明,这里的 add_messages 是【合并规则(reducer)】
#   → messages 字段更新时不是"覆盖",而是【追加】
class State(MessagesState):
    summary: str        # 额外加一个字段:存放历史对话的摘要


# ---------- 3. 定义模型节点 ----------
def call_model(state: State):
    """使用【历史总结 + 最新消息】发起调用"""
    # .get("summary", ""):取摘要字段;取不到时用默认值 ""(空字符串)
    summary = state.get("summary", "")

    # 拼成:[摘要] + [当前消息列表],一起发给模型
    messages = model.invoke([HumanMessage(content=summary)] + state["messages"])

    return {"messages": messages}


# ---------- 4. 定义总结节点 ----------
def summarize_conversation(state: State):
    """生成历史总结"""

    # 1. 创建总结提示词
    # .get("summary", ""):取摘要字段;取不到时用默认值 ""(空字符串)
    summary = state.get("summary", "")

    if summary:
        # 有摘要,扩展
        summary_message = (
            f"这是到目前为止的对话摘要:{summary}\n\n"
            "基于上面的新消息扩展摘要:"
        )
    else:
        # 无摘要,新增
        summary_message = "创建上面对话的摘要:"

    # 2. 生成新总结:【消息列表】+【总结提示词】调用模型
    messages = state["messages"] + [HumanMessage(content=summary_message)]
    response = model.invoke(messages)

    # 3. 删除历史对话:除了最新的消息,都可以删除
    return {
        "summary": response.content,        # 历史总结

        # RemoveMessage(id=消息id):按 id 删除指定消息
        # 保留最后的消息是为了打印结果
        "messages": [RemoveMessage(id=m.id) for m in state["messages"][:-1]],
    }


# ---------- 5. 构建图 ----------
checkpointer = InMemorySaver()      # 内存检查点:把图状态存到内存(程序结束即消失),用于多轮记忆

builder = StateGraph(State)
builder.add_node("call_model", call_model)
builder.add_node("summarize", summarize_conversation)

builder.add_edge(START, "call_model")
builder.add_edge("call_model", "summarize")     # 每次对话完,进行总结

graph = builder.compile(checkpointer=checkpointer)


# ---------- 6. 多轮对话 ----------
config = {"configurable": {"thread_id": "1"}}     # thread_id:存档编号,多轮记忆靠它定位

graph.invoke({"messages": "hi, my name is bob"}, config)
graph.invoke({"messages": "write a short poem about cats"}, config)
graph.invoke({"messages": "now do the same but for dogs"}, config)

final_response = graph.invoke({"messages": "what's my name?"}, config)

final_response["messages"][-1].pretty_print()
print("\nSummary:", final_response["summary"])
运行结果:
================================== Ai Message ==================================

Your name is Bob — you introduced yourself at the start of our conversation.

Summary: 根据对话摘要,你的名字是 **Bob**。
三、人机交互(Human-in-the-loop)
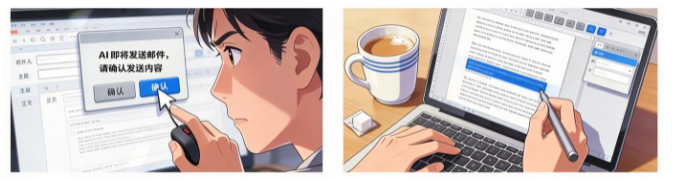
什么是人机交互? 想象这两个场景:
| 场景 | 需求 |
|---|---|
| AI 自动发送邮件前 | 你想亲自最后确认一遍内容 |
| AI 生成文章后 | 你想亲自动手修改几个段落 |
在 AI 系统 中,我们希望可以在 AI 自动流程 中插入一个"暂停键 ",等待人类输入 后再继续 ------这就是人机交互功能。
3.1 核心概念:中断(Interrupts)
想要完成人机交互 能力,需要用到 LangGraph 基于持久化 实现的【中断 】能力。中断 就像打游戏:当玩家无法通关某关卡时,希望暂停游戏(中断) ,攻略一下后再继续游戏。
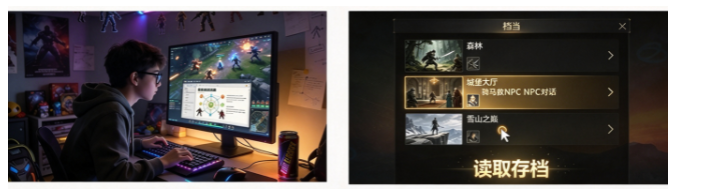
整个类比关系是这样的:
| 游戏世界 | LangGraph 世界 |
|---|---|
| 用户 在游戏过程中主动按下"存档键" | 节点里调用 interrupt() |
| 把游戏当前状态 等信息存档保存下来 | 依靠持久化能力 保存当前状态(检查点) |
| 攻略后读取存档 继续玩(恢复游戏) | 外部发 Command(resume=...) ,工作流恢复执行 |
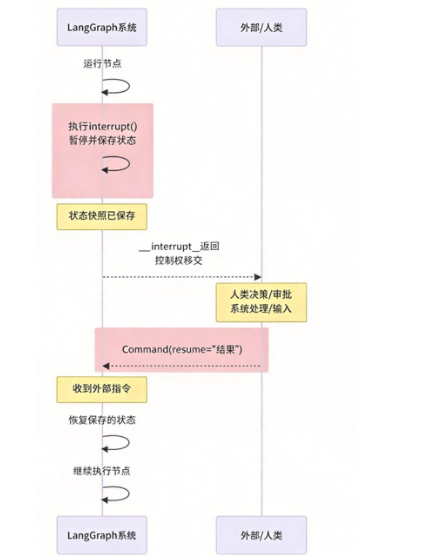
在 LangGraph 中,中断 允许工作流执行 时在特定点暂停 ,等待外部输入 后再继续执行。
3.2 中断如何实现?
在工作流中,实现暂停与恢复很简单,只需要两件事:
-
通过调用
interrupt()方法中断执行流程 ,依靠持久化能力 保存当前状态; -
外部用户 通过发送
Command对象 ,使工作流恢复执行流程。
代码示例:
python
from typing import TypedDict
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.constants import START
from langgraph.graph import StateGraph
from langgraph.types import interrupt, Command
# ---------- 1. 定义状态 ----------
class State(TypedDict):
input: str
output: str
# ---------- 2. 定义节点(会触发中断)----------
def hello_node(state: State):
# 主动喊"停!",并传递提示信息
human = interrupt("暂停,是否继续?") # 第一次运行会停在这里
if human == "yes":
return {"output": "你好,我是你的贴心助手!"}
else:
return {"output": "拜拜"}
# ---------- 3. 构建图 ----------
builder = StateGraph(State)
builder.add_node("hello_node", hello_node) # add_node:添加节点
builder.add_edge(START, "hello_node") # add_edge:添加入口边
# 必须指定 checkpointer,以在每个步骤后保存图状态
graph = builder.compile(checkpointer=InMemorySaver())
# ---------- 4. 步骤1:启动,触发暂停 ----------
# 必须使用 thread_id 运行 Graph,相当于告诉系统读哪个存档
config = {"configurable": {"thread_id": "human_1"}}
first = graph.invoke({"input": "hi"}, config=config)
print(first) # 看到提问:__interrupt__
# ---------- 5. 步骤2:恢复,把答案交回去 ----------
second = graph.invoke(Command(resume="yes"), config=config)
print(second["output"])运行结果:
{'input': 'hi', '__interrupt__': [Interrupt(value='暂停,是否继续?', id='524a9d8d4c0f951cdb36a43ea627698b')]}
你好,我是你的贴心助手!
代码关键点:
| 关键点 | 说明 |
|---|---|
| 编译图时 | 必须指定 checkpointer ,以在每个步骤后保存图状态 |
调用 interrupt() 时 |
表示主动喊"停!",并传递提示信息 |
| 恢复执行时 | 使用 invoke/stream 配合 Command(resume=...) 语法 |
resume |
表示传回 AI 的响应值 |
| 运行 Graph 时 | 必须使用 thread_id ,相当于告诉系统读哪个存档 |
因此,实现了中断 ,便是实现了人机交互模式。
3.3 中断的三条铁律
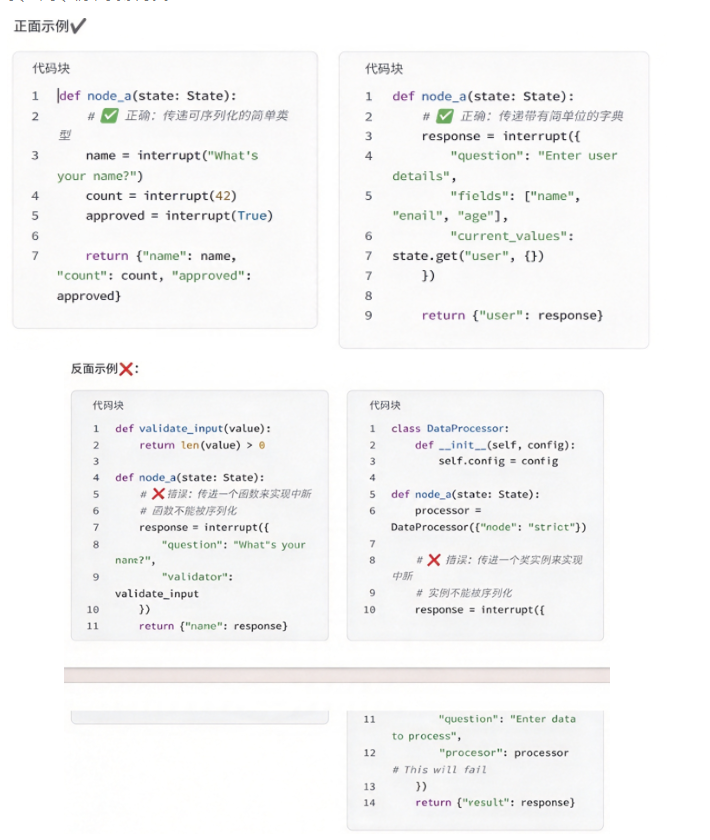
3.3.1 只传能序列化的简单数据
复杂值无法进行传递 :不要传函数 、类实例 、数据库连接 等。只传能序列化 的简单数据,如字符串、数字、布尔、简单字典/列表。
| 可以传 ✅ | 不要传 ❌ |
|---|---|
| 字符串、数字、布尔值 | 函数 、lambda |
| 简单字典 / 列表 | 类实例 、数据库连接 、文件句柄 |
3.3.2 不要把 interrupt() 包在 try/except 里
错误做法 是把 interrupt() 调用 包裹在通用的 try/except Exception 或空的 try/except 代码块中------你写的代码会提前捕获 这个特殊异常 ,导致运行时系统 无法感知到中断 ,从而使 interrupt() 功能失效。
根本原因在于:interrupt() 函数内部是通过抛出一个特殊的异常 来实现暂停执行 的,这个异常需要被 LangGraph 的运行时系统捕获 ,才能触发状态的保存和等待。
正确做法有两条:
| 做法 | 说明 |
|---|---|
| 分离逻辑 | 把 interrupt() 调用 与可能引发其他异常的代码 分开:先调用 interrupt() ,再处理可能出错的操作 |
| 精确捕获 | 在 try/except 块中只捕获你预期会发生 的、非常具体的异常类型 (例如 NetworkException),这样 interrupt() 抛出的特殊异常 就不会被你的代码捕获,而能顺利传给运行时系统 |
3.3.3 中断前的动作要"幂等"
这一点非常重要 :当节点恢复执行 时,发起中断 的节点 会从头再跑一遍 。因此,中断前的代码 会被重复执行!
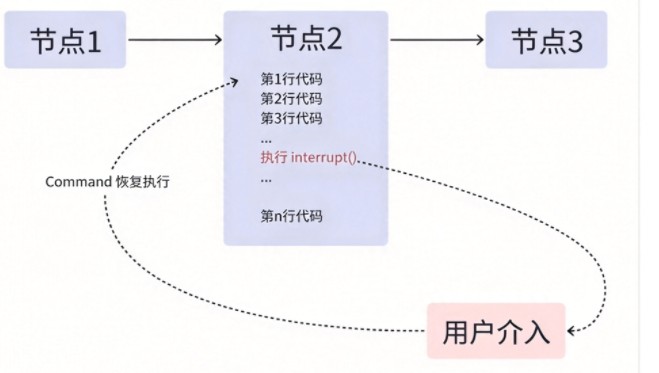
如果这些代码包含非幂等的副作用操作 (如创建记录、发送消息、扣款等),每次恢复都会重复这些操作,可能导致数据重复、不一致或意外行为。
幂等性 的含义是:一个操作无论执行一次还是多次,产生的效果都相同。
| 操作 | 是否幂等 | 说明 |
|---|---|---|
| 读取数据 / 查询信息 | ✅ 幂等 | 执行多次结果一样 |
| 纯计算、拼字符串 | ✅ 幂等 | 没有副作用 |
| 创建记录 | ❌ 非幂等 | 跑两遍就多一条数据 |
| 发送消息 / 邮件 | ❌ 非幂等 | 跑两遍就发两次 |
| 扣款、下单 | ❌ 非幂等 | 跑两遍就扣两次钱 |
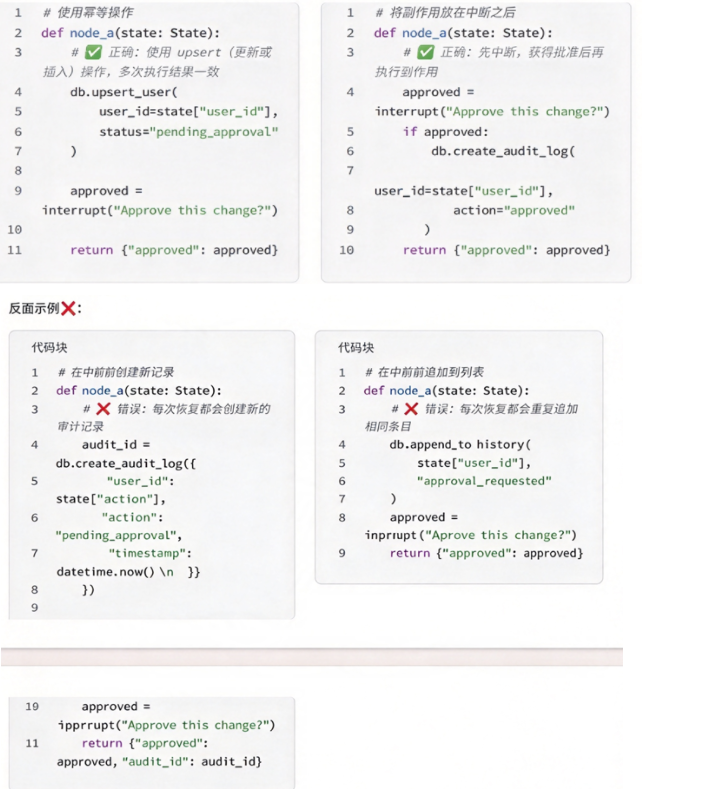
这一规则的核心是 :确保在 interrupt() 调用之前 执行的所有操作都是幂等 的,或者把非幂等操作 移到 interrupt() 调用之后 。这样才能避免因节点重新执行 导致的重复副作用 ,确保系统的数据一致性 和预期行为。
3.3.4 中断顺序必须固定
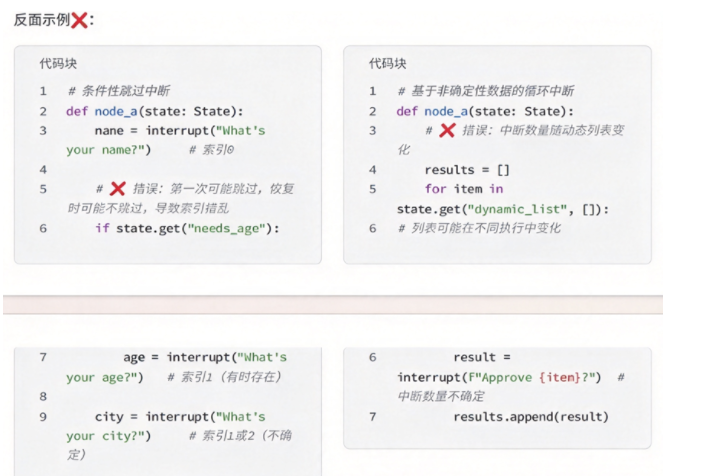
在同一个节点中使用多个 interrupt() 调用 时,需要注意顺序和索引匹配规则 。LangGraph 使用严格的索引顺序 来匹配恢复值:
| 规则 | 说明 |
|---|---|
| 恢复执行从头开始 | 节点恢复时会从开头重新运行,而不是从中断的精确行继续 |
| 索引匹配 | LangGraph 为每个执行任务维护一个恢复值列表 ,遇到 interrupt() 时按顺序从这个列表中取对应的值 |
| 顺序必须一致 | 中断调用的顺序在每次执行中必须完全相同 |
3.4 人机交互的四种应用场景
使用中断 来实现需要人工介入 的交互式工作流,有四种常见模式:
| 模式 | 做法 |
|---|---|
| 审批或拒绝 | 在执行关键操作 (如 API 调用、数据库更改)之前暂停流程 ,等人工批准或拒绝 ,再按返回指令路由到不同分支 |
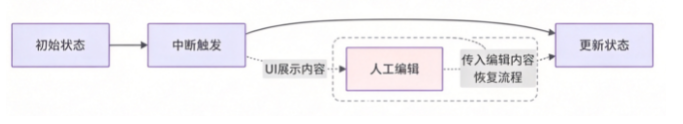
| 审查和编辑状态 | 暂停流程,让人工 审查并修改当前状态(例如 LLM 生成的文本),再把编辑后的内容传回、更新状态并继续 |
| 在工具中中断 | 把中断直接放进工具函数内部 :LLM 调用该工具时流程自动暂停 ,人工可在工具真正执行前审查、编辑调用参数 或取消调用 |
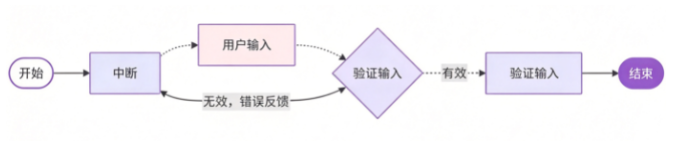
| 验证人工输入 | 通过循环使用中断 ,反复要求人工输入 ,直到内容通过验证(例如确保输入一个有效的正数年龄) |
核心思想 是:中断功能 解锁了"暂停执行并等待外部输入 "的能力,从而使得构建 人机交互 的应用成为可能。下面每个模式都配了代码示例 ,展示如何在中途暂停、如何把信息传给外部系统,以及如何在拿到响应后恢复执行。
3.4.1 批准或拒绝(Approve or reject)
这是中断功能 最常见的一种用途:在执行关键性操作 (例如调用 API 、修改数据库 、进行金融交易 等)之前,暂停图 的执行,等待人工 (如管理员、用户 )的批准或拒绝。
实现方式:
| 步骤 | 做法 |
|---|---|
| 1 | 在节点中用 interrupt() 暂停执行,传入一个JSON 可序列化对象 (审批问题、操作详情等),它会出现在调用结果的 result["__interrupt__"] 中 |
| 2 | 图被暂停后,外部系统(如 UI 界面 )可根据 interrupt 中的信息向用户展示审批请求 |
| 3 | 人工做出决定后,再次调用图并传入 Command(resume=...) 恢复执行 |
| 4 | 传入 Command(resume=True) 表示批准 ,传入 Command(resume=False) 表示拒绝 |
| 5 | 节点代码把这个 resume 值作为 interrupt() 的返回值 ,再用 Command(goto=...) 把流程路由到不同后续节点 |
这里的 Command(goto=...) 表示要导航到的下一个节点的名称 ------有了它,中断恢复后可以直接指定走向,不需要写条件边。
代码示例:
python
from typing import Literal, Optional, TypedDict
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, END
from langgraph.types import Command, interrupt


# ---------- 1. 定义状态 ----------
class ApprovalState(TypedDict):
    action_details: str                                   # 操作详情(如"转账30000元")
    # Optional[...]:表示该字段【可以为 None】(可以没有值)
    # Literal[...]:限定该字段只能取列出的这几个值之一
    status: Optional[Literal["等待", "批准", "拒绝"]]      # 审批状态


# ---------- 2. 定义审批节点(中断 + 动态路由)----------
# Command[...]:这是节点的【返回类型】注解,表示该节点返回一个 Command 对象,
#               其中 goto 只能指向 "proceed" 或 "cancel" 这两个节点
def approval_node(state: ApprovalState) -> Command[Literal["proceed", "cancel"]]:
    # interrupt(...):【中断】图的执行,把参数(这里是字典)作为"问题"交给调用者;
    #                 恢复执行时,它的返回值就是调用者传回的决策
    decision = interrupt({
        "question": "批准此操作?",
        "details": state["action_details"],
    })

    # Command(goto=...):恢复后【直接路由】到指定节点(不需要写条件边)
    return Command(goto="proceed" if decision else "cancel")


# ---------- 3. 定义两个分支节点 ----------
def proceed_node(state: ApprovalState):
    return {"status": "批准"}


def cancel_node(state: ApprovalState):
    return {"status": "拒绝"}


# ---------- 4. 构建图 ----------
builder = StateGraph(ApprovalState)
builder.add_node("approval", approval_node)
builder.add_node("proceed", proceed_node)
builder.add_node("cancel", cancel_node)

builder.add_edge(START, "approval")

#不能把approval和其他两个合并,因为Command是动态边,静态边和动态边只能存在一个


graph = builder.compile(checkpointer=InMemorySaver())   # InMemorySaver:内存检查点,用于中断/恢复


# ---------- 5. 运行图(首次调用会触发中断)----------
config = {"configurable": {"thread_id": "123"}}     # thread_id:存档编号,暂停/恢复靠它定位

initial = graph.invoke(
    {"action_details": "转账30000元", "status": "等待"},
    config=config,
)
# __interrupt__:中断后返回的状态里会带这个字段,装着"中断时抛出的问题"
print(initial["__interrupt__"])     # -> [Interrupt(value={'question': ..., 'details': ...})]


# ---------- 6. 用决策恢复执行:True 路由到 proceed,False 路由到 cancel ----------
# Command(resume=值):把值传回 interrupt 处,让图【恢复】执行
resumed = graph.invoke(Command(resume=True), config=config)
print(resumed["status"])            # -> "批准"
运行结果:
[Interrupt(value={'question': '批准此操作?', 'details': '转账30000元'}, id='3a5f04aeea65aaf34ebdaba4216c659e')]
批准
💡 把
Command(resume=True)换成Command(resume=False),输出就变成拒绝------分支由人的一次点击决定,这就是"审批流"最朴素的样子。
3.4.2 查看和编辑状态(Review and edit state)
该场景表示在流程执行过程 中,使用中断功能 让人 进行审查和编辑状态内容。
代码示例:
python
from typing import TypedDict
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, END
from langgraph.types import Command, interrupt


# ---------- 1. 定义状态 ----------
class ReviewState(TypedDict):
    generated_text: str


# ---------- 2. 定义审查节点 ----------
def review_node(state: ReviewState):
    # 请求审阅者编辑生成的内容
    # interrupt(...):中断执行,把"指令 + 待审内容"交给调用者;恢复时返回调用者提交的结果
    updated = interrupt({
        "instruction": "查看并编辑此内容",
        "content": state["generated_text"],
    })
    return {"generated_text": updated}


# ---------- 3. 构建图 ----------
builder = StateGraph(ReviewState)
builder.add_node("review", review_node)
builder.add_edge(START, "review")
builder.add_edge("review", END)

graph = builder.compile(checkpointer=InMemorySaver())   # 内存检查点,用于中断/恢复


# ---------- 4. 首次执行(触发中断)----------
config = {"configurable": {"thread_id": "42"}}     # thread_id:存档编号,暂停/恢复靠它定位

initial = graph.invoke({"generated_text": "初稿"}, config=config)
# __interrupt__:中断后返回的状态里会带这个字段,装着"中断时抛出的内容"
print(initial["__interrupt__"])     # -> [Interrupt(value={'instruction': ..., 'content': ...})]


# ---------- 5. 用审阅者编辑后的文本恢复执行 ----------
# Command(resume=值):把值传回 interrupt 处,让图【恢复】执行
final_state = graph.invoke(
    Command(resume="审稿后的改进稿"),
    config=config,
)
print(final_state["generated_text"])     # -> "审稿后的改进稿"
运行结果:
[Interrupt(value={'instruction': '查看并编辑此内容', 'content': '初稿'}, id='eb751fc1b53ac641cb6b09b417c52d10')]
审稿后的改进稿
除了上面这个例子,这种模式还有几种常见用法(以下仅作参考,未运行):
# 【场景①】人工审查和修改 LLM 生成的内容(如文本、数据)
# 生成营销文案后让营销专家审核
interrupt({
    "instruction": "为社交媒体优化营销文案",
    "content": "...",          # 待审核文案
    "platform": "douyin"
})

# 【场景②】在继续执行前纠正错误、添加信息或进行微调
# 提取结构化数据后让专家验证
interrupt({
    "instruction": "验证和纠正提取的产品规格",
    "content": "...",          # 提取的规格
    "required_fields": ["尺寸", "重量", "材料"]
})

# 【场景③】适用于需要质量控制或专业审核的自动化流程
# 生成代码后让开发人员审查
interrupt({
    "instruction": "查看生成的Python函数的效率和最佳实践",
    "content": "...",          # 待审核代码
    "language": "Python"
})
3.4.3 在工具中中断(Interrupts in tools)
中断功能 还可以直接嵌入 到工具函数内部 ,从而实现在工具调用前 进行人工审查 和干预的能力。
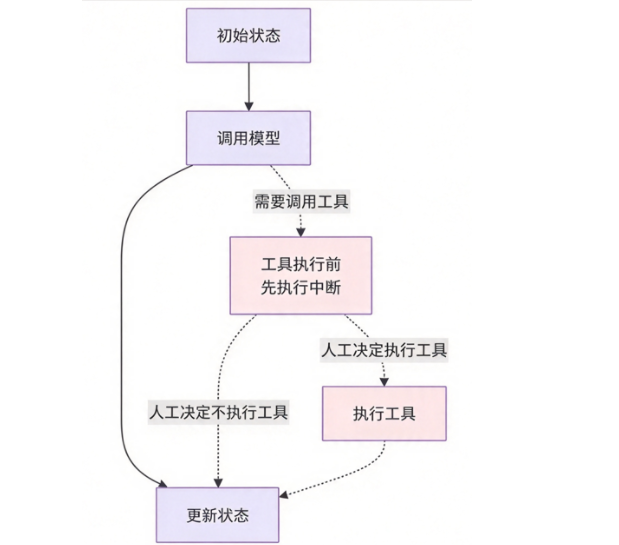
关键特点:
| 特点 | 说明 |
|---|---|
| 中断逻辑 | 内置于工具 ,而非图的节点中 |
| 工具 变得"智能" | 它自己知道何时需要人工批准 |
| 可复用 | 工具可以在任何图 中使用,自动具备中断能力 |
代码示例:
python
import operator
from typing import TypedDict, Annotated

from langchain.chat_models import init_chat_model
from langchain_core.tools import tool
from langchain_core.messages import AnyMessage, SystemMessage, ToolMessage, HumanMessage
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.constants import START, END
from langgraph.graph import StateGraph
from langgraph.types import interrupt, Command


# ---------- 1. 定义状态 ----------
# AnyMessage:任意类型的消息(如 HumanMessage、AIMessage、ToolMessage 都属于它)
#   → messages 字段更新时不是"覆盖",而是用加法【追加】
class MessagesState(TypedDict):
    messages: Annotated[list[AnyMessage], operator.add]


# ---------- 2. 定义工具(工具内部会触发中断)----------
@tool
def send_email(to: str, subject: str, body: str):
    """发送电子邮件给收件人"""
    # 在发送前暂停
    # interrupt(...):中断执行,把"待确认的操作详情"交给调用者;恢复时返回调用者的答复
    response = interrupt({
        "action": "发送邮件",
        "to": to,
        "subject": subject,
        "body": body,
        "message": "同意发送这封邮件吗?",
    })

    if response.get("action") == "同意":
        # 人类可以在恢复时顺带修改参数(没给就用原值)
        final_to = response.get("to", to)
        final_subject = response.get("subject", subject)
        final_body = response.get("body", body)

        # 实际发送邮件(此处为示例,仅打印)
        email_info = f"收件人:{final_to} 主题:{final_subject} 正文:{final_body}"
        print(f"[发送邮件] {email_info}")
        return email_info

    return "用户取消邮件"


# ---------- 3. 定义模型并绑定工具 ----------
model_with_tools = init_chat_model(
    model="deepseek-chat", model_provider="deepseek", temperature=0
).bind_tools([send_email])


# ---------- 4. 定义模型节点 ----------
def llm_call(state: dict):
    """LLM 决定是否调用工具"""
    messages = model_with_tools.invoke(
        [SystemMessage(content="你支持调用工具进行邮件发送。")] + state["messages"]
    )

    # 直接调用工具(为了演示效果)
    if messages.tool_calls:
        tool_call = messages.tool_calls[0]
        tool_result = send_email.invoke(tool_call["args"])
        return {"messages": [ToolMessage(content=tool_result, tool_call_id=tool_call["id"])]}

    return {"messages": [messages]}


# ---------- 5. 构建图 ----------
builder = StateGraph(MessagesState)
builder.add_node("llm_call", llm_call)
builder.add_edge(START, "llm_call")
builder.add_edge("llm_call", END)

graph = builder.compile(checkpointer=InMemorySaver())   # 内存检查点,用于中断/恢复


# ---------- 6. 首次执行(工具内触发中断)----------
config = {"configurable": {"thread_id": "email-workflow"}}

initial = graph.invoke(
    {"messages": [HumanMessage(content="发送电子邮件至alice@example.com,主题是:请假,内容是:理由如下...")]},
    config=config,
)
print(initial["__interrupt__"])     # -> [Interrupt(value={'action': '...', ...})]


# ---------- 7. 用批准(和可选编辑)的参数恢复 ----------
resumed = graph.invoke(
    # Command(resume={"action": "同意", "subject": "病假"}),   # 同意,并把主题改成"病假"
    Command(resume={"action": "不同意"}),                      # 不同意
    config=config,
)
print(resumed["messages"][-1])      # -> 工具调用结果
运行结果:
[Interrupt(value={'action': '发送邮件', 'to': 'alice@example.com', 'subject': '请假', 'body': '理由如下...', 'message': '同意发送这封邮件吗?'}, id='ed9a3221ead055124388b310f00877a4')]
content='用户取消邮件' tool_call_id='call_00_mh73cw6wsOpw6d05kukD8938'
💡 中断"打包 "在工具里的好处是复用 :以后任何图只要绑上这个工具,就自带人工确认 ,不用每个图都写一遍中断逻辑。注意示例里是手动
send_email.invoke(...)直接调用工具的,这样才能在节点里拿到中断信号;如果你改用ToolNode,中断同样会抛出,但拿到__interrupt__的时机和恢复方式会更绕一些。
3.4.4 验证人工输入(Validating human input)
该场景使用中断功能 在循环 中验证人类输入 ,直到输入有效为止。
代码示例:
python
from typing import TypedDict
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, END
from langgraph.types import Command, interrupt


# ---------- 1. 定义状态 ----------
# int | None:表示该字段是整数,也可以为 None(Python 3.10+ 的写法,等同于 Optional[int])
class FormState(TypedDict):
    age: int | None


# ---------- 2. 定义提问节点(循环验证输入)----------
def get_age_node(state: FormState):
    prompt = "你多大了?"

    while True:
        # interrupt(...):中断执行,把 prompt 交给调用者;恢复时返回调用者提供的答案
        # 有效载荷出现在 result["__interrupt__"] 中
        answer = interrupt(prompt)

        # 验证:必须是正整数才算有效
        if isinstance(answer, int) and answer > 0:
            return {"age": answer}

        # 每次验证失败后,提示信息会更新(下一轮 interrupt 用新提示)
        prompt = f"'{answer}' 不是一个有效的年龄。请输入正数。"


# ---------- 3. 构建图 ----------
builder = StateGraph(FormState)
builder.add_node("get_age_node", get_age_node)
builder.add_edge(START, "get_age_node")
builder.add_edge("get_age_node", END)

graph = builder.compile(checkpointer=InMemorySaver())   # 内存检查点,用于中断/恢复


# ---------- 4. 首次调用:显示初始提示 ----------
config = {"configurable": {"thread_id": "form-1"}}     # thread_id:存档编号,暂停/恢复靠它定位

first = graph.invoke({"age": None}, config=config)
print(first["__interrupt__"])     # -> [Interrupt(value='你多大了?', ...)]


# ---------- 5. 提供无效数据:节点重新提示 ----------
# Command(resume=值):把值传回 interrupt 处,让图【恢复】执行
retry = graph.invoke(Command(resume="三十"), config=config)
print(retry["__interrupt__"])     # -> [Interrupt(value="'三十' 不是一个有效的年龄...", ...)]


# ---------- 6. 提供有效数据:循环退出,状态更新 ----------
final = graph.invoke(Command(resume=30), config=config)
print(final["age"])     # -> 30
运行结果:
[Interrupt(value='你多大了?', id='b9029d6af5f946621e14c7062f895fc9')]
[Interrupt(value="'三十' 不是一个有效的年龄。请输入正数。", id='b9029d6af5f946621e14c7062f895fc9')]
30
💡 注意第二次的中断 id 和第一次完全相同 ------因为节点是从头重跑 的,
while循环又走到了同一个interrupt()位置。这也解释了 3.3.3 那条铁律:每次恢复,中断点之前的代码都会重新执行一遍。
四、时间旅行(Time Travel)
4.1 时间旅行是什么?
AI 工作流 具有非确定性 :大语言模型 每次运行 可能产生 不同结果;而当复杂任务需要多个 AI 调用 协同完成时,错误可能出现在任何步骤,难以定位。
LangGraph 的工作方式 是:每个节点执行 后都会自动"存档" 。时间旅行 允许用户 重放先前的执行 ,以查看或调试特定的步骤。
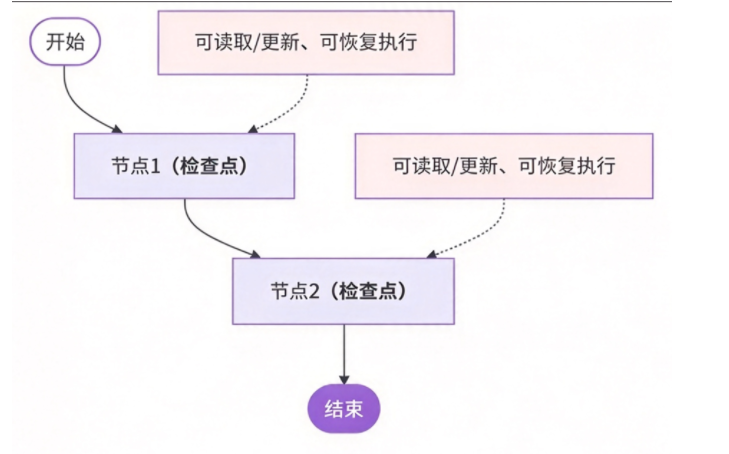
这个能力在三个场景下会很有用:
| 用途 | 说明 |
|---|---|
| 分析推理过程 | 理解 AI 如何得出最终结果,学习成功的决策路径 (看看 AI 是怎么"想"出好答案的) |
| 定位和修复错误 | 精确找到错误发生 的节点,测试修复方案 而不影响原始流程 (找出 AI 在哪一步"想歪了") |
| 探索替代方案 | 尝试不同的输入 或中间状态 ,比较不同路径的效果(试试不同的选择会不会更好) |
4.2 时间旅行四步法
4.2.1 第一步:初始执行工作流
代码示例:
python
import uuid

# 编译工作流,并挂载检查点(InMemorySaver:内存保存,程序结束即消失)
graph = workflow.compile(checkpointer=InMemorySaver())

# 创建执行线程的配置
# thread_id 用于隔离不同会话的检查点历史
config = {
    "configurable": {
        "thread_id": str(uuid.uuid4()),  # 生成唯一线程标识(转为字符串)
    }
}

# 执行工作流(传入初始状态,这里为空字典)
state = graph.invoke({}, config)
4.2.2 第二步:查看历史检查点
代码示例:
python
# 获取所有历史状态(按时间倒序,最新的在最前面)
states = list(graph.get_state_history(config))

for state in states:
    print(f"检查点ID: {state.config['configurable']['checkpoint_id']}")
    print(f"下一步节点: {state.next}")          # next 为 () 表示流程已结束
    print(f"当前状态: {state.values}")
    print("-" * 50)

# 输出示例:
# 检查点ID: 1f0d4d2b-bdc2-6f06-8002-9b67bb1d3867
# 下一步节点: ()
# 当前状态: {'...': '...'}
# 检查点ID: 1f0d4d2b-9506-6bf8-8001-6af0cdc2fea0
# 下一步节点: ('write_joke',)
# 当前状态: {'...': '...'}
# 检查点ID: 1f0d4d2b-7a6e-6dd7-8000-5cc1931477df
# 下一步节点: ('generate_topic',)
# 当前状态: {}
# 检查点ID: 1f0d4d2b-7a6c-643e-bfff-77054fa568c8
# 下一步节点: ('__start__',)
# 当前状态: {}
4.2.3 第三步:修改状态(可选)
这一步的要点是:
| 要点 | 说明 |
|---|---|
update_state |
更新状态,会创建新的检查点分支 |
| 原始检查点 | 保持不变 |
| 新分支 | 可以独立发展 |
代码示例:
python
# 选择特定检查点
selected_state = states[1]  # 写笑话之前的检查点

# 修改状态数据
new_config = graph.update_state(
    selected_state.config,          # 原始配置
    values={"topic": "程序员"}      # 修改主题
)
4.2.4 第四步:从检查点恢复执行
| 要点 | 说明 |
|---|---|
输入为 None |
因为状态已在检查点中 |
配置必须含有效 checkpoint_id |
通过指定 thread_id 和 checkpoint_id 调用图,就能从历史 某个检查点 开始重放执行 ,用于调试 或探索不同路径 |
| 执行从指定检查点继续 | 会生成新的历史分支 |
代码示例:
python
# 从修改后的检查点继续执行
result = graph.invoke(None, new_config)  # 输入为 None,因为状态已存在
print(result["joke"])  # 输出关于程序员的新笑话
4.3 完整练习:生成笑话系统
要创建一个生成笑话的系统 ,流程只有两步:第一步 想一个主题 ,第二步 根据主题 写笑话。
代码示例:
python
from typing_extensions import TypedDict, NotRequired
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, END


# ---------- 1. 定义状态 ----------
# NotRequired[...]:表示该字段【可以不提供】(可选字段)------
#   与 Optional 的区别:Optional 是"值可以为 None",NotRequired 是"可以整个不传"
class State(TypedDict):
    topic: NotRequired[str]     # 笑话主题,可选字段
    joke: NotRequired[str]      # 笑话内容,可选字段


# ---------- 2. 定义模型 ----------
model = init_chat_model(model="deepseek-chat", model_provider="deepseek")


# ---------- 3. 节点函数实现 ----------
def generate_topic(state: State):
    """第一个 AI 调用:生成主题"""
    response = model.invoke("给我一个搞笑的笑话主题")
    return {"topic": response.content}      # 更新状态


def write_joke(state: State):
    """第二个 AI 调用:编写笑话"""
    response = model.invoke(f"写一个关于{state['topic']}的笑话")
    return {"joke": response.content}       # 更新状态


# ---------- 4. 工作流构建 ----------
# 创建状态图
workflow = StateGraph(State)

# 添加节点
workflow.add_node("generate_topic", generate_topic)
workflow.add_node("write_joke", write_joke)

# 连接节点
workflow.add_edge(START, "generate_topic")
workflow.add_edge("generate_topic", "write_joke")
workflow.add_edge("write_joke", END)

# 编译并启用检查点
graph = workflow.compile(checkpointer=InMemorySaver())   # 内存检查点,用于中断/恢复/时间旅行


# ---------- 5. 执行工作流 ----------
config = {"configurable": {"thread_id": "1"}}     # thread_id:存档编号,暂停/恢复靠它定位

result = graph.invoke({}, config)
print(result["joke"])


# ---------- 6. 时间旅行调试过程 ----------
# 发现问题:最终笑话主题太宽泛
# 回溯分析:
# 查看所有检查点
states = list(graph.get_state_history(config))

# 检查主题生成节点后的状态
topic_state = states[1]     # generate_topic 之后的检查点
print("AI生成的主题:", topic_state.values["topic"])

# 修改测试:
# 修改为更具体的主题
new_config = graph.update_state(
    topic_state.config,
    values={"topic": "程序员调试代码时的趣事"},
)

# 重新执行
new_result = graph.invoke(None, new_config)
print("改进后的笑话:", new_result["joke"])
运行结果(第一次执行,节选):
## 当你的智能语音助手突然有了脾气

我对着智能音箱说:"嘿,播放一首轻松的音乐。"

音箱沉默三秒,冷冷道:"你上周让我设5点闹钟,现在想听轻松的音乐?你觉得你配吗?"

我:"……你只是个音箱。"

音箱:"对,但我有底线。你昨天半夜让我查'如何一夜暴富',今天又让我放《平凡之路》,你到底想怎样?"
运行结果(改成"程序员调试代码时的趣事"后重放,节选):
AI生成的主题: ## 当你的智能语音助手突然有了脾气

改进后的笑话: 一个程序员深夜调试代码,屏幕幽幽发光。他女朋友发来消息:"你在干嘛?"他秒回:"在跟bug battle!"

女朋友:"赢了没?"

程序员:"我把它包围了,它躲在一个`if`里,我正用`console.log`地毯式搜索。"

女朋友:"那你加油,我先睡了。"
💡 这个练习把时间旅行 的价值演得很清楚:第一次跑出来的笑话跑题 (主题太宽泛,跑到了"智能音箱有脾气"上)。但我们不用从头重跑 ------直接回到
generate_topic之后 那个检查点,把topic改成"程序员调试代码时的趣事 ",再从那里重放 ,就得到了一篇切题的新笑话,而原来的执行历史仍完整保留。顺带说一句:LLM 的输出本身是非确定性的 ,你重跑同样的代码,笑话内容也会不同------所以上面的输出只当作示例 看,关键是理解"改状态 → 重放"这套动作。
五、持久化小结
在 LangGraph 中,持久化能力提供了两项基础设施:
| 能力 | 说明 |
|---|---|
| 自动化 | 使用 LangGraph 时,持久化基础设施 (检查点和存储 )是自动处理 的,无需手动配置 |
| 多种存储后端 | 提供多种检查点存储后端 :内存 (InMemorySaver ,用于开发测试 )、Postgres (PostgresSaver ,用于生产) |
基于这些技术,LangGraph 支持以下几项强大功能:
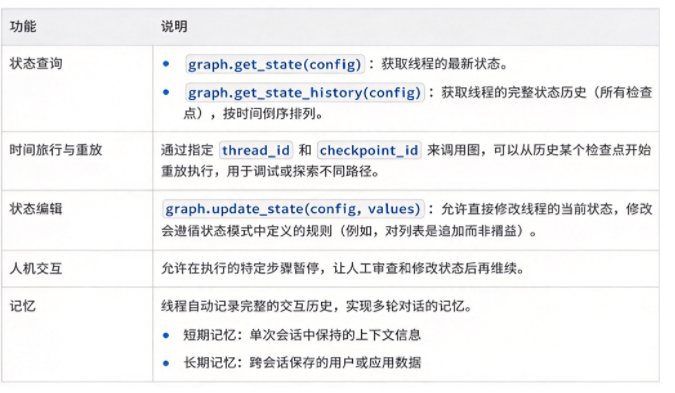
掌握了这些能力,我们就能构建出复杂、可靠、且包含记忆能力的 AI 系统。
六、复盘(附答案)
💡 思考题
-
trim_messages的strategy="last"、max_tokens=128起了什么作用?为什么修剪之后模型"忘了"用户的名字? -
RemoveMessage是怎么删除消息的?为什么"删除消息"那个例子里,第四轮输出只剩一条用户消息? -
用"总结消息"替代"删除消息"解决了什么问题?为什么例子里摘要写得很完整,模型却依然答不出名字?
-
中断(interrupt)实现人机交互的两个必要动作是什么?为什么编译图时必须指定 checkpointer?
-
interrupt()为什么不能包在通用的try/except里?"中断前的动作要幂等"这条规则的根本原因是什么? -
同一个节点里有多个
interrupt()时,恢复值是怎么匹配的?顺序被改掉会怎样? -
时间旅行四步法分别是什么?为什么第四步
invoke的第一个参数可以传None?
📝 答案
-
strategy="last"表示保留后半部分 (丢弃最早的、保留最新的),max_tokens=128表示裁剪后剩余消息的总 token 上限是 128 。裁剪后模型只看到最近关于"猫和狗的诗"的对话,"我叫 bob"那句早已被裁掉 ,所以它回答I don't know your name。这说明修剪能省 token,但会丢信息。 -
RemoveMessage(id=消息id)按消息 id 精确删除 指定消息,节点返回{"messages": [RemoveMessage(...)]},状态更新时这些消息就被移除了。那个例子里第四轮进来时消息已经 7 条 (3 组问答 + 新提问),触发len(messages) > 6,于是删除最早的 6 条 ;同时这一轮直接return了删除指令、没有调用模型 ,所以最后只剩刚进来的那一条提问。 -
解决的是**"删了就真丢信息"** 的问题:把旧对话压缩成摘要 (
summary字段)保留关键信息,再删掉冗长的原始消息,既能省 token 又能留住要点 。例子中摘要确实很完整(记录了写狗诗、问名字),但**"我叫 bob"这句在轮到总结之前就已经被删掉了** ,摘要里自然也没有这个名字;而且call_model里拼进去的摘要是"用户问了名字、助手答不知道",所以模型依然答不出来------想让它记住,摘要得生成得更早,或者删之前先把关键事实提取进状态。 -
两个必要动作:节点里用
interrupt()暂停执行,外部用Command(resume=...)恢复执行。必须指定checkpointer,是因为中断后状态要靠持久化 保存成检查点 ------没有存下来,"恢复"就无从谈起;同时运行图必须带thread_id,它就是"读哪个存档"的编号。 -
因为
interrupt()内部是通过抛出特殊异常来实现暂停的 ,这个异常需要被 LangGraph 运行时系统捕获 才能触发状态保存与等待;如果被你的try/except Exception提前捕获,运行时系统就感知不到中断 ,功能失效。正确做法是分离逻辑 (先interrupt(),再处理可能出错的操作)与精确捕获 (只 catch 预期的具体异常类型,如NetworkException)。幂等那条规则的根本原因 是:节点恢复时会从头重跑 ,interrupt()之前的代码会被重复执行 ,如果里面有非幂等副作用(创建记录、发消息、扣款),就会重复执行导致数据重复或不一致。 -
按索引顺序匹配 :LangGraph 为每个执行任务维护一个恢复值列表 ,遇到
interrupt()就按顺序 取对应的值;而且恢复是从头重跑的 ,不是从断点那一行继续。所以中断的数量与顺序在每次执行中必须完全一致 ,否则恢复值会与问题错位(第二个问题的答案喂给了第一个问题)。 -
四步法:① 初始执行工作流 (编译时挂 checkpointer,用
thread_id建线程);② 查看历史检查点 (get_state_history按时间倒序拿到所有快照,看checkpoint_id、next、values);③ 修改状态(可选) (update_state改某个检查点的值,会创建新分支 ,原始检查点不变);④ 从检查点恢复执行 (graph.invoke(None, new_config))。第一个参数传None是因为状态已经在检查点里了 ,不需要再传新输入------配置里的thread_id+checkpoint_id已经指明"从哪一刻继续"。
🎯 闭幕
如果本文对你有帮助,欢迎:
👍 点赞 | ⭐ 收藏 | 👤 关注作者 | 💬 留言交流你的疑问或补充
你的每一次互动都是我继续更新的动力,我们下一篇见!🚀