上一篇我们跑通了 MiniMax H3 的文生视频(没看过的可以翻我主页)。但实际创作里更常用的其实是图生视频 :手里已经有一张满意的图------AI 生成的成图、自己拍的照片、上一步视频的某一帧------让它动起来、配上声音。H3 的 i2v 模式正是干这个的:首帧严格锚定你的输入图,然后延续出 5 秒带立体声音轨的动态画面。
本篇实测:拿上一篇文生视频成片里的一帧(奔跑者+反乌托邦城市)作为输入,12G 显存的 4070 Ti 上 5 分 38 秒 出片。模型与上一篇完全相同、零新增下载------看过上篇的你直接跳到第三节开跑。
一、效果先看
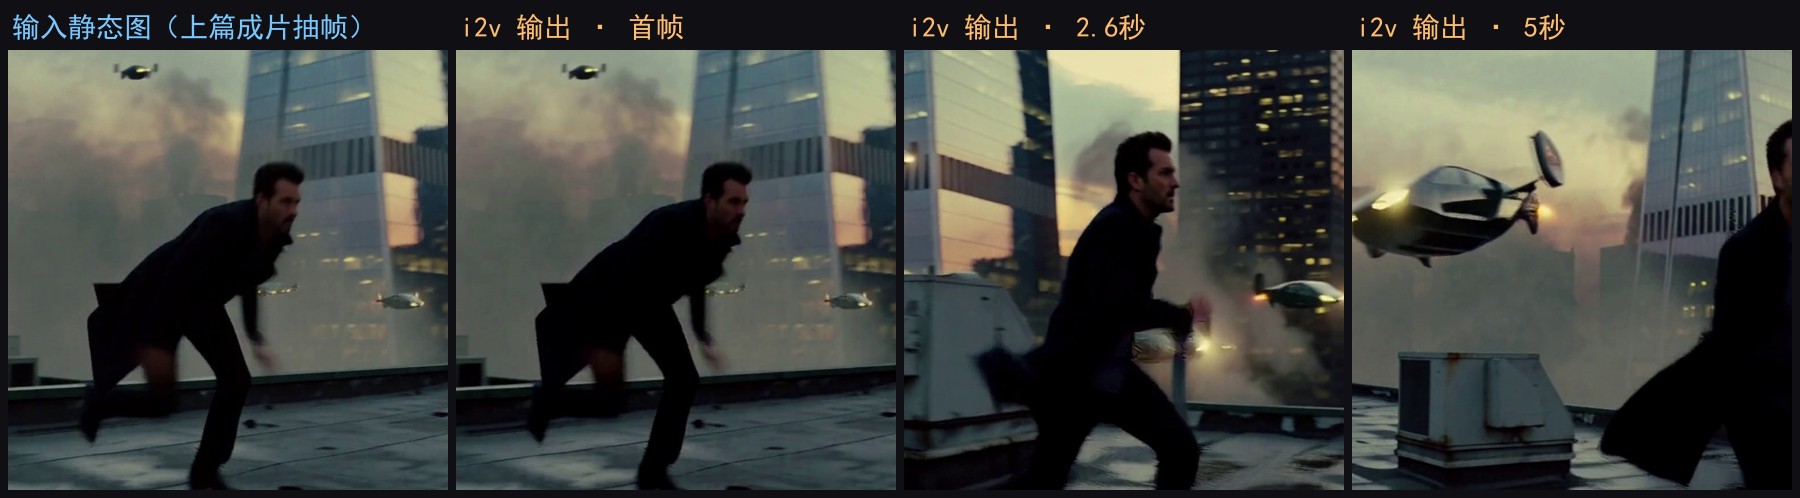
四联对比图从左到右:输入静态图 → 视频首帧 → 2.6 秒 → 5 秒。两个关键行为都成立:
- 首帧锚定:视频第一帧和输入图构图、人物姿态、场景元素高度一致(i2v 模式的核心承诺,实测没跑偏);
- 动态推进:人物奔跑姿势逐帧推进,背景飞行器下移、雾气流动,不是"画面微微抖动"式的假动态。
出片规格:1344×768、24fps、124 帧(5.17 秒)、自带立体声音轨(追逐低音配乐+湿 footsteps+飞行器掠过的引擎声,都写进提示词里让它生成)。turbo 8 步档全程 338 秒;模型加载被上一篇的运行缓存过,冷启动也就多 38 秒。
二、和文生视频的差异:只有一行
工作流结构上,i2v 和上篇的 t2v 只差一个输入:
| t2v(上篇) | i2v(本篇) | |
|---|---|---|
| 输入 | 纯文字提示词 | 提示词 + first_frame 输入图 |
| 节点 | 15 个 | 16 个(多一个 LoadImage) |
| 模型 | 完全相同的 5 个 | 同左,零新增 |
MiniMaxH3ImageToVideo 节点有个可选输入 first_frame,把 LoadImage 的图接进去就是图生视频;不接就是文生视频。首尾帧(first_frame + last_frame)都接则是官方模板里的 flf2v 玩法------给开头和结尾两张图,中间让模型自己补,适合做"转场"类镜头。
三、跑起来
模型准备(5 个,和上篇完全一致,没装过的按这里放):
| 模型文件 | 大小 | 放置目录 | 官方下载 | 网盘备份 |
|---|---|---|---|
| minimax_h3_fl2va_pruned_int8_convrot.safetensors | 21.0 GB | diffusion_models | 官方下载页 | 网盘下载 |
| qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 15.7 GB | text_encoders | 官方下载页 | 网盘下载 |
| minimax_h3_video_vae_int8_convrot.safetensors | 2.81 GB | vae | 官方下载页 | 网盘下载 |
| minimax_h3_audio_vae_fp32.safetensors | 0.61 GB | vae | 官方下载页 | 网盘下载 |
| minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors(加速可选) | 1.96 GB | loras | 官方下载页 | 网盘下载 |
官方 HuggingFace 国内可把链接里的 huggingface.co 换成 hf-mirror.com 直连;网盘是同一文件的备份,点开自动带提取码。
操作三步:
- 载入文末下载的工作流(官方原版或我摊平的 turbo API 版);
- 把你的图拖进 LoadImage(建议短边 768 以上的清晰图,横竖比尽量贴近 16:9,生成尺寸填 1344×768);
- 写提示词,点运行。
图生视频的提示词怎么写 :和 t2v 不同,i2v 的提示词不要描述画面长什么样(图已经定了),重点写"接下来发生什么":一段动作走向 + 镜头运动(Camera: 平移跟随/推拉摇移)+ Audio 段落描述声音。本篇实测用的结构:
画面延续总述:与输入图完全一致的写实调色、同一场景同一人物......

Scene overview: 人物保持全速奔跑并向画面右侧移动,身后的追兵逐渐逼近,一架飞行器低空掠过......

Camera: 与奔跑者同速的平移跟拍,胸部高度,步伐带轻微手持抖动,不切镜头。

Audio: 低音追逐配乐渐强、湿漉路面上的急促脚步、风声、远处警笛、飞行器引擎掠过的低频呼啸,最后一秒一个重音点。

No text, subtitles, logos or watermarks......
参数沿用上篇:res_multistep 采样器、simple 调度、denoise 1.0、124 帧/24fps、seed 固定。turbo LoRA 挂不挂随意,挂了 8 步出片,不挂 20 步细节更锐。
四、实测踩坑
1. 输入图的分辨率就是生成分辨率。 first_frame 锚定后,宽高参数要和输入图对齐(或等比),差距太大模型会在首帧"强行缩放",动态开场会抖。我的输入图就是 1344×768,参数原样填。
2. 上一段视频的抽帧是最好的输入图来源。 做续集/长镜头时,从上一段成片里抽一帧接着 i2v,画面无缝续接------本篇就是这么做的。抽帧用 ffmpeg 或随手截屏都行。
3. 静态构图太"平"的图不容易出好动态。 全是风景、没有明确运动主体的图,模型只能给你云在飘、树叶在摇。输入图里最好有姿态明确的主体(奔跑/伸手/回头),提示词再顺着它的姿势写动作方向。
4. 音频还是要靠提示词里的 Audio 段。 不写 Audio 段,出来的视频音轨会只有环境底噪;写了才有配乐和音效编排(H3 是画面和声音一次性联合生成的)。
五、下载汇总
工作流与成片(城通网盘,点击自动带提取码):
- minimax_h3_i2v_工作流.json(官方原版,需 ComfyUI v0.39+)
- minimax_h3_i2v_turbo_API.json(turbo 8 步摊平版)
- MiniMax_H3_i2v_00001_.mp4(本篇成片,含音轨)
模型文件见上面第三节的双链接表格(官方页 + 网盘备份各一条)。模型许可证按 MiniMax 官方仓库条款使用。
你手上有什么想让 它动起来的图?评论区丢上来,我挑几张跑给你看。