
【作者主页】Francek Chen
【专栏介绍】⌈ ⌈ ⌈大数据技术原理与应用 ⌋ ⌋ ⌋专栏系统介绍大数据的相关知识,分为大数据基础篇、大数据存储与管理篇、大数据处理与分析篇、大数据应用篇。内容包含大数据概述、大数据处理架构Hadoop、分布式文件系统HDFS、分布式数据库HBase、NoSQL数据库、云数据库、MapReduce、Hadoop再探讨、数据仓库Hive、Spark、流计算、Flink、图计算、数据可视化,以及大数据在互联网领域、生物医学领域的应用和大数据的其他应用。
【GitCode】专栏资源保存在我的GitCode仓库:https://gitcode.com/Morse_Chen/BigData_principle_application。
文章目录
Hive 的功能十分强大,可以支持采用 SQL 方式查询 Hadoop 平台上的数据。但是,在实际应用中,Hive 也暴露出不稳定的问题,在极少数情况下,甚至会出现端口不响应或者进程丢失的问题。Hive HA 的出现,就是为了解决这类问题。
Hive HA 基本原理如图1所示。在 Hive HA 中,在 Hadoop 集群上构建的数据仓库是由多个 Hive 实例进行管理的,这些 Hive 实例被纳入一个资源池中,并由 HAProxy 提供一个统一的对外接口。客户端的查询请求首先访问 HAProxy,由 HAProxy 对访问请求进行转发。HAProxy 收到请求后,会轮询资源池里可用的 Hive 实例,执行逻辑可用性测试。如果某个 Hive 实例逻辑可用,就会把客户端的访问请求转发到该 Hive 实例上,如果该 Hive 实例逻辑不可用,就把它放入黑名单,并继续从资源池中取出下一个 Hive 实例进行逻辑可用性测试。对于黑名单中的 Hive 实例,HiveHA 会每隔一段时间进行统一处理,首先尝试重启该 Hive 实例,如果重启成功,就再次把它放入资源池中。由于采用 HAProxy 提供统一的对外访问接口,因此,对于程序开发人员来说,可以把它当作一台超强"Hive"。
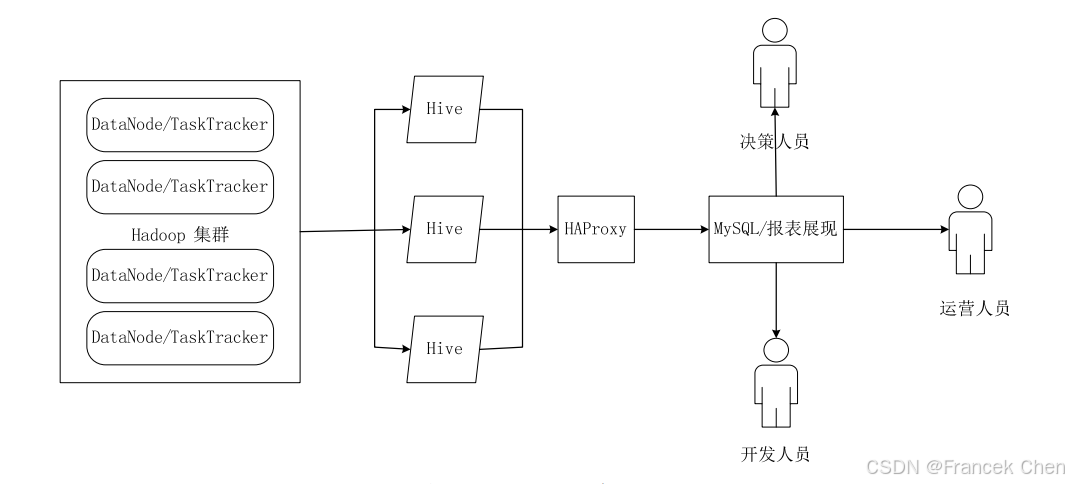
图1 Hive HA 基本原理
欢迎 点赞👍 | 收藏⭐ | 评论✍ | 关注🤗
