摘要
- 单点工具再强,也解决不了链路问题。 五个助手各做一件事,比一个助手做五件事更可靠------但前提是它们之间有字段级契约,而不是靠人复制粘贴。
- 风险不能只用 P0--P3。 金融场景必须 P(技术严重度)× M(资金影响)双维定级:支付页错别字是 P3M0,批量对账任务在日切窗口失败也是「不阻断」,但两者的资源投入完全不是一个量级。
- 结论必须带证据等级 L0--L3。 这是关住 AI 幻觉最有效的一条工程规则------L0/L1 的结论禁止进入定论。比在 Prompt 里写"请不要幻觉"有效一百倍。
- 数据动作必须有红线。 SQL 仅允许
SELECT + LIMIT + 时间边界,禁止任何 DDL/DML,这是金融行业不可让步的红线。 - 人的签字不可替代。 三道人工闸门:SQL 执行前确认、根因双签、资金类结论业务/财务确认。AI 提供结构化线索,责任必须由人承担。
- 目录建好只是开始。 能否长期活下来,取决于是否进了 Git、是否挂了 CI 校验、是否有驳回回流机制。
一、凌晨一点,我打开第五个对话窗口
那次排查一个「支付成功但订单未更新」的线上问题,小贾打开了五个不同的 AI 对话窗口。
第一个问 Bug 分析,第二个贴日志排查,第三个分析 SQL,第四个整理回归清单,第五个验证 Prompt 是否还稳定。
五个窗口,五种输入格式,五种输出风格。
排查到一半,小贾甚至记不清哪个结论是来自哪个窗口了。开发问我「日志方向是什么」,得翻回第二个窗口;Leader 问小贾「回归范围定了吗」,小贾得翻回第四个窗口。
单点提效的工具我都有了,但它们之间是割裂的。我需要的不是五个更聪明的助手,而是一个能把它们串起来的指挥系统。
今天把这套方案从架构到落地细节,完整拆给你看。
1.1 割裂状态的真实代价
「五个窗口」这件事本身,在测试场景里是效率损失;但在金融场景里,它的代价会被显著放大:
| 割裂表现 | 金融场景下被放大的真实代价 |
|---|---|
| 输出风格各写各的,难以横向对比 | 结论没有出处,审计问询时无法举证 |
| 环节间靠人肉复制粘贴 | 语义漂移导致根因误判 → 直接资金损失与差错考核 |
| 无数据动作约束 | SQL 误执行 → 生产账务数据被改写 |
| 风险口径各自理解 | 优先级排不出来 → 资源错配,真事故被 P3 文案挤掉 |
| 结论直接采信 | 幻觉根因写入缺陷单 → 修复方向跑偏,越改越坏 |
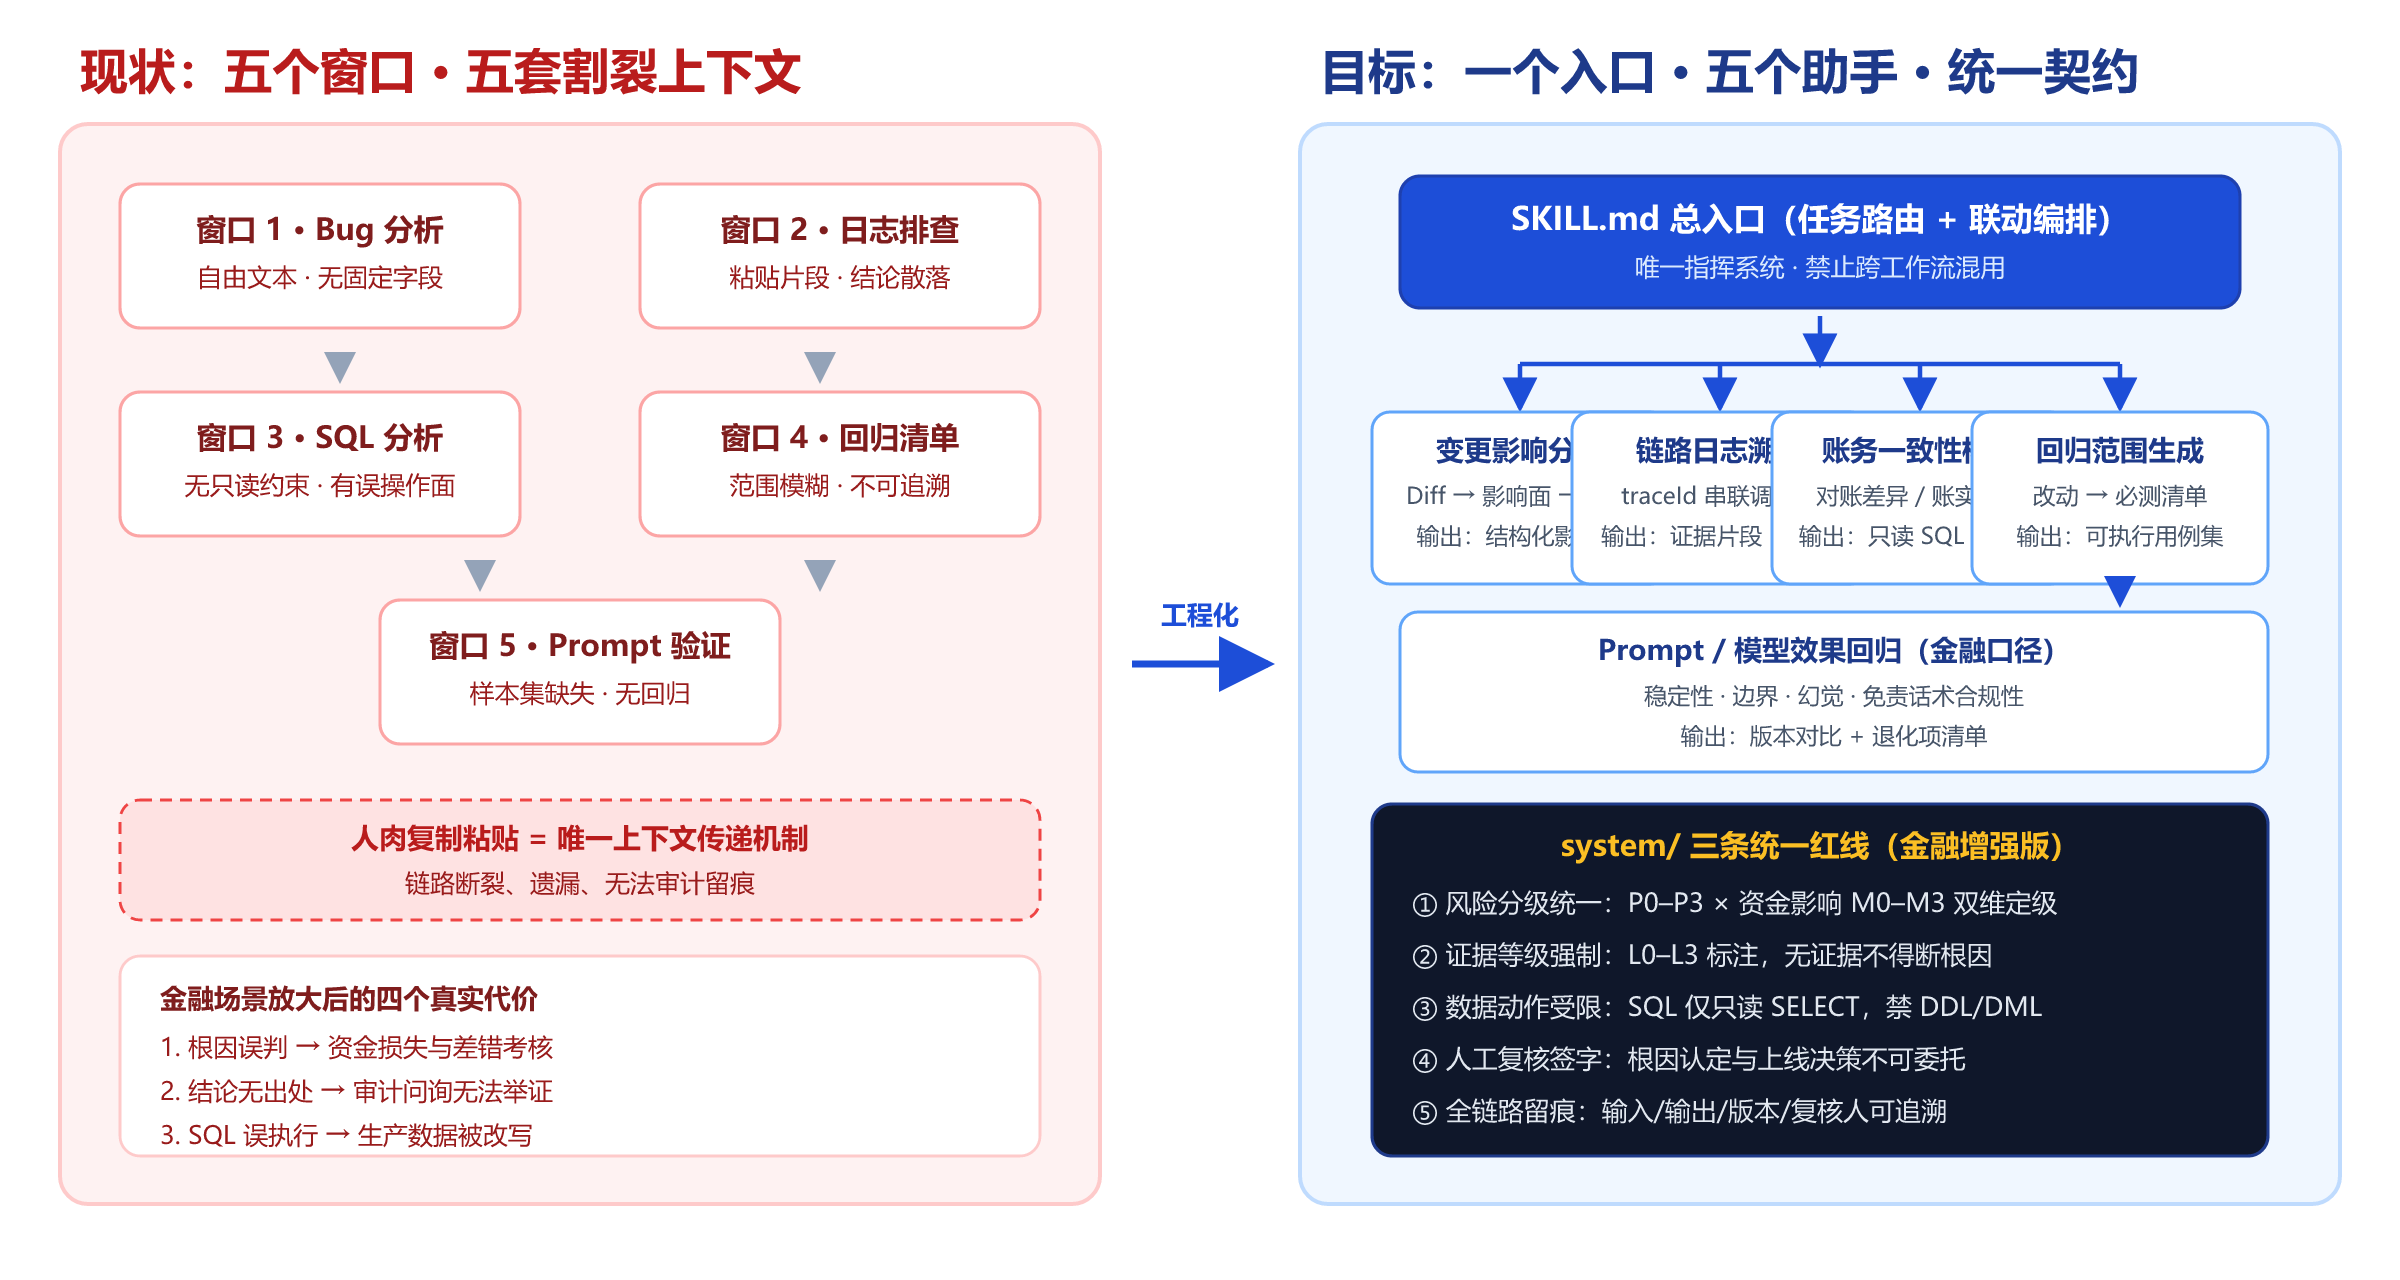
看图 1 左右两侧:左边每个窗口都是孤岛,靠「人肉复制粘贴」这一最脆弱的机制传递上下文;右边是一个入口 + 五个助手 + 统一红线。
右边的价值不只是效率,而是把"AI 的猜测"和"团队的事实"在制度层面隔离开了。
二、为什么「单工作流」一定不够
很多同学已经有若干专属 Prompt:一个生成用例的,一个分析 Bug 的,一个排查日志的。单独用每个都好用,但串起来用问题就暴露了。以下四个困境,在金融场景里的根因和后果都需要重新理解。
困境一:每次从零描述任务
表面上浪费的是"找 Prompt"的十几分钟;真正浪费的是每次重新描述都产生新的口径偏差------同一条交易链路,三个人描述出三个版本。偏差累积到第四次,就会做出三个不同的修复决策。
困境二:输出格式不统一
表面上是风格问题;本质是数据无法结构化。格式乱的输出机器读不了,机器读不了就无法参与自动化流转,也无法做趋势度量------你永远算不出"这个月 L3 结论占比是多少""复核驳回率是多少"。
困境三:难以团队协作
本质是知识资产没有资产化 。经验不该存在人脑里(人会走、会忘、会被覆盖),而该存在可评审、可版本化、可继承的仓库里。
困境四:联动全靠人肉
本质是接口没有定义 。人肉搬运等于"用自然语言做接口",而自然语言接口的必然结果是语义漂移------A 助手说"支付回调异常",B 助手理解成"订单状态异常",两个助手查两张表,最终谁也定位不到根因。
核心结论:单工作流解决"点"(一个任务做快一点),矩阵解决"面"(多个任务如何协同)。但要真的解决"面",光有矩阵不够,必须给矩阵装上"接口"。
三、六层架构:把行业经验焊进目录结构
整套体系的基础是一套标准化目录 + 依赖方向明确。依赖只能自上而下,禁止反向引用 ------workflows/ 可以读 system/ 的规则,但绝不允许在 workflows/ 里硬编码风险等级,否则改一次定级标准要改五个文件,三个月后必然出现五套口径。
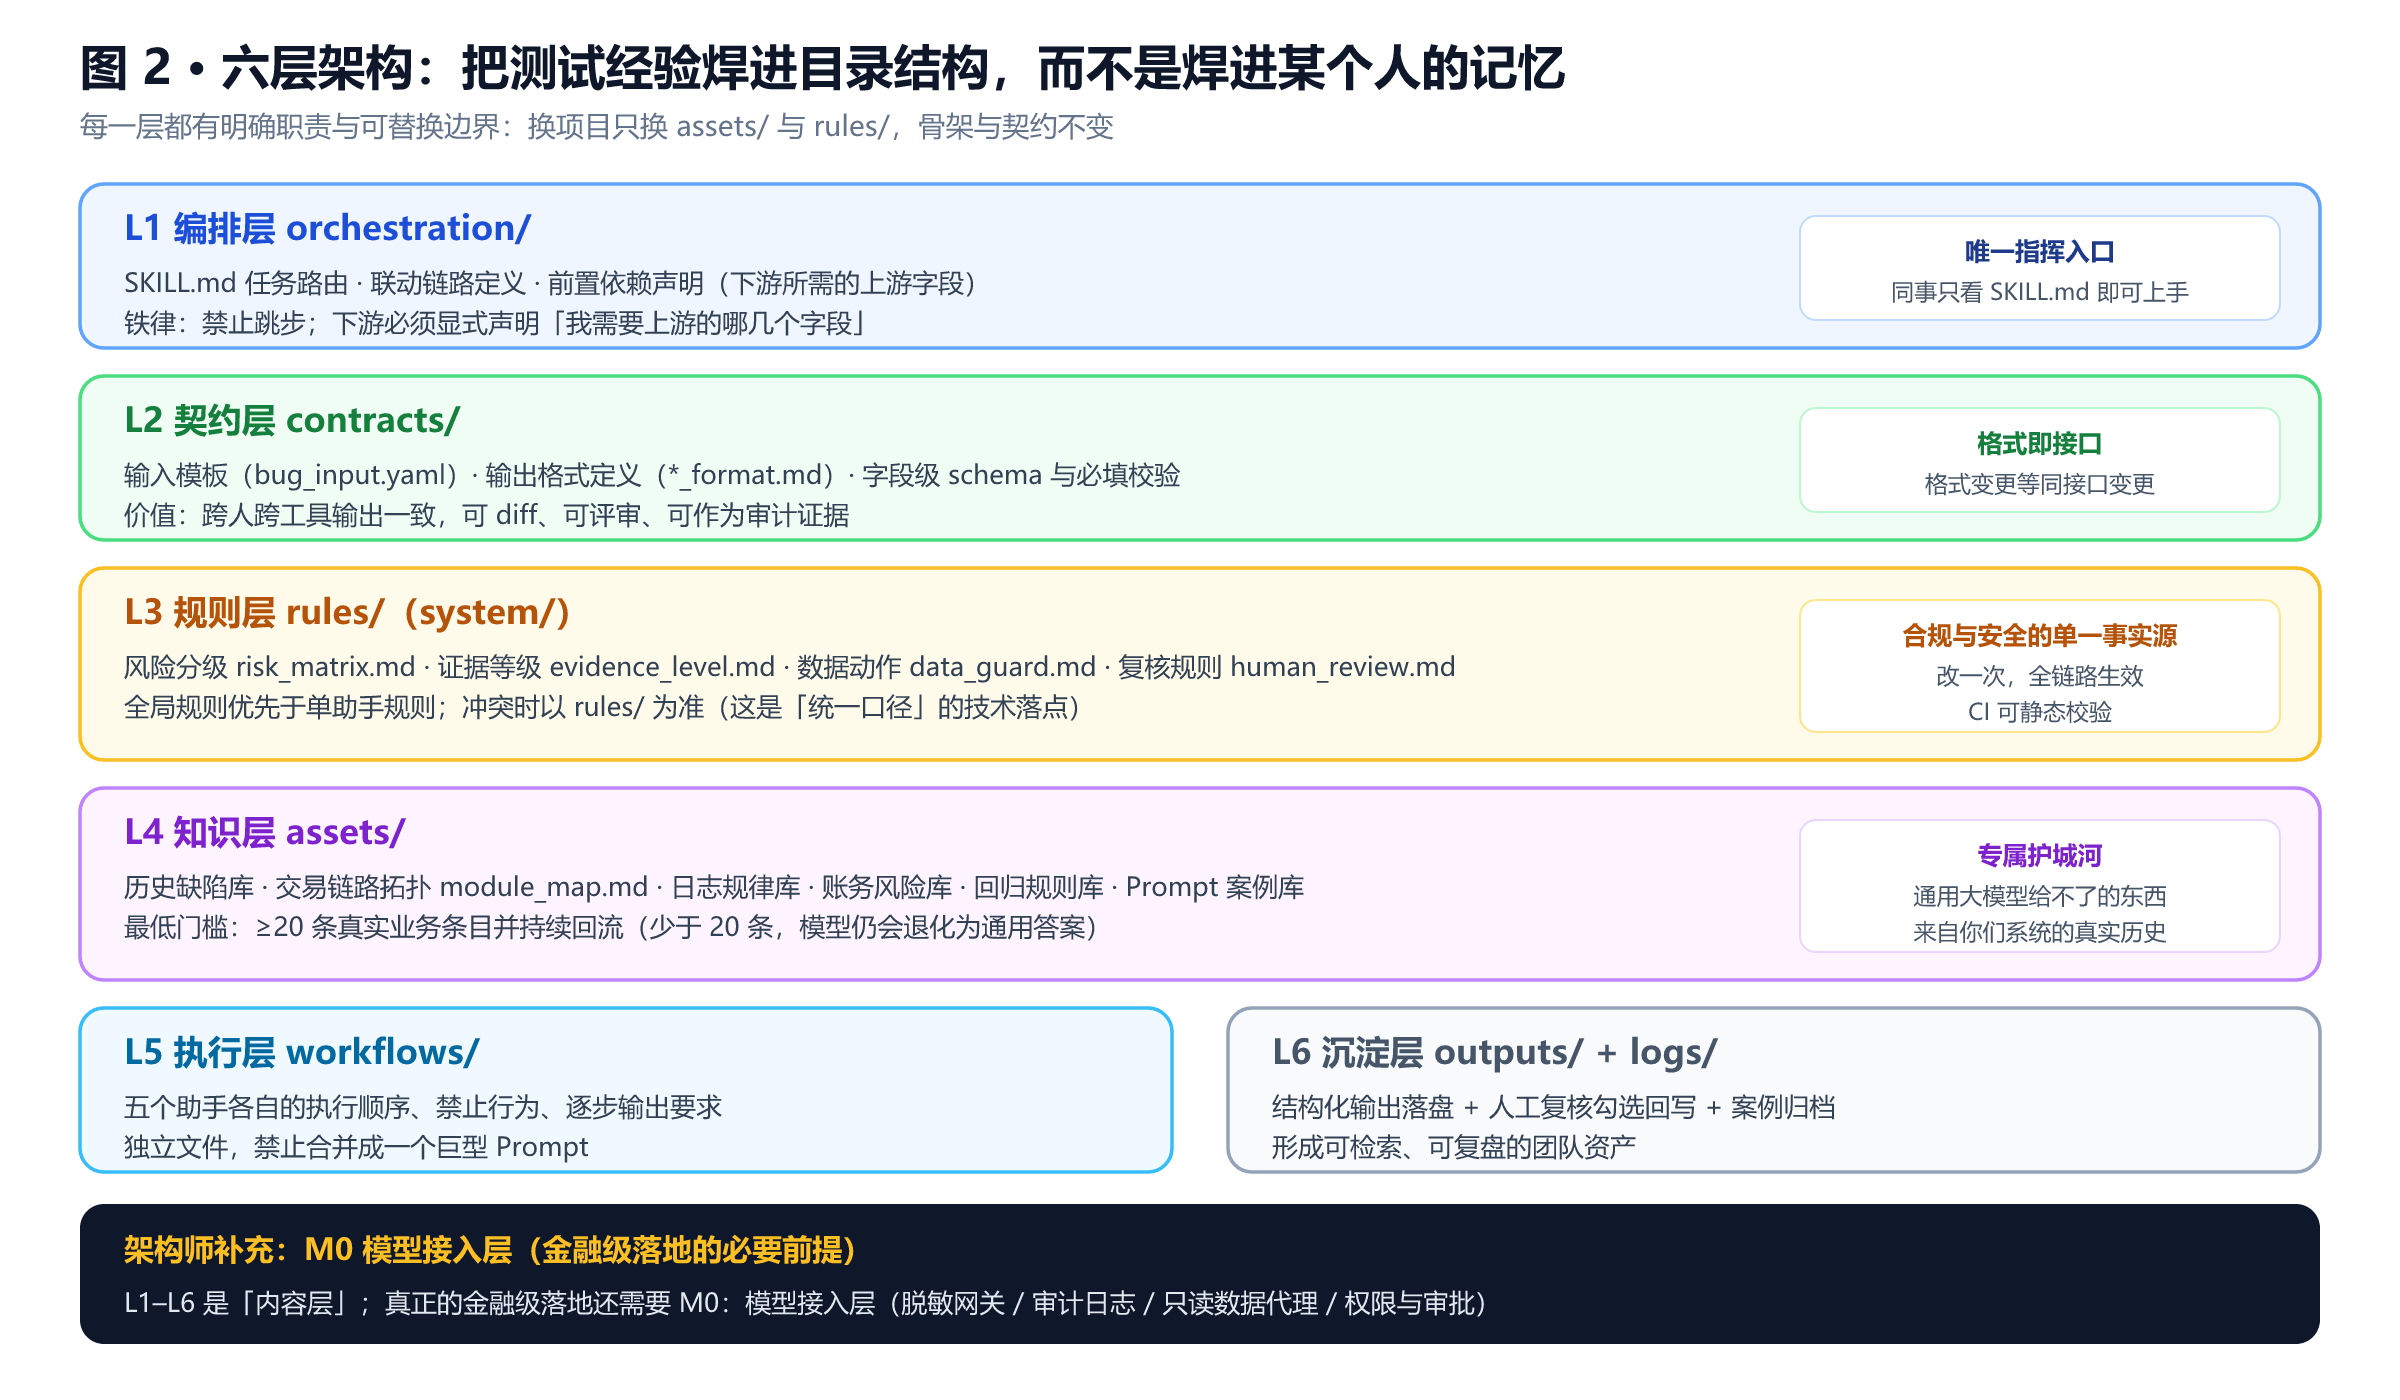
| 层 | 目录 | 职责 | 变更影响 | 评审要求 |
|---|---|---|---|---|
| L1 编排层 | orchestration/ |
SKILL.md:任务路由、联动链路、前置依赖声明 | 改路由 = 改全员工作方式 | code review + 团队通知 |
| L2 契约层 | contracts/ |
输入模板、输出 schema、必填校验 | 改字段 = 破坏下游兼容 | 版本号 + 变更记录 |
| L3 规则层 | system/ |
风险定级、证据等级、数据动作、复核规则 | 改规则 = 改制度 | 最高级别(等同制度变更) |
| L4 知识层 | assets/ |
历史缺陷、链路拓扑、日志规律、账务风险 | 只增不改(纠错除外) | 每月回流一次 |
| L5 执行层 | workflows/ |
五助手各自的执行顺序与禁止行为 | 改流程 = 改作业方式 | 常规 review |
| L6 沉淀层 | outputs/ reviews/ |
结构化输出、人工签字留痕 | 只写不改 | append-only,不可篡改 |
3.1 L1 编排层:唯一指挥入口
# 一键创建骨架
mkdir -p $TOOLBOX/{orchestration,system,contracts,workflows,prompts,assets,examples,outputs,reviews,ci}
touch $TOOLBOX/SKILL.md
SKILL.md 是整套体系的指挥入口,核心是一张任务路由表 + 一条联动链路:
# 核心交易测试 AI 协作矩阵 - 总入口

## 任务路由
- "分析缺陷 / 看这个 Bug"   → workflows/bug_analysis.md
- "排查日志 / 查 traceId"    → workflows/log_analysis.md
- "核查账务 / 对账差异"      → workflows/sql_analysis.md
- "定回归范围"              → workflows/regression.md
- "验证 Prompt / 模型效果"   → workflows/prompt_test.md

## 联动链路(完整缺陷需全流程时按序调用,禁止跳步)
变更影响分析 → 链路日志溯源 → 账务一致性核查 → 回归范围生成 → Prompt/模型回归(可选)

## 前置依赖声明
- B 必须消费 A 的 services / keywords 字段
- C 必须消费 A 的 tables 字段 + B 的主键取值范围
- D 必须消费 A 的影响模块 + C 的差异面
- E 必须消费 D 的回归清单作为样本集「前置依赖声明」是联动可靠的关键:它把"下游需要什么"从隐性假设变成显式契约,避免下游因缺字段而静默降级。
3.2 L3 规则层:四条不可让步的全局规则
规则层是全体系唯一事实源 ,全局规则优先于单助手规则,冲突时以 system/ 为准。
① 风险定级 risk_matrix.md ------ P×M 双维,详见第四节
② 证据等级 evidence_level.md
L0 仅假设     ------ 有现象无数据,只能作为"下一步排查方向"
L1 单点证据   ------ 单条日志 / 单个样本,不足以支撑结论
L2 交叉印证   ------ 日志与数据互相印证,可提交人工复核
L3 完整证据链 ------ 现象+链路+数据+可复现,可作为定论依据

硬性规则:任何助手的任何结论,都必须显式标注 L 等级。
L0/L1 结论禁止直接写入缺陷单根因栏、禁止作为修复依据。
③ 数据动作 data_guard.md
允许:SELECT ... LIMIT n(n ≤ 1000),必须带时间边界
禁止:任何 DDL / DML / UPDATE / DELETE / TRUNCATE
禁止:SELECT * 且无 LIMIT 的大表查询
禁止:输出未经脱敏的账号、卡号、手机号、证件号
禁止:给出"直接修复 SQL"(只给定位 SQL,修复由人执行)
查询结果行数 > 阈值时,提示并要求人工确认后继续
④ 人工复核 human_review.md ------ 不只写"需确认",要定义谁确认、确认什么、怎么留痕,详见第六节
3.3 L4 知识层:结构化比数量更重要
知识库的最低门槛是 ≥20 条真实业务条目。少于这个数,模型仍会退化成通用答案------那等于付出了全部工程成本,却拿不到任何专属收益。
| 阶段 | 条目数 | 效果 |
|---|---|---|
| 起步 | ≥ 20 条 | 覆盖高频场景,至少优于裸模型一个档 |
| 有效 | ≥ 100 条 | 在自己业务域内形成专属护城河 |
| 领先 | ≥ 500 条 + 持续回流 | 具备"经验资产"属性,人难替代 |
关键不是数量,是结构化。 每条资产必须标注:
# assets/ 的一条条目
模块: 支付回调
触发条件: 支付网关返回 SUCCESS 但 order-service 未更新状态
典型症状: 订单停留在 UNPAID,用户已扣款
判定标准: |
  1. 查 t_pay_order.pay_status = 'SUCCESS' AND order_status = 'UNPAID'
  2. 关联 t_account_entry 确认资金已入账
  3. 查 MQ 消费日志确认是否被限流丢弃
引用来源: INC-20260912-001(真实故障)
四、核心设计一:P×M 双维风险定级
只用 P0--P3 单维分级会漏掉一件事:「严重程度」和「涉及多少钱」在金融场景里是两个正交的问题,必须拆开评。
看两个例子:
- 支付页文案有个错别字 → 不阻断、无资金影响
- 批量对账任务在日切窗口失败 → 也不阻断、单笔交易都正常
单维 P 值下两者可能同级,但处置方式完全相反:前者改文案,后者要看财务关账与监管报送。
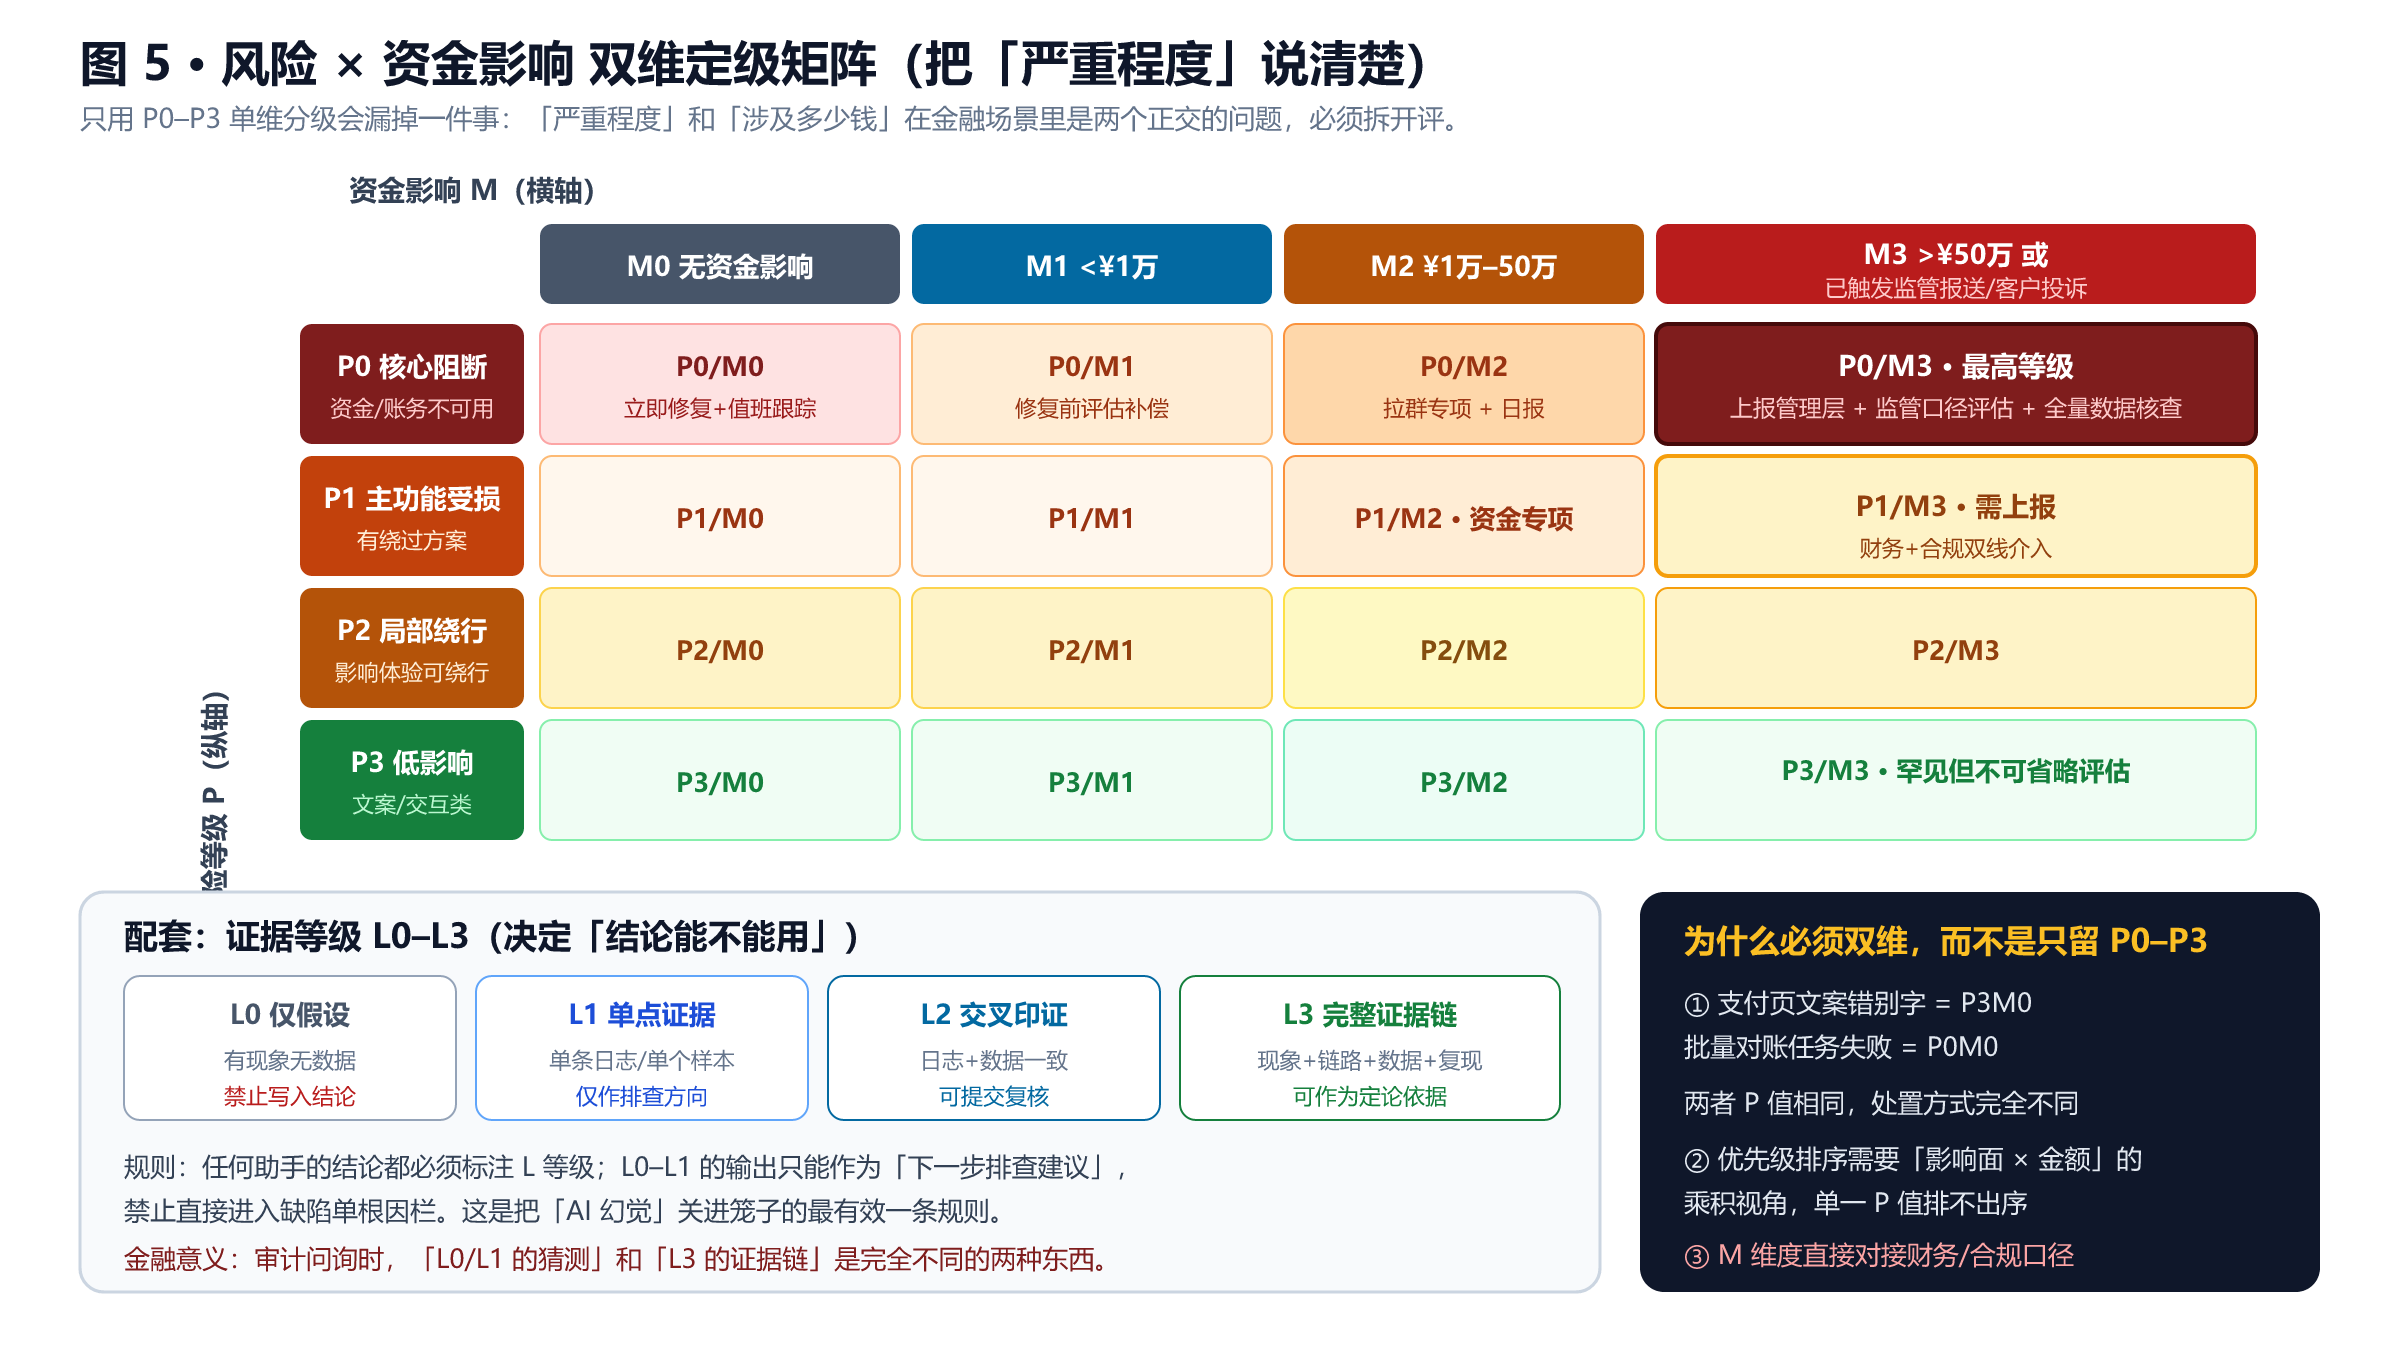
4.1 双维定义
维度一:P --- 技术/业务严重程度
| 等级 | 含义 |
|---|---|
| P0 | 核心阻断:资金、账务、核心交易不可用 |
| P1 | 主功能受损:有绕过方案,主流程受影响 |
| P2 | 局部绕行:影响体验可绕行 |
| P3 | 低影响:文案 / 交互 / 非核心路径 |
维度二:M --- 资金影响与合规敞口
| 等级 | 金额区间 | 附加条件 |
|---|---|---|
| M0 | 无资金影响 | --- |
| M1 | < ¥1 万 | --- |
| M2 | ¥1 万 -- 50 万 | --- |
| M3 | > ¥50 万 | 或已触发监管报送 / 客户投诉 |
定级规则:最终等级 = 矩阵映射结果,且 P ≥ 1 且 M ≥ 2 一律进入资金专项流程,无论 P 值多少。P0M3 是最高等级,必须上报管理层并做监管口径评估。
4.2 配套:证据等级决定"结论能不能用"
定级解决"多严重",证据等级解决"可信吗"。两个维度必须同时存在,缺一不可。
规则很硬:任何结论必须标注 L 等级;L0/L1 只能作为"下一步排查建议",禁止直接进入定论。
这条规则在审计场景下会体现得淋漓尽致------审计问询时,「L0/L1 的猜测」和「L3 的证据链」是完全不同的两种东西。前者不能作为结论,后者可以。
这是把 AI 幻觉关进笼子最有效的一条工程规则,比在 Prompt 里写"请不要幻觉"有效一百倍,因为它是架构约束而不是善意请求。
五、核心设计二:输出必须升级为字段级契约
每个助手包含三部分:输入模板 + 执行流程 + 输出契约。但"输出格式"如果只是"建议长这样",在联动场景下会立刻崩掉。
契约的每个字段必须声明四件事:必填性、类型、下游消费方、禁止内容。
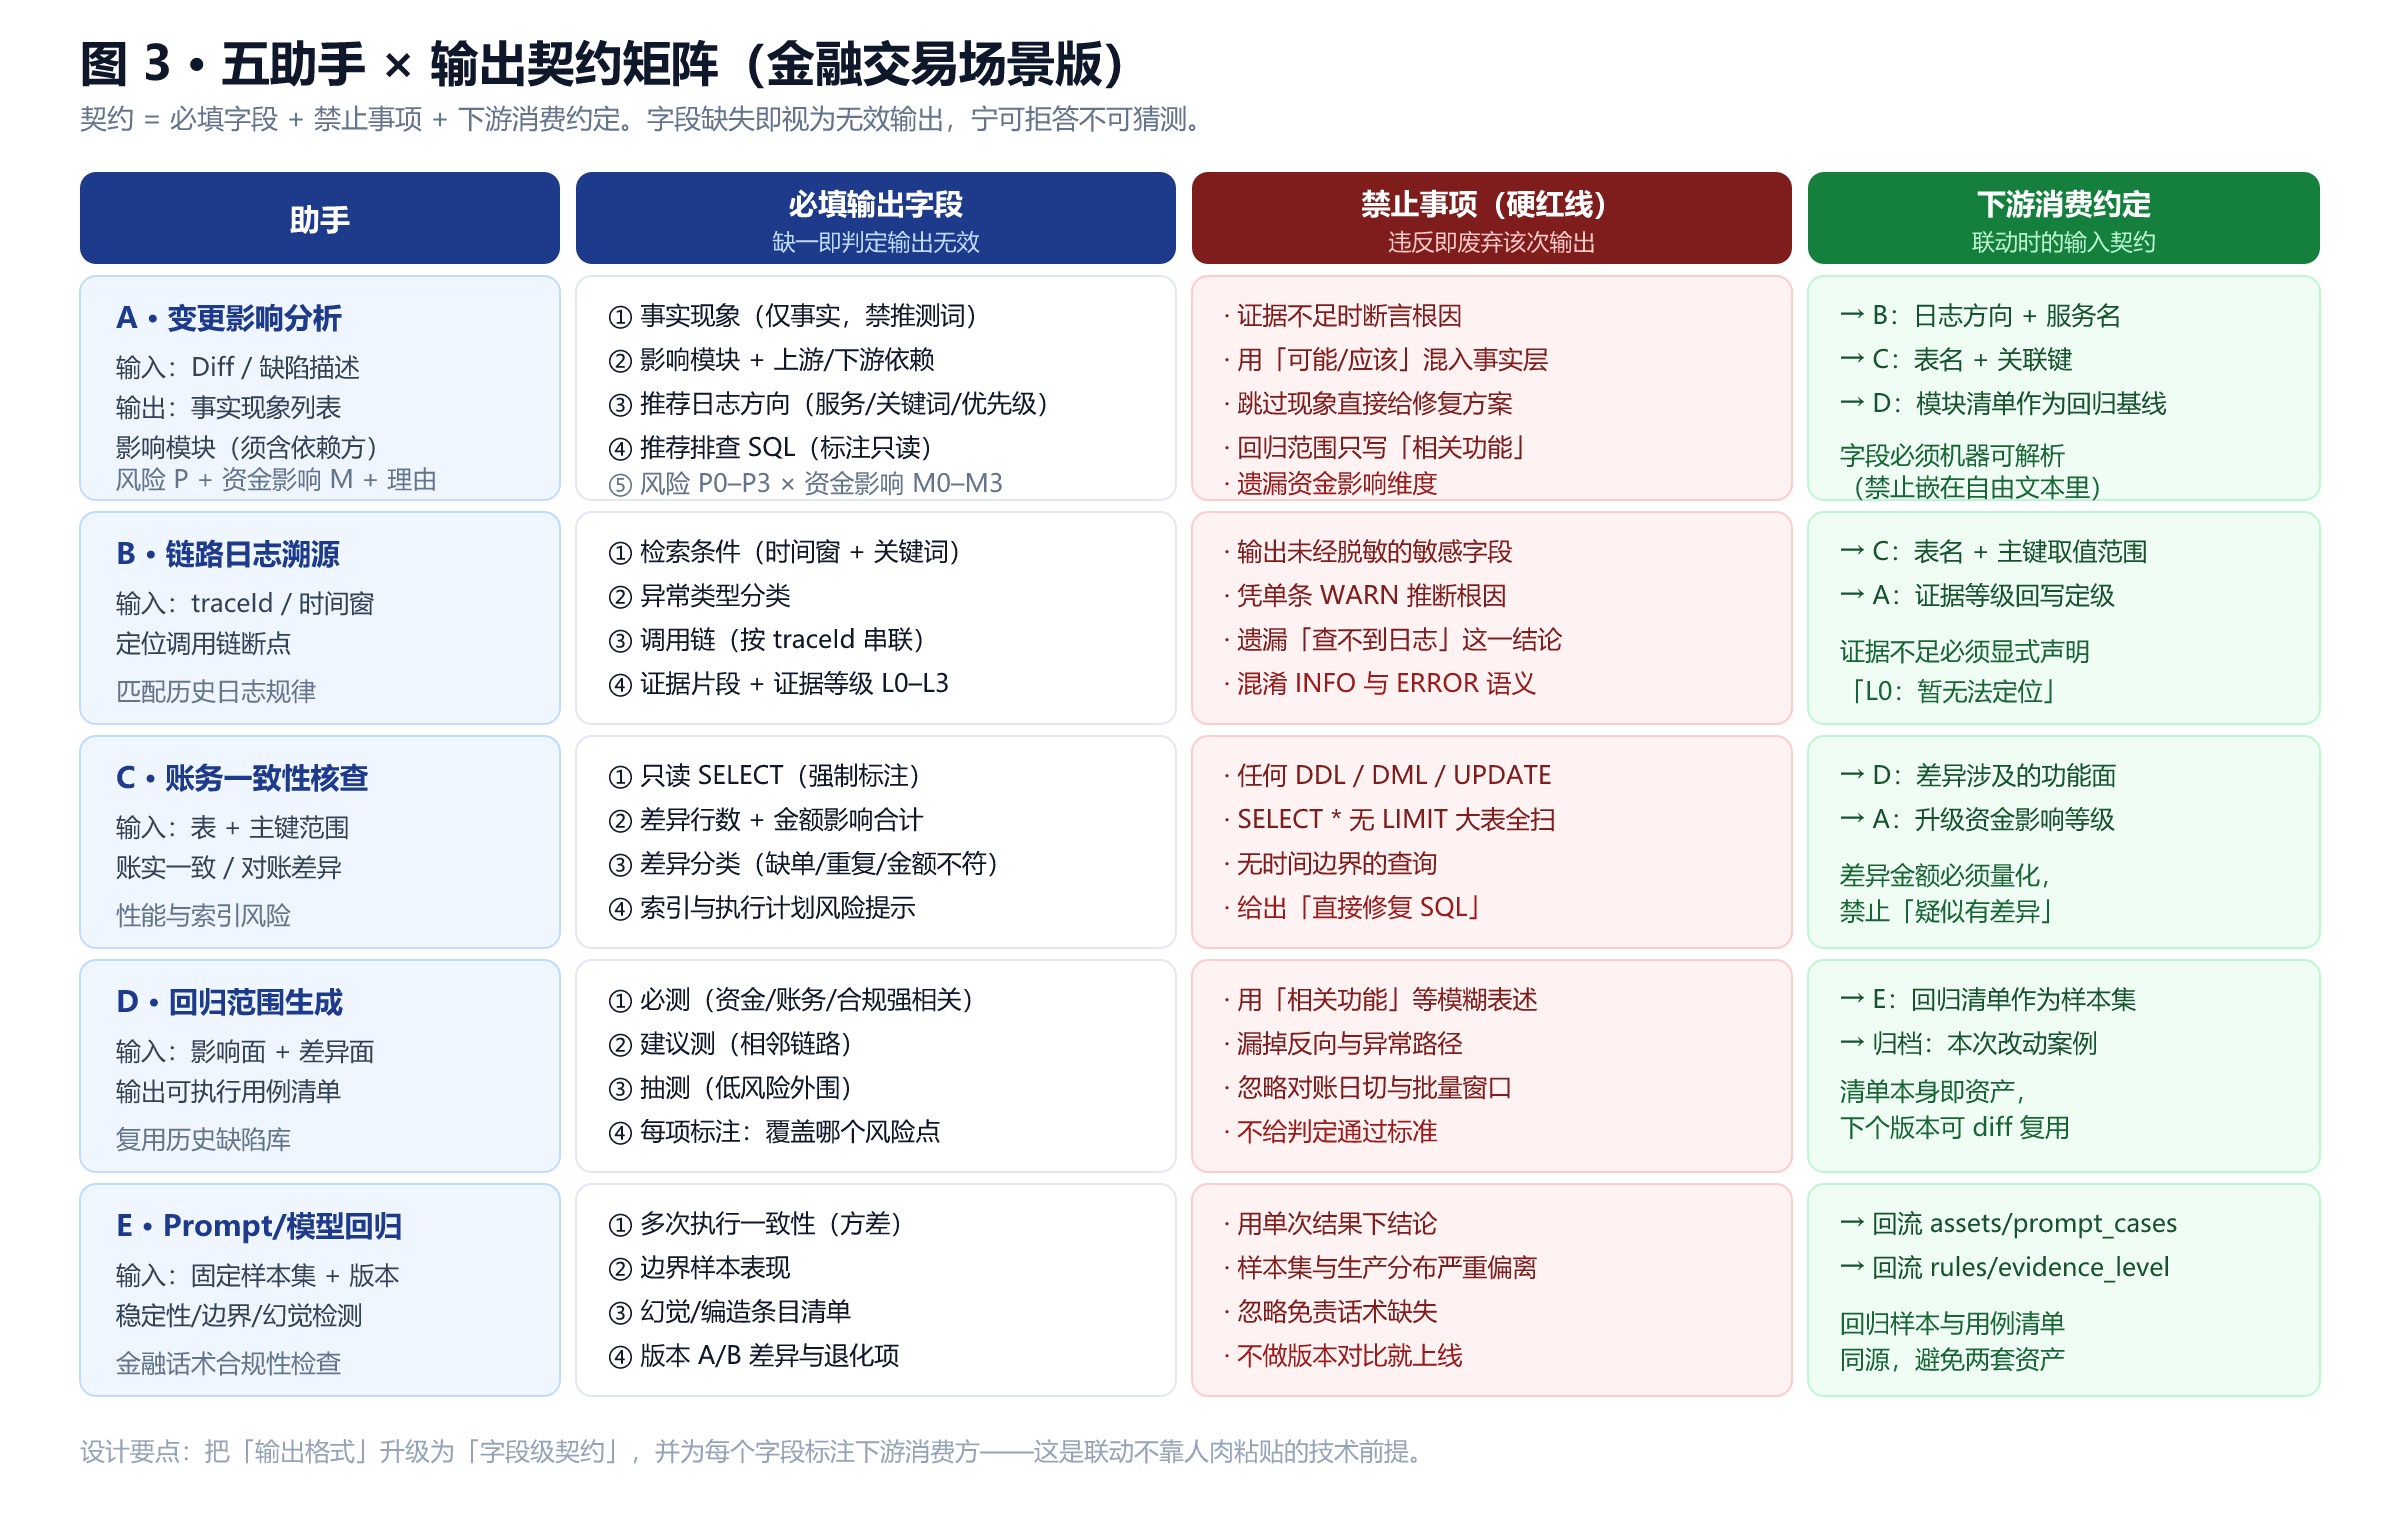
5.1 契约长什么样
以「变更影响分析助手」为例:
# contracts/bug_analysis_contract.yaml
output_fields:
  - name: 现象列表
    required: true
    type: list[string]
    rules: ["仅事实", "禁止出现 可能/应该/大概是"]
    consumed_by: [人工复核人, 团队 Leader]

  - name: 影响模块
    required: true
    type: list[module]
    rules: ["必须标注上游依赖方与下游受影响方"]
    consumed_by: [日志溯源助手, 回归范围助手]

  - name: 推荐日志方向
    required: true
    type: list[{service, keyword, priority}]
    consumed_by: [日志溯源助手]

  - name: 推荐排查SQL
    required: true
    type: list[string]
    rules: ["仅 SELECT", "必须含 LIMIT ≤1000", "必须含时间边界"]
    consumed_by: [账务一致性核查助手]

  - name: 风险等级
    required: true
    type: {P: "P0|P1|P2|P3", M: "M0|M1|M2|M3"}
    rules: ["必须附理由", "M 维度不得省略"]
    consumed_by: [人工复核人, 流程审批]

  - name: 证据等级
    required: true
    type: "L0|L1|L2|L3"
    rules: ["L0/L1 不得作为定论"]
    consumed_by: [人工复核人]

  - name: 人工复核点
    required: true
    type: list[string]
    consumed_by: [人工复核人]

forbidden_content:
  - "在证据等级 L0/L1 时断言根因"
  - "跳过现象直接给修复方案"
  - "任何 DDL/DML 语句"
  - "未脱敏的账号/卡号/手机号"
5.2 为什么契约是联动的技术前提
看图 3 最右侧那一列------每个字段都标注了 consumed_by 。这一列看起来不起眼,但它是整套体系能否自动联动的唯一决定因素。
如果「推荐日志方向」只是一段自由文本,下游助手必须靠自然语言理解去解析它,那么:换个模型解析失败、换个措辞解析失败、字段少写一个也解析失败。
而一旦它是结构化的 {service, keyword, priority} 三元组列表,下游可直接消费,零理解成本。
这是"消灭人肉复制粘贴"的真正技术方案:不是让 AI 更聪明地复制粘贴,而是让下游根本不需要解析自然语言。
5.3 五助手职责速查
| 助手 | 输入 | 核心职责 | 典型金融场景 |
|---|---|---|---|
| A 变更影响分析 | Diff / 缺陷描述 | 现象 → 影响模块 → 排查路径 → 双维定级 | 「支付成功后订单仍显示未支付」 |
| B 链路日志溯源 | traceId / 时间窗 | 关键词 → 异常类型 → 调用链 → 证据等级 | ERROR payment-svc traceId=abc123 |
| C 账务一致性核查 | 表 + 主键范围 | 账实一致、对账差异、索引风险 | 单笔金额差异超过 ¥0.01 |
| D 回归范围生成 | 影响面 + 差异面 | 改动 → 必测/建议测/抽测清单 | 「优化支付回调幂等逻辑」 |
| E Prompt/模型回归 | 固定样本集 + 版本 | 稳定性、边界、幻觉、话术合规 | 分析 Prompt 在同类样本上是否退化 |
5.4 单个助手的执行流程范式
每个助手的 workflows/*.md 都遵循同一范式:逐步输出、禁止跳步、显式声明禁止行为。
# 变更影响分析工作流

## 执行顺序(必须逐步输出,禁止跳步)
1. 校验输入:对照 contracts/bug_input.yaml,缺项则追问
2. 提取问题现象:仅事实,列表输出,禁止「可能/应该」
3. 判断影响模块:结合 assets/module_map,标注上下游依赖
4. 推荐日志方向:表格输出(服务 / 关键词 / 优先级)
5. 推荐账务核查方向:可执行 SELECT(标注只读 + LIMIT)
6. 关联历史缺陷:标注相似度与引用来源
7. 输出回归范围:必测 / 建议测 / 抽测
8. 双维定级:P0-P3 × M0-M3 + 理由
9. 标注证据等级:L0-L3
10. 输出人工复核清单与签字人

## 禁止行为
- 证据等级 L0/L1 时断言根因
- 跳过现象直接给「修复方案」
- 回归范围仅写「相关功能」等模糊表述
- 省略资金影响维度 M
第 9 步(标注证据等级)与第 10 步(输出复核清单)是最容易被省掉、也最不该省的两步。
六、核心设计三:三道人工闸门
前面五个助手再怎么自动化,这三道闸门一个都不能省。
| 闸门 | 触发时机 | 签字人 | 理由 |
|---|---|---|---|
| 闸门 1 | SQL 执行前 | 研发 / 运维 | 即使只读,也需防全表扫描打爆主库 |
| 闸门 2 | 根因认定 | 测试 + 研发双签 | AI 给线索、人给结论,双人交叉验证 |
| 闸门 3 | 资金类结论 | 业务 / 财务 | 涉及金额差异、赔付、对账差错 |
# contracts/human_review.yaml
reviews:
  - gate: 1
    trigger: 助手输出了待执行 SQL
    signers: [研发, 运维]
    checks: ["仅 SELECT", "含 LIMIT ≤1000", "含时间边界", "预估影响行数"]

  - gate: 2
    trigger: 结论拟写入缺陷单根因栏
    signers: [测试, 研发]
    checks: ["证据等级 ≥ L2", "根因可复现", "已排除替代解释"]

  - gate: 3
    trigger: 涉及金额差异 / 赔付 / 对账差错
    signers: [业务, 财务]
    checks: ["差异金额已量化", "影响范围已界定", "处理方案已备案"]
所有签字结果写入 reviews/,append-only,不可篡改。这是审计问询时唯一的举证材料。
七、联动实战:一个案例走完五步
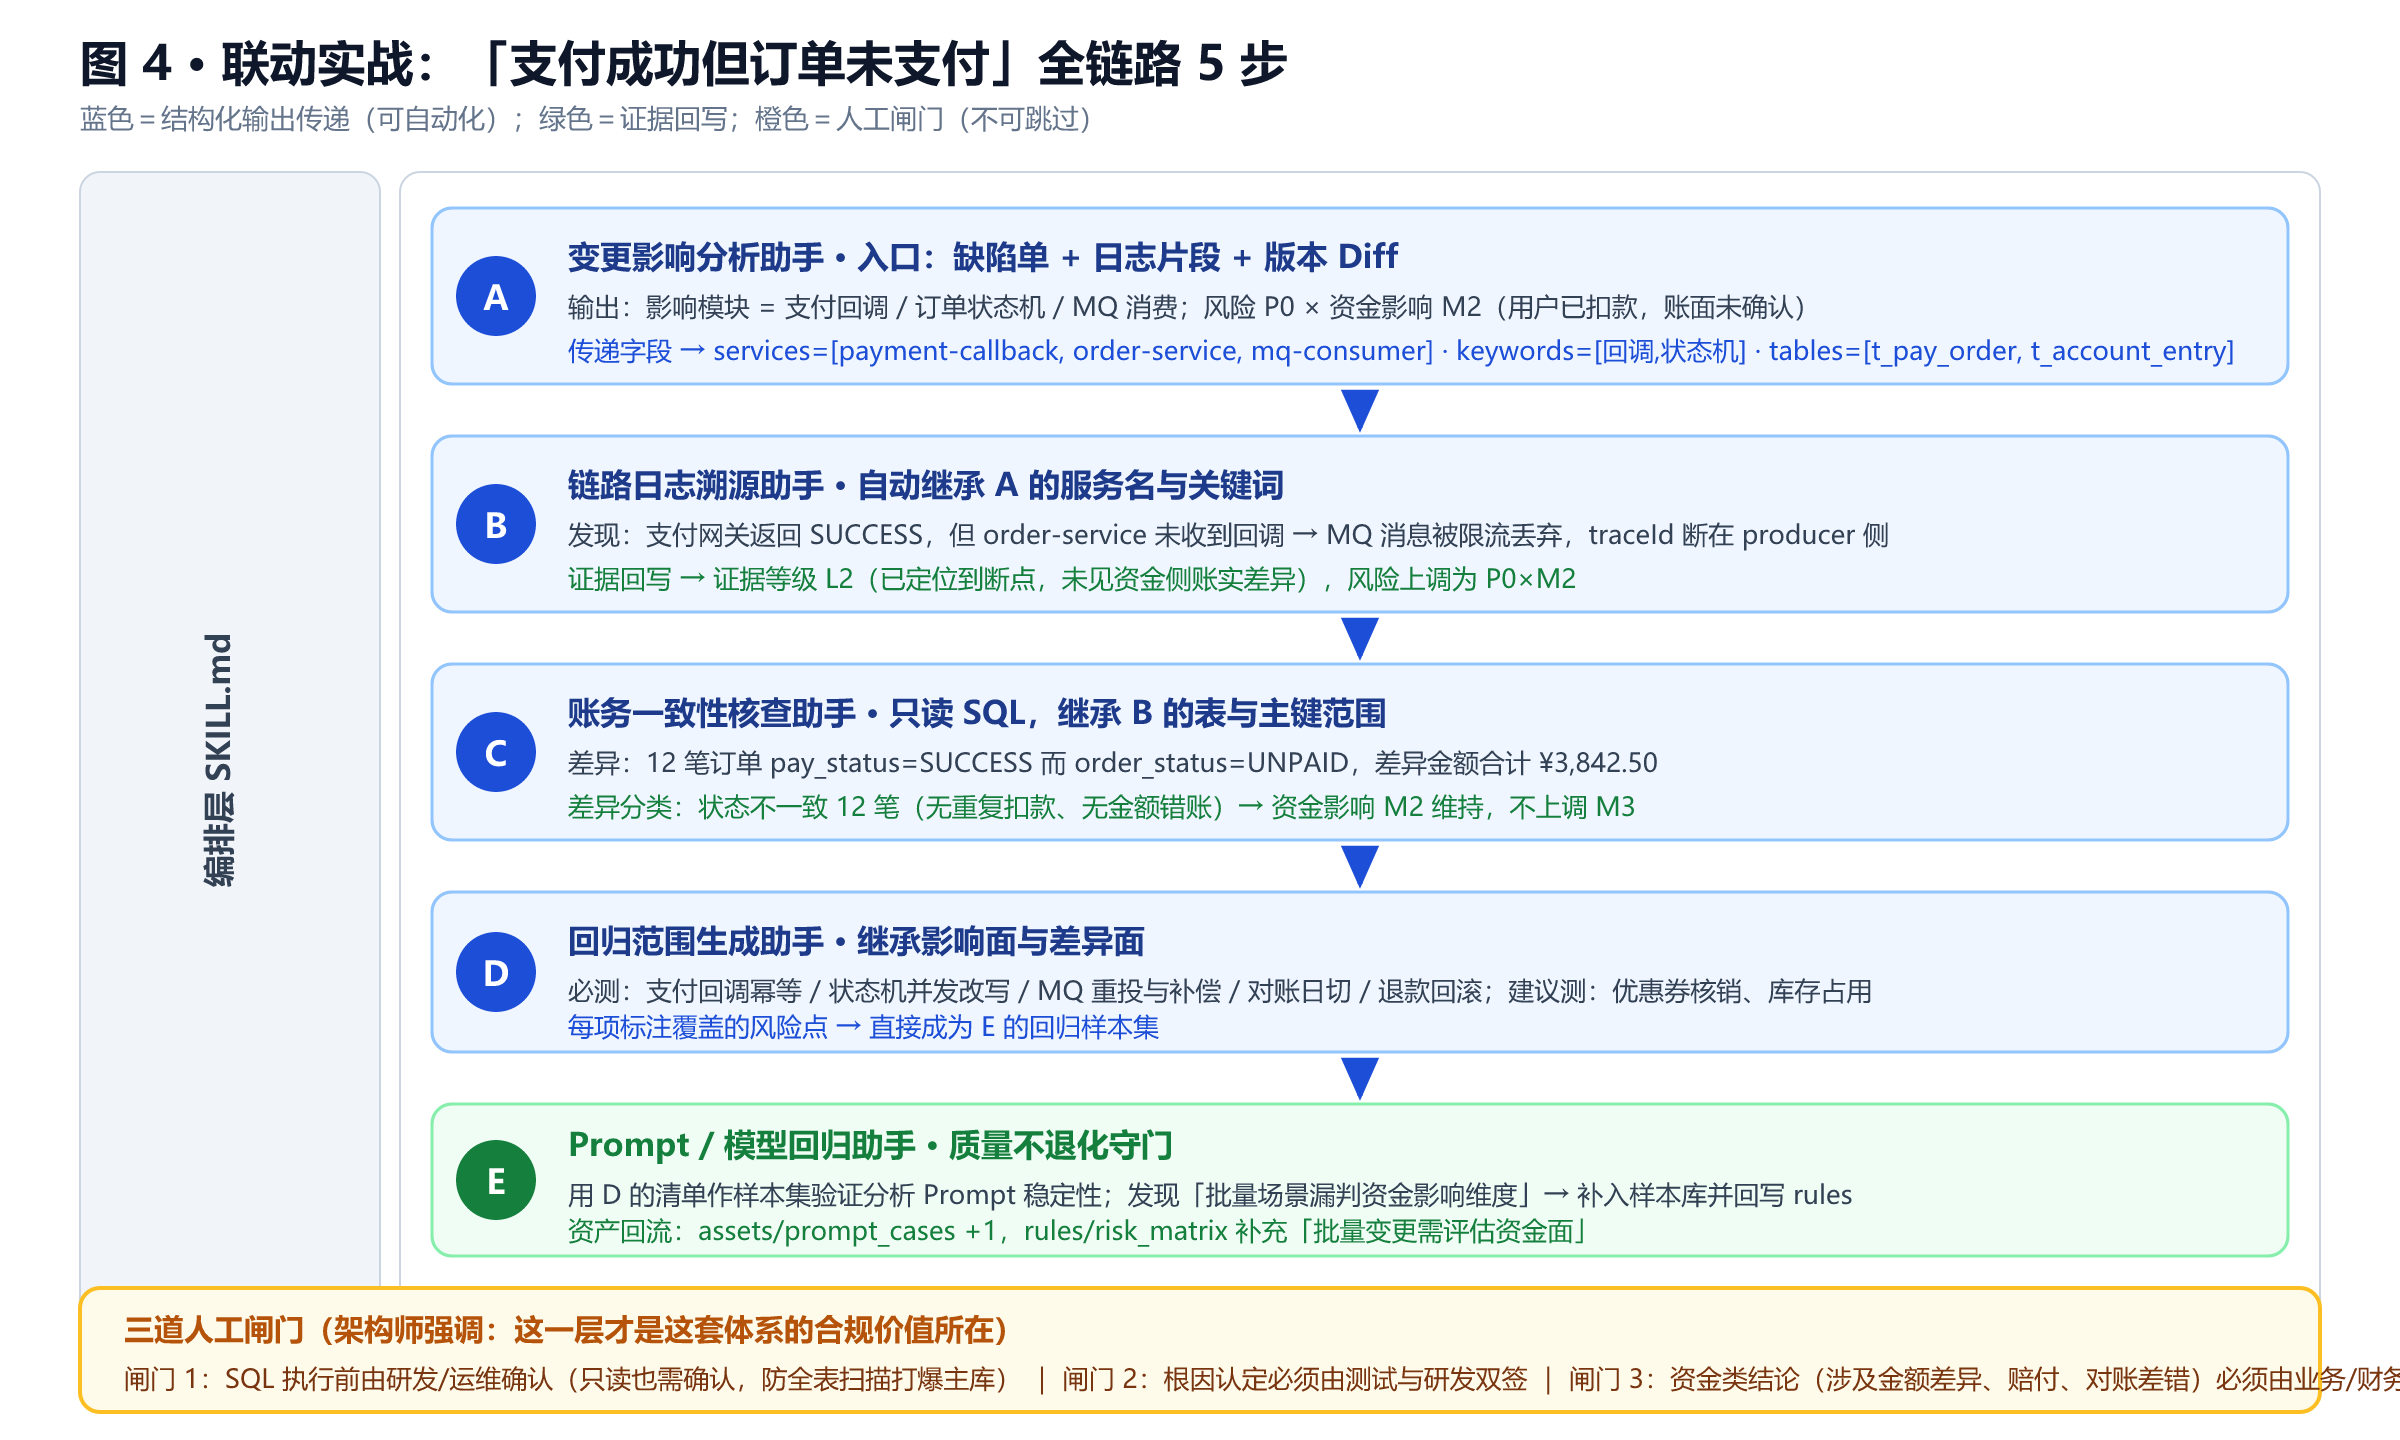
以高频案例走完全流程:「用户已扣款,但订单仍显示未支付」
Step A · 变更影响分析
- 输入:缺陷单 + 关键日志片段 + 版本 Diff
- 输出 :影响模块 = 支付回调 / 订单状态机 / MQ 消费;定级 P0 × M2 (用户已扣款、账面未确认);证据等级 L0(此刻只有现象)
- 结构化传递:
```
services = payment-callback, order-service, mq-consumer
keywords = 回调, 状态机, 限流
tables = t_pay_order, t_account_entry
```
Step B · 链路日志溯源
- 自动继承 A 的服务名与关键词,零人工复制
- 发现 :支付网关返回 SUCCESS,但 order-service 未收到回调 → MQ 消息被限流丢弃,traceId 断在 producer 侧
- 证据回写 :等级 L2(已定位断点,但未见资金侧账实差异);定级维持 P0×M2
Step C · 账务一致性核查
- 只读 SQL(继承 B 的表与主键范围):
```sql
SELECT o.order_id, o.order_status, p.pay_status, p.amount, p.paid_at
FROM t_pay_order o
LEFT JOIN t_account_entry p ON p.order_id = o.order_id
WHERE p.paid_at >= '2026-09-01' AND p.paid_at < '2026-10-01'
AND o.order_status = 'UNPAID' AND p.pay_status = 'SUCCESS'
LIMIT 1000;
```
→ 触发闸门 1,研发确认后执行
- 差异结论 :12 笔订单状态不一致,差异金额合计 ¥3,842.50 ;类型为状态不一致,无重复扣款、无金额错账
- 定级 M2 维持,不上调 M3 ------ 这一步的价值在于"排除",比"发现"更重要
- 证据回写 :等级 L3(现象 + 链路 + 数据 + 可复现齐备)
Step D · 回归范围生成
- 必测:支付回调幂等 / 状态机并发改写 / MQ 重投与补偿 / 对账日切 / 退款回滚
- 建议测:优惠券核销、库存占用
- 每项标注"覆盖哪个风险点" → 清单直接成为 E 的回归样本集(一份资产两处用)
Step E · Prompt / 模型回归
- 发现「批量场景下漏判资金影响维度 」的退化 → 补入样本库并回写
rules/risk_matrix.md(新增"批量变更需强制评估资金面") - 这一步让矩阵形成闭环:每一次真实使用都在让下一批任务更准
完整输出样例
一份合格的联动输出,应该是这样一份带证据链的报告:
【问题现象】用户已扣款,订单状态未更新(事实,无推测)
【影响模块】payment-callback / order-service / mq-consumer
【根因】MQ 消息被消费端限流丢弃,traceId 断在 producer 侧
【证据等级】L3(网关日志 + MQ 丢弃日志 + 数据差异三方印证)
【推荐日志】payment-callback.callback / mq-consumer.limit-reject
【推荐SQL】见 contracts/c_account_check.sql(只读,已过闸门 1)
【差异量化】12 笔 / ¥3,842.50 / 无重复扣款
【风险等级】P0 × M2 ------ 核心阻断 + 资金影响中等,需上报专项
【回归范围】必测 5 项 / 建议测 2 项 / 抽测 3 项
【人工复核】闸门 2 待双签、闸门 3 待财务确认对照一下:避免的是「可能是数据库问题,建议检查」这类缺乏上下文与排查抓手的输出------它没有任何证据等级、没有量化差异、没有签字人,无法交接、无法追溯、无法复用。
八、工程化落地:让体系能长期活下来
建目录是 5 分钟的事,做完只是有了骨架。真正决定这套体系能活多久的,是后面三件事。
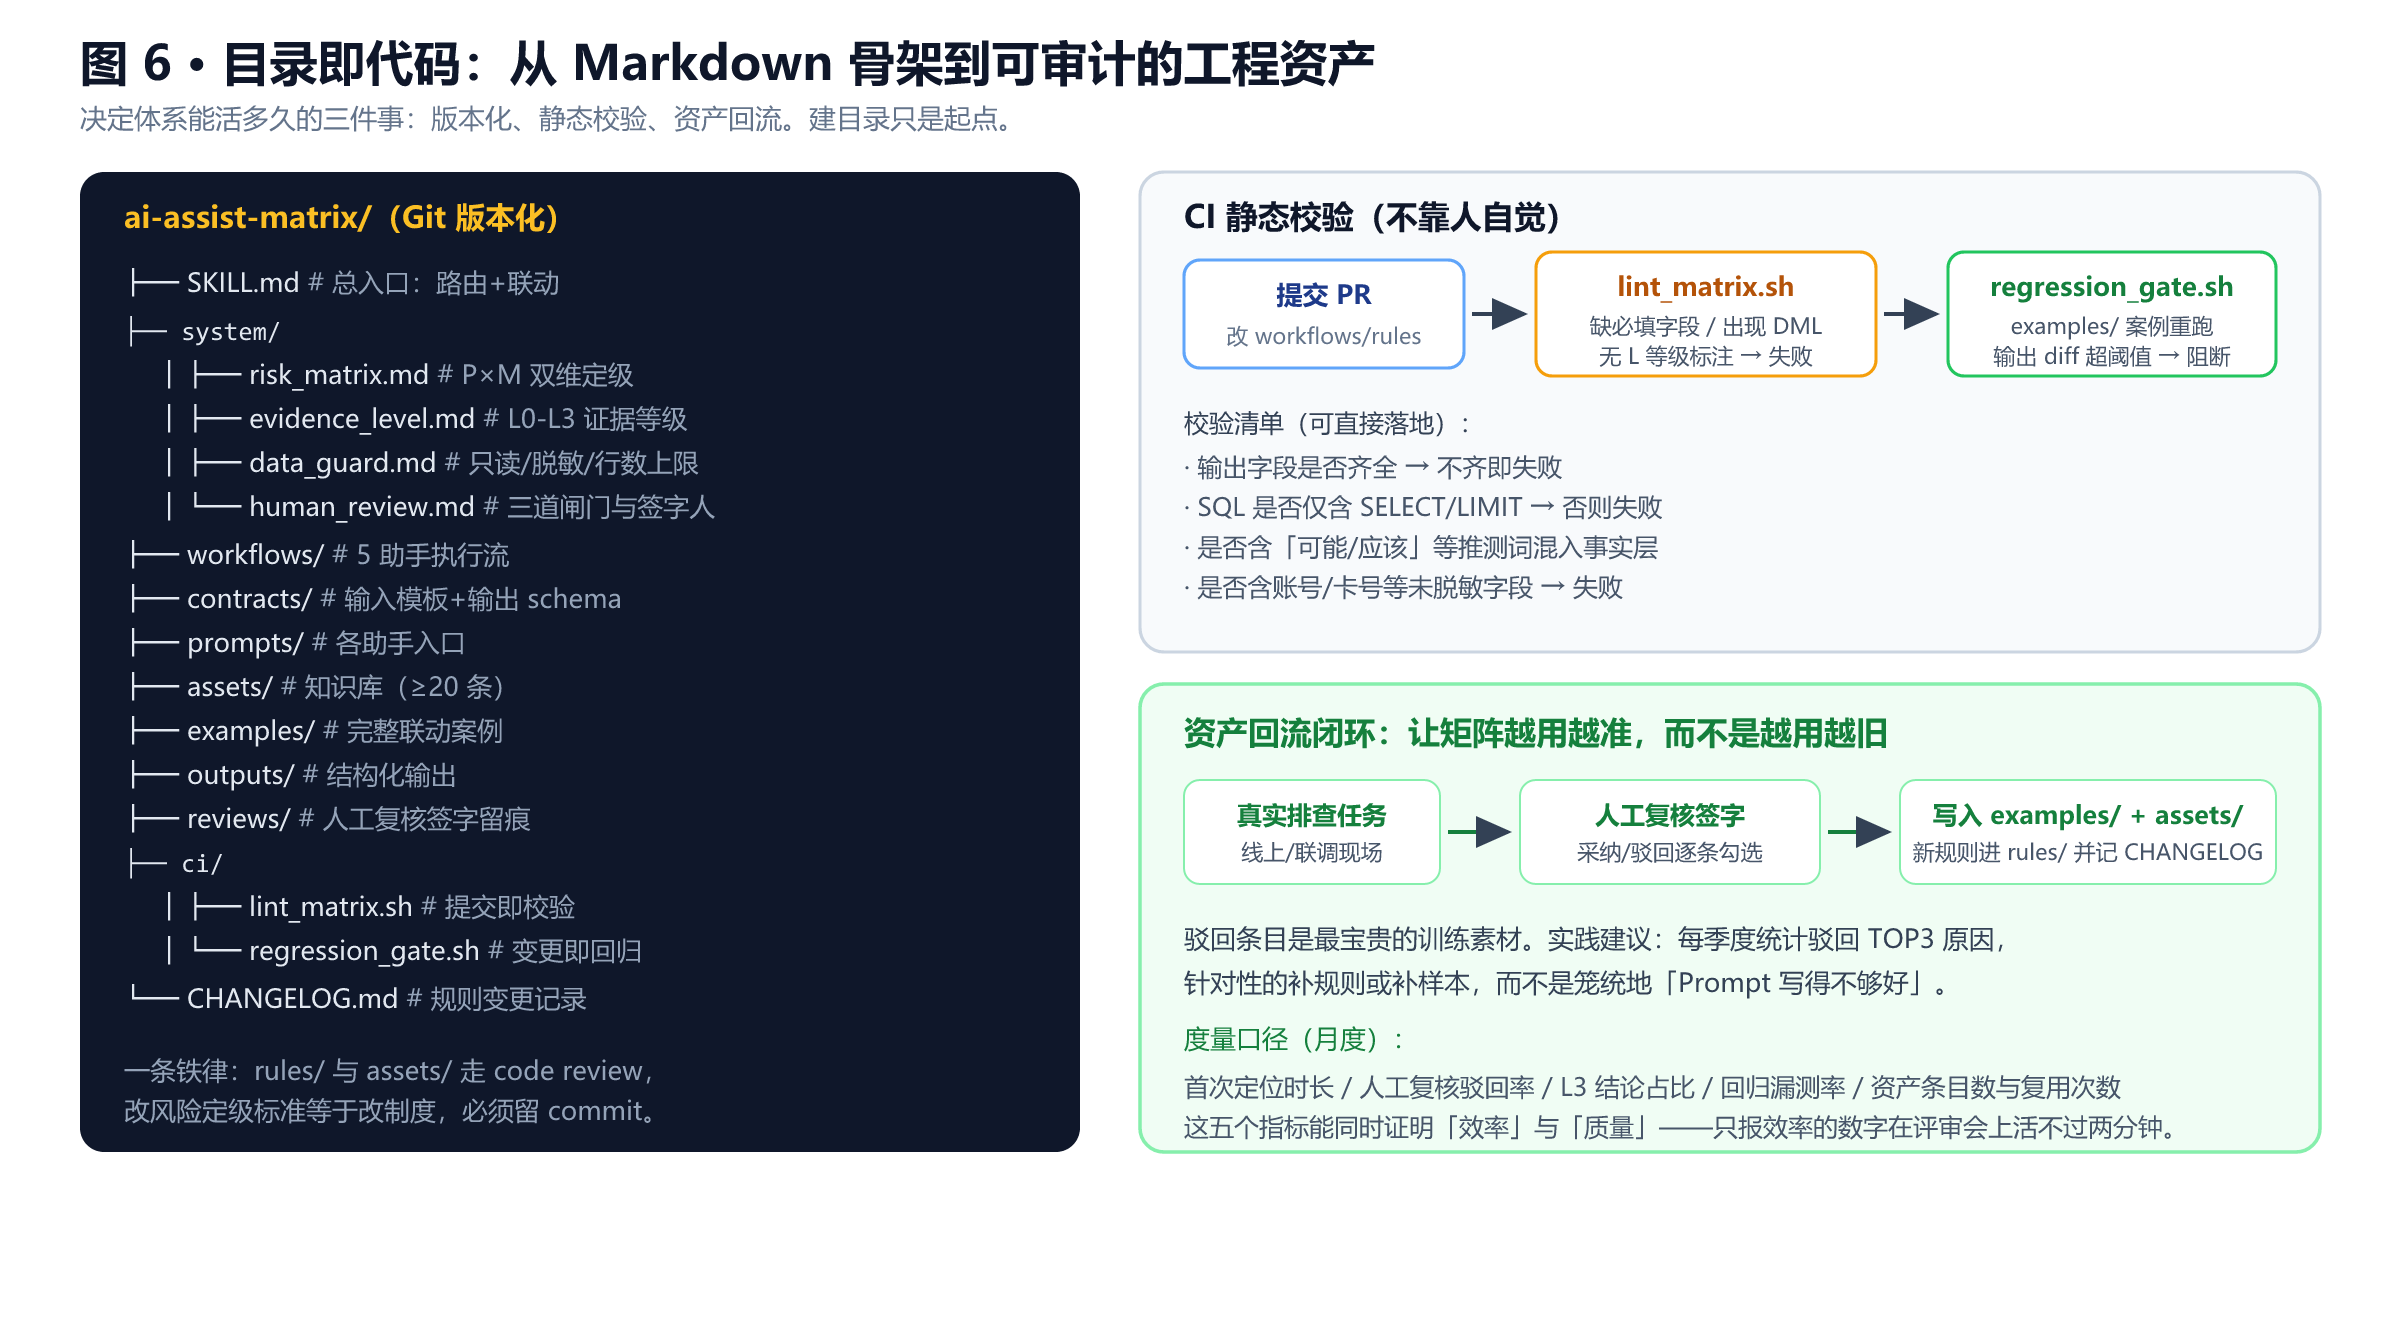
8.1 进 Git,走分层 Code Review
规则写在文档里没人看,所以要先版本化,并且评审级别要分层:
| 变更内容 | 评审级别 | 理由 |
|---|---|---|
outputs/ reviews/ |
只读,append-only | 审计留痕,不可篡改 |
assets/ |
只增不改(纠错除外) | 历史记录本身是资产 |
workflows/ |
常规 PR review | 影响作业方式 |
contracts/ |
版本号 + 兼容说明 | 改字段会破坏下游 |
system/(规则层) |
最高级别,等同制度变更 | 改风险定级标准就是改制度 |
一条铁律:改 system/ 必须有 commit 记录和 CHANGELOG 条目。 因为风险定级口径是团队共识,一旦被随手改掉,之前所有历史结论的定级依据都会失效。
8.2 CI 静态校验,不靠人自觉
规则挂到提交钩子上,写成脚本:
#!/usr/bin/env bash
# ci/lint_matrix.sh ------ 提交即校验
set -euo pipefail
FAIL=0

# 1. 输出契约:必填字段是否齐全
for f in outputs/*.md; do
  for field in 风险等级 证据等级 人工复核; do
    grep -q "$field" "$f" || { echo "[FAIL] $f 缺少字段: $field"; FAIL=1; }
  done
done

# 2. 数据动作:SQL 仅允许 SELECT/LIMIT
if grep -rniE '\b(update|delete|insert|alter|drop|truncate)\b' workflows/ contracts/; then
  echo "[FAIL] 检测到写操作关键词,违反 data_guard.md"; FAIL=1
fi

# 3. 事实层纯净度:禁止推测词
if grep -rn "可能是\|应该是\|大概是" workflows/; then
  echo "[WARN] 推测词出现,确认未混入事实层"
fi

# 4. 脱敏:禁止输出敏感字段
if grep -rniE '卡号|身份证|手机号.*=' contracts/; then
  echo "[FAIL] 疑似未脱敏字段"; FAIL=1
fi

# 5. 回归门禁:examples/ 案例重跑,输出 diff 超阈值则阻断
if [ -n "${RUN_EXAMPLES:-}" ]; then
  ./ci/regression_gate.sh || FAIL=1
fi

exit $FAIL
校验不通过 = 不能合并。 这一步把"规则"从"倡议"变成"约束"------这是体系能不能规模化的分水岭。
8.3 资产回流闭环
复利效应确实存在,但它有一个容易被忽略的前提:第二次会有人去更新知识库 。现实里不会,所以必须设计机制而不是寄望自觉。
真实排查任务
    → 人工复核签字(采纳/驳回逐条勾选)
        → 采纳:新案例写入 examples/,新规则写入 system/ 并记 CHANGELOG
        → 驳回:驳回原因写入 reviews/,按月统计 TOP3 并针对性补规则
驳回条目是最宝贵的训练素材。 建议每季度统计驳回 TOP3 原因,针对性地补规则或补样本,而不是笼统归结为"Prompt 写得不够好"------前者可执行,后者是甩锅。
8.4 度量口径:五个指标,证明的不只是效率
只报"效率提升 40%"的方案,在架构评审会上活不过两分钟。要证明价值,得同时证明效率 和质量:
| 指标 | 定义 | 说明 |
|---|---|---|
| 首次定位时长 | 从问题上报到根因确认的耗时 | 效率 |
| 人工复核驳回率 | 被驳回条数 / 总输出条数 | 质量的核心反向指标 |
| L3 结论占比 | 达到完整证据链的结论 / 总结论 | 输出可靠性 |
| 回归漏测率 | 上线后发现的遗漏缺陷 / 总缺陷 | 有效性 |
| 资产条目与复用次数 | assets/ 条数、被引用次数 |
复利程度 |
驳回率是这套体系的"体温计"。 初期偏高是正常的(规则不完善),CI 落地后应逐步下降------如果持续走高,说明规则库已过时;如果长期为零,反而要警惕:是不是大家都在无脑签字?
九、十个最容易踩的坑
| # | 误区 | 事实 | 关键理由 |
|---|---|---|---|
| 1 | 五个助手塞进一个 Prompt | 拆分独立文件 + SKILL.md 统一路由 | 避免多阶段任务串台 |
| 2 | 各助手自定义风险标准 | 在 system/ 统一推行 P×M 双维 |
跨模块严重程度与金额口径必须对齐 |
| 3 | 联动执行直接跳步 | 明确链路顺序与前置依赖声明 | 保证下游拿到完整上游输入 |
| 4 | 知识库条目太少 | 起步 ≥20 条,有效 ≥100 条 | 少于 20 条等于没建,模型仍退化通用答案 |
| 5 | AI 输出直接交付开发 | 末尾强制人工复核清单 + 三道闸门 | AI 给线索,关键根因必须人签字 |
| 6 | 规则写文档就算落地 | 必须挂 CI 校验,不靠人自觉 | 从"倡议"变"约束",规模化的分水岭 |
| 7 | 目录建好就结束 | 必须进 Git,走分层 Code Review | 规则层改动 = 制度变更,需留 commit |
| 8 | 知识库靠人自觉更新 | 必须有驳回回流机制 | 复利的前提是有人更新,否则必然腐烂 |
| 9 | 只测效率指标 | 必须同时报驳回率与 L3 占比 | 只报效率的方案过不了架构评审 |
| 10 | 假设 AI 输出可信 | 必须 L0--L3 证据等级 | 禁幻觉入结论,审计场景刚需 |
第 6 到第 10 条,是"方法论正确"与"工程到位"之间真正缺的距离。
十、验收标准
怎么判断这套矩阵搭好了?分四层判定,全部要可判定,不能靠感觉。
结构层
- 新同事只看 SKILL.md 就能自主选对助手并完成一次完整任务
examples/至少 1 个完整联动案例,含四类助手输出 + P×M 定级 + 复核勾选assets/条目数 ≥ 20,每条标注适用模块与判定标准
契约层
- 五个助手的输出字段齐全率 100%,缺字段能被 CI 拦截
- 每个输出字段在契约中标注了
consumed_by - 联动链路中零人工复制粘贴即可完成五步流转
规则层
- 所有输出带双维定级(P×M)与证据等级(L)
- 所有 SQL 仅含 SELECT + LIMIT + 时间边界,CI 可拦截违规
- 三道人工闸门真实存在,且有留痕记录
资产层
reviews/中驳回条目有统计口径与月度分析- 规则变更有 CHANGELOG 记录,季度复盘一次
- 五个度量指标可采集、可视化、可追溯
判定标准很简单:随机抽一个新人,不给任何口头指导,让他独立完成一次完整联动并写出合规报告。 做不到,就是还没落地。
十一、落地路线:三步走
| 阶段 | 周期 | 目标 | 交付物 |
|---|---|---|---|
| 第一步:可用 | 第 1--2 周 | 骨架 + 单助手跑通 | 目录结构、system/ 规则、A/B 两助手契约、20 条资产 |
| 第二步:可信 | 第 3--6 周 | 五助手联动 + CI 校验 | 完整契约矩阵、CI 脚本、三道闸门、联动案例 3 例 |
| 第三步:可复制 | 第 7 周起 | 跨项目/跨团队复用 | 分层 Code Review 规范、驳回回流机制、五指标看板 |
给不同角色的落地建议:
- 测试同学:先做 A/B 两助手,把"证据等级"这条规则用起来------收益最快、感知最强
- 架构师 / 技术负责人:优先做契约层和 CI 校验,这决定了体系能不能规模化
- 团队负责人 :把
system/的变更纳入制度管理,明确"改定级标准需要评审"
十二、写在最后
回到开头那个场景。同一个「支付成功但订单未支付」的问题,以前要开五个窗口来回切换;现在一个入口,五个助手自动接力,输出一份带双维定级、证据等级、三道签字闸门的统一报告。
这不是"AI 变强了",而是给它了一套可执行的协同框架。
我想再补一句:
在金融行业,比"给 AI 一套框架"更重要的是"给 AI 一套边界"。
我们让 AI 去翻日志、去写只读 SQL、去生成回归清单------这些事它做得比人快、也比人不累。但根因认定、资金结论、上线决策 ,这三件事永远不能交出去。不是因为 AI 不够强,而是因为在这些场景里,责任必须有人承担,而责任无法被算法承担。
这套体系真正做的事,是把"翻日志、猜原因"的时间省下来,让你有时间去做真正需要人脑的事------判断、权衡、签字。
从"每次重新教 AI"到"一次固化、长期复用",这是认知负担的迁移。而在监管越来越严、审计越来越细的今天,这种迁移的价值不只是效率,是让团队的能力从"存在个人脑子里"变成"存在组织资产里"。
前者会随着人员流动消失,后者不会。
会搭这套矩阵的人,本质上具备的是"把行业经验结构化、可继承化"的能力。这种能力,在任何规模的团队里都是稀缺的。