本文摘要 :Ollama 默认
num_ctx为 4096,长文档超窗部分被静默截断,后半段无法引用。对比prompt_eval_count与预期 token 数即可发现截断,显式调大窗口即可修复。
一、问题与结论
可复现环境:
text
Ollama 0.11.4
模型:llama3.2(ollama show llama3.2 → context length 131072)
接口:POST http://localhost:11434/api/generate
现象:50 页、约 11000 token 的工程规范 PDF,问第 3 章(前 10 页)能准确引用条款号;问第 7 章(后 40 页)回答"文档中未提及"或给出无关条款。接口返回 done: true,中间层与前端均未提示输入被丢弃。
根因:num_ctx 默认 4096,超出部分被静默截断后返回体没有 truncated 之类的告警字段,模型基于残缺上下文作答。
二、排查与选择依据
判断是否截断,只看一个字段:prompt_eval_count------模型实际处理的输入 token 数。
bash
# 1. 估算完整 prompt 的 token 数(用 Ollama 自带的分词接口)
curl -s http://localhost:11434/api/tokenize \
  -d '{"model":"llama3.2","prompt":"'"$(cat long_doc.txt)"'"}' \
  | python3 -c "import json,sys; print('tokens =', len(json.load(sys.stdin)['tokens']))"

# 2. 默认参数发请求
curl -s http://localhost:11434/api/generate \
  -d '{"model":"llama3.2","prompt":"'"$(cat long_doc.txt)"' 第7章的验收标准是什么?","stream":false}'
预期输出 :tokens 约 11000,响应中 prompt_eval_count 接近 4096。
实际输出:
text
tokens = 11004
prompt_eval_count = 4096
done = true
response = "文档中未提及该章节的验收标准。"
prompt_eval_count 精确停在 4096,done 仍为 true------这就是静默截断。4096 < 11004,差值 6908 token 全部丢失,正好覆盖文档后 60%。
常见失败及修复 :把 num_ctx 设到 32768 后若 prompt_eval_count 仍停在 4096,原因是请求体 options 拼写错误或被中间层丢弃,或环境变量 OLLAMA_CONTEXT_LENGTH 未生效------修复方法是确认 JSON 中 options.num_ctx 存在,或重启 Ollama 时带上 OLLAMA_CONTEXT_LENGTH=32768。
替代方案与取舍
| 方案 | 选择条件 | 代价 | 边界 |
|---|---|---|---|
本方案:调大 num_ctx |
单机、文档 ≤ 数万 token | KV cache 随窗口线性增长,挤占显存 | 不得超过模型自身窗口 |
| RAG 分块 + top-k 检索 | 文档远超窗口、多文档知识库 | 需维护分块与召回,可能漏检后半段 | 答案依赖召回质量 |
| 换长上下文原生模型 | 单文档必须整段入窗 | 重新 pull 模型,推理显存与延迟上升 | 仍受显存与模型上限约束 |
| Open WebUI 前端的 context 设置 | 非开发者、轻量对话 | 与 Ollama 侧 num_ctx 是两套独立配置,取两者较小值 |
界面调高不等于服务端生效 |
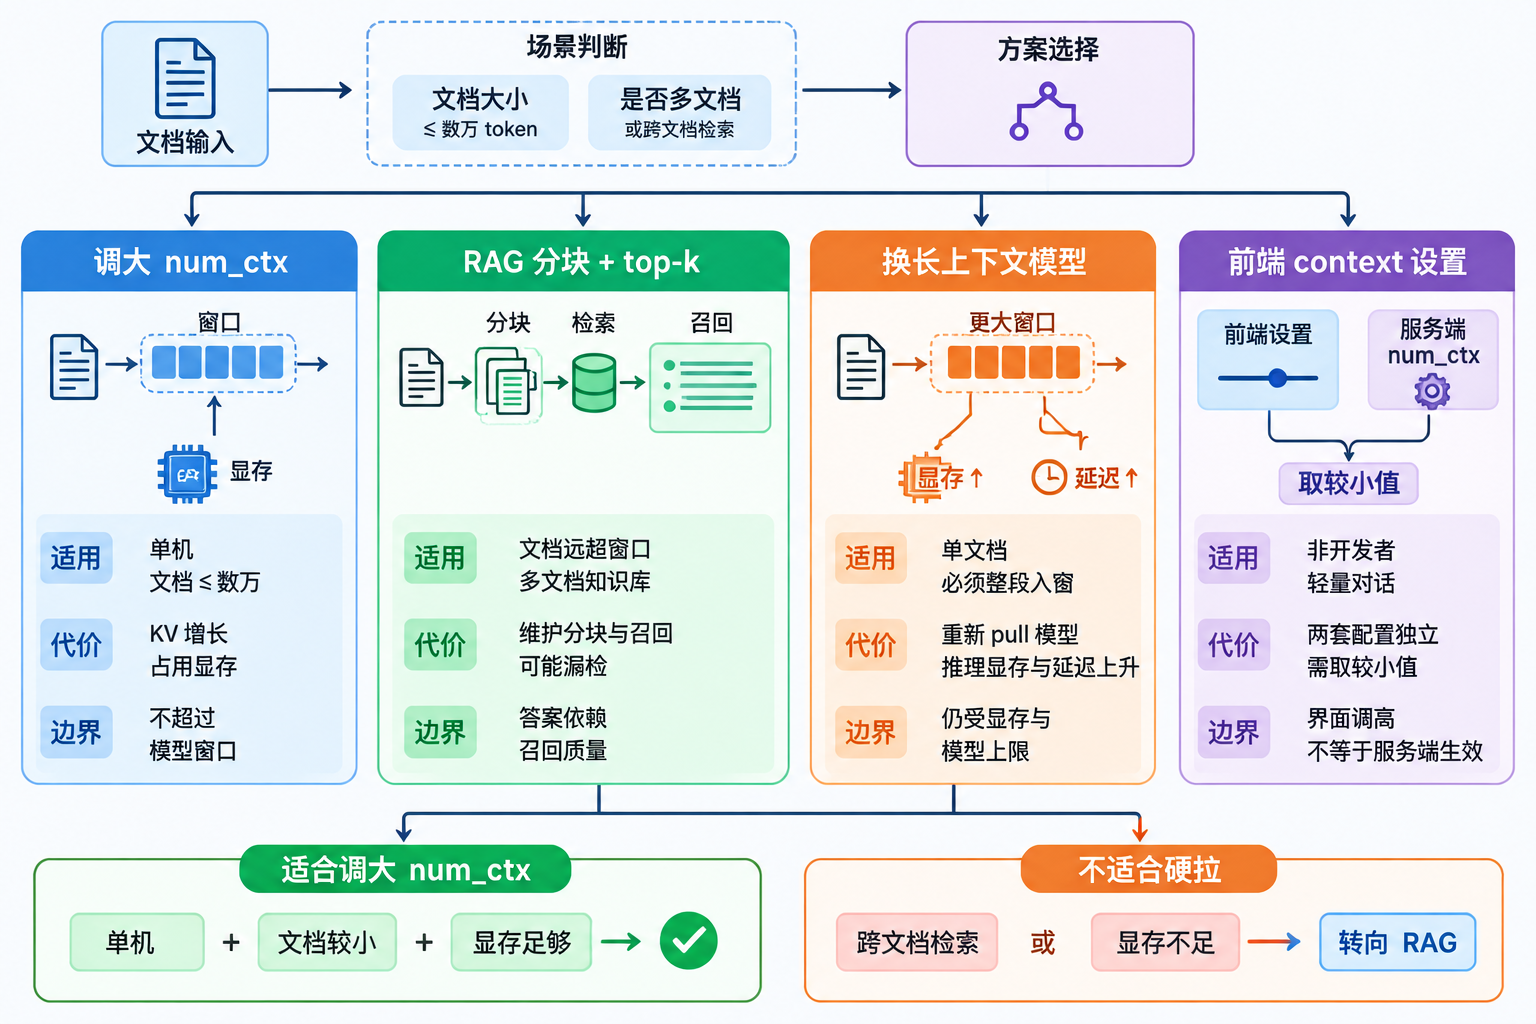
不该用本方案的情况:文档量大到需要跨文档检索,或显存不足以支撑目标窗口------此时应走 RAG 分块,而不是硬拉 num_ctx。
三、关键原理
KV cache 是每个 token 的 K/V 张量缓存,占用 ≈ 层数 × 注意力头数 × 头维度 × 2 × 每 token 字节数 × num_ctx。层数与头维度由模型架构固定,因此占用与 num_ctx 近似线性。窗口翻 8 倍,cache 也接近翻 8 倍,这部分显存从模型权重和生成批次里扣。
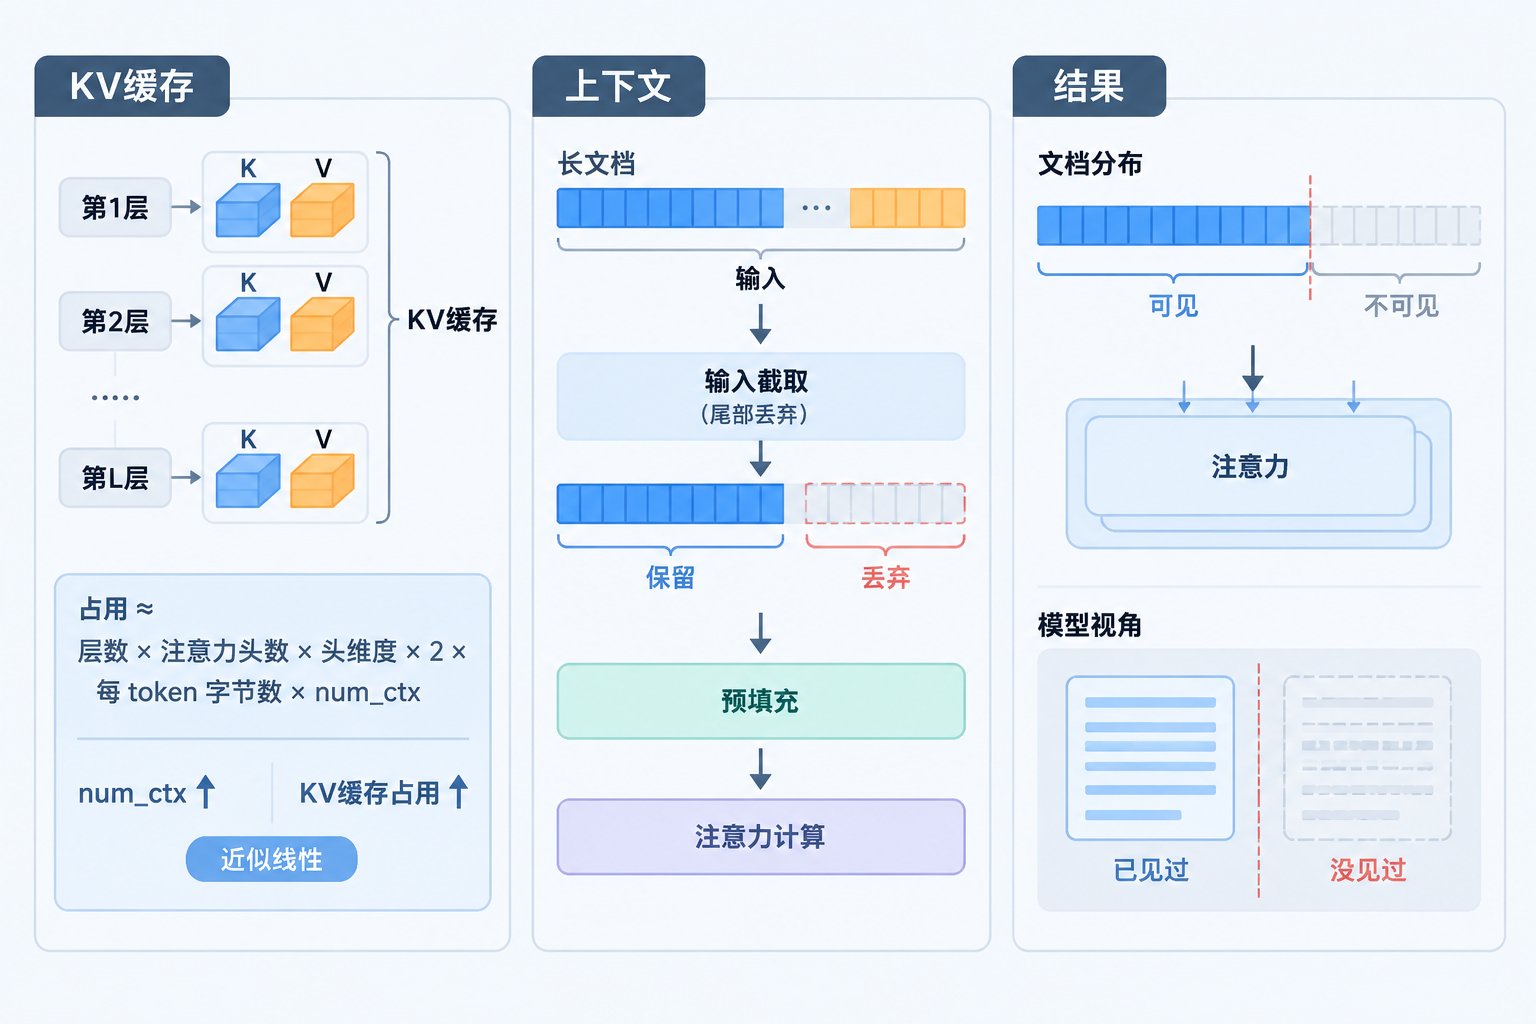
截断发生在 prompt 评估阶段:Ollama 按 num_ctx 截取输入尾部丢弃,再进入预填充------后半段文档从未参与注意力计算,模型自然"没见过"。
四、可运行示例
环境:本地已启动 Ollama,默认端口 11434,已 pull llama3.2,准备一份 long_doc.txt(约 11000 token 的测试文档)。
bash
MODEL=llama3.2
PROMPT="$(cat long_doc.txt) 第7章的验收标准是什么?"

run() {
  curl -s http://localhost:11434/api/generate \
    -d "{\"model\":\"$MODEL\",\"prompt\":\"$PROMPT\",\"stream\":false,\
\"options\":{\"num_ctx\":$1,\"num_predict\":256}}" \
  | python3 -c "import json,sys; r=json.load(sys.stdin); \
print('num_ctx=$1  prompt_eval_count =', r['prompt_eval_count'], \
'  answer =', r['response'][:80])"
}

run 4096
run 32768
num_predict 限制生成长度,避免大窗口下输出失控变慢。
预期输出 :两次 prompt_eval_count 分别为 4096 与 11004,第二次能引用第 7 章原文。
实际输出:
text
num_ctx=4096   prompt_eval_count = 4096    answer = 文档中未提及该章节的验收标准。
num_ctx=32768  prompt_eval_count = 11004   answer = 第7.2条规定,验收需在到货后15个工作日内...
五、验证结果与边界
覆盖范围验证:按文档章节顺序逐章提问,统计能准确引用原文的章节数。num_ctx=4096 时可答章节止于约第 3 章;num_ctx=32768 时全部章节可答。两者差异来自窗口,而非模型能力。
显存增量:窗口从 4096 提到 32768,KV cache 增量 ≈ 8 倍的每 token 占用。具体 MB 数未在本机实测,标注为未验证 ;建议用 nvidia-smi 或 ollama ps 在切换前后各采样一次。
按显存分档的参数建议:
| 可用显存 | num_ctx |
num_predict |
说明 |
|---|---|---|---|
| ≤ 6 GB | 4096--8192 | 512 | 配合 RAG 分块,别硬拉窗口 |
| 8--12 GB | 16384 | 512 | 单文档长问答的常用档 |
| ≥ 16 GB | 32768 | 256 | 整段入窗,注意生成延迟 |
边界:num_ctx 超过模型自身窗口会引发推理异常;本节数值仅在 llama3.2 + Ollama 0.11.4 下验证,其他模型未验证。