拿到一份用户行为日志,想分析"用户从进入网站到离开,依次访问了哪些页面",这几乎是每个数据分析师都写过的查询。但很多人写完的路径序列是错的------因为没有按**会话(Session)**做切分,把用户跨了几小时的访问拼成了一条不存在的路径。这篇文章我把会话切分的标准 SQL 写法拆开讲。
🛠 建议把这段 SQL 存到你的查询片段库里,下次做用户路径分析时直接改表名就能用。
问题:为什么不能直接按 user_id 排序
错误做法: 按
user_id分组、event_time排序,把所有页面浏览拼成一个数组。**结果:**用户昨天晚上访问了首页→商品页,今天早上又来了一次首页→结算页,你拼成的路径是"首页→商品页→首页→结算页"。这两条路径本来应该是两次独立会话,但你的 SQL 把它们连成了一条,后续的路径转化分析全错。
Google Analytics 的默认规则是:用户不活动超过 30 分钟 ,就自动开启一个新会话(来源:Google Analytics 官方文档《About Analytics sessions》)。这个 30 分钟不是随便定的,它是业界判断"两次访问是否属于同一次来访"的通用标准。GA4 支持的调整范围是 5 分钟到 7 小时 55 分钟。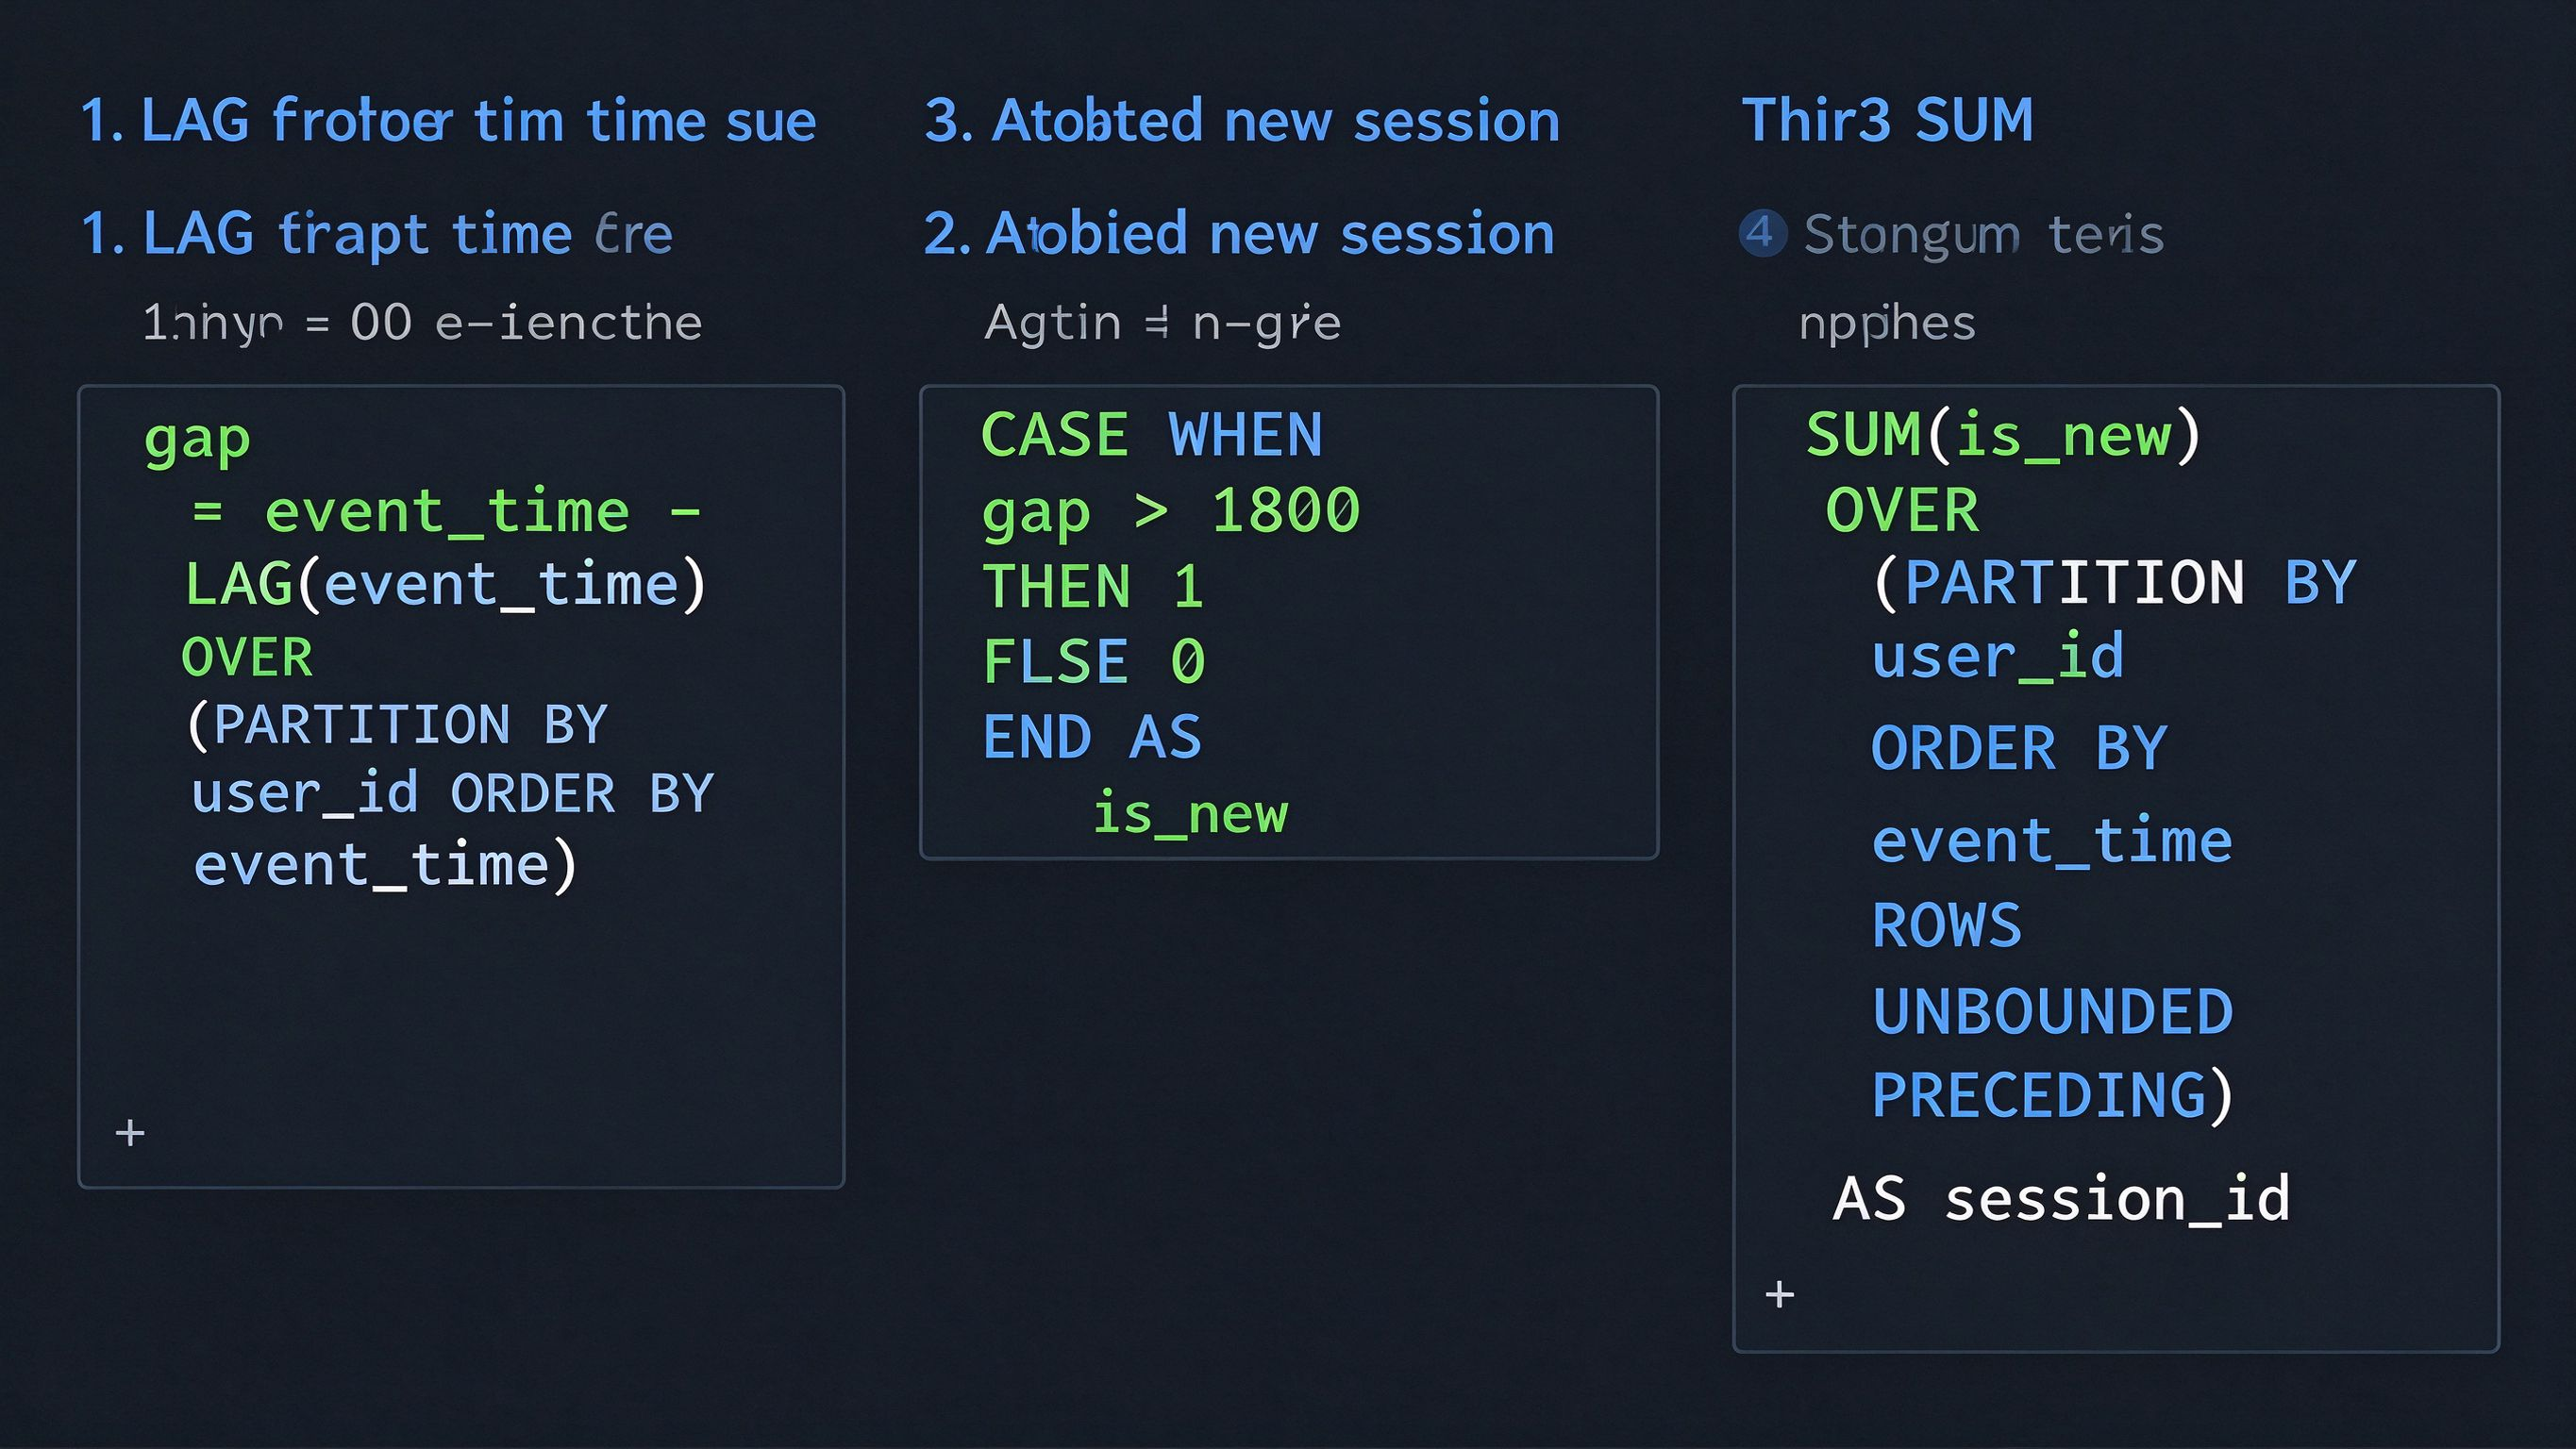
核心思路:用 LAG 和 SUM 标记会话起点
整个方法分三步:
1.用 LAG() 取出同一用户上一条记录的时间,计算当前记录和上一条的时间差。
2.如果时间差超过 30 分钟,标记为"新会话开始"(值为 1),否则为 0。
3.对标记列做累加求和 (窗口函数),得到每个用户的会话编号 session_id。
完整 SQL(以 Hive/Spark SQL 为例)
-- 第一步:计算每条记录与上一条的时间差,标记新会话
WITH step1 AS (
  SELECT
    user_id,
    event_time,
    page_url,
    -- 同一用户上一条记录的时间
    LAG(event_time) OVER (
      PARTITION BY user_id
      ORDER BY event_time
    ) AS prev_time,
    -- 时间差(秒)
    UNIX_TIMESTAMP(event_time) -
    UNIX_TIMESTAMP(LAG(event_time) OVER (
      PARTITION BY user_id ORDER BY event_time
    )) AS gap_seconds
  FROM user_pageview_log
  WHERE dt = '2026-10-11'
),

-- 第二步:标记会话起点(gap 超过 1800 秒 = 30 分钟,就是新会话)
step2 AS (
  SELECT
    user_id,
    event_time,
    page_url,
    CASE
      WHEN gap_seconds IS NULL THEN 1  -- 第一条记录,肯定是新会话
      WHEN gap_seconds > 1800 THEN 1
      ELSE 0
    END AS is_new_session
  FROM step1
),

-- 第三步:累加得到会话编号
step3 AS (
  SELECT
    user_id,
    event_time,
    page_url,
    SUM(is_new_session) OVER (
      PARTITION BY user_id
      ORDER BY event_time
      ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS session_seq
  FROM step2
)

-- 最终:按 user_id + session_seq 聚合出完整路径
-- 注意:COLLECT_LIST 是聚合函数,放在 GROUP BY 层级,不要和窗口函数混用
SELECT
  user_id,
  session_seq,
  MIN(event_time) AS session_start,
  MAX(event_time) AS session_end,
  COUNT(*) AS page_count,
  CONCAT_WS(' → ', COLLECT_LIST(page_url)) AS user_journey
FROM step3
GROUP BY user_id, session_seq
ORDER BY user_id, session_seq;
为什么不能把 COLLECT_LIST 写在 OVER (...) 里?
在 Hive / Spark SQL 中,窗口函数(OVER 子句)和聚合函数(GROUP BY)不能在同一层 SELECT 里混用。上面这个错误写法会直接报 AnalysisException。正确做法就是像上面这样:先在 CTE 里用窗口函数算好 session_seq,再在外层 GROUP BY 时把 COLLECT_LIST 当聚合函数用。
这段 SQL 的关键细节
1. 为什么用 1800 秒而不是其他值
1800 秒 = 30 分钟,这是 Google Analytics 的默认会话超时时间。你可以根据自己的业务调整:如果是工具类产品(用户可能开着页面半天不动),可以设成 60 分钟;如果是电商导购站,15 分钟可能更合理。但不要设成 0------那样每次请求都是新会话,路径就没意义了。
2. ROWS BETWEEN 的写法
第三步的累加求和必须用 ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW,这是从分区第一行累加到当前行的意思。在 Hive/Spark 里,不写这个 frame clause,默认行为可能不是你想要的。
3. COLLECT_LIST 去重问题
如果用户在同一会话里反复访问同一个页面(比如来回切换两个 tab),COLLECT_LIST 会保留所有重复。如果你只想看路径骨架,可以用 COLLECT_SET,但那样会丢失顺序。我的建议是保留顺序,分析时再决定是否去重。
不同数据仓库的写法差异
| 引擎 | 时间差函数 | 拼接数组函数 | 注意事项 |
|---|---|---|---|
| Hive / Spark SQL | UNIX_TIMESTAMP 相减 | CONCAT_WS + COLLECT_LIST | 需要手动指定 window frame |
| BigQuery | TIMESTAMP_DIFF | STRING_AGG | 原生支持 ARRAY_AGG |
| PostgreSQL | EXTRACT(EPOCH FROM ...) | STRING_AGG | 窗口函数语法标准 |
| ClickHouse | date_diff('second', ...) | groupArray | 性能最好,适合大数据量 |
一个常见误区
误区: 把跨天的访问也算成同一会话。
**说明:**30 分钟不活动规则下,如果用户前一天晚上 11:50 访问,第二天凌晨 00:20 又访问,中间隔了 30 分钟以上,SQL 会正确切成两个会话。但如果你按 dt 分区查询,每天单独跑一次,就会把前一天的最后一条记录和第二天的第一条记录当成两条独立记录------这本身是对的。问题出在你如果做跨天分析,要把多天数据 union 起来再跑这套 SQL,而不是每天跑完再拼。
最后
用户路径分析的质量,取决于会话切分的准确性。这套 LAG + SUM 累加的写法是标准做法,不依赖特定工具。在网站行为分析方案中,建议把这段 SQL 封装成一个视图,后续做路径转化、流失分析都直接基于这个视图。
FAQ
Q1:会话超时时间设多少合适?
A:参考 GA 的 30 分钟作为起点。工具类产品可以放宽到 60 分钟,电商导购类可以收紧到 15 分钟。关键是全网站统一一个值,不要不同页面设不同值。
Q2:怎么验证切出来的会话是对的?
A:抽样 10 个用户,手动对比原始日志。看同一个 user_id 下,相邻两条记录的 gap 是否都 ≤30 分钟,会话之间的 gap 是否都 >30 分钟。
Q3:用户关掉浏览器再打开,算同一会话吗?
A:GA4 的会话不是靠 cookie 判断的,而是由 session_start 事件和 30 分钟不活动超时共同决定:用户关闭浏览器后 30 分钟内再次访问,且没有触发新的 session_start,会归入同一会话;超过 30 分钟不活动,自动开启新会话。纯靠服务端日志分析时,没有 session_start 事件,就只能用 user_id + 时间窗口(30 分钟)来近似切分。
Q4:数据量很大时这段 SQL 慢怎么办?
A:先按 user_id 做 distribute by,再做窗口函数。或者用 ClickHouse 这类列存引擎,性能会好一个数量级。
参考资料
- Google Analytics 官方文档. About Analytics Sessions(默认30分钟超时). support.google.com.
- Hive 语言手册. Window Functions 与 OVER clause.
- BigQuery 文档. TIMESTAMP_DIFF 与 ARRAY_AGG.