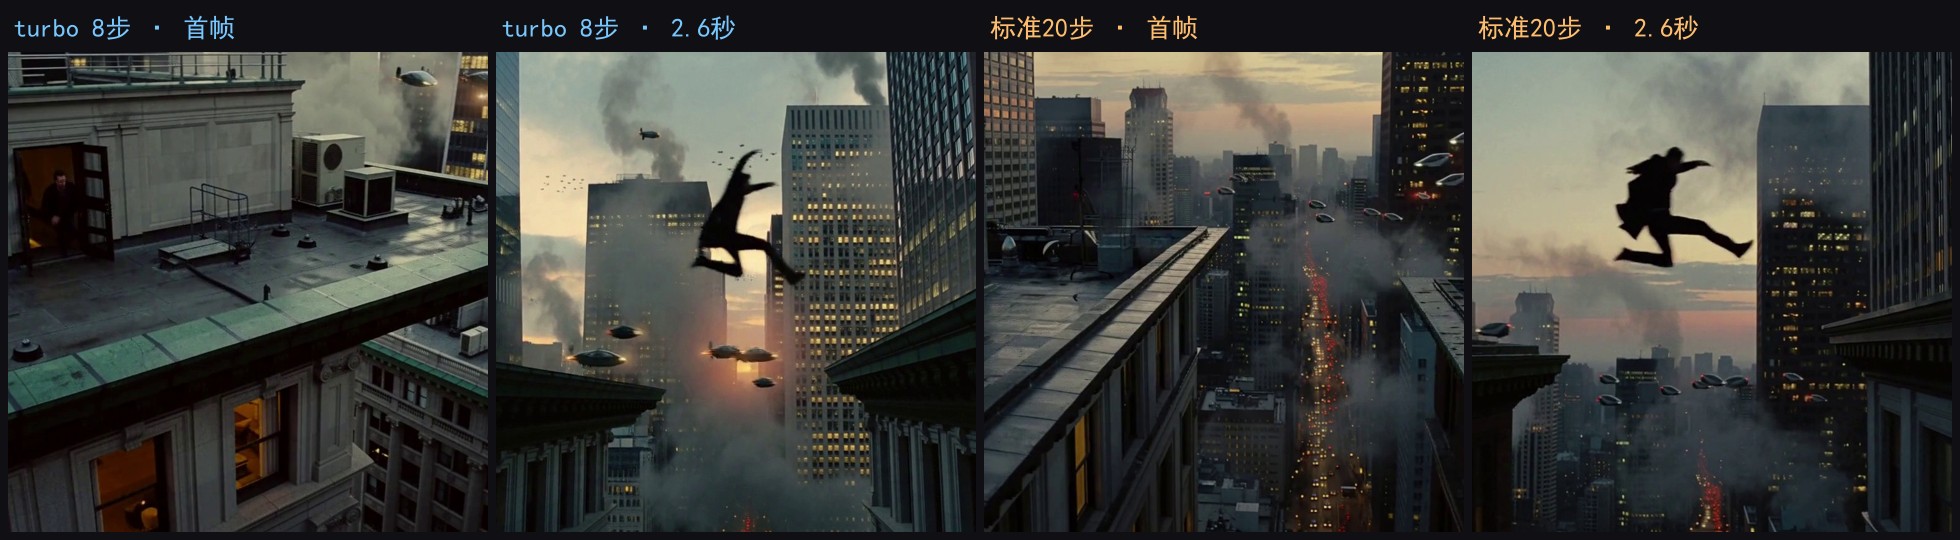
MiniMax H3 是最近讨论度最高的视频生成模型:文生视频、图生视频一个模型全包,生成的视频原生自带立体声音轨(风声、脚步、配乐和画面一起生成,不是后期贴上去的)。很多同学的顾虑是------官方模型动辄 20G+,我这张 12G 的显卡是不是就无缘了?
本篇实测给你答案:12G 显存的 RTX 4070 Ti,跑 21G 的 int8 量化版 H3,一次生成 5 秒 1344×768 带720p 音轨的视频,全程无爆显存,turbo 加速档 5 分 14 秒出片。所有参数、模型放置目录、工作流 JSON 都在文末,照抄就能跑。
一、效果先看
同一段提示词(黄昏都市天台追逃动作片分镜,含音效描述),固定种子,两种采样档位各跑一遍:
| 档位 | 耗时 | 说明 |
|---|---|---|
| turbo 8 步(挂 LoRA) | 5 分 14 秒 | 出片快,动态略柔和 |
| 标准 20 步 | 11 分 49 秒 | 细节更锐利(楼宇窗格、烟雾层次) |
视频规格一致:1344×768、24fps、124 帧(5.17 秒)、带立体声音轨。两种档位是官方工作流自带的开关,不是民间魔改------要不要挂 turbo LoRA、跑几步,改一个参数就行。
两个完整成片 mp4(含音轨)和对比图都打包在文末下载区,可以直接下载到本地播放看细节。
二、环境与模型准备
我的环境:官方便携版 ComfyUI v0.39.0 + RTX 4070 Ti(12G)+ 64G 内存。H3 是 v0.39 内置原生支持的,不需要装任何自定义节点,这对新手非常友好。
模型一共 4 个必装 + 1 个可选加速,按下面的目录放好(ComfyUI/models/ 对应子目录):
| 模型文件 | 大小 | 放置目录 | 说明 |
|---|---|---|---|
| minimax_h3_fl2va_pruned_int8_convrot.safetensors | 21.0 GB | diffusion_models | 主模型(int8 量化版,低显存首选)官方下载页 |
| qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 15.7 GB | text_encoders | 文本编码器(40 系显卡实测可跑)官方下载页 |
| minimax_h3_video_vae_int8_convrot.safetensors | 2.81 GB | vae | 视频 VAE(模板默认这个,别下成 fp16 版)点击下载自动带提取码 |
| minimax_h3_audio_vae_fp32.safetensors | 0.61 GB | vae | 音频 VAE(出声就靠它)官方下载页 |
| minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors(可选) | 1.96 GB | loras | turbo 8 步加速 LoRA 点击下载自动带提取码 |
所有模型我都传了城通网盘备份,官方源也一并给出(HF 链接国内把 huggingface.co 换成 hf-mirror.com 可直连),点对应链接即可下载。
12G 显存为什么跑得动 21G 的模型? ComfyUI 会自动把放不下的权重卸载到内存,我的实测内存占用 40G+------所以内存 32G 以下不建议尝试这个量化版本,显存反而不是瓶颈。
三、跑起来只要三步
工作流我导出了两个版本(文末下载),都是官方模板摊平后的形态,直接拖进 ComfyUI 界面:
第 1 步:装模型。 按上面表格把 4+1 个文件放进对应目录,文件名保持一致。
第 2 步:载入工作流。 拖入 minimax_h3_t2v_工作流.json(原版,带子图,需要 ComfyUI v0.39+),或者直接用我摊平好的 API 版本。
第 3 步:写提示词,点运行。 H3 的提示词写法和图片模型不一样,推荐模板自带的结构------一段总述 + 分镜脚本(每个镜头标时间区间)+ 一段 Audio 描述,例如官方示例的骨架:
画面总述:实拍电影质感、镜头类型、整体氛围......

Scene overview: (一句话说清这场戏发生了什么)

Storyboard (each shot a separate scene):
[0s-1.5s] Shot 1: 高角度侧拍:主角在天台边缘狂奔,追兵出现在身后的天台门口......
[1.5s-3s] Shot 2: 主角跃过两栋楼之间的间隙,身体腾空,慢动作感......
[3s-5s] Shot 3: ......

Camera: 每个镜头各自的角度,硬切不叠化......

Audio: 风声、急促脚步声、城市环境音,低音配乐在 4 秒处爆发......
关键参数不用动:分辨率 1344×768(模型原生画布,短边 768)、124 帧/24fps(5 秒时长按 17k+5 网格对齐)、采样器 res_multistep、调度 simple、denoise 1.0。唯一值得动的是步数:要快就开 turbo 开关挂 LoRA 跑 8 步,要细节就关掉跑 20 步。
四、实测踩坑(都是我趟过的)
1. 视频 VAE 别下错版本。 官方仓库有 int8_convrot 和 fp16 两个视频 VAE,官方模板默认挂的是 int8_convrot(还更省显存)。下成 fp16 版轻则报错重则默默解码异常。
2. 模型没下完也能出现在下拉框里。 ComfyUI 的模型下拉只看文件是否存在、不看是否下完。LoRA 还剩最后几百 MB 时它就会出现在列表里,这时候点运行必炸。提交前确认文件大小和官方页面对得上。
3. 内存比显存先成为瓶颈。 12G 显存全程没爆(自动 offload),但内存峰值 40G+。8G 显存的卡可以再等等更强的量化版,内存不足 32G 的别硬上。
4. 首次运行慢是正常的。 21G 模型从硬盘加载要 38 秒左右,之后每次采样约 35 秒/步。跑批量任务时别频繁重启 ComfyUI,模型缓存能省一半时间。
五、下载汇总
工作流与成片(城通网盘,点击自动带提取码):
- minimax_h3_t2v_工作流.json(官方原版)
- minimax_h3_t2v_turbo_API.json(turbo 8 步摊平版)
- minimax_h3_t2v_标准20步_API.json(标准档摊平版)
- MiniMax_H3_turbo_00001_.mp4(turbo 成片,含音轨)
- MiniMax_H3_default_00001_.mp4(标准 20 步成片,含音轨)
- compare_turbo_vs_default.jpg(两种档位对比图)
模型文件见上表,每个模型双链接:官方页 + 城通网盘备份。
模型许可证:MiniMax H3 模型按官方仓库许可使用,生成的视频用途请遵守其条款。
你有 12G 显存吗?跑通了的欢迎在评论区晒图;卡在哪一步的,把报错贴出来我帮你看。