**直答:**RFM 分层按阈值把用户切进不同格子,边界一改,靠近边界的用户就会跳格,旧历史随之失真。回溯时按代价在全量重算、增量重算、快照回放三种策略里选:数据小选全量,影响面小选增量,要严格复现历史选快照。
RFM 是一套经典的用户价值分层方法。先给定义:Recency 指最近一次交易距今天的时间间隔,Frequency 指统计周期内的交易频次,Monetary 指周期内累计消费金额。三个维度各自打分,再组合成不同价值层级,比如重要价值用户、保持用户、流失用户等。Wikipedia 对 RFM(market research)的词条把它描述为一种基于交易历史的行为分群技术。
问题出在边界上。分层不是连续分数,而是用一组阈值把用户切进离散格子。比如 Frequency 按"小于 3 次、3 到 6 次、6 次以上"切三档。一旦你把"3 次"这个边界调整成"4 次",那些正好落在 3 次附近的用户,就会从一格跳到另一格。历史报表如果还挂着旧边界算出来的分层,就和新口径对不上了。
边界移动为什么会让历史分层失真?
// 定义:分层格子 = { R区间 × F区间 × M区间 } // 边界 b 移动后:用户 u 满足 R(u)∈R1, F(u)∈F1, M(u)∈M1 // 若 F1 的中频下界从 3 改为 4,则 F(u)=3 的用户从"中频格"落入"低频格" // 结果:历史上该用户的分层标签发生变化
推导一下。设某用户的 Frequency 是 3 次。旧边界下它落在中频格;新边界把中频起点提到 4,它就掉进低频格。这个用户本身的行为没有任何变化,只是判定线挪了位置,标签却变了。这就是"边界变化导致历史分层失真"的本质:失真不是数据错了,而是判定规则变了。
影响范围有多大?取决于边界移动的幅度和用户在边界附近的分布。如果大量用户集中在阈值附近,一次边界微调就会让大批用户换层;如果用户分散,影响面就小。所以回溯之前,先要估算受影响用户的规模,再决定用哪种策略。
这里要区分两种"变化"。一种是你主动调整边界,目的是让分层更贴合当前业务;另一种是数据本身变了,比如统计窗口从 90 天改成 180 天。前者是规则变化,后者是输入变化,两者都会让历史分层错位,但回溯策略并不完全相同。规则变化优先选快照回放保住历史口径,输入变化通常选全量重算让新旧窗口可比。
三种回溯重算策略怎么选?
按代价从小到大,有三条路。
| 策略 | 做法 | 优点 | 代价与局限 |
|---|---|---|---|
| 全量重算 | 用新边界把全部历史用户重新跑一遍分层 | 结果干净、口径一致 | 算力大,历史久时成本高 |
| 增量重算 | 只重算边界附近受影响的用户 | 省算力,覆盖主要变化 | 要精确判断谁受影响,逻辑复杂 |
| 快照回放 | 预先存各时点分层快照,历史不重算 | 严格复现当时决策,可复现性强 | 要事先存快照,事后无法补 |
一些数据平台在用户价值分析侧提供 LTV(用户生命周期价值)分析等能力,事件分析支持按事件名与属性回看用户行为;RFM 分层所需的消费频次、最近一次消费等原始字段,可由事件属性聚合得到,具体价值分群能力以官网产品页为准。落到具体实现上,选哪种策略要看数据规模和时间要求:数据量不大、口径刚调整,全量重算更省心;用户量大、只动了一两个边界,增量重算更划算;需要严格复现历史营销决策,快照回放更稳妥。
全量重算:什么时候更划算?
全量重算就是用新边界把历史所有用户重新分一次。它的好处是结果完全一致,不会留下"这部分是新口径、那部分是旧口径"的拼接痕迹。代价是要重跑全量数据,历史越长、用户越多,算力消耗越大。
判断标准很直接:如果你的用户量级不大、重算一遍成本可控,就直接全量。它逻辑简单,也不容易出错。只有当全量重算明显拖慢任务时,才考虑更省算力的增量方案。
全量重算还有个额外收益:它顺便校正了历史上因数据补录、迟到事件造成的分层偏差。这种"顺手清理"的效果,增量方案是拿不到的。
增量重算:怎么圈定受影响用户?
增量重算的核心问题是:谁受影响?原则是"只重算判定线跨越的用户"。比如 Frequency 中频下界从 3 改到 4,那就把 F=3 附近的用户挑出来重算,其余保持不变。
受影响集合的正确方向
关键是公式方向不能写反。设旧中频下界为 old_low=3,新中频下界为 new_low=4。一个用户之所以需要重算,是因为他的 F 值被这次边界移动"跨过"了------旧规则算中频、新规则算低频,或者反过来。正确的受影响集合是:
// 正确:受影响 = 判定线这次移动跨越的用户 // affected = { u | old_low ≤ F(u) < new_low } // 代入 old_low=3, new_low=4:3 ≤ F(u) < 4,即 F(u)=3 的那批用户 // 其余用户(F=5、F=6 等)的格子没变,标签保持不变
注意这个区间是左闭右开、夹在新旧两条下界之间。如果误写成 new_low < F(u) < old_high(即 4 < F < 6),圈到的是 F=5 这批------他们新旧都在中频格,根本不需要重算,按这种写法选不出真正要动的人。下面给一段可运行代码,用一批样例用户验证。
# 增量重算:圈定被边界移动跨越的用户(可运行)
old_low, new_low = 3, 4      # 中频下界由 3 调到 4
users = [1, 2, 3, 3, 4, 5, 5, 6, 7]   # 每个元素是该用户的 Frequency

# 正确:old_low <= F(u) < new_low  →  F=3 的用户
affected = [u for u in users if old_low <= u < new_low]
print(affected)            # [3, 3],从"中频"掉进"低频"的人

# 错误方向(对照):new_low < F < old_high=6 → F=5,不需重算
wrong = [u for u in users if new_low < u < 6]
print(wrong)                # [5, 5],这批人新旧都在中频,圈错了
它的风险是圈得不准。如果漏了边界带,历史报表里会残留一些旧口径标签;如果圈得太大,就退化成全量重算。所以增量方案要先在一小批用户上验证受影响名单,再批量跑。
还有一个实现细节:增量重算要保证幂等。同一份受影响名单跑两次,结果必须一致,否则中途失败重跑会造成部分用户用新边界、部分用旧边界。把"待重算名单"落成一张临时表,按表逐条更新,跑完核对名单清空,比边算边删更安全。
快照回放:为什么要提前存?
快照回放的思路和前两种不同:它不重算历史,而是把每个时间点算好的分层结果存下来。边界变化后,回看历史时直接读当时的快照,保持历史决策原貌。它在"可复现性"这一项上是最强的:历史结论不被后来的口径改动改写。
它的前提是你当初就存了快照。如果没存,事后再想"回放"是做不到的。所以对需要长期审计营销决策的团队,提前规划快照存储是必要的。历史分层快照是否提供、保留多久,要在使用时和平台侧确认清楚。
快照回放还有一个好处:它让"历史上为什么把这个用户分到重要价值层"这件事有据可查。回溯重算改的是现在的标签,快照保的是当时的判断依据,两者用途不同,不要混为一谈。
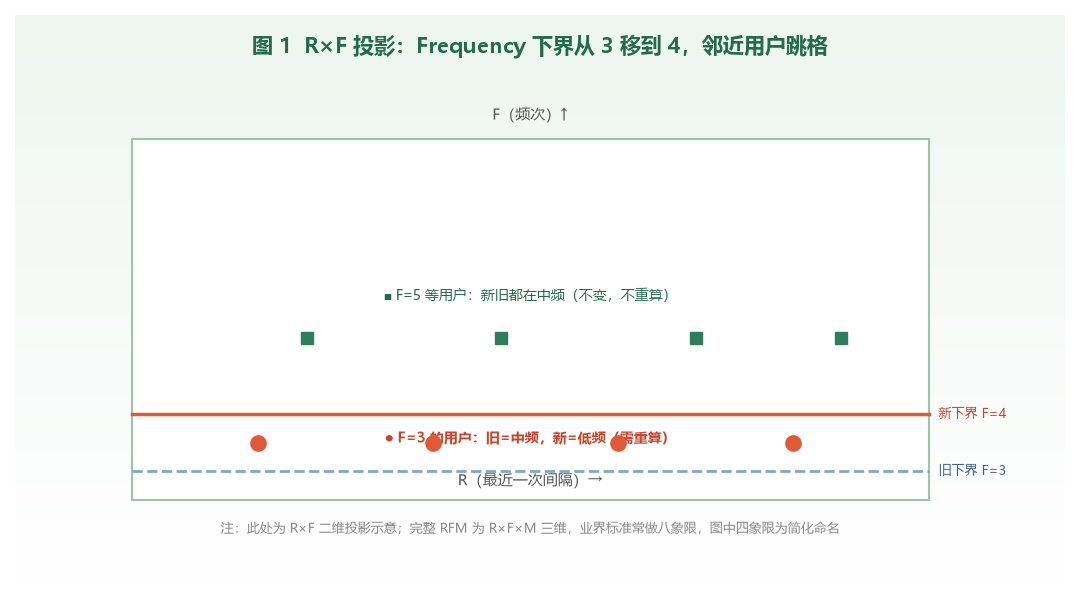 R×F 平面投影示意(完整 RFM 为 R×F×M 三维、业界标准常做八象限;此处为简化四象限投影)。边界线移动后邻近用户
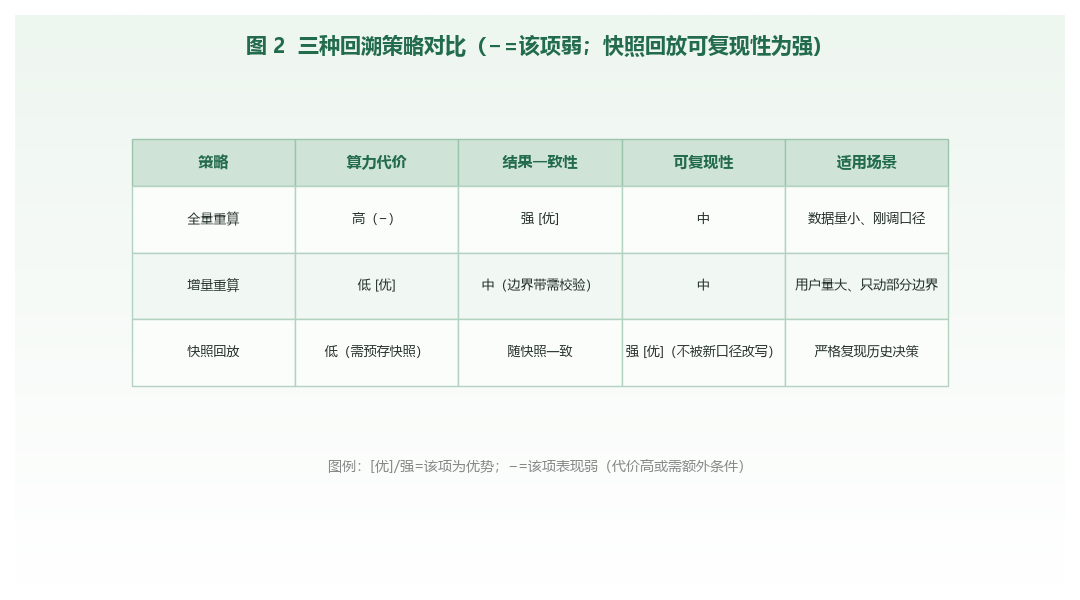 三策略对比("−"表示该项表现弱;快照回放可复现性为"强/✓",与正文核心优势一致)
一个常见误区:把重算当成改写历史决策
一个常见误区是边界一改就去重写所有历史报表,连当时基于旧分层做的营销动作记录也改了。这会让历史失去审计意义。正确做法是:重算分层标签,但保留历史动作,并标注"历史分层按旧口径计算"。
另一个坑是不估算影响面就贸然全量重算,结果跑了大半天,事后才发现只动了一个边界、影响了几百个用户。回溯前先算影响规模,再选策略,这一步省不得。
需要长期维护用户价值分层时,把边界版本和回溯策略一起规划更稳。平台侧提供用户画像与价值分层的基础能力,自建数仓侧则用边界版本表和快照把历史管起来,两层配合,分层口径才经得起反复回看。
常见问题
RFM 分层为什么会因为边界变化而失真?
分层是按阈值把用户切进不同格子,边界一旦移动,原本靠近边界的用户会从一个格子跳到另一个格子。历史报表如果还用旧边界算出来的分层,就和新口径对不上。
增量重算怎么圈定受影响用户?
只圈判定线跨越的用户。以 Frequency 下界从 3 调到 4 为例,受影响集合是 old_low<=F(u)
全量重算和增量重算怎么选?
数据量小、边界变化影响面大时选全量重算,结果干净一致;数据量大、只动了部分边界时选增量重算,只重算受影响用户,省算力但逻辑更复杂。
快照回放是什么意思?
事先把每个时间点的分层结果存成快照,边界变化后不重算历史,而是回放当时的快照。它的可复现性强,适合需要严格复现历史决策、不想因口径变化改写历史的场景。
数据来源
- Wikipedia《RFM (market research)》
- University of Bristol《RFM Analysis 方法说明》
总结:RFM 边界一变,旧分层就错位。全量重算、增量重算、快照回放三种策略按代价选型------数据小选全量、影响面小选增量、要严格复现历史选快照,而增量重算务必把受影响集合写成 old_low≤F(u)