文章目录
- 一、概念简述
-
- [1.1 手动恢复主从:为什么不靠谱](#1.1 手动恢复主从:为什么不靠谱)
- [1.2 哨兵是什么](#1.2 哨兵是什么)
- [1.3 哨兵自动恢复流程](#1.3 哨兵自动恢复流程)
- [1.4 哨兵的核心功能](#1.4 哨兵的核心功能)
- 二、实战搭建
-
- [2.1 配置主从节点](#2.1 配置主从节点)
- [2.2 配置哨兵节点](#2.2 配置哨兵节点)
- [2.3 模拟主节点故障](#2.3 模拟主节点故障)
- [2.4 旧主节点恢复](#2.4 旧主节点恢复)
- 三、故障转移的原理
-
- [3.1 主观下线与客观下线](#3.1 主观下线与客观下线)
- [3.2 选举 leader 哨兵](#3.2 选举 leader 哨兵)
- [3.3 leader 如何挑选新的主节点](#3.3 leader 如何挑选新的主节点)
- [3.4 新主确定之后](#3.4 新主确定之后)
- 四、总结与局限
一、概念简述
上一篇讲了主从复制,它提高了读的并发和可用性,但留下了一个致命的问题:主节点挂了怎么办? 从节点不会自动晋升为主节点,整个系统就没法写了。哨兵(Sentinel) 就是用自动化的手段解决这个问题的。
1.1 手动恢复主从:为什么不靠谱
主节点挂了之后,如果靠人工处理,流程是这样的:
- 监控系统报警,通知程序员。
- 程序员登录上去看看,能不能抢救。
- 抢救不了,就从从节点里挑一个作为新的主节点,执行
slaveof no one。 - 修改其他从节点,通过
slaveof让它们认新的主节点。 - 告知客户端,让它们连接新的主节点。
- 旧主节点修好之后,作为一个新的从节点挂回集群。
这样的手动修复有两个问题:
- 繁琐,容易出错:步骤多,一旦出错后果更严重。
- 慢:即使程序员第一时间响应,也需要一段时间,这段时间系统是不可写的。
1.2 哨兵是什么
- 哨兵是独立的进程(
redis-sentinel),不负责存储数据 ,只负责监控。 - 哨兵通常不是单个,而是一个集合(后面会解释原因)。
- 它监控的是 Redis 的数据节点(主节点和从节点),并在主节点出问题时自动处理。
1.3 哨兵自动恢复流程
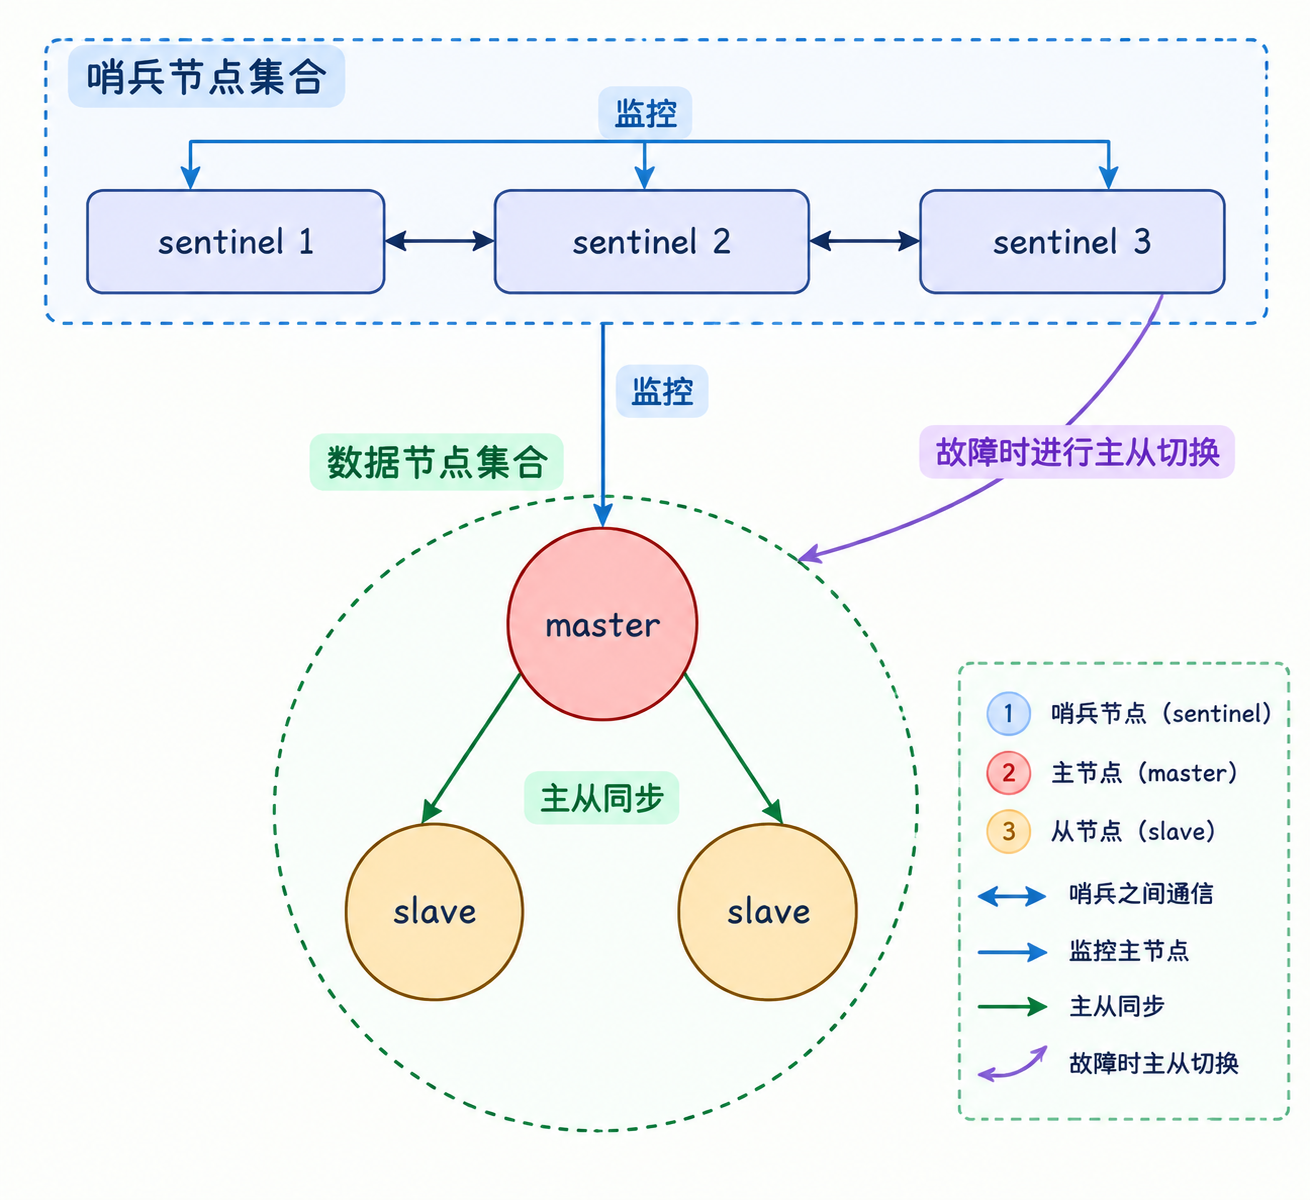
- 哨兵节点不断给 Redis 数据节点发送心跳包(
PING),检测是否正常。 - 主节点挂了,一个哨兵发现后,还需要多个哨兵认同,才能确认主节点真的挂了,以防误判。
- 哨兵们选举出一个 leader,由它来负责这次故障转移。
- leader 从从节点中挑选出新的主节点 ,自动控制它执行
slaveof no one,并控制其他从节点执行slaveof,改认新的主节点。 - 客户端通过哨兵得知新的主节点是谁,之后的写操作就会发给新的主节点。
- 旧主节点恢复后,哨兵会自动把它变成新主节点的从节点。
1.4 哨兵的核心功能
-
监控:持续检查主节点、从节点是否正常。
-
自动故障转移:主节点挂了,自动选出新主,并调整主从关系。
-
通知:把故障转移的结果通知给客户端(和管理员)。
-
细节:客户端其实不会直接写死 Redis 的地址,而是先连哨兵,问它当前的主节点是谁 (
sentinel get-master-addr-by-name),所以哨兵还承担了"配置提供者"的角色。
为什么哨兵一个节点也能完成完整的功能,却还要部署多个?
① 哨兵本身也可能挂 :如果只有一个哨兵,它挂了,这时候再碰上 Redis 主节点也挂了,就没人做自动恢复了。分布式系统中应当避免出现单点。
② 误判的概率高 :网络传输容易延迟、丢包,一个哨兵连不上主节点,不代表主节点真挂了,可能只是这个哨兵到主节点的网络有问题。需要多个哨兵投票 才能降低误判。
哨兵节点为什么最好是奇数个?
哨兵的决策都是靠多数派(超过半数)达成的。3 个哨兵,多数是 2,允许挂 1 个;4 个哨兵,多数是 3,还是只允许挂 1 个。多出来的那一个并没有提升容错能力,反而多了一份开销。所以选奇数个(3、5)就够了。
二、实战搭建
准备 6 个节点:1 主 2 从 + 3 哨兵 ,使用Docker Compose来搭建。
注意:这里为了演示,把所有节点放在同一台服务器上。实际应用中,所有节点放在一台服务器上是没有意义的(服务器挂了就全挂了),应该分布在不同的主机上。
2.1 配置主从节点
创建master-slave/docker-compose.yml:
yaml
version: '3.7'
services:
  master:
    image: 'redis:5.0.9'
    container_name: redis-master
    restart: always
    command: redis-server --appendonly yes
    ports:
      - 6379:6379
  slave1:
    image: 'redis:5.0.9'
    container_name: redis-slave1
    restart: always
    command: redis-server --appendonly yes --slaveof redis-master 6379
    ports:
      - 6380:6379
  slave2:
    image: 'redis:5.0.9'
    container_name: redis-slave2
    restart: always
    command: redis-server --appendonly yes --slaveof redis-master 6379
    ports:
      - 6381:6379
启动容器:
bash
docker-compose up -d- 细节:
--slaveof redis-master 6379中直接使用了容器名,因为同一个docker网络内,容器之间可以通过名字互相访问。
2.2 配置哨兵节点
创建redis-sentinel/docker-compose.yml:
yaml
version: '3.7'
services:
  sentinel1:
    image: 'redis:5.0.9'
    container_name: redis-sentinel-1
    restart: always
    command: redis-sentinel /etc/redis/sentinel.conf
    volumes:
      - ./sentinel1.conf:/etc/redis/sentinel.conf
    ports:
      - 26379:26379
  sentinel2:
    image: 'redis:5.0.9'
    container_name: redis-sentinel-2
    restart: always
    command: redis-sentinel /etc/redis/sentinel.conf
    volumes:
      - ./sentinel2.conf:/etc/redis/sentinel.conf
    ports:
      - 26380:26379
  sentinel3:
    image: 'redis:5.0.9'
    container_name: redis-sentinel-3
    restart: always
    command: redis-sentinel /etc/redis/sentinel.conf
    volumes:
      - ./sentinel3.conf:/etc/redis/sentinel.conf
    ports:
      - 26381:26379

networks:
  default:
    external:
name: master-slave_default- 注意:
networks这一段是让哨兵容器加入主从节点所在的网络(master-slave_default),这样哨兵才能通过容器名访问到redis-master。
再创建sentinel1.conf、sentinel2.conf、sentinel3.conf三份文件,内容完全相同 ,都放在/root/redis-sentinel/目录中:
bash
bind 0.0.0.0
port 26379
sentinel monitor redis-master redis-master 6379 2
sentinel down-after-milliseconds redis-master 1000
逐行解释:
bind 0.0.0.0:允许任意地址访问。port 26379:哨兵的端口(Redis 默认是 6379,哨兵默认是 26379)。sentinel monitor <名字> <ip> <port> <quorum>:<名字>:给被监控的主节点起的名字,这里叫redis-master。<ip> <port>:主节点的地址,这里用的是容器名。<quorum>:法定票数。至少有多少个哨兵认为主节点挂了,才会判定为客观下线。这里是 2,通常设为"哨兵总数的一半加一"。
sentinel down-after-milliseconds <名字> <毫秒>:多久收不到心跳回复,就认为主节点"主观下线"。这里设为 1000ms,是为了演示效果;实际默认是 30000ms。
细节:
- 三份配置文件必须是三份独立的文件,不能共用一个。 因为哨兵运行时会改写自己的配置文件(记录自己的 id、发现的从节点和其他哨兵等信息)。
- 配置里只写了主节点,没有写从节点和其他哨兵,因为哨兵会自动发现 :通过主节点的
info命令得到所有从节点,再通过主节点上的发布订阅频道互相发现其他哨兵。 - 说明:用容器名作为
<ip>是演示的写法,Redis 6.2+ 需要额外配置resolve-hostnames yes才支持主机名,生产环境建议直接写 IP。
启动哨兵:
bash
docker-compose up -d2.3 模拟主节点故障
手动把主节点停掉:
bash
docker stop redis-master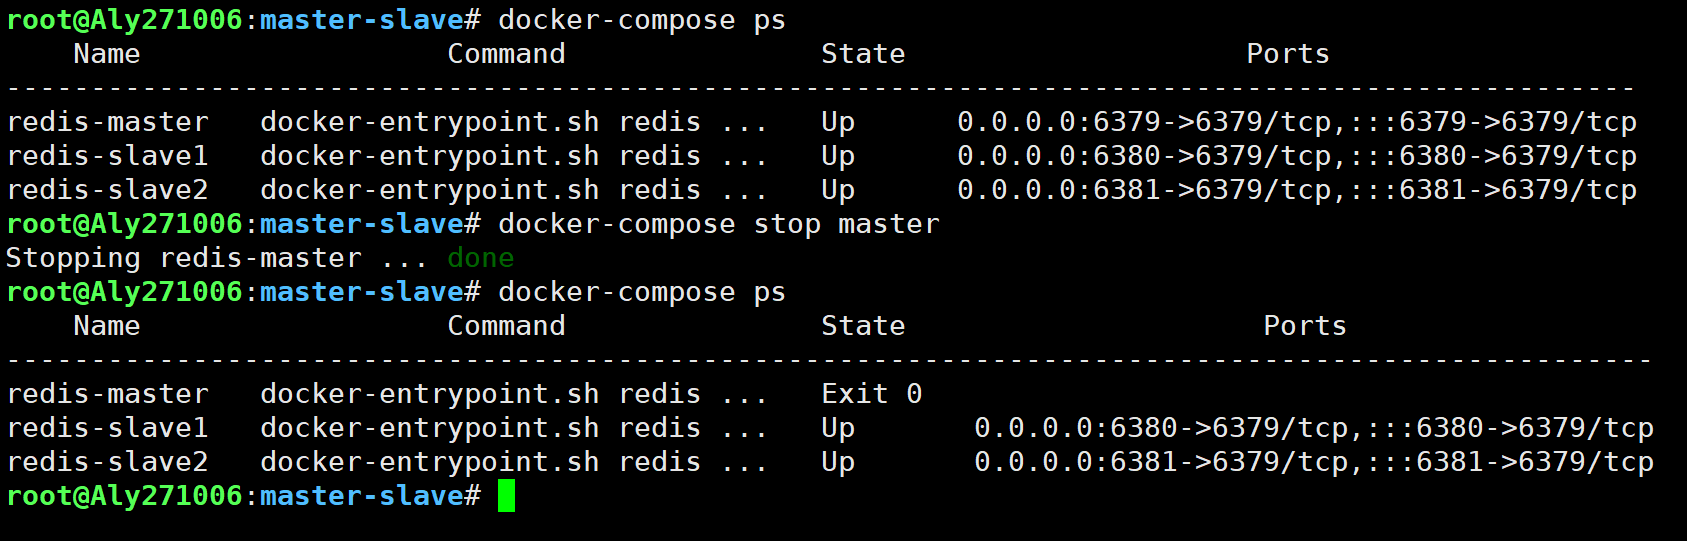
主节点一挂,哨兵节点就开始工作了。在哨兵的目录下用docker-compose logs查看哨兵节点的工作情况:
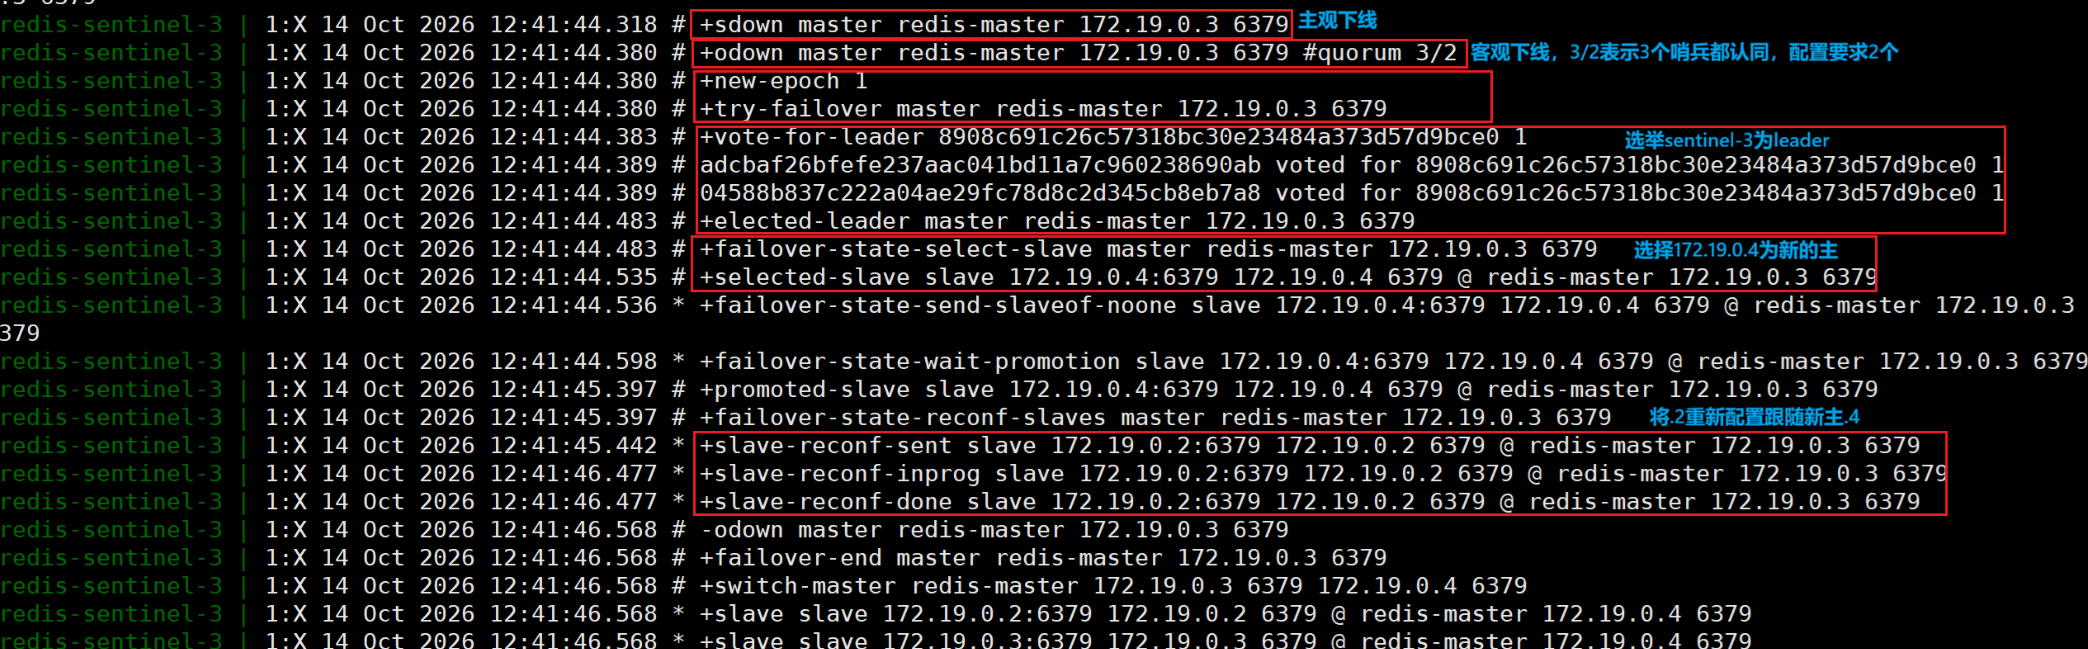
日志里几个关键的事件,正好对应故障转移的过程:
| 日志事件 | 含义 |
|---|---|
+sdown |
主观下线:这个哨兵认为主节点挂了 |
+odown |
客观下线:达到法定票数,确认主节点挂了 |
+try-failover |
开始尝试故障转移 |
+vote-for-leader/ +elected-leader |
哨兵之间投票,选出 leader |
+selected-slave |
leader 选中了某个从节点作为新主 |
+promoted-slave |
该从节点已晋升为主节点 |
+switch-master |
主节点切换完成,通知客户端新主节点的地址 |
2.4 旧主节点恢复
再把原来的主节点启动起来,观察它的状态:
bash
docker-compose start master
redis-cli -p 6379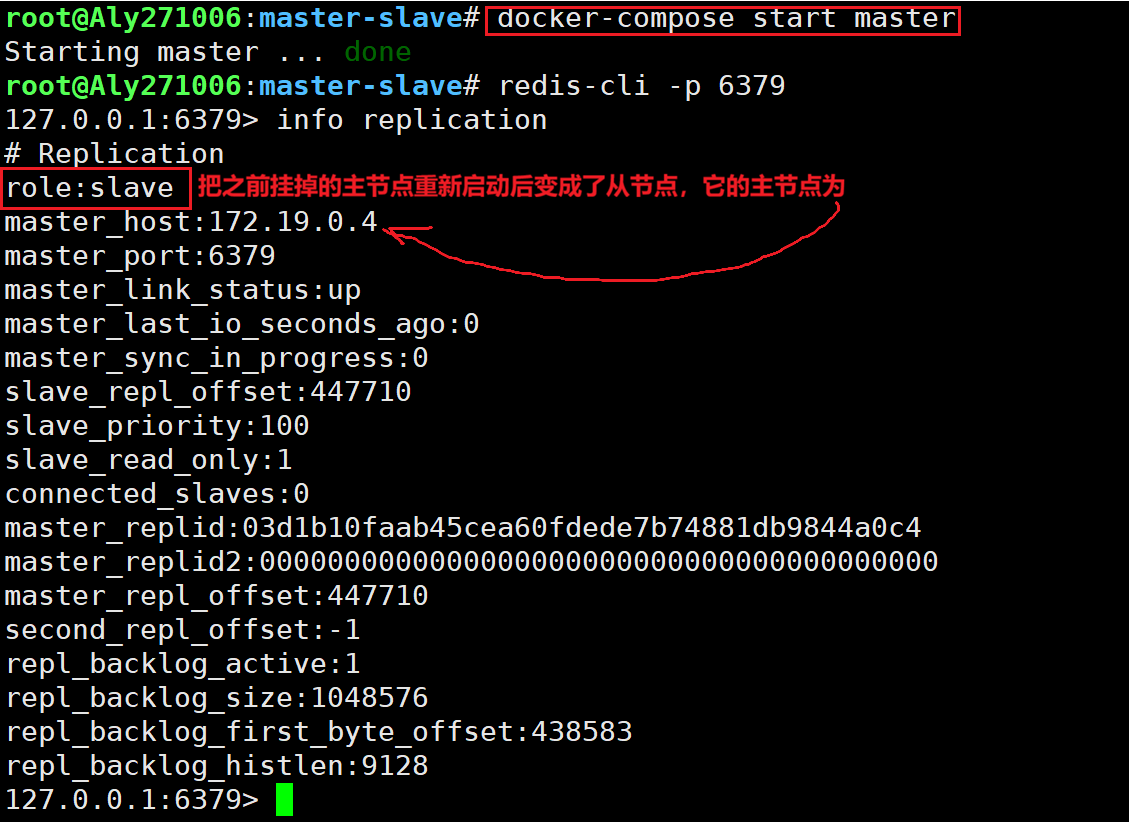
可以发现,旧的主节点恢复后变成了从节点,挂在新的主节点下面,没有"抢回"主节点的位置。这也是哨兵自动完成的,不需要人工干预。
三、故障转移的原理
哨兵重新选择主节点,大致分三步:判定主节点挂了 → 选出 leader 哨兵 → leader 选出新的主节点。
3.1 主观下线与客观下线
- 主观下线(SDOWN):一个 哨兵给节点发的心跳包,在
down-after-milliseconds内没有收到有效回复,这个哨兵就单方面认为该节点挂了。 - 客观下线(ODOWN):主观下线只是一个哨兵的看法,可能误判。它会询问其他哨兵,认为主节点挂了的哨兵数量达到了法定票数(quorum),才算客观下线,才能开始故障转移。
这里的"挂"不一定是进程崩了,只要是无法正常访问,都可以视为是挂了(比如网络不通、进程卡死)。
3.2 选举 leader 哨兵
确认主节点客观下线后,需要由一个哨兵来执行故障转移,不能多个哨兵各干各的,所以要先选出 leader。
举个例子:1 号哨兵最先发现主节点客观下线,它就向其他哨兵发起投票请求,给自己投一票;另外两个哨兵也给 1 号哨兵投了一票,1 号哨兵得票过半,成为 leader。本质上是谁反应快、谁先发起,谁就更容易当选。(这里用的是 Raft 算法的简化版)
- 细节:
quorum只决定"能不能判定客观下线";真正执行故障转移,还需要这个 leader 得到==多数(超过哨兵总数一半)哨兵的授权==。这也是哨兵要部署奇数个的原因。
3.3 leader 如何挑选新的主节点
leader 会去从节点中挑选一个作为新的主节点,先排除掉不健康的节点(已经下线、断线太久的),剩下的按下面三个条件依次比较:
- 优先级 :每个 Redis 数据节点在配置文件中都有一个优先级配置(
replica-priority,默认 100),值越小优先级越高(设为 0 表示永远不会被选为主节点)。 - offset(复制偏移量) :优先级相同,就看同步进度,offset 越大说明数据越新,越容易胜出。
- run id :前两项都一样,就看 run id,字典序最小的胜出。run id 是每个 Redis 节点启动时随机生成的一串字符,这里只是为了保证最终能选出唯一的节点。
为什么要看 offset?
因为主从复制是异步的,从节点的数据可能落后于旧主节点。选 offset 最大的,意味着选出的新主丢失的数据最少。
3.4 新主确定之后
- leader 让被选中的节点执行
slaveof no one,晋升为主节点。 - leader 让其他从节点执行
slaveof 新主节点,改认新的主节点。(默认一次只让 1 个从节点去同步,避免新主压力过大,由parallel-syncs配置) - 哨兵把新主节点的信息通知给客户端(
+switch-master)。 - 旧主节点恢复后,被设置为新主节点的从节点。
四、总结与局限
哨兵 = 主从复制 + 自动故障转移 ,解决了主节点挂了需要人工处理的问题,提高了系统的可用性。但它依然有局限:
- 写能力和容量没有提升:写操作依然只能在一个主节点上,每个节点保存的还是全量数据,受单机内存限制。
- 切换期间有短暂的不可用:从主节点挂了,到新主节点选出来,这段时间内写操作是失败的。
- 可能丢数据:主从复制是异步的,旧主节点上还没来得及同步给从节点的数据,在切换后会丢失。
要解决写能力和存储容量的问题,就需要把数据分片 存储到多组节点上,这就是下一篇要讲的 Redis 集群(Cluster)。
非常感谢您能耐心读完这篇文章。倘若您从中有所收获,还望多多支持呀!🎉