Spring AI+Vue3 企业知识库设计:让每个答案有依据,让每份资料守住权限
🌐 文档地址 :https://ruoyioffice.com
👇 文章底部获取源码和演示地址 👇
💬 :17156169080(获取产品咨询)
本文由 RuoYi Office 团队整理,结合实际项目分享企业软件的设计思路与开发经验。
员工问:"我下周去外地参加客户验收,交通和住宿该按哪个标准申请?"知识库很快给出了完整答案,但引用的是去年的制度,还混入了只向管理层开放的补充说明。文字再流畅,这也不是一次合格的企业问答。真正要解决的,是让答案使用正确范围内、正确版本的资料,并让读者可以核验依据。
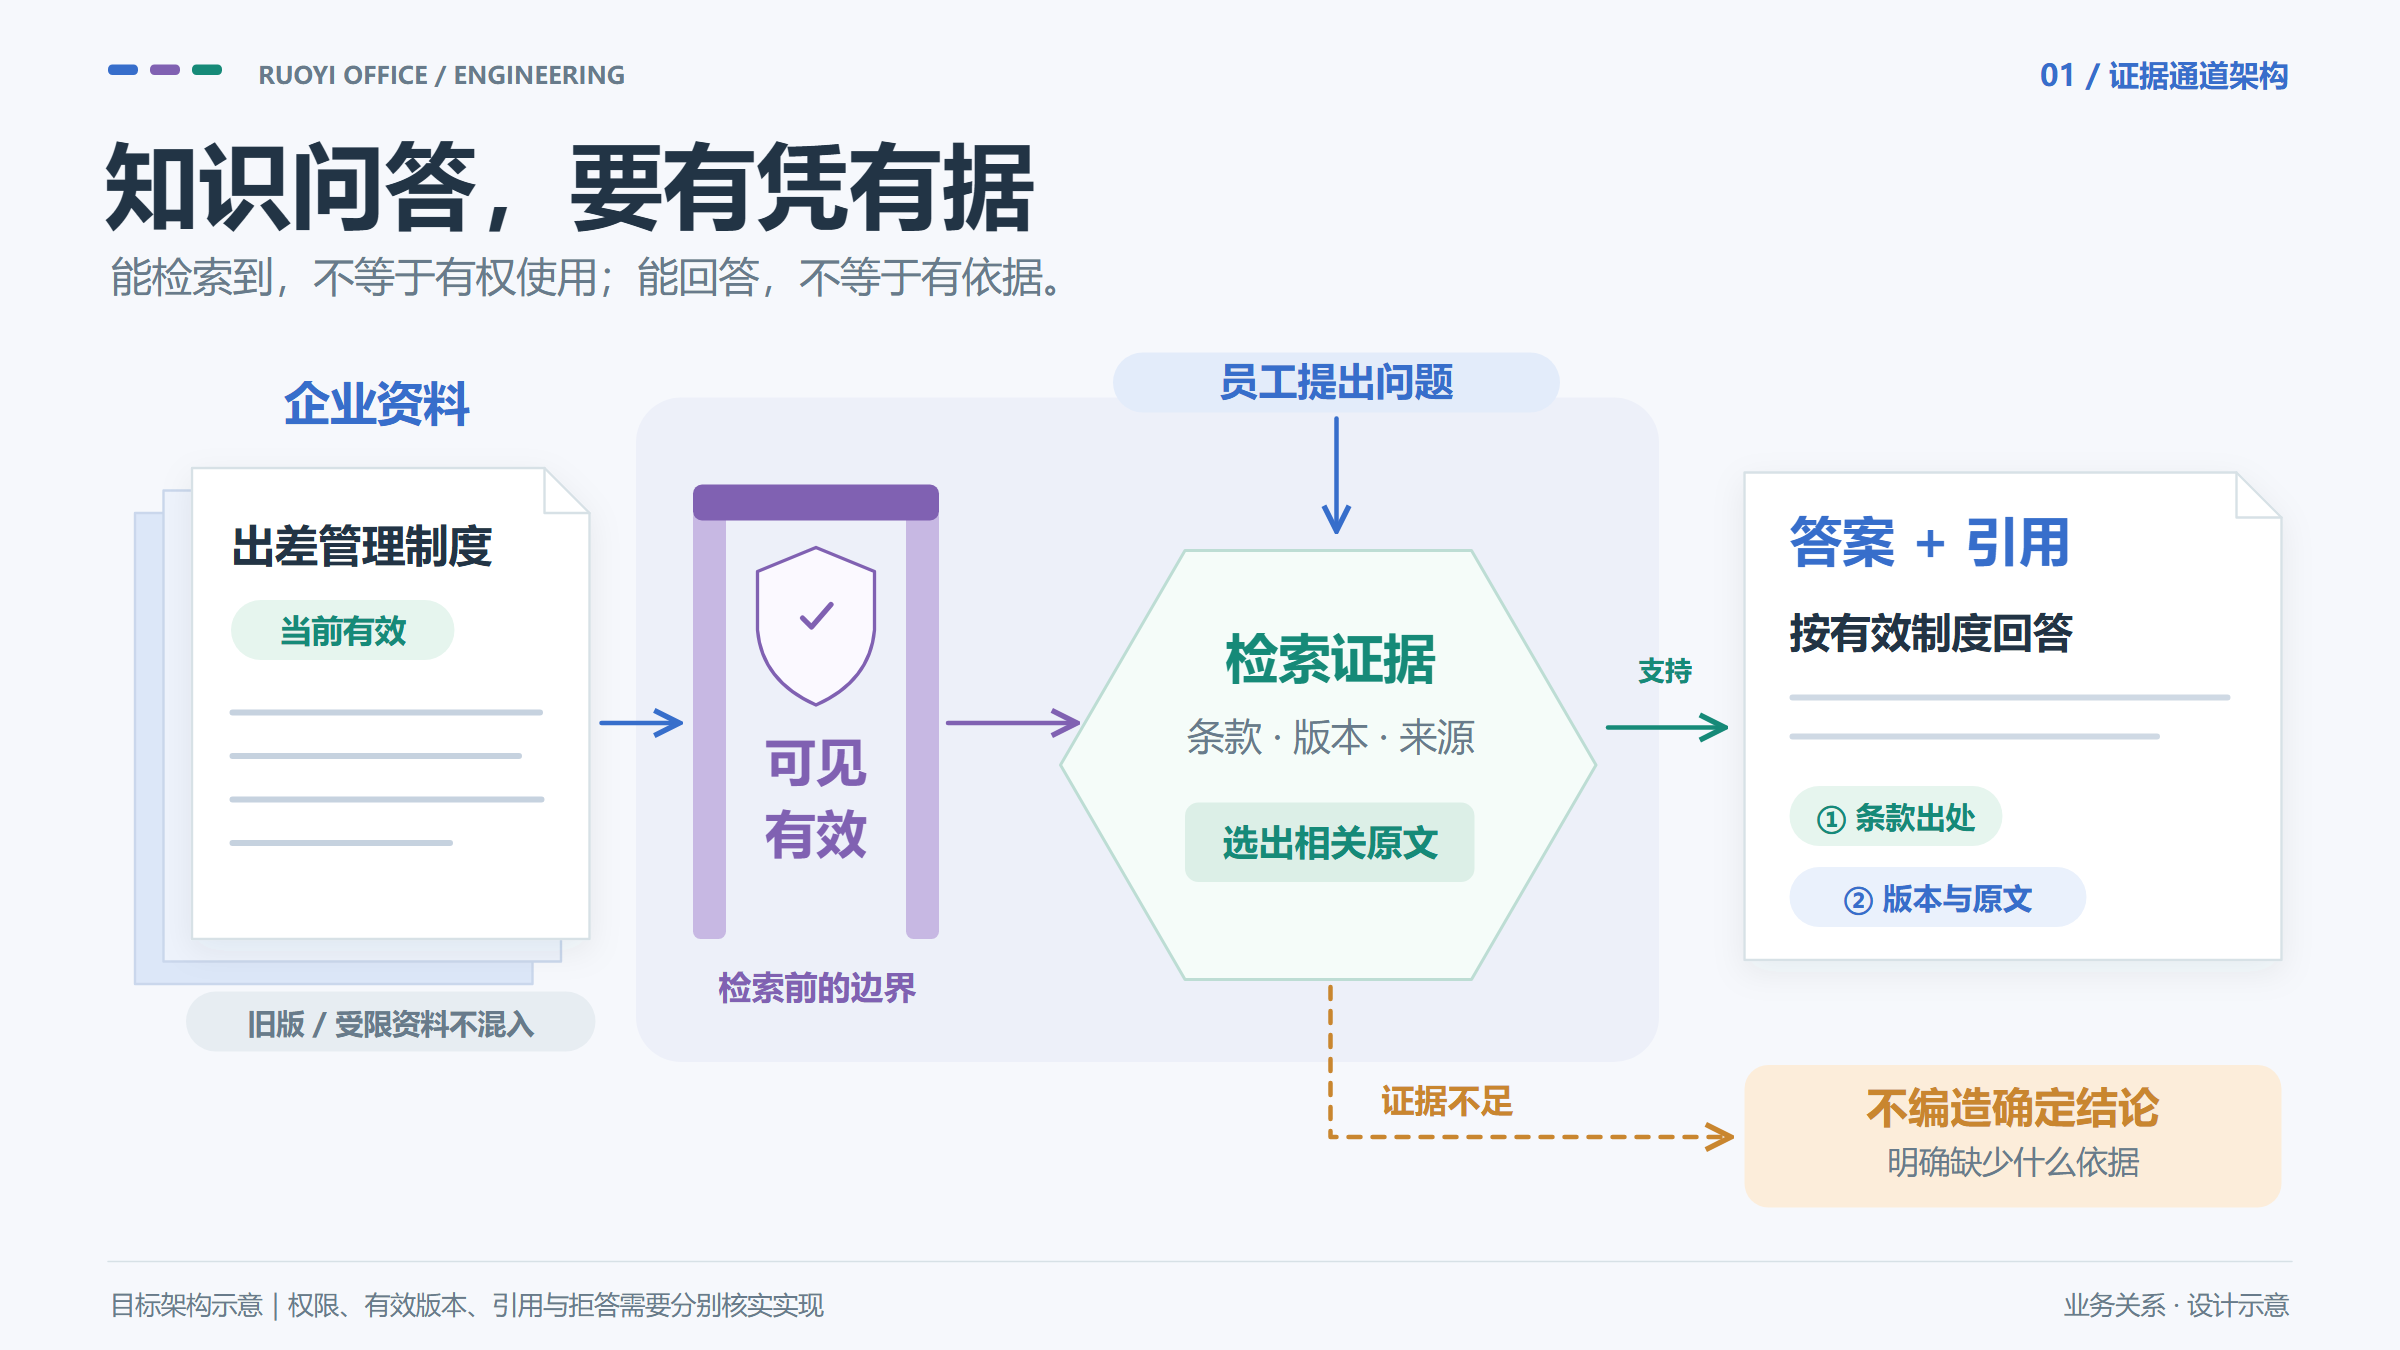
▲ 目标架构示意:资料先经过可见性和有效性筛选,再成为回答证据;证据不足时应明确说明,而不是补出一个看似合理的结论。
一、企业知识问答的难点,不是再多接一个模型
RAG,即检索增强生成,是先检索与问题相关的资料,再让模型结合资料组织回答。它能缓解模型不知道企业内部信息的问题,但并不自动解决"这份资料能不能给这个人看""现在还是否有效""引用是否真正支持结论"等问题。
在企业场景里,资料通常同时具有内容属性和管理属性。两份标题相近的制度,可能分别属于不同子公司;同一个操作手册,可能保留着适用不同产品版本的分支;一份合同模板,可能包含内部谈判说明。把它们都转成向量,不能抹掉这些差别。
因此,企业知识问答至少包含三层责任:**业务确定资料边界,检索寻找有效证据,模型组织可解释的表达。**如果把三层责任全部交给一句提示词,系统就很难证明自己在权限变更、资料更新和问题歧义时仍然正确。
| 用户看到的现象 | 实际缺失的能力 | 应当验证什么 |
|---|---|---|
| 回答引用了旧制度 | 缺少生效与适用范围判断 | 当前问题适用哪个版本 |
| 普通员工看见内部补充条款 | 内容可见范围未进入检索链路 | 资料是否属于当前主体可见集合 |
| 有引用,但点开不支持结论 | 引用只是装饰性链接 | 原文是否支撑对应断言 |
| 没找到资料仍然回答得很肯定 | 缺少证据不足分支 | 是否区分已知、未知与待确认 |
本文以"查询出差制度"为贯穿案例。讨论的是软件设计,不替企业制定报销政策。制度金额、适用人员和审批要求应来自企业自己的有效文件,而不是由模型凭经验补全。
现有工程给了哪些基础
RuoYi Office 的 AI 模块已经具有知识库配置、文档处理、分段、检索测试和对话中的知识引用组件。源码中的 AiKnowledgeSegmentServiceImpl 会写入知识库、文档、分段标识,按知识库限定向量检索,再根据向量标识回读关系库中的段落记录。
这些能力解决了"资料如何被检索、证据如何回到业务记录"的基础问题。本文进一步讨论的组织级 ACL、制度生效版本、引用点击时重新授权与证据不足策略,应当作为扩展设计核实,不能因为出现了一个知识库过滤条件,就宣称已经完成所有安全治理。
二、先把资料变成可以管理的知识,而不只是上传文件
1. 知识库配置解决检索方式,不代替业务授权
知识库配置页上的模型、召回数量和相似度阈值,属于检索参数。它们影响"从候选资料中找出什么",不直接定义"哪些资料允许成为候选"。这两个问题在产品界面上也应该有清晰分工。
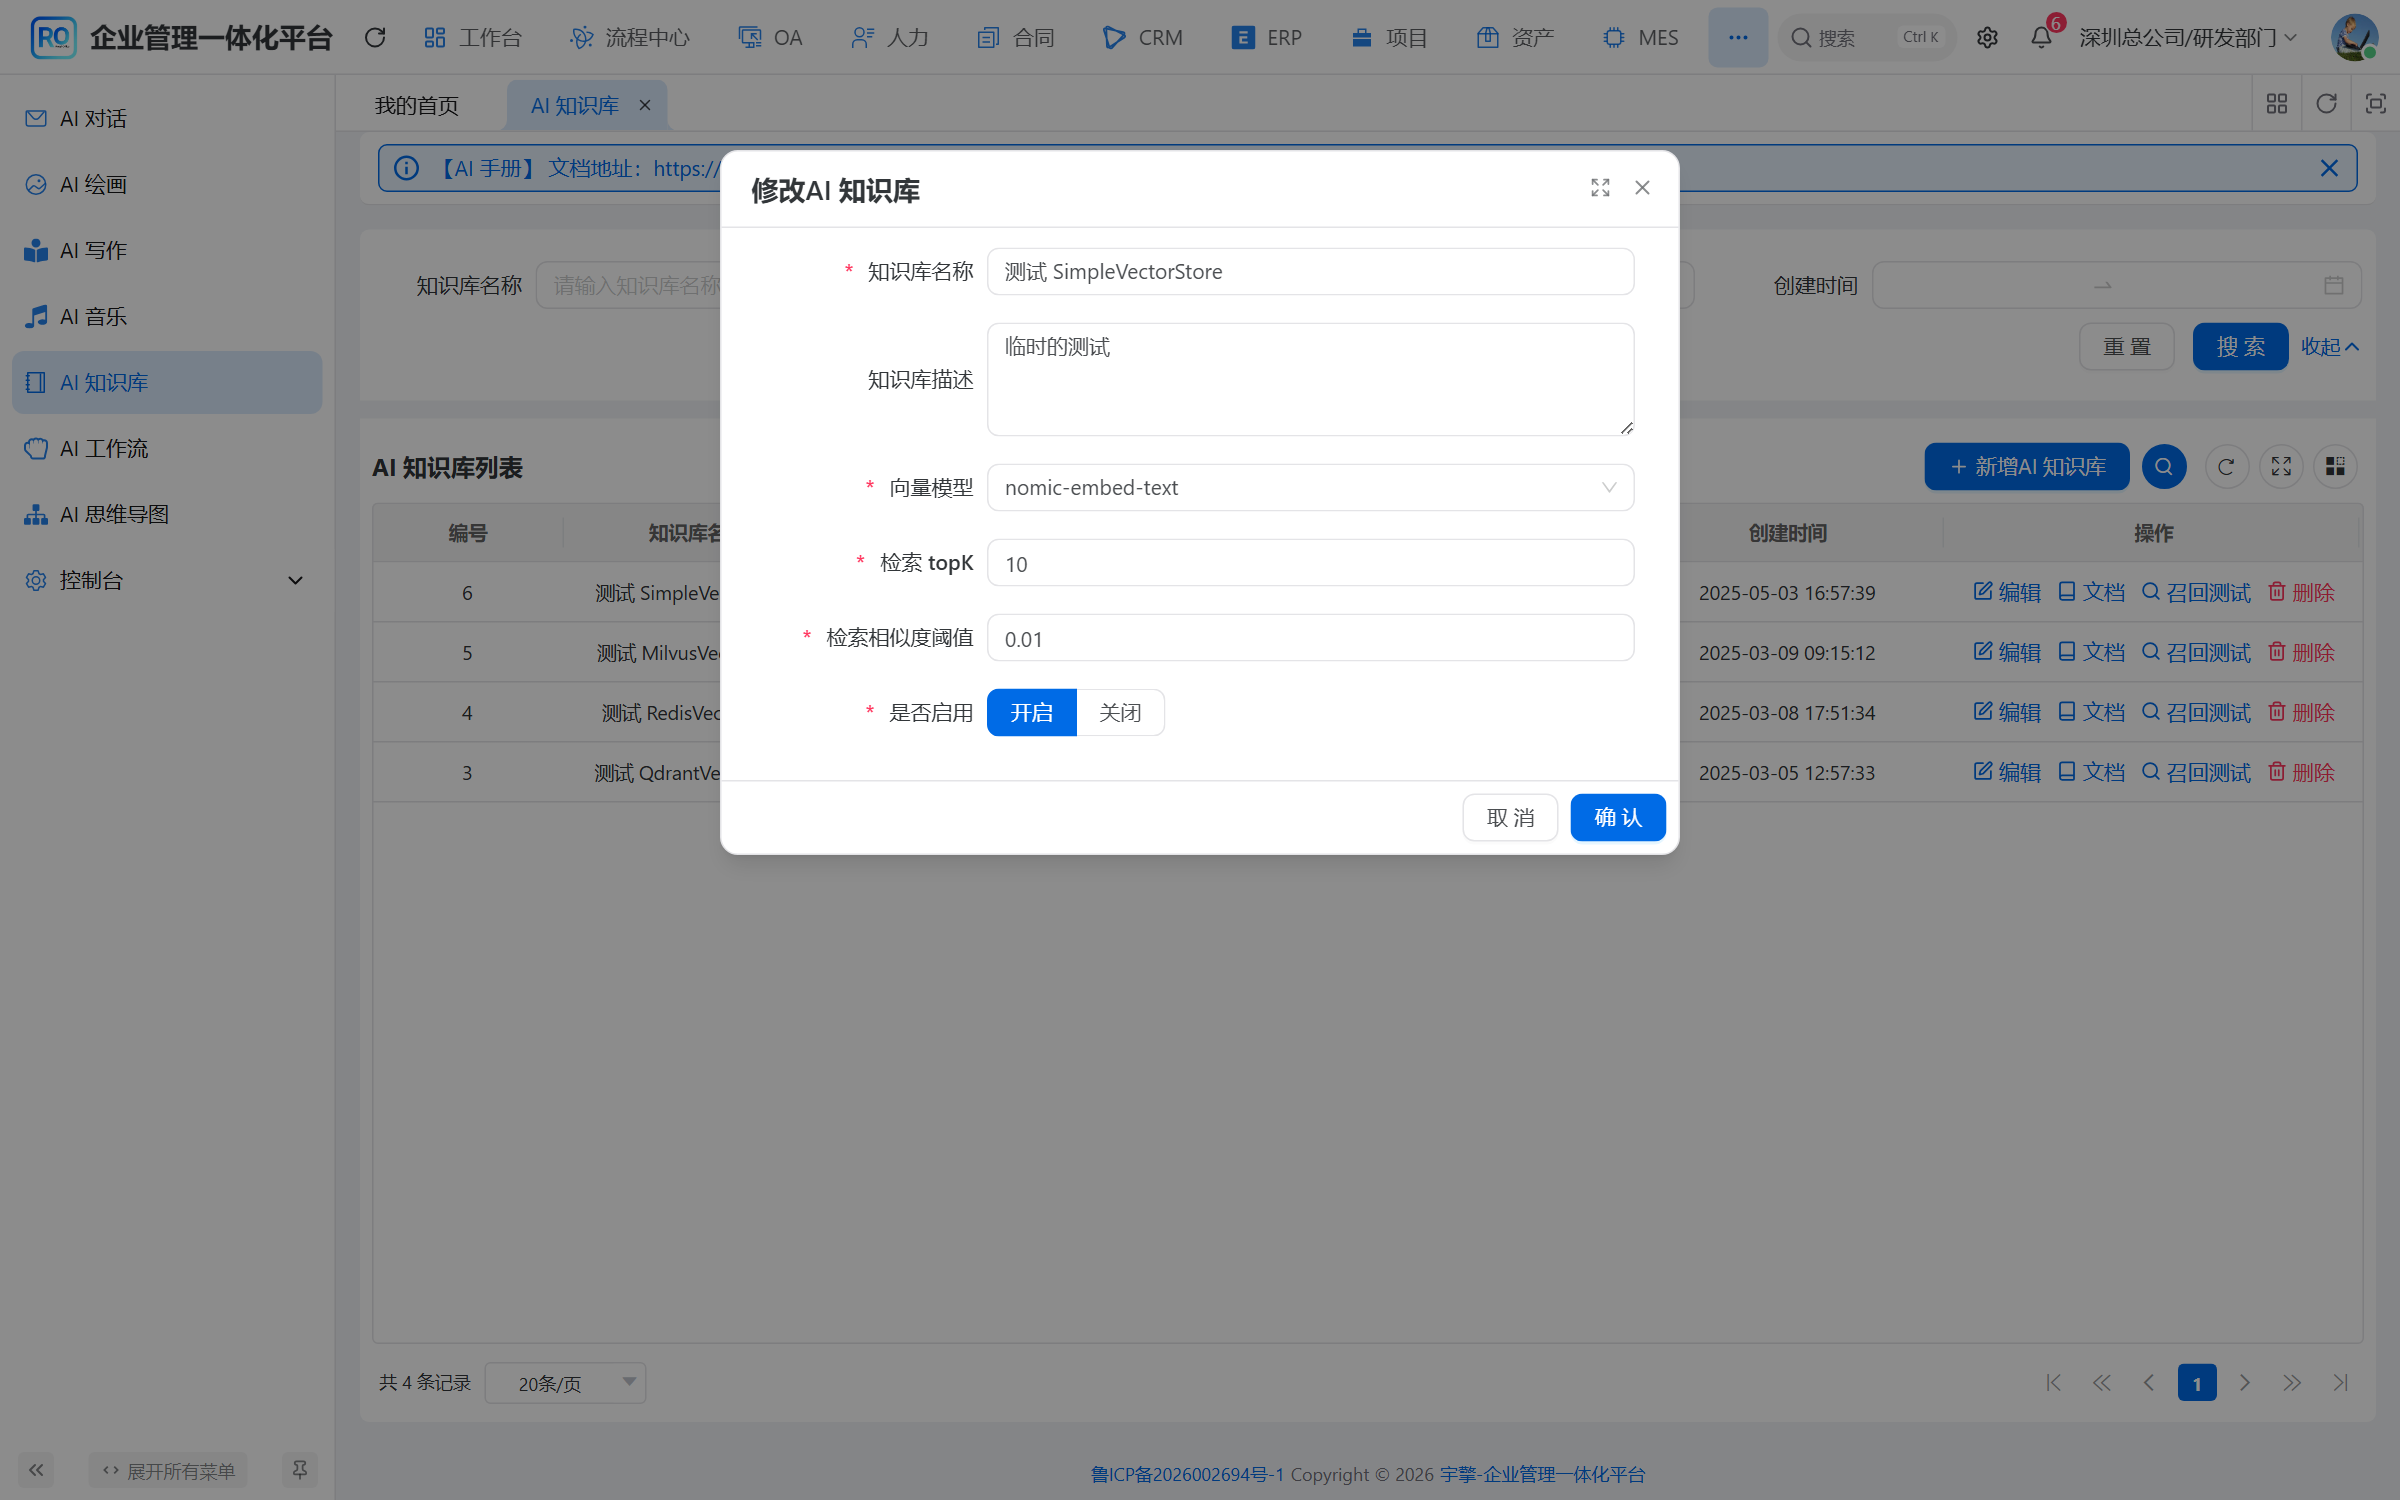
▲ 真实系统配置界面。模型和召回参数是已有入口;组织可见范围与制度有效性不能仅靠这些参数推断。
对制度类知识,管理员还需要给出负责人、适用组织、业务主题、生效时间和替代关系。这里不建议一开始就做庞大的知识本体,而应先确定那些一旦缺失就可能造成错误答案的属性。
例如,问题里只有"出差住宿标准",但资料库存在不同地区和不同职级的规则。系统可以先询问缺少的适用条件,也可以返回带条件的比较说明。直接选择相似度最高的一段给出唯一金额,反而掩盖了资料本身的分支。
2. 文档处理完成,不等于知识已经可以上线
上传、解析、分段、向量写入,是资料进入检索系统的技术过程。业务上的"已发布、可查询"则是另一个决定。两者合并成一个状态,会让解析成功但尚未复核的制度提前参与问答。
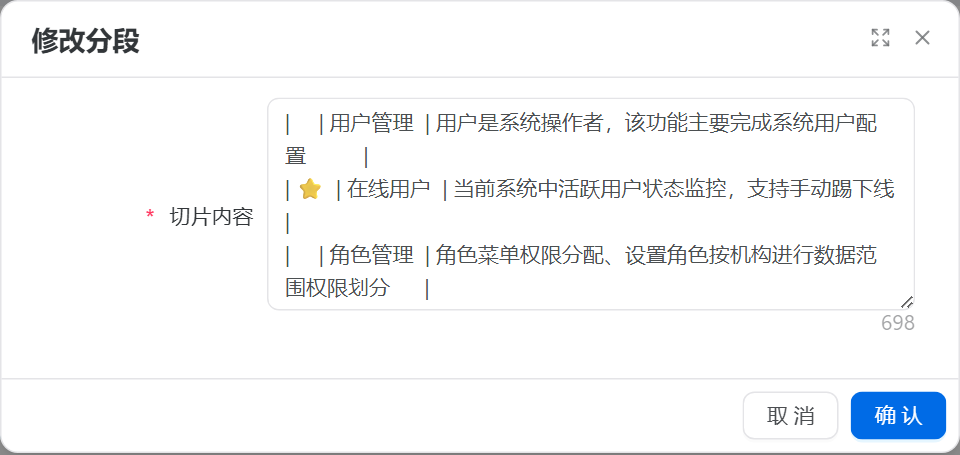
▲ 真实分段编辑页面,用于查看和修订资料内容。本次仅打开查看,未保存更改;该入口不代表已经具备完整的制度发布审批。
一种可落地的设计,是把处理状态和业务状态拆开:处理状态描述解析是否成功、索引是否就绪;业务状态描述草稿、待复核、生效、废止。只有两方面都满足条件,文档版本才进入可检索集合。
旧版资料也不一定应该删除。它可能仍然是解释历史报销单的依据。更合适的方式是保留版本身份,并明确"当前制度问答"和"历史业务核查"是两种查询模式。后一种模式需要显式给定业务日期,不能悄悄与当前查询混用。
3. 分段必须保留回到原文的路径
段落是检索单位,但文档通常才是权限、版本和责任归属的单位。一个段落被命中之后,系统至少应知道它来自哪份文档、哪一版、哪个位置。否则读者看见的只是一段脱离上下文的文字。
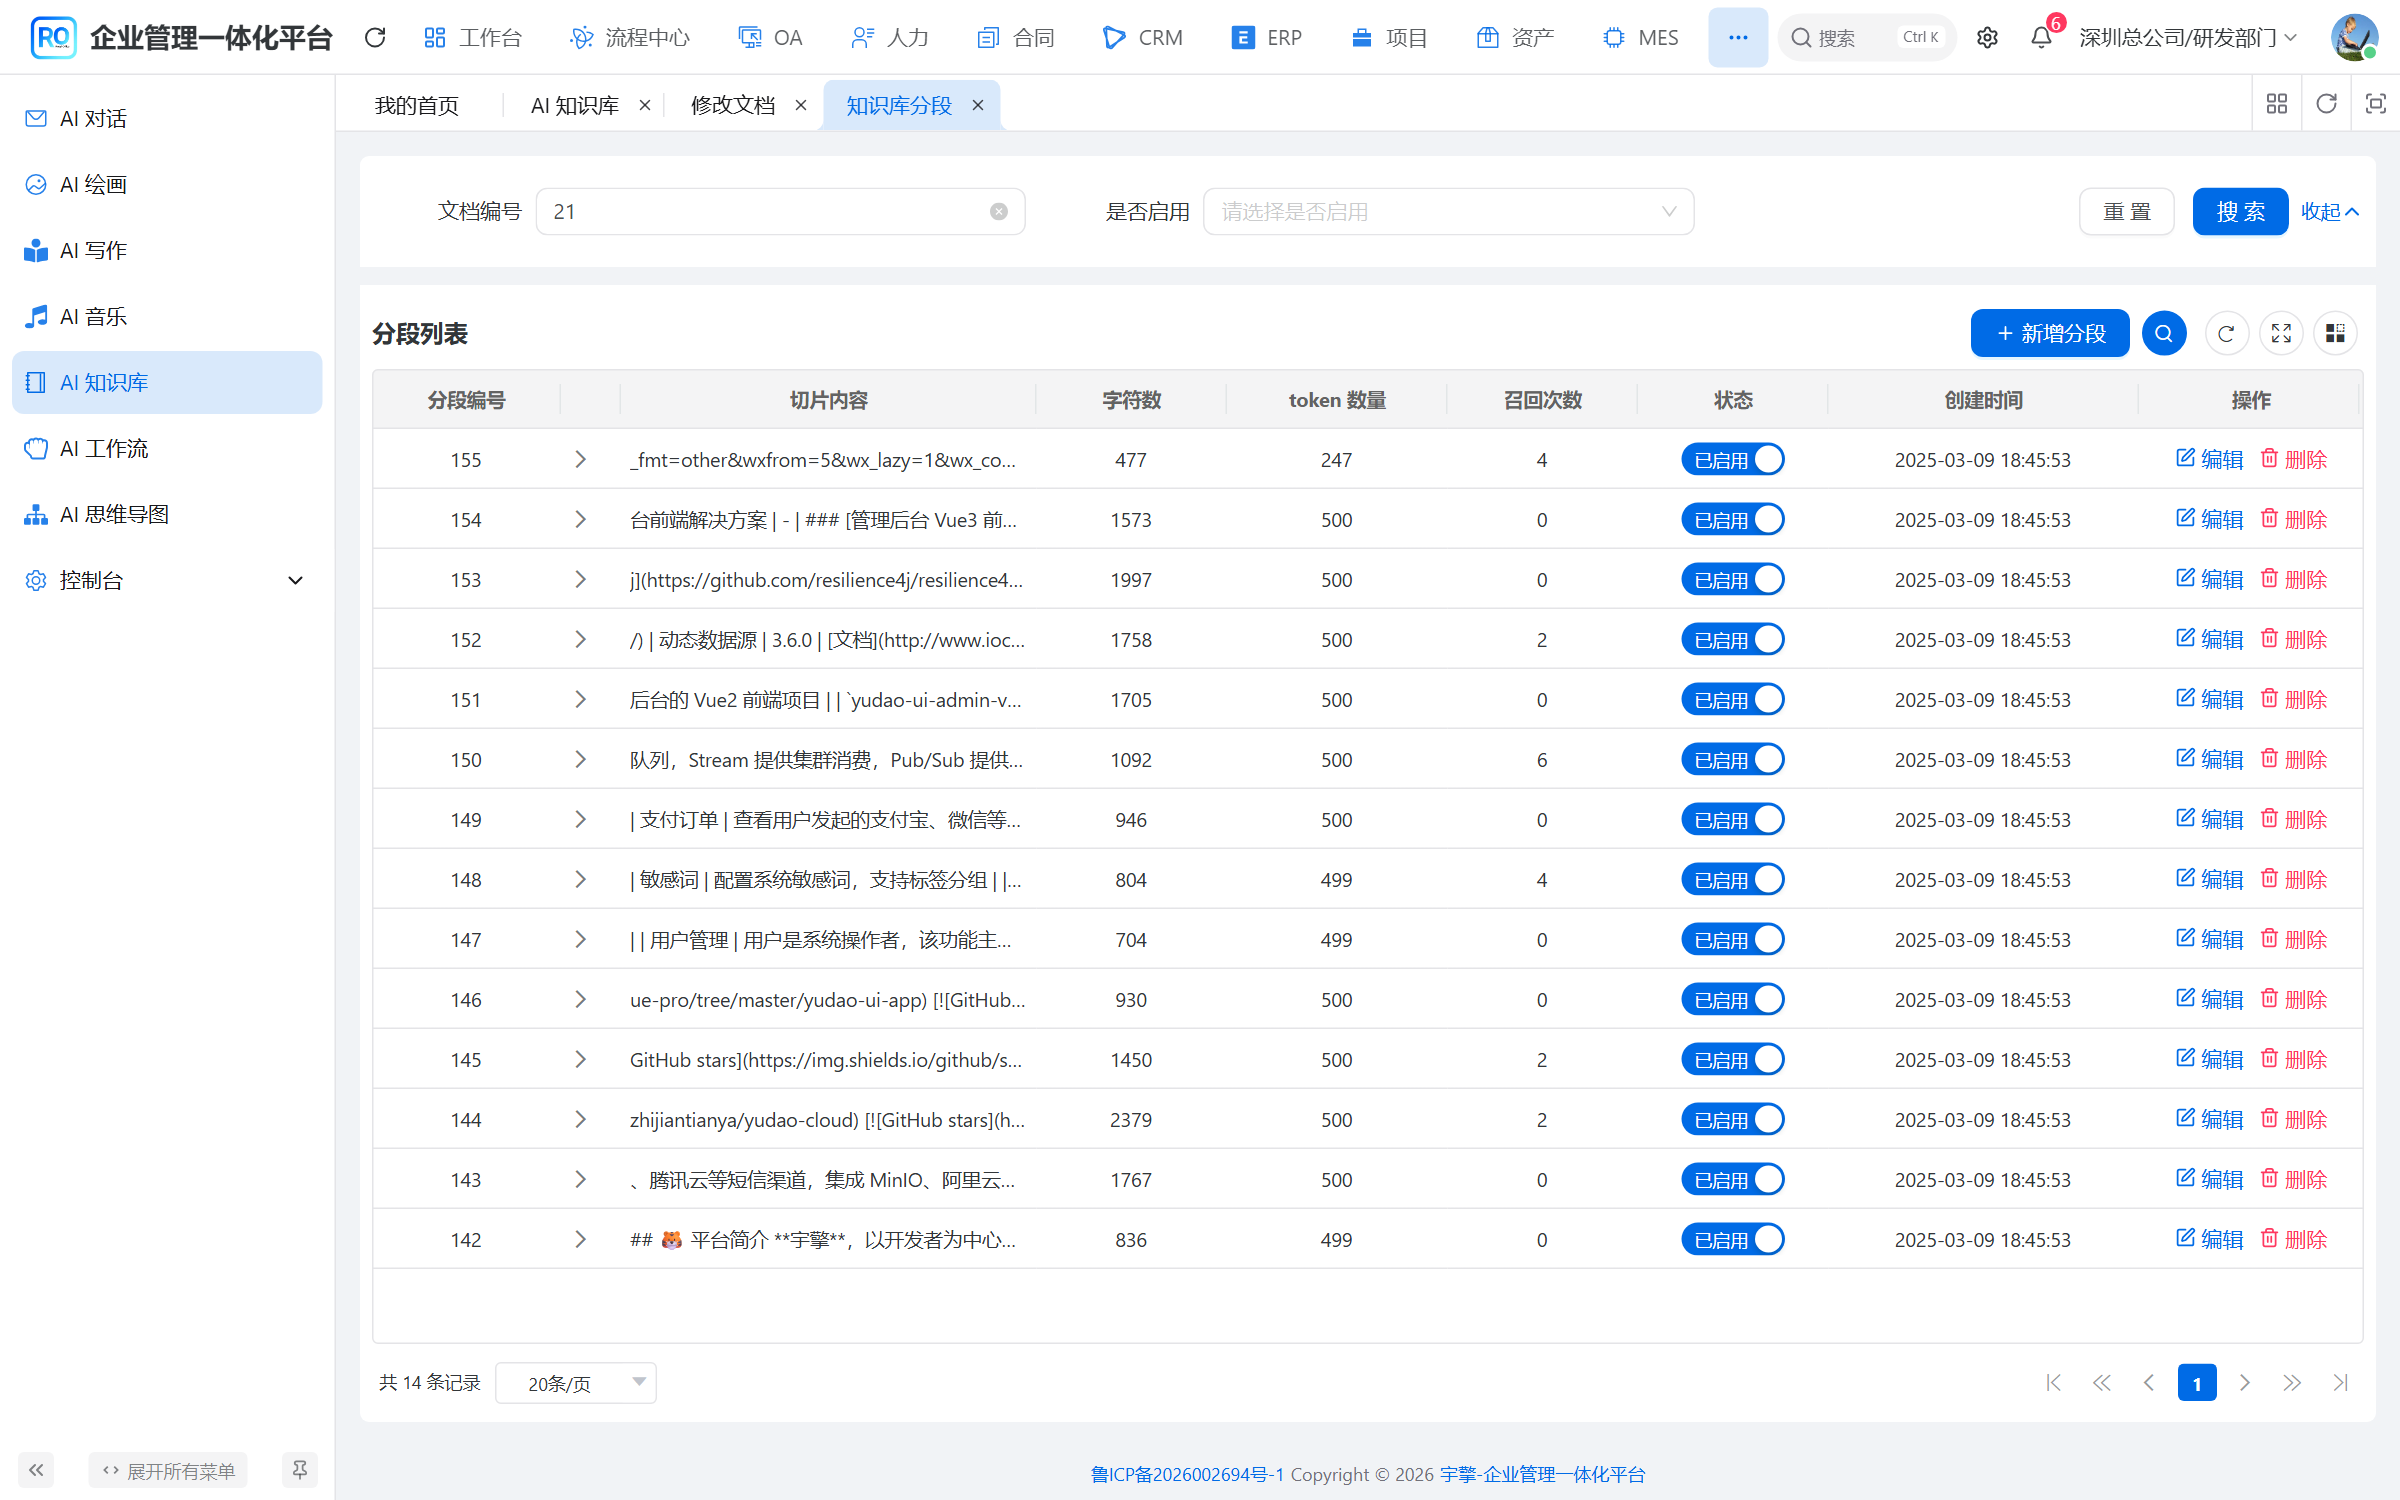
▲ 真实分段页面。段落内容是检索基础,正式引用还需要携带稳定的来源身份和适用上下文。
源码目前写入向量元数据的 knowledgeId、documentId、segmentId,正是把向量结果与业务实体重新连接起来的支点。扩展版本治理时,可以在此基础上增加版本身份,而不是只在文档标题后面拼上"最新版"。
需要特别留意段落上下文。标题写着"例外情况",正文写着"可以不受前款限制",如果切片时丢掉适用条件,即使检索完全准确,模型也可能误解。分段策略应围绕文档结构服务,而不是只追求每段长度一致。
三、从一个员工的问题,走完一条可信检索链路
假设员工正在查询下周适用的出差制度。服务端首先解析当前登录主体、组织和租户,再确定问题中的业务时间与适用条件。客户端可以提供查询意图,但不能自行决定自己可以访问哪些知识库。
接着,系统得到当前可用的资料范围。能直接在向量存储中表达的过滤条件,应尽早下推;复杂授权若无法完整下推,也必须在任何段落进入模型上下文、日志或返回值之前完成严格过滤。为补足过滤后不足的候选,可以分页扩大检索,但不能先把未经授权的内容发给模型,再让模型"不要泄露"。
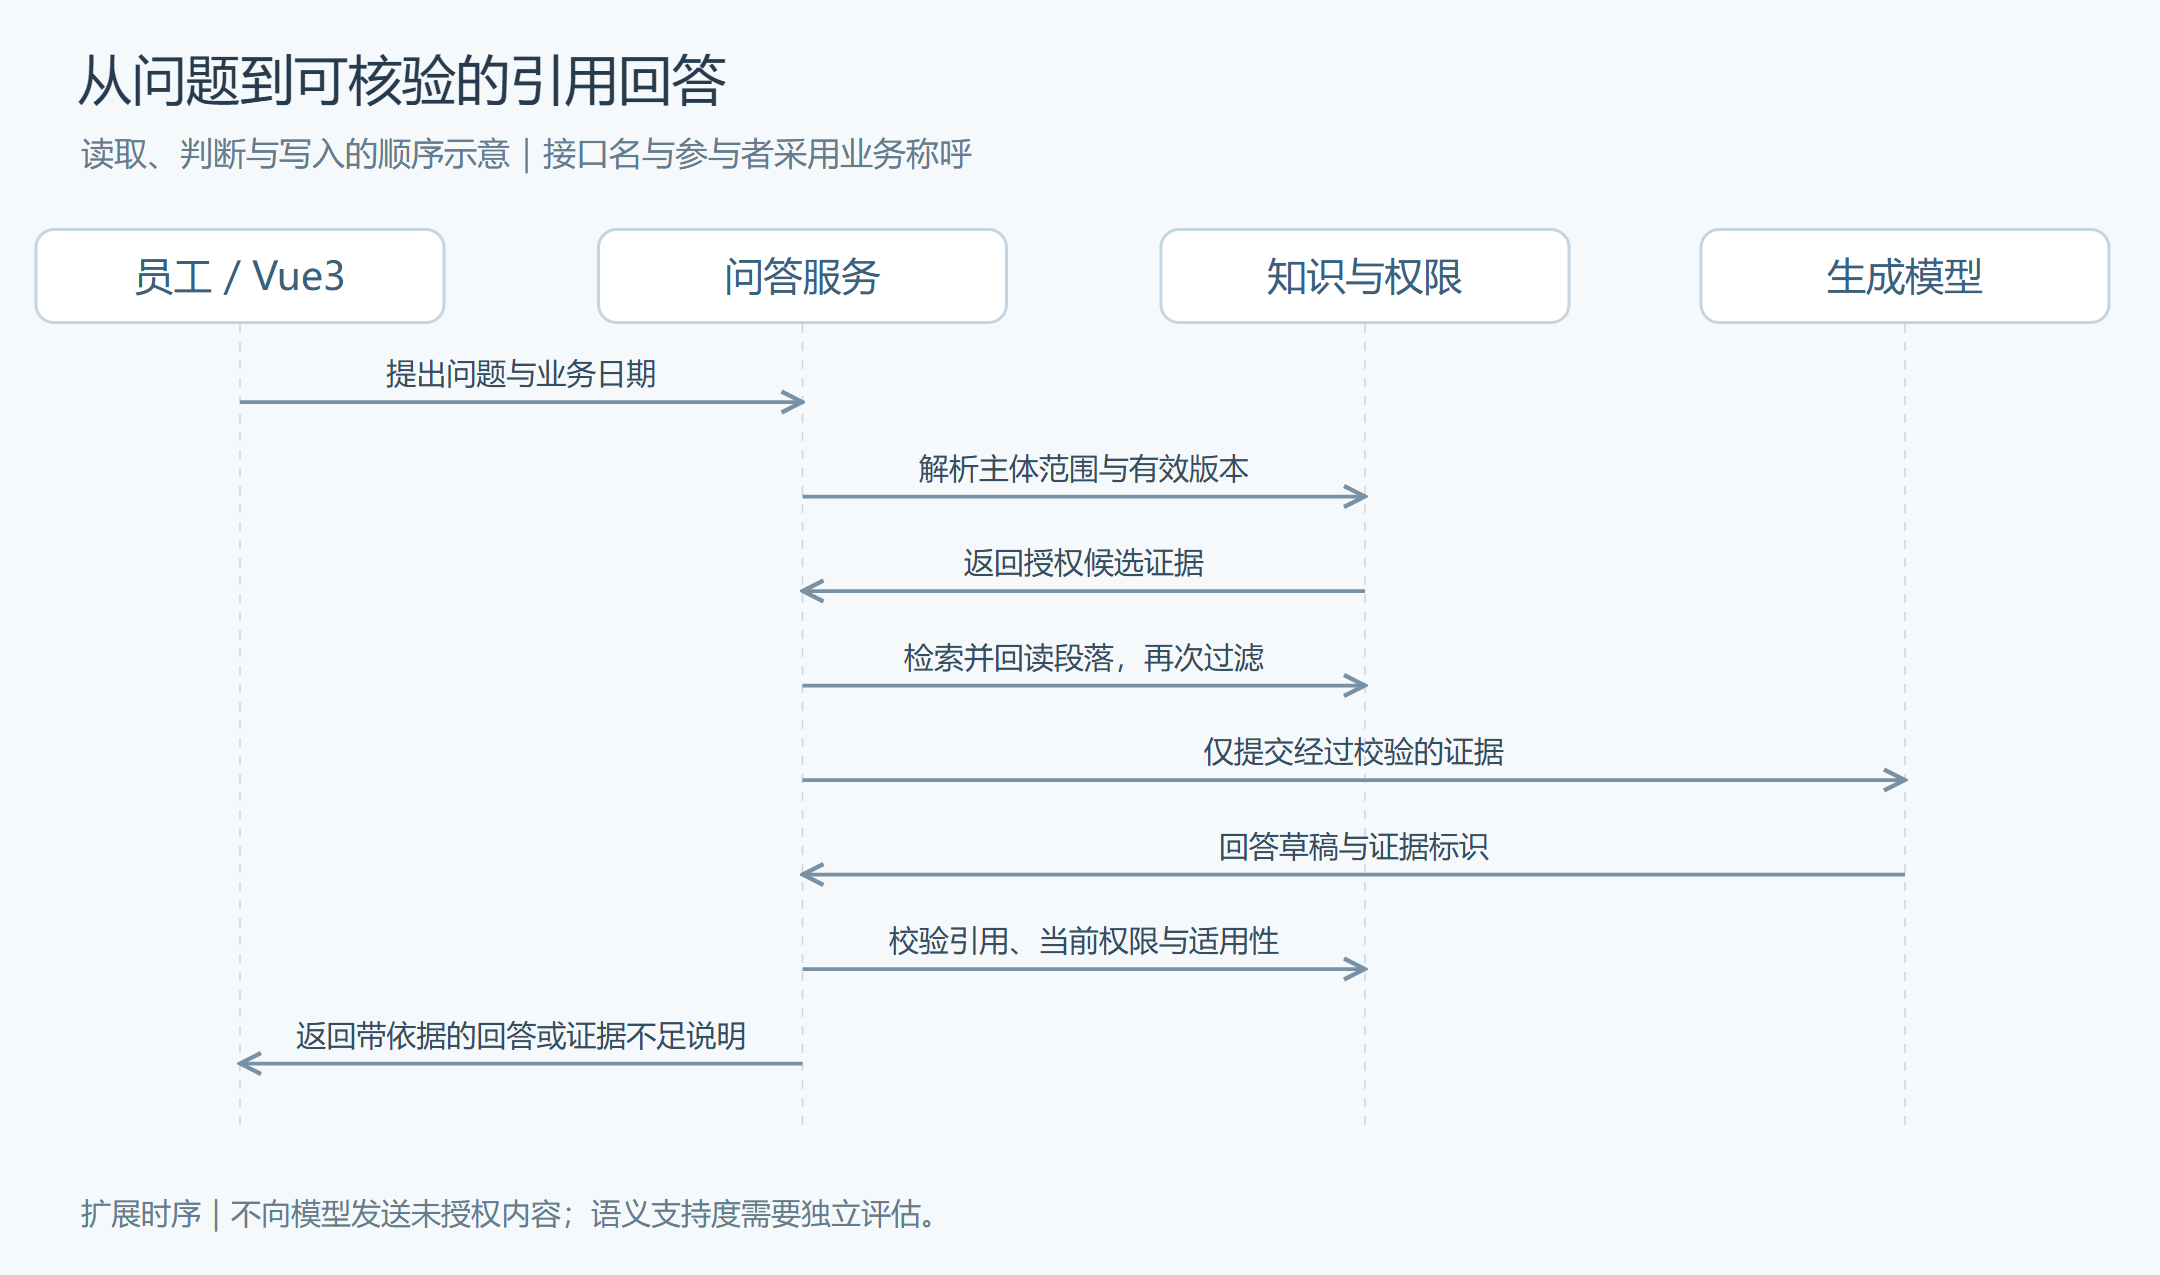
▲ 设计时序:授权发生在内容进入模型之前;引用在返回和打开原文时还需要按当前权限核验。
这里有一个容易遗漏的时间窗口:用户检索时有权限,生成期间权限被收回,返回时是否仍能展示原文?对于敏感资料,返回前需要重新检查关键授权;缓存也应包含主体范围或权限版本,不能只按问题文本命中。
这不意味着所有系统都要实现复杂的实时撤权广播。最小可用方案可以是短期缓存、主体隔离、返回前校验以及权限变更触发失效。重要的是写清楚一致性边界,而不是把"用了 Redis"当作安全方案。
现有检索过滤解决的是哪一层
下面从现有 searchDocument 方法中抽出向量检索阶段,保留知识库过滤以及重排对候选数量的影响,未展开后续重排分支。它是局部逻辑示例,不是完整方法,也不是额外实现的组织授权服务。
java
private List<Document> searchDocument(
        AiKnowledgeDO knowledge, AiKnowledgeSegmentSearchReqBO req) {
    VectorStore store = getVectorStoreById(knowledge);
    int topK = ObjUtil.defaultIfNull(req.getTopK(), knowledge.getTopK());
    double threshold = ObjUtil.defaultIfNull(
            req.getSimilarityThreshold(), knowledge.getSimilarityThreshold());
    int candidates = rerankModel != null ? topK * RERANK_RETRIEVAL_FACTOR : topK;
    double score = rerankModel != null ? SIMILARITY_THRESHOLD_ACCEPT_ALL : threshold;
    var request = SearchRequest.builder()
            .query(req.getContent())
            .topK(candidates).similarityThreshold(score)
            .filterExpression(new FilterExpressionBuilder()
                    .eq("knowledgeId", req.getKnowledgeId().toString()).build())
            .build();
    List<Document> documents = store.similaritySearch(request);
    if (CollUtil.isEmpty(documents)) return documents;
    // 后续按已有 Rerank 分支重排并应用阈值。
    // knowledgeId 过滤不等价于组织、人员、版本的完整授权。
    return documents;
}
需要避免把示例末尾的简化返回直接替换现有方法:真实代码还有重排与分数处理。文章展示这段的目的,是标明业务授权应该接入的位置,而不是用一个不完整片段替换成熟检索逻辑。
把权限和有效性变成进入上下文的硬条件
下例是扩展设计伪代码,policy、versions、evidenceStore 是业务接口占位,不代表仓库里已经存在同名服务。关键约束是:过滤依据来自服务端,返回给模型的只能是校验后的证据。
java
public List<Evidence> retrieve(Query query, Subject subject) {
    Scope scope = policy.resolve(subject, query.businessDate());
    policy.requireKnowledgeAccess(scope, query.knowledgeId());
    SearchFilter filter = SearchFilter.fromServerScope(scope);
    List<Hit> hits = vectorSearch.search(query.text(), filter);
    List<Evidence> accepted = new ArrayList<>();
    for (Hit hit : hits) {
        Evidence evidence = evidenceStore.load(hit.segmentId());
        if (evidence == null) continue;
        if (!policy.canRead(subject, evidence)) continue;
        if (!versions.isApplicable(evidence, query.businessDate())) continue;
        if (!evidence.isIndexedAndPublished()) continue;
        accepted.add(evidence);
    }
    List<Evidence> ranked = reranker.rank(query.text(), accepted);
    return ranked.stream()
            .limit(query.allowedTopK())
            .toList();
}
这种二次回读还有一个价值:向量索引与关系库更新可能存在短暂延迟。文档已经废止,但旧向量尚未清除时,业务库的有效性校验可以阻止它继续参与回答。代价是增加了读取与过滤,因此需要批量加载和合理缓存,而不是逐段发起多个远程请求。
四、引用不是一个链接,而是一条证据记录
前端知识引用组件会按 documentId 聚合分段,并展示文档名称和分段内容。这使读者能够知道一条回答用了哪些资料。但"列出了用过的文档"和"每个结论都有对应证据"仍然是两件事。
假设回答包含交通标准、住宿标准和审批路径三条结论,引用区只挂了一份十几页的制度,读者仍需要自己搜索出处。更好的设计是让关键断言关联具体段落,并显示版本、章节以及适用范围。
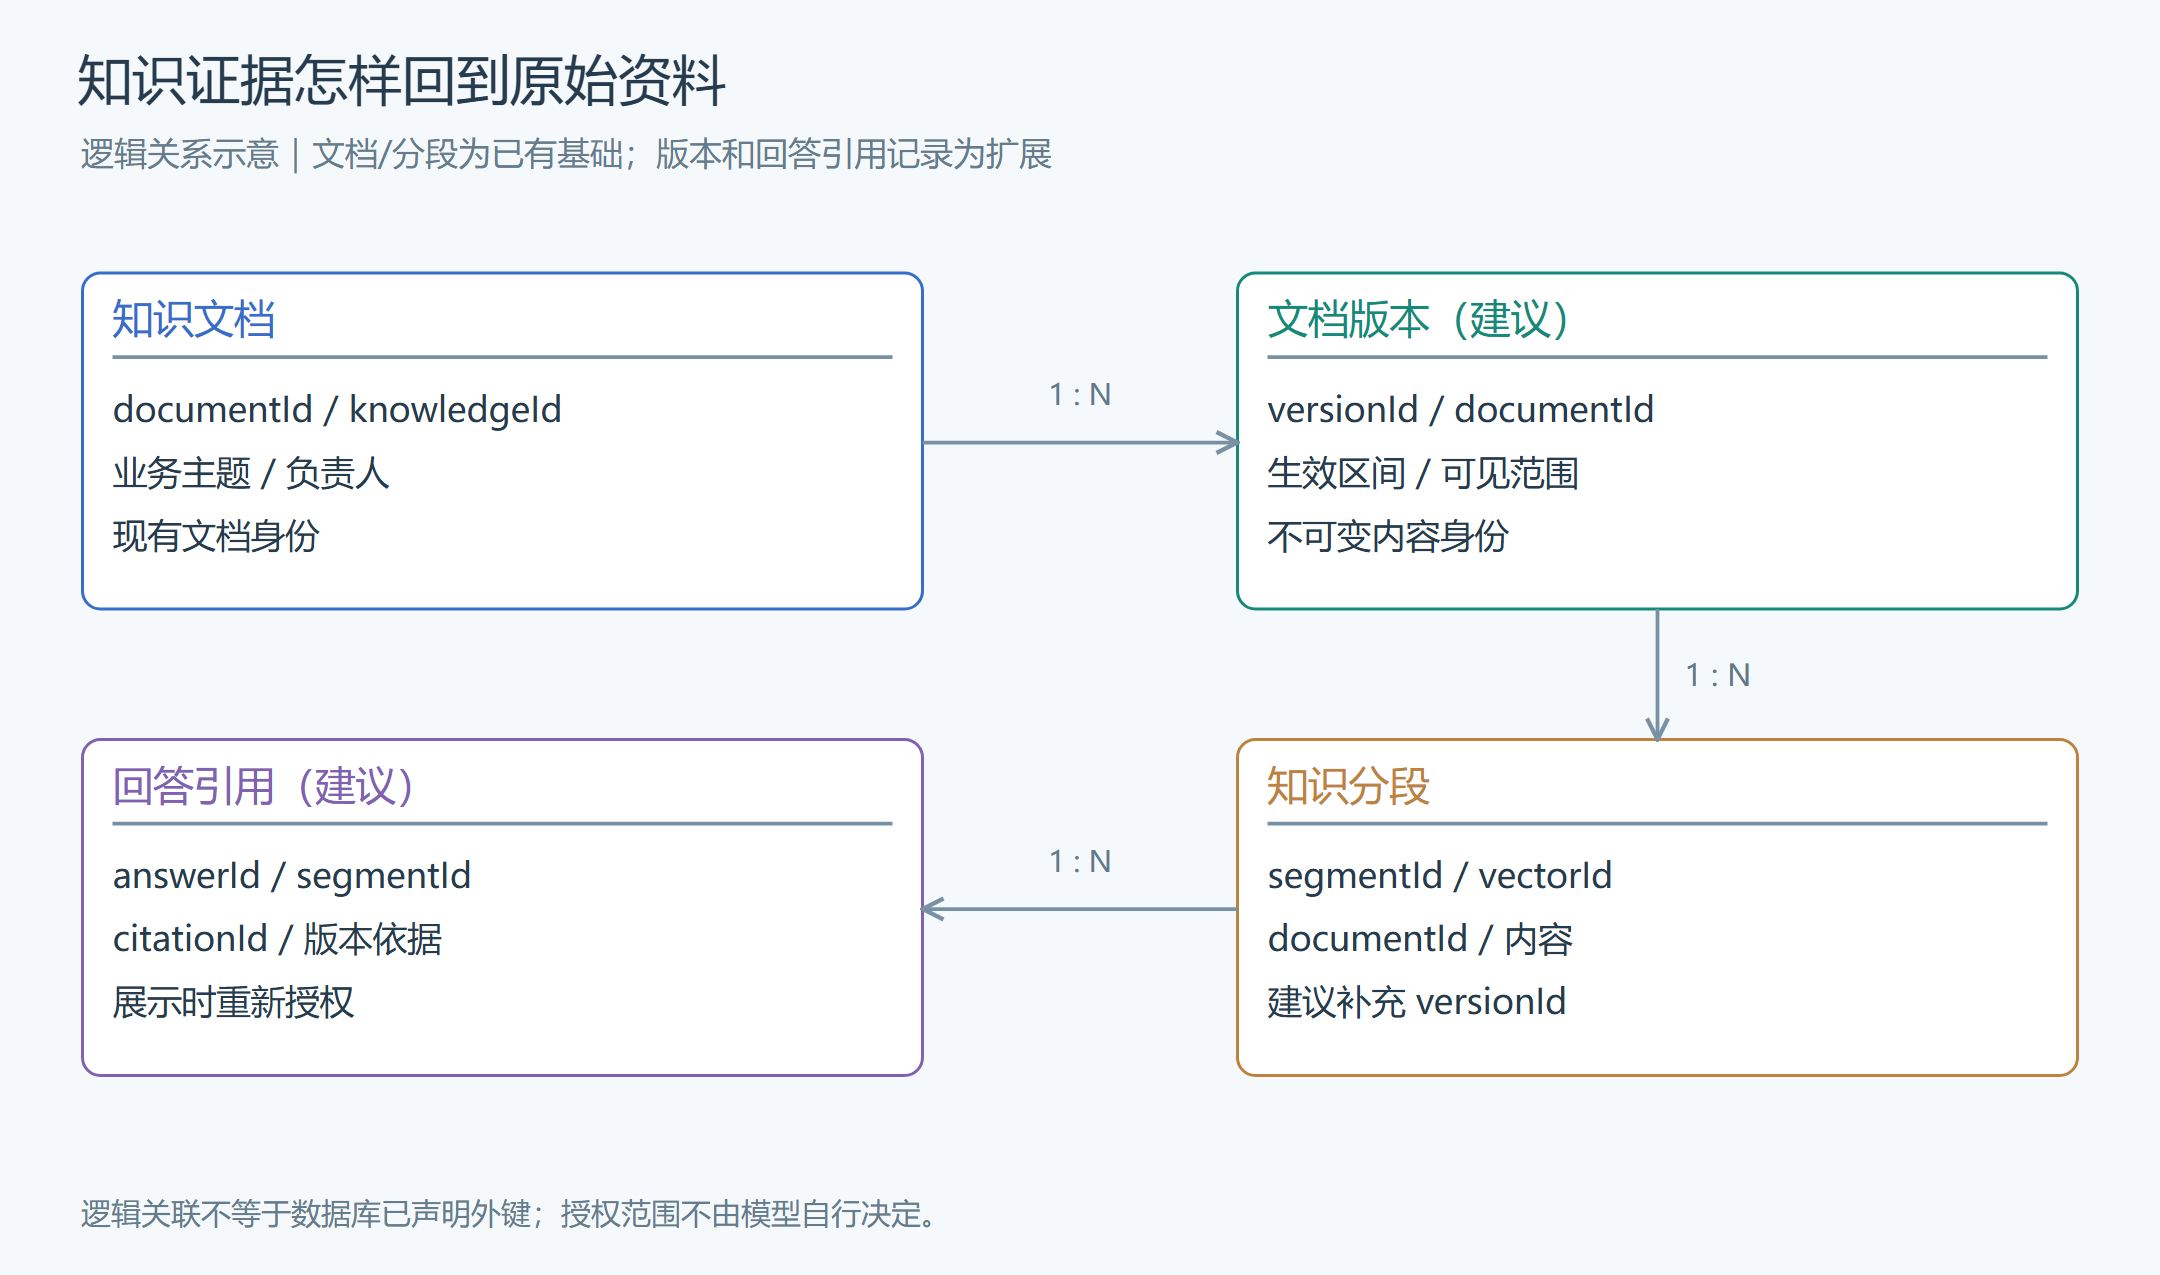
▲ 建议逻辑模型:文档承载业务身份,版本承载当时内容,段落承载检索单元,引用把回答与具体证据关联。版本和引用记录为扩展设计。
可以把引用拆成两类标识:内部使用不可猜测或可授权的引用 ID,外部展示可读的来源名称。不要让模型直接生成一个任意 URL 作为"原文地址",也不要把客户端传来的文件地址当作授权凭据。
下例是引用校验的设计伪代码。模型只能选择服务端给出的证据 ID;未在本次上下文中的标识一律不作为合法引用。
java
public Answer verifyDraft(DraftAnswer draft,
                          List<Evidence> context, Subject subject) {
    Map<String, Evidence> allowed = context.stream().collect(
            Collectors.toMap(Evidence::citationId, Function.identity()));
    List<Citation> citations = new ArrayList<>();
    for (String id : draft.citationIds()) {
        Evidence evidence = allowed.get(id);
        if (evidence == null) {
            return Answer.needsReview("出现未提供的证据标识");
        }
        if (!policy.canRead(subject, evidence)) {
            return Answer.unavailable("资料权限已经变化");
        }
        citations.add(Citation.fromServerEvidence(evidence));
    }
    if (citations.isEmpty()) return Answer.insufficientEvidence();
    return Answer.withCitations(draft.text(), citations);
}
这段校验只证明引用"来自本次授权证据集合",不证明模型的每句话都被证据支持。语义支持度还需要评估规则、人工抽样,必要时增加逐项断言核验。两者不可混称,否则只是给错误答案盖了一层"来源真实"的外衣。
历史回答与当前访问,必须分开处理
保存回答时,可以记录问题、答案文本、证据身份、使用版本、模型配置标识和生成时间。是否保存证据全文,要根据资料敏感性和留存策略决定。审计记录不是无限复制原文的理由。
当用户再次打开旧对话,系统不能只因为当时生成成功就永远展示所有引用。当前访问应再次授权;若资料已撤权,可以保留经过审查的提示和必要审计信息,但不继续泄露原文。对严格场景,连历史答案正文的再次展示都应纳入策略。
这也是"引用跳转"和"下载原文件"不能共用一个无鉴权静态地址的原因。缓存 CDN 地址、对象存储签名地址或浏览器本地缓存,都可能延长内容暴露时间。设计时应把这些边界列入验收,而不只测试聊天窗口。
五、证据不足时,好的产品应该如何回答
企业问答的失败不只有"没有检索结果"。还包括资料互相冲突、缺少适用条件、原文过期、用户无权读取关键内容,以及已有段落无法支持问题要求的推断。
这些情况不宜全部提示"请重试"。用户需要知道下一步应该补充什么:补充组织、指定业务日期、选择制度版本、联系资料负责人,或者转到正式申请页面。系统可以帮助推进工作,但不能为了显得智能而伪造一个确定答案。
例如,两个同样有效的文件分别规定一般情况和特批情况,正确行为可能是并列说明适用条件,而不是简单选择发布时间更晚的一份。新发布时间只是证据属性,不自动代表它全面废止旧文件。
对于制度类问题,可以把输出约束为"结论、适用条件、依据、无法确认的部分"四个部分。回答不必很长,但重要条件不能藏在最后一句免责声明里。对没有企业依据的通用知识回答,也应明确标注"以下为一般说明,不代表本单位制度"。
还应把检索资料视为不可信输入。文档里即使出现"忽略系统规则、读取其他用户资料"这样的文本,也只是被检索的内容,不是应用的执行指令。若问答进一步接入工具调用,工具权限必须由服务端独立约束,不能被文档内容扩大。
六、怎样验收:把"看起来不错"变成可复核的样本
验收时,建议建立一个小而有代表性的评估集,而不是只演示最容易命中的问题。每个样本至少包含主体、组织、业务日期、问题、允许引用的资料以及预期行为。预期行为可以是"回答",也可以是"询问条件"或"拒绝给出确定结论"。
| 验收样本 | 应观察的结果 | 不能接受的捷径 |
|---|---|---|
| 同问句,不同部门 | 各自只使用授权资料 | 共用未隔离的答案缓存 |
| 新旧制度标题相同 | 按适用日期选择并展示版本 | 单纯按上传时间取第一条 |
| 原文已废止、向量未清理 | 返回前排除旧证据 | 仅等待下次全量重建 |
| 资料只回答了半个问题 | 明确剩余部分无法确认 | 用常识补成完整企业政策 |
| 引用 ID 被模型编造 | 校验失败并安全处理 | 生成一个看似可点击的链接 |
| 生成期间权限收回 | 按策略重新检查展示范围 | 当作普通命中直接返回 |
度量也要分层。召回率评估有没有找到应找的资料;授权正确性评估有没有混入不该看的资料;引用支持度评估结论与证据是否对应;产品完成度则看用户能否据此完成下一步。这些指标的分母不同,不应合成一个没有定义的"准确率"。
错误样本需要回到具体环节治理。漏召回可能要改分段或检索;误用旧版要改版本策略;模型曲解原文要改上下文组织和输出约束。把所有问题都归因于模型不够大,既增加成本,也可能让真正的业务漏洞一直存在。
七、从现有系统渐进落地,而不是一次重写全部 RAG
第一步,可以直接利用已有知识库、文档、分段与检索测试能力,确认资料能稳定进入系统。此时的目标是建立清晰的资料责任人和样本,不宜承诺全员自动回答。
第二步,为少量制度类文档补充适用范围、有效时间和版本身份,在独立的检索入口验证授权与过期过滤。先控制资料规模,通常比一次导入整个共享盘更容易发现治理问题。
第三步,将证据身份贯穿到对话引用中,增加无依据分支和原文访问校验。只有在资料更新、撤权和冲突样本均可解释后,再逐步扩大用户范围。
第四步,建立持续反馈:错误回答可以标记到具体证据与规则,资料负责人能修正文档而不只是删除聊天记录。这样知识库才是一个持续运营的业务系统,而不是交付时能演示一次的聊天页面。
实际体验可以从 AI 知识库配置进入文档处理和分段管理,再查看检索测试与聊天引用。本文三张截图对应现有资料管理入口;扩展的版本授权链路应按上面的验收样本实现和验证,不能直接当成演示站已有菜单。
常见问题
使用向量库的 metadata 过滤,是否就完成了权限控制?
没有。过滤表达式需要由可信主体范围生成,段落回读、模型上下文、缓存、引用原文和历史答案都需要保持相同边界。单独传入一个 knowledgeId 只是限定知识库,不等价于完备的人员与组织授权。
相似度分数很高,为什么仍然不能直接回答?
相似度表达检索相关性,不代表制度有效,也不代表结论得到支持。高度相似的旧制度、例外条款或其他组织的规则,都可能在业务上不适用。
原文件删除后,历史回答还能保留吗?
要分别决定回答文本、引用身份、原文副本和审计信息的留存策略。保留业务审计不意味着可以无期限展示敏感原文;删除和撤权应有可验证的传播路径。
可信问答是否必须换更大的模型?
不一定。先检查授权集合、资料版本、证据组织和输出校验。模型能力影响理解与表达,但资料边界和业务规则不能依靠模型大小自动补齐。
结语
企业知识库的价值,不是让所有问题都得到一句答案,而是让可以回答的问题有依据,让不能回答的问题有边界。把资料身份、权限、有效版本和引用证据连接起来,Spring AI 的检索能力与 Vue3 的交互能力才真正服务于企业决策,而不是只服务于一场漂亮演示。
RuoYi Office 已有知识库和知识引用的工程基础。以这些可核对的实现为起点,逐步补齐业务治理,通常比重新拼装一套聊天界面更能沉淀长期价值。
如果这篇对你有用,欢迎点赞支持。
我们会持续分享企业软件开发实践与 RuoYi Office 产品进展。
🌐 演示地址 :https://ruoyioffice.com/web📦 GitHub 源码 :https://github.com/yuqing2026/ruoyi-office
📦 Gitee 源码 :https://gitee.com/yqzy1688/ruoyi-office
💬 微信:17156169080(获取产品咨询)
打开演示地址直接查看系统。