文章目录
-
- [1. 先把任务写成状态、动作和奖励](#1. 先把任务写成状态、动作和奖励)
- [2. 策略输出的是概率](#2. 策略输出的是概率)
- [3. REINFORCE:回报给动作打分](#3. REINFORCE:回报给动作打分)
-
- [3.1 如何用反向传播更新网络?](#3.1 如何用反向传播更新网络?)
- [4. 完整训练流程](#4. 完整训练流程)
- [5. 训练策略与随机策略并排对比](#5. 训练策略与随机策略并排对比)
小车倒立摆的任务很直观:左右推小车,让车上的杆尽量保持直立。我们不给控制器写"杆向右倾就向右推"的规则,而是让它通过试错学会选择动作。
本文只介绍基础 REINFORCE:用一个带隐藏层的神经网络输出动作概率,完成回合后,根据实际获得的回报更新策略。没有价值网络、基线、回报标准化或其他强化学习算法。为了让整个流程可见,环境、策略和训练都写在一个 Python 文件里,只依赖 NumPy。
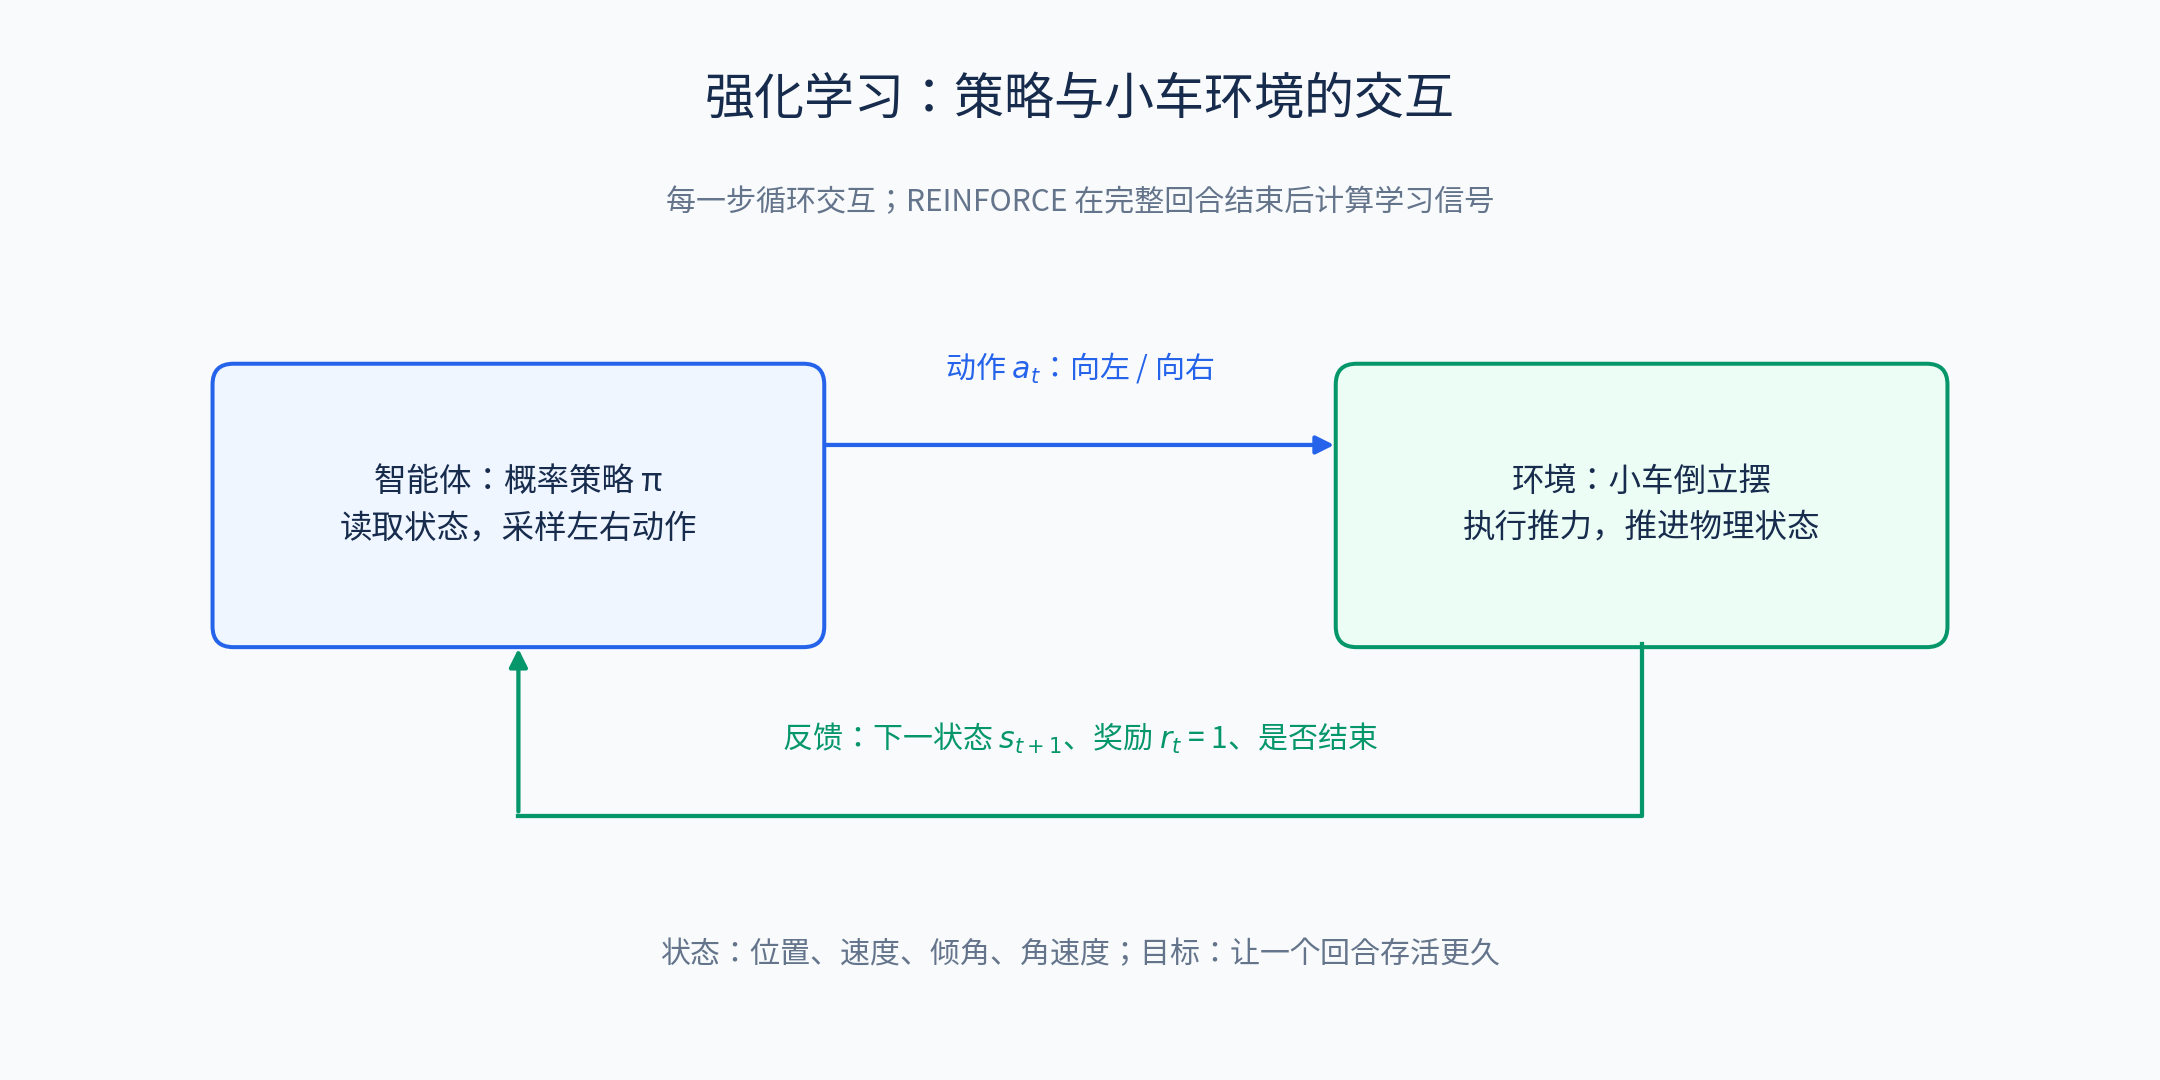
图 1:强化学习的交互闭环。 智能体根据状态采样动作,环境执行动作并反馈下一状态、奖励和结束标志。每一步都发生交互;本文的 REINFORCE 在完整回合结束后计算回报,并每收集 10 个回合更新一次策略。
1. 先把任务写成状态、动作和奖励
这里的小车环境采用经典 CartPole 的参数和规则。它从接近直立的位置开始,目标是维持平衡,而不是从杆垂下的位置摆起。
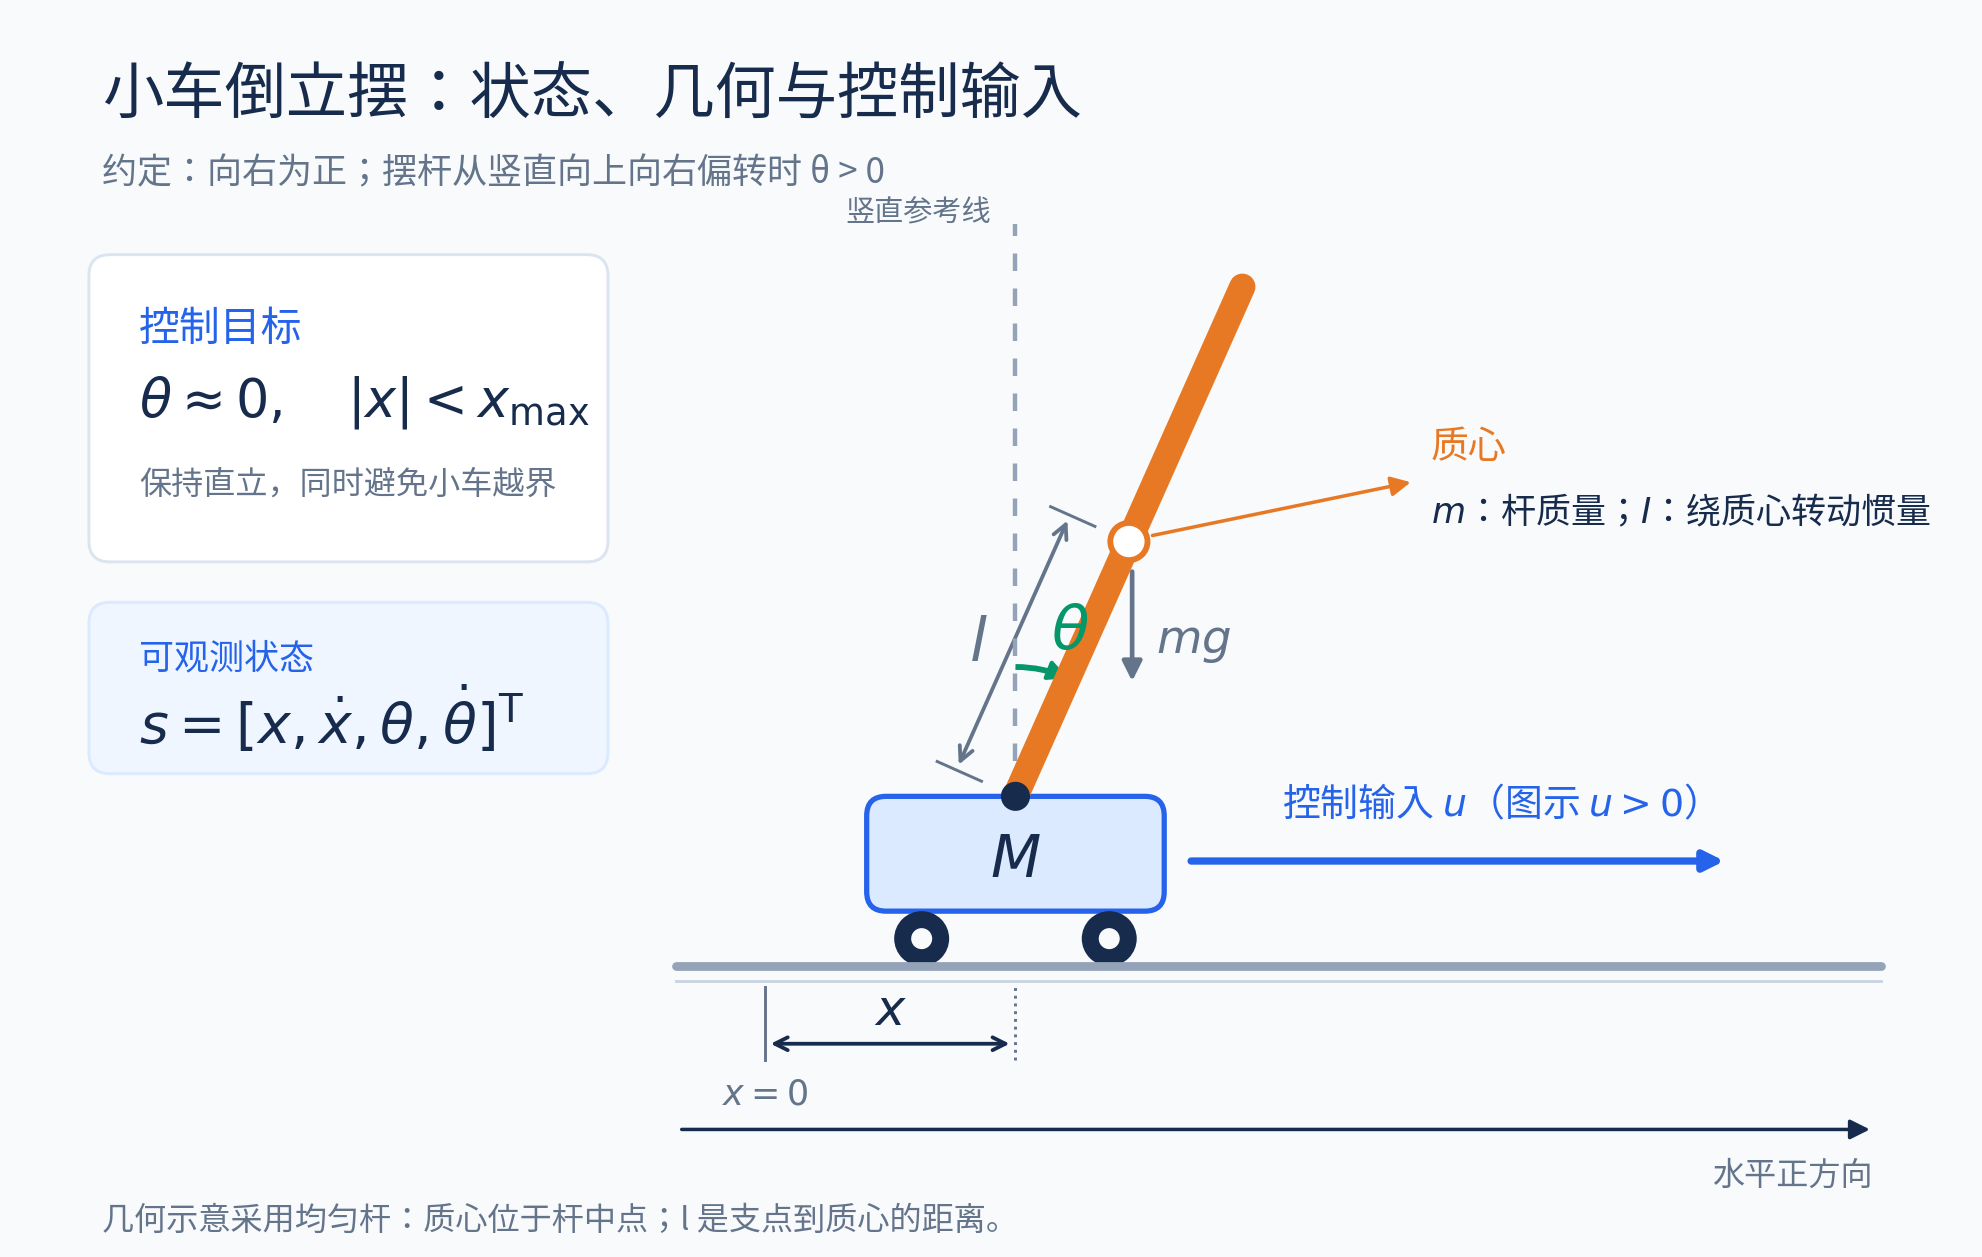
图 2:小车倒立摆原理图。 小车沿水平轨道运动,控制输入 u u u 作用在小车上,通过支点运动影响摆杆。 x x x 从轨道中心量起, θ \theta θ 从竖直向上量起,向右为正; M M M 为小车质量, m m m 为杆质量, l l l 为支点到质心的距离。图中的杆倾斜幅度为几何示意,不是训练初始角度;本文无需读者推导图中的转动惯量 I I I。
状态是四个数:
s t = x t , x ˙ t , θ t , θ ˙ t . s_t=x_t,\\dot x_t,\\theta_t,\\dot\\theta_t. st=xt,x˙t,θt,θ˙t.
| 状态 | 含义 | 单位 |
|---|---|---|
| x x x | 小车相对轨道中心的位置 | m |
| x ˙ \dot x x˙ | 小车速度 | m/s |
| θ \theta θ | 杆相对竖直向上的偏角 | rad |
| θ ˙ \dot\theta θ˙ | 杆角速度 | rad/s |
动作只有两个: a = 0 a=0 a=0 向左施加 10 N 的力, a = 1 a=1 a=1 向右施加 10 N 的力。每一步推进 0.02 秒,获得奖励 1,包括触发失败的那一步。如果小车越过 ± 2.4 \pm2.4 ±2.4 m 或杆角度越过 ± 12 ∘ \pm12^\circ ±12∘,回合失败;否则在 500 步结束。
因此,一个回合的未折扣总奖励就是它的步数。500 步对应 10 秒的观察窗口,不表示控制器能永远平衡。
2. 策略输出的是概率
策略 π W ( a ∣ s ) \pi_W(a\mid s) πW(a∣s) 表示在状态 s s s 下选择动作 a a a 的概率。这里用一个最小的多层感知机(MLP)表示策略:
text
输入状态(4 维) → 全连接层 → tanh(32 个隐藏单元)
               → 全连接层(2 个分数) → Softmax(左右动作概率)
把状态视为行向量,前向计算为:
h = tanh ( s W 1 + b 1 ) , z = h W 2 + b 2 , h=\tanh(sW_1+b_1),\qquad z=hW_2+b_2, h=tanh(sW1+b1),z=hW2+b2,
π W ( a ∣ s ) = e z a e z 0 + e z 1 . \pi_W(a\mid s)=\frac{e^{z_a}}{e^{z_0}+e^{z_1}}. πW(a∣s)=ez0+ez1eza.
W W W 在本文中统指全部网络参数 { W 1 , b 1 , W 2 , b 2 } \{W_1,b_1,W_2,b_2\} {W1,b1,W2,b2}。 W 1 W_1 W1 的形状为 4 × 32 4\times32 4×32, b 1 b_1 b1 为 32 维, W 2 W_2 W2 为 32 × 2 32\times2 32×2, b 2 b_2 b2 为 2 维,共有 128 + 32 + 64 + 2 = 226 128+32+64+2=226 128+32+64+2=226 个可训练参数。隐藏层的 tanh 提供非线性表达能力。
神经网络负责把状态映射为概率,REINFORCE 负责根据回报更新网络。使用 NumPy 不妨碍它成为神经网络:这里显式实现前向传播和反向传播,因此无需安装 PyTorch。
例如输出 [0.3, 0.7],就以 30% 的概率向左推、70% 的概率向右推。训练时按这个分布采样,而不是一直取概率最大的动作。随机采样使策略有机会尝试不同的行为。
计算 Softmax 时先减去最大的分数,可避免指数溢出;这不会改变概率。
3. REINFORCE:回报给动作打分
训练目标是最大化一个回合的期望折扣奖励:
J ( W ) = E τ ∼ π W ∑ t = 0 T − 1 γ t r t . J(W)=\mathbb E_{\tau\sim\pi_W}\left\\sum_{t=0}\^{T-1}\\gamma\^t r_t\\right. J(W)=Eτ∼πWt=0∑T−1γtrt.
T T T 是本回合长度, γ \gamma γ 是折扣因子。本文默认 γ = 1 \gamma=1 γ=1,直接优化回合长度;因为回合最多 500 步,总回报有限。
一条轨迹的概率包含初始状态概率、每一步动作概率和环境转移概率。环境不依赖策略参数 W W W,因此对轨迹概率取对数并求导时,只有动作概率产生参数梯度。再利用恒等式 ∇ p = p ∇ log p \nabla p=p\nabla\log p ∇p=p∇logp,可以把"对期望求导"改写成"采样后计算对数概率梯度"。
已经发生的奖励不需要归因给之后才执行的动作。于是对时刻 t t t 的动作,使用从这一刻开始的奖励:
G t = r t + γ r t + 1 + ⋯ + γ T − 1 − t r T − 1 . G_t=r_t+\gamma r_{t+1}+\cdots+\gamma^{T-1-t}r_{T-1}. Gt=rt+γrt+1+⋯+γT−1−trT−1.
这就是 reward-to-go(从当前时刻起的回报)。REINFORCE 的单回合梯度估计为:
g ^ = ∑ t = 0 T − 1 γ t G t ∇ W log π W ( a t ∣ s t ) . \hat g=\sum_{t=0}^{T-1}\gamma^tG_t\nabla_W\log\pi_W(a_t\mid s_t). g^=t=0∑T−1γtGt∇WlogπW(at∣st).
这里保留外面的 γ t \gamma^t γt,与前面的折扣目标严格对应;默认 γ = 1 \gamma=1 γ=1 时它等于 1。
假设某一回合奖励为 [1, 1, 1], γ = 1 \gamma=1 γ=1,那么回报就是 [3, 2, 1]。早期动作对应更长的后续奖励,但这些数不是动作正确性的精确标签。REINFORCE 依靠许多次随机尝试,在期望意义上找到改善方向。
3.1 如何用反向传播更新网络?
对某一步,记回报权重为 c t = γ t G t c_t=\gamma^tG_t ct=γtGt,动作的独热向量为 e a t e_{a_t} eat,策略输出为 p t p_t pt。加权对数概率对输出分数的梯度是:
δ z = c t ( e a t − p t ) . \delta_z=c_t(e_{a_t}-p_t). δz=ct(eat−pt).
比如采样了向右动作,概率为 [0.3, 0.7],则 e a t − p t = − 0.3 , 0.3 e_{a_t}-p_t=-0.3,0.3 eat−pt=−0.3,0.3。接着通过输出层和 tanh 隐藏层反向传播:
∇ W 2 = h T δ z , ∇ b 2 = δ z , \nabla_{W_2}=h^{\mathsf T}\delta_z,\qquad \nabla_{b_2}=\delta_z, ∇W2=hTδz,∇b2=δz,
δ h = ( δ z W 2 T ) ⊙ ( 1 − h 2 ) , \delta_h=(\delta_z W_2^{\mathsf T})\odot(1-h^2), δh=(δzW2T)⊙(1−h2),
∇ W 1 = s T δ h , ∇ b 1 = δ h . \nabla_{W_1}=s^{\mathsf T}\delta_h,\qquad \nabla_{b_1}=\delta_h. ∇W1=sTδh,∇b1=δh.
⊙ \odot ⊙ 表示逐元素相乘, 1 − h 2 1-h^2 1−h2 是 tanh 的导数。将每一步的贡献相加,得到本回合的梯度。代码中的 gradients() 用矩阵运算一次计算整回合的贡献;每个偏置的梯度沿时间维求和。
代码每收集 B = 10 B=10 B=10 个完整回合,更新一次:
W ← W + α 1 500 B ∑ i = 1 B g ^ i . W\leftarrow W+\alpha\frac{1}{500B}\sum_{i=1}^{B}\hat g_i. W←W+α500B1i=1∑Bg^i.
批次内参数保持不变,记录的概率都是采样时的概率。固定除以 500 是控制梯度尺度,等价于调整学习率;它不依赖本回合结果,也没有减去基线。梯度按回合取平均,不按步数取平均,避免回合长度改变归一化方式。最后不足 10 回合的批次按实际回合数平均。
如果用自动求导框架,一般会构造负的加权对数概率作为损失,再用梯度下降。本文直接手算梯度,因此使用加号做梯度上升。PyTorch 的概率分布文档也给出了通过 sample() 和 log_prob() 实现 REINFORCE 的思路。
4. 完整训练流程
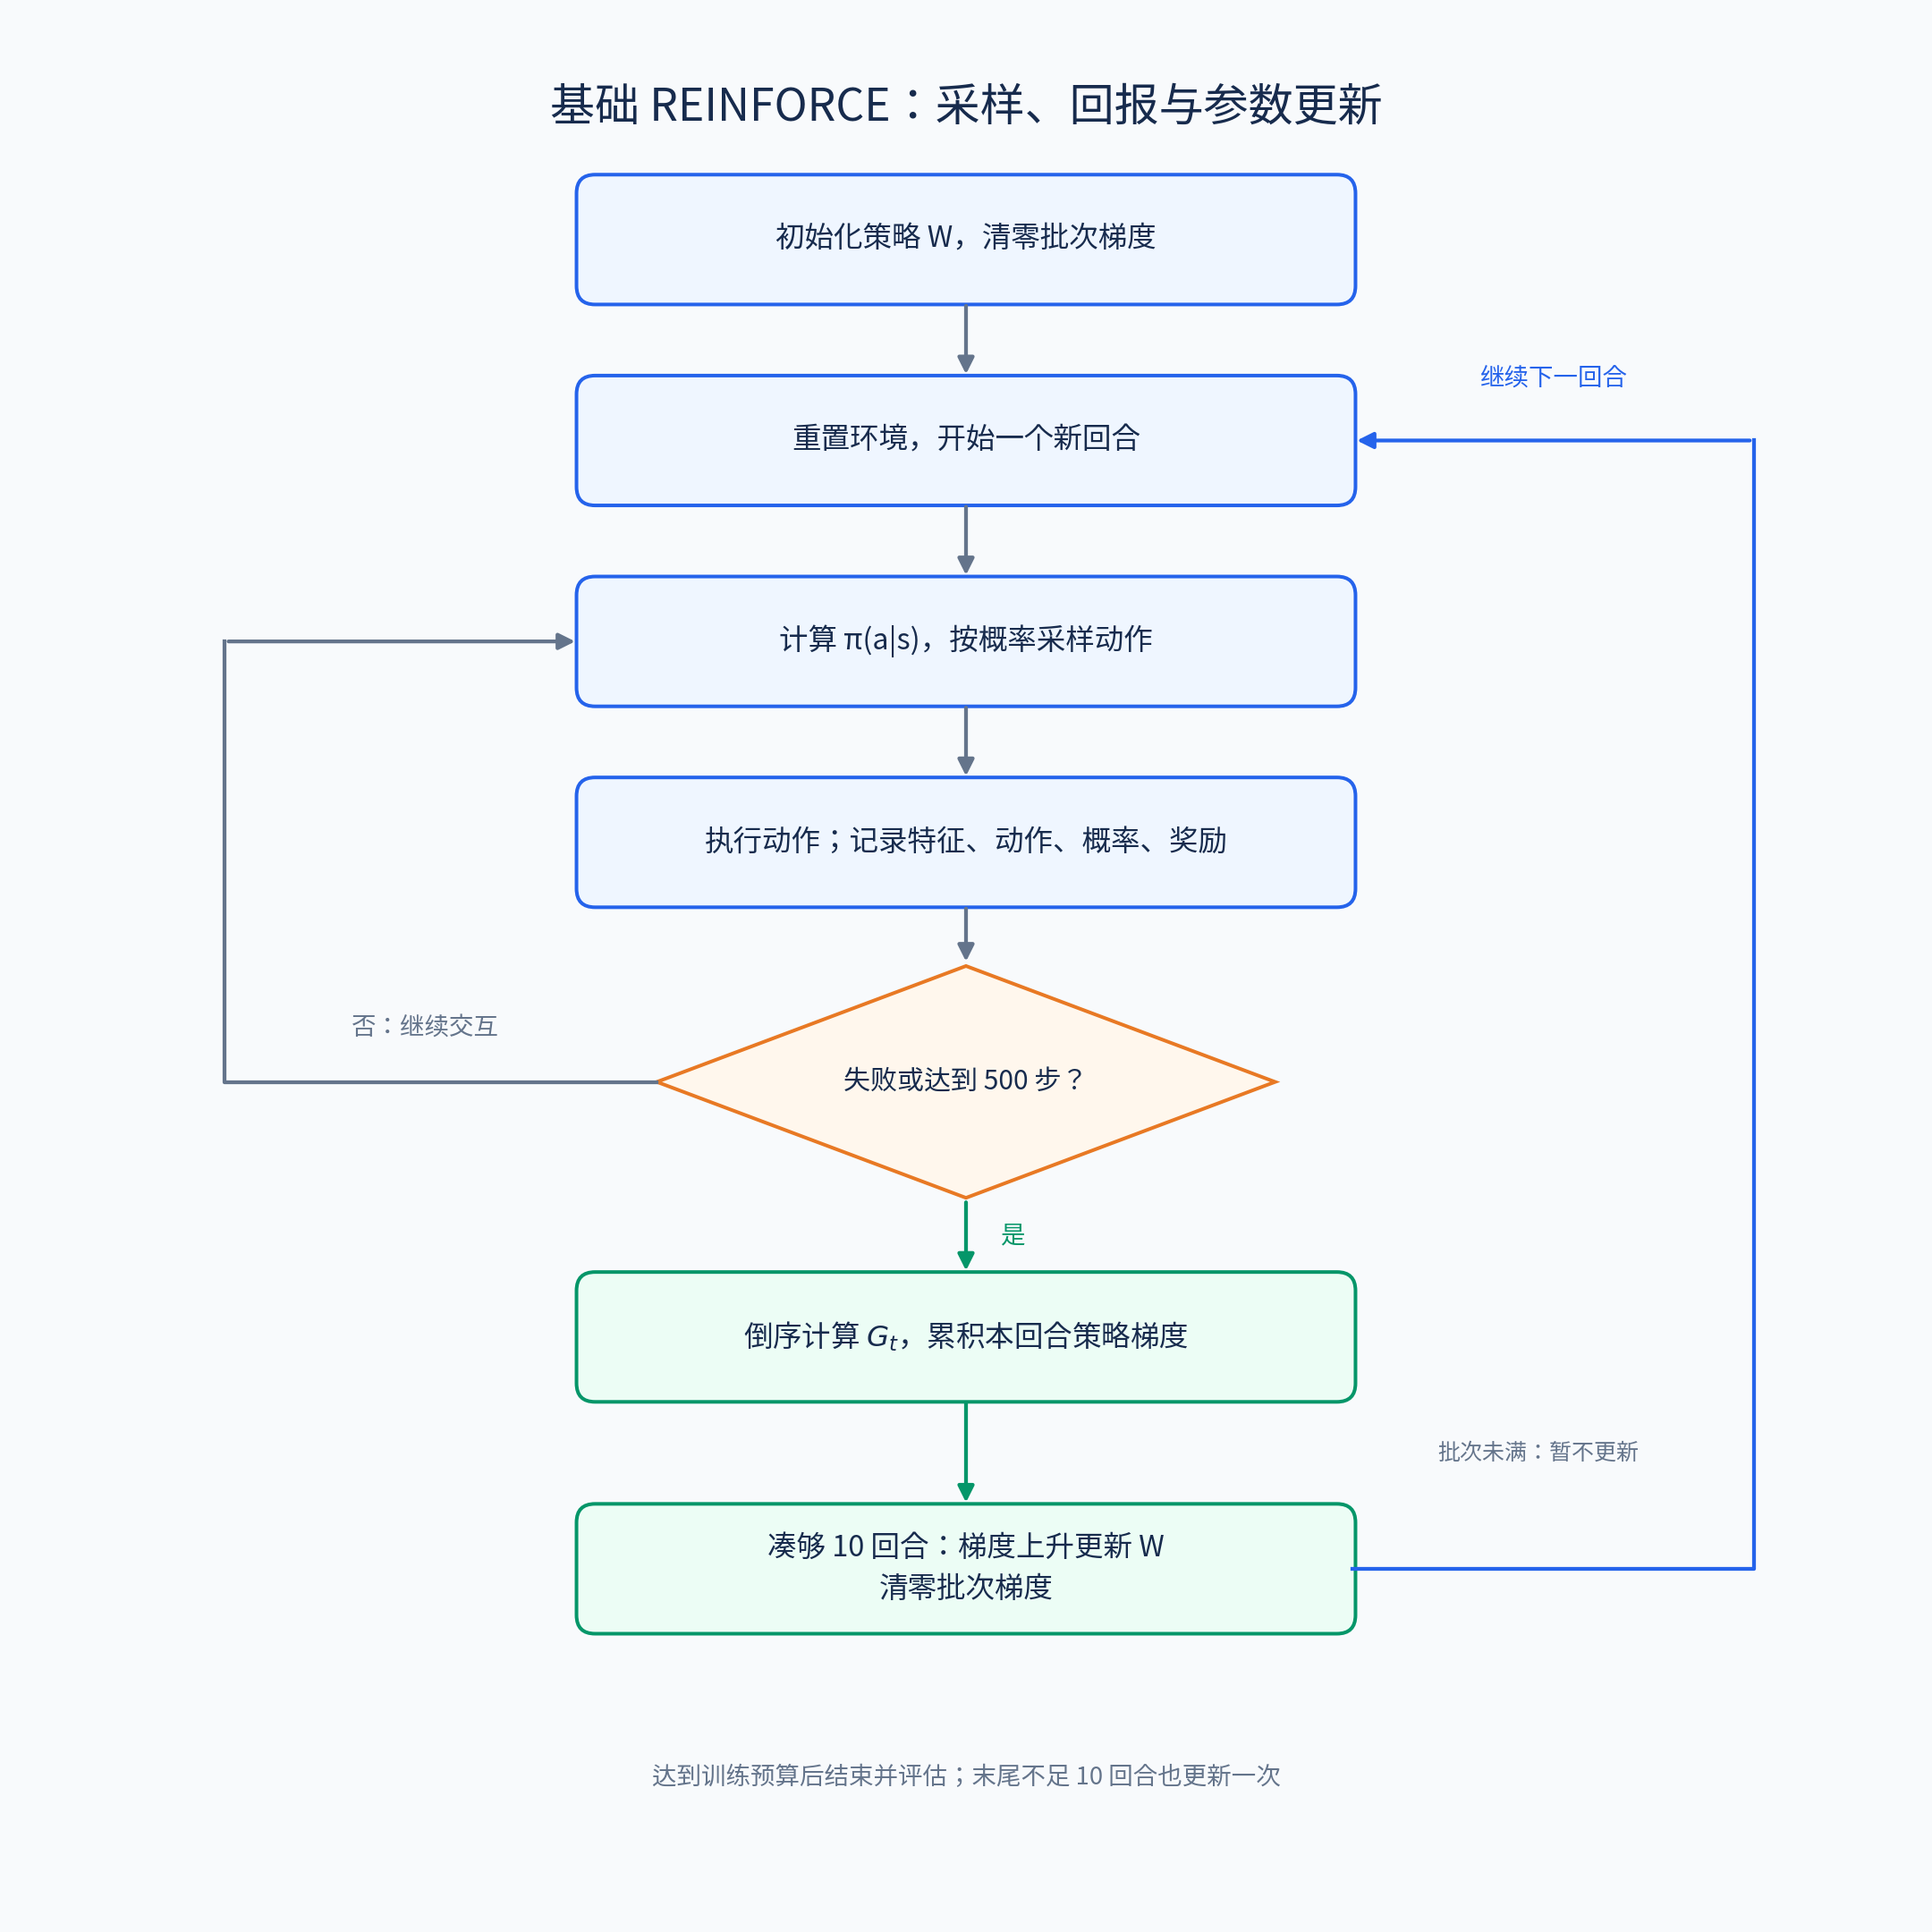
图 3:训练流程。 一个回合内部反复采样和执行动作,参数保持不变。回合结束后计算 reward-to-go 并累积梯度;批次不足 10 回合时直接开始下一回合,批次满后更新参数并清零累积梯度。最后不足一个批次时也执行更新。
- 随机初始化策略参数,重置环境。
- 读取状态,计算两个动作的概率,采样动作。
- 执行动作,保存状态、隐藏层激活、动作、采样概率和奖励。
- 直到失败或达到 500 步,倒序计算 G t G_t Gt。
- 累积这一回合的策略梯度,收集够 10 回合后更新参数。
- 重复训练,最后在另一个随机种子下评估。
这里把 500 步明确作为有限回合任务的结束:不估计结束后的奖励,不进行价值自举。terminated 表示越界失败,truncated 表示达到时间上限,两者都会结束本回合。不能把这个处理直接照搬到无限持续任务的价值学习中。
环境的加速度由当前状态计算,再用显式 Euler 更新四个状态。物理参数为小车质量 1 kg、杆质量 0.1 kg、半杆长 0.5 m、重力加速度 9.8 m/s²。算法只使用观测与奖励;动力学公式负责模拟环境,不参与策略求导。
5. 训练策略与随机策略并排对比
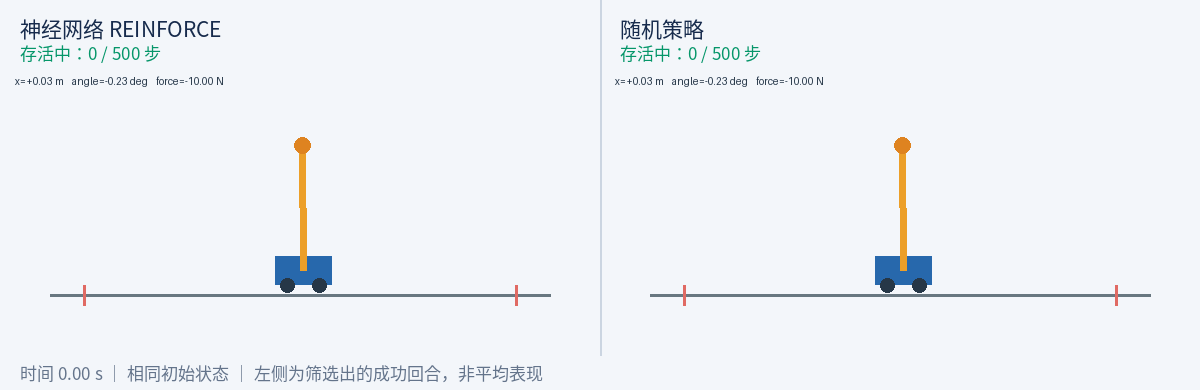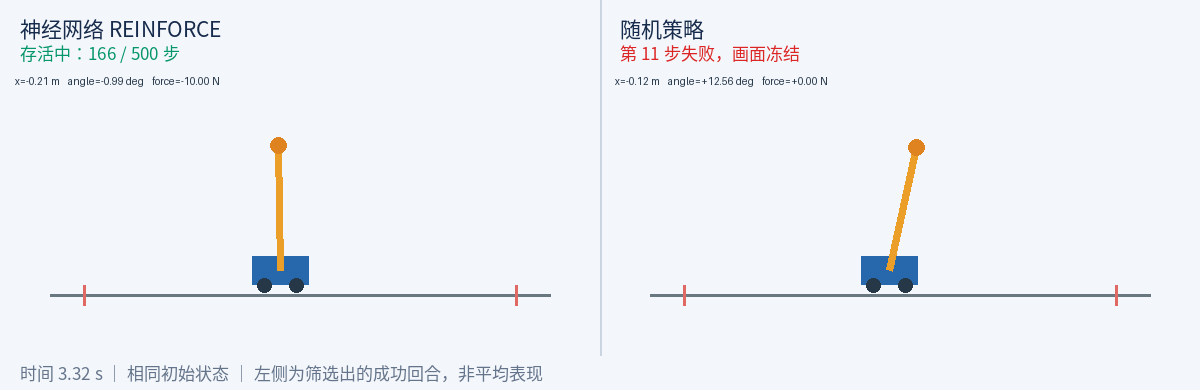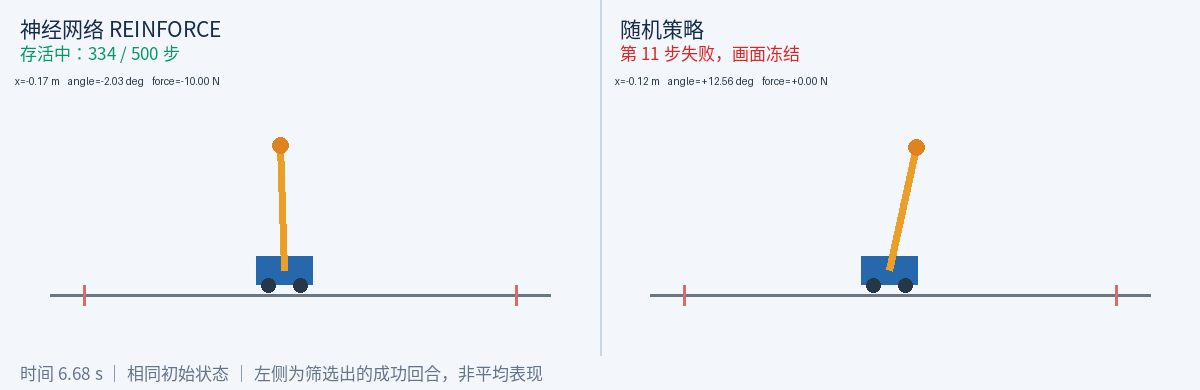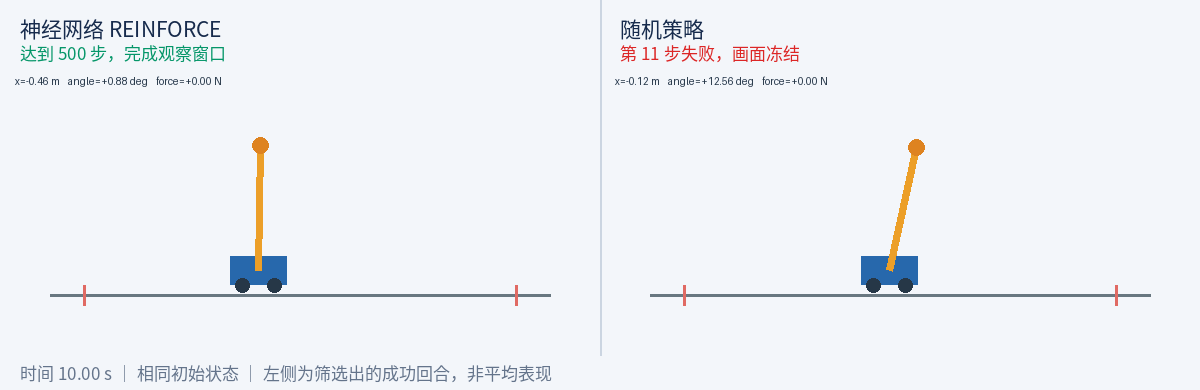
图 4:训练后策略与随机策略的实际轨迹对比。 左侧为训练后的神经网络 REINFORCE 策略,存活 500 步(10 秒) ,达到环境的回合上限;右侧为均匀随机策略,在第 11 步(0.22 秒) 因倾角越界失败,随后画面冻结。两侧从相同初始状态开始,使用相同的物理参数和时间尺度;右侧失败后不会重置。
完整复现代码 :https://download.csdn.net/download/laoxue123456/93701176