TL;DR :CMU、JHU 和 Aurora Innovation 的这篇新论文说,大模型训练的四个阶段------预训练、midtraining、SFT、RL------在算法层面根本就是同一件事 :把合适的 RL 目标改写成「对模型自己生成的成功答案做最大似然拟合」,所有阶段就共享一个损失函数,剩下的全部设计问题只剩三个:喂什么数据、按什么比例、什么时候喂。配套的统一训练系统已经开源,实验显示同算力下泛化和能力保留都更好。
先问一个可能戳到你的问题:你现在要训一个模型,手里有几份完全不同的数据------通用语料、领域教材、标注示范、还有能自动判分的题目。按照教科书流程,你得排四个阶段:先预训练,再 midtraining,然后 SFT,最后 RL。每换一个阶段,数据换、目标函数换,基础设施也得换,很多团队干脆维护着两三套训练代码。
烦不烦?烦。更烦的是,阶段之间还有各种玄学:midtraining 数据喂多了,最终 RL 精度反而掉;RL 训完,预训练学到的通识忘了一堆。这些坑,做后训练的人多少都踩过。
这篇论文的回答简单粗暴:阶段是幻觉,数据才是本质。
想自己动手?资源在这:
它的思路是什么?
拆解之前,先看一个早就存在的事实:预训练、midtraining、SFT 三个阶段用的其实是同一个损失函数------最大似然(就是把「下一个词预测对」的概率往高了调),区别只在喂的数据不同。真正「不合群」的是 RL:它优化的是期望奖励,公式长着另一副面孔。
那 RL 真的特殊吗?论文的钥匙是一类叫 MaxRL 的目标函数。它的直觉特别好懂:
- 模型对每道题采样一批答案,判分;
- 把答对的那些答案挑出来,让模型对这些答案做最大似然------「你自己能做对的题,就把它学得更顺」;
- 全部答错的题,这轮不更新(避免被垃圾答案带偏)。
于是 RL 的每一步更新,等价于「对模型当前策略的成功答案分布做一次最大似然拟合」。到这一步,四个阶段全部统一:大家都是似然拟合,只是数据的来源和权重不同。
具体怎么表达?论文把每种数据源写成「提示词分布 + 目标分布」的一对,再给每个源配一个混合比例 λ,合成一个总的训练数据分布。预训练语料、midtraining 语料、SFT 示范都是现成的静态数据;RL 的「数据」则是模型自己刚生成、刚判过分、按通过率倒数加权的答案。所谓分阶段训练,不过是「每个时刻把 100% 的权重押在某一个源上」的极端特例------而统一训练允许所有源同时在场、比例随时间变化。
这个视角下,传统 RL 里让人头秃的 advantage 估计、奖励归一化都消失了,取而代之的是一个极其朴素的权重:答对的样本权重 = 1/通过率,答错的样本权重 = 0。一道题通过率 10%,答对的那个样本权重就是 10------难题做对了值得多学;通过率 100% 的题,答对了权重 1,别恋战。
系统长什么样?
理论统一了,工程上怎么跑?论文搭了一个「生成器 + 训练器」的异步系统:
- 一个共享数据缓冲区,静态数据和带权重的 RL 生成答案以同一格式混在一起;
- 训练器从缓冲区采样,做一个普通的加权交叉熵更新------就是所有框架里都有的那个 trainer,没有任何特殊组件;
- 生成器拿着模型的近期副本,不停采题、生成、判分,把新数据追加进缓冲区;
- 两者异步运行,训练器每 k 步把最新权重同步给生成器。
换句话说,「训练」这件事从头到尾只有一个循环、一个损失。你不再「切换阶段」,只是拧数据旋钮:预训练期慢慢混入 midtraining 数据,RL 期按比例掺静态语料防止遗忘------把这些写成一个随时间变化的配比表就行。
这其实有点「把戏法变回常识」的味道:深度学习早就教会我们「数据分布决定模型会什么」,这篇论文只是把大模型训练彻底拉回这个常识,代价是需要一套能同时吞吐静态数据和自我生成数据的异步基础设施------好在他们开源了。
效果到底怎么样?
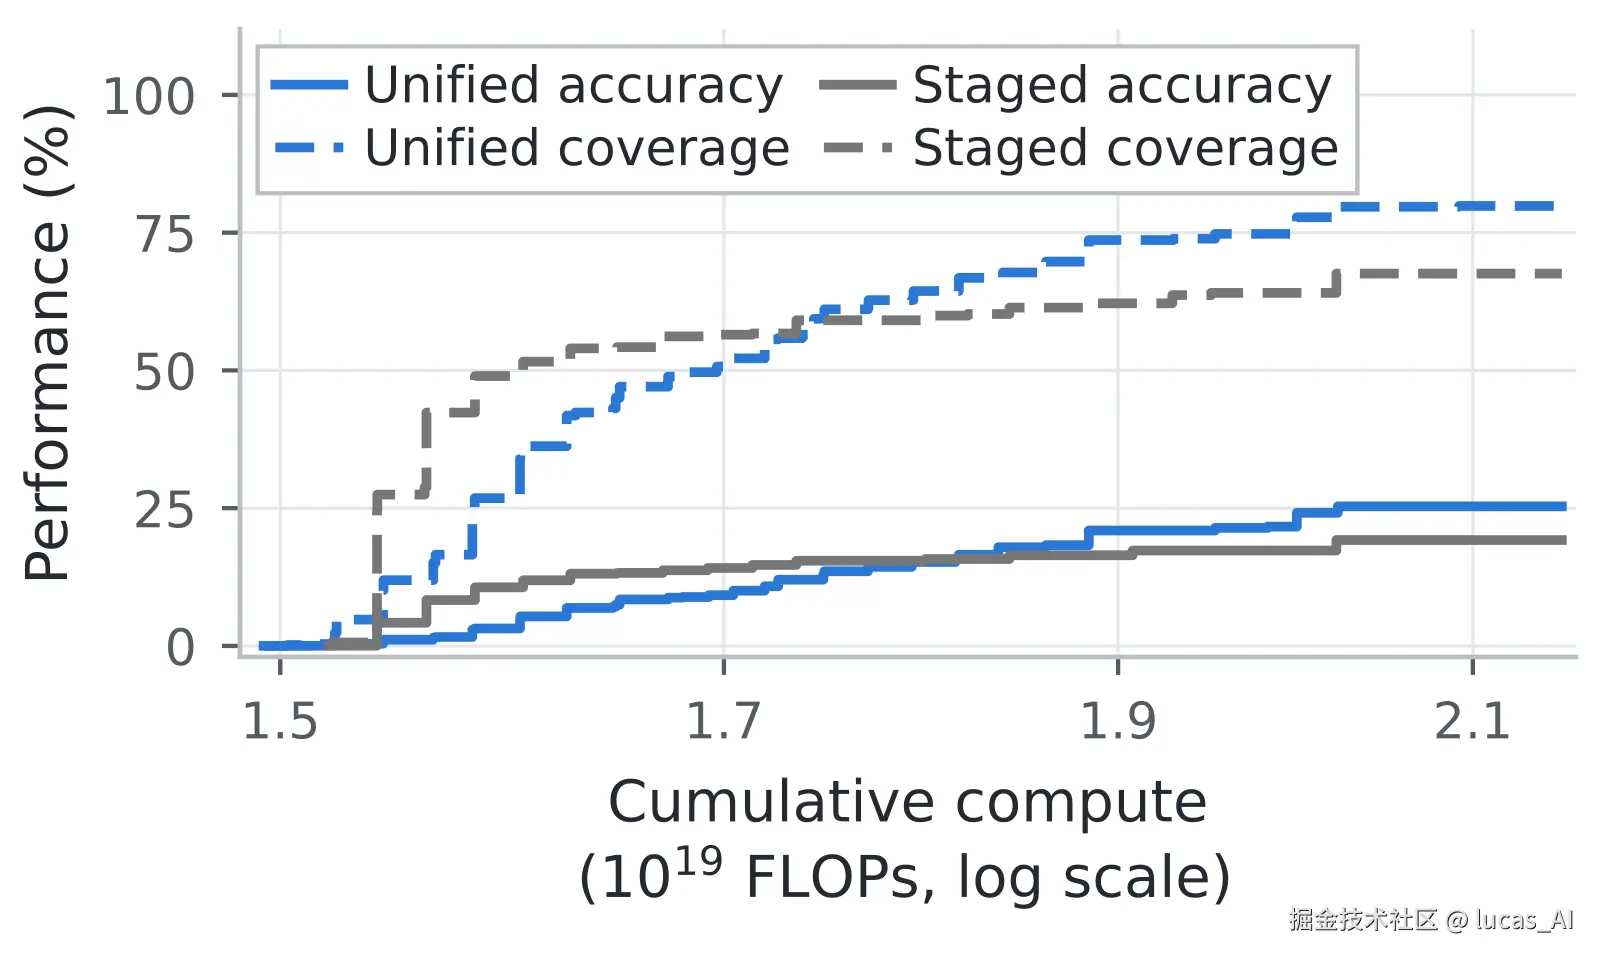
光说不练假把式。论文做了两层实验,先说受控实验:124M 小模型从零训起,20B token 预训练语料、510M token midtraining 语料全部固定,任务是一类可自动判分的推理谜题,统一与分阶段两种范式在同算力预算下正面对比。
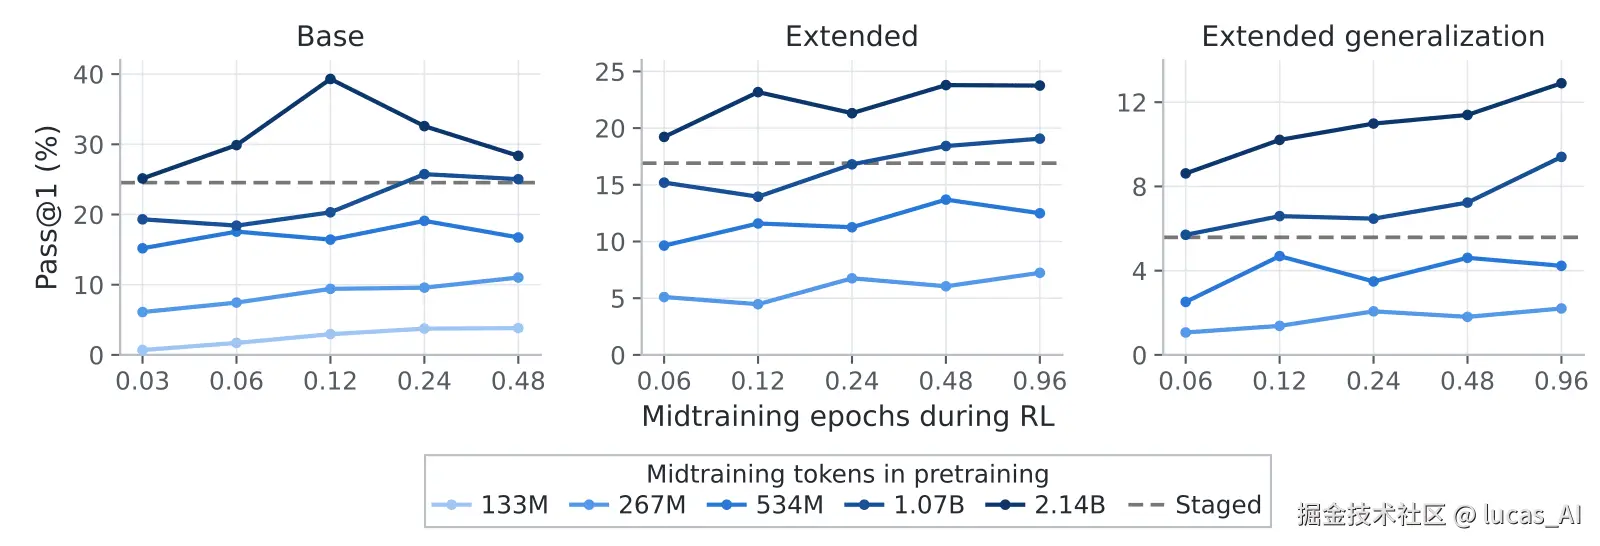
(统一训练的最优配置在 Base、Extended 和更难的泛化设定上全面超过最优分阶段配置。还有个反直觉发现:预训练期混入的 midtraining 数据越多,最终 RL 后表现越好------同一份语料,统一训练能「多吃几轮」而不撑着,分阶段训练多喂就伤。)
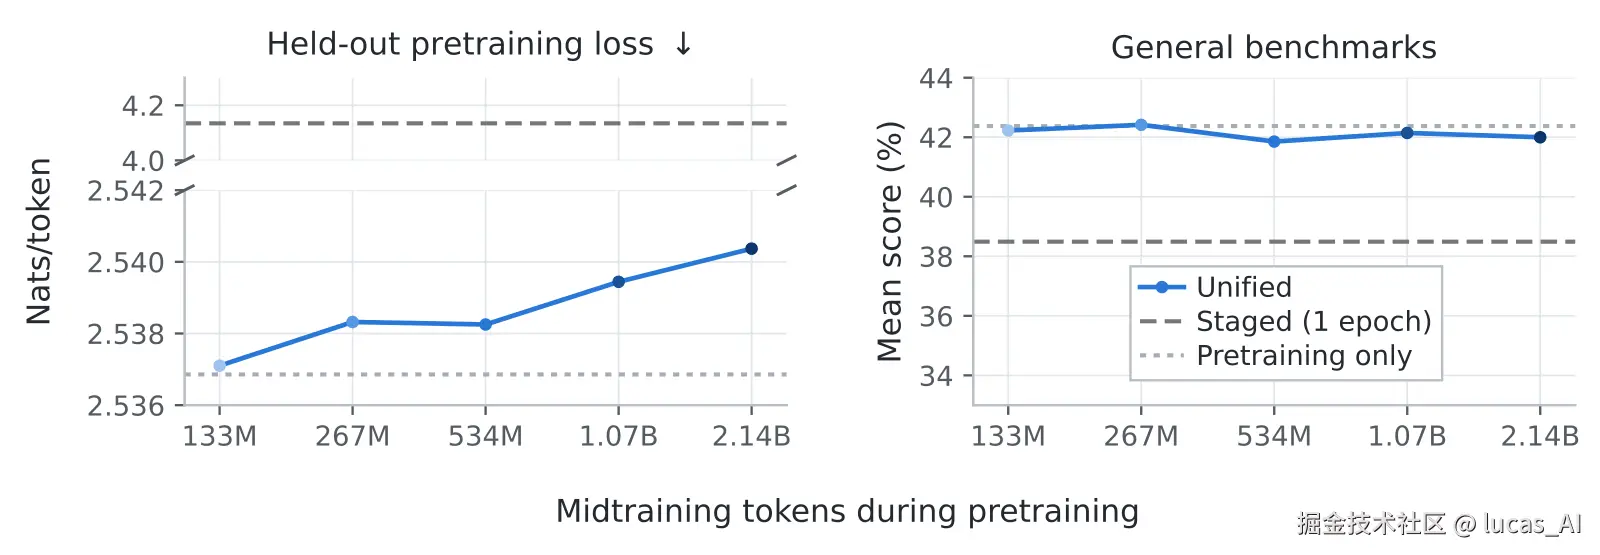
(能力保留的差距更扎眼:把 midtraining 数据混进预训练后,统一训练各配置的 held-out loss 和通用基准分数几乎贴着「纯预训练」的水平线;而最优的分阶段配置,loss 明显上升、基准分数明显下滑。一句话:边学新技能边复习旧知识,忘得少。)
再看真实数据实验:0.76B 模型,数学 RL 期间混入 0~5% 的异构语料(网页、数学、代码、推理链)。
- 混入数据对数学精度几乎无伤,覆盖率反而更高;
- 非零混合全部把 held-out 语料 loss 压到基线以下,通用知识评测(SciQ)普遍提升;
- 代价是 Coding 精度随比例下降------权衡是真实存在的,不是免费午餐。
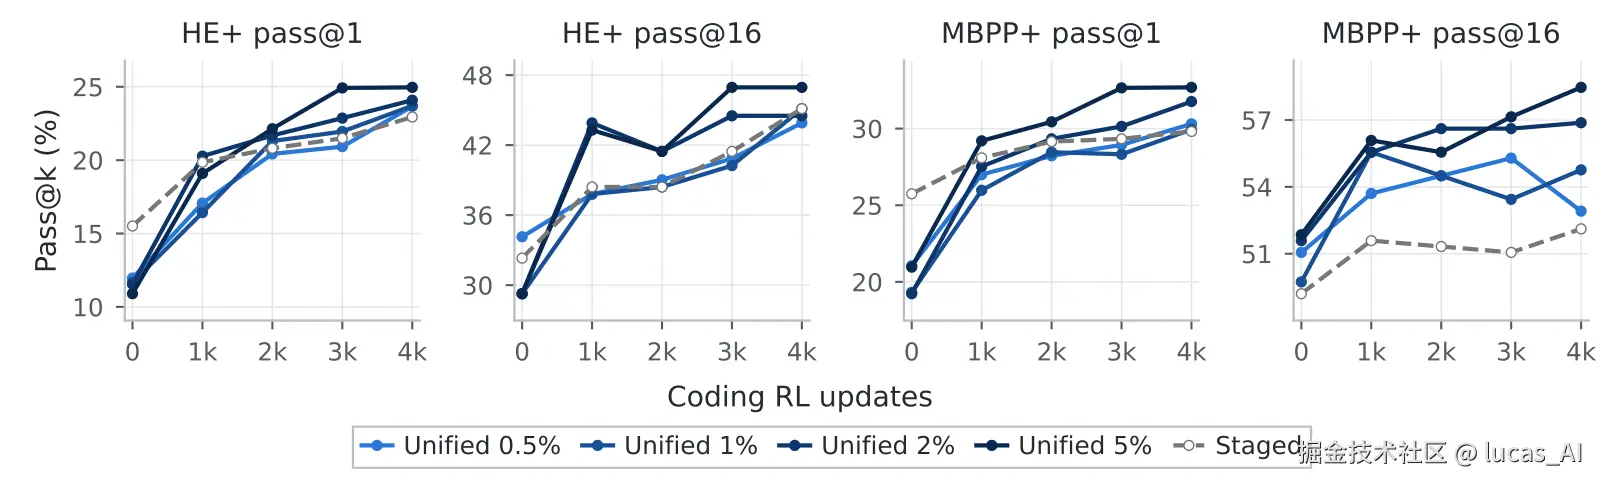
最实用的发现是持续学习:数学训练完成后,所有模型接受完全相同的纯代码 RL。结果统一模型起点更低、终点更高,最终 HumanEval+ 和 MBPP+ 精度全面超过分阶段模型,5% 混合比例四项指标全部领先。之前的学习方式让模型「更会学下一件事」,这比单项分数更有想象空间。
我该怎么用?
泼冷水之前,先给可能马上想试的几个方向:
- 后训练团队:论文那套「样本带权统一格式」改造成本不高------SFT 样本和 RL 样本放进同一个 dataloader,RL 样本按 1/通过率加权、全错置零,就能把两阶段合成一个循环。
- 被「灾难性遗忘」折磨的人:与其在 RL 损失里加 KL 惩罚(论文实测:最强的 KL 惩罚把数学性能也一起压死了,复现不了混数据的效果),不如直接往 RL 批次里掺静态语料。
- 做训练基础设施的人:异步「生成-训练」解耦 + 共享缓冲是值得抄的架构,论文开源实现可以直接读。
泼冷水时间
把预期管理好,几个该打问号的地方:
- 规模:所有实验的主角是 124M 和 0.76B 的模型。「Foundation Models」这个词配上百万级参数,落差不小------结论在 10B+ 上是否成立,没人知道,包括作者。
- 「统一更好」是有脚注的 :受控实验里,分阶段训练在中间算力区间的精度、以及多数区间的覆盖率上仍然占优;统一训练的优势集中在大算力预算、泛化设定和能力保留上。标题的野心比实验结论大一号。
- 没有配方:混合比例和调度(常数/衰减/退火)目前靠搜,论文明确说「没有发现普适最优」,也没有建立有预测力的 scaling law。想抄作业的人得自己做网格搜索。
- 持续学习优势的另一种解释:统一模型的数学 RL 期间一直在见代码语料,终点更高可能只是「没忘」而非「更会学」------虽然论文的语料消融部分缓解了这个疑虑,但没有完全排除。
理性看待
这篇论文最值钱的不是某个数字,而是视角的收缩:训练大模型这件事,从「编排四个各具特色的阶段」收缩成「给一张不断演化的数据配方表」。概念上它把 RL 拉回了似然估计的大家庭,工程上它证明一个 trainer 就能跑完全程,实证上它给出了「精度-覆盖-保留」三角权衡的第一手数据。
对一线从业者,我的建议是:把「统一训练」当成一个值得在自己的规模上验证的假设,而不是一个可直接照搬的结论。反正代码开源了,124M 复现成本不高------你的下一次后训练,也许可以试试只写一张配比表。