【写在前面】
这个系列从零开始讲强化学习。每篇都先用漫画 把意思讲明白,再给公式,最后代入数字手算一遍------公式一时看不懂没关系,跟着例题算一遍就懂了。
主角是扫地机器人小扫 ,它要在一条走廊里自己学会找充电座;戴眼镜的老评负责提问和点评。图里的颜色有固定的意思,记住这四种,后面所有的图都能看懂:
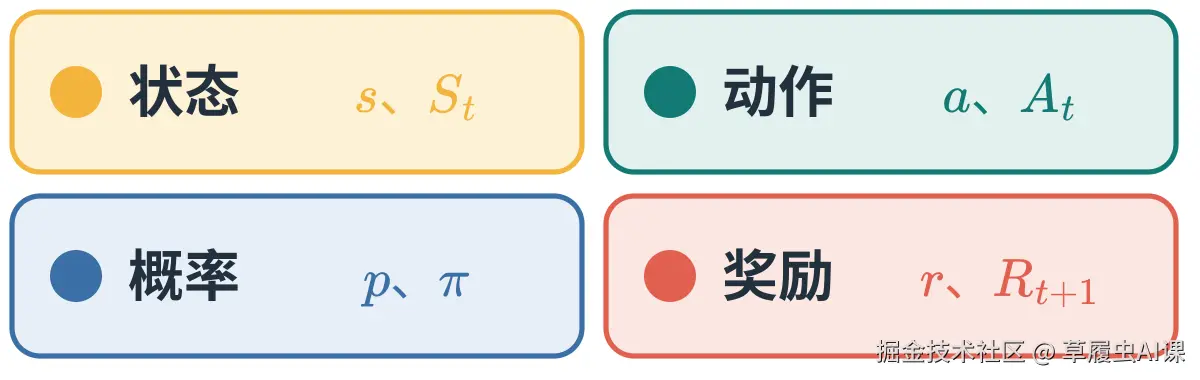
▲ 图 1 图里四种颜色的意思
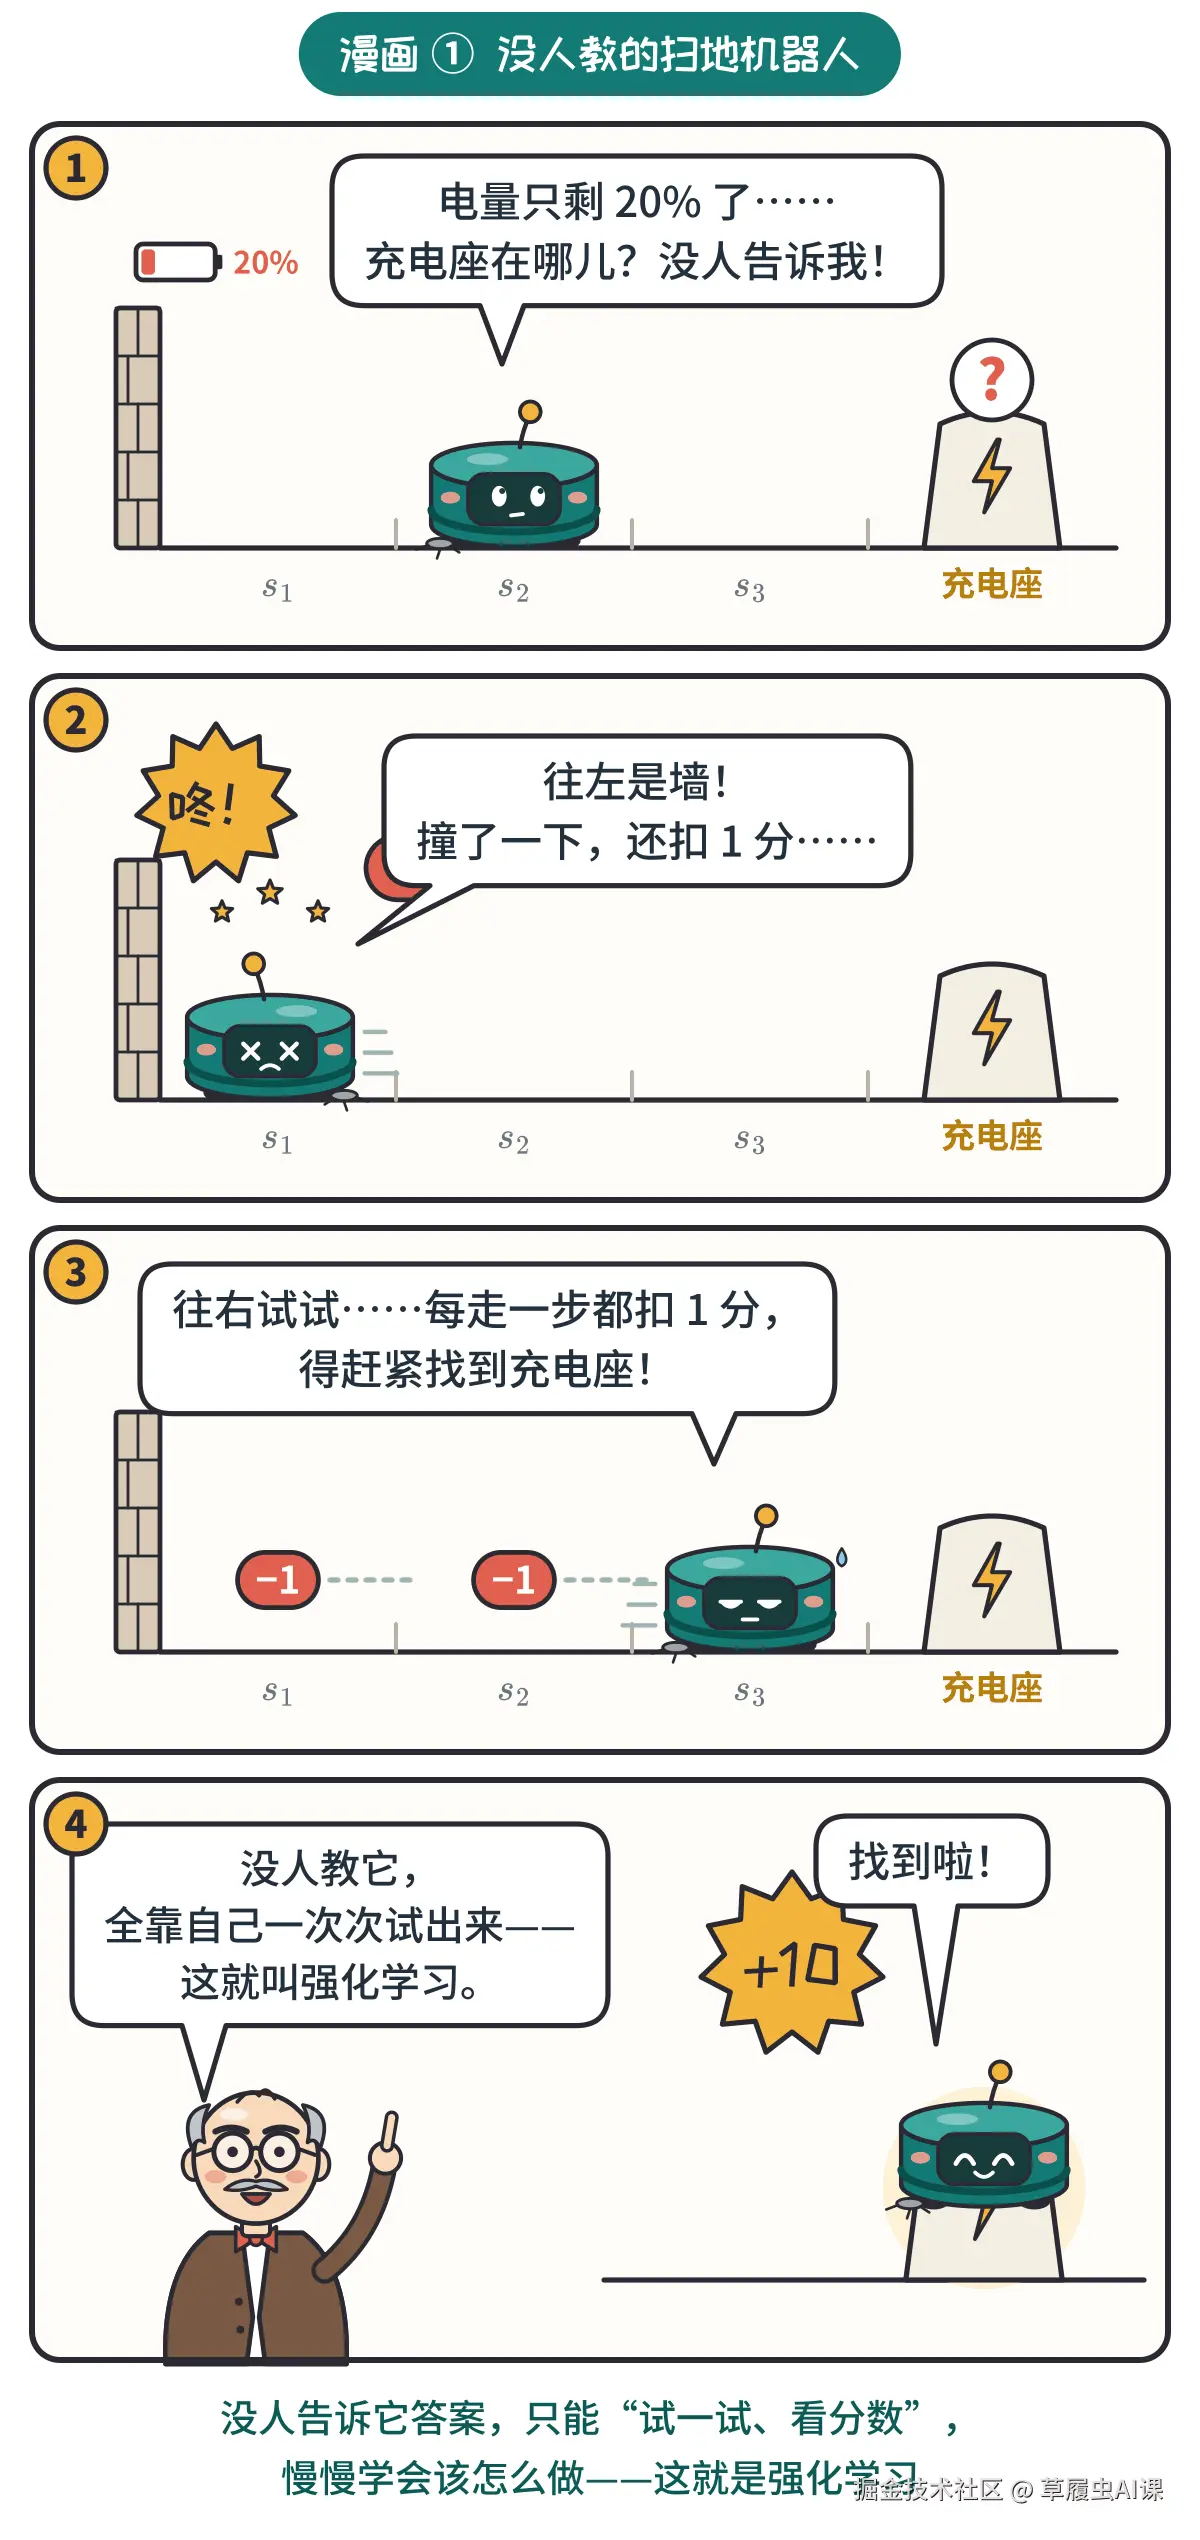 ▲ 图 2 漫画 ① 没人教的扫地机器人
一、强化学习在学什么
漫画里的小扫没有说明书,也没人告诉它充电座在哪。它只能自己动一动,看看结果:往左撞了墙,扣 1 分;往右走,每步也扣 1 分;进了充电座,加 10 分。试得多了,它就知道"一路往右"最划算。
这就是强化学习 (Reinforcement Learning,RL):智能体在环境里反复尝试 ,根据得到的奖励 ,慢慢学会怎样做才能拿到最多的奖励。
"强化"两个字的意思是:带来好结果的做法,以后会被"加强"、做得更多;带来坏结果的做法,就做得越来越少。
和"有老师教"的学习有什么不同
机器学习里最常见的是监督学习:每道题都有标准答案,比如给模型看一张猫的照片,同时告诉它"这是猫"。强化学习没有这样的老师:
| 监督学习 | 强化学习 | |
|---|---|---|
| 给什么 | 每道题的标准答案 | 只给分数(奖励),不说正确做法 |
| 何时给 | 马上给 | 常常要等很多步以后 |
| 数据 | 事先准备好的一批 | 自己边做边收集 |
| 例子 | 认出照片里的猫 | 下棋、玩游戏、控制机器人 |
第二行最让人头疼。小扫往右走的每一步都扣了 1 分,直到最后一步才拿到 +10。那这 10 分该算是哪一步的功劳?是最后一步,还是前面那几步也有份?这叫延迟奖励,强化学习的很多方法都是在想办法回答这个问题。
第三行也很关键:小扫换一种走法,看到的就是另一批数据。学习和收集数据搅在一起,这也是强化学习和监督学习很不一样的地方。
【档案】
1898 Edward Thorndike(桑代克)
美国 · 哥伦比亚大学
博士论文里把饿猫关进"迷箱",箱外放着食物。猫乱抓乱碰,偶然碰到机关就能出来;关的次数越多,出来得越快。1911 年他在《动物智力》一书里把这总结成"效果律":带来满足的动作,以后更容易被重复。这正是"强化"的意思。
1998 Richard Sutton、Andrew Barto(萨顿、巴托)
美国 · 麻省大学阿默斯特分校
两人从 1978 年起在这里合作研究强化学习,1998 年出版教科书《强化学习导论》(2018 年出第 2 版),本系列的记号就沿用这本书。两人因为奠定了强化学习的概念和算法基础,获得 2024 年图灵奖。
二、智能体和环境:一来一回的循环
先认识强化学习里的五个基本角色:
- 智能体(agent):做决定、会学习的那一方,比如小扫。
- 环境(environment):智能体以外的一切,比如走廊、墙和充电座。环境的规则,智能体事先并不知道。
- 状态 (state):环境此刻是什么样子,比如"小扫在 s2"。
- 动作(action):智能体能做的选择,比如"往左""往右"。
- 奖励(reward):每做一个动作,环境回给的一个数,告诉智能体这一步好不好。
它们按固定的节奏一来一回:智能体看状态、选动作;环境收到动作,给出新状态和奖励;然后进入下一轮。
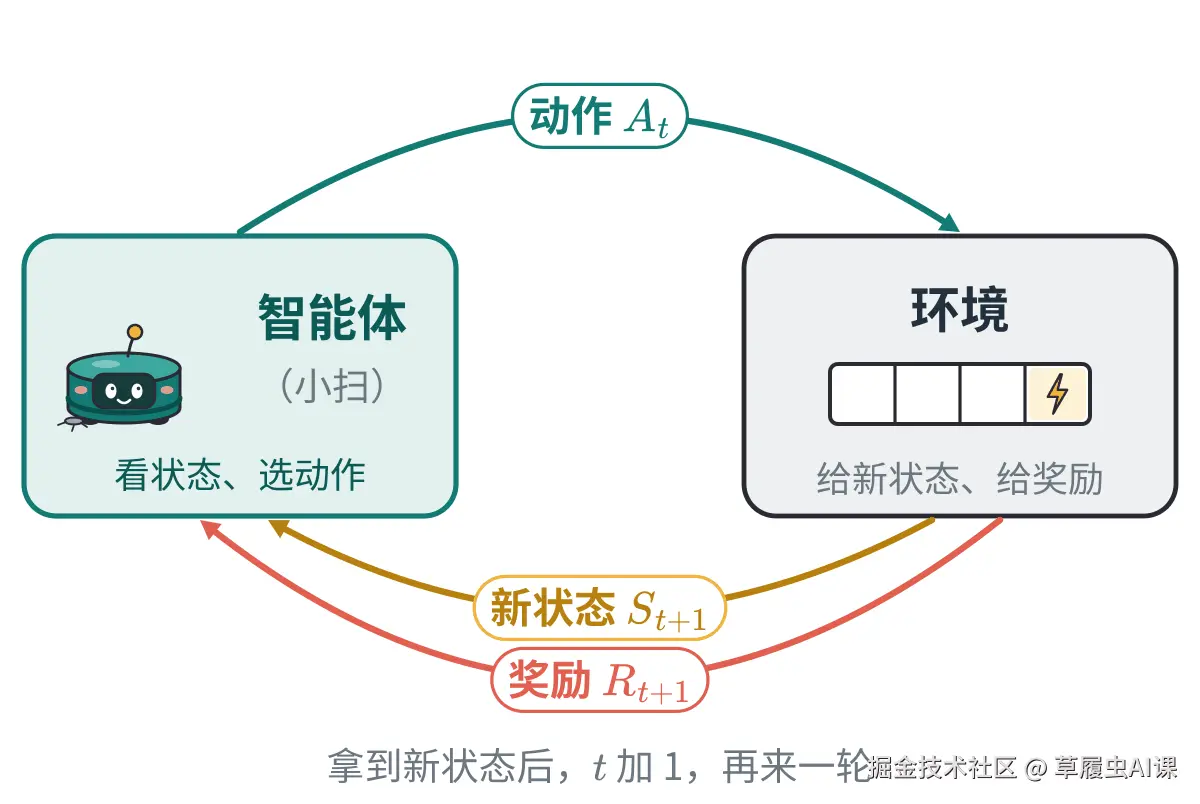
▲ 图 3 智能体和环境的循环:动作送过去,新状态和奖励送回来
本系列的例子:走廊里的扫地机器人
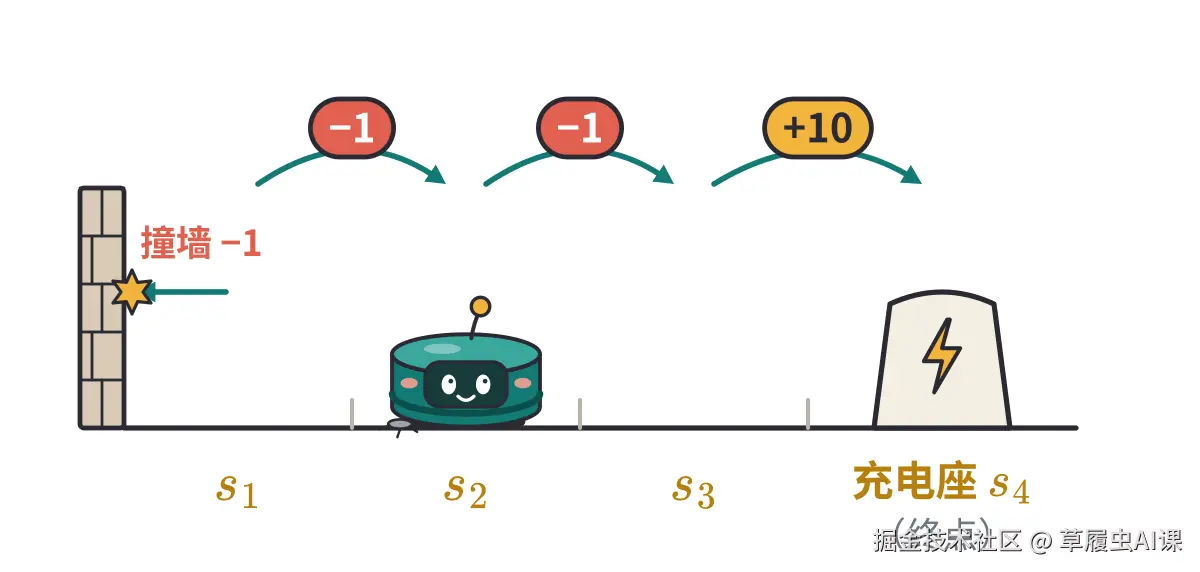
▲ 图 4 走廊里的扫地机器人:一共三个格子,最右边是充电座
【设定】走廊的规则
- 状态 :三个格子 s1,s2,s3,加上充电座 s4。进了充电座,这一回合就结束。
- 动作 :往左 ←、往右 →。动作的结果是确定的:按 → 就一定往右挪一格;在 s1 按 ← 会撞墙,原地不动。
- 奖励:每走一步 −1(耗电),撞墙那一步也一样;走进充电座的那一步 +10。
每步扣 1 分,是在催小扫"别磨蹭";进充电座 +10,是告诉它"这里就是目标"。注意:奖励只说好不好,不说该怎么做------该怎么做,要小扫自己去找。
一个回合怎么记
从出发到进充电座,叫作一个回合 (episode)。把一个回合里发生的事按时间排好,就是一条轨迹:
S0, A0, R1, S1, A1, R2, S2, ...
注意下标:在时刻 t 做了动作 At,环境要到下一刻 才回给奖励和新状态,所以它们的下标是 t+1,记作 Rt+1、 St+1。本系列一直用这个记法(和 Sutton、Barto 的教材一致)。
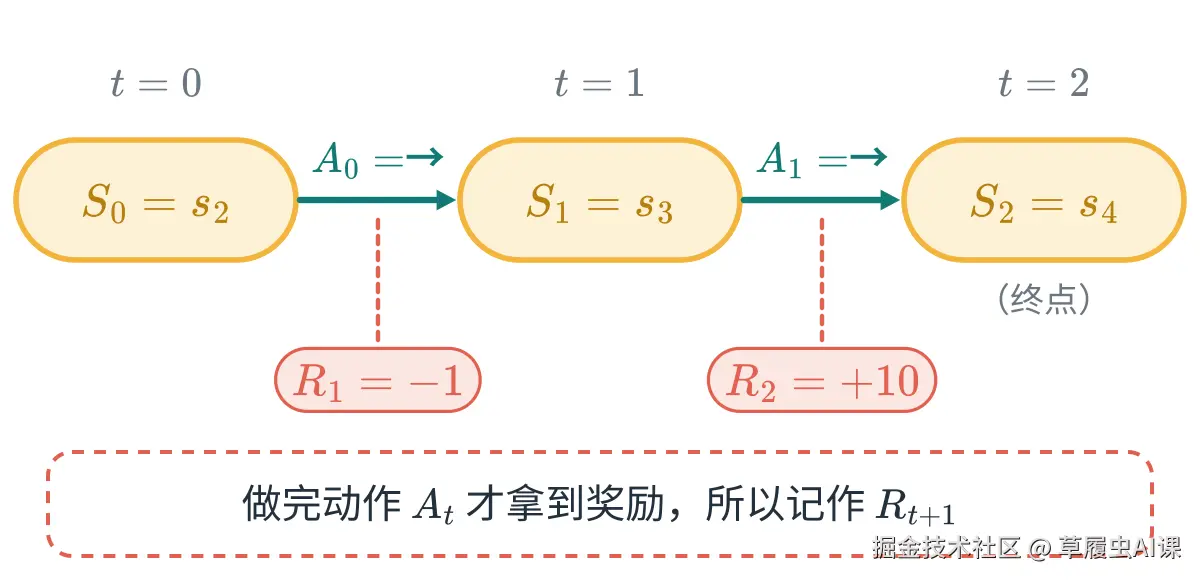
▲ 图 5 回合 A 的轨迹:从 s2 出发,两步就到充电座
【例 1】写出回合 A 的轨迹
小扫从 s2 出发,连按两次 →。
第 1 步( t=0):在 S0=s2 做 A0= →,走到 s3,扣 1 分。所以 R1=−1, S1=s3。
第 2 步( t=1):在 S1=s3 做 A1= →,进了充电座,加 10 分。所以 R2=+10, S2=s4,回合结束。
整条轨迹就是:
S0=s2, A0=→, R1=−1,S1=s3, A1=→, R2=10, S2=s4
【注意】回合制任务和持续性任务
像走廊这样有终点、走到终点就结束的任务,叫回合制任务 ,下一盘棋、打一局游戏都是。也有没有终点、一直进行下去的任务,叫持续性任务,比如一直调节室温的空调。
三、回报:把以后的奖励都算上
每一步都有奖励,但只看一步的奖励是不够的:往右走那一步也扣了 1 分,可它让小扫离充电座更近了。要评价"从现在起走得好不好",得把从现在起往后的奖励都算上 ,这个总和叫回报 (return),记作 Gt。
那把奖励直接加起来行不行?老评先问了小扫一个问题。
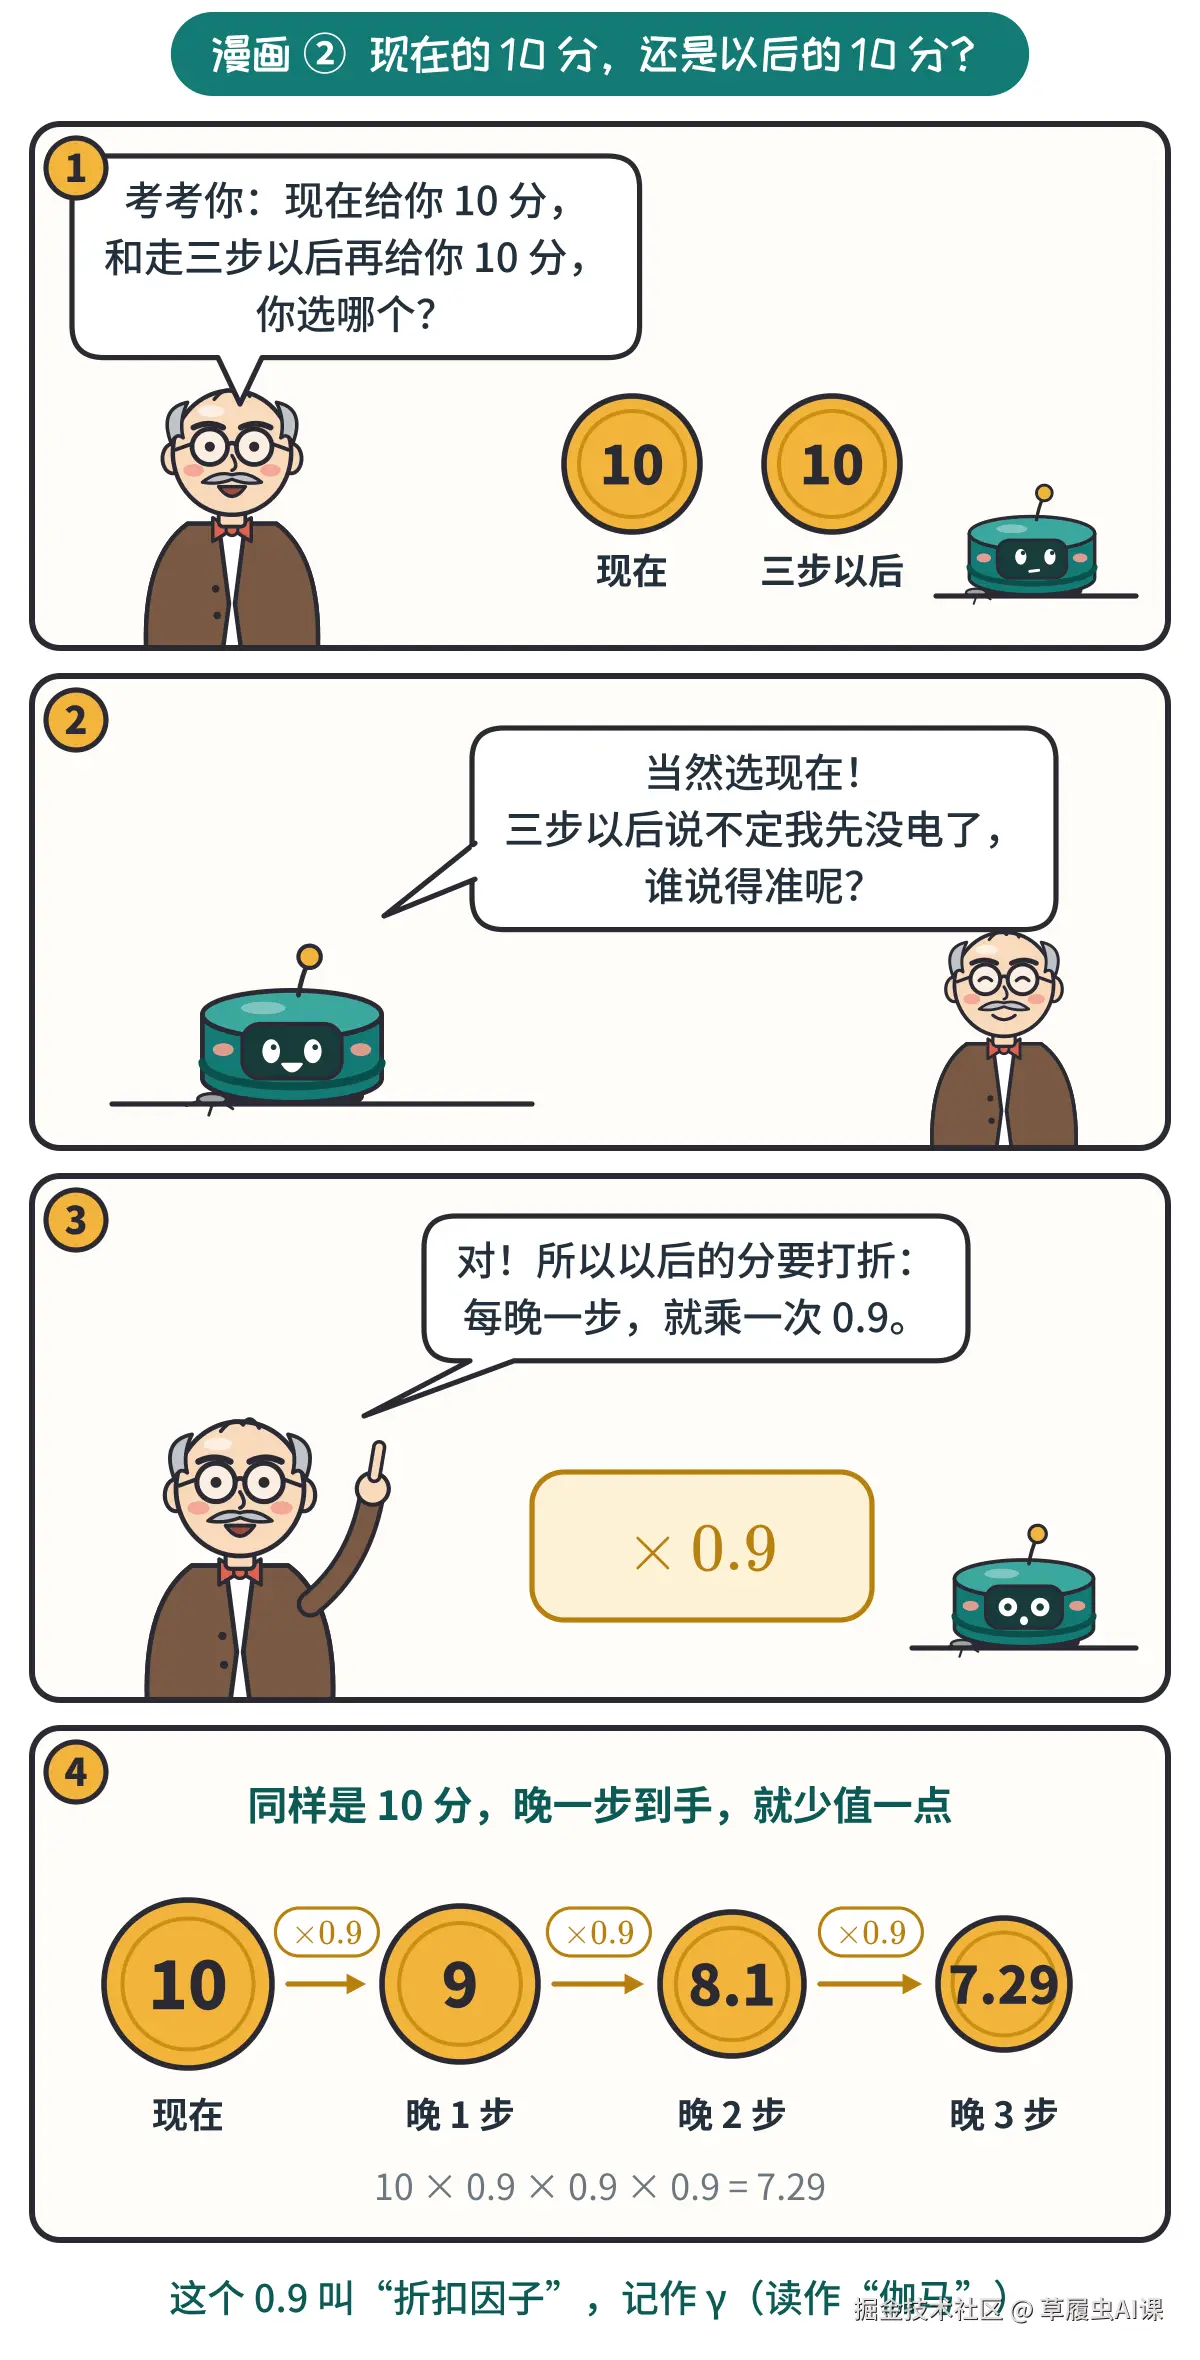
▲ 图 6 漫画 ② 现在的 10 分,还是以后的 10 分?
小扫选"现在"是有道理的:以后的事说不准,同样的 10 分,越晚到手越不值钱。所以算回报时,每晚一步,奖励就多乘一次折扣因子 γ ( 0≤γ≤1;走廊的例子里取 γ=0.9):
Gt=Rt+1+γRt+2+γ2Rt+3+⋯=k=0∑∞γkRt+k+1
读法:紧跟着的奖励 Rt+1 按原价算;再下一个乘 0.9;再下一个乘 0.92=0.81......回合结束以后就没有奖励了,后面的项都是 0。
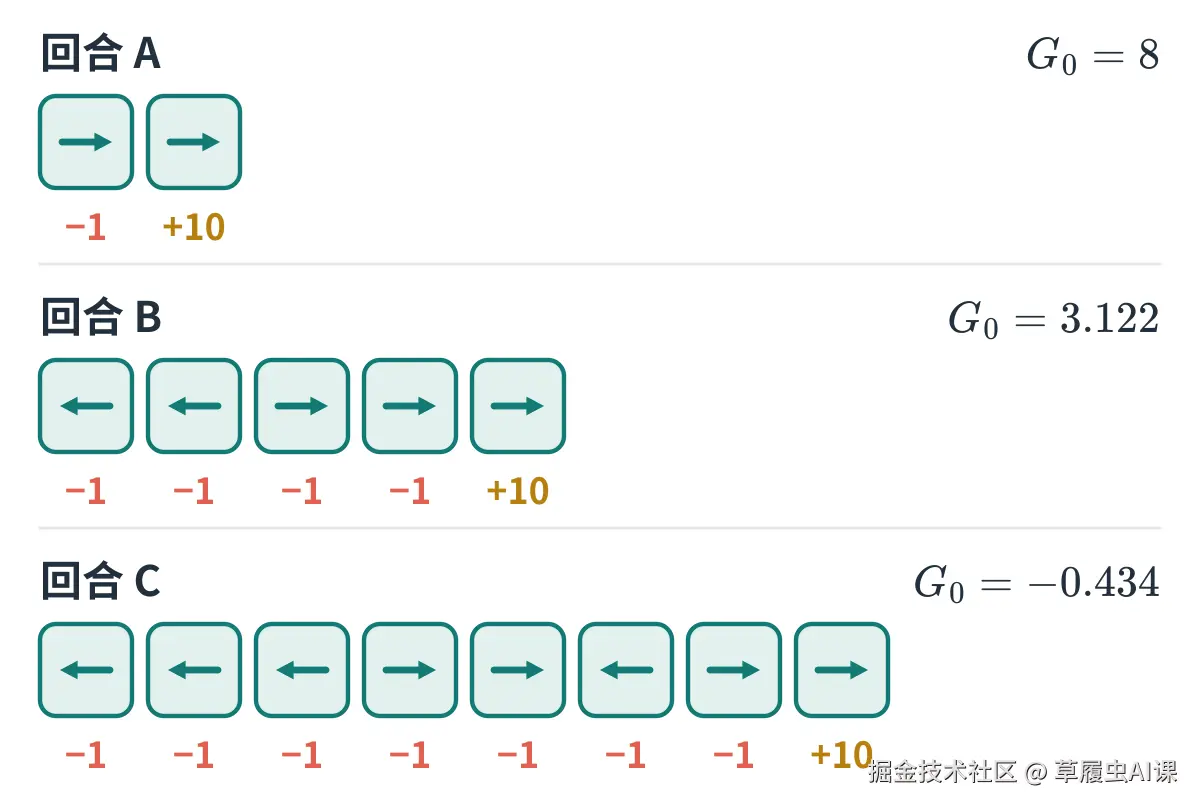
▲ 图 7 三个回合:都从 s2 出发,走法不同,回报也不同
【例 2】算三个回合的回报
取 γ=0.9,三个回合都从 s2 出发,算的是 G0。
回合 A(→→):一步 −1,一步 +10。
G0=−1+0.9×10=8
回合 B (←←→→→):路线是 s2→s1→s1(撞墙) →s2→s3→ 充电座。前 4 步各 −1,第 5 步 +10:
G0=−1−0.9−0.81−0.729+0.94×10=−3.439+6.561=3.122
回合 C (←←←→→←→→):撞了两次墙,还在 s3 掉头走回了 s2,前 7 步各 −1,第 8 步 +10:
G0=−(1+0.9+⋯+0.96)+0.97×10=−5.217+4.783=−0.434
同样从 s2 出发,走得越绕,回报越低。回合 C 甚至是负的:一路扣的分比最后那 10 分还多。
【例 3】γ 取不同的值
还是这三个回合,换几个 γ 再算一遍:
| γ | 回合 A | 回合 B | 回合 C |
|---|---|---|---|
| 0 | −1 | −1 | −1 |
| 0.5 | 4 | −1.25 | −1.91 |
| 0.9 | 8 | 3.122 | −0.434 |
| 1 | 9 | 6 | 3 |
- γ=0:只看眼前一步。三个回合第一步都扣 1 分,完全分不出好坏------太"短视"。
- γ=1:一点不打折。只要最后能到充电座,绕点远路也不太亏。
- γ=0.9:既看得远,又鼓励早点到。
【要点】为什么要打折
- 以后的事不确定。早拿到的奖励更靠得住。
- 鼓励早点完成。同样到终点,步数越少,回报越高。
- 数学上更省心 。如果任务永远不结束,奖励一直加下去会变成无穷大;打了折就有上限。比如每步 −1 一直走下去, γ=0.9 时总和是 −1÷(1−0.9)=−10。所以 γ=1 只能用在一定会结束的回合制任务上。
从后往前算,更省事
把回报的式子拆开看,后面那一串正好是"下一步的回报":
Gt=Rt+1+γ(Rt+2+γRt+3+⋯)=Rt+1+γGt+1
一句话:这一步的回报 = 这一步的奖励 + γ × 下一步的回报。所以可以从最后一步往前推,每次只做一次乘法、一次加法。
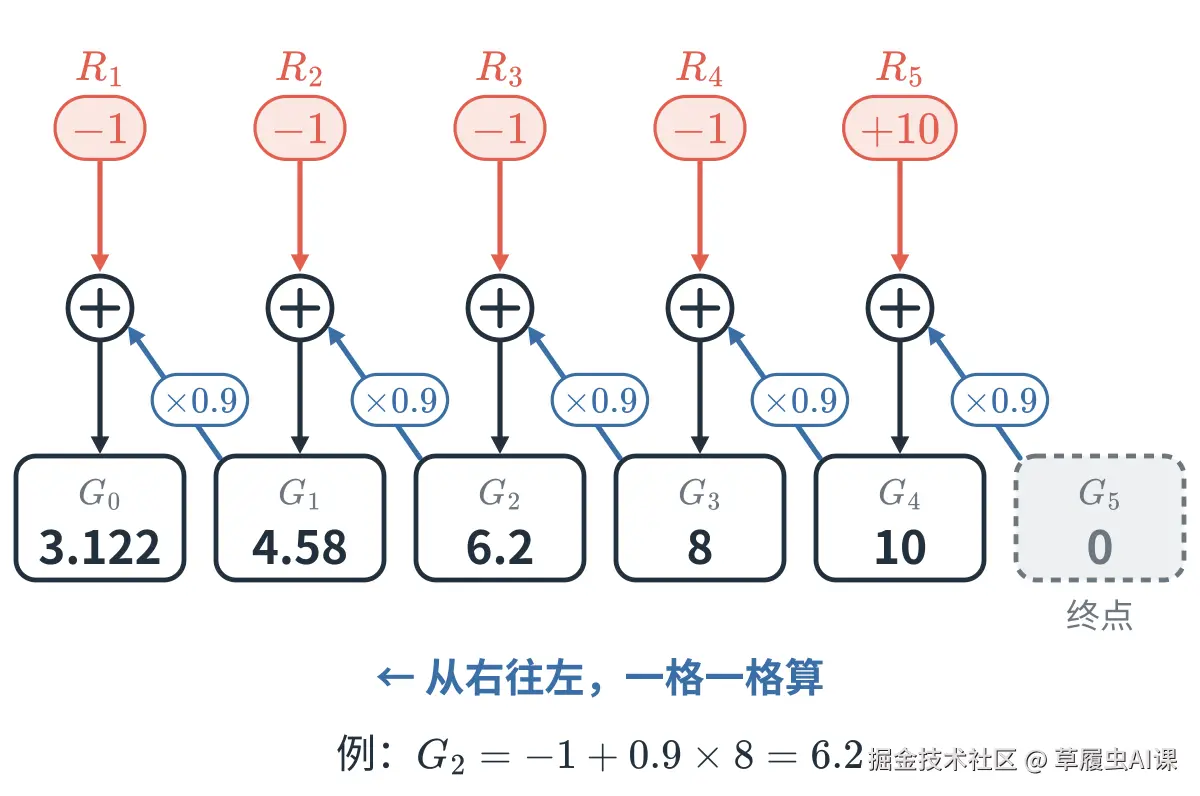
▲ 图 8 回合 B 从后往前算回报:每个 ⊕ 把上面的奖励和右边传来的"回报 ×0.9"加在一起
【例 4】从后往前算回合 B
回合 B 一共 5 步,奖励依次是 −1、−1、−1、−1、+10。终点之后没有奖励,所以 G5=0:
G4G3G2G1G0=10+0.9×0=10=−1+0.9×10=8=−1+0.9×8=6.2=−1+0.9×6.2=4.58=−1+0.9×4.58=3.122
和例 2 一口气算出的 3.122 一样,而且顺便得到了回合里每一个时刻的回报。下一篇的贝尔曼方程,就是从这个"这一步 + γ × 下一步"长出来的。
【要点】
回报是一个回合的成绩。同一个起点,这回走得顺,回报就高;下回绕了远路,回报就低。想知道一种走法"平均"有多好,得看很多个回合------这一点在第五节还会用到。
四、马尔可夫决策过程:把规则写清楚
到这里,一个强化学习问题的各个部分都齐了。把它们用数学写清楚,就叫马尔可夫决策过程(Markov Decision Process,简称 MDP)。它有五个要素:
| 要素 | 记号 | 意思 | 走廊里 |
|---|---|---|---|
| 状态 | S | 所有可能的状态 | s1,s2,s3,s4 |
| 动作 | A | 所有可能的动作 | ←、→ |
| 转移概率 | p(s′∣s,a) | 在 s 做 a,到 s′ 的概率 | 都是 0 或 1 |
| 奖励 | r(s,a) | 在 s 做 a 拿到的奖励 | −1,进充电座 +10 |
| 折扣因子 | γ | 以后的奖励打几折 | 0.9 |
其中 s′ 读作"s 撇",表示下一个状态。把走廊的规则画成图,就是下面这样:
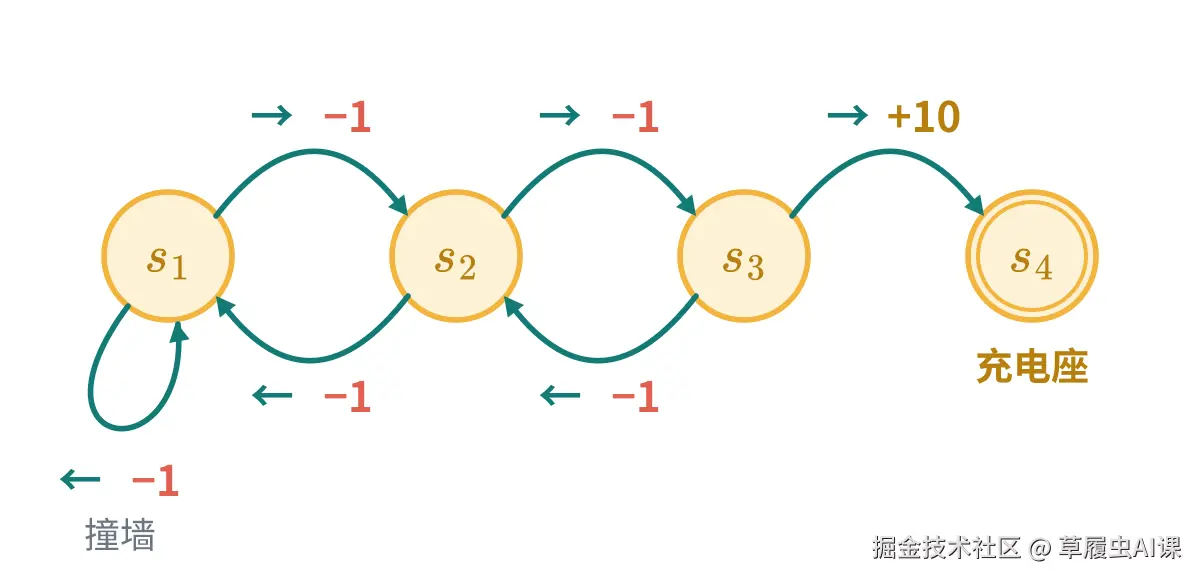
▲ 图 9 走廊的状态转移图:圆圈是状态,箭头是做了某个动作之后去哪
转移概率:要是地板有点滑
走廊里每个动作的结果都是确定的,所以转移概率不是 1 就是 0。现实里常常不是这样。假设刚拖完地,地板有点滑:按 → 时,80% 能挪过去,20% 打滑、留在原地。不管挪没挪成都扣 1 分,只有真的进了充电座才 +10。于是:
p(s3∣s2,→)=0.8,p(s2∣s2,→)=0.2
同一个状态、同一个动作,下一步可能去不同的地方------这就是转移概率要描述的事。同一个 s、同一个 a 下,所有去处的概率加起来一定等于 1(这里 0.8+0.2=1)。
【例 5】滑地板上的两道小题
(1) 在 s3 按 →,这一步平均能拿多少奖励?80% 进充电座拿 +10,20% 打滑拿 −1:
0.8×10+0.2×(−1)=8−0.2=7.8
(2) 从 s2 出发一直按 →,正好两步进充电座的概率是多少?第 1 步要挪成(0.8),第 2 步也要挪成(0.8):
0.8×0.8=0.64
剩下 36% 的情况里至少打滑了一次,要多走几步。下面的概率树把四种情况都画出来了,四个概率加起来正好是 1。
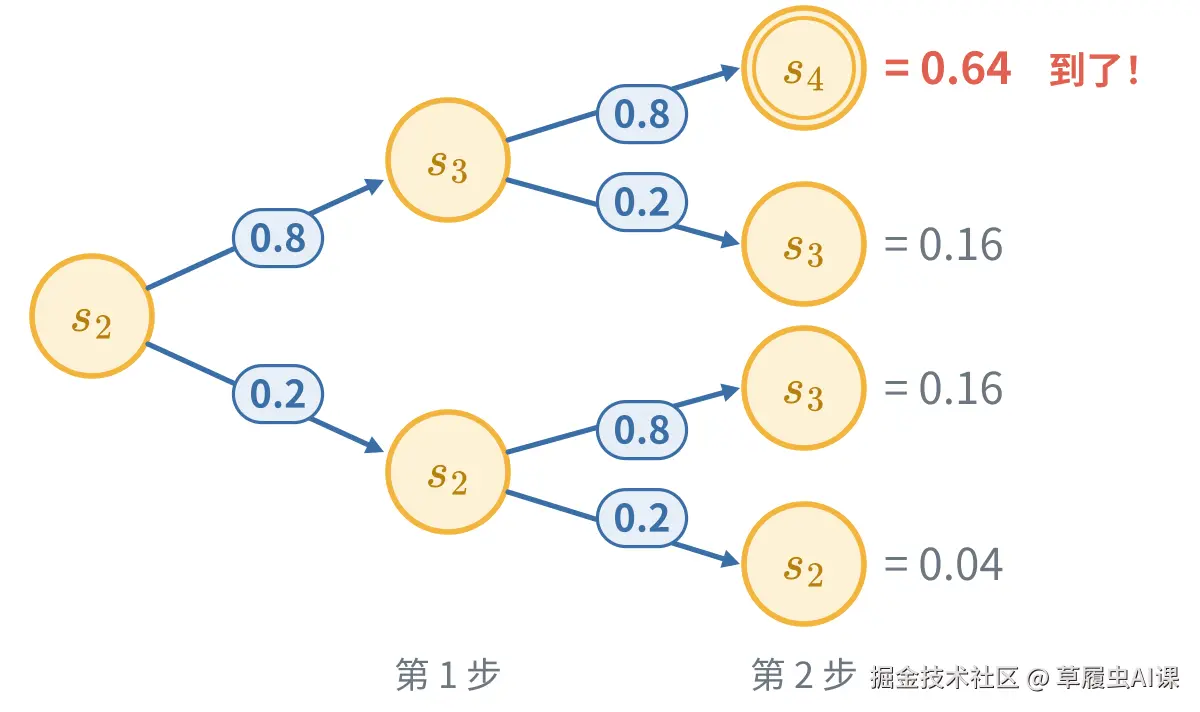
▲ 图 10 概率树:每一步都按 →,0.8 挪成、0.2 打滑;沿着一条路径把概率乘起来
"马尔可夫"是什么意思
▲ 图 11 漫画 ③ 只看现在,不问过去
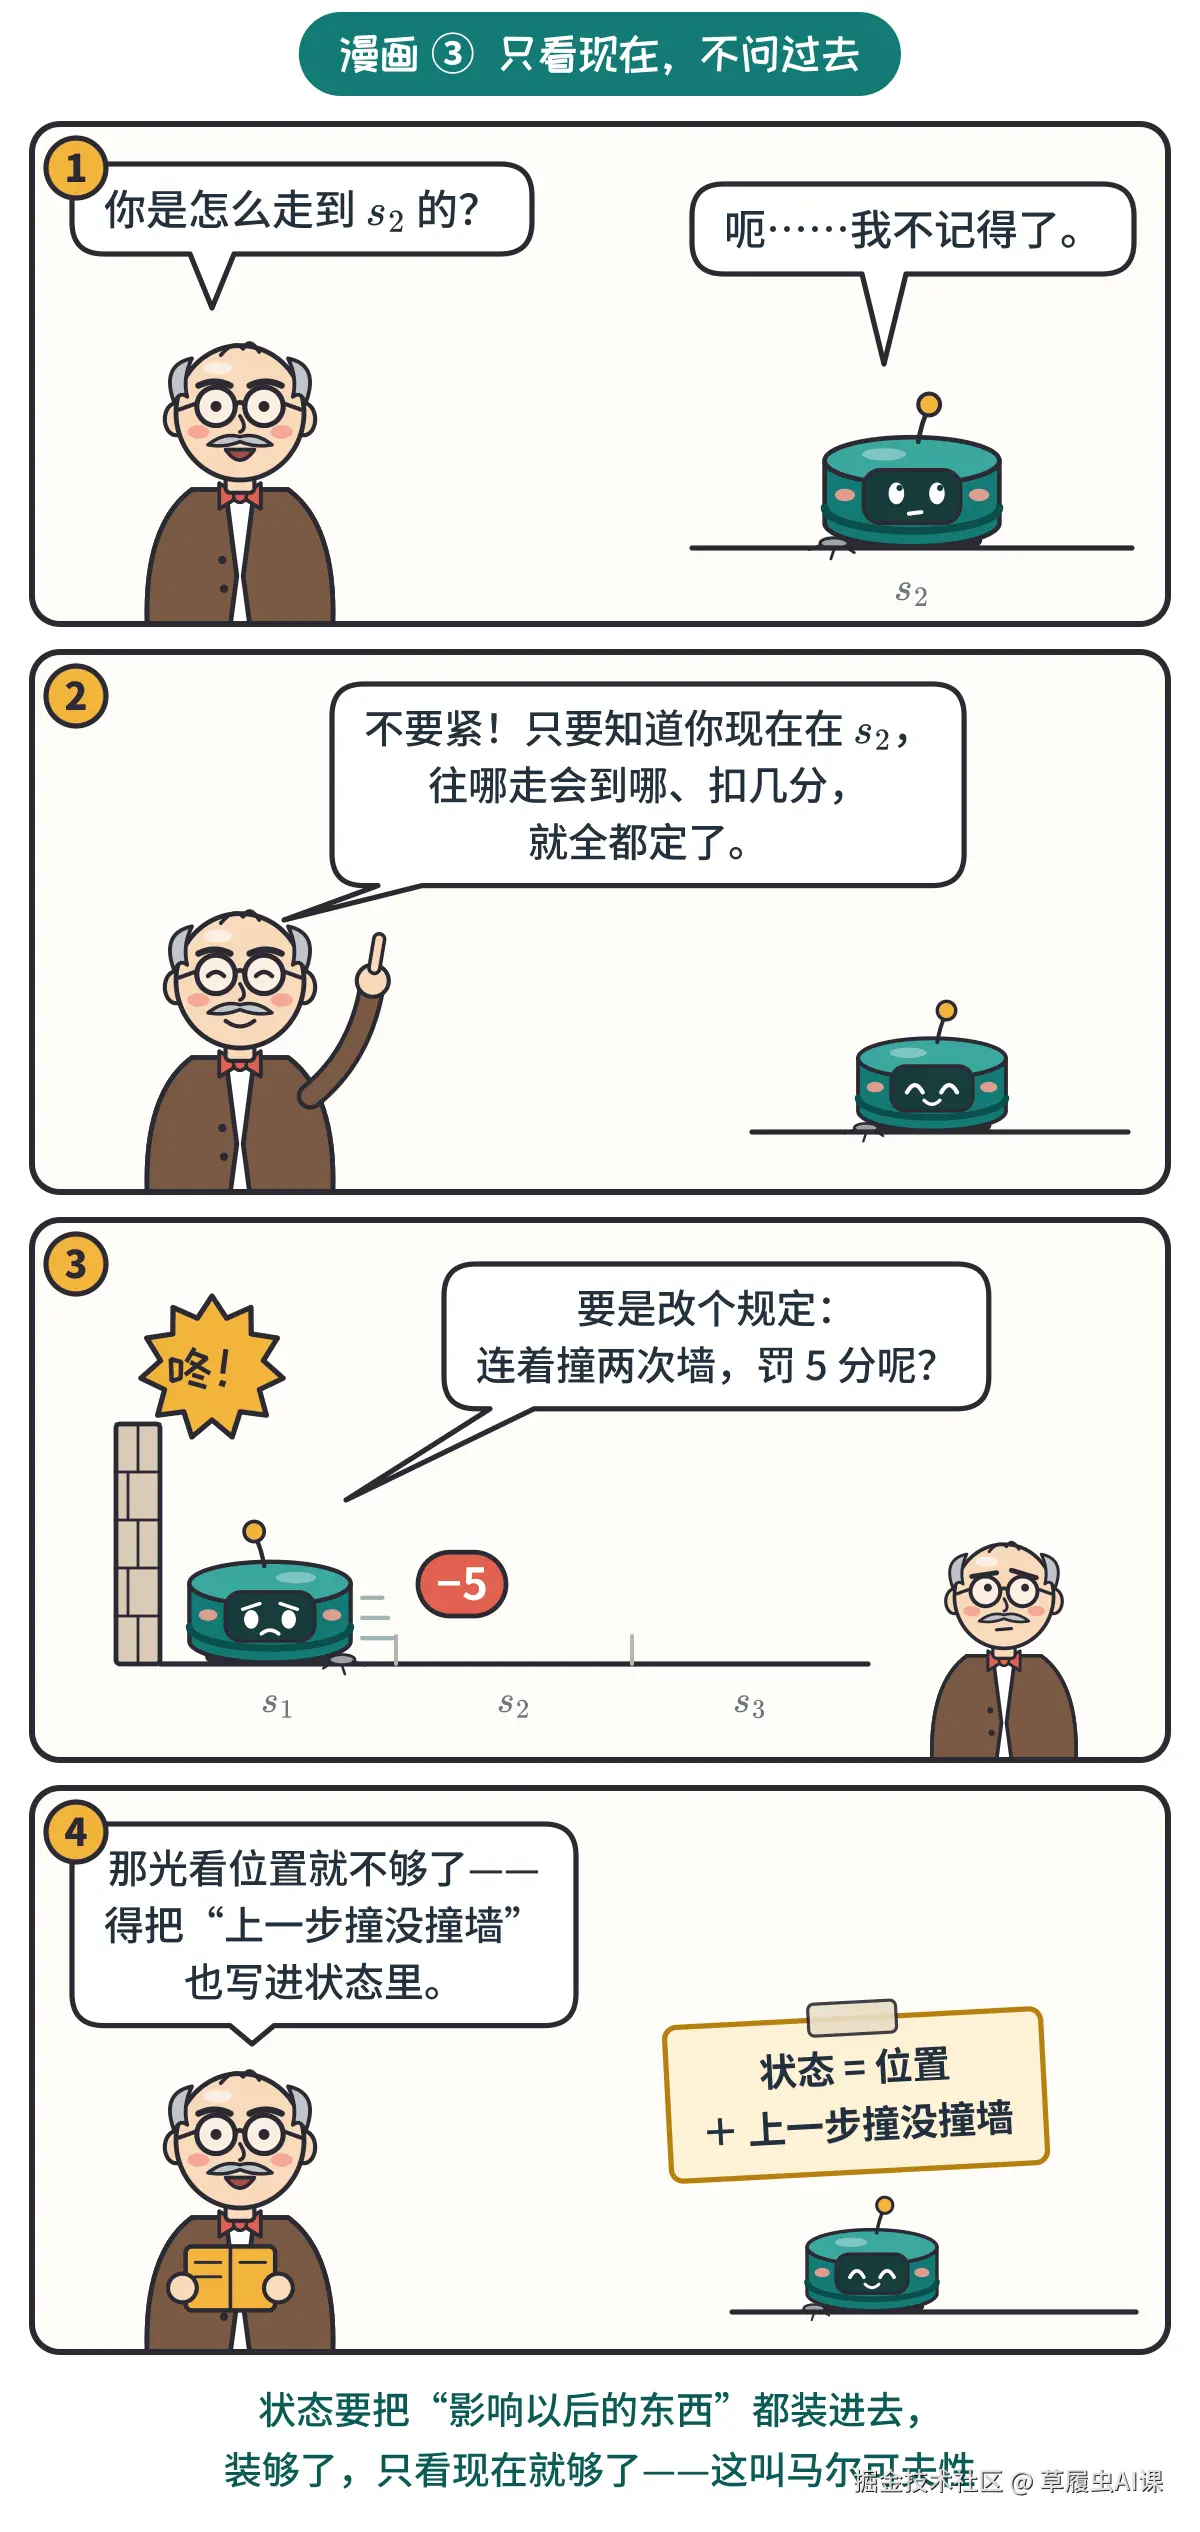
名字里的"马尔可夫",指的是一个假设:下一步会发生什么,只取决于现在的状态和动作,跟之前是怎么走过来的无关。写成式子:
=P(St+1∣St,At)P(St+1∣S0,A0,S1,A1,...,St,At)
左边只看"现在",右边把"全部历史"都看了。两边相等,就说明历史没有提供任何额外的信息。这叫马尔可夫性。奖励也一样,只取决于现在的状态和动作。
【例 6】新规定破坏了马尔可夫性
原来的走廊满足马尔可夫性:只要知道小扫在 s1、要按 ←,结果就一定是"原地不动、−1",不用管它是怎么来到 s1 的。
现在加一条新规定:如果上一步刚撞过墙,这一步再撞,罚 −5 。小扫在 s1 按 ←:
- 上一步是从 s2 走过来的:这是第一次撞墙,奖励 −1;
- 上一步已经撞过墙了:这是连着撞,奖励 −5。
同样是"在 s1 按 ←",奖励可能是 −1,也可能是 −5,得翻历史才知道。只用"位置"当状态,就不满足马尔可夫性了。
办法是把状态分得更细:把 s1 拆成" s1,上一步没撞墙"和" s1,刚撞过墙"两个状态。这样在每个状态按 ←,奖励又是确定的(分别是 −1 和 −5),只看现在又够了。
【要点】
马尔可夫性不是天生的,要看你把什么放进状态里。设计状态时,要把会影响以后的东西都装进去。下棋就是个好例子:只要看清现在的棋盘,之前是怎么下到这一步的,就不重要了。
【档案】1906 Andrey Markov(马尔可夫)
俄国 · 圣彼得堡大学
发表论文研究一种随机序列:下一个结果只和前一个有关。后人把它叫作马尔可夫链。1913 年他数了普希金长诗《叶甫盖尼·奥涅金》里的 2 万个字母,统计元音、辅音怎样前后相接,用真实的文本演示了这种链。
1957 Richard Bellman(贝尔曼)
美国 · 兰德公司
发表论文《马尔可夫决策过程》,在马尔可夫链里加进了"每一步做一个选择",这就是今天 MDP 的雏形;同年出版《动态规划》一书。下一篇的贝尔曼方程,就是以他的名字命名的。
五、策略:小扫的行动手册
▲ 图 12 漫画 ④ 小扫的行动手册
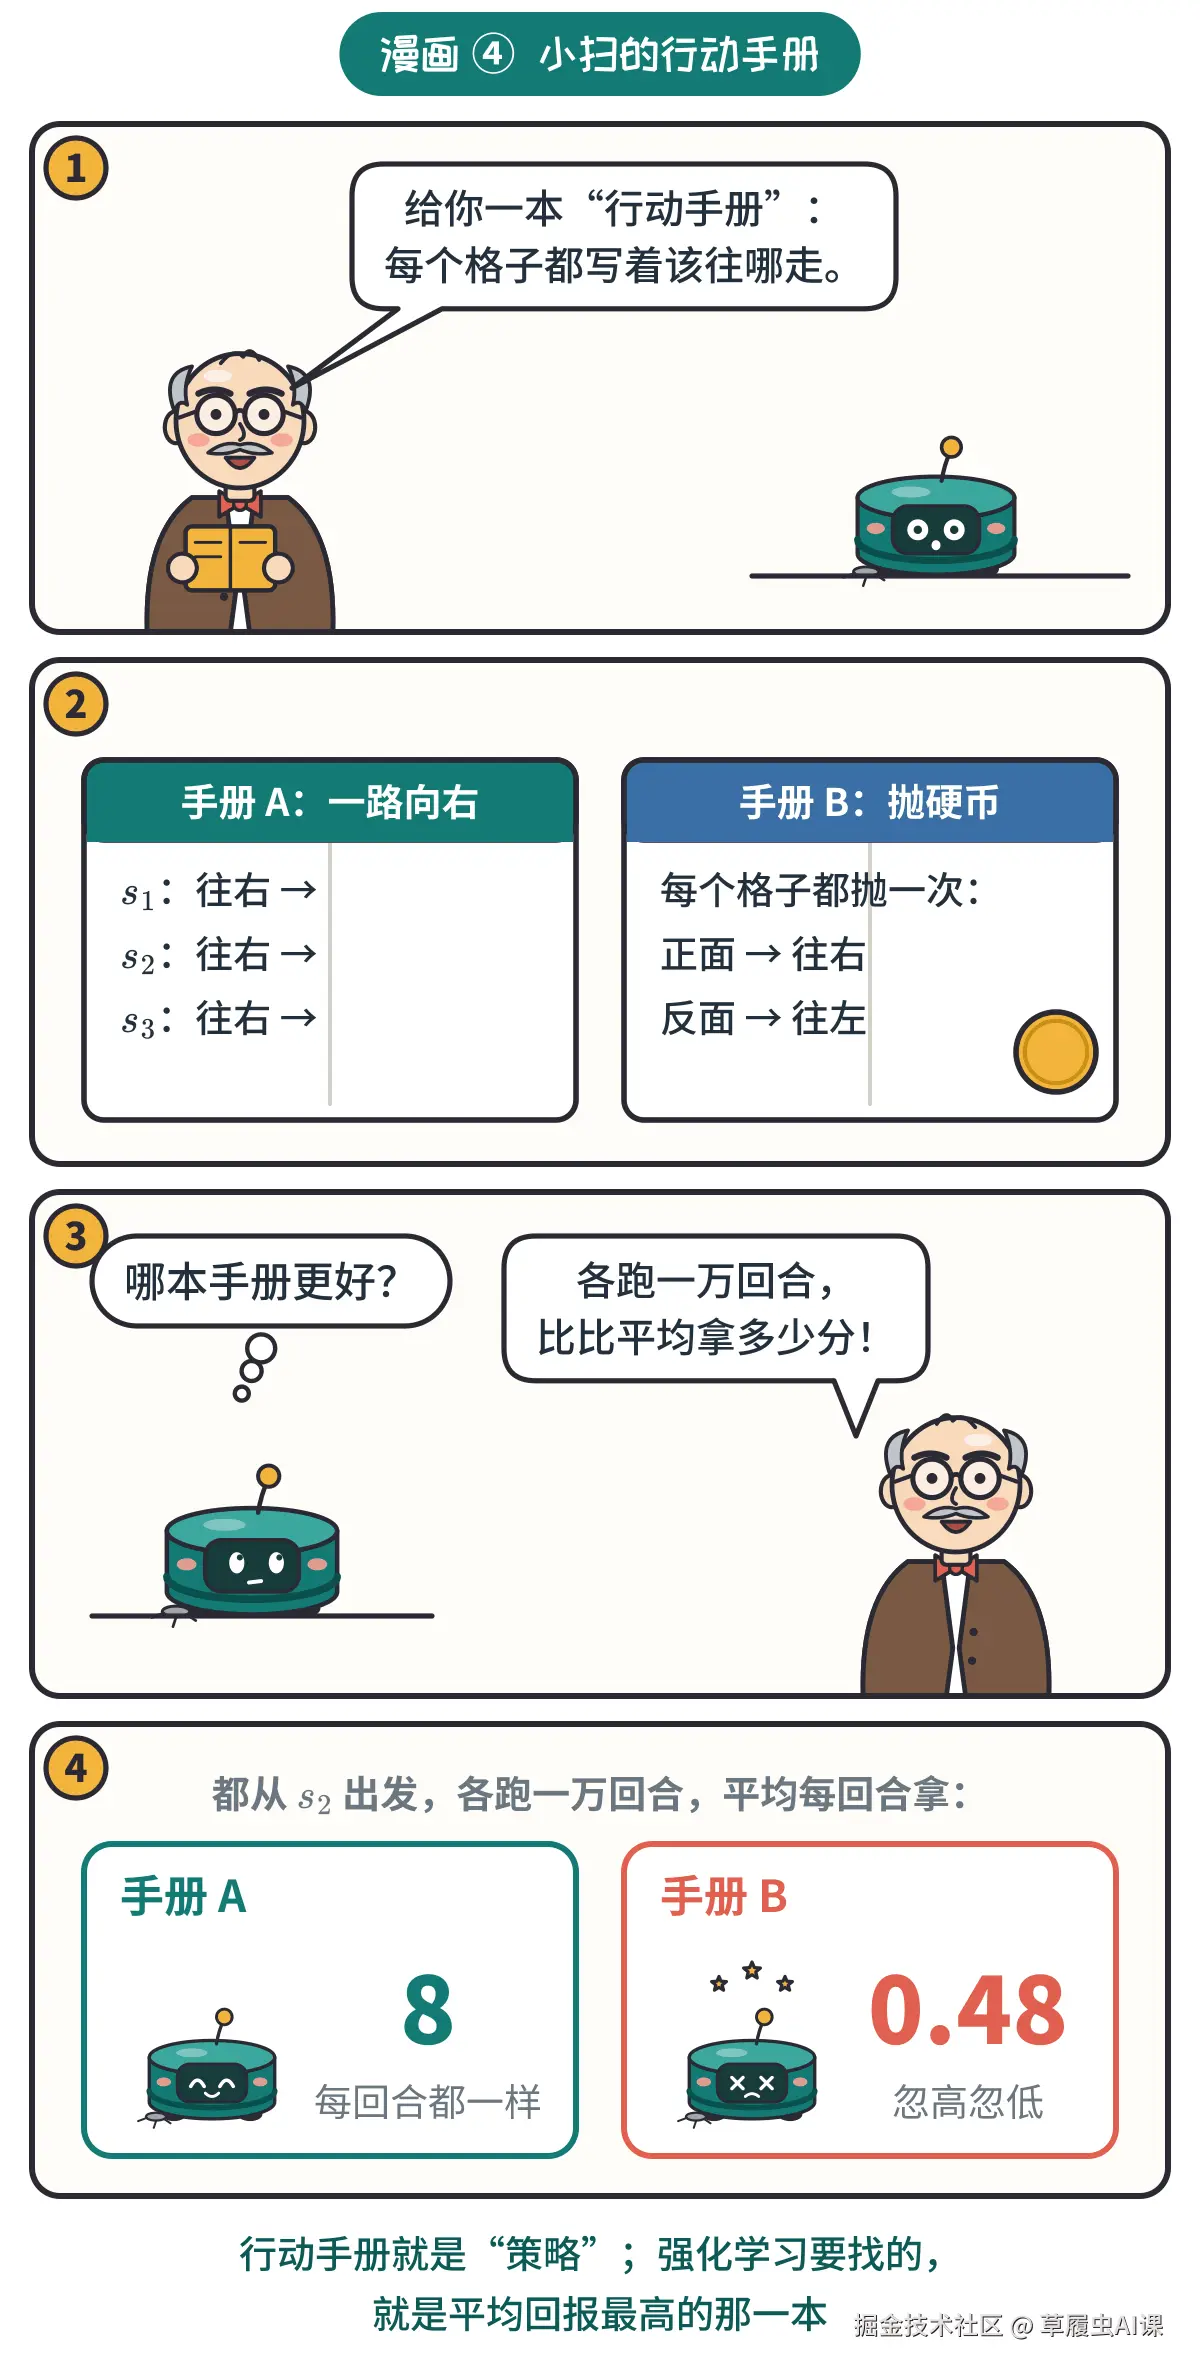
智能体在每个状态下怎样选动作,这套规则叫策略 (policy),记作 π。它就像一本行动手册。策略分两种:
- 确定性策略 :每个状态只写一个动作,记作 π(s)。比如手册 A: π(s1)=π(s2)=π(s3)=→。
- 随机策略 :每个状态写的是"每个动作的概率",记作 π(a∣s),读作"在状态 s 下选动作 a 的概率"。比如手册 B: π(→∣s)=π(←∣s)=0.5。
确定性策略可以看成随机策略的特例:写着的那个动作概率是 1,其余都是 0。再加一本"九成往右"的手册 C,三本手册放在一起比一比:
| 往右的概率 | s1 | s2 | s3 |
|---|---|---|---|
| 手册 A(一路向右) | 1 | 1 | 1 |
| 手册 B(抛硬币) | 0.5 | 0.5 | 0.5 |
| 手册 C(九成向右) | 0.9 | 0.9 | 0.9 |
【例 7】策略决定了会走出哪些回合
走廊里动作的结果是确定的,所以一个回合出现的概率,就是每一步选中那个动作的概率乘起来。还是例 2 的三个回合:
| 回合 | 手册 B | 手册 C |
|---|---|---|
| A(→→) | 0.52=0.25 | 0.92=0.81 |
| B(←←→→→) | 0.55≈0.031 | 0.12×0.93≈0.0073 |
| C(←←←→→←→→) | 0.58≈0.0039 | 0.14×0.94≈0.00007 |
手册 C 很少往左,绕远路的回合 B、C 几乎不会出现;手册 B 什么回合都可能走出来。策略不同,走出的回合不同,回报也就不同。
【例 8】比一比两本手册的平均回报
手册 A 从 s2 出发,每回合都是 →→,回报都是 8。
手册 B 每回合都不一样。好在回报只和步数有关:走了 n 步,前 n−1 步各扣 1 分,最后一步 +10,照例 2 的算法:
G=−(1+0.9+⋯+0.9n−2)+0.9n−1×10=−10+20×0.9n−1
代入 n=2、5、8,得到 8、3.122、−0.434,正好是那三个回合。走到 8 步以上,回报就成了负数。
再算出每种步数出现的概率(或者让程序模拟很多回合数一数),画成下图。
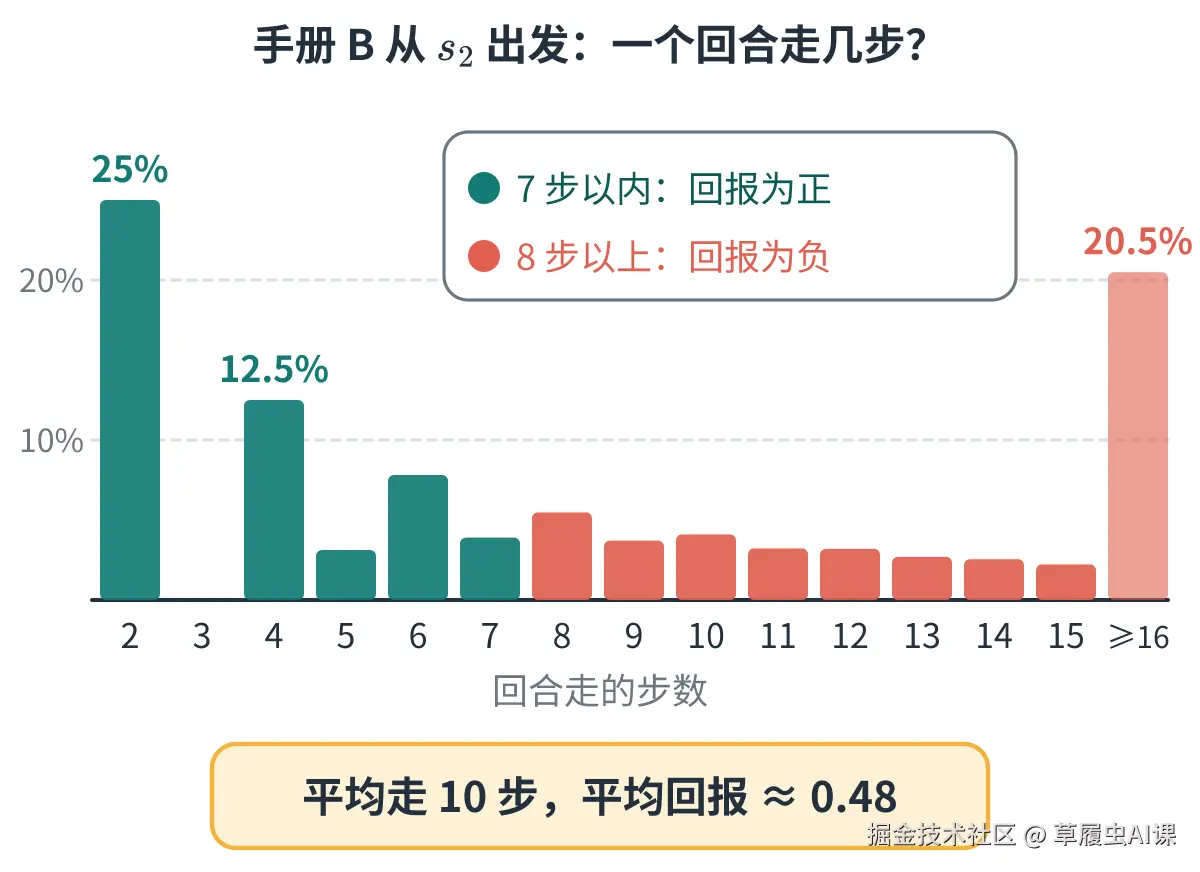
▲ 图 13 手册 B 的回合长度分布。没有 3 步的回合:只要往回走一步,就得多走两步才能回来
有 25% 的回合两步就到,回报 8;可也有 20% 的回合要走 16 步以上,回报不超过 −5.88。把所有回合平均起来,手册 B 从 s2 出发的平均回报约 0.48,远不如手册 A 的 8。
【要点】强化学习的目标
找到一个策略,让平均回报尽可能高。"平均"两个字很重要:每个回合的回报都带着运气成分,评价一个策略,要看它平均能拿多少。
六、小结
| 概念 | 一句话 | 走廊里 |
|---|---|---|
| 智能体 / 环境 | 做决定的一方 / 其余的一切 | 小扫 / 走廊 |
| 状态 St | 环境此刻的样子 | s1∼s4 |
| 动作 At | 智能体的选择 | ←、→ |
| 奖励 Rt+1 | 做完动作拿到的分数 | 每步 −1,进充电座 +10 |
| 回报 Gt | 以后的奖励打折加起来 | 回合 A 是 8 |
| 折扣因子 γ | 每晚一步打几折 | 0.9 |
| MDP | 状态、动作、转移概率、奖励、折扣因子 | 第四节的表 |
| 马尔可夫性 | 只看现在就够了 | 只看位置就够 |
| 策略 π | 每个状态怎样选动作 | 手册 A、B、C |
一句话串起来:智能体按策略 在 MDP 里一步步做动作、拿奖励,把奖励打折加起来就是回报 ;强化学习要找的,是平均回报最高的策略。
附一 动手算一算
下面这段 Python 代码只用到标准库:先用"从后往前"的办法算出三个回合的回报,再让手册 A、B 各跑 10 万个回合,比较平均回报。
python
import random
from random import choice

GAMMA = 0.9

def step(s, a):
    """走廊:s=1,2,3;a=-1左/+1右"""
    if s == 3 and a == 1:
        return 4, 10, True  # 进充电座
    s2 = max(1, s + a)  # s1往左撞墙
    return s2, -1, False

def ret(rewards):
    """从后往前算回报"""
    G = 0.0
    for r in reversed(rewards):
        G = r + GAMMA * G
    return round(G, 3)

print(ret([-1, 10]))         # 8.0
print(ret([-1] * 4 + [10]))  # 3.122
print(ret([-1] * 7 + [10]))  # -0.434

def run(policy, s=2):
    """跑一回合,返回回报 G"""
    G, k, done = 0.0, 0, False
    while not done:
        a = policy(s)
        s, r, done = step(s, a)
        G += GAMMA ** k * r
        k += 1
    return G

book_A = lambda s: 1
book_B = lambda s: choice([-1, 1])

random.seed(0)
N = 100_000
for name, pi in [("A", book_A),
                 ("B", book_B)]:
    gs = [run(pi) for _ in range(N)]
    print(name, round(sum(gs) / N, 3))
# 输出:A 8.0,B 0.478
手册 B 的结果 0.478 是模拟出来的,换一个随机种子会略有不同。下一篇不用模拟,直接把它精确算出来。
附二 参考文献
- Thorndike E L. Animal Intelligence: Experimental Studies. Macmillan, 1911.
- Markov A A. Extension of the Law of Large Numbers to Dependent Quantities (in Russian). Bulletin of the Physico-Mathematical Society of Kazan University, 1906.
- Markov A A. An Example of Statistical Analysis of the Text of Eugene Onegin Illustrating the Association of Trials into a Chain (in Russian). Bulletin of the Imperial Academy of Sciences of St. Petersburg, 1913.
- Bellman R. A Markovian Decision Process. Journal of Mathematics and Mechanics, 1957.
- Sutton R S, Barto A G. Reinforcement Learning: An Introduction (2nd ed.). MIT Press, 2018.
【下期预告】价值函数与贝尔曼方程
回报是一个回合的成绩,忽高忽低。把从某个状态出发的回报平均 起来,就是这个状态的价值 V(s);细到"状态 + 动作",就是 Q(s,a)。
下一篇用本篇的"这一步 + γ × 下一步"写出贝尔曼方程 ,把手册 B 在 s2 的平均回报 0.48 精确算出来;再写出贝尔曼最优方程,算出走廊里每个格子最好能拿多少分。
------ 强化学习从零到一 · 第 1 篇 · 完 ------