💥今天看一下 PyTorch数据通常的处理方法~
一般我们会将dataset用来封装自己的数据集,dataloader用于读取数据
Dataset格式说明
💬dataset定义了这个数据集的总长度,以及会返回哪些参数,模板:
python
from torch.utils.data import Dataset

class MyDataset(Dataset):
    def __init__(self, ):
        # 定义数据集包含的数据和标签

    def __len__(self):
        return len(...)
    def __getitem__(self, index):
        # 当数据集被读取时,返回一个包含数据和标签的元组
        return self.x_data[index], self.y_data[index]
DataLoader格式说明
python
my_dataset = DataLoader(mydataset, batch_size=2, shuffle=True,num_workers=4)
 # num_workers:多进程读取数据
导入两个列表到Dataset
python
class MyDataset(Dataset):
    def __init__(self, ):
        # 定义数据集包含的数据和标签
        self.x_data = [i for i in range(10)]
        self.y_data = [2*i for i in range(10)]

    def __len__(self):
        return len(self.x_data)
    def __getitem__(self, index):
        # 当数据集被读取时,返回一个包含数据和标签的元组
        return self.x_data[index], self.y_data[index]

mydataset = MyDataset()
my_dataset = DataLoader(mydataset)

for x_i ,y_i in my_dataset:
    print(x_i,y_i)
💬输出:
python
tensor([0]) tensor([0])
tensor([1]) tensor([2])
tensor([2]) tensor([4])
tensor([3]) tensor([6])
tensor([4]) tensor([8])
tensor([5]) tensor([10])
tensor([6]) tensor([12])
tensor([7]) tensor([14])
tensor([8]) tensor([16])
tensor([9]) tensor([18])
💬如果修改batch_size为2,则输出:
python
tensor([0, 1]) tensor([0, 2])
tensor([2, 3]) tensor([4, 6])
tensor([4, 5]) tensor([ 8, 10])
tensor([6, 7]) tensor([12, 14])
tensor([8, 9]) tensor([16, 18])- 我们可以看出,这是管理每次输出的批次的
- 还可以控制用多少个线程来加速读取数据(Num Workers),这参数和电脑cpu核心数有关系,尽量不超过电脑的核心数
导入Excel数据到Dataset中
💥dataset只是一个类,因此数据可以从外部导入,我们也可以在dataset中规定数据在返回时进行更多的操作,数据在返回时也不一定是有两个。
python
pip install pandas
pip install openpyxl
python
class myDataset(Dataset):
    def __init__(self, data_loc):
        data = pd.read_ecl(data_loc)
        self.x1,self.x2,self.x3,self.x4,self.y = data['x1'],data['x2'],data['x3'] ,data['x4'],data['y']

    def __len__(self):
        return len(self.x1)

    def __getitem__(self, idx):
        return self.x1[idx],self.x2[idx],self.x3[idx],self.x4[idx],self.y[idx]

mydataset = myDataset(data_loc='e:\pythonProject Pytorch1\data.xls')
my_dataset = DataLoader(mydataset,batch_size=2)
for x1_i ,x2_i,x3_i,x4_i,y_i in my_dataset:
    print(x1_i,x2_i,x3_i,x4_i,y_i)
导入图像数据集到Dataset
需要安装opencv
pip install opencv-python

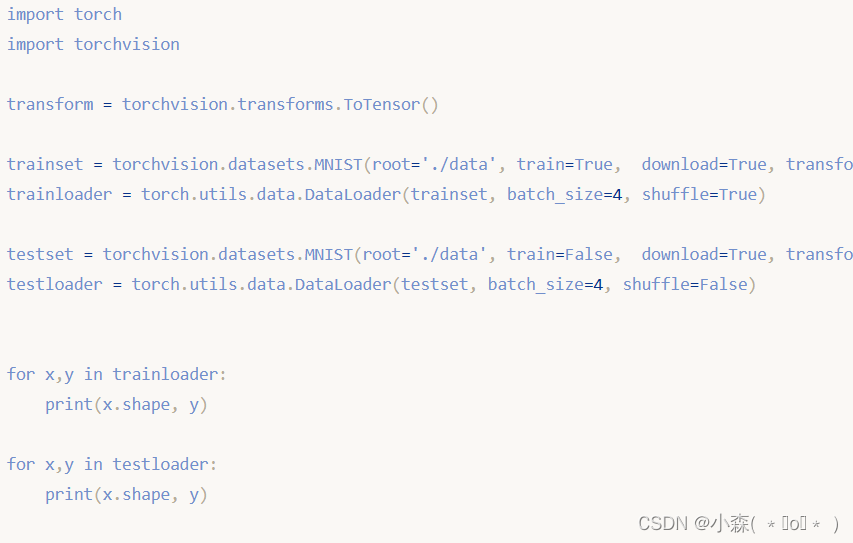
💯加载官方数据集
有一些数据集是PyTorch自带的,它被保存在TorchVision中,以mnist数据集为例进行加载: